Kimi K3技术详解系列(一):KDA 与 Hybrid Attention
Kimi K3技术详解系列(一):KDA 与 Hybrid Attention
这是 Kimi K3 系列的第一篇,专门讲序列方向的改动:KDA(Kimi Delta Attention)和它怎样在 GPU 上运行。后两篇分别讨论深度方向的 AttnRes、宽度方向的 Stable LatentMoE,以及训练和 serving 系统。
系列目录
- Kimi K3技术详解系列(一):KDA 与 Hybrid Attention
- Kimi K3技术详解系列(二):AttnRes 与 Stable LatentMoE
- Kimi K3技术详解系列(三):训练与 Serving Infra
1. 1M context 的真正难点:不是存不下,是读不起
看到”支持 1M context”这种卖点,第一反应往往是”显存怎么塞得下一百万个 token”。但真正棘手的除了存,另一个就是读。
想象一下标准 attention 在生成第 $t$ 个 token 时干了什么:把当前的 hidden state 投影成 query,然后拿它和每一个历史 token 的 key 做相似度比较,最后按比较结果把对应的 value 加权求和,得到当前输出:
\[\bm o_t=\sum_{j\le t} a_{t,j}\bm v_j, \qquad a_{t,j}=\frac{\exp(\bm q_t^\top\bm k_j)} {\sum_{r\le t}\exp(\bm q_t^\top\bm k_r)}.\]KV cache 解决的是”别重复投影”——每个历史 token 的 K/V 只算一次,之后直接查表。但查表也是要读的:每生成一个 token,都要把整段历史 KV 从头到尾扫一遍。1K 的时候无所谓,1M 的时候,这一步的读取量就是原来的 1000 倍。长 context 推理在 decode 阶段越来越慢,根子就在这。
对超长 context,理想上同时想要三件事:
- 精确的 softmax attention:任意 query 都能对每个历史 token 单独打分;
- 固定大小的历史状态:历史从 1K 增长到 1M,显存不随长度增长;
- 固定的单步读取量:生成下一个 token 时,不再扫描全部历史。
这三件事不能同时成立。为什么?因为标准 attention 用的那个相似度函数——也就是”核”——不满足一个简单的代数性质。
这里先把”核”和”特征映射”这两个词解释清楚,后面全程都要用:
- 核函数(kernel) 就是衡量两个向量”有多像”的打分函数 $\kappa(\bm q,\bm k)$,值越大越像。标准 attention 用的核是 $\kappa(\bm q,\bm k)=\exp(\bm q^\top\bm k)$,也就是先算两个向量的点积、再取指数。
- 特征映射(feature map) 是一个变换 $\phi(\cdot)$:如果两个向量的相似度能写成 $\kappa(\bm q,\bm k)=\phi(\bm q)^\top\phi(\bm k)$——各自变换到同一个固定维空间之后做内积——我们就说这个核可分解。
可分解为什么重要?因为一旦可分解,历史就能先聚合:所有历史 key 各自变换、写进一个固定大小的状态里(比如 $\sum_j\phi(\bm k_j)\bm v_j^\top$),等 query 来了直接读——状态的大小和历史的长度无关。
麻烦的是,$\exp(\bm q^\top\bm k)$ 恰恰不可分解。把指数展开:$\exp(x)=\sum_{n\ge0}x^n/n!$,展开出来是 $\bm q^\top\bm k$ 的无穷阶多项式;想把这个”无穷阶”的东西精确地装进”固定维内积”里,特征映射必须是无穷维的。所以只要用 softmax,attention 就必须把每个历史 key 都留下来、等 query 来了逐个算——这不是实现偷懒,是数学上就绕不过去。
那就换个思路:如果不用 softmax 这个核,改用一个可分解的核,固定大小状态是不是就能成立了? 这是第 2 节要推的数学条件。在那之前,先把两条路线说清楚:
- MLA(Multi-head Latent Attention,多头潜在注意力) 选择保留精确的全局读取,只把每个 token 的 KV 压得更小——它降低的是”每个位置占多大”,不是”有多少个位置”。长度继续往上走,位置数量本身的成本还是压不住。
- KDA 走另一条路:承认逐 token 的精确检索放不下,把历史压缩成一个固定大小的状态,换取”状态大小和单步读取量都不随长度增长”。
两者不是替代关系,K3 干脆把两种取舍交替使用:每个 block 里 3 层 KDA 负责低成本地传播和更新压缩记忆,随后 1 层 MLA 保留一次完整的全局内容检索;最后一层也使用 MLA。Hybrid Attention 的 3:1 不是由某个公式必然推出来的常数,而是在”多数层不扫全历史”和”模型仍定期能精确看历史”之间作出的架构选择。
2. 要得到固定状态,attention 必须长成什么样
上一节的结论是:想要固定大小的状态,就得换核。这一节把”换核”具体成数学条件。
目标很朴素:让历史在 query 到来之前,就先被汇总成一个固定形状的对象。把历史记作 $H_t={(\bm k_j,\bm v_j)}_{j\le t}$,我们希望的计算形式是:
\[\bm o_t=R\bigl(\bm q_t,\;G(H_t)\bigr),\]其中 $G(H_t)$ 的形状不能随 $t$ 增长。注意这里和普通 attention 的区别:普通 attention 是”query 来了,再拿它去逐个比历史”;这里要求”历史先算好,query 来了只做一次读取“。
要让 $G$ 能在线更新、又保留 query 相关的内容检索,最直接的条件就是上一节说的核可分解——相似度核必须能拆成 query 的一部分和 key 的一部分:
\[\kappa(\bm q,\bm k)=\phi(\bm q)^\top\phi(\bm k), \qquad \phi(\cdot)\in\mathbb R^r,\]其中 $r$ 是固定维度。把这种核代回 attention 的求和式,历史项就可以提前合并成两个状态:
\[\mathbf S_t=\sum_{j\le t}\phi(\bm k_j)\bm v_j^\top, \qquad \bm z_t=\sum_{j\le t}\phi(\bm k_j),\] \[\bm o_t= \frac{\phi(\bm q_t)^\top\mathbf S_t} {\phi(\bm q_t)^\top\bm z_t}.\]这个式子可以读成一句话:分子负责”相似 key 的 value 该怎么聚合”,分母负责归一化;两者的形状只由 $r$ 和 value 维度决定,跟历史多长没关系。 形象一点说,$\mathbf S_t$ 是一块”记忆黑板”:历史 token 按 $\phi(\bm k)$ 选好方向、把 value 写在上面;query 来了,用 $\phi(\bm q)$ 顺着方向去读。关键变化在于,softmax 的全局竞争被换成了一个有限维的相似度空间——历史 token 写入 $\phi(\bm k)$ 指向的方向,query 用 $\phi(\bm q)$ 读取这些方向。这就是固定状态能成立的数学条件。
为了把状态本身看清楚,先取最简单的 $\phi(\bm x)=\bm x$,并暂时省去归一化项:
\[\bm o_t=\sum_{j\le t}(\bm q_t^\top\bm k_j)\bm v_j =\bm q_t^\top\underbrace{\sum_{j\le t}\bm k_j\bm v_j^\top}_{\mathbf S_t}, \qquad \mathbf S_t=\mathbf S_{t-1}+\bm k_t\bm v_t^\top.\]$\mathbf S_t\in\mathbb R^{d_k\times d_v}$ 是历史的一个”充分统计量”:每个外积 $\bm k_j\bm v_j^\top$ 记录”方向 $\bm k_j$ 上存着 value $\bm v_j$”这条关联,把它们累加,再用 query 左乘 $\bm q_t^\top\mathbf S_t$,就是把与 query 对齐的那些关联读出来。
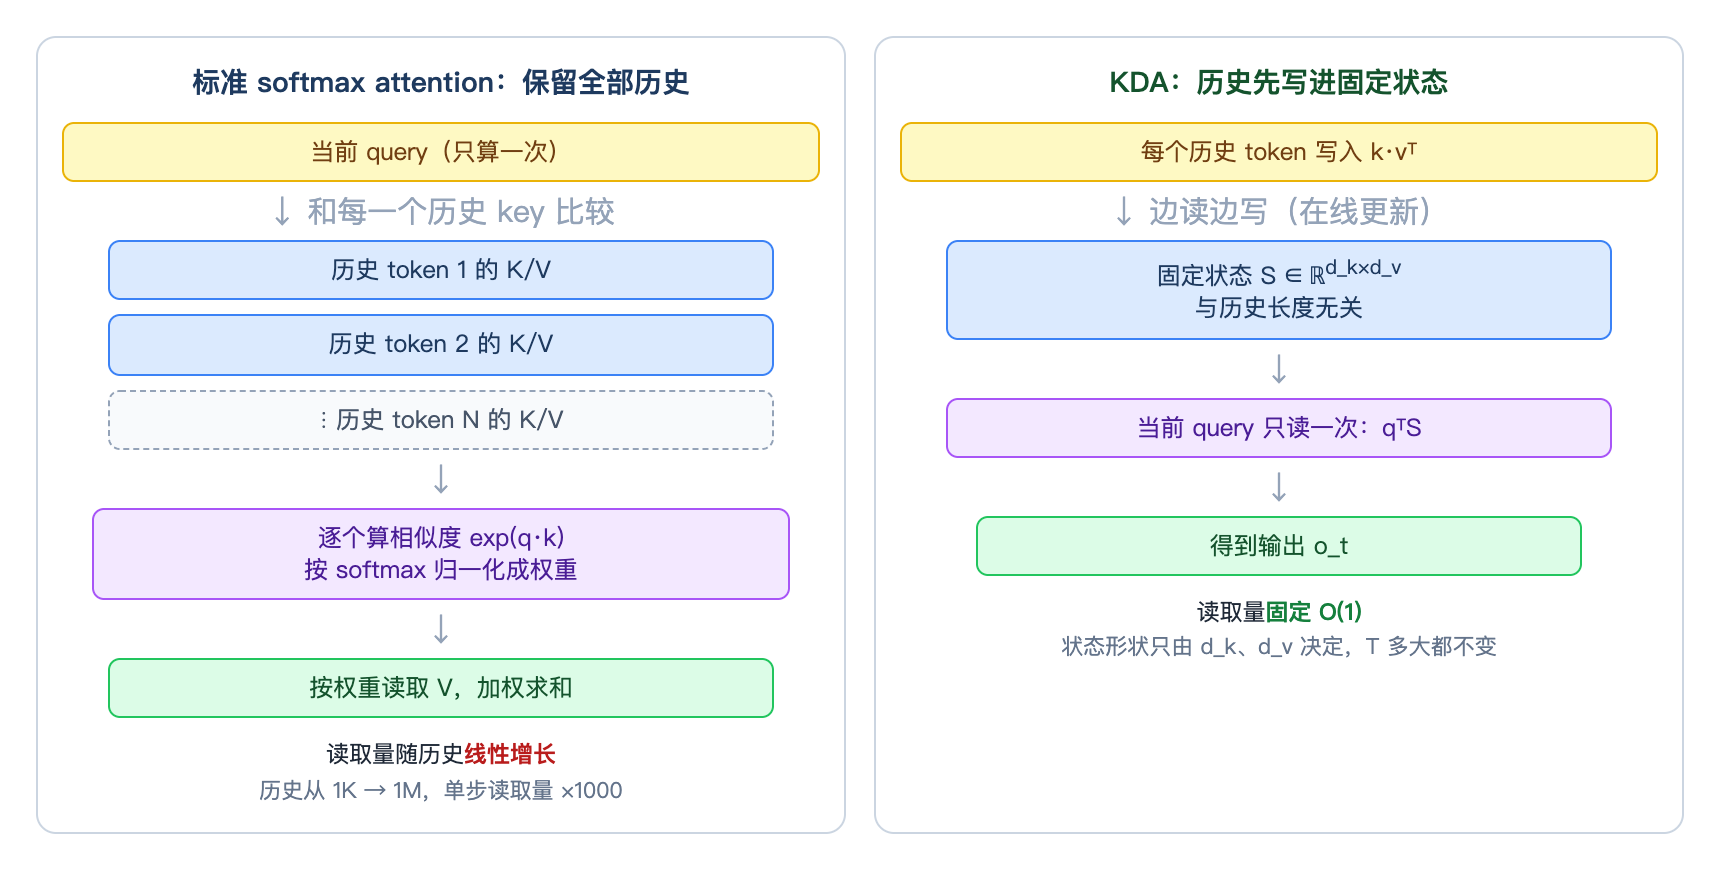
但要注意,这不是在近似实现原来的 softmax,而是定义了一种不同的记忆算子:$W_q/W_k$ 可以学习哪些内容该写到相近的方向,query 也能按方向读取;但状态里不再保留每个 token 的独立身份——两个相近的 key 写进去,会在同一片状态里叠在一起。这也预告了下一个问题:叠加就必然有冲突,冲突了怎么办?KDA 的 $q/k/v$ 投影、短卷积和 L2Norm 在这个可学习的状态空间里构造写入/读取方向,而冲突的解决,靠的是下一节的 delta rule。
3. KDA:先遗忘,再按 key 方向纠错
先看一个具体的冲突长什么样。假设某个 key 方向原先对应”项目延期”,后来同样的方向又写入了”项目已按期交付”。纯加法会让 query 同时读到两段互相矛盾的 value;我们真正想要的是新证据能修正旧记忆,而跟当前 key 无关的方向尽量不受影响。
最简单的记忆管理是给旧状态乘一个遗忘因子:
\[\mathbf S_t=\alpha_t\mathbf S_{t-1}+\bm k_t\bm v_t^\top\]这类 gated linear attention 会让旧信息逐步衰减——但整体打折太粗糙了:每个方向一起淡忘,并没有针对”刚发生冲突的那个 key”纠错。更合理的目标是:当前 key 来查状态时,状态应该返回当前 value。写成优化目标就是:
\[\mathbf S_t^\top\bm k_t\approx\bm v_t, \qquad \mathcal L(\mathbf S)=\frac12\|\mathbf S^\top\bm k_t-\bm v_t\|^2.\]这个目标直白得近乎朴素:”用这个 key 回读时,读出来的要接近这次写入的 value“。而”如何让 $\mathbf S$ 满足这个目标”有一个现成的答案——对上面的损失做一步梯度下降:先把旧状态按通道遗忘,记作 $\mathbf A_t=\operatorname{Diag}(\bm\alpha_t)\mathbf S_{t-1}$,然后从 $\mathbf A_t$ 出发,对误差做一步梯度下降,步长为 $\beta_t$:
\[\begin{aligned} \mathbf S_t &=\mathbf A_t-\beta_t\bm k_t(\bm k_t^\top\mathbf A_t-\bm v_t^\top)\\ &=(\mathbf I-\beta_t\bm k_t\bm k_t^\top)\operatorname{Diag}(\bm\alpha_t)\mathbf S_{t-1} +\beta_t\bm k_t\bm v_t^\top \end{aligned}\]第二行正是论文的 KDA 核心更新。逐项看:
- $\operatorname{Diag}(\bm\alpha_t)\mathbf S_{t-1}$:按通道决定”多久以前的记忆该保留多少”,这是遗忘;
- $(\mathbf I-\beta_t\bm k_t\bm k_t^\top)$:一个沿着 $\bm k_t$ 方向的投影,专门清掉当前 key 方向上的旧响应;
- $\beta_t\bm k_t\bm v_t^\top$:把新 value 写回同一个方向。
$\beta_t$ 决定这次修正的力度:接近 0 时几乎不改,接近 1 时更接近覆盖。
那个外积也很有画面感:括号里是”当前 key 读到的旧答案减去应写入的新答案”,也就是误差;左乘 $\bm k_t$ 表示只沿着当前 key 指向的状态方向修正。与当前 key 几乎正交的方向不会在这次更新里被直接抹掉——这就是 KDA 比”整体遗忘”更细的地方:该擦的擦,不该动的不动。
之后仍用 query 读状态:
\[\tilde{\bm o}_t=\mathbf S_t^\top\bm q_t\]所以一次 KDA 更新的完整顺序是:
- 每个通道按自己的 $\alpha$ 给旧状态打折;
- 用当前 key 读出旧状态在这个方向上的回答;
- 按误差擦掉这个方向的旧回答;
- 用当前 value 写入新记忆;
- 用 query 从更新后的状态读出结果。
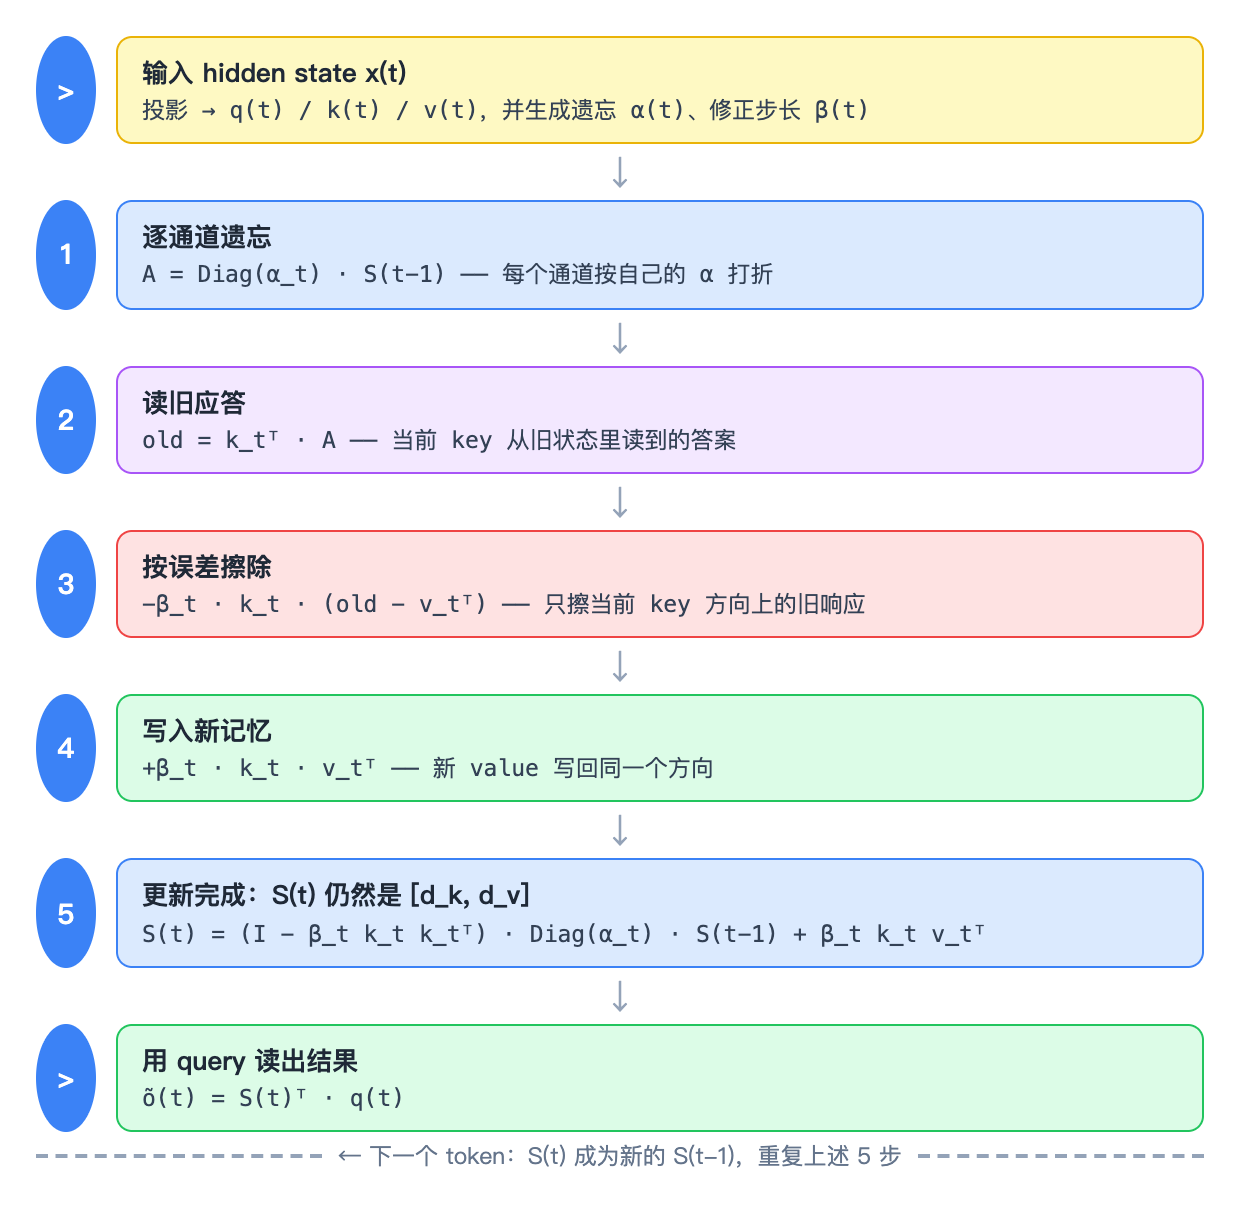
这就是 KDA 所谓的”固定大小状态”:一张会遗忘、会覆盖的联想表(associative memory)。设计链条也由此闭合:固定状态来自可结合的线性 attention;压缩记忆必然发生写入碰撞;delta rule 把覆盖规则写成”最小化当前 key 的回读误差”。
4. 先写一个能跑的 KDA head
光看公式不过瘾,下面是一个教学版单 head 实现,它就是上一节公式的直接翻译。它省略了论文里的 ShortConv(先让相邻 token 局部混合)、L2Norm(把 $q/k$ 长度控制住)和输出门,只保留”投影出 $q/k/v$,再更新和读取 $S$”这条主线。假设 batch size 是 $B$,序列长度是 $T$,输入维度是 $d_{model}$,状态大小是 $[d_k,d_v]$。
import torch
import torch.nn as nn
import torch.nn.functional as F

class KDAHead(nn.Module):
    def __init__(self, d_model, d_k=128, d_v=128):
        super().__init__()
        self.wq = nn.Linear(d_model, d_k, bias=False)
        self.wk = nn.Linear(d_model, d_k, bias=False)
        self.wv = nn.Linear(d_model, d_v, bias=False)
        self.w_beta = nn.Linear(d_model, 1, bias=False)
        self.w_alpha = nn.Linear(d_model, d_k, bias=False)

    def forward(self, x):                 # x: [B, T, d_model]
        B, T, _ = x.shape
        q = F.silu(self.wq(x))             # [B, T, d_k]
        k = F.silu(self.wk(x))             # [B, T, d_k]
        v = F.silu(self.wv(x))             # [B, T, d_v]
        beta = torch.sigmoid(self.w_beta(x))
        alpha = torch.sigmoid(self.w_alpha(x))

        S = x.new_zeros(B, q.size(-1), v.size(-1))  # [B, d_k, d_v]
        outputs = []
        for t in range(T):
            q_t, k_t, v_t = q[:, t], k[:, t], v[:, t]
            Sa = alpha[:, t, :, None] * S
            old = torch.einsum("bk,bkv->bv", k_t, Sa)
            erase = torch.einsum("bk,bv->bkv", beta[:, t] * k_t, old)
            write = torch.einsum("bk,bv->bkv", beta[:, t] * k_t, v_t)
            S = Sa - erase + write
            outputs.append(torch.einsum("bk,bkv->bv", q_t, S))
        return torch.stack(outputs, dim=1)  # [B, T, d_v]
读代码时把每一轮对应回上面的推导:Sa 是 $\operatorname{Diag}(\alpha)S$;old 是 $k^\top Sa$,也就是旧记忆对当前 key 的回答;erase 和 write 合起来是 $-\beta k(k^\top Sa-v^\top)$;最后一个 einsum 是 $q^\top S$。代码只是把”先遗忘,再按误差纠正”的式子拆开执行。输入来自上一层的 hidden states,返回一个 [B,T,d_v] 的序列表示,交给后面的输出投影和残差连接。
它最大的优点是状态 S 始终是 [B,d_k,d_v],不会因为 T 从 4K 变成 1M 而扩大。
但它有一个 GPU 不喜欢的问题:for t in range(T)。每一步都要等上一步更新完 S,然后执行几个很小的矩阵运算。算法上没问题,硬件利用率却很差——Tensor Core 喜欢的是大矩阵乘,不是这种”一次算几个数、还要排队”的串行小运算。
5. Chunkwise:同一个递推,换一种执行顺序
怎么把串行递推变成能吃满 GPU 的形式?答案很朴素:切块,块间串行、块内并行。假设序列被切成每块 4 个 token:
chunk 0: [token 0, token 1, token 2, token 3]
chunk 1: [token 4, token 5, token 6, token 7]
chunk 2: [token 8, token 9, token 10, token 11]
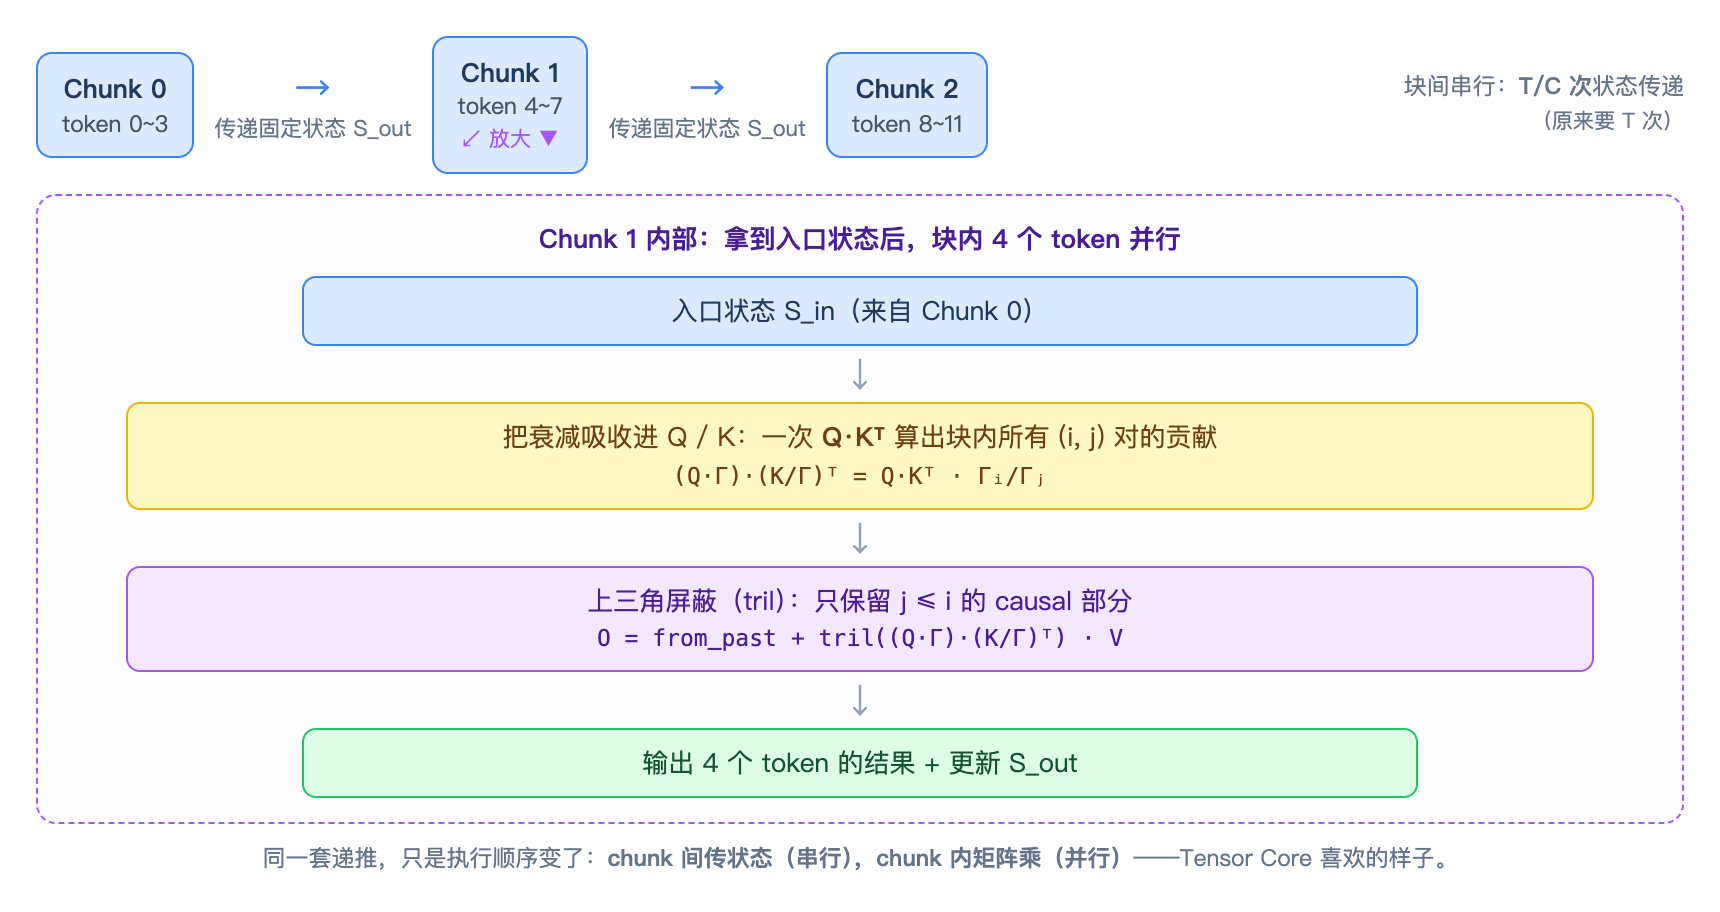
每个 chunk 只从前一个 chunk 接收一个入口状态 $\mathbf S_{in}$。拿到入口状态以后,当前 chunk 内任意位置的输出都能拆成两部分:
token 6 的输出
├── 入口状态 S_in 经过 token 4、5、6 的遗忘后,被 q_6 读取
└── token 4、5、6 在当前 chunk 写入的内容,分别遗忘到 token 6 后被 q_6 读取
接下来关心同一个递推怎样适合 GPU。完整的 delta rule 块内变换比较重,先用只含遗忘和写入的递推展示重排条件——它对应 KDA 更新中省去”按 key 擦除”后的骨架:
\[\mathbf S_i=\alpha_i\mathbf S_{i-1}+\bm k_i\bm v_i^\top\]把 chunk 内第 $i$ 个状态展开:
\[\mathbf S_i= \underbrace{\left(\prod_{r=1}^{i}\alpha_r\right)\mathbf S_{in}}_{\text{chunk 之前的记忆}} + \underbrace{\sum_{j=1}^{i}\left(\prod_{r=j+1}^{i}\alpha_r\right)\bm k_j\bm v_j^\top}_{\text{当前 chunk 的写入}}\]假设 chunk 内 token 2 的衰减因子分别为 $\alpha_1,\alpha_2$,那么:
\[\mathbf S_2=\alpha_2\alpha_1\mathbf S_{in}+\alpha_2\bm k_1\bm v_1^\top+\bm k_2\bm v_2^\top\]第一项是旧记忆,第二项是 token 1 留下的内容,第三项是 token 2 刚写入的内容。注意 token 3 不能出现在 token 2 的状态里——这就是 causal 约束,也是为什么不能一刀切地”全并行”。
接着定义累计衰减:
\[\Gamma_i=\prod_{r=1}^{i}\alpha_r\]从位置 $j$ 写入、到位置 $i$ 读取的衰减就是 $\Gamma_i/\Gamma_j$。妙处在于,可以把衰减分别乘到 query 和 key 上:
\[\left(\bm q_i\Gamma_i\right)^\top\left(\bm k_j/\Gamma_j\right) =\bm q_i^\top\bm k_j\frac{\Gamma_i}{\Gamma_j}\]这意味着整个 chunk 的 query 可以堆成矩阵 $Q$、key 堆成 $K$,一次 $QK^\top$ 就得到所有 $(i,j)$ 对的贡献,再把上三角屏蔽掉,只保留 $j\le i$ 的 causal 部分:
# C=4;每一行代表一个 token
# Q, K: [C, d_k], V: [C, d_v], S_in: [d_k, d_v]
Gamma = alpha.cumprod(dim=0)              # [C, d_k]

from_past = (Q * Gamma) @ S_in             # [C, d_v]
within = torch.tril((Q * Gamma) @ (K / Gamma).T) @ V
O = from_past + within                     # [C, d_v]
from_past 是入口状态对当前 chunk 的贡献,within 是当前 chunk 内历史写入的贡献。两者都变成了矩阵乘法,GPU 可以把一个 chunk 的多个 token 一起交给 Tensor Core。
这里并没有把顺序打乱:chunk 1 仍然要等待 chunk 0 产出 $\mathbf S_{out}$。变化的是串行依赖的粒度:原来 $T$ 个 token 需要 $T$ 次状态传递,现在大约只需要 $T/C$ 次 chunk 传递,chunk 内部则批量并行。这就是”同一个递推,换一种执行顺序”。
最后强调一句:真实 KDA 还包含 delta rule 的擦除项,不能简单删掉。工程实现用 UT transform 把擦除、遗忘和写入一起整理成类似的 causal block 运算(和 GLA 的 unified chunked computation 是同一类技巧)。上面的简化推导只负责证明一件事:状态更新虽然有顺序,但一个 chunk 内的输出能拆成”入口状态的贡献”和”块内历史的贡献”;它不代表实现真的丢掉了擦除机制。
6. Lower-bounded decay:为什么要给遗忘设下限
Chunkwise 里出现了 K / Gamma。如果每一步的遗忘因子都小于 1,连续相乘以后 $\Gamma$ 会越来越小,它的倒数可能非常大。低精度训练使用 BF16 时,这种除法容易溢出,数值不稳定会直接变成训练或 kernel 的问题。
Kimi Linear 使用的负 Softplus 映射允许 log-decay 趋近 $-\infty$。K3 把 log-decay 限制在一个有限区间:
\[\bm g_t^h=g_{min}\cdot\operatorname{Sigmoid}(e^{A_h}\bm z_t^h), \qquad g_{min}=-5\]于是每个通道的遗忘因子不会低于 $e^{-5}\approx6.7\times10^{-3}$。对一个 16-token tile,累计 log-decay 被控制在大约 $(-80,0)$,倒数的范围也被限制住。
这个改动的价值不只是”训练不溢出”。数值范围受控以后,原本需要逐位置处理的对角 tile 也可以使用 dense Tensor Core 矩阵乘法——kernel 不必为对角区域保留一条慢路径。算法上只是给遗忘设了一个下限,系统上却换来了统一的 dense tile 执行。
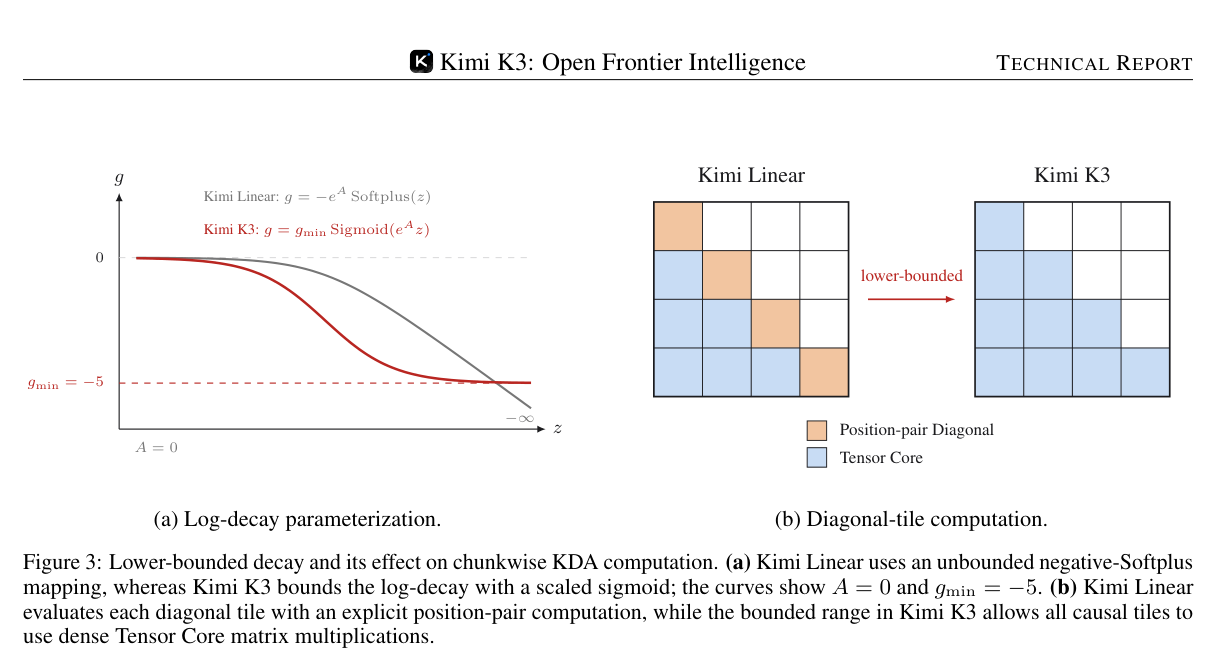
上图左侧对比了无界的负 Softplus 和 K3 的 bounded sigmoid;右侧展示了为什么 bounded decay 能让所有 causal tile 走矩阵乘法,而不是只在非对角区域快。
7. Gated MLA:为什么不能所有层都用 KDA
KDA 的状态固定大小,但它毕竟是压缩记忆:某个任务若需要精确访问很久以前的一段原文,有限状态就不如直接读取原始 KV。这正是第 2 节那次架构交换的代价。K3 因此保留 24 层 MLA,让模型在部分深度上仍然可以做全局 attention。
K3 对 MLA 做了两个配合性改动:
- MLA 层使用 NoPE,不再单独依赖 RoPE 的长上下文外推;KDA 的衰减提供了一部分顺序和远近信号,MLA 更专注于内容检索。
- MLA 使用与 KDA 类似的输出门,让每个 token 通过输入相关的 gate 调制全局 attention 的输出通道。
因此 Hybrid Attention 不是”69 层便宜层加 24 层昂贵层”的简单拼接,而是两个记忆系统分工:KDA 负责高频、低成本的状态更新,MLA 负责少量需要精确全局访问的场景。比例和层位置是模型设计与硬件成本之间的折中,不能直接推广成所有模型都应该采用 3:1。
8. 实验应该怎样读
论文在 H800 集群上比较 Kimi K2 和 K3 的推理 cost per million tokens。这里先交代两个词:prefill 是一次性读入 prompt 的阶段,decode 是逐 token 生成的阶段——长 context 下真正让人难受的是 decode,因为每生成一个 token 都要把历史读一遍。随着 token position 接近 128K,K3 的成本曲线增长更慢,decode 阶段的差距尤其明显:K2 在 128K 位置的成本还在涨,K3 的曲线已经明显被压平了。这正是 KDA”固定状态 + 固定读取量”的直接体现。
读这个结果时要注意两个边界:第一,这个结果测的是完整系统,不是只测 KDA 状态更新;第二,indexer、chunkwise kernel、MLA 层比例和部署配置都会影响绝对数值。KDA 的核心结论是主状态不再随长度保存完整 KV,但端到端收益仍然需要硬件实现来兑现。
9. 小结
KDA 的设计可以按一条因果链记住:
- 全量 KV cache 在超长 context 下带来持续增长的读取成本;
- 线性 attention 用固定矩阵状态代替历史,但只写不擦会产生干扰;
- delta rule 让写入变成”按 key 方向纠错”,再配合逐通道遗忘;
- 逐 token 更新无法喂饱 GPU,于是把递推重排成 chunk 间传状态、chunk 内矩阵并行;
- 衰减连乘会造成数值问题,K3 用 lower-bounded decay 换取统一的 Tensor Core kernel;
- 少量 Gated MLA 保留精确的全局访问,补上固定状态的记忆边界。
下一篇继续沿着”为什么会这样设计”的思路,讲 K3 的 AttnRes 和 Stable LatentMoE:一个处理层与层之间的信息流,一个处理 896 个专家如何稳定训练。
扯一句题外话:打个广告,《动手学 AutoML:从 NAS 到大语言模型优化实战》详细介绍了如何自动化搜索构架模型架构,依靠最新的各种 attention 设计范式,可以让 AI 自动搜索出更加高效的结构,感兴趣的同学可以看看我们的这本书。
