Kimi K3技术详解系列(二):AttnRes 与 Stable LatentMoE
Kimi K3技术详解系列(二):AttnRes 与 Stable LatentMoE
一个 93 层的模型,第 80 层还能不能”看到”第 10 层提取出来的特征?或者说,如果第 80 层就是想要一点早期的局部语法信息,它有没有办法”点名”要,而不是被动接受一层层加工后的混合液?
这一篇要回答的就是这种问题。上一篇解决的是时间轴上的事:很长的历史怎么压缩、怎么遗忘。这一篇换两个方向。深度方向问层与层之间:信息从浅层流到深层时,能不能让某一层自己挑”我要来自哪几层的输入”;宽度方向问专家与专家之间:专家数量涨到 896 个之后,怎么让每个 token 的花费还跟只有十几个专家时差不多。两个方向各自有一个主角——深度方向是 AttnRes(Attention Residuals,注意力残差),宽度方向是 Stable LatentMoE(稳定的潜在空间专家混合)。
动笔前先把两个背景概念说清楚,后面全程要反复用。Transformer 的一层由两块拼成:attention(注意力)负责在不同 token 之间交换信息,回答”当前这个词该看前文哪些词”;FFN(Feed-Forward Network,前馈网络)负责在单个 token 内部做一次非线性变换,不和其他位置发生关系。MoE(Mixture of Experts,专家混合)要改造的正是 FFN:把一整块 FFN 拆成多位”专家”(各自带独立参数的子网络),由一个 router(路由器,一个为每个 token 给所有专家打分的轻量网络)为每个 token 挑出少数几位来算。所有 token 都会经过的分支叫 shared experts(共享专家),由 router 按分数挑选的分支叫 routed experts(路由专家)。
系列目录
- Kimi K3技术详解系列(一):KDA 与 Hybrid Attention
- Kimi K3技术详解系列(二):AttnRes 与 Stable LatentMoE
- Kimi K3技术详解系列(三):训练与 Serving Infra
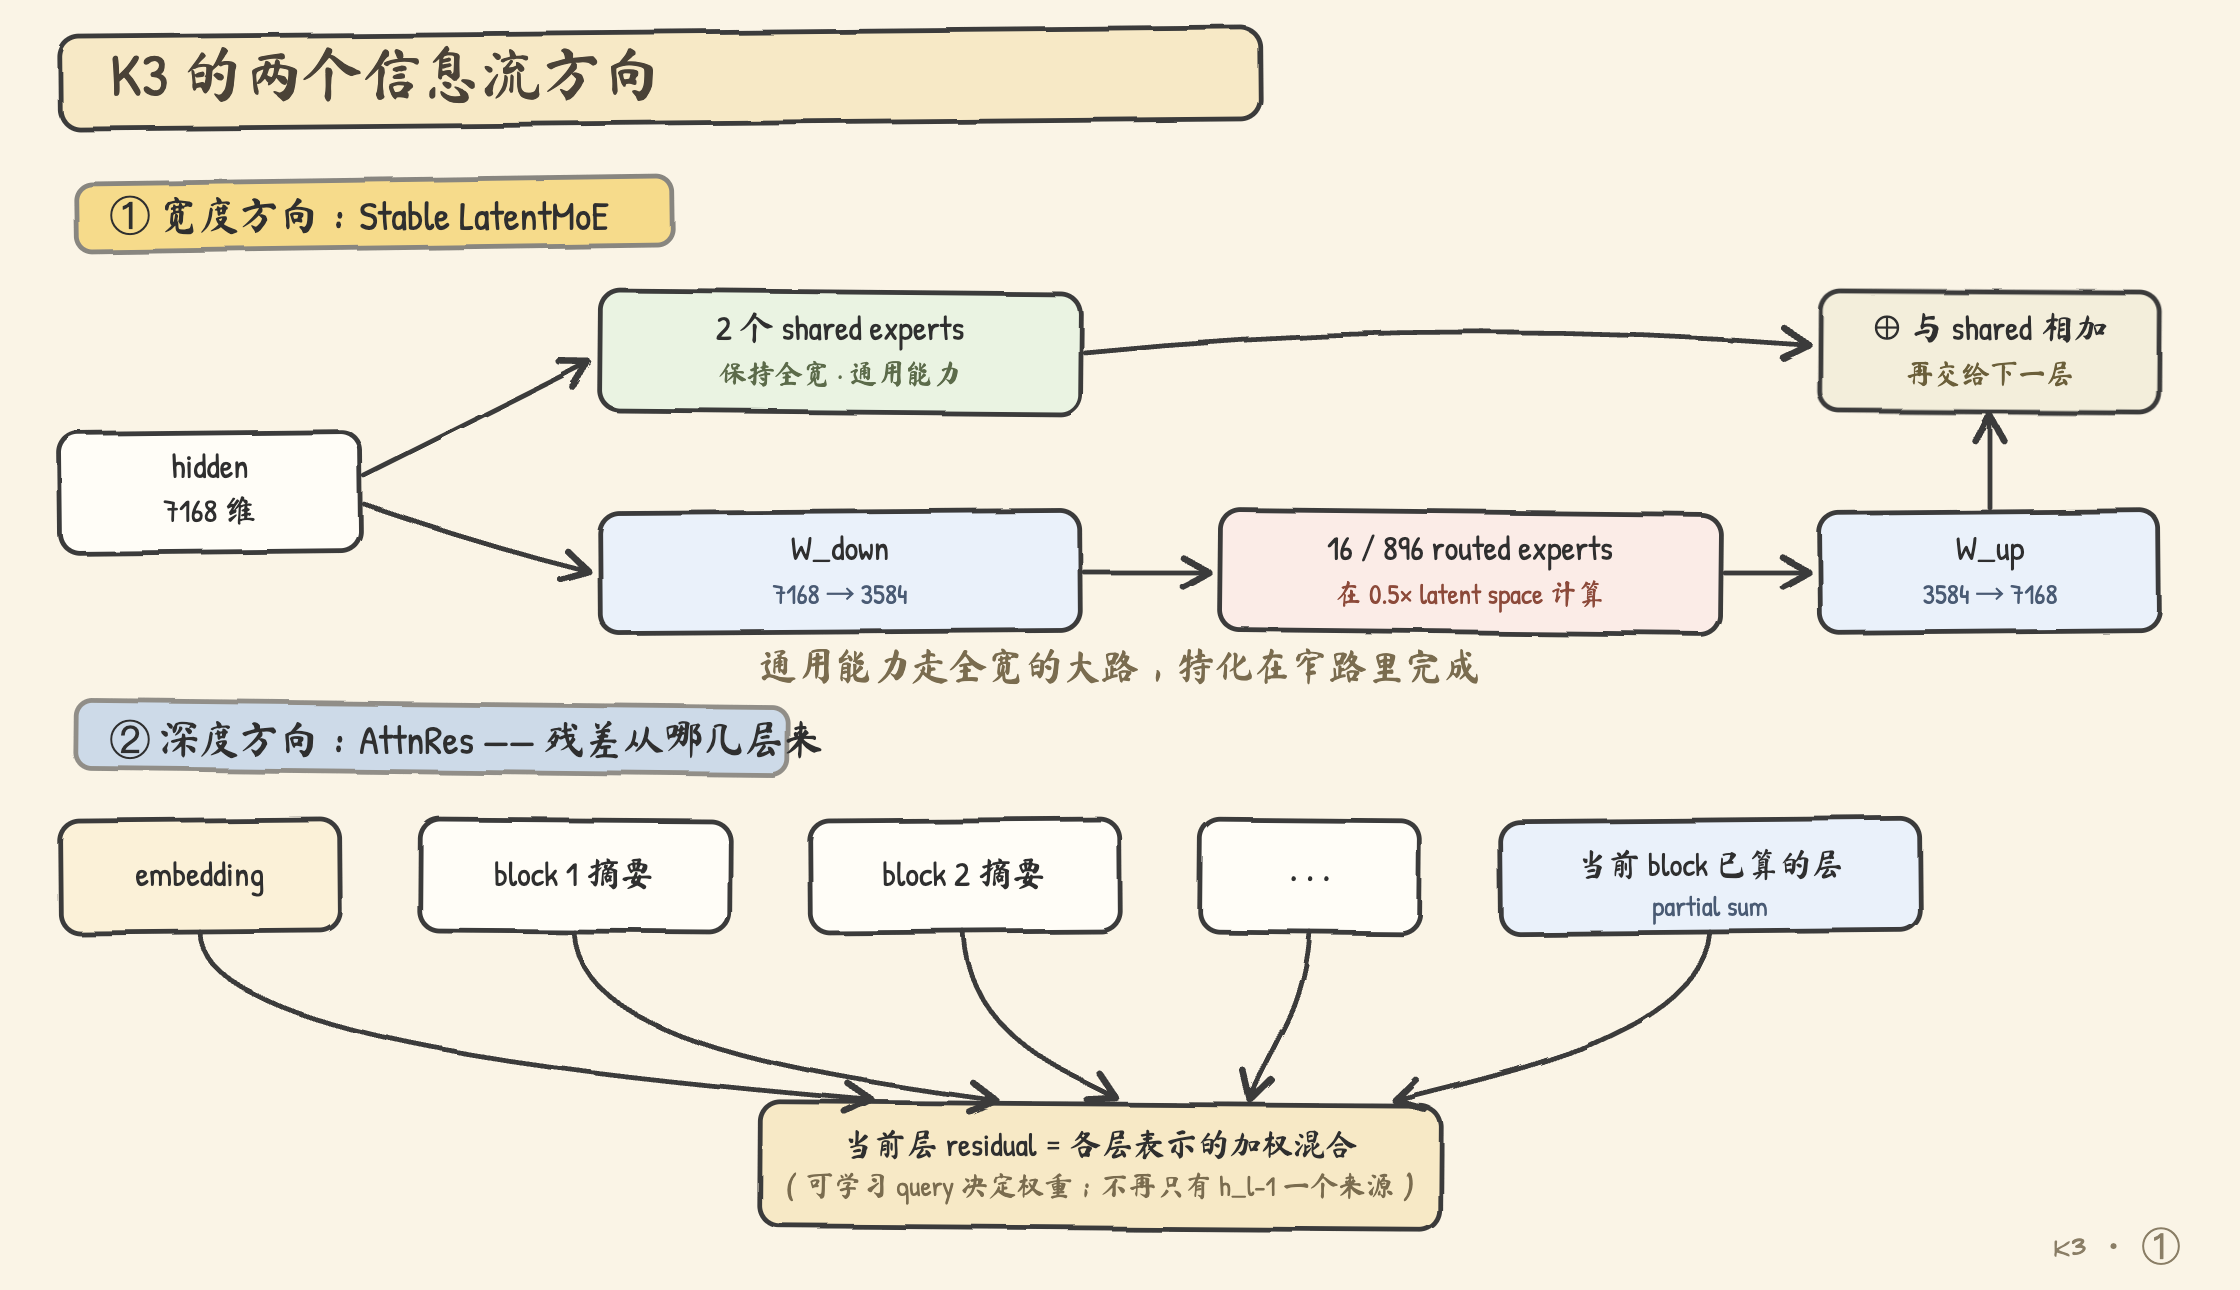
下面这张图先给个全貌:上半是宽度方向——full-width 的 shared experts 留住通用能力,routed experts 在较窄的 latent space 里做特化;下半是深度方向——当前层从 embedding、已完成 block 的摘要和当前 block 的已有结果里选来源。这一篇所有的公式和模块,都是围着这两条信息流转的。
1. 深度方向的默认残差有什么限制
标准 Transformer 每层通常做这样的事情:
\[h_l=h_{l-1}+F_l(h_{l-1})\]$h_{l-1}$ 是上一层的 hidden state(隐状态,即某一层输出的那条向量),$F_l$ 是第 $l$ 层的 attention 或 FFN 变换。这个”输入直接加到输出上”的结构叫残差连接(residual connection):它相当于给网络一个保底选项——就算这一层学歪了,输出也至少还是原来的输入,于是每一层只需要学”增量”。没有它,几十上百层叠起来,梯度和数值很容易在传递中消失或爆炸,这也是当年深层网络训不动的核心原因之一。
那么限制在哪?残差连接并没有”丢掉”更早层的信息,它会一路把它们带下来;问题在于,走到第 $l$ 层时,这些信息已经被压成了一份统一的 $h_{l-1}$。第 $l$ 层不能显式决定”这次多取一点第 10 层的特征、少取一点第 60 层的特征”,只能接受前面各层一路加工后的混合结果。
举个具体例子。假设一个 90 层模型的第 80 层需要某个早期层提取的局部语法特征。这个特征只能混在第 10 层到第 79 层的连续变换里一层层传过来,中间每一层都可能改变它。模型当然可以学着把信息藏在残差里偷偷传,但这条通路不是显式的”回到第 10 层查一下”——残差保证信息不丢,却保证不了信息可检索。
这听起来是不是很像第一篇里的 recurrent state?没错:信息没有消失,只是被压进一个不断更新的状态,你没法从里面”挑”出想要的那一份。Transformer 在时间方向用 attention 解决了”从历史 token 中选择”的问题;K3 的 AttnRes 把同一件事搬到深度方向,把”只接上一层”改成”从前面多个层级中检索”。深度方向上,也可以有检索。
2. AttnRes:把残差连接改成深度上的 attention
先只看一个 token 位置。假设当前是第 $l$ 层,这个位置在前面已经产生了 $l$ 个表示:
\[H_{<l}=[h_0,h_1,\ldots,h_{l-1}]\in\mathbb R^{l\times d}\]其中 $h_0$ 是 token embedding(词嵌入,token 进入网络第一层时的那条向量),$d$ 是 hidden dimension。AttnRes 为当前层准备一个可学习的 pseudo query(伪查询向量)$\bm w_l\in\mathbb R^d$,把前面所有模块的输出当作 key/value 来查。这里 attention 的”查询”不再是某个 token 的内容,而是一个固定的、为第 $l$ 层专属训练的向量——它回答的问题是”我这一层想要什么深度的信息”。因为 $\bm w_l$ 对第 $l$ 层是固定的,但每个 token 位置的 $H_{<l}$ 不同,所以最后的深度权重仍然会随 token 内容变化:
# H_prev: [l, d],前面 l 个层级的表示
# w_l: [d],第 l 层自己的可学习 query
keys = rmsnorm(H_prev)                 # [l, d]
weights = softmax(w_l @ keys.T, dim=-1) # [l]
residual = weights @ H_prev             # [d]
公式写出来是:
\[\bm a_l=\operatorname{softmax}\left(\bm w_l\,\operatorname{RMSNorm}(H_{<l})^\top\right), \qquad r_l=\bm a_lH_{<l}\]这里的 attention 没有发生在 token 之间,而是发生在层的深度轴上。它回答的不是”这个词该看前文哪个词”,而是”当前 token 送入第 $l$ 个模块时,哪一个处理深度的表示更适合作为残差信息”。注意这里 softmax 的作用:把任意一串分数变成一组非负、和为 1 的权重——分数高的层权重高,但谁也别想独吞。
为什么必须先做 RMSNorm(均方根归一化,把向量按自己的均方根长度缩放到单位尺度)?不同层的输出幅值可能差别很大。如果直接点积,某一层仅仅因为数值范数大,就可能在 softmax 中占据绝大多数权重,其他层辛辛苦苦算出来的内容全被淹没;RMSNorm 把比较重点放回方向和内容,而不是谁的向量更长。这跟第一篇里 KDA 每次更新前要给状态做归一化,是同一个道理:先统一个计量口径,再谈取舍。
2.1 用 4 层的例子走一遍
假设前面有 embedding、layer 1、layer 2、layer 3 四个表示,当前 layer 4 的 pseudo query 计算出:
attention over depth = [0.05, 0.10, 0.70, 0.15]
那么 layer 4 使用的 residual 不是 h_3,而是:
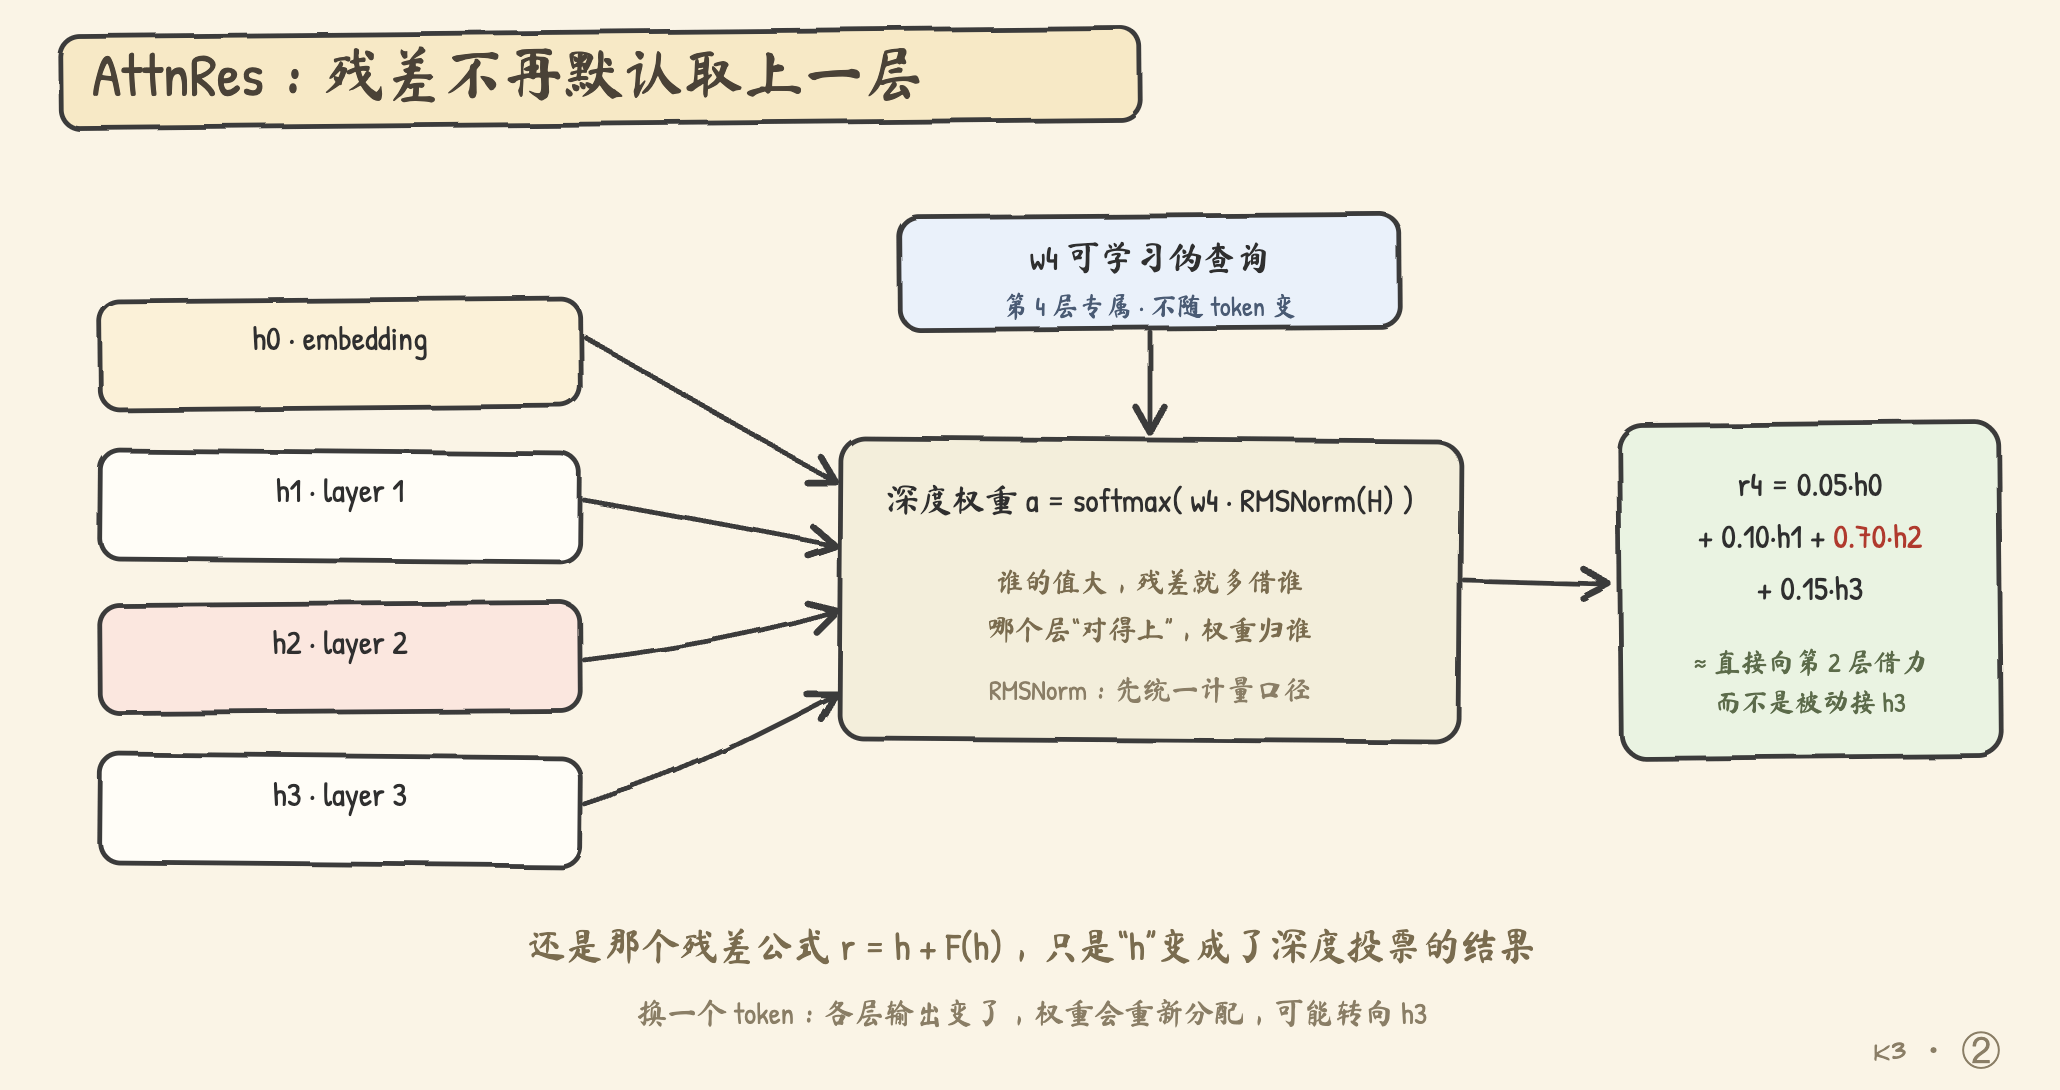
这意味着一件很关键的事:第 4 层不必把所有深度信息都塞进上一层状态里再硬传下来,它能直接复用第 2 层的表征——而第 2 层恰好在这次查询里最受青睐(权重 0.70)。换一个 token,前面各层的输出变了,即便 pseudo query 不变,权重也可能移向 $h_3$。和沿深度无差别累积相比,这多出来的是一种选择能力:网络学会了在什么情况下该向哪个深度借力。
3. 为什么 K3 使用 Block AttnRes
Full AttnRes(每一层都把前面所有层的输出完整存起来供检索)的算术量其实不算可怕——模型深度不到 100,多算几次点积而已。真正贵的是内存:为了让后面任意一层都能随时检索,每一层的输出都不能立刻释放。若有 $L$ 层、hidden dimension 为 $d$,持久保存和跨 pipeline stage(流水线阶段,即模型被切成几段分给不同 GPU 时,每段是一个 stage)传输的规模是 $O(Ld)$。这正好把”给深度更多选择”变成了一笔显存和通信账单。
K3 的解法不是随手每 12 层取一个点,而是把层分成 block:已完成的 block 用块内输出的和压成一个 block representation(块表示),相当于给这个 block 写了一份”摘要”;在当前 block 内部,还保留”到上一层为止”的 partial sum(部分和)。于是当前层既能看 embedding、以前各 block 的摘要,又因为当前 block 还没算完、看不到同 block 后面层的输出——这天然符合因果性。以 93 层为例,8 个约 12 层的 block 加 embedding,共约 9 个长期保存的来源,而不是 93 个。
embedding  ───────────────┐
layers 1-12  -> block 1 ──┤
layers 13-24 -> block 2 ──┤──> 当前层的 depth attention
...                       │
当前 block 已过的层 -> partial sum ─┘
这个近似的直觉是:同一个 block 内相邻层的表示往往比较接近,没必要每一层都单独留一个长期入口——就像一本书里同一小节的内容,不必每段都插书签;跨 block 的语义变化更大,才值得保留独立入口。论文的消融显示,约 8 个 block 就能拿到 Full 版本的大部分收益。
所以 Block AttnRes 的本质,是把”保留多个深度层级的可检索性”和”持久状态只保留约 9 份”放进同一个折中里:多层的可检索性接近满血,内存开销却降了一个数量级。
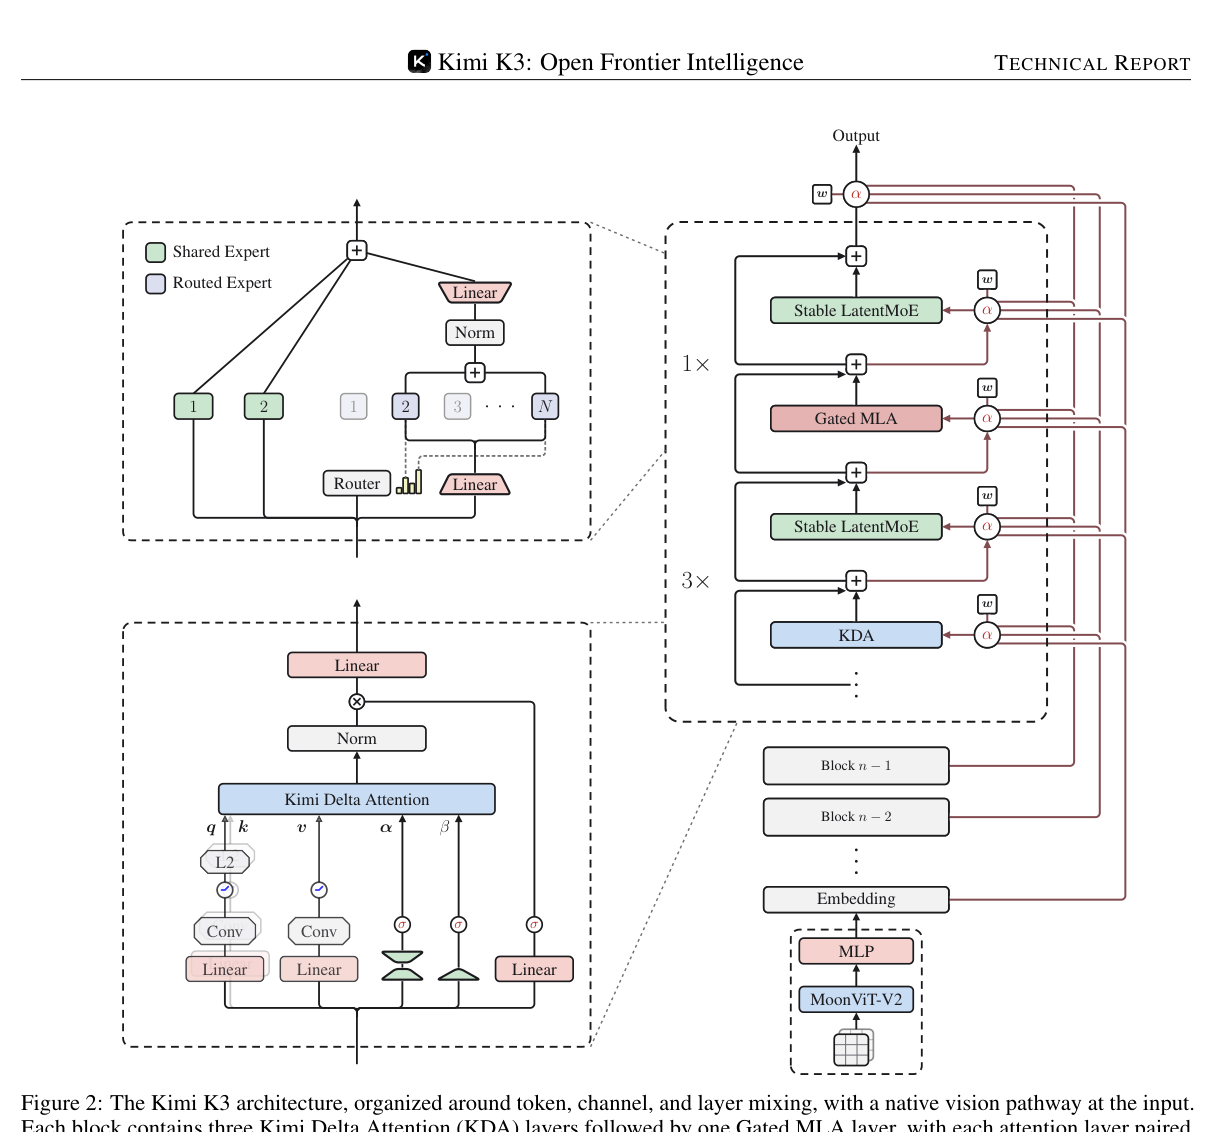
上图把 K3 的三个方向放在一起:token mixing(token 之间的混合)对应 KDA/MLA,layer mixing(层之间的混合)对应 AttnRes,channel mixing(通道之间的混合)对应 MoE。接下来进入宽度方向。
4. 896 个专家为什么要先进入 latent space
MoE 的目标是扩大”可选的计算分支数”:总参数可以很大,但单个 token 只激活少数专家——好比一个巨型医院,全科医生都配齐了,但每位病人只看对应的几个科室。
K3 使用 896 个 routed expert,每个 token 选择 16 个(即从 router 给出的 896 个分数里取最高的 16 个,行话叫 Top-16),另有 2 个所有 token 都经过的 shared expert。问题在于,选择 16 个专家不代表只多算 16 次小函数:若每个 routed expert 都在 7168 维 hidden space 里做完整 FFN,权重容量、token dispatch(把 token 的表示分发到它选中的专家那里)的通信量和专家侧矩阵乘都会按全宽放大。896 位专家各存一份 7168 维的权重,光参数规模就吃不消。
K3 让 routed 分支先把输入从 7168 维压到 3584 维 latent space(潜在空间,一个更窄的中间表示空间),在较窄的空间里完成专家计算,再投影回 7168 维:
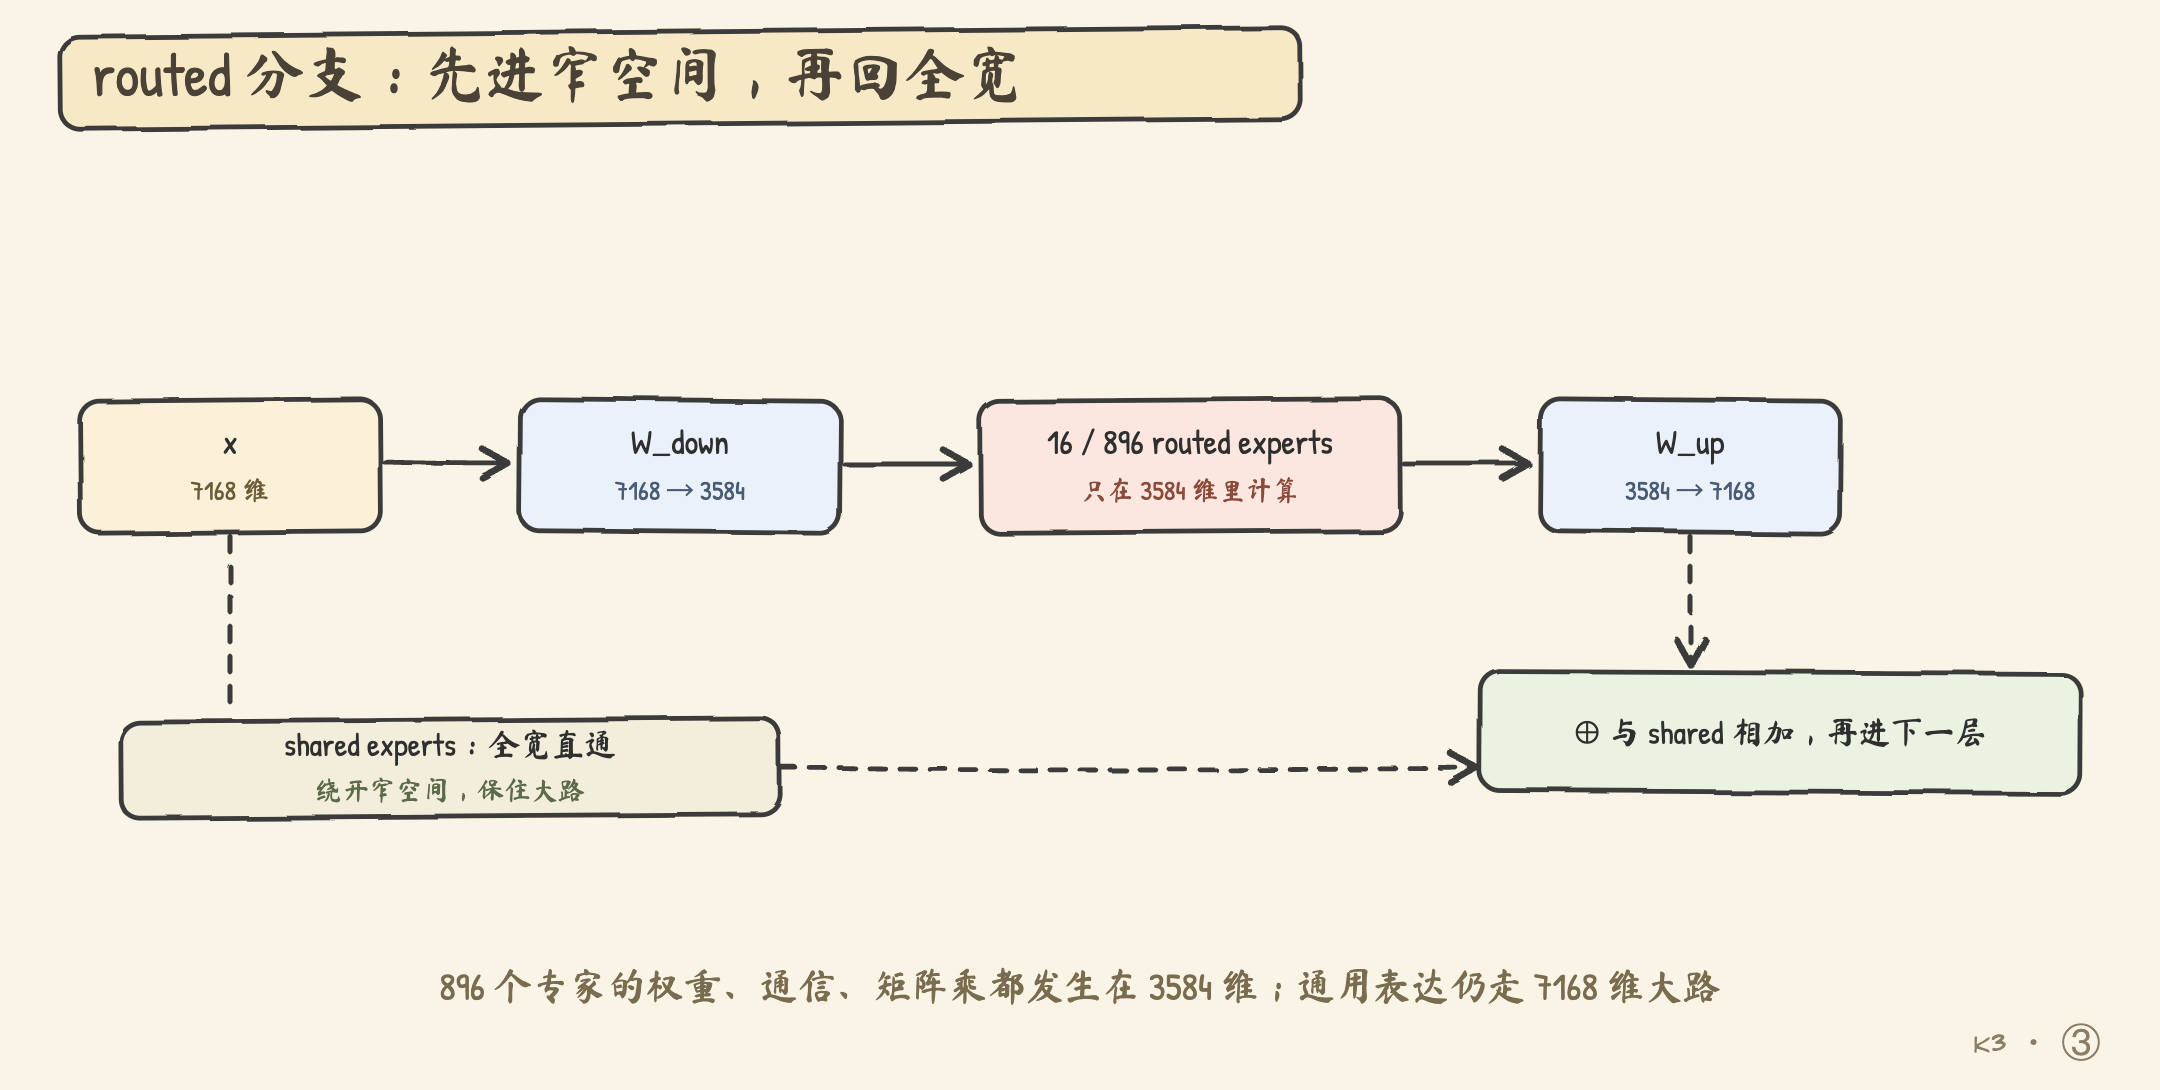
如果所有路径都必须先压到 3584 维,就会出现一个新问题:所有通用计算都要经过一个低维瓶颈,表达能力被卡住。所以 shared experts 保留 full-width 的公共通路,routed experts 只在 latent space 提供稀疏特化——通用的事走大路,专精的事钻小路。于是 896 个专家的成本落在窄空间里,通用信息仍有不经压缩的路径。
5. 激活为什么会爆:先看 routed 分支的乘法链
一条 routed 分支要依次经过 down projection(降维投影)、专家内部的 GLU、16 个专家的加权聚合和 up projection(升维投影),再与 shared 分支相加。这里先解释一下 GLU(Gated Linear Unit,门控线性单元):它是一种经典激活结构,用一个分支的输出当”门”去乘另一个分支,让网络自己决定每个维度放行多少信息;SwiGLU 则是用 Swish 激活函数做门的那一版,也是今天大模型的默认选择。
回到正题。这条链路不是普通 FFN 里一次矩阵乘之后的小波动:前一段的异常幅值会成为后一段矩阵乘的输入,16 个分支的尺度差异又会在聚合时叠加(有的专家输出大、有的小,加在一起就像把高低不齐的砖头摞成一堵墙)。在 2.8T 参数规模和低精度训练下,这条乘法链比”某一层输出略大”危险得多——它的危险在于每一次放大都叠在别人的放大之上。
K3 的第一道保险,是在 routed experts 聚合之后、up projection 之前加一层 RMSNorm:
\[u=\sum_{i\in\mathrm{TopK}}p_iE_i(W_{down}x), \qquad y=W_{up}\operatorname{RMSNorm}(u)+y_{shared}\]它不改变 token 选择哪个专家,也不把专家输出变成同一个方向(归一化只调幅值、不动方向);它只在进入最容易放大幅值的 $W_{up}$ 之前,把 16 个专家聚合后的 scale 拉回可控范围。这里的 RMSNorm 是为 latent 路径带来的尺度波动配的一道闸门。
第二道保险是把 SwiGLU 换成 SiTU-GLU。SwiGLU 的两个分支在大输入上没有硬上限,低精度训练时更容易产生极端值。SiTU-GLU 给两个分支加 soft cap(软上限,即让输出平滑地逼近一个上界,而不是被硬生生截断):
\[f(x)=\left[\beta_1\tanh(W_gx/\beta_1)\odot\sigma(W_gx)\right] \odot\left[\beta_2\tanh(W_ux/\beta_2)\right]\]K3 取 $\beta_1=4$、$\beta_2=25$。为什么这样设?在输入接近 0 时,tanh 近似线性,函数仍像 SwiGLU 一样工作,正常区域的表达能力几乎没有被改写;输入很大时,每个分支会平滑封顶,输出幅值上界约为 $\beta_1\beta_2=100$——极端激活最多被压到 100,而不是跟着指数一起冲上天。
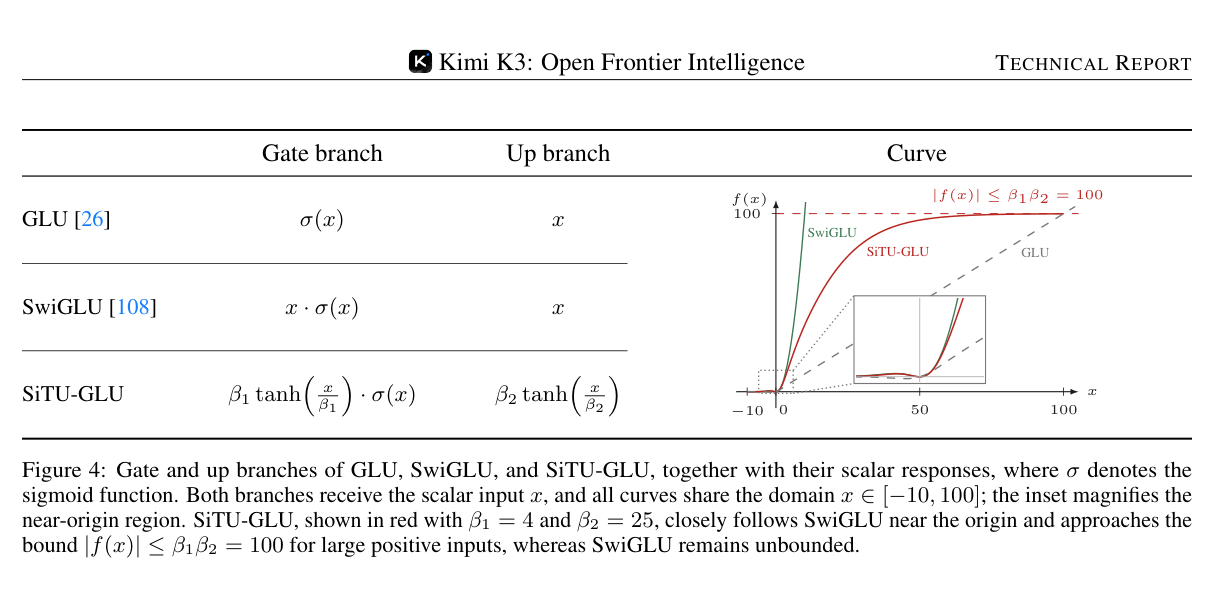
看图时重点看两段:原点附近红色 SiTU-GLU 跟 SwiGLU 几乎重合,说明普通输入区域的行为没被破坏;大输入区域红线逐渐压平,说明低精度路径不会任由异常激活继续放大。一道闸门管聚合后的尺度,一个软上限管极端输入,两道保险合起来,才敢说这 896 个专家在低精度下是”稳定”的——这也是 Stable LatentMoE 里 Stable 这个词的来历。
6. 896 个专家为什么会负载不均
即使激活稳定了,router 还有另一个独立问题:它可能反复把 token 送到少数热门专家。假设一个 batch 有 8 个 token、4 个专家,每个 token 只选 1 个,朴素 Top-1 可能得到负载:
expert 1: 4 tokens
expert 2: 3 tokens
expert 3: 1 token
expert 4: 0 token
在专家并行(Expert Parallelism,EP,即把不同专家放到不同 GPU 上,token 通过通信送到对应专家的组织方式)中,专家 1 所在的 GPU 要处理 4 个 token,专家 4 所在的 GPU 没活干;整个 batch 的时间由最忙的 GPU 决定。专家数量越多,少量偏差更容易把某些专家推成”过热”(被抢破头)或”濒死”(长期接不到活,越训越废)——315 号窗口排起了长队,316 号窗口却一个病人都没有。
过去常见的做法是加 auxiliary loss(辅助损失,在训练目标之外额外加一项,专门惩罚路由不均衡);后来流行的 auxiliary-loss-free 路由(无辅助损失路由)则走另一条路:为每个专家维护一个 bias(偏置,一个可训练的标量),热门专家减一点、冷门专家加一点,让分数往均衡的方向挪。后者虽然避免了额外损失项,却要在”每步太小,调不过来”和”每步太大,来回震荡”之间反复调步长。
K3 注意到一件事:一次 router 前向其实已经给出了更直接的信息——每个 token 要让某个专家进入 Top-k,究竟还差多少分。 与其猜步长,不如直接算账。这就是下一节的 Quantile Balancing。
7. Quantile Balancing:从门槛直接反推 bias
令 $s_{i,j}$ 是 token $i$ 对专家 $j$ 的原始 router 分数。K3 用 bias 只调 Top-k 的选择,而不把 bias 混入最终专家权重——也就是说,bias 只决定”谁能进决赛”,决赛里的权重混合比例还是由原始分数决定,bias 是调度旋钮,不会直接篡改已选专家之间的混合比例。
对 token $i$,在当前带 bias 的分数中取第 $k+1$ 大值 $\alpha_i$。它就是”进入这个 token 的 Top-k 必须跨过的门槛”(cutoff)。下一步若给专家 $j$ 候选 bias $b_j$,它能进入 Top-k,当且仅当:
\[s_{i,j}+b_j>\alpha_i\]移项以后:
\[b_j>\alpha_i-s_{i,j}\]换句话说,$s_{i,j}-\alpha_i$ 表示专家 $j$ 相对 token $i$ 门槛的余量(headroom):正数说明已经够格,负数说明还差一点。若一个 batch 有 $m$ 个 token、$n$ 个专家、每个 token 选 $k$ 个,理想平均负载是 $q=mk/n$。我们不需要猜一个小步长,只需把 $b_j$ 设到恰好让 $q$ 个 token 跨过门槛的位置,也就是余量分布的相应分位点(quantile,把余量从小到大排队后,取第 $q/m$ 百分位处的那个值):
# s: [m, n],m 个 token 对 n 个专家的原始 router 分数
# alpha: [m],当前带 bias 的 Top-(k+1) cutoff
headroom = s - alpha[:, None]
b_hat = -torch.quantile(headroom, q=1 - k / n, dim=0)
b = b_hat - b_hat.mean()
为什么最后要减均值?给所有专家 bias 同时加上同一个常数,不会改变任何 token 的 Top-k 排序;减掉均值只是去掉这个无意义的公共偏移,让 bias 保持在 0 附近。
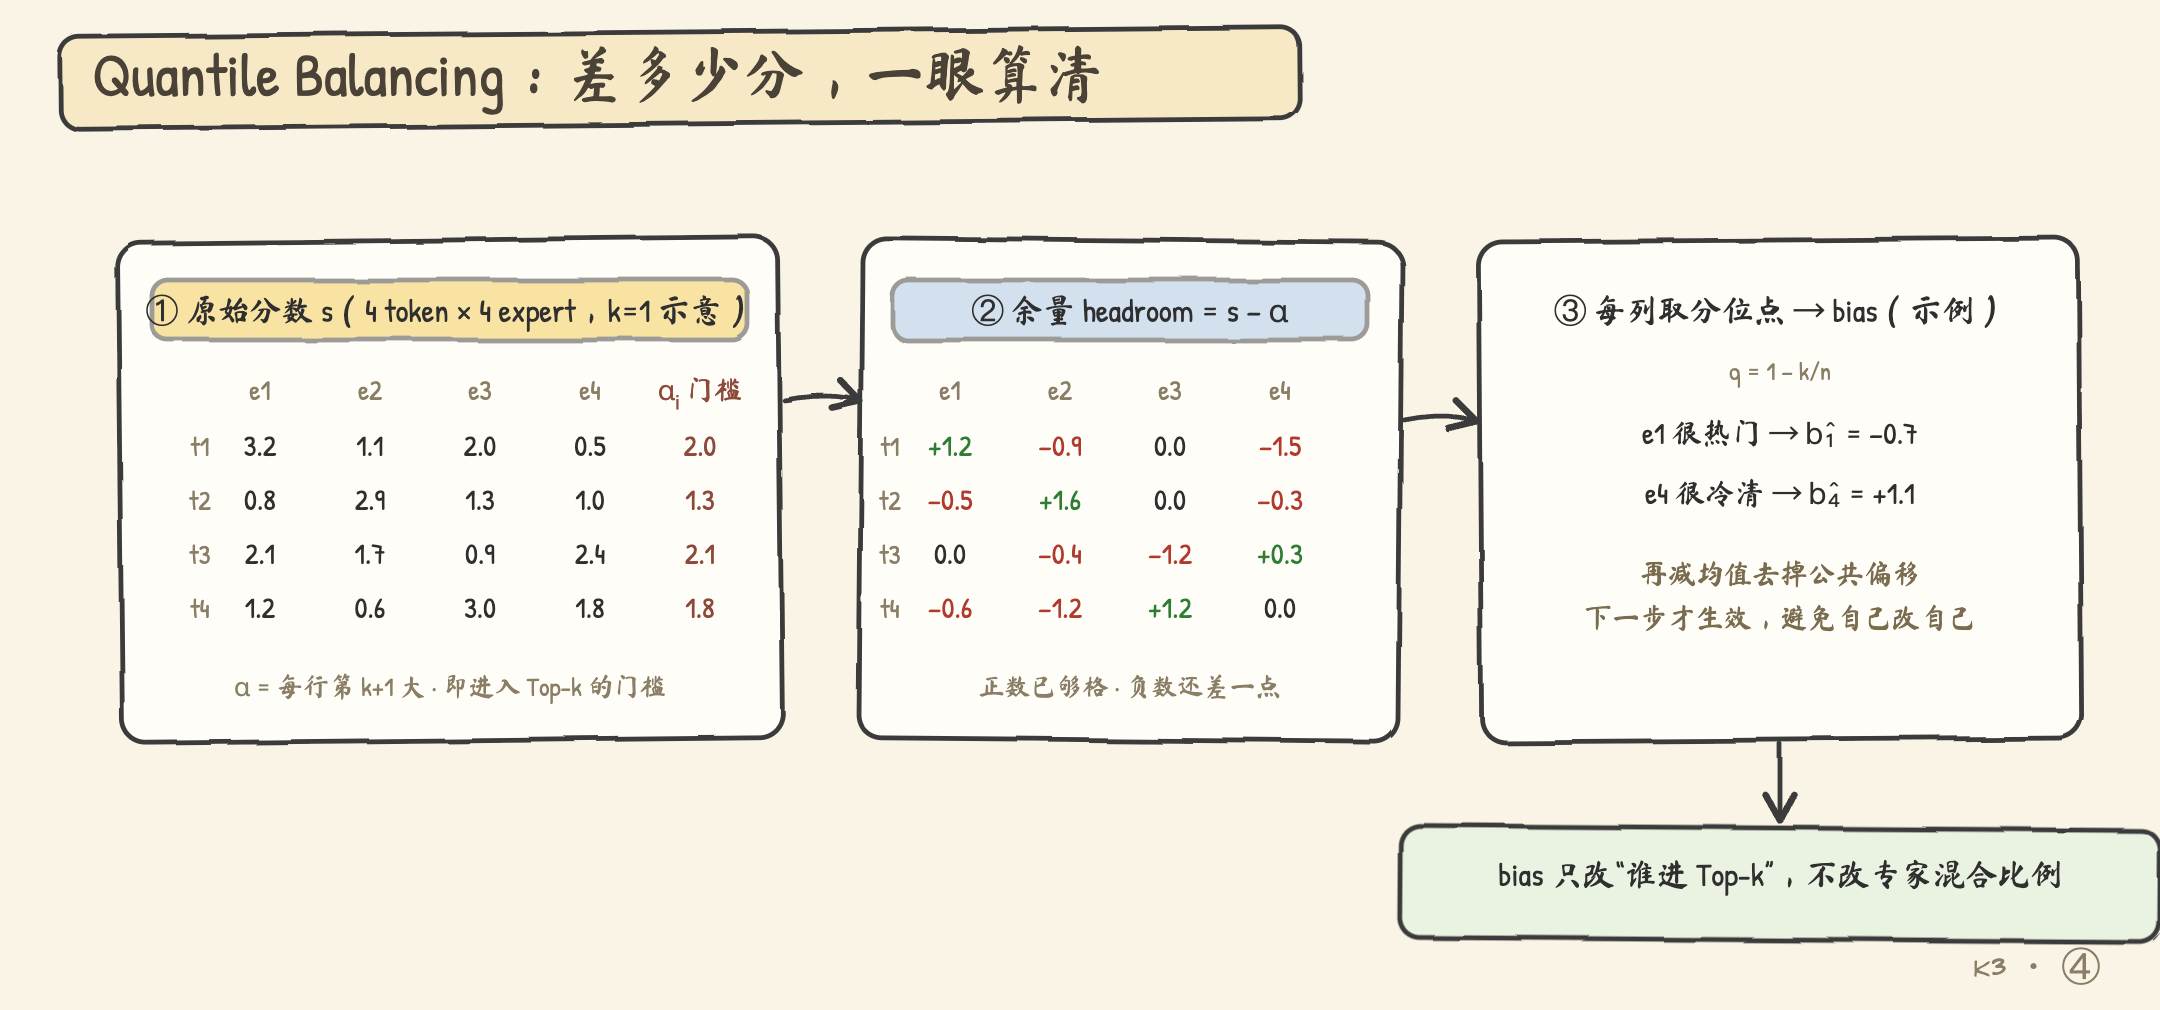
以 8 token、4 expert、$k=1$ 为例,目标负载是 $q=8\times1/4=2$。Quantile Balancing 不是让 bias 每轮只移动一点,而是根据当前余量分布直接估计一个能让每个专家接近 2 个 token 的 bias;为避免同一 batch 用自己算出的 bias 重新路由(自己给自己出难题),它在下一步才生效。
实际训练中,K3 不会把百万级余量全部 gather 到一张卡上——那样通信量就白省了——而是每张卡先统计每个专家的 1000-bin 直方图(bin 即直方图的柱),再 all-reduce(把所有卡上的整数计数汇总相加)合并,最后从合并直方图近似读取分位点。通信量从”所有浮点余量”降到”每个专家固定数量的 bin”,误差约为 bin 宽度级别——用一点点近似,换掉一整轮全量通信。
8. 为什么 K3 的宽度设计要和稳定性绑在一起
把 routed experts 放进 0.5× latent space,并不是单纯为了少算一半矩阵。它同时降低了:
- 896 个专家各自保存 FFN 权重的成本;
- token dispatch 到专家后的矩阵乘规模;
- 多专家聚合后传回全宽 hidden space 的压力。
但压缩宽度以后,shared expert、RMSNorm 和 SiTU-GLU 就变成了必要的稳定性配套:没有它们,窄空间里聚合出来的异常尺度会一路放大到输出;专家数量变多以后,Quantile Balancing 又承担了把计算量分回各个 rank 的职责。latent space、激活 soft cap、路由 bias 不是三个互不相关的小技巧,而是同一个”超大稀疏 FFN 如何可训练、可并行”的问题的不同答案。 这大概也是本篇把 AttnRes 和 Stable LatentMoE 放在一起的原因——深度可检索、宽度可训练,两条腿缺一不可。
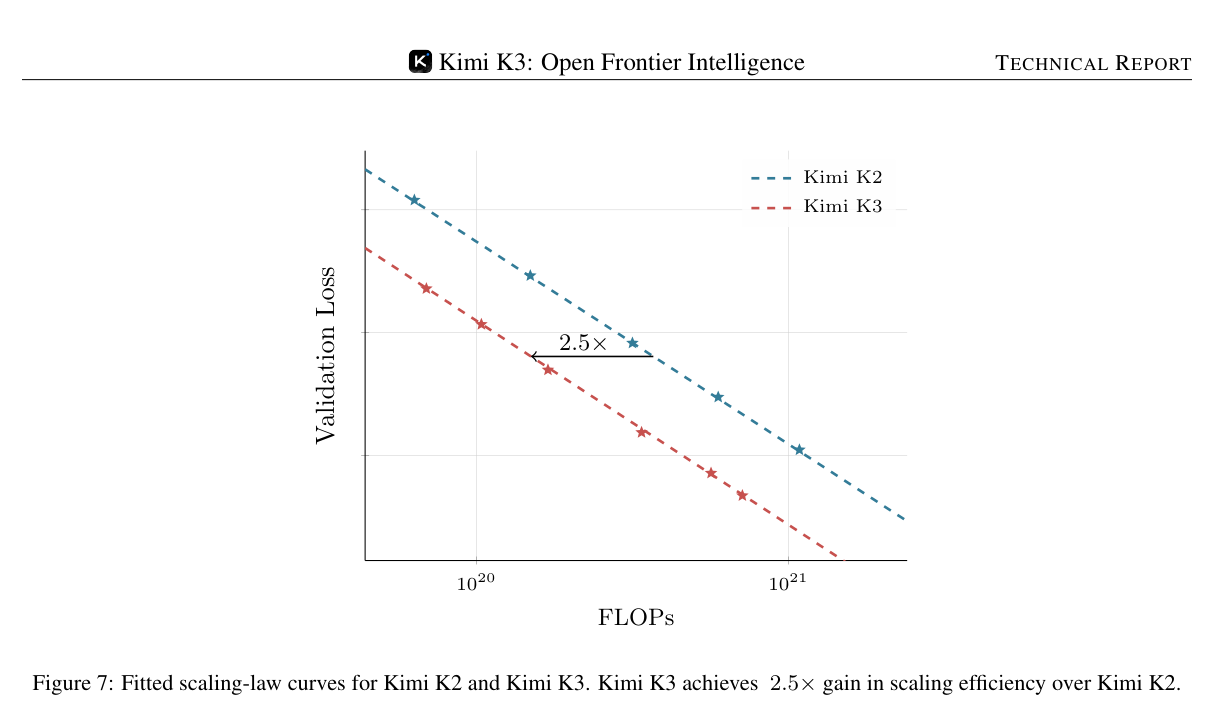
论文的 scaling law(缩放定律,指模型性能随计算量、参数、数据规模变化呈现的规律性关系)图报告 K3 相比 K2 约 2.5× 的 scaling efficiency(缩放效率)提升。这里要强调一句:scaling efficiency 是在相同训练损失或能力目标下所需计算量的拟合比较,不等同于单个 kernel 的 2.5× 加速;它包含架构、训练配方和系统效率的共同影响。
9. 小结
这一篇可以这样记:
- 标准残差只把上一层送给下一层,AttnRes 把”从前面哪些层取信息”变成了可学习的 depth attention(深度注意力);
- Full AttnRes 要保存所有层的输出做检索,Block AttnRes 用约 8 个 block 摘要就保留了大部分效果;
- 896 个 routed experts 如果都在全宽空间运行,参数和通信都太贵,因此先进入 0.5× latent space;
- 进了窄空间就要配稳定性:shared expert 保住全宽通路,RMSNorm 管聚合后的尺度,SiTU-GLU 用软上限管极端激活;
- Quantile Balancing 从第 $k+1$ 个分数提供的门槛反推 bias,让负载均衡从”小步试错”变成”按余量分布直接估计”,而且只花直方图那么点通信量。
下一篇进入系统部分:MoonEP 如何让专家并行的 token 数固定,KDA 的状态如何跨卡传递,1M context 的 Agentic RL 和 prefix cache 又为什么需要重新设计。
扯一句题外话:打个广告,《动手学 AutoML:从 NAS 到大语言模型优化实战》系统地介绍了如何自动化地设计、搜索和压缩模型架构,结合最新的 attention 设计范式,可以让 AI 自动搜出更高效的结构,感兴趣的同学可以看看我们的这本书。
