Kimi K3技术详解系列(三):训练与 Serving Infra
Kimi K3技术详解系列(三):训练与 Serving Infra
一个 2.8T 参数的模型,训练时卡怎么分、状态怎么存、一条 1M token 的请求来了怎么恢复,这些问题不会因为”模型效果好”就自动消失——恰恰相反,架构每改一处,系统就得跟着还一笔债。
这是 Kimi K3 系列的第三篇。前两篇分别讲了 KDA/Hybrid Attention,以及 AttnRes/Stable LatentMoE。本篇不把它们当作几个可以独立替换的层,而是顺着一个问题看:结构变了以后,训练和 serving(在线服务,即模型部署后对外提供推理请求的环节)原先默认的”数据怎么分、状态怎么存、请求怎么恢复”,为什么都要改。
系列目录
- Kimi K3技术详解系列(一):KDA 与 Hybrid Attention
- Kimi K3技术详解系列(二):AttnRes 与 Stable LatentMoE
- Kimi K3技术详解系列(三):训练与 Serving Infra
1. 先分清:每种并行究竟在切什么
训练 2.8T 参数模型时,单卡肯定放不下,因此必须把不同维度的工作切到多张 GPU。这里的几个缩写容易一起出现、互相打架,但它们各自切的是不同对象,先分清再谈别的:
- TP(Tensor Parallelism,张量并行):把一个矩阵切到多张卡,每张卡算一部分列或行——单个矩阵太大,一张卡算不完;
- EP(Expert Parallelism,专家并行):不同 GPU 保存不同的 MoE experts,token 通过通信送到对应专家——专家太多,一张卡存不下;
- PP(Pipeline Parallelism,流水线并行):把连续的模型层切成多个 stage,数据像流水线一样经过这些 stage——层数太深,一张卡塞不下;
- DP(Data Parallelism,数据并行):每张卡或每组卡保存模型副本,处理不同 batch,再同步梯度——模型不大但数据多时,用多份副本并行吃数据;
- CP(Context Parallelism,上下文并行):把一条很长的序列切给不同 GPU,各卡负责不同的上下文片段——单条序列太长,一张卡装不下。
K3 把这些方式组合起来,再加上 ZeRO(Zero Redundancy Optimizer,把 optimizer state、梯度等按维度分片保存,消除冗余)和 offload(把暂时不用的状态搬到 GPU 外,如 CPU 内存或 NVMe 硬盘)。这里要强调一句:这不是”并行方式越多越先进”——TP 解决单个矩阵太大,EP 解决专家太多,PP 解决层数太深,CP 解决序列太长,每一种并行都是针对一个具体瓶颈的”补丁”。下面的 MoonEP、KCP 和 cache 机制,分别是在 EP、CP 和请求生命周期上处理这些切分留下的后果。
2. MoonEP:为什么专家并行最怕动态负载
2.1 一个 batch 就能制造负载倾斜
假设有 4 个 experts,8 个 token,每个 token 只选 1 个。一次 router 可能给出:
expert 1: 4 tokens
expert 2: 3 tokens
expert 3: 1 token
expert 4: 0 token
如果 4 个 expert 分别放在 4 张 GPU 上,GPU 1 要处理 4 个 token,GPU 4 没有工作;即使 GPU 2、3 算完了,整个 batch 也要等 GPU 1。专家并行的吞吐由最忙的 rank(参与训练的 GPU 进程编号)决定——就像排队结账,收银台再多,队伍最长的那条决定了你的等待时间。
通常 token 会先通过 all-to-all(一种集合通信:每张卡把发给其他卡的数据直接送到对方,同时接收别人发给自己的数据)发送到目标专家所在的 GPU,再做 grouped GEMM(把不同专家的 token 合并成一批矩阵乘法,按专家分组计算)。如果每步的 token 数不稳定,通信 buffer 和矩阵乘法的形状也跟着变,host-device 同步(GPU 计算完成后的显式同步点)和动态 kernel launch(运行时才确定形状、临时启动计算内核)会进一步拖慢训练。
2.2 MoonEP 的思路:先规划,再迁移专家
MoonEP 是 K3 报告中的专家并行方案。router 的选择不变,但系统可以把热门 expert 的冗余副本临时放到其他 rank,让原本都要找同一位专家的 token 分流处理。目标不是”平均差不多”,而是让每个 EP rank 在一层恰好接收 $S\times K$ 个 token,其中 $S$ 是该 rank 的序列 token 数,$K$ 是每个 token 选择的专家数。
这个固定数量带来两个系统收益:
- 每个 rank 的矩阵乘形状在编译或计划阶段就知道,不需要等 GPU 统计完 token 数再决定下一步;
- 通信 buffer 可以按 $S\times K$ 预分配,而不用按最坏情况扩成 $S\times K\times R$,其中 $R$ 是 EP rank 数——buffer 从”最坏情况”降为”精确大小”,省下的不只是内存,还有反复分配释放的开销。
一次执行可以按四步理解,下图是这四步的手绘版:
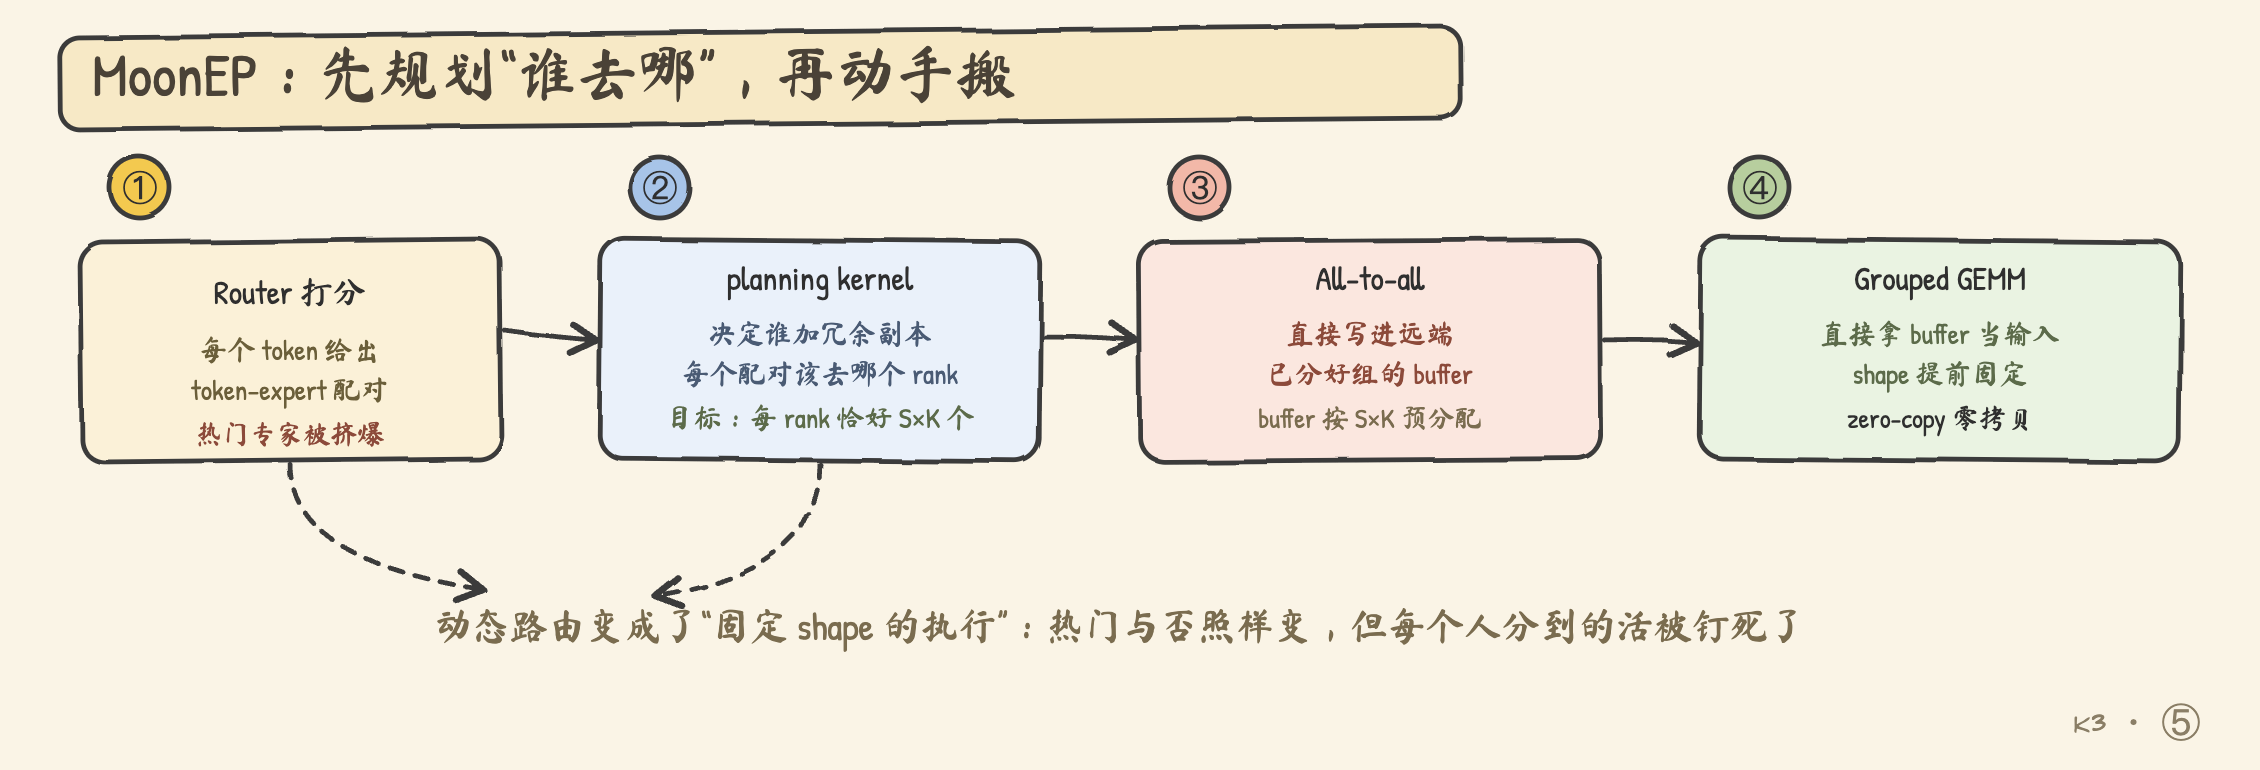
router 先给出 token-expert 配对;planning kernel(规划内核)决定哪些热门 expert 要有冗余副本、每个配对该去哪个 rank;all-to-all 把 token 直接写进远端已经按专家分组的位置;随后 grouped GEMM 直接把这个 buffer 当输入。最后一步不再重排一次,这就是 zero-copy(零拷贝)所说的”通信 buffer 直接作为计算 buffer”——数据搬到位就开算,中间不折腾第二遍。
论文还给出一个冗余槽位的存在性结论:只要每个 rank 预留约 $E/R$ 个冗余 expert 槽位($E$ 为 expert 数,$R$ 为 rank 数),就能找到满足均衡的专家迁移方案。这个 bound 说明”总能找到方案“是有保证的,但真实收益仍取决于迁移成本、expert locality(专家在物理上的局部性)和通信拓扑。
2.3 为什么固定 shape 对大模型很重要
在小模型里,多一次同步可能只是一点微秒;在 93 层、数万步的训练里,微秒会乘上层数、pipeline stage 和训练步数。传统 EP 里,每个专家实际收到多少 token 要等 router 在 GPU 上跑完才知道,host 因而要等 shape 再发起后续计算,中间那段空等会随着训练步数被无限放大。MoonEP 把每个 rank 的总 token 数固定后,通信 buffer、矩阵乘形状和内核调度都可以提前确定,CUDA Graph(把一串内核启动录制下来、以后一次回放的加速技术)也更容易复用。
所以 MoonEP 的价值不只在负载均衡公式,而在于把”动态路由问题”变成”固定 shape 的执行问题”:专家是否热门仍然会变化,但每个 rank 最终接收多少 token 被系统约束住了——变化的是”谁在忙”,不变的”每个人分到多少活”。
3. MoonEP 解决时间,显存策略解决容量
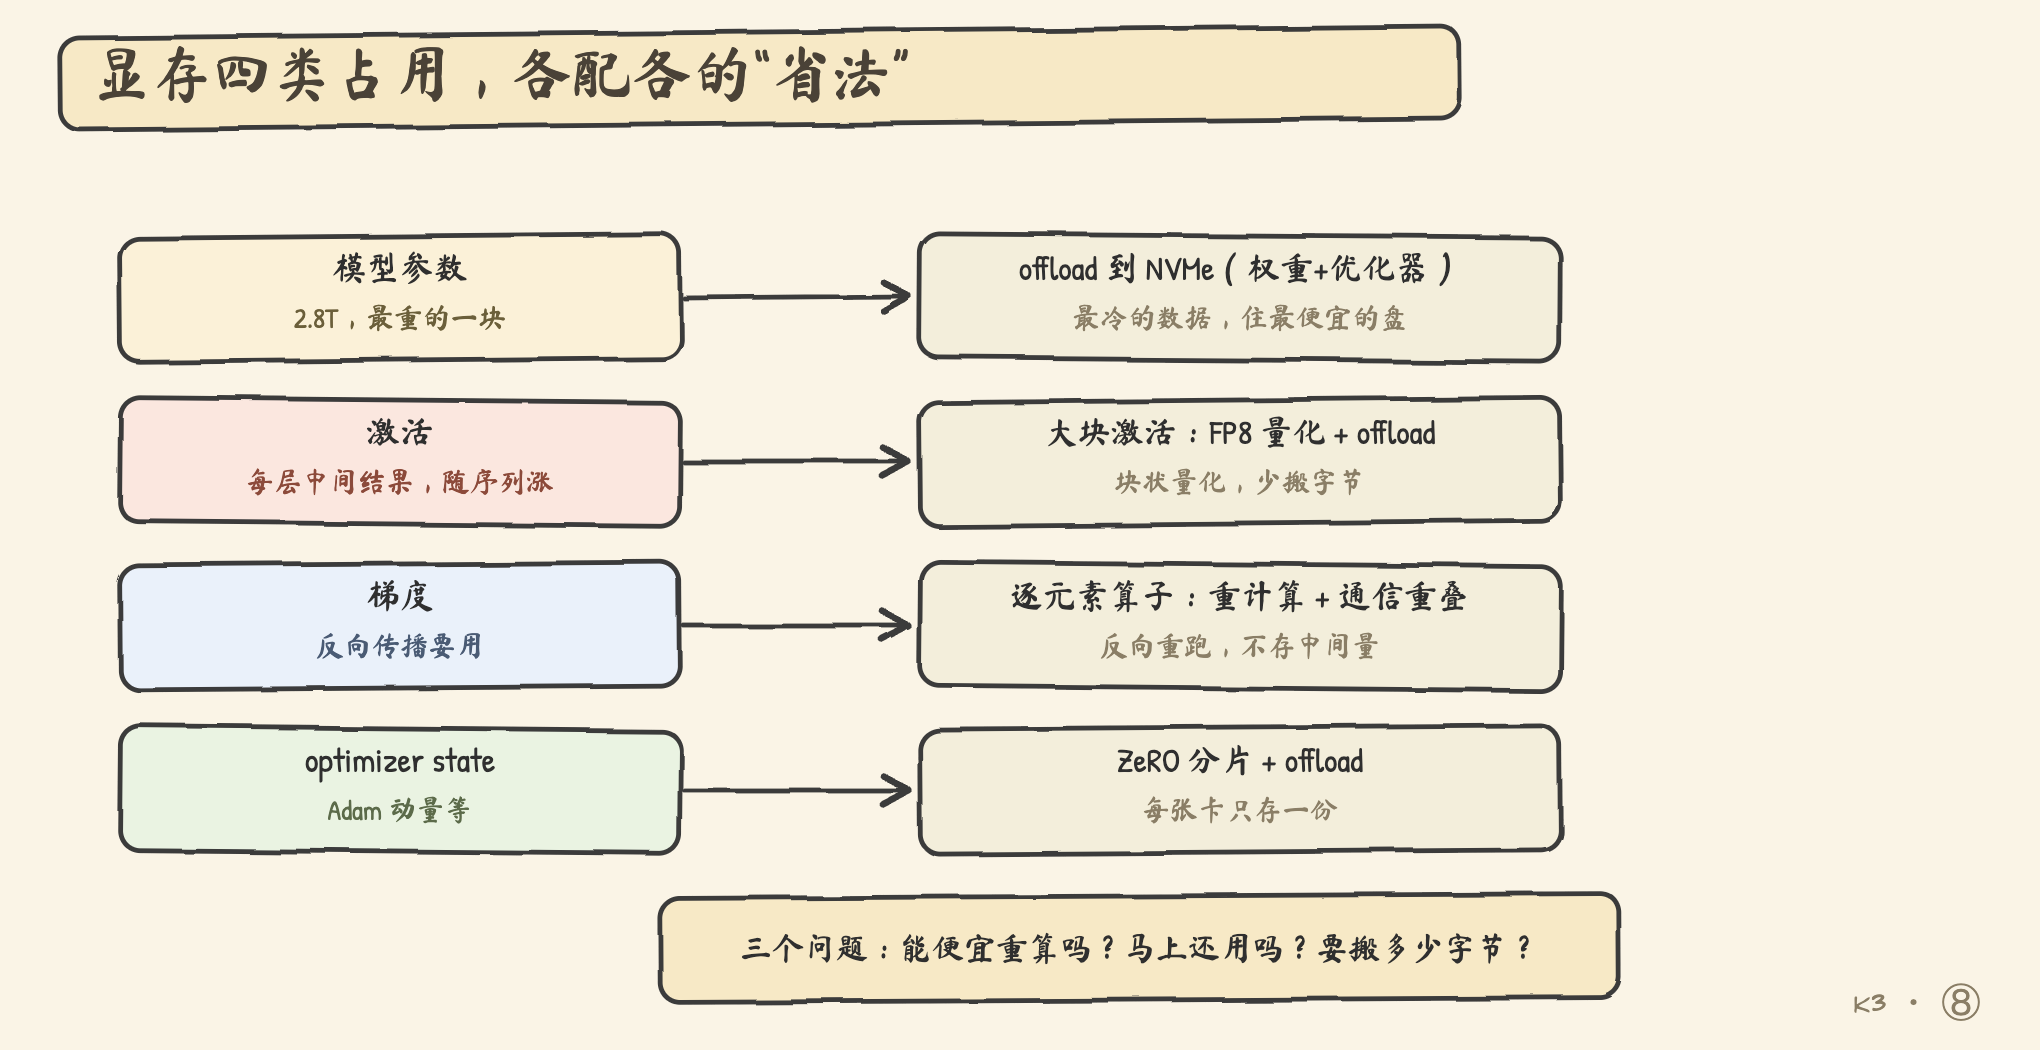
MoonEP 让卡不再互相等,但不会让模型本身少占一字节。训练时显存通常被四类东西占满:模型参数、激活(每一层计算产生的中间结果)、梯度、optimizer state(优化器状态,如 Adam 的一二阶动量)。K3 的做法不是给所有 tensor 规定同一种存储方式,而是按三个问题分别决定:反向时能否便宜重算?是否马上还会用?搬运多少字节? 答案组合起来,就是下面四种策略的取舍:
3.1 激活:用重计算换空间
如果保存每层所有中间激活,反向传播时可以直接读取,但显存随层数和序列长度增长。重计算(recomputation,也叫 checkpointing,只保存关键检查点,反向时重新跑一小段前向)则用额外计算换掉激活存储——多花一次前向的时间,省下一整层的显存。
K3 对大块激活使用 block-wise FP8 量化(把激活按块转成 8 位浮点,块越小误差越小,块越大越省)再 offload,对逐元素算子更多采用重计算。量化减少传输字节数,重计算减少需要传输的 tensor 数量,两者针对的是不同的成本:一个省”搬运的斤两”,一个省”要搬的件数”。
3.2 MoE 反向:不要保存完整 dispatch 中间量
MoE 前向要把 token 按 expert 重新排列,得到 dispatch buffer;反向如果把所有排列后的中间激活完整保存,显存和通信都很可观。K3 利用梯度表达式,只保存必要的 dispatch 输入,反向时重算排列和 GEMM,并与通信流水线重叠——反向的路,前向重走一遍,但只走必要的几段。
3.3 AttnRes 并不一定让显存线性增加
Full AttnRes 确实需要保留多层表示,但 K3 使用 Block AttnRes(见系列二)。一个 block 内的输出先汇总,后续层只访问少量 block 表示;把这段计算纳入 checkpointing 后,每层保存的激活量可以接近标准残差架构,而不是保存 93 份独立层输出。深度方向的可检索性,并没有让显存账单翻 93 倍——这就是 Block 化的意义。
4. KDA 的状态怎样跨卡:难点是顺序,不是状态大小
KDA 的优势是状态 $\mathbf S$ 不随序列长度增长,正因如此跨卡传它本身并不大;难点是状态更新具有顺序依赖。假设把一条长序列切成两段:
GPU 0: token 0 ... token 49999
GPU 1: token 50000 ... token 99999
GPU 1 不能从空状态开始算,因为 token 50000 的结果依赖前 50000 个 token 的状态。最朴素的做法是 GPU 0 先完整算完、传一次固定大小的 $S$ 给 GPU 1;通信并不贵,但 GPU 1 全程闲着——并行了个寂寞。 KCP 要解决的是:两段能否先并行做自己的工作,最后再精确接回同一条状态链。
4.1 普通线性 attention 为什么可以简单相加
最简单的线性 attention 更新是:
\[\mathbf S_t=\mathbf S_{t-1}+\bm k_t\bm v_t^\top\]每段从零开始算出本地贡献,最后把此前各段贡献相加即可。这是因为后面 token 只是在旧状态上加一项,没有改变旧状态本身——加法满足交换律,先加后加无所谓。
KDA 不满足这个条件。当前 token 不仅写入一项,还会遗忘和擦除旧状态,因此它对入口状态施加一个由 token 决定的转移:
\[\mathbf S_t=\mathbf M_t\mathbf S_{t-1}+\mathbf b_t\]其中 $\mathbf M_t=(\mathbf I-\beta_t\bm k_t\bm k_t^\top)\operatorname{Diag}(\bm\alpha_t)$,$\mathbf b_t=\beta_t\bm k_t\bm v_t^\top$。所以后半段即使从零算出了自己的 $\tilde{\mathbf S}$,它仍必须先把前半段传来的状态乘上本段累计 $\mathbf M$;两段本地状态不能简单相加,因为后半段会”改写”不是”追加”。
4.2 KCP:传固定大小的转移信息
Kimi 的 KDA Context Parallelism(KCP)把每段的作用总结成一句仿射变换:给我任意入口状态 $S_{in}$,我都会输出 $\mathbf M_{seg}S_{in}+\tilde{\mathbf S}_{seg}$,即”先乘一个矩阵、再加一个偏移”。其中两项都能只根据本段 token 预先算出:
- 这一段的累积转移矩阵 $\mathbf M$;
- 假设输入状态为零时,这一段自身产生的状态 $\tilde{\mathbf S}$。
例如 GPU 0 的 fragment(片段,这里指一段 token 及其对应的 $\mathbf M,\tilde{\mathbf S}$ 摘要)是 $(\mathbf M^{(0)},\tilde{\mathbf S}^{(0)})$,GPU 1 的 fragment 是 $(\mathbf M^{(1)},\tilde{\mathbf S}^{(1)})$。从初始零状态出发,GPU 1 的真实入口就是 GPU 0 的输出:
\[\mathbf S_{in}^{(1)}=\mathbf M^{(0)}\mathbf S_{in}^{(0)}+\tilde{\mathbf S}^{(0)}.\]GPU 1 随后把这个入口代入自己的 fragment,得到
\[\mathbf S_{out}^{(1)}=\mathbf M^{(1)}\mathbf S_{in}^{(1)}+\tilde{\mathbf S}^{(1)}.\]两段的组合仍是同一种”先乘 $\mathbf M$、再加 $\tilde{\mathbf S}$”的形式,因此可以用 prefix scan(前缀扫描,把所有 fragment 按顺序两两复合一遍,最终每个位置都得到”从开头到这里的完整变换”)连续合并更多 rank:
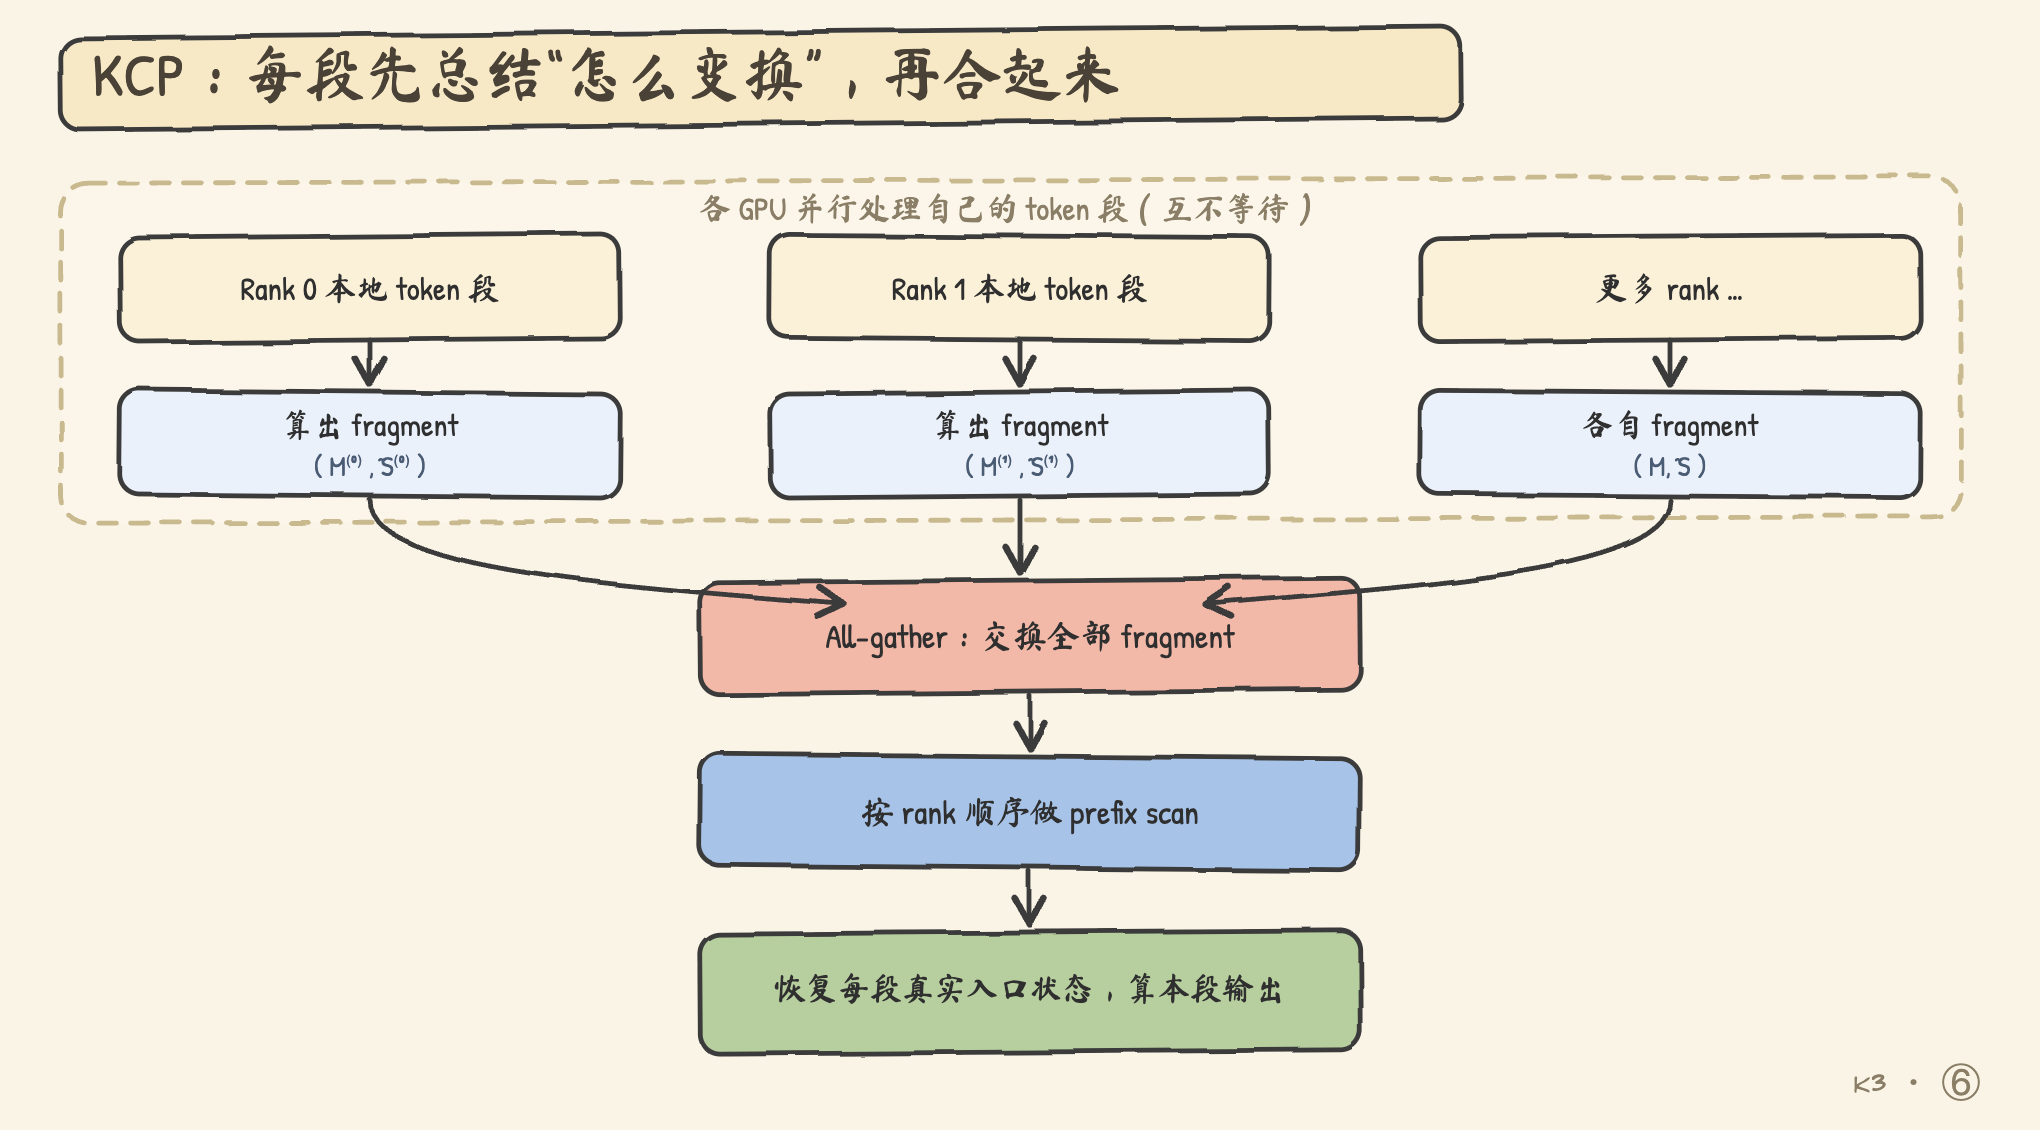
各 GPU 先并行计算自己的 fragment,再交换这些固定大小对象,按 token 段顺序做一次 prefix scan,就能恢复每段真实的入口状态,继而得到输出。关键是 fragment 的复合仍保持顺序,却不需要等待上一段完成 token 级递推;通信量与状态矩阵大小相关,而不随整条序列线性增长。 这和”把序列直接切两半、各算各的”不同:KCP 传的是每段如何变换状态的信息,最后仍然遵守原始 token 顺序——并行的是计算,不是语义。
5. 1M context 的 Agentic RL:状态要能暂停和恢复
到这里讨论的还是一次前向或一次训练 step。Agentic RL(智能体强化学习,让模型在环境里自主调用工具、完成多步任务再训练的范式)则把任务拉成很长的生命周期:模型调用工具、等待工具结果、继续读写文件和执行下一步,再根据最终结果训练。一个 1M token rollout(一次完整的多轮交互轨迹)可能有几百次这样的往返,因此系统要同时管理两类状态:模型已经读过前缀的 cache,以及工具环境里的文件、进程和磁盘状态。
5.1 Cache 池:只为离开 GPU 的前缀付费
正在 decode(逐 token 生成)的请求必须把 cache 留在 GPU;正在等待工具结果的请求暂时不用算,却也不该丢失已经 prefill(预填充,把提示词一次性算完、得到每层 KV)好的长前缀。若所有这类闲置前缀都常驻 GPU,cache 很快爆掉;若每次都从头 prefill,1M token 的等待又会变得很贵。K3 用 write-back(写回缓存:只在数据被驱逐时才写回下一级存储):只在前缀被 GPU 驱逐时才写回 CPU DRAM,下次重新调度前再预取。它和 write-through(写穿缓存:每次更新都同步写一份到下一级)的区别是,仍在 GPU 活跃的 cache 不额外复制一份到 CPU——不搬家就不付搬家的钱。
KDA 状态与对应 MLA KV block 一起 offload,因为它们必须在相同的 token 边界恢复。模型权重和 optimizer state 还会继续 offload 到 NVMe,把 DRAM 主要留给 cache 池——冷数据住硬盘,热数据住内存,正在用的住显存,三级存储各司其职。
5.2 为什么沙箱要用 microVM
cache 恢复了模型的上下文,工具沙箱还要恢复”任务做到哪里”。Agent 可能会创建文件、运行代码、启动容器,甚至触发内核级操作;普通容器隔离不够强时,一次异常就可能影响整台训练机器。K3 使用 Firecracker microVM(一种轻量虚拟机,启动快、隔离强,把每个 AgentENV 当作可暂停、可复制的独立小虚拟机)。
它支持增量 checkpoint,只保存脏页(自上次检查点以来被修改过的内存页);报告中的 checkpoint 约 133ms、resume 约 49ms。Agent 等待工具结果时,沙箱可以暂停,不继续占用 CPU 和内存;需要比较不同动作的 reward 时,还可以 fork 出副本,在副本里试错而不影响原环境——试错成本从”重开一局”变成”复制一份”。
这类机制对 1M context 很关键:长任务的瓶颈不只是 token 数,还包括”一个任务的外部世界状态要活多久”。
6. Prefix Cache:KDA 让已经成熟的 cache 又变复杂
传统 KV cache 是”每个 token 一份 K/V”,按页保存后只要前缀 hash 命中,就能在相应边界继续。KDA 的 cache 不是 token 列表,而是该前缀累积得到的一整块状态;要从某个边界恢复,必须正好有该边界的 state checkpoint。于是一个请求可能出现:MLA 的前缀已经命中,但同一边界没有 KDA checkpoint,仍不能安全继续——就像护照页都在,但签证页缺了,还是过不了关。
K3 的解决思路是把”匹配有多细”和”物理块有多大”解耦:
- 逻辑匹配在 512-token hash block 上进行,保证前缀可以细粒度比较;
- 物理内存用较大的 block 分配,例如一个 6144-token physical block 里包含 12 个 hash block;
- KDA checkpoint 只在稀疏边界保存,通常优先选择对话轮次边界——反正 KDA 恢复成本低,不必每个 token 都存;
- 命中后恢复最近 checkpoint,中间未覆盖的 token 用 copy-on-write(写时复制,复制一份私有副本再修改,不动共享原页)继续 prefill。
下图先把一次请求的决策走一遍:
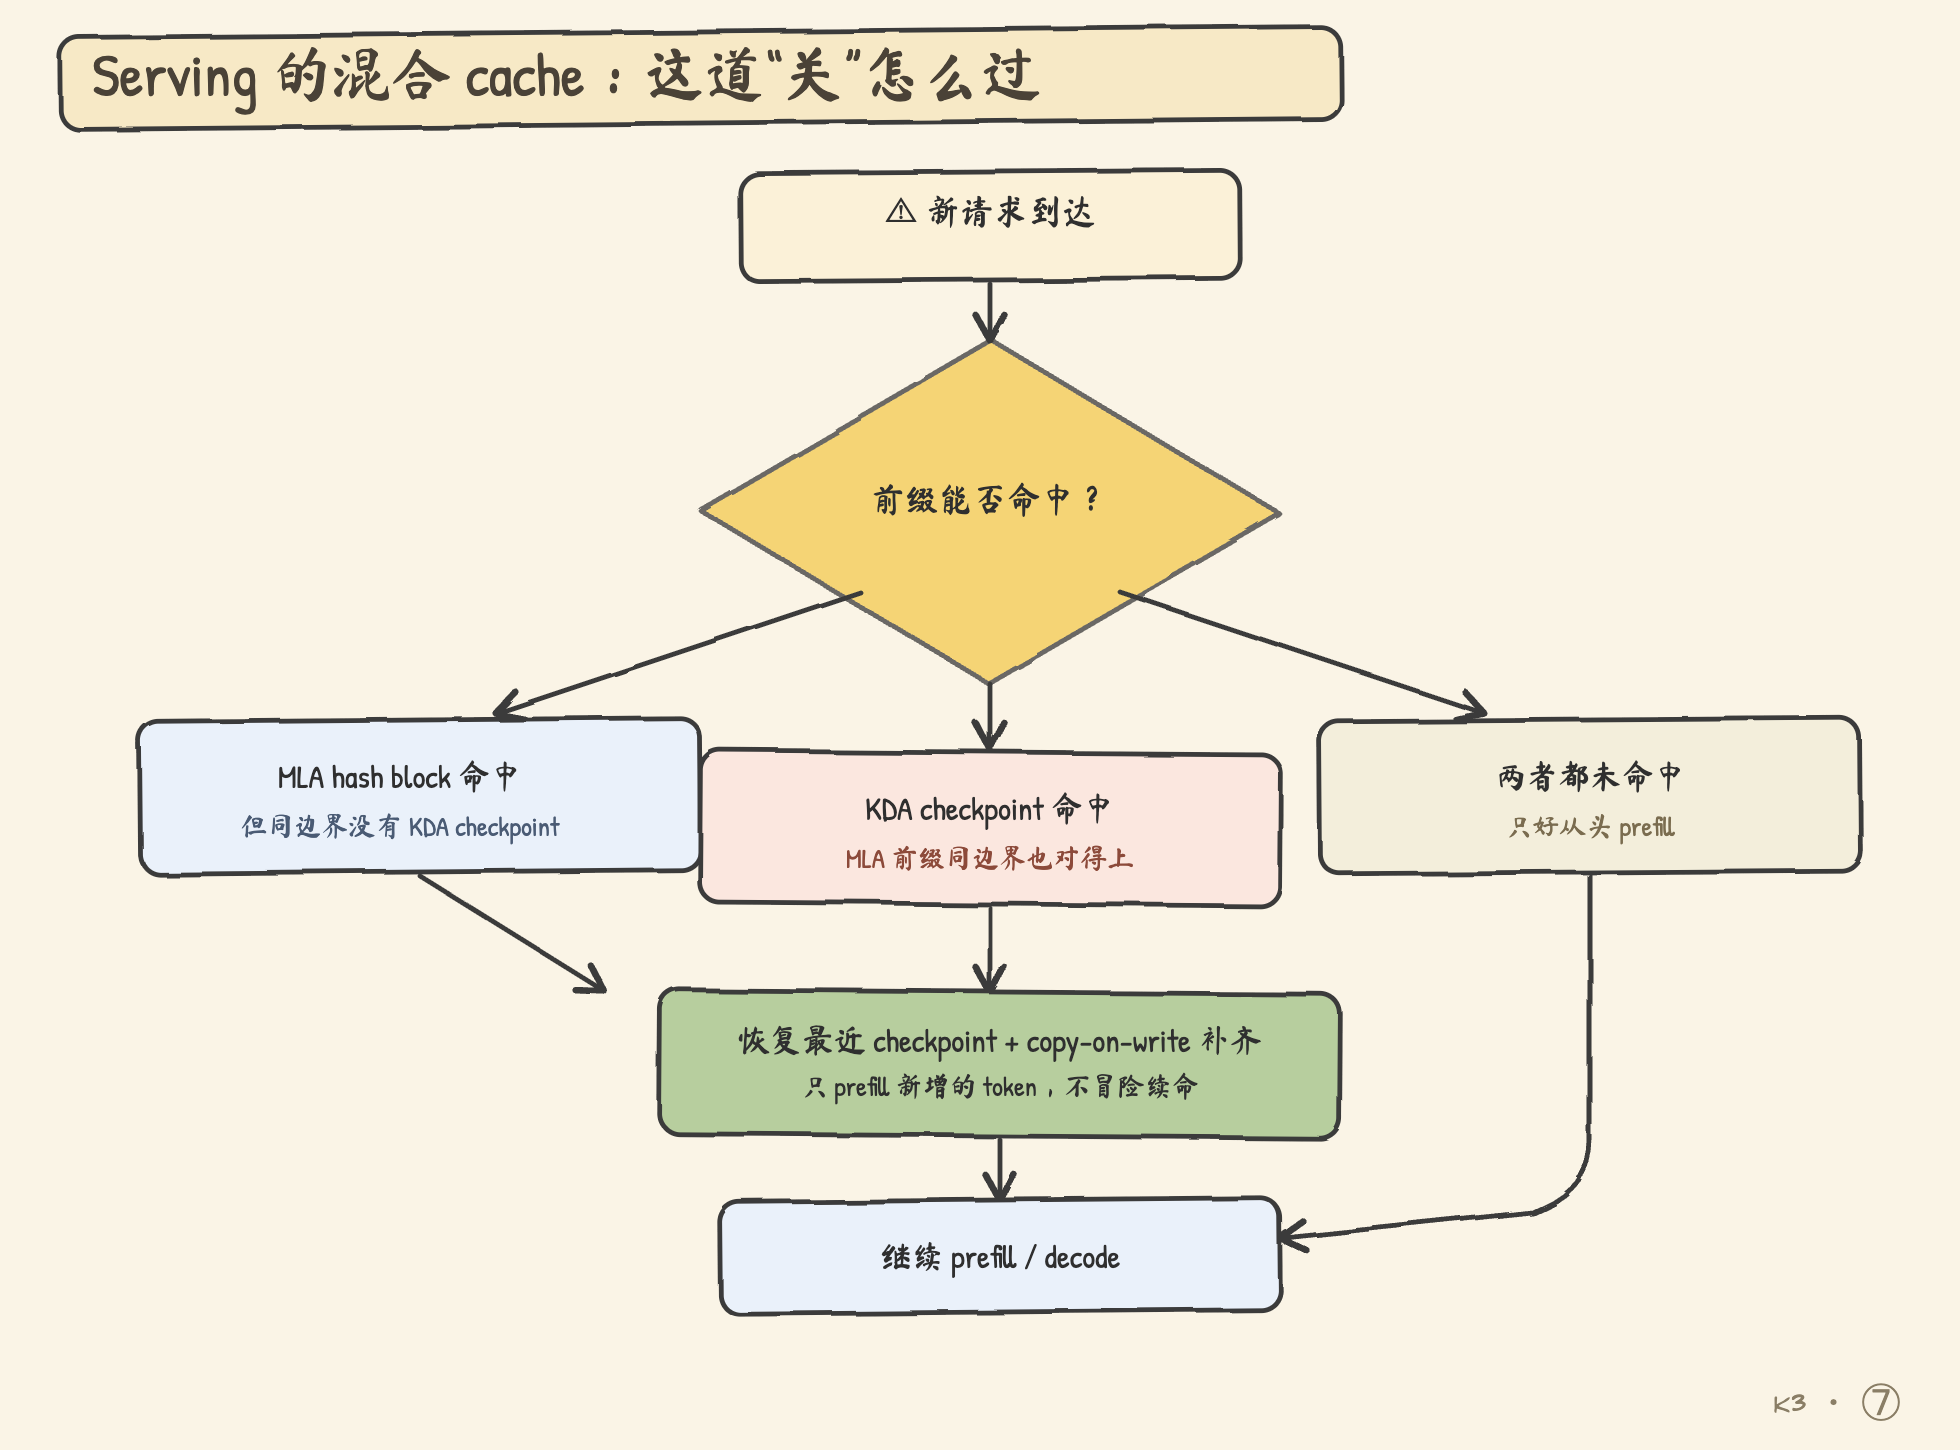
真正可用的命中必须同时满足 MLA 前缀 hash 与各个 KDA 组的 checkpoint;命中后复制出私有的可写部分,再 prefill 新增加的 token,不能直接修改共享 cache。
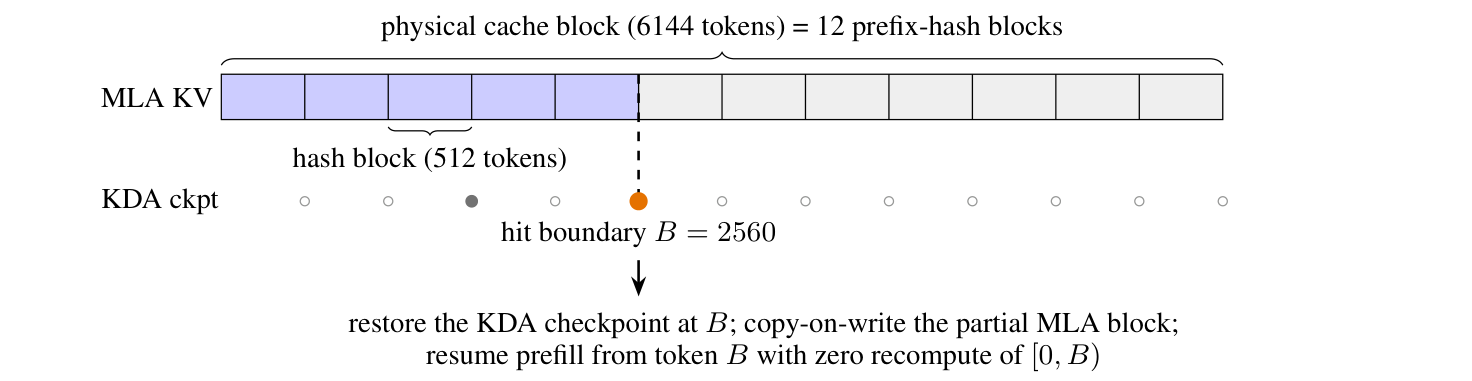
图中蓝色部分是已缓存的 MLA hash block,下面的点表示 KDA checkpoint。比如请求前 2800 个 token 都相同,最长可用边界也许是 2560:此处既有 5 个 512-token hash block,又有 KDA checkpoint。系统复制共享 MLA 的未满物理页,恢复 2560 处的 KDA 状态,然后只 prefill 后面的 240 个 token;它不会为了复用 MLA 而从一个没有 KDA 状态的 2800 边界冒险继续——省 240 个 token 的 prefill,不值得赌上整条状态链的正确性。
这里的关键不是”缓存粒度越细越好”。Checkpoint 本身比单个 token 的 KV 大得多,存得太密会抵消 KDA 的空间优势;存得太稀又会增加恢复时需要重算的 token。K3 的设计是在匹配粒度和状态保存成本之间折中:粒度管”能不能精确接上”,成本管”接上要花多少”。
7. Speculative Decoding:KDA 状态不能随便回滚
Speculative decoding(推测解码)让一个较小的 draft model(草稿模型,先快速猜出候选 token 的模型)一次猜多个 token,再让大模型验证。接受的 token 被写入正式状态,被拒绝的 token 则需要丢弃;它的收益来自一次验证多步候选,而不是让大模型少做验证——大模型该算的还是一步不落。
在普通 KV cache 里,回滚通常是释放被拒绝 token 对应的 cache block,改个长度指针就完事;KDA 每生成一个 token 都会更新同一个状态矩阵,如果 draft 连续走了 7 步,再拒绝第 3 步,状态已经多更新了几次,不能只改一个长度指针——你不是删掉了几行字,而是把整个笔记本的墨水都改了。
K3 的思路是:状态并不需要存下来,只要保存每个 draft token 驱动状态更新所需的 q/k/v 投影输入。验证 kernel 确认接受到第几步后,在片上从最后一个正式状态重放 accepted token 的更新,最后只写回合法状态。投影输入远小于为每个候选都复制一份完整 $\mathbf S$,这就是”重放”比”逐步快照”划算的原因——存”怎么算”比存”算到哪”便宜。
8. 量化和 vLLM:训练时就面对部署格式
K3 的 post-training 使用 MXFP4 量化感知训练:MoE expert 权重以 MXFP4 保存和计算,激活使用 MXFP8,attention projection 和 router 保持更高精度。MXFP4/MXFP8 是带微缩放因子的低精度浮点格式(先按块统计一个缩放因子,再把块内数值缩放到 4 位或 8 位表示,兼顾范围和精度);量化感知训练(QAT)的意思是,训练过程中就模拟部署时的低精度,而不是训练完成后突然把 BF16 权重转换成 MXFP4。
这样做是为了减少 train-inference mismatch(训练与推理的数值格式不一致):训练时模型已经见过量化误差,rollout 和训练使用同一套数值格式,部署后不容易出现突然掉点——考试用什么样的卷子,平时就练什么样的卷子。
开源 serving 侧,vLLM 已提供 K3 的 Day-0 支持。一个最简启动方式是:
vllm serve moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --enable-prefix-caching \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
这里的 tensor-parallel-size 8 表示用 8 张 GPU 切分张量;enable-prefix-caching 打开前面讲的混合 cache;tool-call 和 reasoning parser 则负责把模型输出解析成工具调用和思考/答案结构——模型只管吐 token,怎么解释 token 是部署侧的事。
vLLM 的 scheduler 需要同时管理两种 cache:MLA 的分页 KV block 和 KDA 的固定状态 block。prefill 使用 FlashKDA,decode 使用融合 CUDA kernel。高吞吐部署还可以把 prefill 和 decode 分到不同机器:prefill 侧用 TEP(Tensor-Expert Parallelism,把 attention 做 TP、MoE 做 EP 的并行组合)快速处理长 prompt,decode 侧用 DEP(Decode-Expert Parallelism,以专家并行为主的解码并行)提高逐 token 吞吐,中间通过 NIXL(Non-blocking Inter-node eXchange Layer,跨节点数据传输层)发送 MLA KV、KDA 状态和 block table。
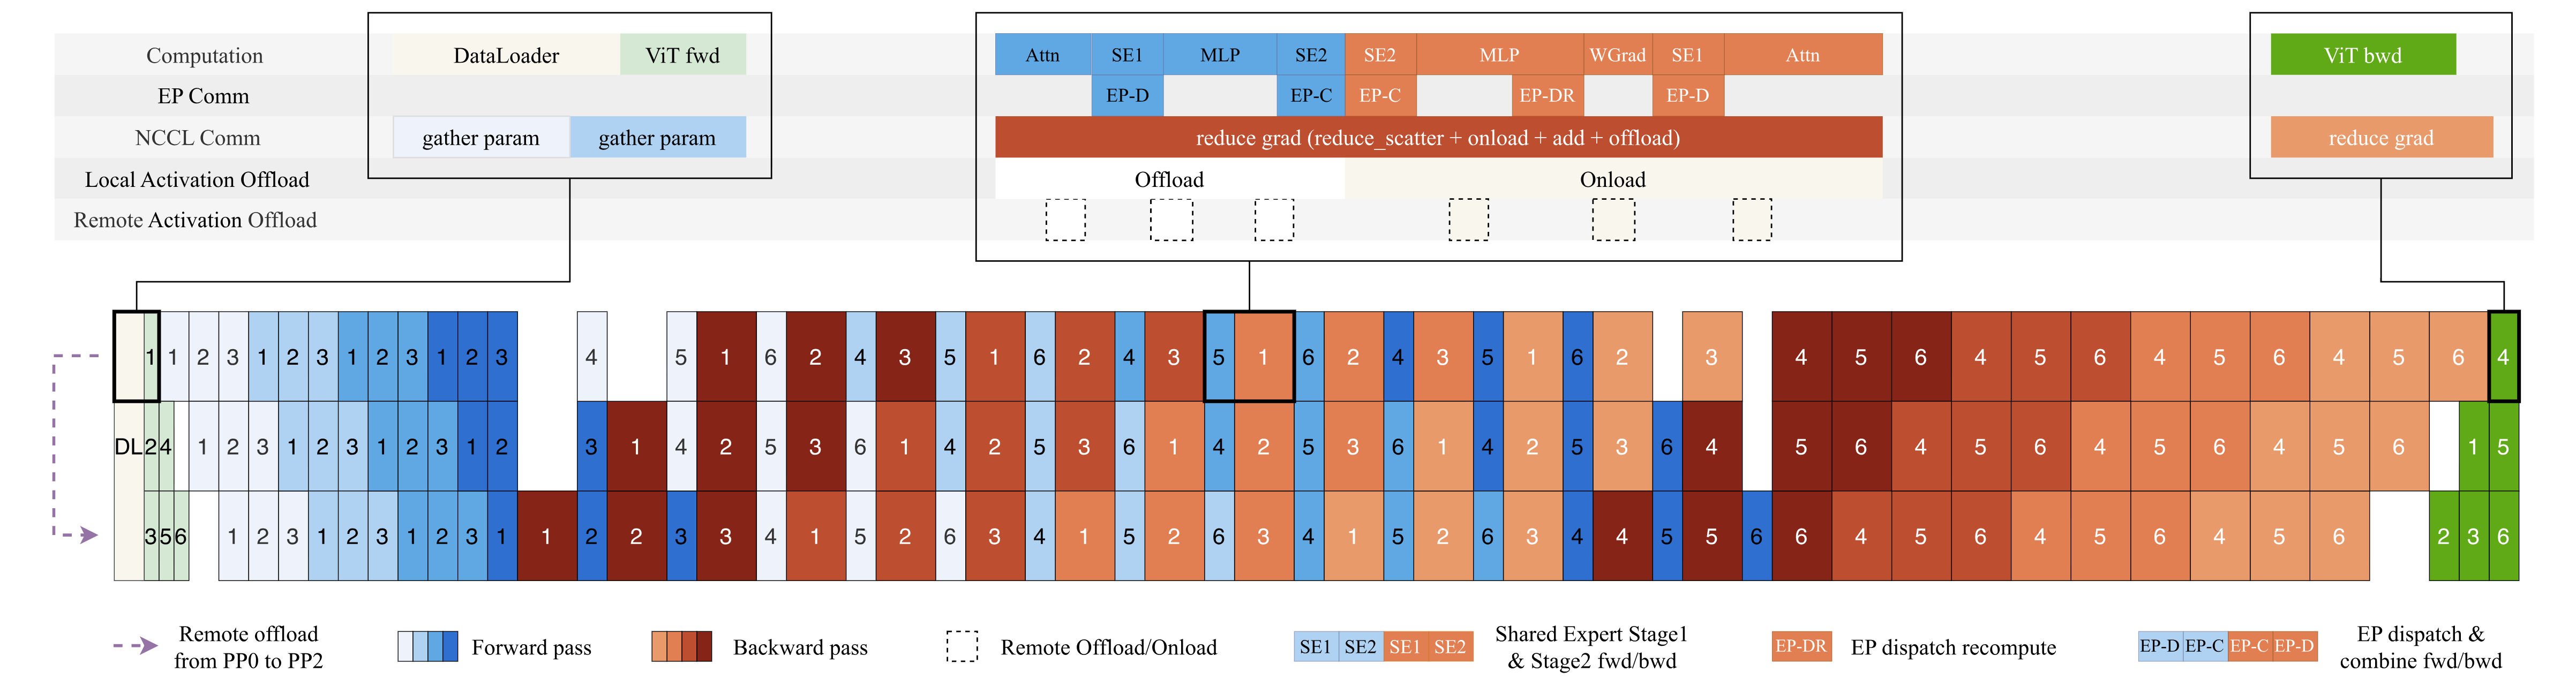
这张图反映的是另一个系统事实:当计算、通信和 offload 能够重叠时,单独优化某一个 kernel 未必决定最终性能;调度顺序和 buffer 生命周期同样重要。
9. 系列小结:新架构把哪些老问题重新打开了
回头看整个系列:KDA 减少了随 context 增长的状态,但引入了状态传递、checkpoint 和回滚问题;AttnRes 提供了深度方向的检索,但要求系统管理跨层表示;LatentMoE 压低了专家计算成本,却要求更严格的负载均衡和激活稳定性。
对应到 infra,就是一条连锁反应:
- MoonEP 把动态专家路由约束成固定 shape,减少 EP 的尾部等待;
- KCP 用固定大小 fragment 做 KDA 的 context parallelism——传”变换规则”而不是”完整状态”;
- 混合 prefix cache 同时管理分页 KV 和稀疏 checkpoint,匹配粒度与存储成本折中;
- Speculative decoding 通过重放状态避免保存大量快照;
- 量化感知训练让训练、rollout 和 serving 使用接近的数值格式;
- vLLM 把这些结构暴露成 scheduler、kernel 和部署参数,而不是只停留在论文里的模块图。
Kimi K3 这份报告的系统价值,主要就在这里:它没有把”新 attention”“超大 MoE”“1M context”当成互不相干的卖点,而是展示了每个结构变化会把哪些系统假设推翻。 真正部署时,决定成败的往往不是某个公式单独快多少,而是状态、通信、内存和调度能不能在同一条 pipeline 里对上。
扯一句题外话:打个广告,《动手学 AutoML:从 NAS 到大语言模型优化实战》系统地介绍了如何自动化地设计、搜索和压缩模型架构,结合最新的 attention 设计范式,可以让 AI 自动搜出更高效的结构,感兴趣的同学可以看看我们的这本书。
