SOSP'26 | StreamEP:拆掉 MoE 通信屏障,让就绪 token 不再陪慢链路等
SOSP’26 | StreamEP:拆掉 MoE 通信屏障,让就绪 token 不再陪慢链路等
原文:StreamEP: Straggler-Tolerant MoE Decoding without Communication Barriers
官方实现:USC-NSL/StreamInfer,本文源码核验固定在
08594f596598b8fb2c838b1d154960ed6a0a442e,不以浮动的 main 分支代替版本证据。
1. GPU 已经收到活了,却还不能开工
想象一下,16 张 GPU 分散在几台服务器里跑一个 MoE 模型。MoE 就是混合专家架构:每层有很多套前馈网络,但一个 token 只选择其中少数几套计算。参数规模可以很大,每个 token 的实际计算量却没那么大,这就是稀疏激活的好处。
问题是,专家权重放不进单张卡,得把不同专家分到不同 GPU 上。这种部署叫专家并行,简称 EP。token 做完本地 attention,由 router 决定找哪些专家,然后跨卡发送,算完再把结果送回来。
现在,前面几路数据已经到了,最后一路被共享网卡上的流量堵了一下。你会觉得,GPU 至少可以先处理收到的那部分吧?在论文讨论的传统 EP 执行方式里,还真不行:这一次集体通信没完成,下一阶段就不能推进,早到的数据也得陪最后一路等。
StreamEP 针对的就是这段等待。它不是再设计一个更快的专家算子,而是改掉“所有卡每层一起走”的运行方式。作者把这个思路实现成 StreamInfer,一个面向逐 token 生成阶段,也就是 decode 的分布式推理引擎。
先把数字放对位置:论文在 16 张 L40S 和 16 张 A100、每台服务器共享一张 200 Gbps 网卡的两套集群上,得到相对传统 EP 最高 1.7× 的解码吞吐。这是特定网络、模型、负载和测量口径下的结果,不是随便换个 MoE 就快 70%。附录还有 dummy KV cache 与路由回放的评测设定,后面一起展开。
2. 通信慢是一回事,让所有人一起等是另一回事
传统 EP 每层的主线很规整:attention → dispatch → 专家计算 → combine → 下一层。dispatch 是把输入发到专家所在卡,combine 是把专家结果送回并合并。
这些步骤通常依靠 collective,也就是一组 GPU 共同参与的通信操作实现。all-to-all 是各卡互相交换不同数据;论文实际对比的 SGLang 版本则用 all-gather 汇集输入、all-reduce 汇总专家输出。具体搬运方式不同,但评测中的共同问题是:整个批次的推进被 collective 的完成条件卡住。这里说的 barrier 是执行上的屏障,不一定是代码里显式调用了某个名叫 barrier 的函数。
这种方式并非一无是处。完整 batch 到齐,张量排列规则,GPU 可以一次处理更多 token,让读出来的专家权重被充分复用。代价是,计算节奏取决于最晚完成的传输或设备。论文把这些拖后腿的链路、消息或设备称为 straggler。
大厂可以用极高带宽互联和专门的通信实现把问题压下去,但共享集群不一定有这个条件。两张卡共享一张网卡、机内 PCIe 和机间网络速度不一致,都会让同一轮的消息到达时间错开。即便每对 GPU 发送相同大小的数据,也不代表同时到达。论文正文与附录 A 的到达时间测试,专门把消息大小固定来隔离这个因素。
还有一个容易混淆的地方:专家计算均衡,不代表每条链路的传输均衡。把专家摆到合适的卡上,可以让各卡总工作量接近,但“GPU 0 发给 GPU 1 多少、发给 GPU 2 多少”仍由路由决定。附录 B 正是在接近均衡的专家放置下,观察到单条消息的最大/平均 token 数比例比每卡专家计算的比例更高。
下面这张入门图先只看左右两条路径:左边把 A、B、C 当作同一批一起放行;右边允许 A、B 先走。底部那句话尤其重要,它限定了什么才算“就绪”。
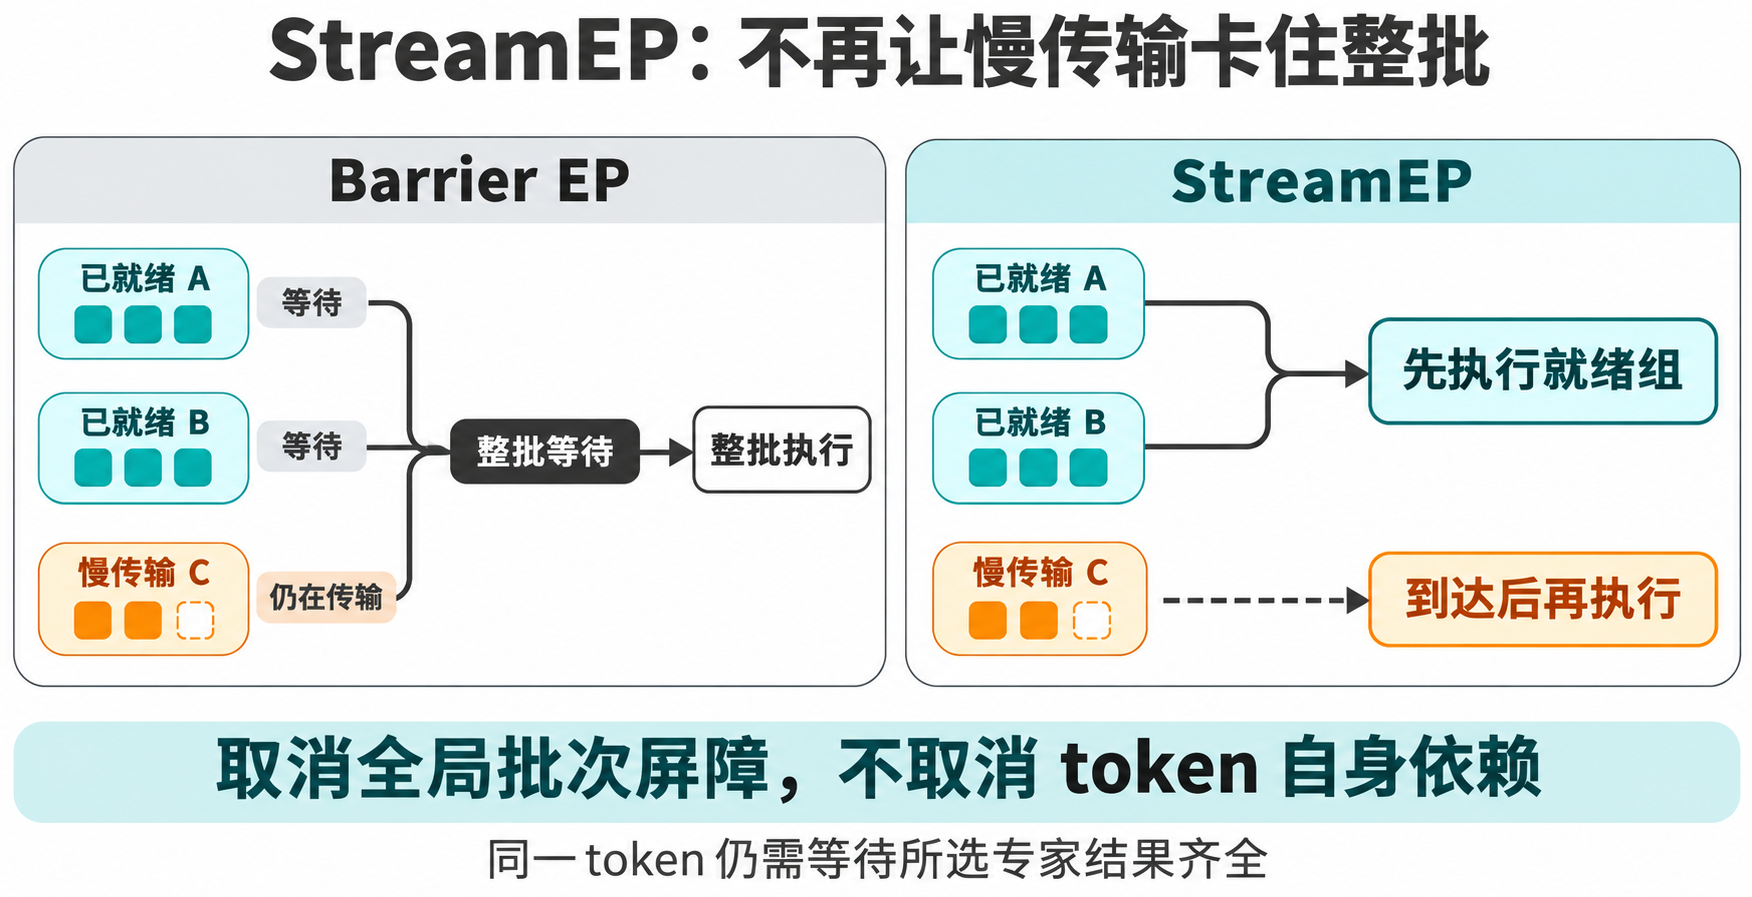
左边 A、B 的数据已经齐了,但 C 还在传,整个批次停着;右边先执行就绪组,C 到了再安排。这里的 A、B、C 是不同 token 组,不是同一个 token 的三份专家输出。如果 A 自己选择了四个专家,只回来三个,A 仍然不能进入下一层。
所以 StreamEP 去掉的是无关 token 之间被整批通信捆出来的等待,不是模型的数据依赖。也不是收到一个 token 就必须立刻启动一个 kernel;kernel 是 GPU 实际执行的计算程序,启动太碎同样会拖垮效率。让哪些就绪 token 一起算,反而成了新问题。
3. 不再整批前进,运行时就得知道每个 token 到了哪
没有 collective 帮你划齐层边界,同一张卡上可能同时躺着第 3 层的专家输入、第 4 层的 attention 输入,以及迟到的第 2 层结果。不能再用“它在 batch 的第几个位置”辨认身份。
StreamInfer 给 GPU 上的张量配了一份 CPU 元数据:请求编号 RequestID、目标位置 LayerID、张量引用和 top-k 合并权重。LayerID 包含层号、attention 所属卡编号、专家编号。每层维护两个微队列,论文写作 $\mu$-queue:一个收 attention 待执行 token,一个收专家待执行 token。$L$ 层模型按这个抽象有 $2L$ 个队列。
attention 的归属不能随便换。这里用数据并行,也就是各卡复制 attention 权重、处理不同请求;请求一经分配,整个 decode 期间绑定同一个 home rank。rank 可以理解为参与分布式执行的设备编号。它保管这个请求的 KV cache——历史 token 的 Key、Value 缓存,后续 attention 要反复读取。专家输出因此得返回这张卡,不能图方便落在别处就直接继续。
下面沿着黄色的请求 37 往下读。上方标注 1|1|1,意思是目标第 1 层、attention 家在 rank 1、这次找 expert 1;下方变成 2|1|X,表示回家准备第 2 层,下一层选谁还没确定。
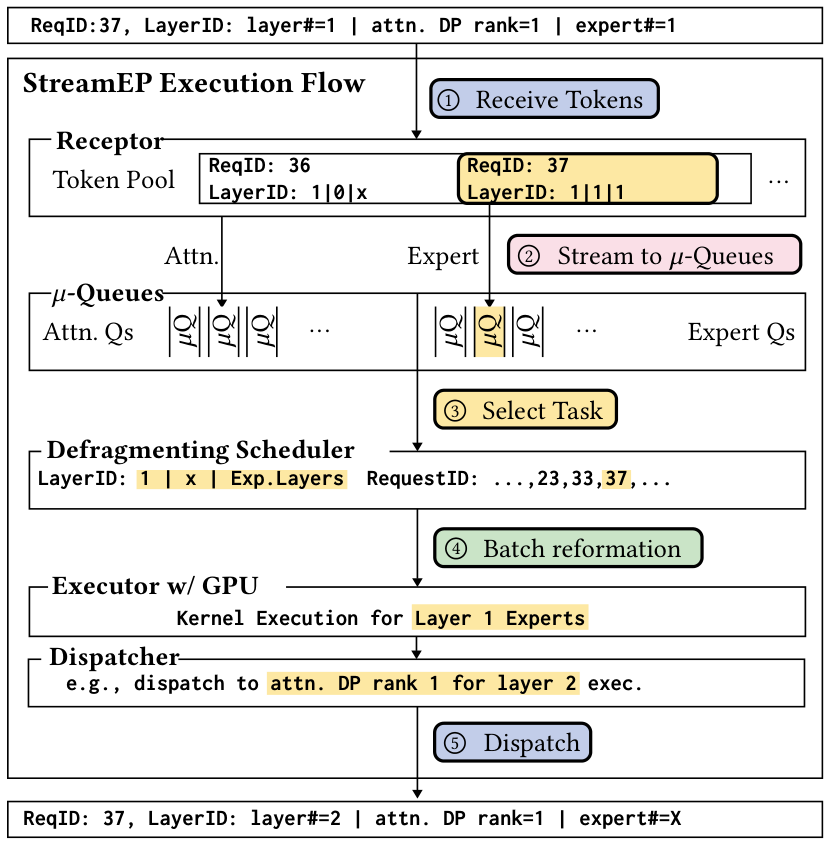
第一步,Receptor 接到张量与元数据,先把 token 收进池子。第二步,按目标层和任务类型送进对应微队列。第三步,调度器选一个非空队列,比如第 1 层专家队列,里面此时已有请求 23、33、37 的输入。
第四步,把这些零散输入整理成连续 batch,再跑专家计算。第五步,Dispatcher 改写下一站,发回 rank 1;若目的地就在本卡,直接本地入队。GPU 算这一批时,其他层的队列继续收数据,下一批自然积累起来,不需要专门停下来凑满原来的逻辑 batch。
把 top-k 放进来,这条链才完整。top-k 指每个 token 选择得分最高的 $K$ 个专家。GPT-OSS-120B 的实验配置是 128 选 4、隐藏维度 2880。假设请求 37 的某层输入是一个长度 2880 的向量,会派生四份专家任务;四个结果分别返回,仍按请求和目标层归并。前三份先回来,只能暂存;第四份也到了,才获得进入下一层 attention 队列的资格。
合并的数学语义没改,仍是按 router 权重加权求和:
\[y = \sum_{j=1}^{K} w_j E_j(x).\]例如 32 个 token 都选四个专家,下一层要恢复的是 32 个长度 2880 的向量,而不是把 128 份专家输出当 128 个独立 token 继续算。系统把搬运零散向量的 gather 与加权合并融合到 batch 重组过程,减少单独启动计算程序的次数。带共享专家的模型也没把这部分丢掉:论文将共享专家放在 home rank 上,attention 后本地执行,再发给路由专家。
数据一直在 GPU 上,CPU 管的是引用、去向和依赖。这不等于没有 CPU–GPU 传输:路由编号、权重、KV 页表等小块元数据仍需要来回同步。
4. 队列建好了,还要防止 GPU 永远忙着算碎片
最直观的调度策略是,哪个队列 token 最多,就先算哪个。论文称作 MTFS,也就是最多 token 优先。单看这一次决策很合理,但连续运行就可能留下很多“小尾巴”:第 8 层刚算掉大头,剩下几个迟到 token;第 15 层此时更多,又跳过去,结果许多层都挂着残片。
反过来,始终优先最前面的层,叫 FLFS,最早层优先。它能把碎片往同一个前沿赶,但新请求一直从第一层进入,老请求就可能一直被插队。机器看起来不停干活,却没有把已有请求送到完成,这就是 livelock,活锁。
下面看横轴时间、纵轴层号,蓝色表示 attention 队列、橙色表示专家队列的深度。先看左边铺满许多层的条纹,再看右边随时间向后层移动的一条斜线。
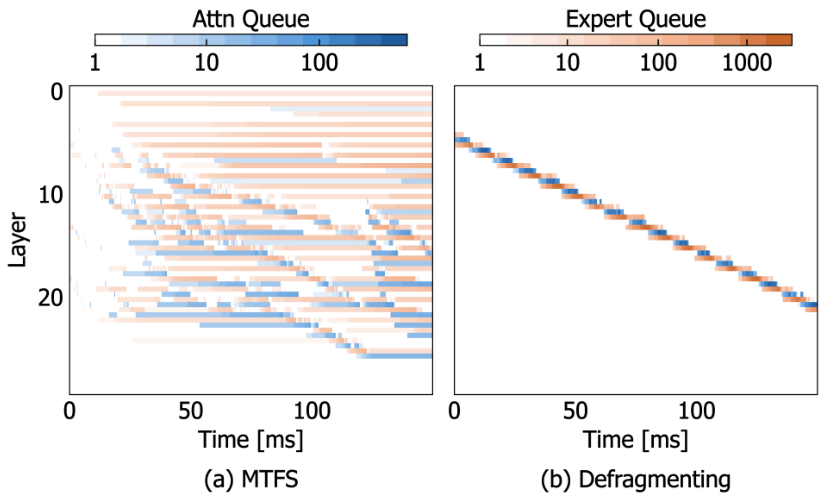
左边 MTFS 的问题不是完全没在推进,而是同时维护太多分散的执行前沿,每层反复启动小 batch。右边的 defragmenting scheduler,也就是去碎片调度器,让执行尽量围绕当前活跃波次集中:这批 token 从 attention 走到专家,再走下一层,沿途把附近残片带上。
它不只看当前队列有多少,还沿“attention → 专家 → 下一层 attention”的链往前看几步。论文简化算法可以写成:
\[S(s)=Q(s)+\sum_{j=1}^{W}\delta^j\left[Q(s_j)+H(s_j)\right].\]这里 $s$ 是候选任务,$Q$ 是当前队列深度,$s_j$ 是后面第 $j$ 个任务,$W$ 是前看窗口,$\delta$ 让越远的任务影响越小;$H$ 是历史活动信号。论文伪代码用最近若干调度步排出的 token 数求和,避免一个刚被排空的队列突然看起来“没热度”。其他卡可能还在算附近的层,后续数据其实正在路上。
举个纯说明性的算分例子,不是实验参数:设只看后两步,$\delta=0.5$。候选 A 当前 20 个 token,后两步的“队列加历史”分别是 100、80,得分就是 $20+50+20=90$;另一个孤立队列有 60 个 token,后面没什么活动,得分 60。调度器宁可先推 A,也不为眼前多出来的 40 个 token 把整条波次打散。
这样能避开“永远只做第一层”的僵硬优先级,也不要求所有迟到碎片先追上队伍。论文把它描述为保证 forward progress,即持续向完成推进。不过,这不是任意到达率下,每个请求都有有限等待上界的证明:算法没有因等待时间增长而不断加分的显式 aging 项,正文也没有给出逐请求最大等待界。持续过载、极端路由热点、长时间断联,不能靠“去碎片”三个字担保。
源码这里值得多说一句。固定版本的 csrc/muhelper/layer.cpp 中,UnifiedDefraggingLayerScheduler::_schedule_impl 确实实现了队列打分与衰减前看,但历史项是有效队列快照的窗口平均,不是论文伪代码的 drained-count 总和;前看还按执行链循环取位置,而简化伪代码在模型末端截断。两者核心意图一致,细节却不能画等号。上面的公式讲的是论文算法,不冒充源码逐行翻译。
5. batch 大小随时变,通信双方怎么对上暗号
到这里还有个工程坑:传统 collective 预先知道参与者和数据布局,异步执行却可能随时从任意 peer 收到不同大小的一批张量。普通 NCCL 的点对点接口仍要求发送和接收匹配,接收方不能对着未知大小的 GPU 数据盲收。NCCL 是 NVIDIA 的 GPU 通信库,StreamInfer 用的是它的普通发送/接收能力,不要求换成某套 Hopper 专用通信 kernel。
下面从左上角 Sender CPU 开始看。第一阶段横着走的是元数据;跨过红线,第二阶段才是 GPU 张量传输。
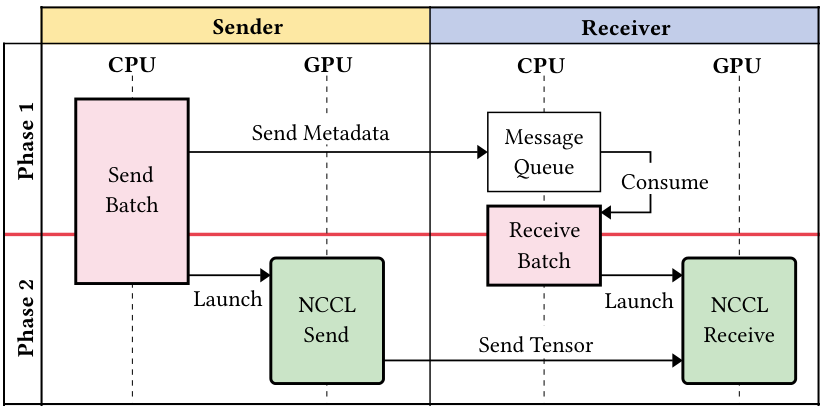
发送端先用 CPU 消息队列发来源、token 数和张量大小。接收端消费消息,分配足够大的 GPU buffer,再安排 NCCL receive。随后两端在专用 GPU stream 上发起发送、接收;stream 是 GPU 上组织操作顺序的执行队列,分开它们才有机会让通信与计算重叠。
比如这次发 32 个 token 的 BF16 表示,BF16 是每个数占 2 字节的浮点格式;每个隐藏维度 2880,单份连续数据约为 $32\times2880\times2=184320$ 字节,即 180 KiB。接收方先拿到形状与类型,才知道该准备多大空间。这里仅是说明单条传输的数据量,不是整层 top-k 总流量,也没把元数据算进去。
CPU 发起传输后继续检查新消息,不是每发一批就原地等完。接收端在确认相应 GPU 数据到齐以后,才交给 Receptor;发送端也得确认发送完成,才能回收 buffer,并限制在途发送数来控制显存占用。
固定源码能对上这条链:MuDispatcher::send_batch_nonblocking 先发序列化元数据,再调用数据通道;接收循环按元数据分配张量,把未完成接收挂起来,轮询 CUDA event,完成后才处理该批。NcclChannel::send_raw/recv_raw 最终调用 ncclSend/ncclRecv。同一版本还含其他传输后端,但这里核对的是论文讨论的 NCCL 路径。
所以 two-phase 是先交换控制信息、再搬数据,不是分布式事务的两阶段提交。它也没有消灭同步:通信端点要匹配、接收完成要确认、top-k 要齐全、同一请求下一步生成要等上一步,这些全都还在。消失的是每层把无关请求绑成一个整体的 collective 推进屏障。
6. 把等待换成调度,开销也得有人买单
异步输入到达后散落在不同 GPU 内存位置,计算前要收拢;attention 还得查每个请求的上下文长度、KV cache 页表和位置。过去整批执行时隐含的规整性,现在都要由 runtime,也就是调度、通信和内存管理组成的运行时,显式维护。
作者用三类手段摊薄这笔账:把 gather 与 top-k merge 融合;GPU 算上一批时,CPU 提前调度和准备下一批;用 GDRCopy 降低小块主机—设备拷贝的延迟。此外采用逐层 CUDA Graph,将一串 GPU 操作预录后重放,减少反复启动的开销;同 batch 大小的不同层共享中间 buffer,避免图数量随层数增长时把静态内存也成倍堆上去。
消融很能说明这里的主次。以“MTFS、无重组优化、无 CPU–GPU 重叠”为起点,只加入去碎片调度,吞吐提高 3.2×;在此之上加入重组与重叠优化,再提高 4.5%。前一个倍率是内部消融,不是相对 SGLang 的端到端加速,不能和 1.7× 混用。光把通信改成异步而不处理碎片,效果可能相当难看。
CPU 成本也绝不是零。论文表中 attention batch 平均每步 CPU 总耗时 633.4 微秒,67.0% 被 GPU 执行遮住;expert batch 是 186.1 微秒,遮住 76.2%。对应 GPU 执行时间分别为 178.4 和 437.3 微秒。attention 计算短、元数据又多,所以更难隐藏控制开销;附录 E 的执行轨迹也呈现这个区别。
这些数不能简单相减得到一层精确延迟,因为流水线上重叠的是相邻 batch,不是把同一行数字相互抵消。它们真正告诉我们的是:去掉屏障省下的时间,必须大于细粒度调度、重组、通信管理新花掉的时间。低负载时没多少 token 可攒,这笔固定开销就特别显眼。
7. 最高 1.7× 成立在哪,哪些结果不能外推
先把硬件和测量口径摆齐。Sphere 是 8 台服务器,每台两张 48 GB L40S,机内 PCIe,两张卡共享一张 200 Gbps RoCE 网卡;RoCE 是通过以太网提供远程直接内存访问的网络方案。Delta 是 4 台服务器,每台四张 40 GB A100,机内 NVLink,四张卡共享一张 200 Gbps Slingshot 网卡。200 Gbps 是每台服务器,不是每张 GPU。
主吞吐实验用 BF16 的 GPT-OSS-120B:36 层、128 个专家、top-4。ShareGPT 是长度差异较大的聊天负载,GSM8k 是数学问答负载。吞吐按每秒生成的 token 数算,越高越好;主结果取最高全局 batch 附近的峰值 60 秒窗口,剔除了爬升和收尾长尾,后续负载实验则统计完整服务时段。
下面先比较黄色 EP 与蓝紫色 StreamInfer,再看橙色 EP-TBO。橙色上方带纹理的部分是理想重叠推算出来的,不是完整 TBO 实现的实测增益。
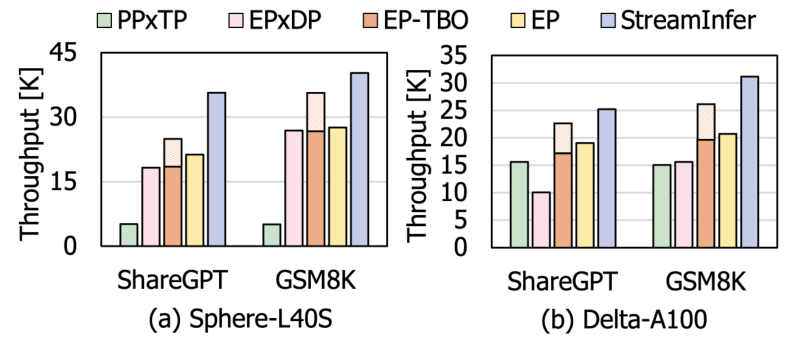
左图 L40S 上,StreamInfer 在 ShareGPT、GSM8k 分别约 36K、40K tokens/s,对比 EP 约 21K、28K,对应 1.7×、1.4×。右图 A100 上分别约 25K、31K,对 EP 是 1.3×、1.5×。A100 场景机内互联更快,但显存更小、最大并发受限,收益形态也跟着变了。
图里还有两类基线:PP×TP 是流水线并行加张量并行,前者把层切成阶段、后者把矩阵切到多卡;EP×DP 则把集群拆成两个各自运行 EP 的模型副本。它们分别可能损失阶段内 batch 大小,或因复制权重挤占 KV cache,不能简单靠“并行维度更多”解决问题。
EP-TBO 指把两个微批次交错,让一个计算、另一个通信。测试配置不支持 pre-Hopper 上的该路径,作者因此在一半并发下实测,再套理想重叠上界。若一批计算花 $C$、通信花 $M$,完美重叠也只能把 $C+M$ 压到 $\max(C,M)$;通信主导时加速上限为 $1+C/M$。这解释了为什么网络特别慢时,单纯覆盖通信也有上限。
但这里不能进一步写成“实测打败了最新 DeepEP”。实际 EP 基线是可在这些硬件上运行的 SGLang all-gather/all-reduce 路径,它与 all-to-all 的字节量、实现效率不完全相同;TBO 又是投影。结果证明了这套便携基线与资源受限场景中的优势,没有隔离出一切通信实现差异,更不是 H100 高带宽集群上的通用排名。
附录 D 则限定了结果的另一半含义:两边都使用 dummy KV cache 隔离 decode,并采集真实模型逐请求、逐 token 的路由结果,在实验中回放;同时按数据集路由 profile 调整专家放置,让计算接近均衡。它保留了模型算术、数据移动和长度分布,但不是从真实 prompt 一路生成有意义答案的在线质量测试,预先掌握的路由 profile 也不能无条件等同于生产流量。
较高并发时,token 排队能自然形成更大的有效 batch;较低并发时,这个优势就弱。完整 46 层 GLM-4.5-Air 的 top-8 路由和更大 KV 占用把并发压低,ShareGPT、GSM8k 吞吐约 7.6K、11.7K,最高只有约 1.2×,其中 ShareGPT 几乎持平。砍成 23 层释放内存后,才分别扩大到 1.3×、1.4×。半层模型是控制并发因素的实验,不是免费把完整模型提速。
交互延迟也有代价。ITL 是相邻两个输出 token 之间的间隔,越低越好;P99 表示第 99 百分位,用来看较慢的那部分体验。轻负载下 StreamInfer 的 ITL 略高,负载上来后吞吐—延迟曲线才更有利。因此它更适合离线生成、批处理或吞吐优先的高负载服务,不是默认最适合低并发聊天。
8. 能容忍局部 straggler,不代表长尾和热点消失了
下面这张图从左往右读:左边是用来构造干扰的 AWS 网络轨迹,中间看吞吐,右边同时看吞吐与平均/P99 ITL。右图越往右吞吐越高,越往下延迟越低。
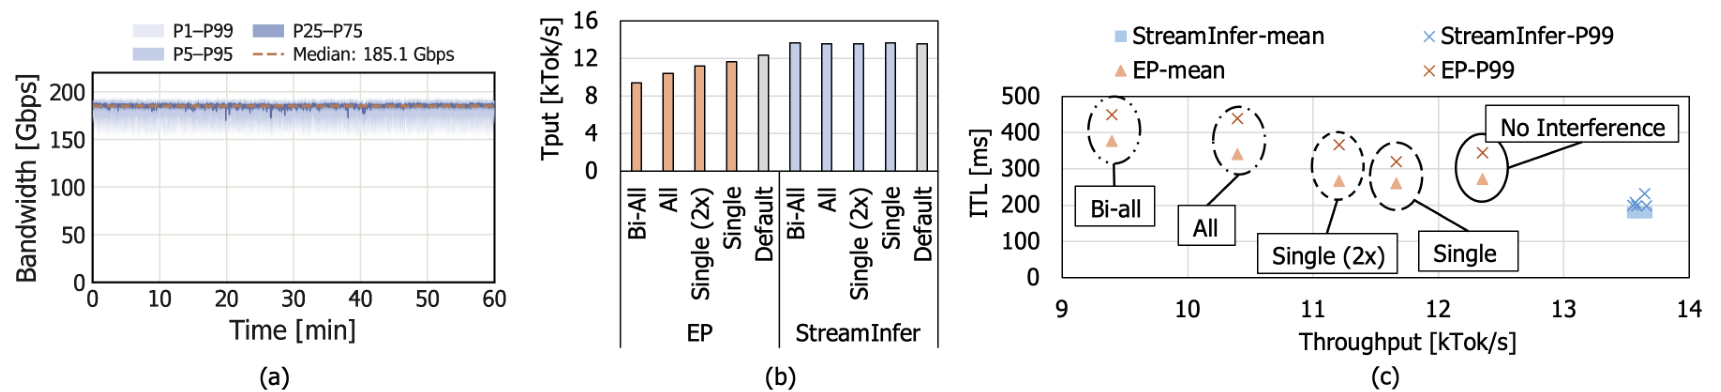
实验在每秒 100 请求的输入负载下回放干扰,从一条机间链路,到所有链路双向受扰。最严重场景平均只消耗约 7.5% 总带宽,EP 吞吐却最多掉约 24%;右图橙色点随干扰向左上漂移。蓝色 StreamInfer 点则较集中,吞吐基本保持,均值与 P99 也更稳定。
关键不在于“平均带宽少了 7.5% 应该只慢 7.5%”,而在于屏障会放大最差瞬时链路的影响:每一层都被最晚到达者定节奏。拆开以后,没经过受扰链路的就绪任务还能继续,局部波动不必立刻传播成全局停顿。
不过,假如很多 token 都要访问同一个长期过载专家,大家最终还是要在那里排队;某个 token 的第四份专家输出迟迟不回,它自己也继续不了。迟到结果、部分 top-k 和发送 buffer 都要占空间,在途发送限制还会形成反压,把拥塞向上游传。这些是机制推导出的边界,不是该论文已经给出的极端压力测试结论。
因此,“straggler 影响从全局变局部”更准确地说是:不再通过每层 collective 立即强迫无关任务陪等,但因果依赖、共享资源和容量约束仍能传播影响。论文测了有限强度的网络波动,不能推出永久故障容忍、持续过载下队列稳定,或任意长尾下每个请求都不受影响。
最后,论文的“端到端”结果也要看清测法。它单独测 SGLang prefill,也就是处理整个输入提示的阶段,同时把 KV 卸载到 Mooncake 来计入相关成本,再用之前的 decode 吞吐推算 5000 请求的总完成时间。ShareGPT 从 171 秒到 96 秒,GSM8k 从 111 秒到 66 秒;这不是完整 prefill—KV 交接—decode 系统联跑测出的生产 makespan。若工作负载主要耗在长输入 prefill,decode 优化自然帮不了多少。
9. 总结
StreamEP 最有价值的地方,是把“通信本来就慢”和“所有人必须等最慢的那个”拆成了两个问题。带宽买不起,至少别再把所有 token 锁在同一把推进锁里。
但真正落地的工作不止把 all-to-all 换成 send/recv:每层队列接住异步到达,top-k 重组守住语义,去碎片调度维持有效批次和推进,两阶段通信让动态大小的传输能匹配,CPU–GPU 重叠再把新增管理成本压下去。这是一条完整的运行时设计链,而不是一个通信 API 的替换技巧。
判断它适不适合自己的部署,可以先问三个具体问题:现在是不是被 collective 最后一路消息卡住?并发是否足够摊薄重组与调度?目标是持续吞吐,还是轻负载下尽量低的单请求延迟?答案不同,1.7× 这个数字的参考价值也不同。
顺带提一句,我们把 AutoML、架构搜索,以及 LLM 压缩、模型融合等方向的积累整理进了《动手学 AutoML:从 NAS 到大语言模型优化实战》。书里不讲 StreamEP 这套分布式 runtime,也不覆盖这里的 NCCL 异步调度实现;如果更关心从模型架构与压缩侧减少计算和存储开销,可以作为另一个角度的参考。
