SOSP'26 | Janus 用双时标调度与 xTensor,让多模型 LLM 服务既能混部又能秒级扩容
SOSP’26 | Janus 用双时标调度与 xTensor,让多模型 LLM 服务既能混部又能秒级扩容
原文:Janus: Multi-LLM Serving at Production Scale
官方源码与补充材料。本文以 2026-11-13 查询到的提交
ec1beca为核对版本;实验数字来自本地论文,源码差异单独说明,未在对应集群复现实验。
1. 单模型跑得快,为什么整个平台还是浪费卡?
一个平台部署几十个 LLM 应用,最直观的办法是每个应用分几张卡,分别交给推理引擎管理。热门应用多分一点,冷门应用少分一点,看起来挺合理。
问题是,冷门不等于不占显存。一个模型一分钟才来几条请求,完整权重还是得放在那里;另一个热门模型突然遇上活动,流量几秒钟涨起来,旁边的卡明明闲着,它却只能排队。把模型混在一起也不一定解决问题:为了省卡把显存塞满,热点出现时又没有空间扩容;每次重新打包所有模型,还可能把正常请求一起打断。
Janus 的生产 trace 很能说明这个矛盾:62 个应用里,头部 12% 贡献了 80% 的请求,头部 30% 贡献了 80% 的 token;部分应用的请求率会在几秒内上涨 5–10 倍。长尾需要的是密集混部,热点需要的是迅速拿到新副本,这两件事对资源管理的要求恰好不一样。
今天想聊的这篇工作,没有继续挤单模型算子的最后一点吞吐,而是把问题提到整个平台:哪些模型该住在一起,什么时候增加副本,请求又该交给谁?更关键的是,上层算出一个扩容计划,底下的引擎能不能真的及时执行?
它的主线可以压缩成一句话:稳定流量慢慢装箱,突发流量快速扩容,再改造底层内存和模型生命周期,让这两个计划不只停在调度器里。
先看一张只保留主线的示意图:从左侧负载分出上下两条决策路径,再看底部共同依赖的执行能力。图里的时间是调度控制周期,不是请求延迟。
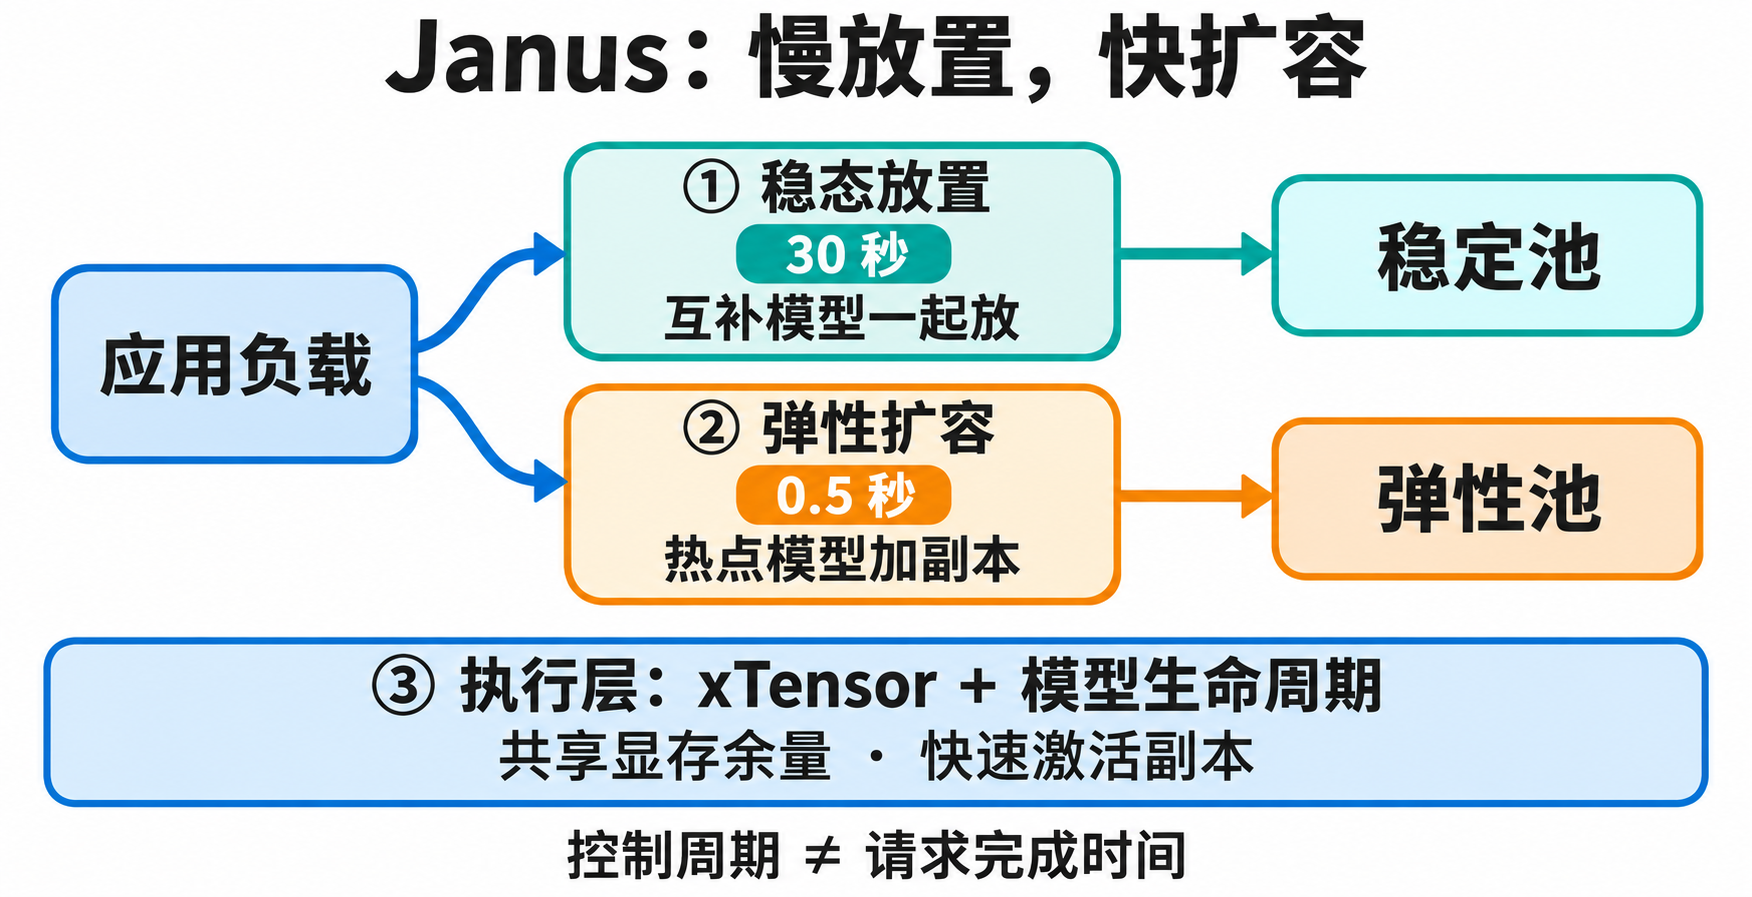
上路把互补模型放进稳定池,追求长期省资源;下路给热点增加弹性副本,追求及时补容量。底部 xTensor 与模型生命周期管理负责让空间真能回收、副本真能恢复。两条路径分开决策,却不能脱离底层能否执行这个共同约束。
2. 把“省卡”和“救火”拆开,但不能让两边各算各的
LLM 推理先做 prefill,把整个输入 prompt 并行处理,随后逐 token decode。前者通常更吃计算,后者频繁读取权重和历史 KV Cache——也就是复用 attention 中间结果的键值缓存——往往更受内存带宽限制。
所以,同样叫“一张卡”,里面至少有三笔账:HBM 高带宽显存的容量、计算资源、HBM 带宽。一个应用显存占得多,不代表算力也占得多。只按卡数平均分配,会错过不同模型之间的互补空间。
先看下面总览图的左下角,两条路径分别决定混部与扩容;再往右看它们落到什么执行环境。上方 Oracle 给计划提供性能预测,右上角 Request Scheduler 才负责分发具体请求。
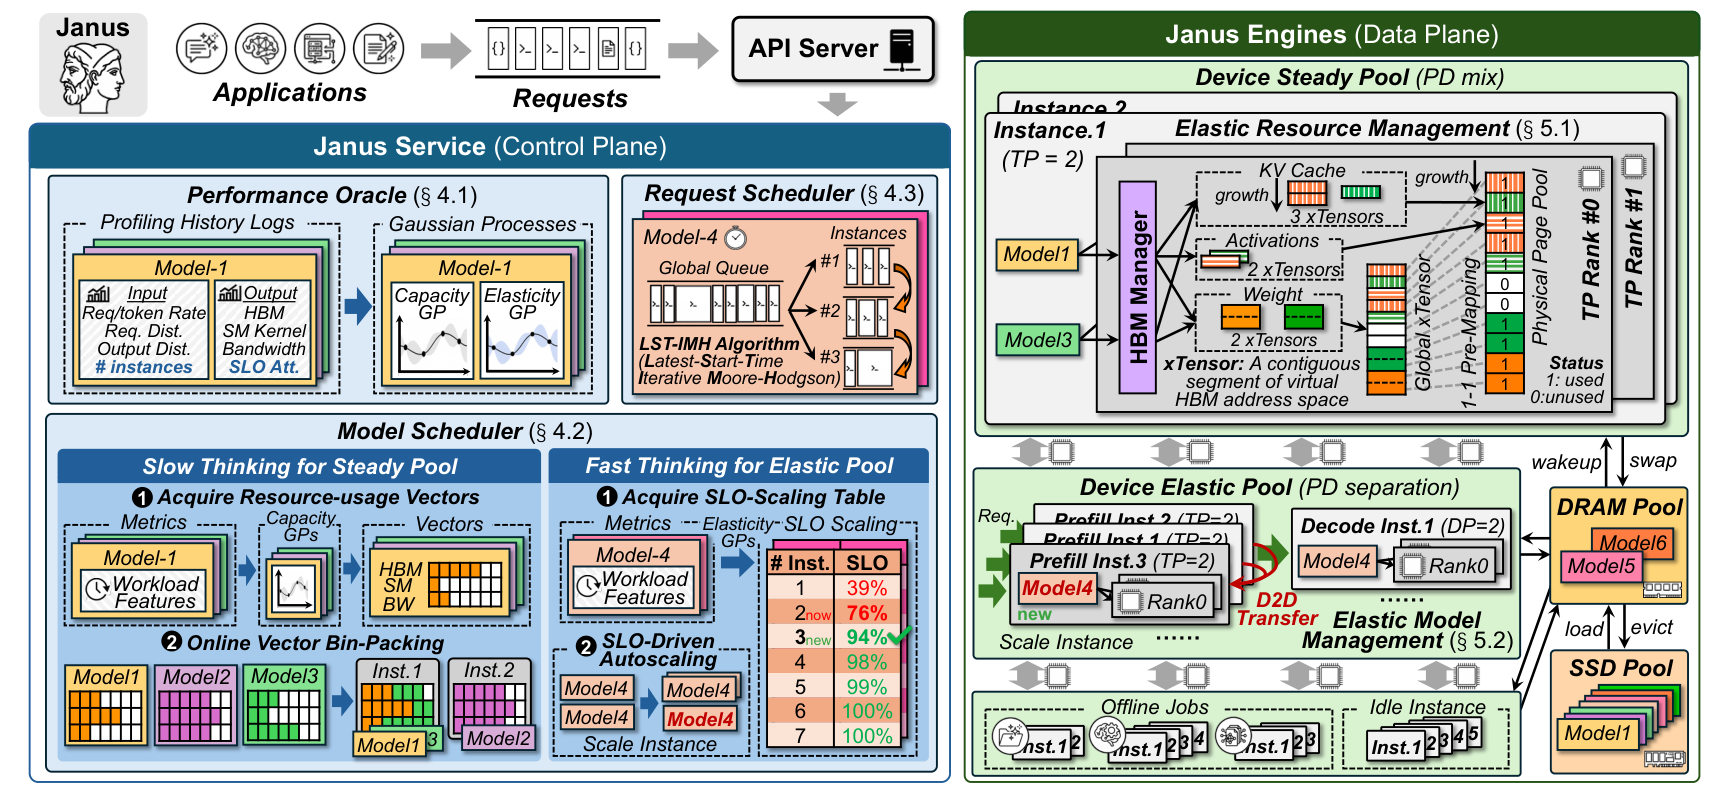
左下的慢路径每 30 秒做一次稳态整理,把互补模型放进 Steady Pool,稳定池。右下的快路径每 0.5 秒检查热点模型需要多少实例,调节 Elastic Pool,弹性池。这里的快慢是控制决策的周期,不是让某些用户的请求故意“慢思考”。
右边把两者的区别画得更具体:稳定池允许一个实例混部多个模型,prefill 和 decode 混合执行;弹性池的每个实例专属一个模型,并采用 P/D 分离,即把 prefill 与 decode 放到不同实例,方便分别扩展。图里的 TP 是 tensor parallelism,把同一模型的张量计算拆到多个设备;DP 是 data parallelism,用副本处理不同请求。
沿着一条请求走:API 接入后进入该模型的全局待处理队列;模型调度器决定有哪些可用实例;请求调度器结合各实例的忙闲和 deadline 选择去向;Engine 真正完成计算、维护 KV、回传 token;运行时遥测再反馈给 Oracle。放置决定单实例容量,扩容决定总容量,路由必须尊重前两者。 三个模块独立做局部最优,结果可能是把请求送到“计划上有容量、实际上还没准备好”的实例。
论文按流量大小与波动性把易突发应用预先隔离到弹性池,不是等流量爆了才希望 30 秒后的全局整理救场。稳定池优先保留资源,因为撤掉一个混部实例可能影响多个模型;弹性池用余下预算,资源不足时允许降低副本数。这也说明它不是一个承诺所有租户同时满足目标的魔法调度器。
3. 两个 Oracle,分别回答“占多少资源”和“加几份才够”
Performance Oracle 这个名字听起来像知道未来,其实就是性能预测器。Janus 为每个模型维护两类高斯过程回归模型,简称 GP:用有限的 profiling 测量学习输入到输出的关系,同时提供预测不确定性。
它们不能混成一个模型来理解。Capacity GP 给慢路径预测资源向量;Elasticity GP 给快路径预测 SLO 达标率。 SLO 是服务级别目标,比如首个 token 等多久、后续 token 间隔多久。
论文描述的输入来自近期滑动窗口:请求率、token 率、输入和输出长度的均值与方差。Capacity GP 输出归一化的三维需求:
\[\mathbf v_i=(v_{i,\mathrm{HBM}},v_{i,\mathrm{compute}},v_{i,\mathrm{BW}}).\]用一个人为构造、只为解释的例子:模型 A 需要 $(0.65,0.15,0.20)$,模型 B 需要 $(0.20,0.55,0.30)$,相加为 $(0.85,0.70,0.50)$,三个维度都没超过 1,可以尝试放一起。另一个模型即使计算需求很低,只要叠加后的显存需求超过 1,就不能硬塞。
慢路径不仅检查装不装得下,还偏好让剩余资源更均衡的组合。补充材料用一个势函数衡量三维资源的失衡:
\[\Phi(\mathbf x)=\left\|\mathbf x-\frac{x_1+x_2+x_3}{3}\mathbf 1\right\|_2^2.\]三项差不多大,势就小;只剩大量算力、显存却没了,势就大。新模型进入时,在可行位置中选择让势变化更小的地方;模型离开破坏互补关系,超过损伤阈值才局部重排,另有 30 秒一次的全局合并。目的不是每次变化都重做一遍全局优化,而是控制迁移成本。
附录对重排次数和箱数给的是带假设的均值场分析:泊松到达、独立指数寿命、非对抗需求,以及近似稳定的剩余资源统计。不能把其中的常数级重排和接近单位的箱数开销,写成任意生产流量下的最坏情况保证。实验里匹配精确求解器箱数的比例达到 99.99%,那是这条 trace 上的经验结果。
快路径不再问资源向量,而是把实例数 $m$ 也作为输入,预测当前负载下的达标率 $\hat s(\mathbf z,m)$。给定目标 $s_{\mathrm{target}}$,寻找:
\[m^*=\min\{m:\hat s(\mathbf z,m)\ge s_{\mathrm{target}}\}.\]比如预测两个副本 76%、三个 94%、四个 98%,目标若是 95%,就应该要四个。这是仿照图中预测表解释选择规则,不是新增实测数据。二分搜索隐含“实例增加,预测达标率不下降”的单调性前提;普通 GP 本身并不自动给出这个性质,源码也把它写成假设。
当各应用目标之和超过预算,论文按比例压缩,再用最大余数法把小数配额变成整数;同时对最近两次计划做防抖,避免副本数在阈值附近来回跳。这里优化的是有限资源下的折中,而不是扩容后必然达标。
预测器也会错。Elasticity GP 的达标率预测绝对误差中位数为 2.5 个百分点,P90 达到 19.0 个百分点。容量预测中,显存误差小,计算和带宽的 P90 相对误差分别为 24.18% 与 23.24%。所以它依赖遥测闭环和保守余量,不能把预测表当物理定律。
源码还提供了一个重要提醒:固定提交的 GPSteadyResourceModel 实际用三个特征——token 率、输入均长、输出均长;动态模型用 token 率、两个长度统计量和实例数。论文机制描述与公开实现的特征接口不完全一致。 30 秒重排、500 毫秒扩容循环能找到对应实现,但不能据此说论文的整个预测流程已经逐项复现。
4. 副本有了,请求也不能一股脑送给最空闲的那台
请求长度不同,先来先服务会让长 prompt 挡住很多短请求;只找负载最低的实例,也不知道队列里哪些请求快到 deadline。Janus 因此为每个模型保留全局队列,估算每个 prefill 实例什么时候做完当前工作,称为 EPDT,即预计 prefill 完成时间。
论文描述在实例接近可用、进入约 20 毫秒的提前量时,统一重看 backlog。每个请求 $j$ 有预计处理时间 $p_j$ 和截止时间 $d_j=a_j+\mathrm{TTFT}_{\mathrm{SLO}}$,其中 $a_j$ 是到达时刻,TTFT 是从提交到第一个 token 的延迟。问题变成:实例从各自的可用时刻 $T_i$ 开始工作,怎样让最多请求按时完成?
LST-IMH,全称 Latest-Start-Time Iterative Moore–Hodgson,把它拆成一连串单机问题。按论文和附录,先处理 $T_i$ 较大的实例,也就是较晚才能腾手、可选请求更受限制的机器;每台机器上的有效 deadline 减去 $T_i$,再运行 Moore–Hodgson。
这个单机算法的动作很朴素:按 deadline 从早到晚排,逐个纳入;一旦总耗时超过当前 deadline,就从已纳入请求里删掉耗时最长的那个。它不是简单“永远先做短请求”,而是在截止时间约束下,用一次删除给更多请求腾出机会。
走一个完整的小例子,以下数字都是教学构造。当前有三条请求 A、B、C,$(p,d)$ 分别是 $(4,5)$、$(2,6)$、$(2,7)$,单位毫秒;两台机器分别从 $T_1=3$ 和 $T_2=0$ 开始可用。
先排较晚可用的机器:加入 A,完成时刻为 7,超过 A 的 deadline 5,移除 A;加入 B,完成时刻为 5,保留;再加入 C,完成时刻为 7,也保留。剩下 A 交给另一台机器,从 0 到 4 完成。三条全部按时结束。一台机器这轮不收的请求,要交给后面的机器再试,不是立刻丢弃。
附录证明它至少完成最优解一半的按时任务,也就是 2-近似。证明的关键不是机器排序,而是每一轮单机子问题都选出最大数量的可行请求:最优解分给这台机器、且尚未被算法取走的请求,是一个可行候选;逐台累计后,可以把最优解中漏掉的数量界在算法已选数量以内。
这个保证有明确边界:针对当前已到达的有限 backlog、固定且准确的处理时间、同速并行机器只在可用时刻上不同、非抢占串行作业、最大化无权任务数量的抽象问题。它不保证持续在线到达时的全局最优,不保证 batching 或混部干扰下的处理时间准确,更不直接保证 decode 和逐 token SLO。
下面左图看首 token 达标率,右图必须一起看失败比例。绿色是不重新入队,红色是放宽 deadline 后重试,不能只盯着最高的那条线。
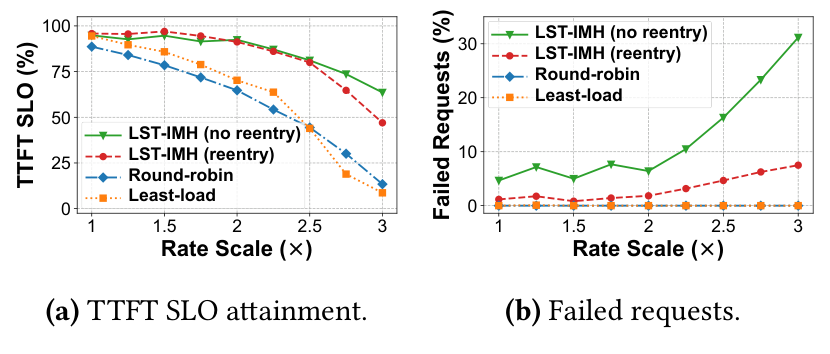
在两倍请求率时,论文报告不重入队达标率 92.4%,重入队 91.2%,轮转分发和最小负载分别为 64.8%、70.2%。到三倍负载,两种 LST-IMH 分别为 63.6%、47.0%。右图解释了差别:不重入队拒绝更多难以按时完成的请求;重入队减少失败,但不能把延后完成算成满足原始目标。
还有个不能略过的源码差异:公开 LstImhPolicy::run_lst_imh 按可用时间升序处理,每台只取单机结果中的第一条,而不是论文里的降序和整个子集;其 coordinator 还会保留未分配请求,等待或扩展 deadline,decode 路由采用轮转而非论文描述的最小 backlog。机器顺序不影响附录的半最优界,但每轮只取一条已经改变了证明依赖的算法。因此这里讲的是论文算法和实验,不能给当前滚动派发代码直接盖上同样的理论保证。
5. 上层敢动态调,底层先得把显存从模型手里拿回来
如果每个模型各自启动进程、预留一大块 KV 空间,上层再聪明也很难借用这些空闲资源。xTensor 的作用就是把“模型看到的 tensor 地址”和“底下真正占用的物理显存页”拆开。
下面这张图先看上半部:所有模型从统一物理页池取资源,但权重与短生命周期数据走不同路径;再看下半部,不同 runtime 保留自己的执行流,共用内存管理器,生命周期操作由 Service 发起。
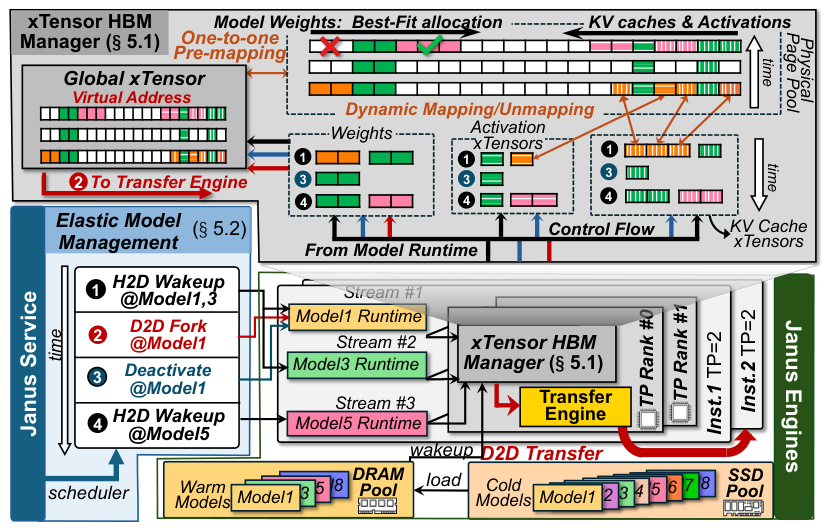
上半部左侧 Global xTensor 是预映射的大虚拟地址区;权重在里面预留连续片段。右侧 KV 与 activation,也就是计算过程中的激活中间值,按需映射、回收。图中两个方向的增长,表达的是不同寿命的分配尽量分开,不是权重和 KV 各有一块永远不能互借的固定显存配额。
为什么权重不跟 KV 一样现用现映射?论文测得每个 2 MB 页 map/unmap 分别约 37/235 微秒,大模型逐页处理会把生命周期操作拖到秒级。权重稳定且大,于是启动时把 Global xTensor 的页映射好、向通信后端注册;后面主要做片段预留、释放和数据恢复。KV 细碎且频繁变化,每个模型保留已映射页缓存,普通申请从缓存走,缓存不足才由后台补映射,避免把驱动操作塞进每条请求的热路径。
按正文更具体的说明,权重取物理页池的高编号端,KV/activation 取低编号端。论文为权重描述 best-fit,即选择最合适大小的空闲片段;但所查源码 allocate_contiguous_from_right 是从右向左找首个够长的连续区间,不是可直接确认的 best-fit。连续区不足时,另建虚拟区映射非连续物理页的 fallback 能找到实现。地址连续不等于物理页必须始终连续,更不等于没有碎片。
数据在两类实例间传递也因此受影响。P/D 分离要让 prefill 把 KV 写到 decode 已分配的位置;刚创建的虚拟 KV 块若尚未绑定物理页,不能照常拿它注册远程访问。Janus 预注册 Global xTensor,查到 KV 对应的物理页编号,转成全局区域内的偏移,再用“基址+偏移”定位目标。它改的是底层地址翻译,不是重新定义 attention。
计算共享则靠每个模型独立的 stream,让硬件交错执行不同模型的 kernel,不要求特定厂商的进程或硬件切分能力。但 stream 并发不是强隔离;共享带宽、算力和缓存时仍可能互相干扰,前面的资源预测也不能替代执行层的正确同步。
下面实验先沿左图看错峰 burst 时的达标率,再看中间 P99 首 token 延迟,最后看右侧持续分配回收造成的碎片。三个面板都保留下来,才能看清它究竟改善了什么。
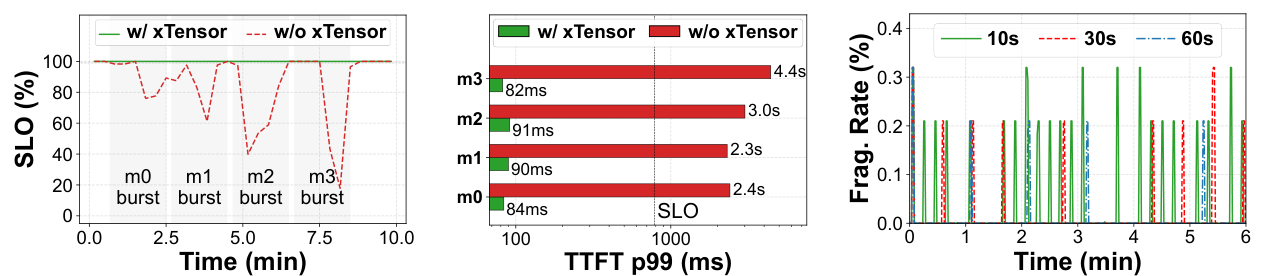
四个 1.7B 模型同卡运行,不用 xTensor 也没有显存溢出,但左图会在 burst 时掉达标率;动态共享则保持 100%。中间对应的 P99,即 99% 请求不超过的延迟,分别从无共享时的 2.3–4.4 秒降到 82–91 毫秒。症结不只是“能否装下”,还包括 KV 容量能否随负载变化及时重分配。右图显示碎片长期维持在约 0.3% 的量级,没有持续累积失控;这仍只是所测周期与负载下的结果,不是一般性零碎片承诺。
6. 0.74 秒激活 671B 副本,不是从硬盘冷启动一个新进程
模型生命周期和实例生命周期解绑之后,才有进一步压缩等待时间的空间。一个实例的资源池和基础设施可以长期存在,里面的模型却切换不同驻留状态:
| 状态 | 权重在哪里 | 保留什么、恢复要付什么成本 |
|---|---|---|
| Active | HBM | 直接在线服务 |
| Warm | 主机锁页 DRAM | 保留通信组、运行时元数据与框架上下文,走 H2D 恢复 |
| Cold | 持久存储 | 释放权重、KV 和通信组,仅留最小框架状态,需要重新加载 |
从 Active 撤下不是粗暴释放指针:先排空在途请求,确认没有 kernel 继续访问,再回收 KV 页和权重片段。Warm 需要主机有可用权重副本;已有则复用,没有则从存储恢复到锁页内存。Cold 进一步释放这份 DRAM 占用。三态是资源保留程度不同,不是换三个名字表示“进程还在”。
日常恢复走 H2D,即 host-to-device,从主机锁页内存异步搬大块权重到设备。突发扩容走 D2D,即 device-to-device,从一个在线副本所在设备直接拉权重。名字叫 fork,但不是操作系统式写时复制,不共享一份权重跨卡执行,也不是把源实例的请求与 KV 状态克隆过去。
完整扩容链路是:Service 选中目标实例,准备模型上下文和权重空间;源实例提供权重在 Global xTensor 中的偏移或分段信息;目标通过 Mooncake 传输引擎拉取数据,写进自己已分配的权重区域;恢复模型的设备侧权重视图,随后接收新请求。源码可核对到预注册、分段拉取和恢复视图这几步,且目标权重区必须先准备好。
下面左图把整个突发窗口放在一起,先看 burst 出现后的低谷持续多久;右图再看“借别人搬权重”有没有影响源实例。
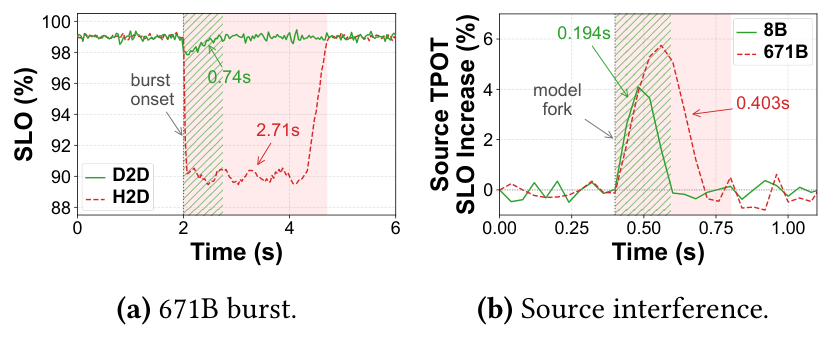
671B DeepSeek-V3 在 TP=16 的配置下,论文报告 D2D 副本恢复约 0.74 秒,H2D 为 2.71 秒;左图的达标率分别维持在约 98% 与短暂跌到约 90%。但表 1 明确隔离测量的是传输延迟,图中又将同组数字标作副本恢复;原文不足以确认 0.74 秒覆盖前面全部目标准备和控制面步骤,不能把它升级成完整扩容时延。
右图也不是说完全无干扰:源端 P99 的 TPOT,也就是后续输出 token 的时间开销,671B 最大增加 5.7%,8B 最大增加 4.0%,随后恢复。图里的 403/194 毫秒来自另一组源端干扰实验,不能与左侧恢复数字直接混用。
0.74 秒成立的前提很强。实验在 CloudMatrix 384 超节点,768 个“设备”按 Ascend 910C 的 die 计数,每个模块有两个 die,不是 768 张普通 GPU 卡。实测单设备单向 D2D 163.6 GB/s,H2D 59.0 GB/s,且高速互联覆盖超节点内跨服务器通信。TP=16 也意味着权重分布在多个设备上,不是一个设备串行读完 671B 全部权重。
它不能直接外推到跨机架普通以太网,更不能把“500 毫秒控制周期+亚秒级激活”理解成任意 burst 都在一秒内恢复。双池消融里从冲击到指标恢复仍用了约 9 秒,队列消化、检测、预算和实际执行都有成本。
公开代码的边界还要再收一道:远程权重 wakeup 在 USE_NPU 路径下实现,并明确不支持同时启用 rolling load;其他设备分支会返回不支持。论文说核心机制具备可移植性,不等于该提交所有硬件后端都已经打通。模型的 TP/DP 度也在创建时固定,扩副本不是在线把 TP=2 无缝变成 TP=4。
7. 结果确实漂亮,但必须把回放与指标口径摆在一起
论文的生产环境一天处理 4560 万请求;端到端对比并不是让四个系统各完整处理这一天。它按比例采样约 60.3 万请求,再把 24 小时时间轴压到 30 分钟,保留应用身份、顺序、输入输出长度与相对时间关系。回放平均到达率约为原始生产日的 0.64 倍。
这是 open-loop,即按照既定时间独立发请求,不等前一条完成再发下一条。这样系统慢下来不会自动降低输入压力,错误和超时也计入未达标,比“跑慢了就少送请求”更有比较意义。但采样与压缩保留的是归一化流量形状,不等于原封不动复现生产中的每一段队列演化。
还有一处容易踩坑:导论把 SLO attainment 概括成请求是否同时满足目标,实验 §7.1 却明确使用逐 token 的按时比例。本文端到端的 0.97–1.0 按后者理解。若第 $i$ 个 token 相对请求提交的送达时刻为 $t_i$,按时条件是:
\[t_i\le\mathrm{TTFT}_{\mathrm{SLO}}+(i-1)\mathrm{TPOT}_{\mathrm{SLO}}.\]失败请求的全部 token 都计为未达标。TTFT/TPOT 各自达标率则按请求统计;goodput 是满足端到端目标的请求速率,越大越好。97% token 按时,不自动等于 97% 请求的所有 token 都按时。
下面左边自上而下是负载、有效吞吐、活跃设备数;右边是三个达标率。先锁定约第 11–13 分钟的负载跃升,再横向对齐看各系统反应。
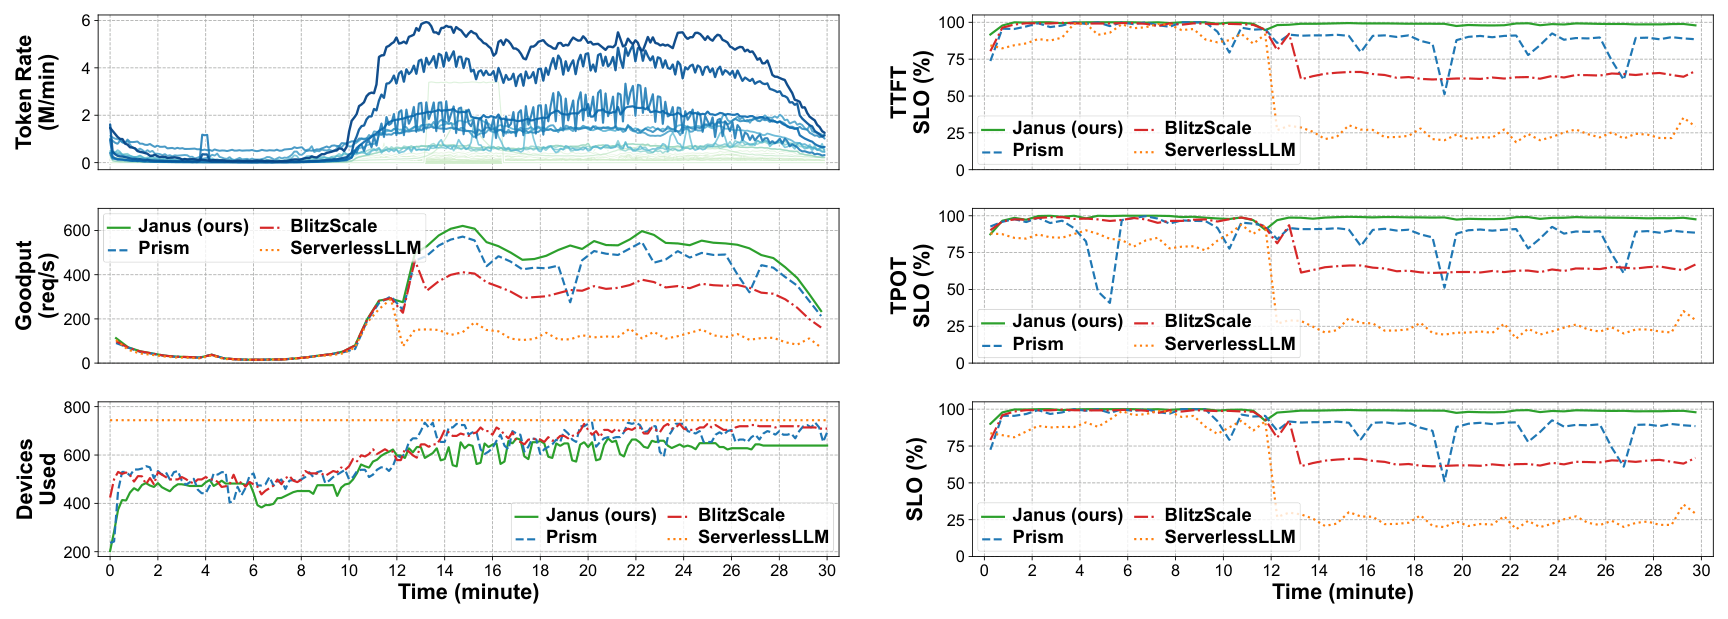
论文正文报告 Janus 的整体达标率为 0.97–1.0;不过图中初始阶段及负载跃升附近仍可见短暂低谷,后者约跌到 90% 附近,再恢复到接近 100%。正文与图在“全程下界”上并不完全一致,不能把 97% 当作这条曲线已验证的逐时刻保证。 白天阶段 goodput 约 400–500 请求/秒,峰值约 620。Prism 白天通常为 0.80–0.92,并有周期性重排造成的下跌;ServerlessLLM 在本文静态分区配置下更差。设备曲线则说明 Janus 不是靠始终占满资源换取达标。
论文报告日归一化设备用量 13,440 device-hours,对照静态 ServerlessLLM 的 $768\times24=18,432$,约省 27%。这是活跃设备时间,不是直接测出的电费或端到端云账单。固定提交 README 写的 24% 和 17,856 与正文不一致,这里采用论文口径,不把两份数字拼起来算。
对照配置同样重要:ServerlessLLM 被均分并静态绑定应用,Prism 有固定总池内的周期放置,但不能运行时重分配应用设备预算;BlitzScale 用原生逐应用扩缩容。结论是整个平台的资源协调更强,不宜概括成所有场景下某个局部加载算法全面胜出。
作者也给 Prism 加了 Janus 的全局分配器:应用平均达标率从 92.7% 升到 97.6%,但最差应用仍只有 57.2%;完整 Janus 平均为 99.4%、最差为 90.0%。这说明全局分配贡献很大,但突发时的尾部保护还依赖快速激活和混部机制。另一个五应用双池消融中,完整方案为 97.8%,只有弹性池为 59.0%,只有稳定池为 37.1%,两条路径确实各解决了一半问题。
8. 总结:真正连起来的是决策速度与资源可操作性
Janus 最值得借鉴的不是“又加了一个调度器”,而是它承认不同问题不该用同一个节奏处理。长尾模型靠互补放置省资源,热门模型靠专属弹性副本承接突发;Oracle 估容量,请求调度器挑可行任务,xTensor 和模型状态管理把计划落实到物理资源上。
但这套方案也有清楚的代价:需要可信的性能预测、能快速搬权重的互联、足够可用的目标空间与预先准备的运行时;过载时会做拒绝与延后之间的取舍,而不是凭空变出容量。附录的调度保证依赖简化作业模型,不能包办实际系统里的预测误差、公平性和在线到达。
源码可读是好事,读完发现它与论文算法存在差异也同样有价值。这里尚未核验成一致的部分,就应留在“论文机制”这个层级,而不是写成已经跑通、已经证明的工程事实。
把空闲资源变成别的模型真正能用的容量,再让它在 deadline 之前到位——这比只把卡的平均利用率涂高一点,难多了。
顺带一提,想沿着“模型怎样更省资源”继续往下看,可以看看《动手学 AutoML:从 NAS 到大语言模型优化实战》。书里讲 NAS、LLM 压缩、模型融合和剪枝实战;与本文目标相邻,但不覆盖 Janus 的集群调度、xTensor 或 D2D 扩容工程,别把它当这篇论文的配套实现教程。
