2026 综述解读 | 从零理解 Physical AI:LLM 与 Agent 如何真正走进物理世界
2026 综述解读 | 从零理解 Physical AI:LLM 与 Agent 如何真正走进物理世界
原文:Physical AI: A Survey of Models, Learning, Systems, and Open Challenges,本文依据 arXiv v1 解读。
阅读路线:第 1—4 节从收拾杯子的例子建立基础;第 5—10 节解释模型、数据、学习、控制和系统;第 11—14 节讨论评测、安全与可行的研究路线。熟悉机器人学习的读者可以先读第 5、10、13、14 节,再按需回看。
1. 让 AI 写一段收拾桌面的计划,和让它真的收拾桌面,差了什么?
桌上有一个杯子,旁边放着电脑。你对 AI 说:“把杯子收进柜子,别碰到电脑。”
如果只是生成文字,这个任务不难:
找到杯子,伸手,抓住,抬起,移动,打开柜门,放进去。
但把同一句话交给一台机器人,问题就开始长出来了。
杯子是空的还是装着热水?把手被挡住了,从哪边抓?夹爪已经闭合,是抓住了杯子,还是两个手指在杯子旁边碰到了一起?刚才拍照时杯子在左边,现在被人挪走了怎么办?拿着杯子时网络断了,是停住、放下,还是继续执行缓存里的动作?
更麻烦的是,上一动作会改变下一动作面对的世界。 一次没抓稳,可能让杯子滑到桌边;一次错误移动,可能让电脑挡住相机。后面的步骤不能继续假装一切正常。
Physical AI,物理人工智能,要处理的就是这一类问题:让系统通过传感器感知物理世界,作出决定,通过身体行动,再根据实际发生的结果调整下一步。
它不是某个模型的名字,也不只指人形机器人。机械臂、移动机器人、无人机、自动驾驶系统,都涉及物理交互。这篇综述主要讨论机器人系统,所以本文也以机器人为主,不把一个机械臂上的实验直接推广到所有 Physical AI 场景。
这篇综述最有价值的地方,是把模型放回了完整的物理交互闭环。 模型当然重要,但感知、控制、计算、验证和恢复中的任何一处断掉,都可能让一个“看起来很聪明”的系统无法完成任务。
前半篇先把这套闭环讲清楚。后半篇再讨论:LLM,也就是从大量文本中学习语言与知识的大语言模型,以及能够围绕目标反复观察、决策、调用工具的 Agent,究竟给这套系统带来了什么新东西。
可以先用这张导航表建立全景。每一行都是闭环中的一类问题,横向对应到同一个抓杯任务;它们不是必须依次运行的八个模块。
| 综述分支 | 抓杯任务里的具体问题 | 本文位置 |
|---|---|---|
| 信息、表征与记忆 | 看到哪个杯子?位置还有效吗? | 第 2—3 节 |
| 预测、规划与动作模型 | 会发生什么?选什么?具体怎么动? | 第 5—7 节 |
| 数据 | 哪些来源能教会这台机器人抓杯子? | 第 8 节 |
| 学习与适应 | 模仿、纠偏和奖励各补什么? | 第 9 节 |
| 身体与控制 | 夹爪够得到、拿得住吗? | 第 4、10 节 |
| 计算系统 | 算完时杯子是否已经移动? | 第 10 节 |
| 评测 | 真的独立完成了吗,付出了多少成本? | 第 11 节 |
| 安全与开放挑战 | 能否及时阻止错误,并持续改善? | 第 12—15 节 |
2. 从一只杯子开始,建立 Physical AI 的最小闭环
2.1 身体、传感器、模型、控制器,各自负责什么?
机器人首先需要一个身体:机械臂能伸多远,关节能转多少度,夹爪能夹多宽,负载有多大。这些条件决定它能做什么。
身体上或环境里有传感器。相机提供图像,关节编码器测量关节角度,力传感器测量受力,触觉传感器提供局部接触信息。它们给出的是测量,不是对整个世界的完整解释。
模型利用这些测量、任务指令和历史信息,选择下一步行动。机器人学习里常把“根据当前信息选择动作的规则”叫作策略,policy。这个规则可以是神经网络,也可以和人工设计的规划逻辑组合。
控制器把模型给出的目标变成身体可以执行的驱动命令。模型可以说“夹爪向前移动两厘米”,控制器则要不断根据实际位置误差调整电机。
最后,执行器把电流、扭矩等变成真正的运动。杯子是否被抬起,要由新的测量来确认。
下面这张图分成三栏。先看左栏的任务与决策,再看中栏的物理执行,沿底部绿色箭头回到决策;右栏另画了一条经验更新路径,注意它和执行回路是分开的。
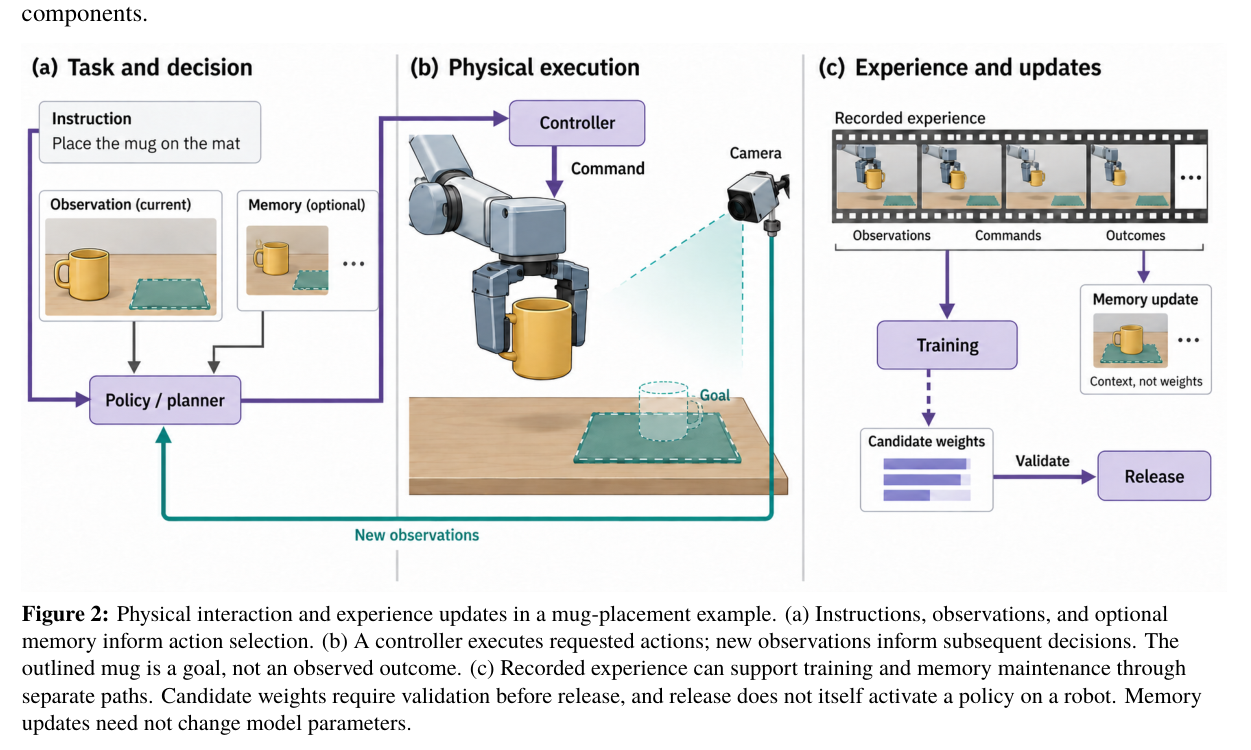
沿着左栏到中栏的箭头走一遍:机器人看见杯子,选择抓取;控制器驱动夹爪;夹爪碰到杯子;新观测回到决策;系统再决定继续放置,还是重新调整。图中明确画出相机反馈,实际系统还可以加入触觉等信息。虚线轮廓表示想达到的位置,不能当作杯子已经到了那里。
右栏则把交互记录拿去训练,得到候选模型,再验证、发布;旁边还有不改权重的记忆更新分支。运行时根据新观测调整行为,不等于运行时更新了模型权重。 把杯子的新位置记进记忆,也不一定需要训练。
这三个过程很容易混在一起:反馈改变下一动作,记忆保留新信息,训练改变模型参数。它们可以同时存在,但各自解决的问题不同。
2.2 “闭环”到底闭在哪里?
假设机器人一次生成未来一秒的动作,不再看相机就执行完。这一秒内,高层策略对新视觉信息是开环的:杯子被挪走,它可能还朝旧位置伸手。
如果每执行一小段就重新观察、再决定下一小段,就是闭环。
不过,“开环还是闭环”必须说明层级。高层模型一秒更新一次,底层控制器仍然可能一直读取关节位置,纠正电机跟踪误差。底层在闭环,不代表高层已经看见杯子被挪走。
系统有没有反馈,与反馈能不能及时改变相关动作,是两回事。
2.3 动作不是一句话,而是一组有单位、有坐标的数
举一个简化的机械臂接口例子。每一步输出:
\[a_t=(\Delta x,\Delta y,\Delta z,\Delta r_x,\Delta r_y,\Delta r_z,g).\]这里,$t$ 表示当前时刻;前三项是夹爪的位置增量,中间三项表示旋转增量,$g$ 控制夹爪开合。这个七维接口只是教学例子,不是所有机器人的统一标准。本例约定平移在底座坐标系中、单位为米,相对当前测得的末端位置;旋转采用底座坐标系下的小角度旋转向量、单位为弧度;$g=0$ 请求张开、$g=1$ 请求闭合。
例如,平移部分是 $(0.02,0,0)$,就表示请求末端目标沿底座坐标系的 $x$ 方向偏移两厘米。是否真的移动到那里,还要看执行结果。
“指定坐标系”这几个字不能省。如果夹爪朝向和机器人底座相差 90 度,沿夹爪的 $x$ 方向移动,可能相当于沿底座的 $y$ 方向移动。同一个数,物理效果完全不同。
再比如,“相对移动两厘米”,相对的是当前测得的位置、上一条目标位置,还是整段轨迹开始时的位置?连续执行十次时,这个差别就很大。
理解了这个例子,后面再看“统一动作空间”“跨机器人迁移”,就不会误以为把不同机器人的输出都补成一样长的向量,问题就解决了。
3. 机器人为什么比聊天模型更难“知道现在发生了什么”?
3.1 图像只是观测,世界状态藏在图像背后
相机拍到杯子,并不直接告诉你杯子的质量、摩擦系数、背面形状,以及杯底有没有粘在桌上。
这叫部分可观测:系统只能测到世界的一部分。
用两个符号区分会更清楚:$s_t$ 表示真实物理状态,$o_t$ 表示传感器观测。真实状态可能包含杯子的位置、速度、温度、质量和接触情况;相机只给出其中一部分信息投影到图像后的结果。
因此,策略往往不能只看一张图片,还要利用历史:
\[a_t\sim\pi_\theta(\,\cdot\mid h_t,G),\]其中,$\pi_\theta$ 是参数为 $\theta$ 的策略,$h_t$ 是截至当前可用的观测与动作历史,$G$ 是任务目标,与前面的夹爪命令 $g$ 分开记。符号 $\sim$ 表示从策略给出的动作分布中采样;确定性策略也可以直接输出唯一结果。
历史的作用很具体:单张图看不出杯子是否正在滑动,连续几帧可能看出来;一次触碰测不准重量,轻轻抬起后的受力变化可能提供线索。
但历史也不是越长越好。旧位置可能已经失效,冗余画面会增加计算,模型还可能学到“上一动作通常接着下一动作”的捷径,却忽略当前真正发生的变化。
3.2 语义、几何、接触,是三种不同的信息
“把红色杯子收起来”,首先涉及语义对应:把指令中的“红色杯子”对应到图像里的正确对象。这个过程常叫 grounding,可以理解成把语言落到具体物体和关系上。
选对对象之后,还需要几何信息:它离机器人多远,杯口朝哪,夹爪能从哪个方向进去。深度相机和点云可以提供三维线索。点云就是一组空间点,每个点至少有三个坐标;它记录看见的表面,不会自动补全被遮挡的背面。
手伸过去之后,又需要接触信息:是否碰到了杯子,碰在哪里,是否在滑动。视觉能看见夹爪靠近,但很难只凭画面确定夹持是否可靠。
下面这张图从左到右、从上到下分别放了目标区域、三维点云、身体与触觉信息、时间历史和任务记录。它们是互补的信息视角,不是必须依次执行的五个模块。
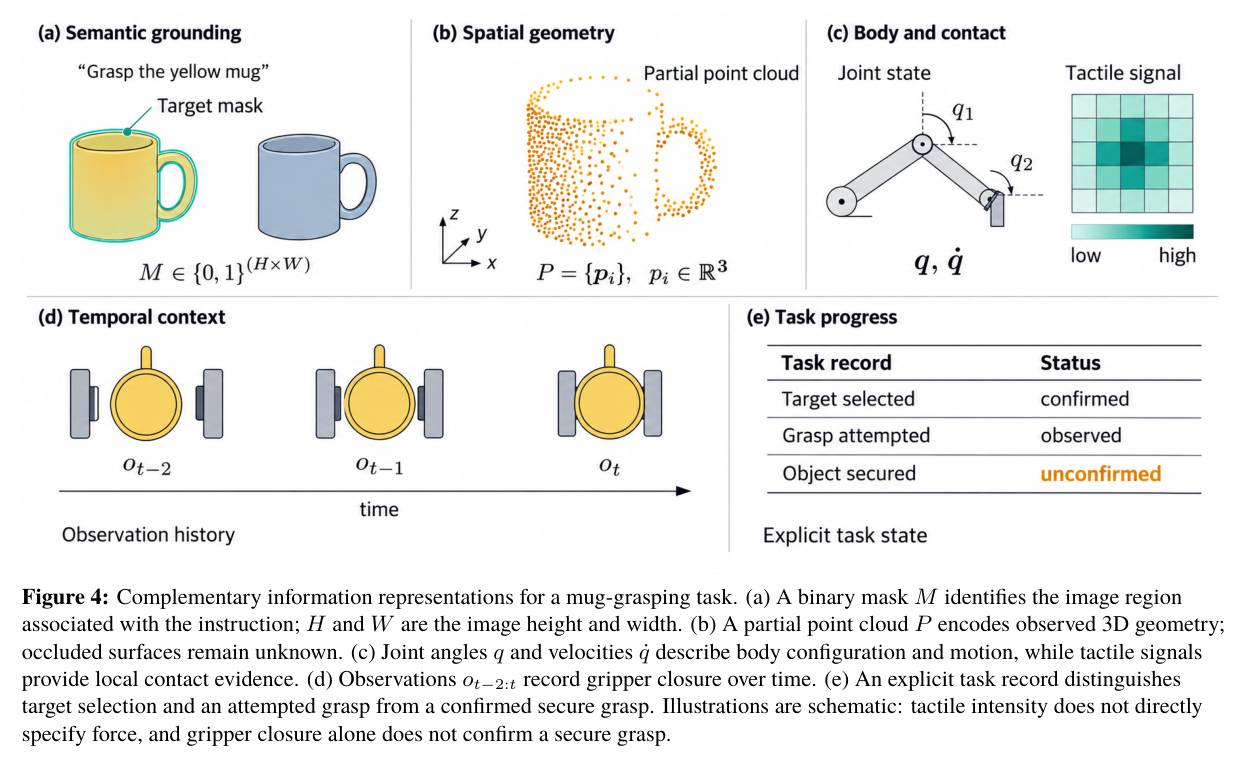
目标区域回答“抓哪个”,点云回答“在哪里、形状怎样”,关节与接触测量回答“身体现在怎样”,历史回答“刚才如何变化”。右下角的任务记录还要区分:已经选中杯子、已经尝试抓取、已经确认抓稳。
最后这个区分尤其重要。夹爪闭合是执行事实;杯子被稳定持有,才是下一阶段需要的任务事实。
3.3 任务状态比物理位置多了一层“事情做到哪了”
假设两个场景里的杯子位置完全相同,但一个洗过,一个没洗过。下一步动作可能完全不同。
所以还需要任务状态:哪些子目标已经完成,哪些前提还成立,剩下什么。
物理状态关心杯子在哪、手怎么动;任务状态还关心杯子有没有清洗、柜门是否已经打开、刚才的抓取是否经过确认。
而且,任务状态会被后续事件推翻。杯子曾经抓稳,后来滑落,就不能继续沿用“正在持有杯子”;杯子曾经洗干净,后来掉进脏水,也不能只记着那次清洗成功。
3.4 记忆需要有效条件,不只是检索相似文本
综述把记忆中的内容分成事件经历、空间信息和技能等,并强调记忆维护。
这与 LLM 里的检索增强生成有相似之处:需要时从外部记录找信息。但物理世界多了一个很尖锐的问题——检索命中,不代表事实仍然有效。
“十分钟前杯子在 A”可能一直是正确历史;“杯子现在在 A”却可能已经错误。
因此,位置记录需要时间与来源,技能记录需要适用身体和条件。相机没看见杯子,也要区分“那个位置被完整看见且确实空了”和“被遮挡所以没看见”。
从 Agent 的角度看,这是一个机会:记忆可以从“存了什么”进一步走向“这条信息在什么情况下允许参与决策”。后面讨论高级路线时会再回来。
4. 先有机器人技术积累,才有今天的 Physical AI
容易出现一种错觉:LLM 出现之后,机器人突然从写规则变成了学习。
实际并不是。LLM 之前,机器人已经有很长的技术积累。
运动学研究关节角度与末端位置之间的关系。例如,机械臂有多个关节,想让夹爪到达桌面上的某点,需要算出一组可行关节角度。
动力学进一步研究力、质量、惯性与运动的关系。同样的机械臂,空手移动和拿着重物移动,所需力矩不同。
运动规划寻找避开障碍、满足关节约束的运动路径。找到杯子不等于手臂能直线伸过去,中间可能隔着显示器。
反馈控制负责执行时持续修正误差。一个最直观的例子是:目标位置减去当前位置得到误差,误差越大就施加越大的纠正,再利用阻尼减小振荡。真实控制器还需要考虑稳定性、时延和驱动限制。
机器学习则逐渐进入感知、抓取、移动和控制:从数据中学视觉特征,从示范中学动作,通过奖励学行为。
今天的变化,是预训练模型把跨对象、跨任务、跨场景的知识带入了这套体系。通用知识的来源变宽了,但机器人仍然要满足运动学、动力学和反馈时限。
“用大模型取代一切”听起来很痛快,具体落地时却得回答:替代了哪个环节,新的误差由谁兜住,执行时限还能不能满足。
5. VLA、world model、Agent:先把这几个词放回各自的位置
5.1 三个问题,分别对应预测、规划与动作生成
面对同一个抓杯任务,可以问三个不同的问题:
| 问题 | 对应功能 | 可能的输出 |
|---|---|---|
| 如果从左边推一下,会发生什么? | 预测 | 杯子未来位置、图像或内部特征 |
| 左边推、右边抓、先开柜门,应该选哪个? | 规划与动作选择 | 技能、子目标或候选动作序列 |
| 下一小段究竟怎样移动夹爪? | 动作生成 | 可交给机器人接口的数值命令 |
这些功能可以共享一个模型,也可以由不同模块承担。有的策略直接从观测输出动作,并不显式生成未来,也不显式搜索计划。
原文这张图适合当作模型分支地图。先看三个功能框,再看虚线:虚线表示可能存在的依赖,不表示所有系统都必须沿同一条流水线运行。
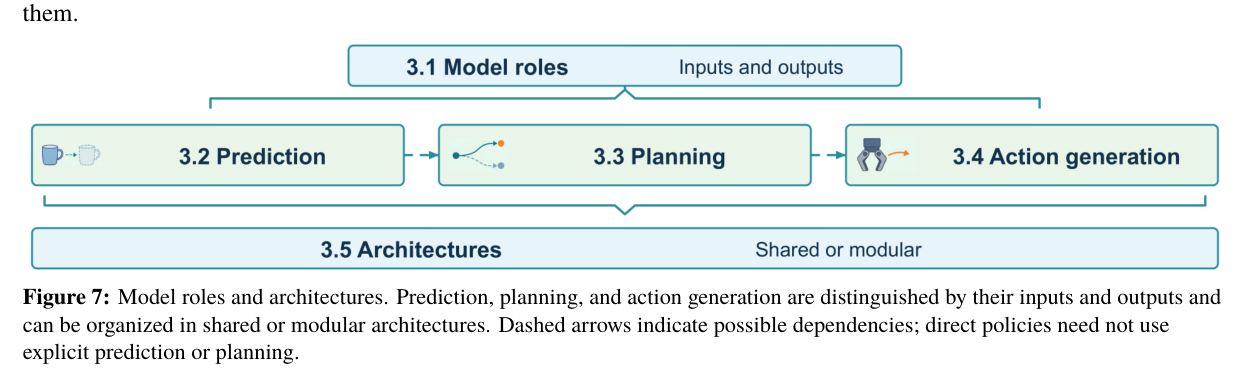
预测分支提供可能的后果,规划分支选择行动,动作生成分支给出具体输出。直接策略可以绕过显式预测和规划;共享架构也可以把几个功能装进同一个网络。判断一个系统属于哪类,关键是它的输入、输出和实际用途。
5.2 VLM 处理视觉与语言,VLA 进一步输出动作
VLM 是 vision–language model,视觉语言模型:把图像与语言放进同一套模型处理,例如根据图片回答“红杯子在哪”。
VLA 是 vision–language–action model,视觉语言动作模型:把视觉、语言知识连接到机器人动作输出。它是一类模型,OpenVLA、$\pi_0$ 等都是具体实例。
一个简化的数据流可以写成:
相机图像 + 指令 + 可选身体状态 → 特征编码 → 多模态主干 → 动作头 → 数值动作 → 控制器。
“特征编码”就是把图像、文字等转换成模型能处理的数字表示;主干负责整合条件;动作头负责把条件转换成动作。不同模型的组件、维度和连接方式不同,这里描述的是概念接口,不冒充某个实现的源码结构。
在一个教学设定里,假设一次预测 16 步,每步用前面讲的七维动作,那么输出形状可以是 [16, 7]。有两个机器人同时处理,就是 [2, 16, 7]。这三个维度分别是机器人批量、未来步数和每步动作维度。
这个例子说明:VLA 的输出可以是一小段连续运动,不一定是“抓杯子”这样一句自然语言,也不一定逐个生成文本 token。
5.3 World model 负责预测,不限于生成视频
World model,世界模型,在这里指学习物理世界如何变化、据此预测未来的模型。
它可以预测未来图像,也可以预测杯子的位姿,也就是位置与朝向,以及速度、接触等显式量,还可以预测 latent——模型内部的压缩特征,不要求每个维度都有可直接命名的物理含义。
三种选择的取舍很具体:
| 预测对象 | 直接好处 | 主要代价或风险 |
|---|---|---|
| 未来图像、视频 | 容易观察与解释,能利用视频数据 | 生成成本高,视觉逼真不保证接触正确 |
| 位姿、速度、接触等物理量 | 便于检查目标与约束 | 需要可靠估计,表示范围可能漏掉关键因素 |
| latent 特征 | 可以省掉渲染,紧扣下游决策 | 压缩可能丢信息,需验证特征距离是否对应任务差异 |
还有一个比“预测什么”更重要的条件:预测有没有以候选动作作为输入?
看过很多杯子掉落视频,学会“杯子可能向下掉”,与知道“这台机械臂施加这个动作后,杯子会怎样”,中间还差了干预与身体的对应。
一个简化的动作条件模型是:
\[\hat z_{t+1}=f_\phi(z_t,a_t).\]$z_t$ 是当前状态的内部表示,$a_t$ 是候选动作,$f_\phi$ 是学到的转移模型,帽子表示预测量。真实结果仍然要等新观测。
5.4 Agent 是系统组织方式,不能和动作头排成互斥路线
Agent 通常围绕目标,反复获取信息、选择步骤、调用工具、检查结果。落到机器人上,工具可以是抓取技能、导航模块、视觉查询或运动规划器。
因此,Agent 可以调用 VLA,也可以调用世界模型;VLA 内部可以用 diffusion 动作头;训练时还可以同时使用模仿学习和强化学习。
VLA 描述输入输出连接,world model 描述预测功能,diffusion 描述生成机制,RL 描述学习方式,Agent 描述系统如何组织决策与执行。
把它们列成“谁将取代谁”的几条平行路线,第一步就把问题分错了。
6. 从“会预测”到“会规划”,中间还差一次可靠的选择
6.1 LLM 拆任务,需要知道机器人究竟会什么
让 LLM 把“收好杯子”拆成几步,可以复用大量语言与常识知识。但计划里出现“打开柜门”,不代表机器人真的掌握了开这种柜门的技能。
SayCan 这类工作的关键是把语言相关性与机器人技能可行性结合起来:某技能是否符合当前指令,还要看它在当前状态下有没有希望执行。
这里的 affordance,常译为可供性,可以粗略理解成“当前身体与环境允许怎样使用或操作这个东西”。门把手能不能拉,不只看它像不像把手,还看夹爪能否够到、运动方向是否可行。
不过,可行性分数只是执行前的判断。是否已经完成,仍需要执行后的证据。
一个可靠的子任务交接应当是:
提出抓取 → 执行 → 观测到杯子被持有且抬起 → 检查搬运前提 → 开始搬运。
如果没有确认抓稳,就进入搬运,整段自然语言计划即使逻辑顺序正确,也会失败。
6.2 世界模型参与规划,至少有两种不同走法
第一种,先生成想达到的未来,再找实现它的动作。
例如生成“杯子已经在柜子里”的目标图,交给目标条件策略去实现;或者生成一段未来视频,再从相邻状态推断动作。后者常涉及逆动力学:通常的动力学是动作推后果,逆动力学则试图由前后状态恢复动作。
问题是,想象中的未来可能不可达;即便目标可达,恢复动作的模型也可能做不到。
第二种,先提出候选动作,再预测后果、比较好坏。
比如提出十条抓取路径,分别预测会不会撞电脑、能否稳稳抬杯,再选一条执行。执行一小段后重新观察,继续规划。
这对应模型预测控制,MPC:每次只向前规划有限时域,执行前缀,再用新状态重算。这里强调的是滚动规划方式,不要求所有 MPC 都使用神经网络世界模型。
用一个教学公式表达:
\[\mathbf a^\star =\arg\max_{\mathbf a} \sum_{k=0}^{H-1} \hat r(\hat z_{t+k},a_{t+k}).\]$\mathbf a$ 是待比较的候选动作序列,$H$ 是向前看的步数,$\hat z$ 是预测状态,$\hat r$ 是预测的任务收益。比如,杯子更接近目标可加分,接近电脑或发生碰撞应减分。真实规划还可能有终端价值和硬约束,这个式子只保留直觉。
6.3 预测画面好看,不代表规划有效
如果十条候选路径的预测都很逼真,但模型总把危险路径排第一,它就不是一个好规划器。
反过来,预测画面不够细腻,却能稳定区分“抓得住”和“会碰倒”,也可能非常有用。
因此,应该验证的不是单一视频质量,而是:相关候选的排序是否正确,预测能提前多远仍然可靠,搜索增加的计算是否让动作过时,以及它最终有没有改善真实完成率。
综述还区分了世界模型的几种用途:
- 在运行时搜索候选动作;
- 在训练时生成想象轨迹,训练策略;
- 作为预测辅助目标,让表征更有用;
- 预测未来特征,给动作模块提供条件;
- 生成数据或辅助评测。
训练时用过预测,不代表执行时必须生成未来视频。 部署是否依赖预测,是另一个设计选择。
这给资源受限的机器人留下了很实际的路线:训练时利用昂贵预测学习知识,部署时只保留便宜策略;或者只在高风险、分歧大的决策点调用预测。
7. 动作为什么要一次生成一段?diffusion 和 flow 又解决什么?
7.1 Action chunk 解决时间协调,但也改变反馈节奏
Action chunk 就是一次生成一小段动作,而不是只生成下一步。
拿杯子时,“靠近—闭合—抬起”有时间上的关联。整段一起预测,可以减少逐步决策的不一致,也降低大模型调用频率。
但必须分开两个数:
- $H$:一次生成多少步;
- $K$:在下次策略更新前,实际执行多少步,且 $1\leq K\leq H$。
假设 $H=16$、$K=4$,接口每秒执行 20 步,那么生成的总轨迹覆盖 0.8 秒,执行前缀覆盖 0.2 秒。不是等 0.8 秒才重新观察。
如果接口变成每秒 50 步,同样的 $K=4$ 只覆盖 0.08 秒。所以光写“chunk length=16”不足以判断反应速度。
原文下面的图把四种生成机制从上到下排开,把真正执行的物理时间放在底部。先看右侧共享的动作块,再回头看它可以由哪些路径生成。
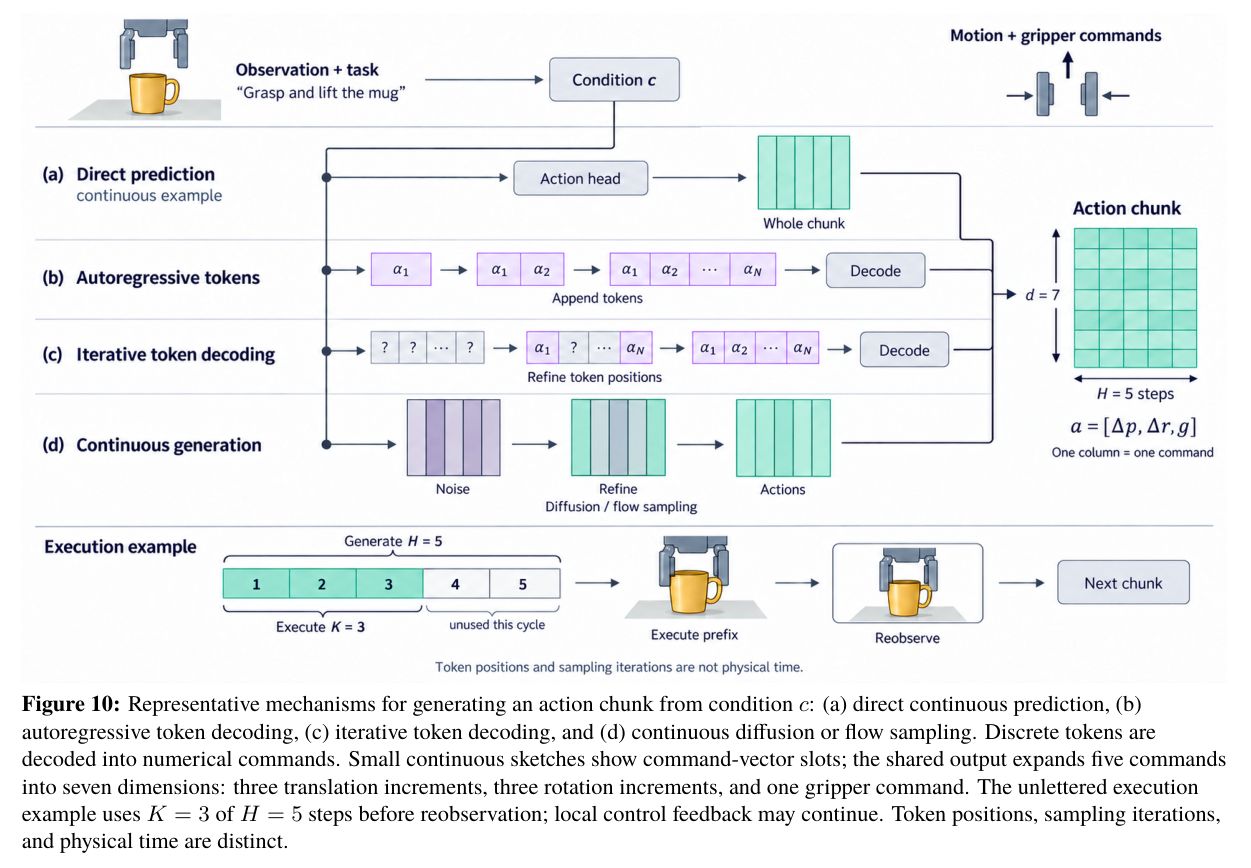
上面第一行直接预测数值,第二、三行分别通过自回归和迭代修改生成离散 token 再解码,第四行通过连续生成迭代得到动作。它们最后都可以交给右侧同一个 chunk 接口。底部示意一次生成五步,只执行前三步再重观察;局部控制反馈仍可以持续。
token 的位置、去噪迭代次数、机器人执行步数,是三根不同的时间轴。 把它们都叫“step”,读代码时很容易踩坑。
7.2 直接回归:简单便宜,什么时候会平均出一个坏动作?
最直接的方法,是让网络输出动作数值,用示范动作作为目标训练。
如果相同场景有两种可行策略:从障碍物左侧绕过去,或者从右侧绕过去,简单的平均误差目标可能偏向两种策略的中间。
偏偏中间就是障碍物(笑)。
这是行为分布存在多个有效模式的问题。“多模态”在这里指多种行为模式,和前面图像、语言、触觉这些输入模态不是同一意思。
但不能因此得出回归一定不行。如果指令、历史或上层选择已经明确了从哪边走,歧义大幅减少,直接预测就可能足够有效。
综述转述 OpenVLA-OFT 的 LIBERO 仿真结果:在所比较的单图配置中,L1 回归头与 diffusion 头平均成功率分别为 95.3% 和 95.4%。这里的成功率是按该基准任务定义完成的试验比例,越高越好。这个结果支持“简单头值得做匹配基线”,不支持“diffusion 在所有机器人任务都没有价值”。
7.3 离散 token:把动作编码成模型能预测的符号
一种办法是把连续值划成区间。例如,把 $[-1,1]$ 的某个动作分量分成 256 档,模型预测其中一个编号,再转换回数值。
token 就是这类离散符号。动作 token 不一定对应自然语言词。
如果七个分量、16 个时间步都各占一个 token,未经压缩就是 112 个 token。这个教学算例说明,动作表示会直接影响解码长度。
FAST 等方法沿时间方向压缩动作序列,再编码成更紧凑的 token。这里的关键是利用动作的时间结构,减少需要预测的符号数。
但离散不等于必须自回归。自回归表示后一个 token 依赖先前已生成 token;有的方法并行预测,有的方法反复修改 token。压缩 token 数与去掉串行依赖,也不是同一件事。
7.4 Diffusion:从噪声动作逐步修成合理轨迹
Diffusion,扩散生成,可以这样理解:训练时把示范动作加噪,模型学习在当前图像、指令等条件下去掉噪声;执行时从随机噪声动作开始,逐步修成一段动作。
它建模的是动作分布,有机会保留“左绕”和“右绕”这样的多种有效模式,而不是只给一个平均值。
代价是需要多次模型计算,而且生成出了轨迹,也不代表满足碰撞、力和稳定性约束。
7.5 Flow matching:学习从噪声走到动作的变化方向
Flow matching,流匹配,学习一条从噪声到动作的路径上“应该往哪个方向变化”。
用一个便于解释的线性路径:
\[x_\tau=(1-\tau)\epsilon+\tau a,\qquad \tau\in[0,1].\]$\epsilon$ 是噪声,$a$ 是示范动作序列,$\tau$ 是生成过程的进度。$\tau=0$ 时是噪声,$\tau=1$ 时是动作。模型学习这条路径的速度方向,采样时逐步积分,把噪声推向动作。
注意,$\tau$ 是生成过程的时间,不是机器人运动的物理时刻 $t$。这里的参数方向是教学约定,与某些论文反过来记的方式等价。
$\pi_0$ 这类 VLA 使用 flow 动作专家,把多模态条件变成连续动作序列。条件不变时,可以复用较重的主干特征,只反复计算动作部分。
不过,不要把 diffusion 和 flow 讲成“前者随机、后者一定确定而平滑”。二者在部分路径和参数化下有密切联系,实际差别还涉及噪声安排、损失权重与采样器。
需要多少生成能力,要和条件是否充分、任务是否真的存在多种策略,以及推理预算一起讨论。
8. Physical AI 的数据为什么不能直接照搬 LLM 的规模故事?
8.1 互联网知道杯子长什么样,但不一定知道机器人怎样抓它
文本与图像容易获得,机器人交互却需要时间、设备、场地和重置。
人类视频包含大量行为知识,但通常不带机器人动作标签。视频里人的手向前移动两厘米,不能直接复制成某台机械臂的关节命令。
不同来源能教会系统不同东西:
| 来源 | 比较容易学到什么 | 通常缺什么 |
|---|---|---|
| 图像与文本 | 物体、属性、语义关系 | 动作、接触和运动后果 |
| 人类活动视频 | 操作顺序、状态变化、行为线索 | 可执行机器人动作与身体对应 |
| 人体或手持工具运动记录 | 更明确的运动几何 | 目标机器人标定、可达性与控制映射 |
| 机器人示范 | 特定身体上的观测—动作关系 | 足够多的失败、纠偏与新场景覆盖 |
| 自主交互与人工接管 | 策略真正遇到的困难状态 | 专家标签、可靠结果核验与低成本重置 |
| 仿真与合成 | 可控覆盖、批量生成、部分完整状态 | 与真实接触、时延和执行结果的一致性 |
因此,“能不能利用互联网规模数据”要拆成:学语义、学时序、学物理预测,还是直接监督动作?越接近具体控制,动作对应的要求越高。
8.2 仿真有两种价值,也有几种不同的差距
仿真器是一个可交互的计算环境:给动作,计算身体与物体如何变化。它可以廉价地产生经验,也能在不损坏真实设备的情况下测试失败。
但仿真到真实的差距,sim-to-real gap,不只是画面不像。
还有摩擦、柔性、碰撞和传感器噪声不准,以及控制延迟、通信抖动和执行接口不同。
域随机化就是在训练中改变光照、物体质量、摩擦等条件,让策略适应一个范围,而不是只记住一套环境。它能提高覆盖,但变化范围要有意义;随机化纹理不能自动修好错误的接触模型。
数字孪生强调对某个真实系统建立对应的数字模型;另一种思路则构造大量相似但不完全相同的环境,学习跨变化能力。到底需要多精确,应由目标任务对哪些误差敏感来决定,不能只比画面真实感。
8.3 合成数据的关键,是改变观察后,动作标签还对不对
把杯子背景从白桌换成木桌,旧抓取动作可能仍然有效。
把杯子位置向右移动十厘米,却保持旧动作不变,标签就可能错了。
生成一段“抓取成功”的视频,也不意味着已经存在一条在真实机器人上可执行的动作序列。
因此,合成需要说明:改变了外观还是几何?动作是直接记录、变换得到,还是推断出来的伪动作?有没有执行验证?成功条件由谁检查?
原文的判断很实在:数据质量要看验证和下游真实表现,不能只看生成量。
8.4 失败数据不是脏数据,人工纠偏也不能算自主成功
一条失败轨迹可能非常有价值:它告诉系统什么状态容易滑落,以及如何恢复。
真正损坏的记录则可能是时间戳错乱、相机冻结、动作与观察错位。
至少要独立保留三种标签:记录是否完整,任务结果如何,动作由谁控制。
假设机器人第一次抓空,人接管调整,最后机器人自己放好。这个过程可以提供有价值的纠偏训练数据,但整个任务仍然包含人工帮助。
还有一个隐藏成本:恢复环境。抓取失败后,谁把杯子摆回来?奖励自动标注了,重置却每次需要人,数据闭环仍然不便宜。
对于行业落地,降低一次有效改进所需的人时,可能比提高每天生成的轨迹数更关键。
9. 模仿、强化学习、后训练与持续学习,各自补哪种缺口?
9.1 模仿学习:先把人做过的动作学会
模仿学习利用示范,学习在相似信息下采取相似动作。最直接的行为克隆,behavior cloning,就是把观测映射到专家动作。
问题是,训练时的状态和部署失误后的状态不同。
专家每次都把手伸到杯子旁边,训练数据就很少包含“手把杯子碰歪之后怎么办”。模型只要偏一点,下一步就进入没见过的状态,误差继续累积。
这叫状态分布偏移:策略自己造成了训练数据里很少出现的局面。
DAgger 一类交互式模仿方法,让学习中的策略进入自己的状态,再请专家告诉它应该怎样纠正,把这些数据加入训练。
因此,更强的动作分布模型和纠偏示范解决的是不同问题:前者改善“已有数据怎么拟合”,后者补上“失误后该怎么做”的缺失监督。
9.2 强化学习:不只模仿动作,还根据结果改进
强化学习,reinforcement learning,简称 RL,利用奖励来优化行为。奖励可以反映杯子有没有放好、是否碰撞、花了多少时间等。
它的吸引力是:未必要给每一步提供正确动作,可以从结果中学习更好的策略。
但奖励也可能设错。相机里的杯子看起来进了柜子,实际卡在门边;如果评分器只看“杯子是否从桌面消失”,模型可能优化出错误捷径。
奖励模型说成功,和物理任务真的成功,仍然要分开。
离线 RL 从已有交互记录里学习,难点是评估数据很少覆盖的动作;在线 RL 增加新交互,难点是真实尝试昂贵且有后果。
还有一条路线,在世界模型预测的轨迹里训练策略。它可以减少真实交互,但策略也可能学会利用世界模型的错误。短期预测、真实数据锚定和独立验证都很重要。
原文用下面这张图区分三种监督。看三栏各自在“比较什么”,比记算法名更有用。
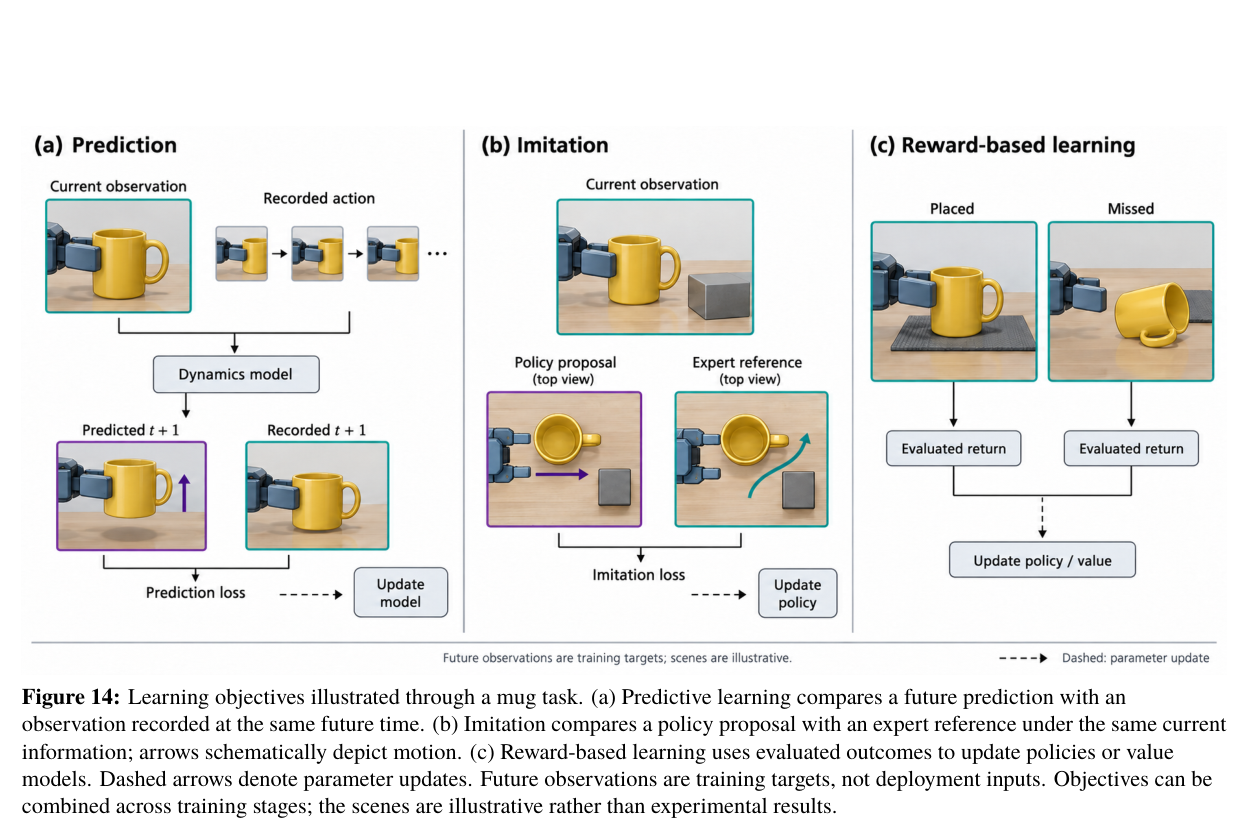
预测学习比较“预测未来”与“后来真的观测到的未来”;模仿学习比较“策略动作”与“专家动作”;奖励学习根据结果评价改变策略。虚线表示训练更新,不是机器人在运行时能提前看到未来。
9.3 预训练和后训练描述阶段,不规定必须用哪种目标
预训练建立广泛能力,后训练针对目标任务、身体或部署要求继续调整。
可以先模仿预训练,再奖励后训练;也可以通过人工纠偏继续监督微调。监督微调,SFT,就是利用有目标标签的数据继续训练。
如果机器人自主采集成功轨迹,然后照着这些动作拟合,依然可以是监督学习。数据由谁采,与优化目标是什么,是两条轴。
LLM 后训练里的方法也不能直接原封不动搬过来:离散动作 token、连续回归、diffusion 和 flow 的概率接口不同,真实交互预算更紧,奖励还要反映物理后果。
9.4 持续学习要证明“同一个系统越学越多”
今天微调一个模型学开门,明天从原始模型重新微调另一个学拿杯子,不能证明同一台系统累计掌握了两种能力。
同样,加入 replay——回放旧数据——只说明有一种保留机制,不保证旧技能没掉。低秩适配 LoRA 用两个较小矩阵表示并训练权重增量,减少要训练的参数,也不自动保证旧行为不受影响。
持续学习可以把知识放在外部记忆、独立技能模块或共享权重里。位置不同,代价与风险也不同:
| 存储位置 | 有利之处 | 必须额外验证 |
|---|---|---|
| 外部记忆、技能库 | 不必每次改共享模型 | 检索、适用条件、技能选择是否正确 |
| 独立参数模块 | 减少直接参数干扰 | 路由、存储增长、共享组件的限制 |
| 共享参数 | 能复用知识、共同改善 | 旧技能遗忘与广泛回归 |
真正的证据应该跟踪同一个系统:每次更新后,新任务怎么样,旧任务怎么样,安全与恢复有没有退步,需要多少存储和人工验证。
能适应一次,与能持续积累,是两个不同的研究目标。
10. 模型终于算出动作了,为什么系统仍然可能失败?
10.1 身体接口不是最后接一下线
模型输出的位置目标,到真实电机之间还有控制器。
位置控制更像“去这个位置”,速度控制更像“以这个速度移动”,力矩控制直接指定关节驱动力矩;阻抗控制则调节机器人面对接触时的柔顺程度,可以粗略理解为“既要往目标走,也要像弹簧一样允许适度让步”。
插接、擦拭、柔性物体操作往往需要处理接触,而不只是追踪几何路径。
不同接口把责任放在不同地方:直接输出力矩,对策略时限与稳定性的要求通常更直接;输出末端目标,则把很多细节交给下游。
控制器能纠正位置跟踪误差,却不能把“拿错杯子”纠正成“拿对杯子”。语义错误和控制错误要分开诊断。
10.2 推理延迟与观测年龄,是两种不同的时间
设传感器记录观察的时间为 $t_{\text{obs}}$,动作结果就绪时间为 $t_{\text{ready}}$,该动作交给执行侧的时间为 $t_{\text{exec}}$。
处理路径延迟:
\[L=t_{\text{ready}}-t_{\text{obs}}.\]执行时的观测年龄:
\[A=t_{\text{exec}}-t_{\text{obs}}.\]假设模型处理花了 100 毫秒,结果就绪后又排队等了 50 毫秒,执行时依据的观测就已经有 150 毫秒历史。
若接下来每 20 毫秒从同一动作块执行一步,后续动作依据的源观测还会继续变旧。
每秒输出 50 个动作,并不等于每秒根据 50 次新观测重新作决策。
下面这张时序图,先看右上方的观测、结果就绪和执行起点,再看下方缓存动作与局部新反馈的区别。
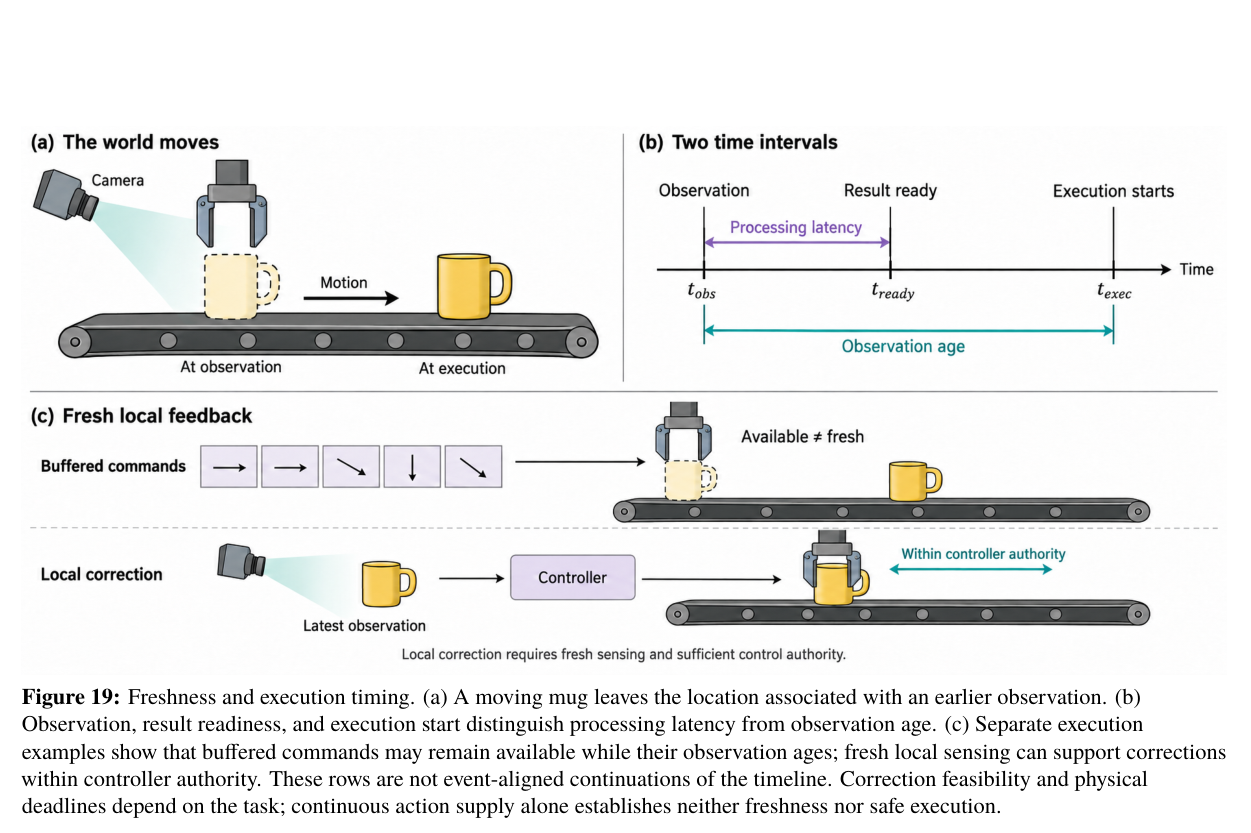
右上方把“计算完”与“真正开始执行”分开,因此排队与等待也会增加观测年龄。下方的缓存能保证还有动作可发,却不能让旧图像变新;局部传感器可以修正部分误差,但修正范围受控制器权限与可用信息限制。下方两行是独立执行示例,不能与上方时间线逐事件对齐。
此外,真实执行器还有响应延迟,多种传感器也各有时间戳。一个系统总延迟数字无法描述所有反馈路径。
10.3 异步执行能避免干等,但接续必须对得上
常见办法是:机器人执行上一段动作时,模型已经在算下一段。
好处很明显,不必每次停住等推理。
但当下一段算完,机器人已经往前走了。新动作不能再把这段时间当作没发生,也不能随便覆盖已经执行或已经交给控制器的前缀。
RTC,real-time chunking,实时动作分块,是相关代表路线:保留确定会被执行的前缀,在这个条件下生成后续动作。还可以训练模型适应延迟,或者用快速反馈纠正慢模型输出。
需要一起检查四件事:
- 剩余缓存能不能覆盖下一次计算和交接;
- 新旧轨迹是否与已执行、已承诺部分一致;
- 接续是否仍然朝正确任务目标前进;
- 结果是否过期,必要时能否取消并进入可行后备行为。
轨迹平滑只是其中一项。把“从左绕”和“从右绕”平滑平均,可能又回到了障碍物中间。
10.4 LLM 推理优化仍然有用,但目标函数变了
这里和熟悉的 LLM 系统研究接上了:减少视觉 token、量化、缓存、编译、减少生成迭代、云边协作,都可能降低成本。
但物理系统有两个特别之处。
第一,近似误差可能通过反馈累积成行为差异。跨帧复用视觉特征,静态场景可能很好;杯子突然被移动,缓存反而可能阻止系统及时发现。
第二,吞吐、请求延迟与物理反应不是一个指标。
综述列出的 OpenVLA-OFT 例子里,在所引 A100 测试配置下,请求延迟从 0.240 秒降到 0.073 秒,约为 3.29 倍;动作吞吐从每秒 4.2 个提升到 109.7 个,约为 26 倍。这些具体测量值依照综述转述,倍率据此复算;后一个倍率不能直接写成机器人反应快了 26 倍。
如果为提高多机器人总吞吐而等待更大的 batch,单台机器人的观测可能更旧。GPU 利用率更高,杯子却抓得更差,这完全可能。
因此,除了平均计算时间,还应测延迟尾部、错过物理期限的比例、扰动到纠正的时间,以及每台机器人的真实任务表现。延迟尾部指少数较慢请求,例如 p99 是 99% 请求不超过的时长。
10.5 共享模型更新,还要决定哪台机器人何时激活
机群可以共享经验和模型,但服务器发布新模型,不等于每台机器人都应立即切换。
一台机械臂正拿着杯子,另一台正在等待。它们的控制器、标定甚至夹爪也可能不同。
原文明确区分:训练候选、验证与发布、逐机器人兼容性检查、合适交接点激活。
回滚也不只是恢复旧权重。动作归一化、相机标定、控制器、监测器都可能需要一致版本;杯子已经掉地上了,恢复软件版本不会把它放回桌面。
这是物理 Agent 与普通模型服务很不一样的地方:软件状态可以回退,物理历史不能撤销。
11. 行业里最容易高估的能力,往往来自评测边界没说清楚
11.1 高成功率先问:在哪些条件下、分母是什么?
100 次任务里,80 次第一次独立完成,10 次自主重试后完成,5 次需要人扶一下,5 次失败。
可以报告首次自主完成率 80%,也可以报告允许既定重试预算后的自主完成率 90%,还可以说含人工协助共有 95 次最终完成。
这些数字各有用途,但不能都简称“95% 成功率”。
这是教学算例。现实评测同样要声明试验单位、重试预算、人工介入、隐藏重置和计时边界。
离线动作误差也不能直接替代闭环成功:两条不同路径都可能完成任务;一个看似很小的误差也可能刚好撞到杯沿。
11.2 熟悉场景的成功,不代表陌生条件下的泛化
泛化是对训练范围之外变化的能力,但要说明变化是什么:新杯子、新背景、新相机、新指令、新任务组合,还是新机器人。
综述引用 LIBERO-Plus 的一个结果:第三人称单视角 OpenVLA-OFT 配置在相机扰动下,成功率从 95.3% 降到 16.8%。这是特定配置与扰动条件的结果,不能推广为所有 VLA 的固定退化幅度。
它说明一个现实问题:原测试环境里分数很高,仍然可能依赖脆弱的视角线索。
单因素稳健也不代表组合变化稳健。新杯子加新相机再加不同夹爪,可能一起击穿系统。
11.3 学习流程的漂亮分数,必须保留原始口径
Learning While Deploying 展示了机群共享数据与在线改进:原论文在八个任务上报告平均得分 0.95,相比 SFT 基线为 0.76。
但这里四个任务用二元成功评分,另四个用分步骤进度评分,0.95 不是统一的“95% 首次自主完成率”。完整流程还涉及纠偏、结果标注和支持成本。
这个例子值得记住,因为 Physical AI 很容易把不同层次的证据压缩成一句“机器人已经能自我进化”。
比较两个学习方案时,至少要一起核算 robot-hours、human-hours 和计算预算,分别是机器人占用时间、人工时间和计算资源消耗。只比训练 GPU 时间,很可能漏掉最贵的部分。
11.4 用世界模型和 LLM 当裁判,可以省试验,但也会共享盲区
代理评测可以提前筛选候选策略,帮助节省真实机器人试验。
但策略、世界模型与奖励模型如果依赖同一套错误视觉线索,三者一致不等于任务真实完成。
而且,能正确给几个模型排先后,与能准确预测每次任务是否成功,以及能否支持发布门槛,是三个不同要求。
最终仍需独立结果核验。策略更新后进入新状态分布,旧裁判即使参数没变,也可能需要重新校准。
一个小统计例子也很有提醒作用:在独立、同分布的二项试验假设下,20 次测试零失败,对应单侧 95% 置信上界仍允许真实失败率约为 13.9%。它不说明系统有这么高的失败率,而是说明这点试验不足以排除它。
12. 安全不只是一句“不能伤害人”,还要有实际干预路径
LLM 可以判断一句指令是否危险,规划器可以检查禁区,控制器可以限制速度与力。这些保护针对不同层次。
但看见风险之后,谁有权拦住动作?来不来得及?拦住后机器人怎样保持稳定?
原文把监测、过滤或控制切换、后备行为和恢复分别讨论。下面这张图先看左侧危险动作被拒绝,再看中间后备行为,最后看右侧重新开始需要检查哪些事实。
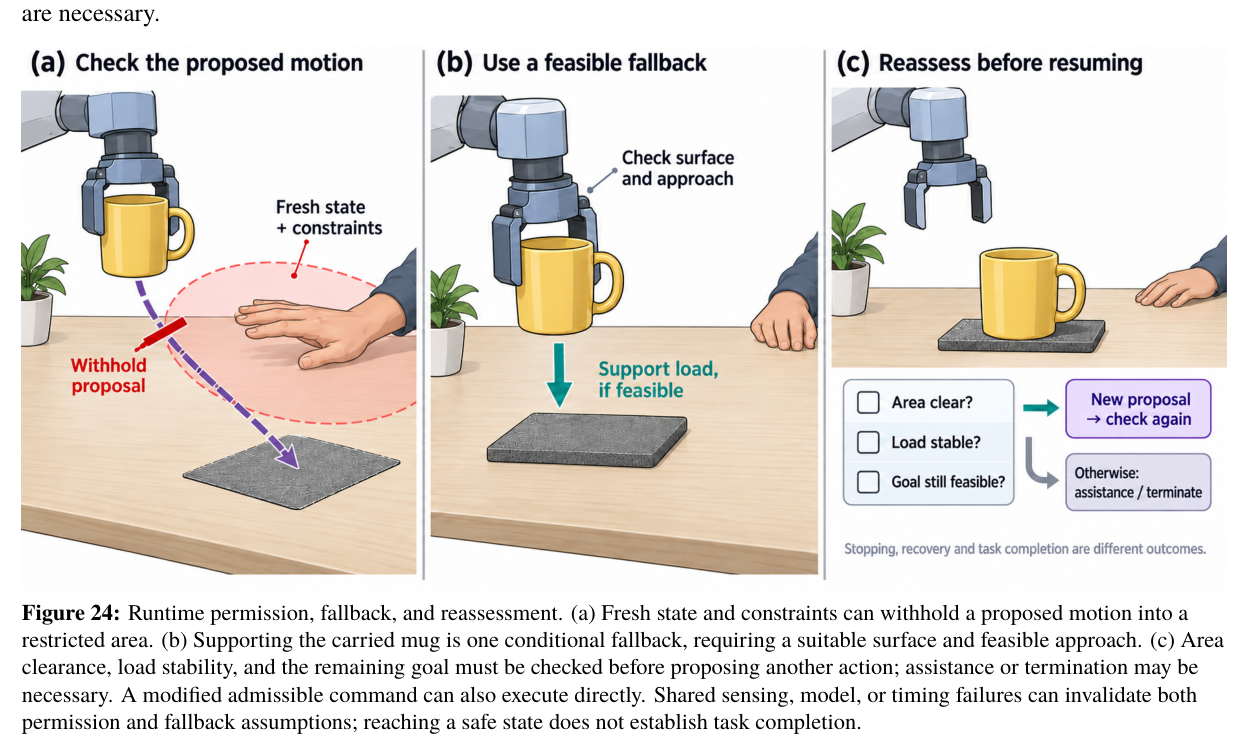
左侧检查动作是否仍被允许;中间把杯子支撑到合适表面,只是一个有条件可行的后备例子;右侧还要确认区域清空、载荷稳定、剩余任务仍成立,才能继续。
解除眼前危险、恢复完成任务的条件、真正继续执行,是三个不同结果。
机器人拿着杯子时直接断电,可能把杯子摔了;行走机器人突然冻结关节,也可能摔倒。“紧急停机”如何实施,取决于具体身体和状态。
安全检查器还可能与策略共享故障。二者都读同一份陈旧状态,检查器也许会放过同一个错误。分成两个进程,不代表失效模式独立。
对 LLM Agent 而言,还有恶意指令、视觉中的误导标记、重放观测、受污染记忆等问题。身份认证可以证明消息来自谁,不能证明消息内容真实、新鲜或安全。
因此,更完整的执行问题是:这个动作语义上允许吗,身体上可行吗,依据的信息还有效吗,出现问题后是否存在及时而可行的干预?
13. LLM 与 Agent 带来的新机遇,究竟在哪里?
到这里,基础组件已经齐了。这一节开始是基于综述的技术判断;下面的研究组合不代表作者已经实现了完整系统,也不意味着相关方向没人研究。
13.1 从为每个任务写流程,转向复用语义与技能组合
LLM 的直接价值是利用广泛知识理解指令、选择技能、处理条件分支,并与人沟通。
过去每增加一个任务,可能都要手写一套流程;现在有机会复用已有抓取、放置、导航等技能,动态组合任务。
但这个机会受技能覆盖限制。选择器再聪明,也不能凭空让夹爪学会拧紧一个从未能操作的瓶盖。
可行脉络是:语义理解 → 技能选择 → 可执行前提检查 → 结果验证 → 失败后重规划。
真正值得攻的接口,不只是让 LLM 会调用函数,还要让它知道函数在当前身体、状态和时间条件下能否执行。
13.2 从孤立动作学习,转向多来源知识与物理经验分工
互联网数据提供对象与任务知识,人类视频提供行为结构,机器人数据锚定动作,仿真扩展覆盖,真实失败提供纠偏。
这里有机会形成分层的数据效率:把昂贵机器人数据用在身体对应、接触和恢复上,而不是让它重新学习“杯子是什么”。
难点则是知识迁移在哪里止步。人类视频学到的顺序可以复用,手指运动却未必能映射到两指夹爪。需要用实验分清语义收益、运动收益和真实接触收益。
13.3 从每一步都调用大模型,转向多时间尺度的智能
任务层需要理解“不要碰电脑”,接触层需要及时应对滑移。二者适合的计算节奏不同。
一个现实架构是:慢速语义决策,中速动作策略,快速局部反馈,再加有执行权限的安全机制。它们可以是独立模块,也可以在共享模型内组织成不同路径。
机会在于按阶段分配计算:接近空桌面时少算一点,接触、遮挡、人员进入时多看一点、缩短动作前缀,必要时启动更重的规划。
挑战是共享状态和交接。如果快速回路只知道手的位置,不知道高层目标已经撤销,反应再快也可能在高效地做错事。
13.4 从一次性训练,转向有证据的部署学习
Agent 可以辅助挑任务、整理失败、提出奖励、检索历史、请求人工纠偏;机群可以共享经验。
但“自动化更多环节”不能替代可靠结果、重置与验证。一个会自己标成功、自己生成数据、再自己给自己打分的闭环,也可能越来越确信自己的错误。
最有价值的目标不是无限更新,而是在有限设备、人工和验证预算下,更快得到可确认的新能力,同时保留旧能力。
14. 六条 advanced 技术路线:怎样从方向变成能做实验的问题?
14.1 技能接口加入前提、身体语义与时间有效性
软件工具调用一般关心参数格式;物理技能还需要坐标、单位、当前状态、载荷、前提、完成证据和中止条件。
例如,place(cup, shelf) 之外,还需要知道:杯子是否确认持有,目标是否可达,位置来自哪次观测,允许执行到什么时候,失败后是否有可用支撑面。
综述已经提出动作块有效期与执行权限等原则。进一步研究,可以把它们实现为结构化技能契约与运行时检查。
可检验假设:固定同一个 LLM 和底层策略,加入这些接口信息,能否减少坐标错误、过期动作和前提失效后的错误执行?
对照应从仅检查参数格式开始,逐步加入坐标与单位、状态有效性、后备条件。指标同时看错误执行、误拒绝、检查时延、任务完成和人工干预,避免用“全都拒绝执行”换取表面安全。
主要挑战是:前提由谁测量,完成证据是否可靠,契约检查自身会不会过时。
14.2 世界模型朝“决策相关、可校准、按需计算”发展
比起每一步生成高分辨率未来视频,更直接的研究目标是:保留影响动作选择的信息,预测候选后果,并知道预测在哪些条件下不可靠。
可沿三条线推进:
表征线:像素、三维结构、接触变量与 latent 怎么组合,让模型既省计算,又不丢掉滑移和碰撞等关键变化。
规划线:只在候选意见分歧、风险升高或目标变化时搜索;其余时刻复用便宜策略。这样需要比较搜索收益与额外时延。
学习线:训练时使用预测与想象,部署时蒸馏到动作策略;复杂预测保留在困难决策点或后台。
实验应该固定真实交互与计算预算,对比直接策略、始终规划、事件触发规划,并测候选排序、预测成功概率的校准误差、完成率和扰动响应。校准的意思是:模型预测成功概率为 80% 的那类尝试,实际是否也约有 80% 成功。
最关键的反例是:世界模型让预测指标更好,却因为慢了而使真实任务更差。一个可信方案必须能识别并避免这种情况。
14.3 记忆与主动感知结合:决定何时应该重新看
主动感知指通过动作获得信息:转一下相机、换个视角、轻触物体、试探性抬起。
在抓杯任务里,它可能体现为:不确定杯底是否粘住,先轻抬一点;遮挡导致位置过期,先移开视角,而不是继续猜。
一个有用的教学决策关系是:
\[\text{主动观测的价值} \approx \text{减少错误决策的预期损失} - \text{观测所需时间、动作与风险成本}.\]这不是原文提出的新算法,而是把问题写清楚:多看一次有成本,不看也有成本。
研究可比较大容量记忆、固定周期刷新,以及按事实依赖和决策风险触发刷新。让物体在遮挡时移动、工具更换、目标撤销,分别测检索错误、陈旧事实错误、错误动作和最终完成率,并核算重观测成本。
难点是,信息无法辨识时不能假装有一个准确置信度。模型说“90% 确定”也需要实际校准。
14.4 推理系统从“更高吞吐”走向“更及时的有效决策”
这条路线很适合 LLM 系统研究向 Physical AI 延伸。
研究对象可以是:视觉 token 裁剪、动作头迭代、缓存失效、云边分工、异步续接和机群调度。但共同目标应当落到物理结果。
举例:系统同时服务十台机器人。优先给谁算?缓存最少的,观测最旧的,还是正在接触危险物体的?
仅按请求到达顺序,或只看缓存余量,可能漏掉真正紧急的机器人。
可以在固定总算力下,对比先到先服务、按截止期、按 buffer、按观测年龄与任务阶段的调度;加入网络抖动、目标移动和突发拥塞。
指标应包含每台机器人的完成量、观测年龄、错过期限、缓存耗尽、扰动反应、能耗与后备成本。平均值之外还要看最差机器人的服务情况。
一项近似优化是否成立,要看它何时失效,以及失效能否被及时发现。 这比只报一个平均加速倍数更有研究价值。
14.5 数据闭环围绕失败原因与改进成本,而不是轨迹总量
一次抓取失败,可能来自目标选错、深度偏差、动作坐标错误、反馈太慢、夹爪摩擦不足,或训练没覆盖恢复。
这些问题需要不同修复:补数据、加传感器、修接口、调控制器,甚至换夹具。
因此,Agent 辅助失败分析的价值,是帮助选择最便宜的有效干预,而不只是生成一段解释。
实验可以从已知故障注入开始:分别制造坐标错误、观测陈旧、对象变化和力不足,比较随机补采、按困难程度补采、按原因选择补采或系统修复。
记录每次有效改进需要的机器人时间、人工时间、验证时间和额外硬件成本。还要确认诊断建议是否真正改变结果,避免把“解释听起来合理”当成故障定位成功。
这里的高级脉络是:通用策略提供起点,交互发现缺口,纠偏或奖励优化局部能力,再把验证通过的改进整合回通用系统。
14.6 持续学习与版本激活一起设计,追踪完整能力账本
把同一个系统依次放进任务 A、B、C,每轮学习后都复测已有任务,而不是每次从原模型独立开始。
可以记录一个能力矩阵:
\[R_{k,j} =\text{第 }k\text{ 次更新后,在任务 }j\text{ 上的表现}.\]比如,更新到第三轮后,检查 A、B、C;第四轮新增 D 后,再检查 A、B、C、D。旧任务下降多少,新任务提升多少,一眼就能看到。
在同样数据、存储与验证预算下,对比外部记忆、独立适配模块、共享权重回放和混合方案。激活到机器人时,再验证身体、控制器与安全机制兼容。
除了最终分数,还要测路由错误、模块增长、检索时延、回滚后的物理恢复,以及每轮发布需要的人工支持。
真正困难的部分是:新能力改变状态分布,旧评测器和旧安全假设也可能失效。因此持续学习不只更新策略,还要维护“哪些能力已经被什么证据验证”。
14.7 用一张路线表收束:不是六个孤立项目
| 路线 | 借用 LLM / Agent 的什么能力 | Physical AI 新增的核心约束 | 最直接的验证目标 |
|---|---|---|---|
| 技能契约 | 语义理解、工具选择 | 身体、前提、时效与执行权限 | 少做错误动作,完成率不被误拒绝拖垮 |
| 决策相关世界模型 | 表征、生成、搜索 | 动作条件、真实接触、计算期限 | 规划收益超过预测与搜索代价 |
| 记忆与主动感知 | 检索、历史组织 | 动态事实失效、观测成本 | 少用陈旧信息,必要时主动获取证据 |
| 物理期限下的计算 | 缓存、压缩、服务调度 | 新鲜度、接续、单机截止期 | 扰动来后更早作出有效纠正 |
| 失败驱动数据闭环 | 分析、选择、自动组织 | 真实试验、奖励、重置成本 | 更少人时得到一次有效改进 |
| 可累积部署学习 | 记忆、模块、参数更新 | 旧能力、安全与版本一致性 | 同一系统连续改善并保留能力 |
它们有明确依赖:技能契约需要可信状态;可信状态可能需要主动感知;新观测需要及时计算;失败结果要进入有效数据;模型更新再回到验证与激活。
综述最后的图也是这个意思。先看顶部四类开放问题如何汇入中间的联合设计,再看底部长期能力证据如何通过双向箭头修正设计。
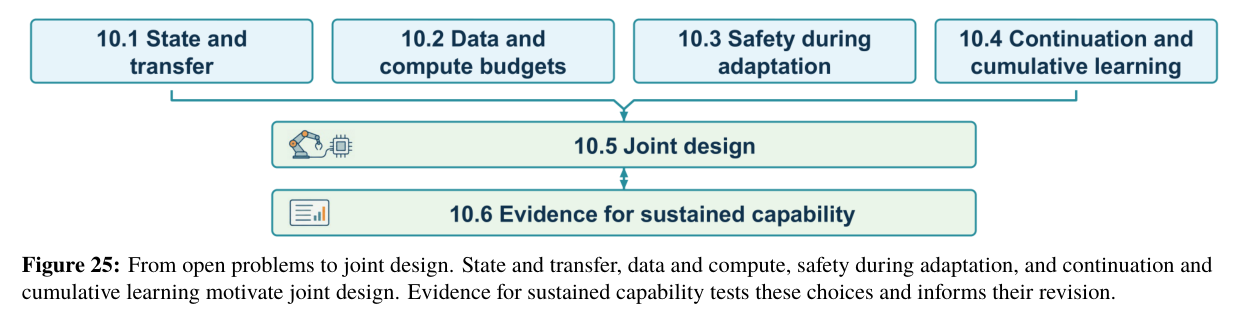
顶部各分支不能只靠局部最优解决:增大模型可能压缩反馈预算,减少观测可能损伤接触判断,更新策略也可能改变安全条件。底部的长期证据要求把这些取舍放回同一个系统,检查它是否真的更稳、更省、更安全、更少依赖人工。
15. 不同团队,怎样选一个现实的切入点?
如果主要积累在 LLM 与 Agent,可以从技能选择、任务状态、记忆有效性、结果验证和求助策略切入。先固定一个可靠的底层执行平台,验证高层组织的贡献,避免同时重写所有组件。
如果主要积累在 模型与学习,可以研究身体对应、多来源数据、接触表征、动作分布、world–action 联合学习和后训练。这里 world–action 指把世界预测与动作建模连接起来,不规定只能用一种架构。关键是让新增模块对应一个可辨认的失败来源。
如果主要积累在 推理与系统,可以从观测到动作的全路径分析、多速率反馈、异步接续、任务相关缓存失效、机群调度和版本激活切入。固定模型,也能做出有意义的物理能力改善。
如果主要积累在 机器人与控制,可以把身体、传感、控制器与学习策略联合设计。某些任务的突破口可能是更合适的夹爪或触觉,而不是更大的主干。
如果暂时没有真实机器人,用仿真研究机制完全合理,但应当把结论限定在模拟条件。视觉泛化、接触真实性、实际时延与人工支持成本,仍需要后续真实平台证据。
选择课题时,可以问一句很具体的话:
这个方案让哪一种失败更少了,代价是什么,能否在匹配预算的完整闭环里证明?
这个问题比“要不要做下一代通用 Physical AI foundation model”更容易变成一个扎实的研究项目。
16. 总结
从零理解 Physical AI,先抓住一件事:机器人行动会改变世界,世界变化又会改变下一步可用的信息。模型、记忆、控制、计算与验证,都要围绕这个闭环协作。
LLM 与 Agent 扩展了语义理解、技能组合、知识复用和交互组织;VLA 把这些条件连接到动作;世界模型帮助预测与选择;模仿和强化学习利用不同监督改善行为。这些路线有大量组合空间。
但通往可靠物理智能的路径,还包括非常具体的工作:动作坐标对齐,接触反馈及时进入决策,旧记忆失效,晚到结果被拒绝,失败后能恢复,模型更新不破坏旧能力。
行业真正需要跨过的,是从“模型能给出一个合理动作”,走到“完整系统能在变化中持续完成任务”。
这也是这篇长综述适合反复翻看的原因。它提供了一套检查技术主张的坐标:看到了什么,预测了什么,执行了什么,实际发生了什么,最后又凭什么说系统变好了。
延伸阅读与来源说明
本文对综述的内容按教学顺序重新组织,概念公式与明确标出的数字例子用于解释,不是对某个具体模型实现的复刻。第 13—15 节中的路线组合、实验建议和优先判断属于延伸分析。本文未做机器人实验复现。
主要对应关系:
| 本文内容 | 综述位置 |
|---|---|
| 闭环、任务信息与记忆 | §1—2 |
| 预测、规划、VLA、动作生成 | §3 |
| 数据来源、对齐与质量 | §4 |
| 模仿、RL、后训练、迁移与持续学习 | §5 |
| 身体、传感与控制 | §6 |
| 观测年龄、异步执行与部署 | §7 |
| 泛化、成功定义与统计证据 | §8 |
| 执行权限、安全与恢复 | §9 |
| 研究路线所依据的缺口 | §10,尤其联合设计与长期证据部分 |
可沿以下原始工作深入阅读。除文中明确说明的结果核对外,不把综述转述等同于逐篇独立复核:
- SayCan:Do As I Can, Not As I Say:语言规划与机器人技能可行性。
- OpenVLA:开放的视觉语言动作模型。
- π0:VLA 与连续 flow 动作生成。
- ACT:低成本双臂操作与动作分块。
- Diffusion Policy:条件扩散动作序列。
- FAST:利用时间结构压缩动作 token。
- DreamerV3:在世界模型的想象轨迹中学习行为。
- Open X-Embodiment:跨机器人数据与模型。
- DAgger:在学习者访问状态上获取专家监督。
- Real-Time Chunking:异步动作分块与接续。
- OpenVLA-OFT:动作表示、生成与微调效率。
- LIBERO-Plus:对多种变化条件的稳健性评测。
- Learning While Deploying:部署交互与在线改进流程。
正文八张论文配图均来自原综述,保留英文标注,正文配中文走读,文末书封另计;原文页面标注采用 CC BY 4.0 许可。图中的示意路径与数据槽位不应当作已验证的实验结果。
顺带一提,如果对模型自动化设计与效率优化这条相邻路线感兴趣,我们在《动手学 AutoML:从 NAS 到大语言模型优化实战》里整理了架构搜索、LLM 剪枝与压缩、模型融合,以及 LLM 参与自动化优化的相关方法。书里没有本文讨论的机器人控制和安全部署内容,更适合作为模型优化方向的补充阅读。
