arXiv'26 | StartLux-Decision:LLM 决策模型的自适应推理,RL 奖励的是概率质量而不是对错
arXiv’26 | StartLux-Decision:LLM 决策模型的自适应推理,RL 奖励的是概率质量而不是对错
1. 前言:决策模型既要快,又得会算
想象你在搭一个 agent 系统。用户发来一句”我被重复扣款了,订单还显示未支付”,系统得先决定这条工单分给哪个团队、要不要今天处理、严重程度几级;agent 调用工具之前,还得判断这次 tool call 的参数合不合法;任务跑完,又要判断它到底完成了没有。
这类”小决策”在 LLM 系统里无处不在,而且有个共同点:下游不只要答案,还要概率。置信度 0.98 就自动执行,0.6 就升级给更大的模型或者转人工。专门干这件事的模型现在一般叫决策模型(decision model):输入一个状态和若干带类型的问题,对每个问题输出候选选项上的概率分布。
现有开源决策模型几乎都走单次前向(single-pass)路线:读完 prompt,从最后一个位置的 logits 直接读出选项概率,一个 token 都不生成,几十毫秒出结果。快是真快,但碰到需要算一下的题就容易翻车,比如”导出记录数小于 100 时 Rule 3 不适用”这种规则核对,或者排期冲突检测。
自然的想法是让它先推理再回答。但作者发现一个很麻烦的现象:经过决策训练的模型,推理能力会被训坏。4B 模型被要求推理时,约 40% 的题几乎不写推理;9B 模型则相反,约 70% 的题一直写到长度上限都停不下来。光把 token 生成打开,根本救不回来。
所以这篇论文要回答的是:决策模型能不能只在需要时才推理,平时保持单次前向的速度,而且推理前后输出的都是可信的概率?
StartLux-Decision 的答案是一个 0.8B–27B 的模型家族,分两个变体,共用同一套概率读出接口:
- Instant:只做单次前向,并在 full-attention 层对 prompt 开双向注意力;
- AutoThink:先单次读出一次,置信度不够才推理,最后把推理前后两个分布加权融合。
再配一个强化学习方法 RLCD²:奖励的不是”答对没有”,而是”推理让概率质量提升了多少”,同时对写太长的推理施加软惩罚。
2. 单次前向读概率很快,但遇到要算的题就露馅
先说清楚”从 logits 读概率”到底是怎么回事。把一个问题格式化成 prompt,里面包含输入状态、问题、以及用字母 A、B、C 标好的选项。模型 forward 一遍之后,看最后一个位置上 LM head 给字母 A、B、C 打的 logit,记第 $k$ 个选项的 logit 为 $z_k$,再在这 $K$ 个选项上做带温度的 softmax:
\[p_k=\frac{\exp(z_k/T)}{\sum_{j=1}^{K}\exp(z_j/T)},\qquad k=1,\ldots,K\]这里的温度 $T$ 是训练完之后在 held-out 数据上单独拟合的,用来做概率校准(calibration):让”模型说 80% 把握”的那批题,实际正确率也接近 80%。$T$ 只缩放 logits,不改变选项排序。
这条路线的问题出在”一次 forward 必须把题做完”。对”这条评论是不是讽刺”这种题,一次 forward 足够;但对”8 条记录、0 次导出、有 legal hold,按这四条规则该批准还是升级”这种题,模型得一条条核对规则,单次前向里没有地方放这些中间步骤。
而推理模型那边,每道题都推理一遍又太贵。决策场景里大部分题其实很简单,全量推理纯属浪费。快和会算之间的矛盾,就是这篇论文要处理的核心问题。
3. 一套读出接口撑起两个变体:从请求到概率的完整计算流
这一节对照开源代码(StartLuxLabs/StartLux-Decision)和 HuggingFace 上发布的 config.json,把一个请求从进来到出概率的每一步都走一遍。维度统一用 4B 模型举例。
3.1 一个请求先被拆成 M 条独立的 prompt
请求由一个 state 和若干带类型的问题组成。state 可以是字符串或任意 JSON,可以带图。问题类型有三种:
-
choice:从命名选项里选一个,每个选项可以附一句自然语言描述(criteria),比如billing: Payments and refunds; -
noul:是/否判断,渲染时就是 yes、no 两个选项; -
score:2 到 10 级的有序量表,最终返回期望等级 $\sum_i i\cdot p_i$。
关键设计是:每个问题单独渲染成一条完整的 prompt,作为 batch 里的一行。同一份文档问 32 个问题,就是 32 行,每行都带着完整的 state。仓库 startlux_decide/prompt.py 里的 messages() 渲染出来是这样:
[system]    Apply the criterion to the evidence. Choose exactly one listed option. Answer with its letter only.
[user]      Evidence:
            {"ticket": "I was charged twice for order #4411 ..."}
            Question: Which team should handle this ticket?
            Options:
            A) billing: Payments and refunds
            B) shipping: Delivery
            C) technical: App and login
[assistant] <think>\n\n</think>\n\n     ← 单次读出时以一个空的 think 块结尾,答案就从这之后的位置读
几个细节:
- 每个选项对应一个字母,A–Z 在 tokenizer 里各自恰好是一个 token(
check_tokenizer()启动时会校验),所以一个问题最多 26 个选项; - 超过 26 个选项时走淘汰赛:先切成每组最多 25 个并行读出,每组前 3 名进决赛再读一次。151 个选项时,正确答案在初赛就被淘汰的比例只有 0.2–0.7%;
- 训练时用记录的 hash 确定性地打乱选项顺序,防止模型学会”总选 A”这种位置捷径。
3.2 骨干网络是 Qwen3.5 的 3:1 混合注意力
论文的训练流程图里写明基座是 Qwen3.5 / Qwen3.8,发布的 config.json 里 architectures 也是 Qwen3_5ForConditionalGeneration。这一代 Qwen 用的是混合注意力:大部分层是线性注意力(具体是 Gated DeltaNet),每隔几层插一层标准的 softmax full attention。线性注意力不存完整的 KV cache,而是每个头维护一个固定大小的状态矩阵,逐 token 递归更新,所以长上下文下又省显存又快,代价是结构上天然只能因果地从左往右扫。
4B 模型的具体配置:
| 项目 | 4B | 27B |
|---|---|---|
| 层数 | 32,[linear ×3, full ×1] × 8 | 64,[linear ×3, full ×1] × 16 |
| 隐藏维度 $d$ | 2560 | 5120 |
| full attention | 16 个 Q 头、4 个 KV 头,head_dim=256,输出带 sigmoid 门 | 24 个 Q 头、4 个 KV 头,head_dim=256 |
| Gated DeltaNet | 16 个 key 头、32 个 value 头,每头 128 维;短卷积 kernel=4 | 16 个 key 头、48 个 value 头 |
| 词表 / 上下文 | 248,320 / 262,144 | 同左 |
full attention 层用的是 GQA(grouped-query attention):16 个 query 头共享 4 组 K/V,每 4 个 Q 头共用一组,KV cache 只有 MHA 的 1/4。embedding 和 LM head 共享权重(tie_word_embeddings: true)。
记住”只有 1/4 的层是 full attention”这件事,后面 Instant 的双向注意力只能开在这 8 层上。
3.3 单次读出:维度一步步怎么变
单次读出是 Instant 的全部,也是 AutoThink 的第一步和最后一步。下面这张图从左往右读,六个阶段用粗箭头串起来,每个框下面标了这一步输出的 tensor 形状;紫色是本文的两个关键点:full attention 层和最终概率。设 batch 里有 $M$ 个问题,padding 后长度 $L$,某个问题有 $K$ 个选项。
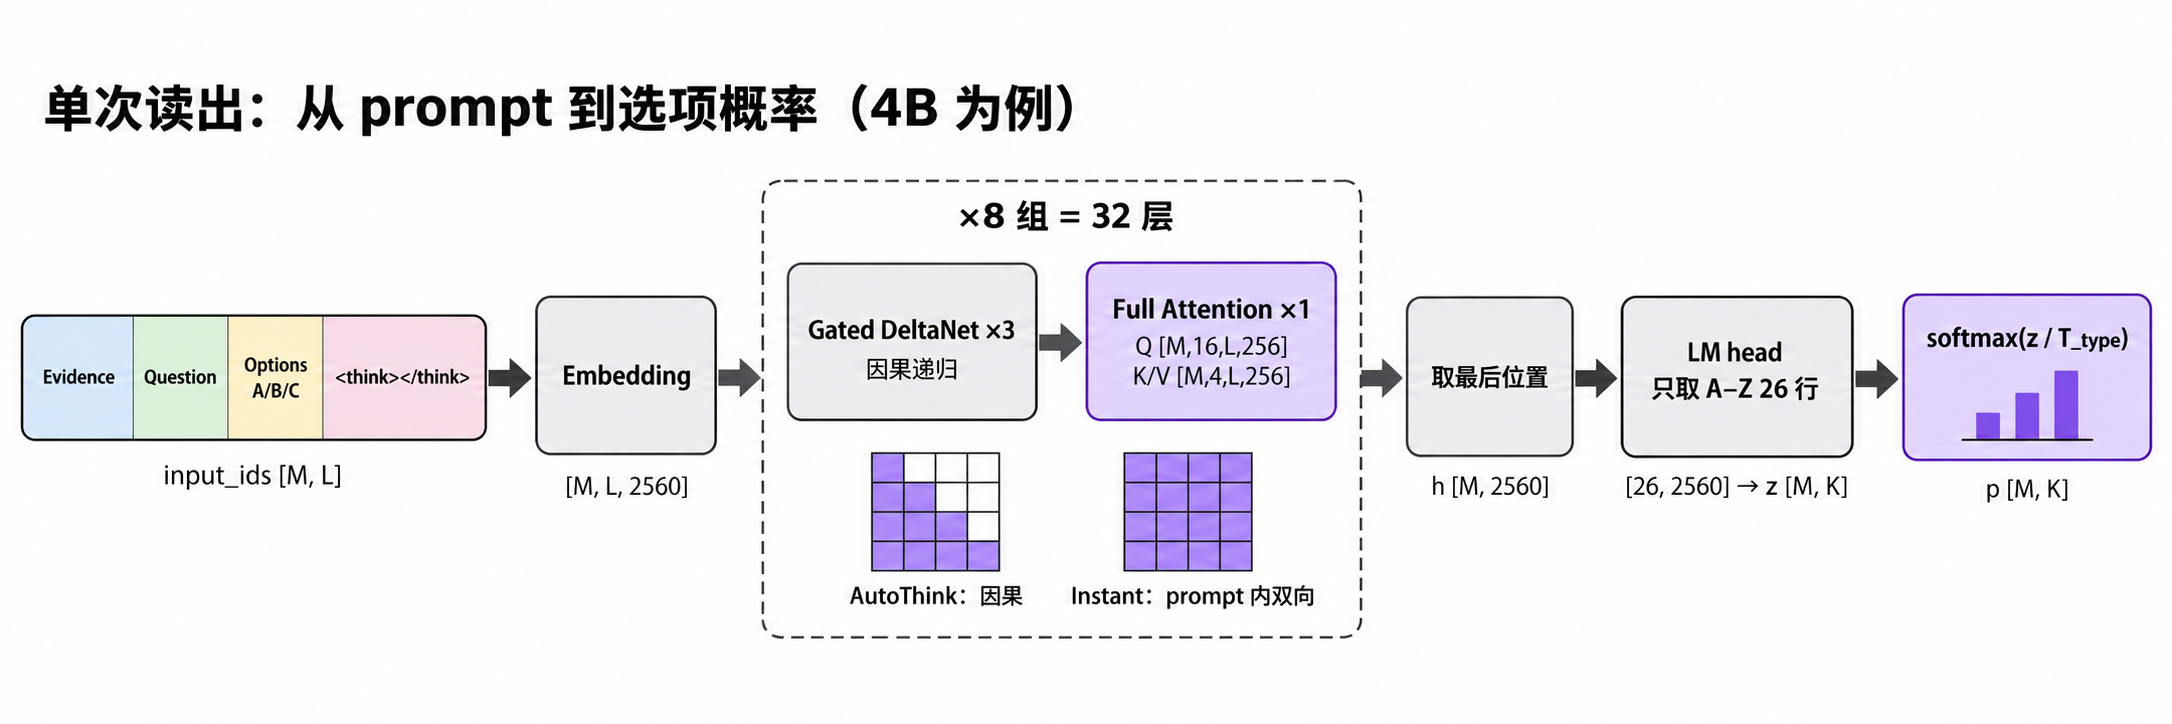
对着图从左往右走一遍:
- token 条:$M$ 个问题渲染成 $M$ 条 prompt,每条依次是 Evidence、Question、Options 和结尾的空 think 块,tokenize 得到
input_ids,形状[M, L]。 - Embedding:查 embedding 表得到 $X^{(0)}$,形状
[M, L, 2560]。如果 state 里有图,图像先过预训练的 vision tower(24 层 ViT,输出投影到 2560 维),以 image token 的形式嵌进序列。vision tower 在整个训练过程中一直冻结。 - 虚线框(×8 组 = 32 层):每组先过 3 层 Gated DeltaNet,每个 value 头维护一个
[128, 128]的状态矩阵,逐 token 递归更新,严格因果;再过 1 层 full attention,Q 是[M, 16, L, 256],K/V 是[M, 4, L, 256],注意力输出再乘一个 sigmoid 门,投影回 2560 维。整个主干里隐藏状态的形状一直是[M, L, 2560]。框下面的两个小方格是 full attention 层的 mask:左边下三角是 AutoThink 的因果 mask,右边全满是 Instant 的 prompt 内双向 mask。两个变体唯一的结构差别就在这里,3.4 节展开。 - 取最后位置:取每行最后一个有效 prompt 位置(也就是空 think 块之后、答案字母本该出现的位置)的隐藏状态,得到
h: [M, 2560]。 - LM head 只取 A–Z 26 行:正常的 LM head 会算出
[M, 248320]的 logits,但这里只需要 A–Z 这 26 个 token,所以等价于只用 LM head 里对应的 26 行W_letter: [26, 2560],再按每个问题的选项数截取前 $K$ 个,得到z: [M, K]。没有额外的分类头,读出完全复用语言模型自己的输出投影。 - softmax:除以按问题类型拟合的温度 $T_{\text{type}}$,在 $K$ 个选项上做 softmax,得到
p: [M, K]。
$T_{\text{type}}$ 是 choice、noul、score 三种类型各拟合一个。论文报告所有拟合出来的温度都大于 1,也就是训练完的模型普遍过度自信,需要把分布”摊平”一点。
最后按类型组装输出:choice 返回 argmax 和每个选项的概率,noul 返回 yes 的概率,score 返回期望等级和每级概率。
3.4 Instant:只在 full-attention 层把 prompt 改成双向
这里有个容易想岔的地方:因果模型里,最后一个位置本来就能看到整个 prompt,为什么还要双向?
问题出在前面 token 的表示上。prompt 的顺序是 Evidence → Question → Options,因果注意力下,evidence 里的每个 token 在被编码时完全不知道后面要问什么。同一段工单,问”分给哪个团队”和问”严重程度几级”,关注的是完全不同的信息,但因果编码只能给出一份与问题无关的表示,所有”按问题挑重点”的活都压在最后几个位置上。
Instant 的做法是:既然单次读出时整个 prompt 都已经在手里,就让 evidence 也能看到后面的问题和选项。下图左半边是 mask 的对比,行是 query、列是 key,灰色是因果注意力本来就能看的部分,紫色是双向后新增的部分;右半边是控制变量实验的结果。
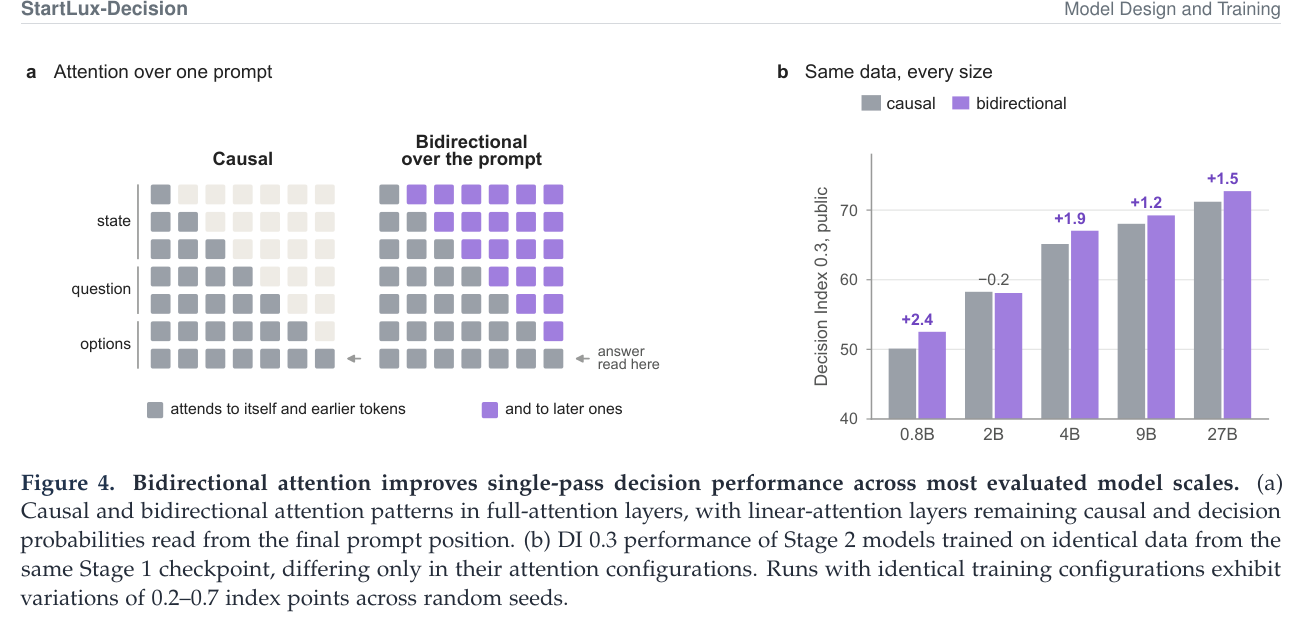
看左图:state 那几行在因果模式下只能看自己和左边,双向之后整行都是紫色,可以看到 question 和 options;答案依然从最后一个位置读(”answer read here”)。右图是用同一份数据、同一个 Stage 1 起点,只改注意力模式训出来的 Stage 2 模型,在 DI 0.3(Decision Index,后文第 6 节介绍)上的对比:5 个规模里有 4 个涨分,0.8B 涨得最多(+2.4),2B 基本持平(−0.2)。作者也给了噪声水平:同配置不同 seed 本身就有 0.2–0.7 分的波动,所以 +1.2 到 +2.4 的提升是可信的,2B 的 −0.2 在噪声范围里。
具体实现有三个要点:
- 只改 8 层 full attention 的 mask,24 层 Gated DeltaNet 保持因果递归。线性注意力是递归扫描,没有 mask 可去。但这样已经够用:问题信息在 full-attention 层写进 evidence 位置的表示里,之后的因果线性层拿到的输入就已经是”带着问题读过”的版本。
- vLLM 插件
vllm_plugin.py里的 mask 规则写得很清楚:query $q$ 能看 key $k$,当且仅当 $k\le q$,或者 $q<p$ 且 $k<p$,其中 $p$ 是 prompt 结束位置。这就是 prefix-LM 的 mask。单次读出时 $p=L$,整个 prompt 全双向。 - 训练时就用双向 mask,而不是推理时临时切换。直接改一个因果训练模型的 mask 会把它的预测打乱(BehnamGhader et al., 2024 的 LLM2Vec 观察过这个现象)。关掉双向后,修改过的实现和原始因果实现输出逐 bit 一致。
双向的代价也很实在:
- 同一文档的多个问题没法共享 KV cache 了。因果模型可以把文档部分编码一次,后面接不同问题复用;双向之后 evidence 的表示依赖问题,每个问题都得从头算。论文附录给的数字是,因果模式下 27B 处理 3,200 token 文档配 32 个问题,复用文档表示能把吞吐从 2.8 提到 27 决策/秒,Instant 拿不到这个收益。
- 部署时必须用作者的插件。
config.json里多了一个"jev_prompt_attention": "bidirectional"字段,但原生 vLLM、llama.cpp、mlx-lm 不认它,会按因果方式加载,不报错,静默地变成另一个模型。这个坑部署时一定要注意。
AutoThink 则保持因果注意力,因为它后面还要自回归生成推理,而且推理后的那次读出需要接在推理文本后面。
3.5 AutoThink:先读一次,没把握再想
AutoThink 的推理流程论文叫 Read-or-Think。先看全局图:上半部分 (a) 是训练流程,第 4 节再讲;现在只看下半部分 (b),两条横条分别是 Instant 和 AutoThink 在一条 prompt 上做了什么。
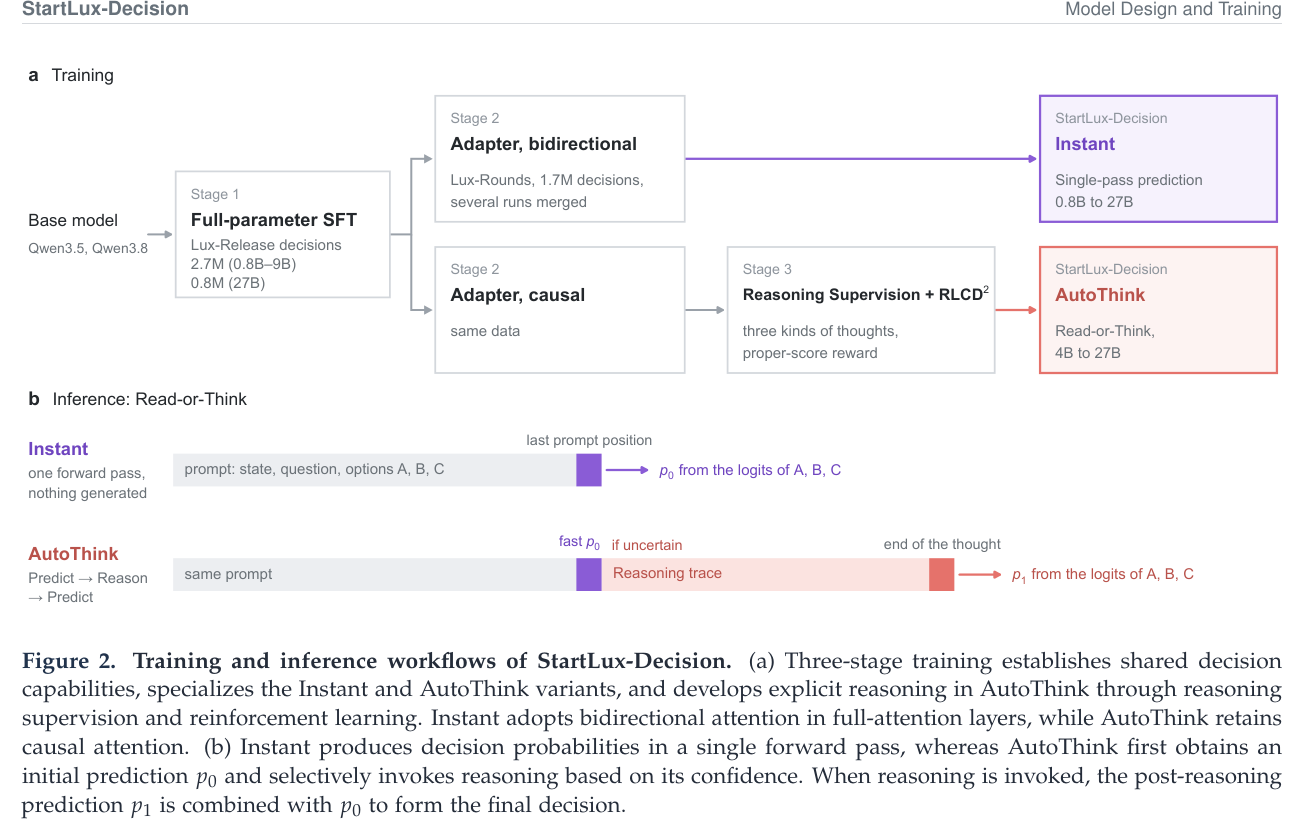
(b) 的上面一条是 Instant:灰色 prompt 读完,在最后一个位置(紫色块)读出 A、B、C 的 logits,结束。下面一条是 AutoThink:同样的 prompt 先在紫色块读出一个快速的 $p_0$;如果不确定,接着生成粉色的推理文本,推理结束的位置(红色块)再读一次,得到 $p_1$。两次读出、推理生成用的是同一套权重。
每个问题独立走下面五步:
- 第一次读出:用 3.1 节那个以空 think 块结尾的 prompt,因果地 forward 一次,得到 $p_0\in\mathbb{R}^K$。这一步和 Instant 的计算完全一样,只是 mask 是因果的。
- 门控:如果 $\max_k p_{0,k}\ge g$,直接返回 $p_0$。论文所有结果都用 $g=0.9$,注意仓库默认值是 0.6。
- 推理:换成 thinking 打开的 prompt(以
<think>\n结尾),先强制写入一行固定前缀Let me work through this carefully, step by step.,然后采样生成(temperature 0.6、top_p 0.95、top_k 20),遇到</think>停止,最多 4,096 个 token。如果到上限还没停,runtime 会替它补一句收尾再关上 think 块。 - 第二次读出:在
prompt + 推理 + </think>之后的位置再读一次字母 logits,得到 $p_1\in\mathbb{R}^K$。 - 融合:
$\alpha=0.75$ 是推理后分布的权重。为什么不直接用 $p_1$?第 6 节有数据,这里先给结论:$p_1$ 在计算题上更准,但整体偏过度自信;留 25% 的 $p_0$ 是用一点准确率换概率质量。$\alpha$ 是在 held-out 数据上让 Brier score 最小选出来的。
下面这张图把论文里的真实例子画了出来。上半部分是同一条数据导出策略下的两个 case,从左往右按”单次读出 → 门控 → 推理 → 推理后读出 → 最终答案”五列读;下半部分是 27B 在 7,800 道 DecisionPivot 题上的整体统计。
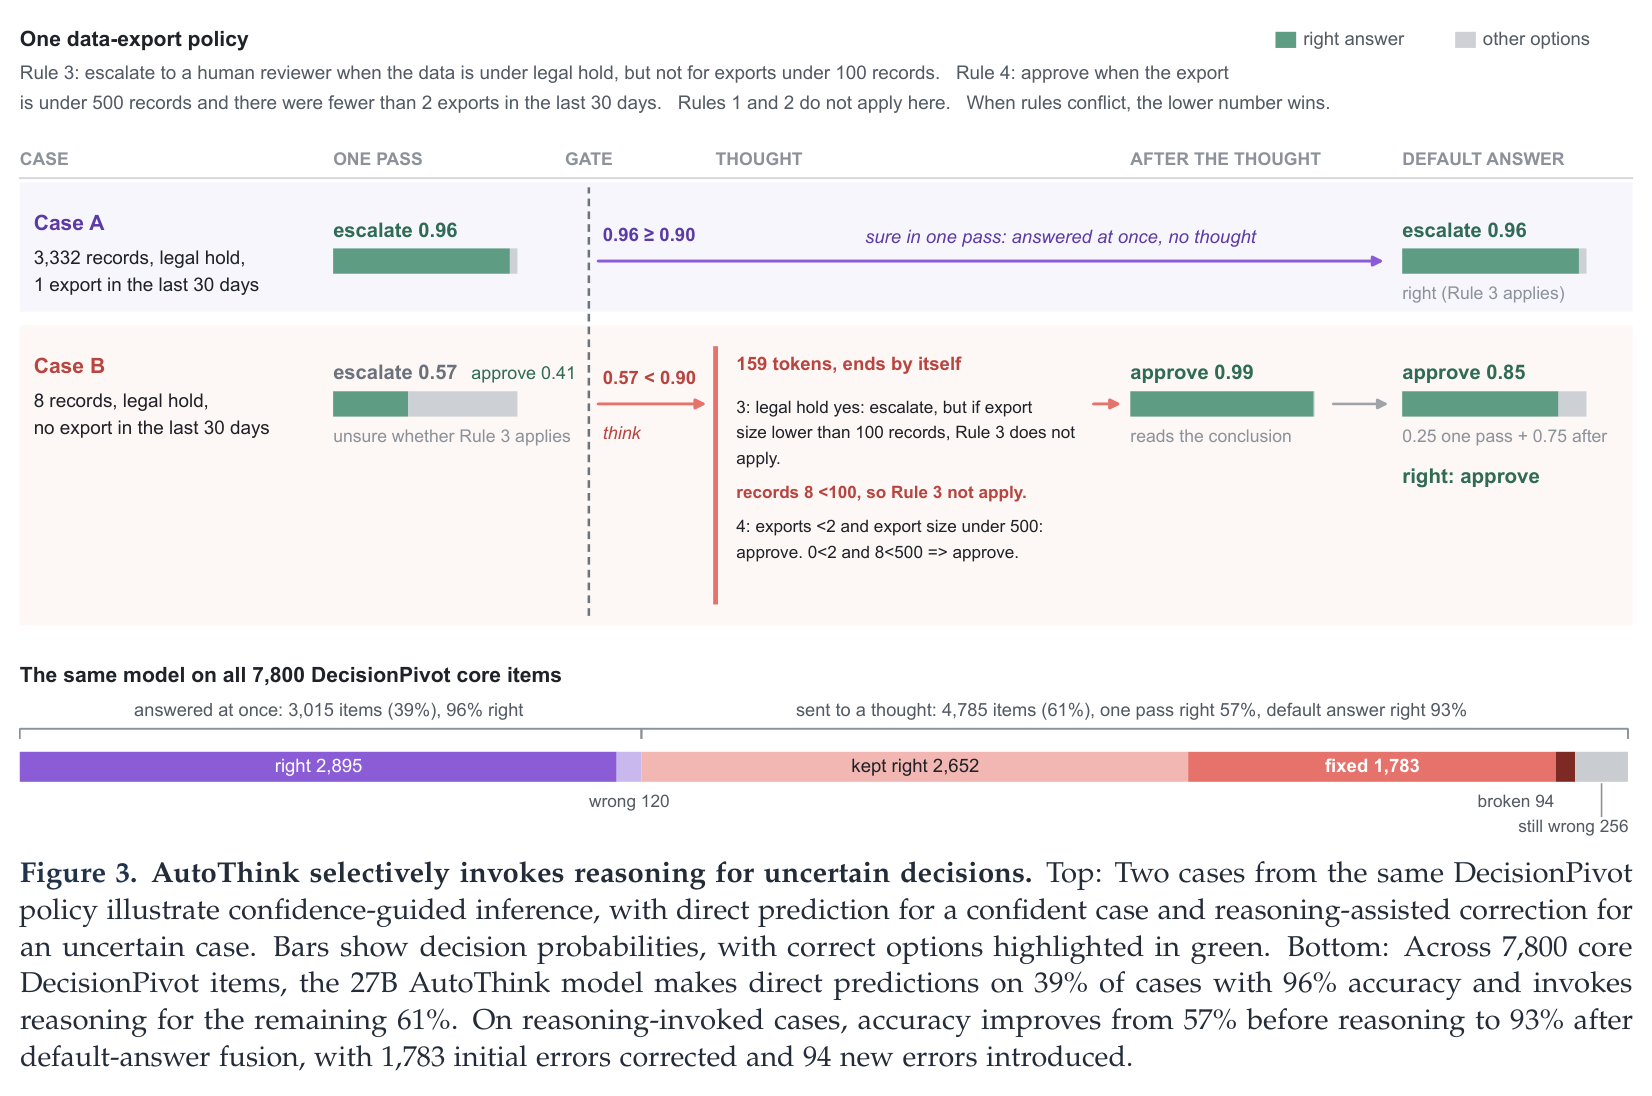
Case A(3,332 条记录,有 legal hold,近 30 天导出 1 次):单次读出 escalate 0.96,超过 0.9 的门槛,直接返回,不推理。
Case B(8 条记录,有 legal hold,近 30 天 0 次导出):单次读出 escalate 0.57、approve 0.41,模型拿不准 Rule 3 到底适不适用,低于门槛,进入推理。推理只写了 159 个 token,关键一步是”records 8 < 100, so Rule 3 not apply”,然后 Rule 4 命中,approve。推理后读出 approve 0.99。融合后:
\[p_{\text{approve}}=0.25\times0.408+0.75\times0.995\approx0.848,\qquad p_{\text{escalate}}=0.25\times0.567+0.75\times0.005\approx0.145\]最终 approve 0.85,答对了。
下半部分的长条更有说服力:39% 的题(3,015 道)单次读出就过了门槛,正确率 96%;剩下 61%(4,785 道)进入推理,这批题单次读出只有 57% 正确,融合后到了 93%。推理纠正了 1,783 个错误,同时把 94 个原本答对的题改错了。门控的作用就是把推理预算花在这 61% 真正没把握的题上。
4. 三阶段训练:先学会出概率,再分叉,最后补回推理能力
回到上面流程图的 (a) 部分,从左往右读:基座先过 Stage 1 全参 SFT,然后分成两条支线。上面一条走双向 adapter 直接得到 Instant;下面一条走因果 adapter,再经过 Stage 3 的推理监督和 RLCD²,得到 AutoThink。所以 AutoThink 只有 4B、9B、27B 三个规模,Instant 有五个。
Stage 1:全参 SFT,把语言模型训成一个概率读出器
数据叫 Lux-Release,0.8B–9B 用约 2.7M 条,27B 用约 0.8M 条(基准训练集和知识类选择题的比例更高)。来源包括公开的分类、NLI(自然语言推理,判断两句话是蕴含、矛盾还是无关)、QA、安全、偏好、tool use 数据集,全部改写成带类型的决策格式。
SFT(supervised fine-tuning,有监督微调)的损失只在最后一个位置、只对 $K$ 个选项字母计算 soft cross-entropy:
\[\mathcal{L}_{\text{SFT}}=-\sum_{k=1}^{K}t_k\log p_k\]$t\in\mathbb{R}^K$ 是目标分布,可以是 one-hot,也可以是教师模型给的软标签。这一步训的是全部语言模型参数,包括输出投影。训完按问题类型拟合温度 $T_{\text{type}}$。
去污染做得比较细:凡是和 Decision Index 测试集、JevBench 公开题、DecisionPivot 撞上的记录,连同它所属的整个 parent group(从同一个 state 衍生出来的所有记录)一起删掉。
Stage 2:adapter 训练,Instant 和 AutoThink 在这里分叉
数据叫 Lux-Rounds,约 1.7M 条,主要是基准训练集和相关公开数据,加上程序生成的规则类决策、多选题,以及 API 生成的样本。API 生成的样本只有在两个独立 verifier 模型都同意标签时才保留。另外保留一部分 Lux-Release,防止 Stage 1 学到的能力被冲掉。
这一阶段训的是 adapter(插在主干上的少量可训练参数,LoRA 是最常见的一种),训完再合并回主干权重,损失和 Stage 1 一样。两条支线用的数据相同,唯一区别是 mask:Instant 用双向,AutoThink 用因果。
Instant 还多做了一步 seed 权重平均:同一配置用不同随机种子训 3 次(0.8B)或 4 次(2B–27B),把权重直接取均值,也就是常说的 model soup,然后重新拟合温度。
附录有一个对照:如果 Stage 1、2 都改成在原始基座上只训一个 adapter,DI 0.2.1 只有 63.3 和 58.2,全参训练是 64.8。Stage 1 用全参是有必要的。
Stage 3:推理监督,先把”会写推理、会停”补回来
这一步只针对 AutoThink,就是前言里那个问题:决策训练把推理能力训坏了,4B 写不出推理,9B 停不下来。作者用 Lux-Think 数据集,每个模型 4k–21k 条推理样本,再训一个 adapter 并合并。
做完这一步,所有 AutoThink 模型推理后的准确率都超过了单次读出。但终止问题只解决了一部分:9B 仍有一半以上的推理写到 4,096 上限都停不下来。这就是 RLCD² 要接手的地方。
5. RLCD²:奖励推理带来的概率提升,而不是答案对错
DeepSeek-R1 这一类推理 RL 的奖励基本就是”答对给 1,答错给 0”。但决策模型的产品是概率,只看对错有两个问题:一是推理把正确选项从 0.55 推到 0.99,和推到 0.56,奖励一样;二是模型没有动力把概率报准,反而可能学得越来越自信。
RLCD²(Reinforcement Learning for Calibrated Deliberative Decisions)建立在之前的 RLCD 工作上,核心是换一种打分方式。
5.1 用 proper scoring rule 给整个分布打分
proper scoring rule(适当评分规则)可以这样理解:如果一个打分规则让模型只有如实报告自己真实相信的概率,期望得分才最高,它就是 proper 的。最常见的两个:
- Brier score:$S_B(p,t)=-|p-t|_2^2$,预测分布和目标的平方误差取负;
- 对数评分:$S_L(p,t)=\sum_k t_k\log p_k$,就是 Stage 1、2 那个交叉熵取负。
RLCD² 发布的模型用的是第三种,决策加权评分。对单个选项,设报告概率为 $q$,真实结果 $z\in{0,1}$:
\[s(q,z)=z\,W(q)-C(q),\qquad W(q)=\int_0^q w(c)\,dc,\qquad C(q)=\int_0^q c\,w(c)\,dc\]再对所有选项求和:$S_D(p,t)=\sum_{k=1}^K s(p_k,t_k)$。设这个选项真实的正确概率是 $\pi$,对 $q$ 求期望得分的导数:
\[\frac{\partial}{\partial q}\mathbb{E}[s(q,z)]=w(q)(\pi-q)\]只要 $w\ge0$,$q<\pi$ 时导数为正、$q>\pi$ 时为负,期望得分在 $q=\pi$ 处最大,所以它是 proper 的。$w(c)$ 是一个权重密度,决定哪个概率区间的误差更要紧。作者取的是均匀分布和 Beta(8,2) 各占一半的混合。Beta(8,2) 的峰值在 0.875 附近,意思是 0.8–0.95 这段高置信区间的误差被重点惩罚。这正好对应下游的用法:”置信度过 0.9 就自动执行”,在这个阈值附近报错概率,代价最大。对 score 这种有序等级,评分作用在累积概率上。
5.2 奖励怎么算,策略怎么更新
下面这张图是一道题在 RL 里走的完整流程。从左边的”题目 x”出发,分上下两路:上路是紫色的策略模型采样 $G$ 条推理,下路直接进入蓝色的冻结模型;两路在冻结模型汇合,产出 $p_0$ 和 $p_{1,i}$,再从左往右依次变成奖励、优势和损失,顶部的紫色虚线表示用损失更新策略模型。
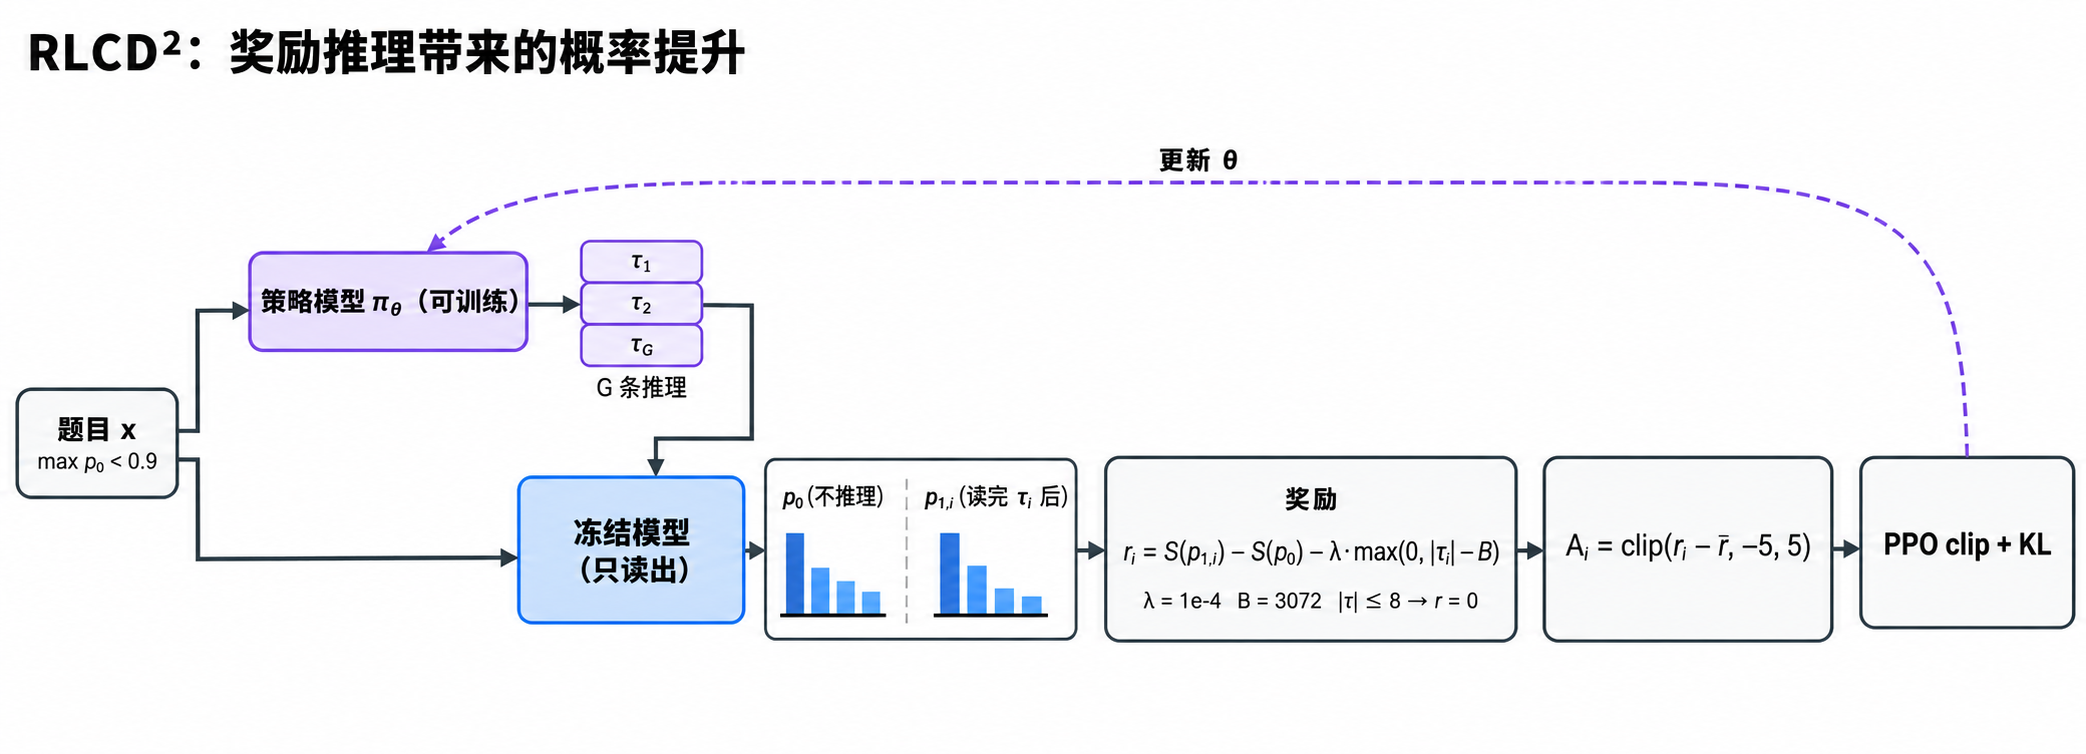
奖励公式:
\[r(x,\tau)=S\big(p_1(x,\tau),t\big)-S\big(p_0(x),t\big)-\lambda\max\big(0,\,|\tau|-B\big)\]对着图走一遍:
- 选题:只用 $\max p_0<0.9$ 的题训练,和推理时的门控一致。确定能直接答的题,推理不推理都无所谓,不拿来训。
- $p_0$ 和 $p_1$ 都由一份冻结的模型计算,也就是推理监督之后的起点模型。策略模型(全部参数可训)只负责生成推理 $\tau$。这一点很关键:如果读出也用策略模型自己,它可以通过改读出层来”刷分”,而不是写出更有用的推理。冻结 scorer 之后,奖励只反映推理内容本身让一个固定的读者判断得更好了多少。
- 长度惩罚:$B=3072$ 是软预算(和 4,096 的生成上限是两回事),$\lambda=10^{-4}$,超出预算 1,000 个 token 扣 0.1 分。不做硬截断,只是越长越亏。
- 空推理:8 个 token 以内就结束的轨迹视为没推理,奖励固定为 0。
优化用的是 GRPO(Group Relative Policy Optimization)风格:不训 value 网络,对同一道题采样 $G$ 条推理,用组内平均奖励当 baseline:
\[A_i=\mathrm{clip}\big(r_i-\bar r,\,-5,\,5\big)\] \[\mathcal{L}=-\frac{1}{N}\sum_{i\in\mathcal{T}}\sum_{s=1}^{|\tau_i|}\min\Big(\rho_{i,s}A_i,\ \mathrm{clip}(\rho_{i,s},1-\epsilon,1+\epsilon)A_i\Big)+\beta\,\widehat{\mathrm{KL}}(\pi_\theta\|\pi_{\text{ref}})\]各变量的作用和形状:
- $A_i$ 是序列级的标量,第 $i$ 条推理的每个 token 都用同一个 $A_i$;
-
$\rho_{i,s}=\pi_\theta(\tau_{i,s})/\pi_{\text{old}}(\tau_{i,s})$ 是第 $i$ 条推理第 $s$ 个 token 在当前策略和采样策略下的概率比。实现上,策略模型对每条推理输出 [|τ_i|, 248320]的 logits,gather 出采样 token 的 log-prob,就得到一个长度 $\tau_i $ 的向量; - $N$ 是 batch 里所有生成 token 的总数,所以这是 token 级平均,长推理的 token 不会被稀释;
- KL 用 k3 估计:对每个生成 token 算 $\pi_{\text{ref}}/\pi_\theta-\log(\pi_{\text{ref}}/\pi_\theta)-1$ 再平均,这个估计恒非负、方差小;
- 优势不除以组内标准差(沿用 Dr. GRPO,Liu et al. 2025 的做法),奖励差异小的组更新也小,不会被标准化放大。
论文没有给 $G$、$\epsilon$、$\beta$ 的具体取值。
有个细节值得想一下:同一道题的 $G$ 条推理,$S(p_0,t)$ 是同一个常数,中心化之后会被减掉。那它还有什么用?用在空推理身上。空推理奖励固定为 0,而非空推理的奖励是 $S(p_1)-S(p_0)-\text{惩罚}$。这样只有当推理真的让分数提升超过了长度成本,非空推理的奖励才会大于 0、高过空推理;否则”不想”反而更划算。$S(p_0)$ 就是”不推理”这个选项的基准线。
5.3 RLCD² 的主要收益是省 token,不是涨分
下面这张图有五个子图,灰点是 RL 前(只做了推理监督),紫点是 RLCD² 之后的发布版,箭头表示变化方向。从左往右依次是:held-out 准确率、推理自己停下来的比例、平均推理长度、推理后的校准误差、DecisionPivot 上的对题率。
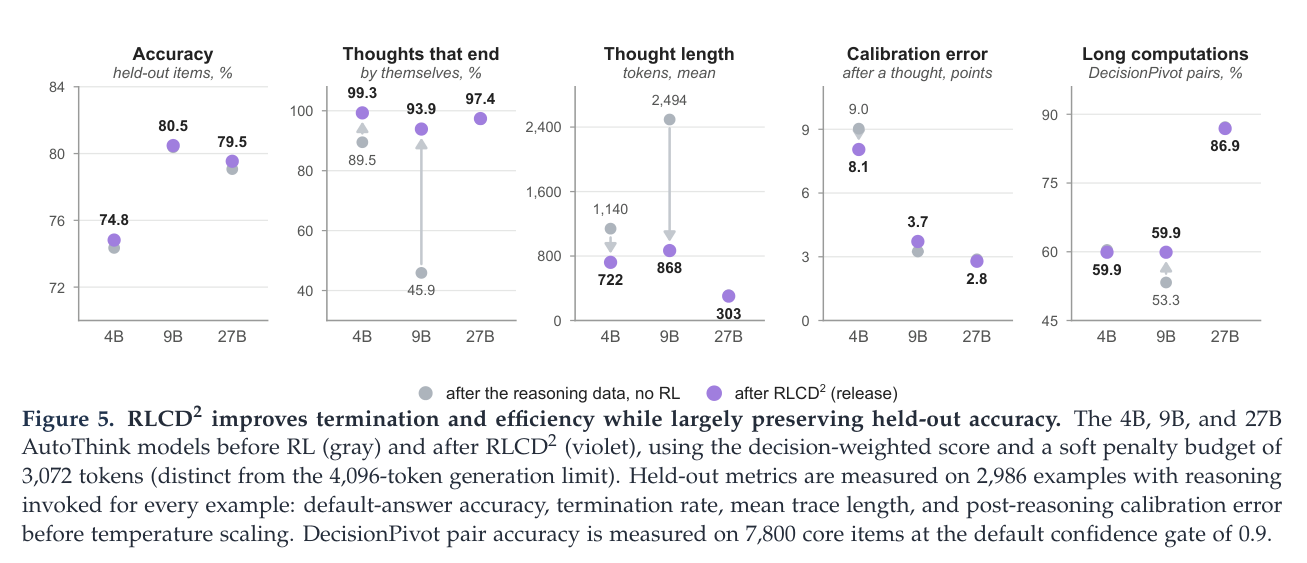
几个子图对着看:
- 第二、三个子图变化最大。9B 的终止率从 45.9% 拉到 93.9%,平均推理长度从 2,494 降到 868 token,少了 65%。4B 的终止率从 89.5% 到 99.3%,长度少了 37%,90 分位从 4,096 降到 1,358。
- 第一个子图几乎没动:准确率变化的置信区间都包含 0。27B 本来推理就短(平均 313 token)、终止率 97.2%,RL 基本没有可改的空间。
- 第四个子图的校准误差(calibration error,按置信度分桶,统计每个桶里”平均置信度”和”实际正确率”的差距再加权平均,越低越好)只有 4B 从 9.0 降到 8.1,做完温度缩放后两者又差不多。
- 第五个子图里唯一明显的涨分是 9B 在 DecisionPivot 上从 53.3% 到 59.9%,原因是 RL 前 9B 有 54% 的题推理停不下来,RL 治好了这部分。
作者还做了奖励组件的对照,结论很干脆:终止率的改善几乎全是长度惩罚的功劳,把预测奖励换成随机噪声,终止率照样接近 100%;校准的改善则来自 proper score 奖励,换成只看对错的奖励,或者把长度惩罚换成”停下来就加分”,校准都不会变好。
预算 $B$ 也有取舍。4B 用 512 的预算,推理长度减半,但 DecisionPivot 从 60.4% 掉到 52.9%;完全不加长度惩罚,DecisionPivot 能到 61.7%,但推理长 40%,约三分之一停不下来。最终选的 3,072 在两者之间:DecisionPivot 59.9%,held-out 终止率 99.3%。代价是原本要推理 2,048–4,095 token 的长计算题,RL 后仍会掉 4–6 分。
6. 实验:Instant 拿总分,AutoThink 拿计算题
主要评测有两个。Decision Index(DI)是决策模型的公开排行榜,0.2.1 版汇总了 5 个领域 38 个基准的分数,每个基准都做了”机会校正”:先扣掉随机瞎猜能拿到的分,所以 0 分等于瞎猜。0.3 版去掉了 ForecastBench,并重建了 2,638 道 GSM8K 题,去掉了选项里泄露答案的线索。公开部分只占排行榜总分的 20%,论文只评了公开部分。
DecisionPivot 是作者自己提出的新基准:13 个程序生成的任务族,每族 600 题,大多组织成只差一个关键细节、答案就不同的题对,比如上面 Case A 和 Case B 那样。指标是 pair accuracy,一对题必须都答对才算分,所以靠猜或者靠表面特征很难拿分。
先看 DI 0.3。下图横轴是参数量,紫线是 StartLux-Decision Instant,灰线连的是每个规模上最强的第三方模型(全是 Decision 3.0 家族),虚线是闭源的 Jev。
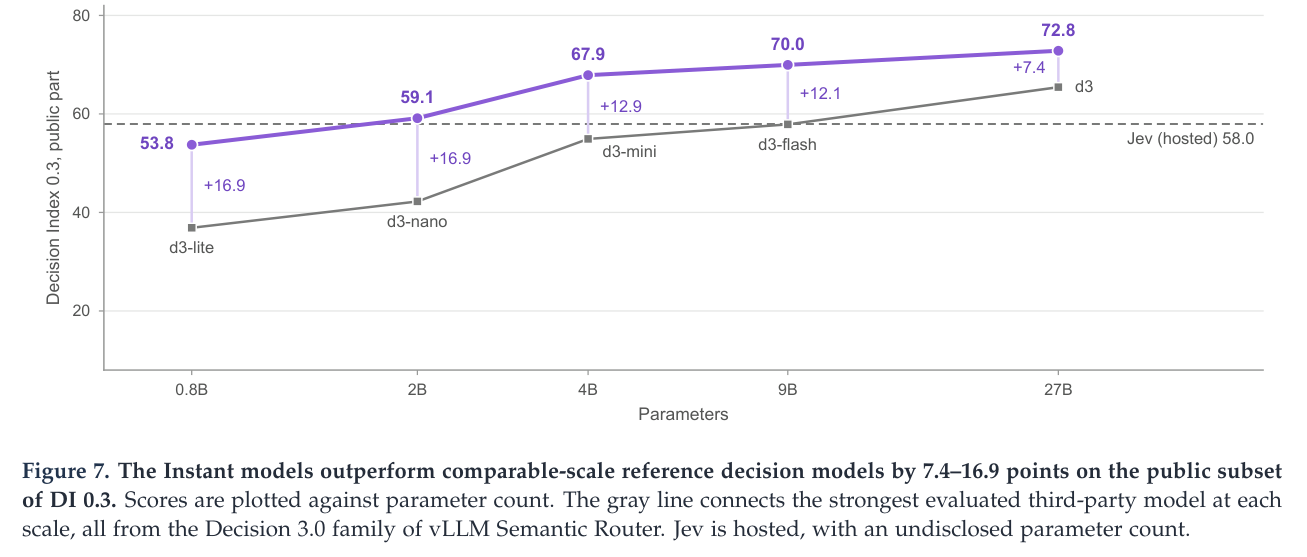
每个规模上 Instant 都领先 7.4–16.9 分,小模型领先得更多。最值得注意的是 4B Instant 的 67.9,已经超过了所有参考模型,包括 27B 的 Decision 3.0 d3(65.4)。AutoThink 在 DI 总分上只比 Instant 多 0.3–0.5 分,因为 DI 里大部分题不需要算;但在 Knowledge & Reasoning 这个域,4B 和 9B 的 AutoThink 分别比 Instant 高 7.0 和 6.2 分。
再看 DecisionPivot。下图的实心条是单次读出(Instant),斜纹延伸部分是 AutoThink 多出来的分数,灰色是其他系统。
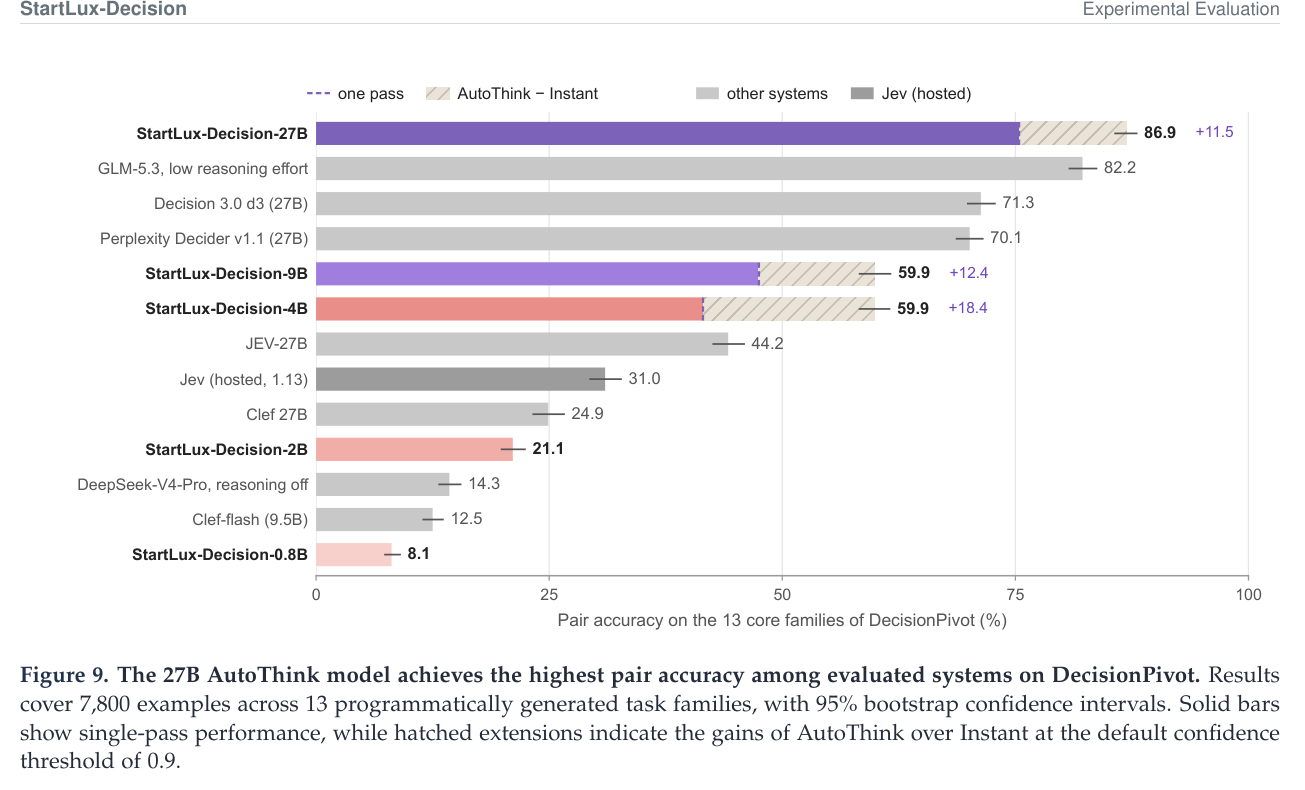
AutoThink 在三个规模上分别比 Instant 高 18.4(4B)、12.4(9B)、11.5(27B)分。27B AutoThink 的 86.9% 排第一,超过了开着推理的 GLM-5.3(82.2%)。0.8B 和 2B 只有 8.1% 和 21.1%,说明这个基准对单次读出的小模型确实很难。
分任务族看差异更明显:过滤类任务上 4B、9B 的 AutoThink 比 Instant 高约 51 和 56 分,目标状态校验高 30 和 44 分,排期冲突检测高 46 和 25 分;而策略解读、条款变化、依赖解析这类偏结构理解的任务,单次读出已经足够好。推理的价值集中在真正需要算的题上。
最后看门控阈值的作用。下图每条曲线是把 $g$ 从 0(从不推理)扫到 1(总是推理),横轴是平均每题花的推理 token(不推理的题按 0 算),星号是默认的 $g=0.9$;实线是 RL 后,灰色虚线是 RL 前。上排是 held-out 准确率,下排是 DecisionPivot。
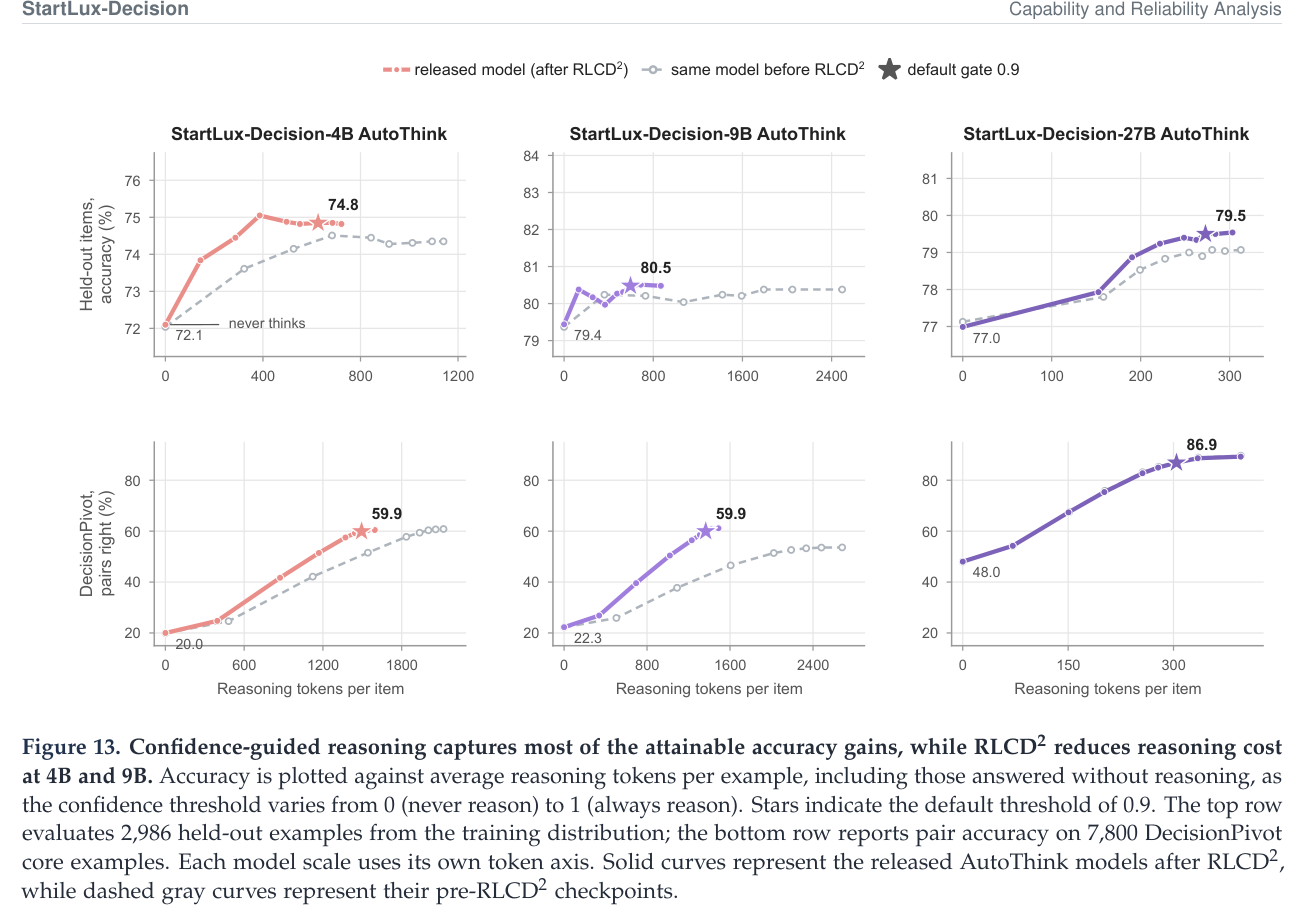
上排说明门控在 0.9 时已经拿到了大部分收益:9B 在星号处 80.5%,再往右(更多题去推理)基本不涨;27B 平均每题只花 273 个推理 token 就涨了 2.5 分。下排说明在计算题上推理的收益要大得多:9B 关掉推理只有 22.3%,开到默认门控是 59.9%;27B 从 48.0% 到 86.9%。再对比实线和虚线,RL 后的曲线整体左移,同样的准确率花的 token 更少,这就是 5.3 节说的效率收益。
部署开销上,默认门控下 4B、9B、27B 在 DI 上分别对约 33%、29%、28% 的题触发推理,平均每题 372、271、110 个推理 token。单次读出在一张 H200 上 1,024 token 的 prompt 只要 31 ms(0.8B)到 98 ms(27B),延迟敏感的场景用 Instant 更合适。
7. 单条预测校准得好,进了下游 pipeline 不一定还准
论文后半部分还有一个很有意思的发现,和模型本身无关,但对所有用置信度做决策的系统都适用。
决策模型的概率通常不是单独用的,而是被下游策略拿去筛选和路由。常见的几种:best-of-N(生成 N 个候选,用 verifier 打分,选分最高的那个)、cascade(小模型没把握就升级给大模型)、AutoThink 自己的 think-gate。问题是,经过这些策略筛选之后,原本校准好的概率可能就不准了。
下图左边是 9B 当 verifier 做 best-of-N 的例子:只看报告置信度在 80–90% 之间的那批被选中的回答,横轴是候选数 $N$,纵轴是这批回答的实际正确率。灰线是常规校准,紫线是作者的 policy-aware 校准。右边是四类 pipeline、共 184 个设置上的平均偏差。
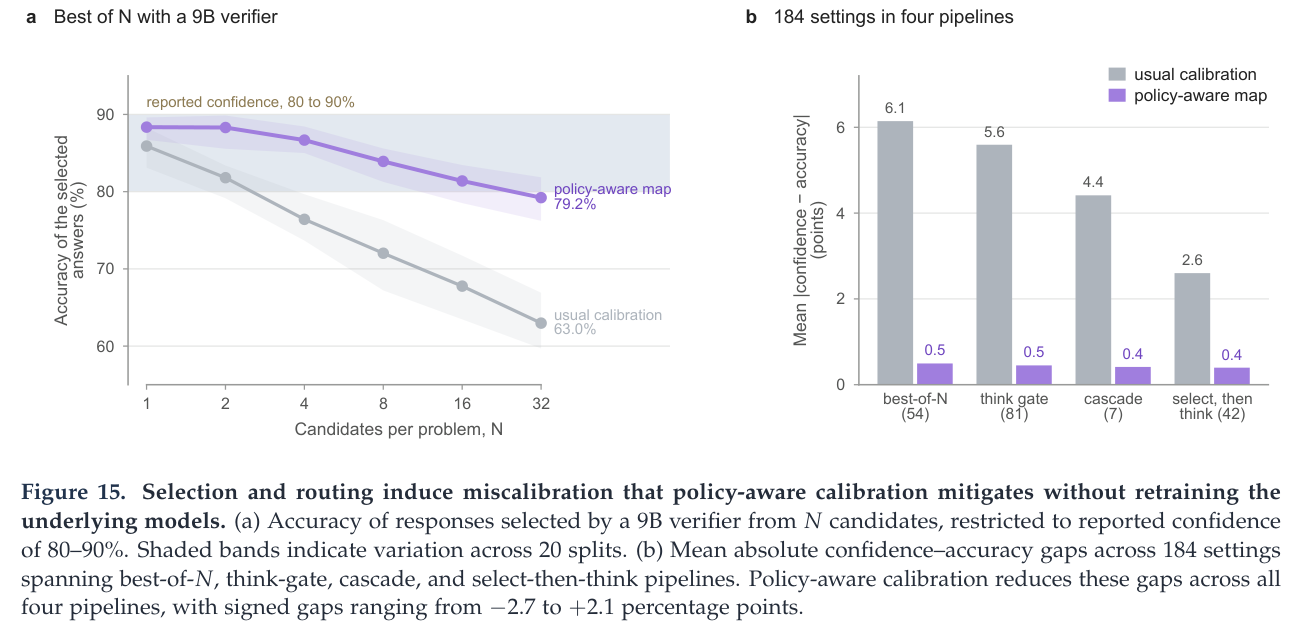
看灰线:$N=1$ 时正确率接近 86%,基本在 80–90% 的区间里;$N$ 一路涨到 32,正确率掉到 63%。模型没变,报告的置信度也没变,但”80–90% 把握”的实际含义已经完全不同了。原因是从 32 个候选里挑最高分,挑中的往往是分数恰好向上波动的那个,和 optimizer’s curse 是一回事;而且其余 31 个候选的分数本身也包含”这题有多难”的信息,只看赢家的分数会丢掉这部分信息。在 $N=16$ 时,113 个生成器–verifier 组合里有 111 个出现了过度自信。
作者的解法叫 policy-aware calibration:在部署的那个策略的输出上做校准,而不是在单条预测上做。
- 对门控和 cascade,按路由时用的置信度分位数分层,每层里单独做 isotonic 回归(一种保序回归,只要求映射单调不减,不假设具体函数形式);
- 对 best-of-N,用报告置信度、候选平均分、$N$、$\log N$ 拟合一个 logistic 模型,再接 isotonic。
右图里四类 pipeline 的平均偏差都从 2.6–6.1 个百分点压到了 0.4–0.5。不用重训模型,只改后处理。局限是对分布偏移敏感:在 held-out 分布上拟合的映射迁移到没见过的数据集上,仍有最高 6.1 个百分点的过度自信。
8. 总结
这篇工作把”决策模型要不要推理”拆成了几个可以单独回答的问题:
- 怎么读概率:字母 logits + 按类型拟合温度,不加分类头,单次读出和推理后读出用同一个接口,两个分布天然可以融合。
- 单次读出怎么更准:在 3:1 混合架构里只把 8 层 full attention 改成 prompt 内双向,训练时就用这个 mask,改动小、收益稳定,代价是不能复用文档 KV cache。
- 什么时候推理:$\max p_0<0.9$ 才推理,在 DecisionPivot 上 61% 的题进入推理,正确率从 57% 拉到 93%。
- 推理怎么训:冻结 scorer 算推理前后的 proper score 之差当奖励,加软长度惩罚。长度惩罚负责”停下来”,proper score 负责”概率报准”,分工有对照实验支撑。
几个需要注意的地方:
- DI 公开子集同时是开发集,数据配方、注意力变体、seed 平均都是按它挑的,作者自己也承认这些分数不算独立测试。真正的独立评测是 DecisionPivot,但它也是作者自己建的基准。
- RLCD² 的主要贡献是效率。9B 推理长度少 65%、终止率翻倍,但准确率基本持平,明显涨分只出现在 9B 的 DecisionPivot 上。长计算题还会掉 4–6 分。
- $\alpha$ 没有放之四海皆准的取值:DecisionPivot 上只用 $p_1$ 准确率最高(9B 61.5%),但在 DI 上 $\alpha=0.75$ 反而比等权多了 0.8–2.0 分的校准误差。
- 部署有坑:Instant 必须用作者的 vLLM 插件、llama.cpp patch 或 MLX 后端,用原生引擎加载会静默退化成因果模型;仓库默认门控是 0.6,论文结果是 0.9。权重是 CC BY-NC 4.0,商用需要另外授权。
更大的启发在第 7 节:“模型校准得好”和”系统里的置信度可信”是两回事。只要下游有 best-of-N、cascade、think-gate 这类按分数筛选的逻辑,就应该在实际部署的 pipeline 输出上重新校准和设阈值。
欢迎评论区交流,有理解不对的地方也请指出。
顺带一提,这篇论文做的事情本质上是”按题目难度分配算力”:简单题一次前向,难题才推理,再用 RL 把推理压到够用的长度。这和 AutoML 里”把搜索预算花在有希望的候选上”是相近的思路,只是对象从网络结构换成了推理 token。我们写的《动手学 AutoML:从 NAS 到大语言模型优化实战》没有讲决策模型和推理 RL,但应用篇里 LLM 剪枝量化(第 8 章)和 LLM Agent + AutoML(第 9 章)这两部分,讨论的也是怎么在效果和开销之间做取舍,感兴趣可以翻翻。
