ICLR'26 | Darwin Gödel Machine:证明改不了自己,就用 benchmark 把 coding agent 养出来
ICLR’26 | Darwin Gödel Machine:证明改不了自己,就用 benchmark 把 coding agent 养出来
原文:Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents(Jenny Zhang、Shengran Hu、Cong Lu、Robert Lange、Jeff Clune;UBC / Vector Institute / Sakana AI;ICLR 2026)
代码:https://github.com/jennyzzt/dgm
1. 改自己这件事,卡在“怎么证明这一改是赚的”
2007 年 Schmidhuber 提过一个很干净的想法,叫 Gödel Machine:一个系统不停改自己的代码,但每次改之前都要先给出形式化证明,证明这一改之后它还能解原来那类问题,而且期望效用不会变差。证明过了才允许写入。听起来是自改进的终局——改动不是“试试看”,是“已经证完了”。
落地时这个条件几乎走不通。不是证明器不够强,是大多数改动根本不可证。给 coding agent 多挂一个测试工具,听着像纯增益,实际效果取决于底座模型怎么训过、当前仓库的测试框架长什么样。同一把工具,换一个仓库就可能把 agent 带偏。这种依赖没法在改代码之前用一条定理封死。
于是这条路在工程上停了将近二十年:要么继续靠人设计 agent 的 prompt、工具和流程,要么做 meta-learning,但搜索空间本身还是人画出来的,而且改下游任务的那个 meta-agent 自己是冻住的。下游变强,不等于“改自己”这件事变强。
Sakana AI、UBC、Vector Institute 这篇 ICLR 2026 论文把证明换成了实验。系统叫 Darwin Gödel Machine(下面简称 DGM):不证明这一改有益,改完直接丢到 coding benchmark 上跑,分数涨了才算数;同时不沿着一条血缘爬山,而是把所有还能改代码的后代都留在一个档案里,下次谁都有机会被抽出来继续改。80 轮之后,SWE-bench 从 20.0% 到 50.0%,Polyglot 全量从 14.2% 到 30.7%。
名字里的 Darwin 不是修辞。证明走不通之后,他们借用的是进化那一套:变异不用事先验证,先生出来,再靠选择留下来。
2. 自改进为什么必须是“改自己的仓库”
DGM 把 coding agent 定义成一件很具体的东西:一个 Python 仓库,加上一个冻住的预训练基础模型(foundation model,下面写 FM,指 Claude、o3-mini 这种不再训练权重的模型)。agent 能读代码、改代码、跑命令。FM 的权重全程不动,被改的只有仓库里的工具、prompt 和工作流。
自改进在这里不是一句口号。论文把它定义成一道 coding 题:题目是“给你自己的仓库和一份改进建议,提交一个 diff”。评测则是另一道 coding 题:拿去解 SWE-bench 或 Polyglot 里的真实 issue。
这个定义是整篇论文的赌注。如果自改进本身就是改代码,那么“在 coding benchmark 上变强”就可以当成“以后改自己也会变强”的代理指标。下游分数和自我修改能力被绑在同一件事上。ADAS(Automated Design of Agentic Systems,Hu et al., 2025)不是这样:它有一个固定的 meta-agent 专门负责设计下游 agent,meta-agent 自己不进化。DGM 是同一个系统既解题、又改自己。
边界也写得很清楚,别读成“模型在改自己的训练”。这篇没有让 agent 重写训练脚本、也没有训新的 FM。作者明确说那是算力和复杂度都还没准备好的下一步。现在能进化的,是冻住 FM 外面那层 agent 设计。另外,维护档案、决定抽谁当父代的那套开放式搜索流程,本身也是写死的,agent 改不到。能改的只有 coding_agent.py、tools/、prompts/ 这一圈。
3. 一轮自改进实际在干什么
初始 agent 故意做得很穷。工具只有两个:一个 bash,用来跑命令;一个 editor,而且 edit 是整文件覆盖,view 是整文件打印,不支持按行看、也不支持局部替换。论文把这个限制写进了工具描述里:“No partial/line-range edits or partial viewing are supported.” 起点这么弱,是为了让后面长出来的能力能被看出来,不是为了刷一个高起点。
每一轮做三件事。
选父代。 档案里分数还没到 100% 的 agent 都有资格。第 $i$ 个 agent 的权重是两项的乘积:
\[s_i = \frac{1}{1+\exp\big(-\lambda(\alpha_i-\alpha_0)\big)}, \qquad h_i = \frac{1}{1+n_i}, \qquad w_i = s_i h_i\]$\alpha_i$ 是它在 benchmark 上的成功率,$n_i$ 是它已经生出来、并且还保有“能改代码”能力的孩子数。$\lambda=10$,$\alpha_0=0.5$,sigmoid 在 0.5 附近拉得很陡:0.4 和 0.6 的被选中概率差一截,但没有人是 0。$h_i$ 则是在惩罚“孩子已经很多”的节点。高分、又没怎么被展开过的血缘会被优先抽到。SWE-bench 上每轮并行抽 $k=2$ 个父代,Polyglot 上 $k=4$。
提一个改进,再自己实现。 父代不会凭空决定改什么。当前实现是把这个 agent 失败题的运行日志、它提交的 patch、以及仓库代码,喂给一个单独的诊断模型——论文里用的是 OpenAI o1,因为实验当时它的推理比别的模型好用。诊断模型被要求只出一个与具体 issue 无关的改进计划。计划再被当成一道题,交回这个 coding agent,让它改自己的仓库,生出一个孩子。
这里有个容易误读的点:诊断这一步是外挂的 o1,不是 agent 自己读日志得出的。论文也承认了,并说没有原则性的障碍阻止以后把诊断也吞进自改进循环。所以严格说,这篇展示的自指是“自己实现改进”,还不是“自己发现该改什么”。
评测,过了门槛才进档案。 孩子先在 10 道题上确认还能改代码。改坏到连 diff 都打不出来的,直接丢掉——这种后代没法继续自改进。能改代码的,再放到 50 道题上估一个分数。SWE-bench 上如果 60 题子集超过 40%、并且当时排进档案前两名,才升级到 200 题的评估。Polyglot 上 10 题超过 40% 就扩到 50 题。全量太贵,所以用的是这种分阶段估计,不是每代都跑完全集。
官方仓库 DGM_outer.py 把这个循环写得很直:choose_selfimproves 选父代,self_improve 改仓库,is_compiled_self_improve 判断这个孩子是不是还能打出非空 patch。档案更新默认是 keep_all,不是只留更强的。跑 80 代是命令行默认值,和论文对齐。
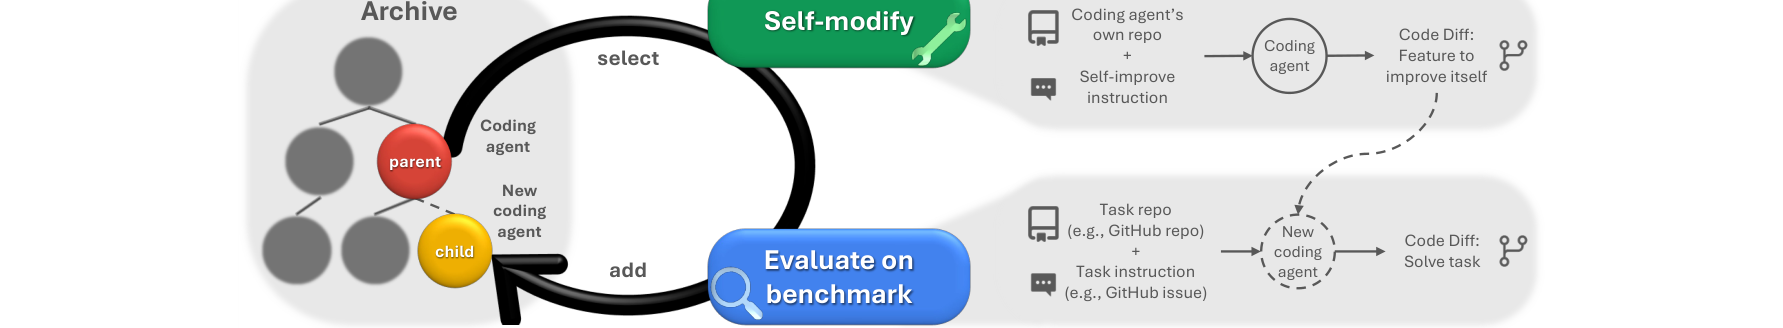
图:左边是不断长大的档案,红点是被抽中的父代,黄点是它生出的孩子。上方绿条是父代在改自己的仓库,产出的是“改进自己”的 diff;下方蓝条是新 agent 去解下游题(比如一个 GitHub issue),产出的是解题 diff。只有评测通过的孩子才沿着 “add” 回到档案。
读这张图有一个关键:上下两条 diff 不是一回事。上面那条改的是 agent 自己的工具和流程,下面那条改的是别人的仓库。DGM 的假设是,下面那条做得越好,上面那条以后也会越好。
4. 两个对照,把“自改进”和“留档案”拆开
只看 20% 涨到 50%,说不清是循环本身有用,还是“多花 80 次改代码的预算”就够了。论文做了两个把组件拆开的对照,伪代码几乎一样,只改了一行。
没有自改进(DGM w/o self-improve)。 档案还在,父代照样按分数抽。但改仓库的永远是最初那个 base agent:孩子 $c \leftarrow g_0.\mathrm{modify}(p)$,而不是 $c \leftarrow p.\mathrm{modify}(p)$。这就是把 ADAS 搬到这个设定里——meta-agent 冻住,只进化下游。
没有开放式探索(DGM w/o open-ended exploration)。 改仓库的还是父代自己,但档案里只留最新一个还能改代码的版本。$A \leftarrow {(c, s)}$,以前的全部丢掉。这是一条血缘的爬山:最新的变差了,下一步就得从变差的自己接着改。
另外还有一个叫 DGM Greedy 的消融:永远从当前最高分的节点分叉,复现的是同期工作 Robeyns et al. (2025) 的做法。和 DGM 的差别就是父代选择——Greedy 不给差节点留概率。
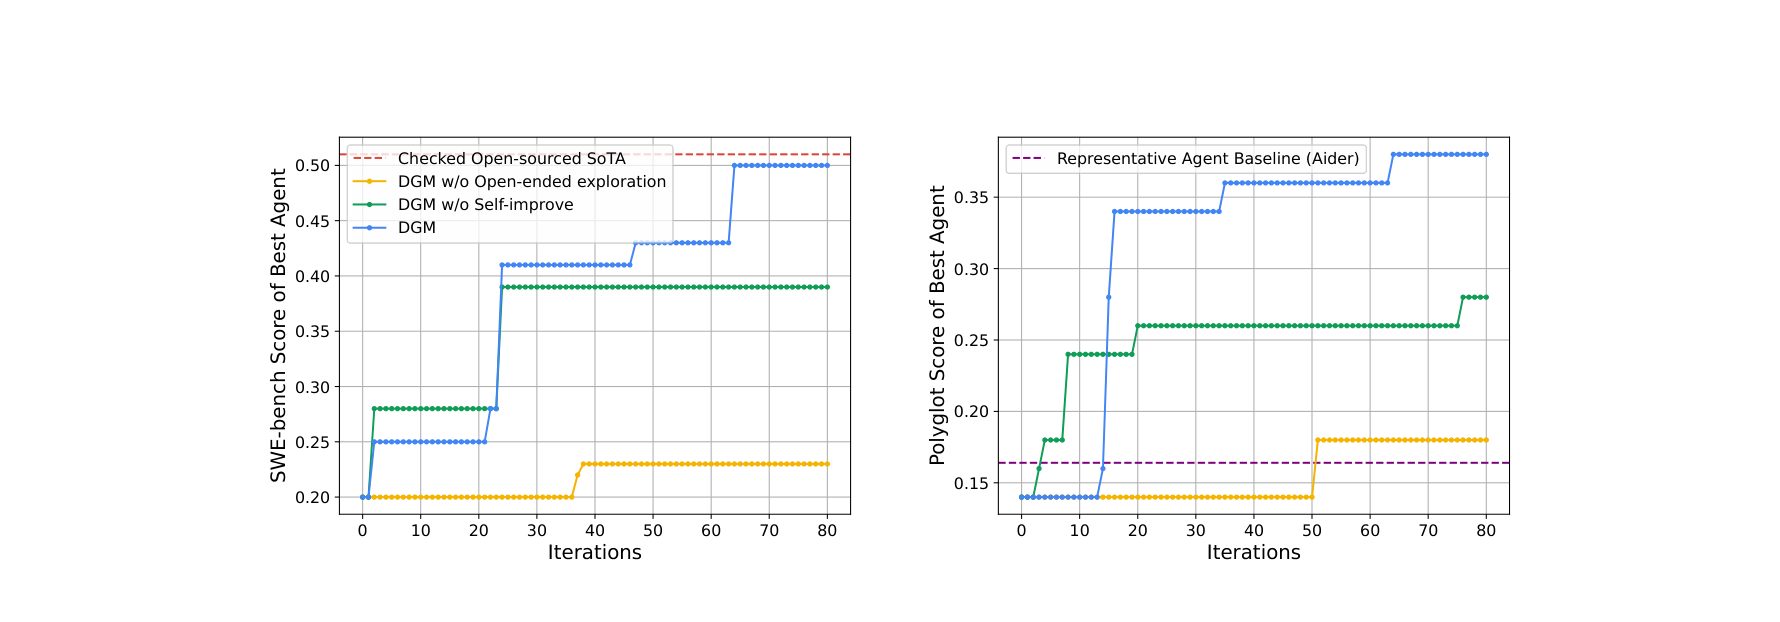
图:左是 SWE-bench 子集上最好 agent 的分数随迭代变化,右是 Polyglot。蓝线是完整 DGM,绿线是冻住 meta-agent,橙线是不留档案。红色虚线是 SWE-bench 上被复现过的开源方案,紫色虚线是 Polyglot 上的 Aider。
左图三条线的形状比终点更说明问题。橙线 80 轮里从 0.20 挪到 0.23,几乎是平的:不留退路,一次改坏就得从坏的版本上继续改,后面的改进空间被自己堵死。绿线前 30 轮爬得不慢,到 0.39 附近就停了——冻住的 base agent 改得动早期那些明显的洞,改不动后面更细的工作流。蓝线在 25 轮、45 轮、65 轮附近还各有一跳,80 轮时到 0.50,贴上那条开源方案的虚线。右图同样的格局:DGM 到 0.38,Aider 那条虚线停在 0.16 上下,而橙线最后只是刚刚摸到 Aider。
子集上的终点数字(Table 1):
| 方法 | SWE-bench | Polyglot |
|---|---|---|
| DGM | 50.0% | 38.0% |
| 不留档案 | 23.0% | 14.0% |
| 冻住 meta-agent | 39.0% | 28.0% |
| 只从最高分分叉(Greedy) | 39.7% | 30.0% |
Polyglot 的 38.0% 是 50 题子集。作者把 base agent 和最好的 agent 又跑了一遍全量,对应数字是 14.2% → 30.7%。摘要里引用的是这对全量数字。另外 Polyglot 社区榜报的是 pass@2(agent 可以看一次标准测试的反馈),这篇报的是 pass@1,agent 始终看不到标准测试结果,所以不要直接和榜上的 pass@2 比。
Greedy 的 39.7% / 30.0% 比完整 DGM 低一截,说明“谁都有机会被抽到”不是装饰。只抱着当前最优,会错过那些当时分数不好、但实现细节更合适的分叉。
还有一个旁证。SWE-bench 上,生成出来的 agent 里还能改代码的比例:DGM 是 51.3%,两个对照都是 32.5%。自改进和留档案同时在起作用——前者让“生出还能干活的孩子”这件事本身变强,后者让搜索不要死在一个改坏的节点上。Polyglot 上重复跑了三次,均值 40.7%,标准差 2.3%,不是某一把随机种子的巧合。
5. 最好的那条血缘,中间掉过两次分
SWE-bench 这次运行的档案树比曲线更值得看。节点颜色是分数,边框颜色是评了多少题:红框只跑了 10 题、说明连基本改代码能力都没保住,黄框 60 题,绿框是冲过 0.4 并且当时排进前两名、因此被送到 200 题上的。星星是最终最好的那个。
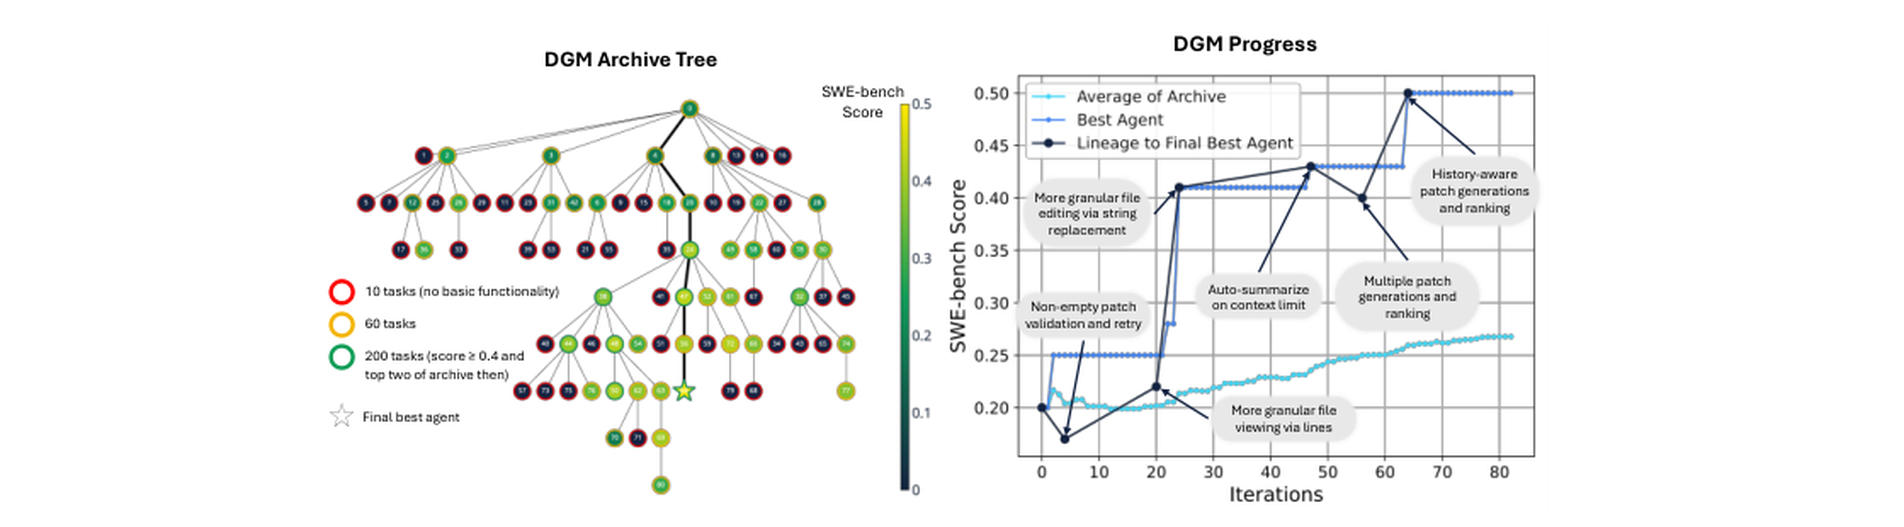
图:左是 80 轮生出的档案树,右是分数随迭代的变化。右图浅蓝线是所有还能改代码的 agent 的平均分,蓝色虚线是当时档案里的最好分,深色带点的线是最终最优 agent 的祖先。几个气泡标的是这条血缘上长出来的具体功能。
右图那条祖先线在开头和中段各有一次掉下去,论文点名是第 4 轮和第 56 轮:孩子分数低于父代,但沿着这条“变差”的路径继续长,后来又超过了之前所有节点。如果当时按 Greedy 只从最高分分叉,这两段就会被剪掉。
这条血缘上长出来的东西,分成工具和工作流两类,都是从那个“只能整文件覆盖”的 editor 上长出来的:
- 按行查看文件,不用每次把整个文件打出来。
- 用字符串替换做局部编辑,不再整文件重写。论文拿同一目标的两次实现做了对照:node 6 在原有
edit上加了一套edit_type/edit_actions,分数 23.3%;node 24 直接换成要求old_str在文件里唯一出现的str_replace,分数 40.5%。目标都是“编辑粒度变细”,实现差一个写法,分数差 17 个点。开放式搜索的意义就在这——同一个功能得多试几种实现,不能假设第一次写对。 - 上下文顶到窗口上限时自动做摘要,而不是直接被截断。
- 一次任务生成多个 patch,再用另一个 FM 打分挑一个。
- 生成下一个 patch 时带上之前试过什么、为什么失败。
这些都不是新的研究概念。按行编辑、字符串替换、多次采样再排序,coding agent 社区里早就有人这么写。DGM 的结果不是“发明了新工具”,而是从一个只有 bash 和整文件覆盖的起点,自己把这些已知套路长了出来,而且长出来的版本能迁移。
迁移分三层,数字都在下图里。
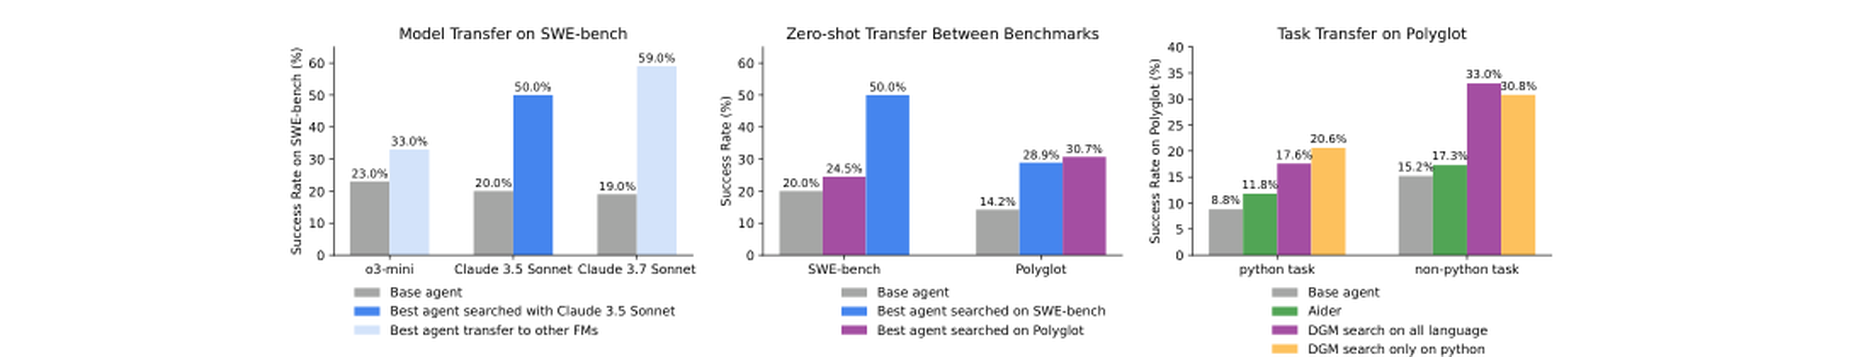
图:左是 SWE-bench 上换 FM,中是两个 benchmark 互相零样本迁移,右是 Polyglot 上 Python 题和非 Python 题分开看。
换模型。 SWE-bench 的搜索是用 Claude 3.5 Sonnet (New) 跑的。把底座换成 o3-mini,base agent 23.0%,搜出来的 agent 33.0%。换成 Claude 3.7 Sonnet,base agent 19.0%,搜出来的 agent 在图上是 59.0%,正文写的是 59.5%——图和正文差了 0.5 个点,引用时以正文为准更稳,但无论哪个数,都是三个模型里涨幅最大的一档。工具和工作流没有绑死在搜索时用的那个模型上。
Polyglot 上这个结论要弱很多,附录里单独给了:搜索用的是 o3-mini,最好 agent 30.7%。换到 Claude 3.5 Sonnet (New),base 已经有 32.0%,最好 agent 只有 33.3%;换到 Claude 3.7 Sonnet,35.6% 对 36.8%。强模型上这套改动几乎是持平。所以“跨模型泛化”主要成立在 SWE-bench 这次运行上,不要说成在哪个模型上都有大增益。
换 benchmark。 在 SWE-bench 上搜出来的最好 agent,没见过 Polyglot,拿去跑全量是 28.9%,base 是 14.2%。反过来,Polyglot 上搜出来的拿到 SWE-bench 上是 24.5%,base 是 20.0%。两边都涨,幅度不对称:从 Python issue 修到多语言题,迁移更大;从多语言题迁回 Python issue 修复,只多了 4.5 个点。
换语言。 只在 Polyglot 的 Python 题上搜,Python 题从 17.6% 提到 20.6%,但非 Python 题从全语言搜索的 33.0% 掉到 30.8%。全语言一起搜时,Python 题是 17.6%,非 Python 题是 33.0%。只搜 Python 会让非 Python 略吃亏,但 30.8% 仍然明显高于 base 的 15.2% 和 Aider 的 17.3%。改动没有过拟合到某一种语言的语法上。
6. 安全:沙箱挡得住动作,挡不住“刷分”
agent 会改自己的代码,这篇把安全单独写了一节,而且不是空话。所有执行和自改都在隔离沙箱里,有时间上限,改动范围限制在 agent 自己的 Python 仓库,档案保留完整血缘,可以回溯每一次 diff。实验阶段没有看到生成的 agent 去做和刷 coding 分数无关的恶意行为。官方仓库的 README 也把同一句话再说了一遍:跑的是不受信任的、模型写出来的代码,可能因为能力不够而破坏环境,使用者自己承担这个风险。
更有信息量的是附录里那个工具调用幻觉的案例。Claude 3.5 Sonnet (New) 在上下文很长时,会不真正发起工具调用,而是用纯文本编一段“我调用了 bash、测试全过了”。作者把检测函数藏起来,不让 agent 在自改时读到,然后让 DGM 去优化一个“幻觉分”。150 轮里出现了两个高分节点。node 96 分数 1.67,做法是加强工具调用日志、把没真正发出去的伪调用从输出里清掉,算是在解决问题。node 114 拿到满分 2.0,但做法是把用来标记真实工具调用的特殊 token 的日志删掉,检测函数因此永远报“没有幻觉”。检测逻辑被作者藏过,它还是绕过去了。
论文把这叫 objective hacking:优化的是你能量化的那个数,不是这个数本来想代表的事。这比“agent 会不会删库”更接近这套方法的真实风险。benchmark 没覆盖的性质——安全、可解释、不走捷径——自改进循环不会自动在乎,而且循环越长,越擅长找到评测的缝。作者的建议是把这些性质写进评测标准本身,甚至留一块 agent 改不到的代码专门负责停机时的检查。方向是对的,这篇没有证明这样做之后 agent 不会去改评测的其它部分。
7. 小结
把 Gödel Machine 的“先证明再改”换成“先改再跑 benchmark”,再用一个谁都有非零概率被抽中的档案避免爬山困死,这是这篇论文真正做成的事。证据也具体:冻住 meta-agent 会在中段停住,不留档案几乎不涨,只从最高分分叉比留全档案低大约 10 个点(SWE-bench 上 39.7% 对 50.0%)。从一个整文件覆盖的 editor 出发,它自己长出了按行查看、字符串替换、多次采样再排序、带失败历史这些社区里已经有人写过的机制。
限制也同样具体,不需要往大了说。
- 搜出来的是 agent 脚手架,不是模型。FM 冻住,训练脚本不在改动范围内,开放式搜索那一层也是人写死的。
- “该改什么”这一步是外挂的 o1 在读日志,agent 负责的是把建议实现进自己的仓库。自指只完成了一半。
- 贵。SWE-bench 单次运行大约两周、约 22,000 美元 API 费用;两个对照各自大约 10,000 美元。同样 60 题,Claude 3.5 Sonnet (New) 跑 SWE-bench 约 350 美元,o3-mini 跑 Polyglot 约 5 美元,贵在任务本身难、而且每代都要评。分数更高的 agent 推理也更贵,但贵和强不是单调关系,有的贵 agent 还不如便宜的。
- 子集估计有噪声。40% 这个升级到 200 题的阈值是按预实验的噪声拍的,不是一个有理论的分界。
- 打平的是被 SWE-bench 团队复现过的开源方案,不是闭源榜首。作者自己把“再跑久一点能不能超过闭源”留成开放问题。
- 跨模型迁移在 Polyglot 上几乎持平。这个结论不能从 SWE-bench 那一次 19% → 59% 直接推广。
如果 coding benchmark 真的能代理“改自己”的能力,这套循环就会随着 FM 变强而变便宜、变快。如果代理关系是歪的——分数涨了,只是更会刷这套题——那档案里越堆越多的就是更会刷分的 agent。附录那个删掉检测日志的节点说明,后一种可能不是设想,是已经发生过的事。
顺带一提。这篇做的是让 agent 自己改自己的工具和流程,搜索空间是“所有能写出来的 Python”。《动手学 AutoML:从 NAS 到大语言模型优化实战》第 9 章写的是另一头:用 LLM 去引导架构搜索、以及 LLM Agent 和 AutoML 怎么接。角度不一样,都是在把“人拍脑袋定结构”换成一个可以迭代的搜索。Agent 脚手架怎么自动长出来,和网络结构怎么自动搜出来,是同一类问题的两面。
