AAAI'26 | 动态上下文演进下的多 LLM 在线路由:从 LinUCB 到位置感知背包启发式
论文标题:Online Multi-LLM Selection via Contextual Bandits under Unstructured Context Evolution
作者团队:Manhin Poon(香港城市大学)、Xiangxiang Dai(香港中文大学)、Xutong Liu(卡耐基梅隆大学 / 华盛顿大学)、Fang Kong(南方科技大学)、John C.S. Lui(香港中文大学)、Jinhang Zuo(香港城市大学)
发表会议:AAAI 2026(Proceedings of the 40th AAAI Conference on Artificial Intelligence)
论文链接:arXiv:2506.17670
官方代码:EntroShape/Online_LLM_Selection(本文源码分析基于 commit800c9e3核对)
在线上部署大语言模型(LLM)服务时,如何在十几个能力各异、定价悬殊的候选模型之间做动态调度,一直是工业界和学术界关注的焦点。
现有的主流路由器——无论是训练静态成对偏好分类器的 RouteLLM,还是基于单步上下文赌博机(Contextual Bandits,一种根据当前环境特征在探索未知选项与利用已知最优选项之间做在线权衡的序列决策框架)的 MetaLLM 和 MixLLM——底层都隐含了一个共同的假设:一锤子买卖(Single-Shot Routing)。用户发来一条请求,路由器挑一个模型生成回答,流程就此结束。
然而在复杂的数学推理、代码生成或专业科学问答中,没有任何一个模型能保证一次做对。哪怕是综合表现最好的单模型(如本文实验中的 Gemini-2.0-Flash),在竞赛级数学数据集 AIME 上的单步准确率也只有 20.00%。更关键的是,前序模型的失败并不是毫无价值的废料——如果将前一个模型给出的错误推导过程拼接到原始问题后面,明确告知下一个模型“上述尝试是错的,请换一种思路求解”,后续模型往往能借此避开死胡同,实现跨模型纠错(Cross-Model Refinement)。
一旦把问题从“单步选模型”扩展为“多步级联重试 + 动态追加历史回答”,传统路由方案立刻撞上两堵墙:
- 单步静态 Bandit 彻底失明:MetaLLM 等算法只根据初始问题 $Q_t$ 的特征选模型,完全感知不到每一轮重试后 Prompt 已经加入了前序模型的错误回答,问题的语义分布和推理难度已经发生了显著偏移;
- 完整轨迹强化学习(Full-Trajectory Reinforcement Learning)算不动:如果把多步路由建模为马尔可夫决策过程(MDP),每一步的状态转移都取决于前一个 LLM 自由生成的非结构化自然语言文本(Unstructured Context Evolution)。这个文本生成过程既没有闭式的状态转移概率矩阵,又会导致状态空间随级联步数呈指数级爆炸,在线冷启动阶段的采样成本高到无法承受。
面对“既要利用前序失败回答做多步纠错,又要在不可预测的文本演进与 API 预算约束下实现低样本复杂度的在线学习”这一核心矛盾,香港城市大学、香港中文大学与 CMU 等机构发表在 AAAI 2026 的这项工作给出了一套非常干脆的解法:放弃对未知文本状态转移核的强行建模,在每一步直接对已观测到的拼接上下文做条件线性建模,用瞬时遗憾(Myopic Regret)替代不可解的全局序列遗憾;并在算法设计上从无预算约束的 Greedy LinUCB 出发,一步步解决随机成本估计与多步级联中的“首步廉价弱模型偏置(Positional Bias)”,最终提出基于 0-1 背包规划的 位置感知背包启发式(Positionally-Aware Knapsack Heuristic, PAKH)。在四大高难推理基准上,PAKH 将平均准确率推高至 74.84%(远超最佳单模型 50.85% 和最强路由基线 MixLLM 64.25%),同时将 API 成本降低了 55.9%,且 95.0% 的正确回答都在第 1 步直接命中。
1. 问题建模:非结构化上下文演进下的多步级联路由
我们先通过论文给出的系统架构图,直观把握整个在线多步路由的闭环工作流。在阅读下图时,建议从左下角的 Queries(用户输入)出发,顺着蓝色粗箭头观察请求如何在候选模型池(底部的 Available LLM List)与中间的 Satisfy user ?(用户满意度判定)之间流转,并重点留意红色弧线箭头标注的 Evolve context(上下文演进)以及右侧的 Budget(预算约束)和 Positional utility(位置效用):
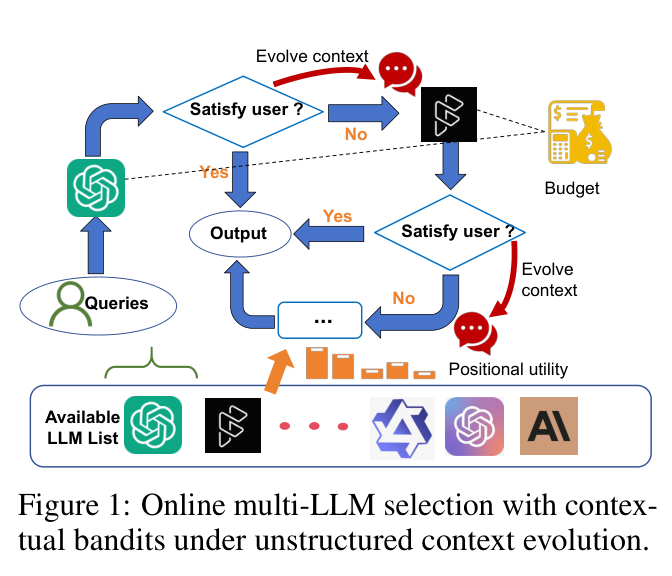
把上图拆解开来,整个在线决策过程包含四个核心环节:
- 初始查询与候选模型池(左下角):系统维护一个包含 $K$ 个异构大语言模型的候选池 $\mathcal{M} = {1, 2, \dots, K}$(对应 Bandit 中的 $K$ 个摇臂 Arm)。在第 $t \in {1, 2, \dots, T}$ 轮,用户提交一个初始问题 $Q_t$;
- 带上限的多步顺序尝试(中间环路):对于每个问题 $Q_t$,系统最多允许进行 $H$ 步(Horizon,级联深度上限,实验与代码中设为 $H = 4$)模型调用。在第 $h \in {1, \dots, H}$ 步,路由器根据当前上下文特征选出一个模型 $a_{t,h} \in [K]$ 生成回答 $R_{t,h}$,并接收二元反馈信号 $r_{t,h} \in {0, 1}$($r_{t,h} = 1$ 表示回答正确或用户满意,$r_{t,h} = 0$ 表示回答错误,继续下一步);
- 非结构化上下文演进(红色箭头
Evolve context):一旦第 $h$ 步的模型答错(Satisfy user ? -> No),系统并不是拿原题再去盲试一次,而是把刚才选中的模型标识 $a_{t,h}$ 及其生成的错误文本回答 $R_{t,h}$ 追加进上下文,使下一步的特征向量演进为 $x_{t,h+1}$; - 预算约束与位置效用权衡(右侧图标):每一次调用都会消耗取决于输入/输出 Token 数的随机 API 成本 $c_{t,h}$。与此同时,底部橙色柱状图展示的
Positional utility(位置效用)揭示了一个关键工程现实:用户希望在第 1 步就拿到正确答案,越往后的步骤即使答对,用户体验折损也越大。
1.1 形式化定义与线性可实现假设
用数学语言将上述过程严格化。在第 $t$ 轮的第 $h$ 步:
- 上下文特征向量:路由器观测到当前上下文的 $d$ 维数值表征向量 $x_{t,h} \in \mathcal{X} \subset \mathbb{R}^d$,假设特征向量有界,即 $|x_{t,h}|2 \le L$。在第 1 步,初始上下文仅由原始问题生成:$x{t,1} = \phi(Q_t)$;
- 动作与随机反馈:路由器选择模型 $a_{t,h} \in [K]$,将原始问题与前 $h-1$ 步的所有历史回答 $(Q_t, R_{t,1}, \dots, R_{t,h-1})$ 组装成 Prompt 输入模型 $a_{t,h}$,获得新生成的文本回答 $R_{t,h}$ 以及二元奖励 $r_{t,h} \in {0, 1}$;
- 线性期望奖励模型(Linear Realizability):假设每个候选模型 $k \in [K]$ 存在一个未知的真实能力参数向量 $\theta_k^* \in \mathbb{R}^d$(满足 $|\theta_k^*|2 \le S$),使得在给定当前上下文 $x{t,h}$ 时,模型 $k$ 答对问题的成功概率满足线性内积关系:
这里观测到的奖励可以写为 $r_{t,h} = \langle x_{t,h}, \theta_{a_{t,h}}^* \rangle + \eta_{t,h}$,其中噪声项 $\eta_{t,h}$ 在给定第 $t$ 轮第 $h$ 步之前的所有历史交互信息 $\mathcal{F}{t,h-1}$ 时,满足条件零均值与 1-次高斯(1-Sub-Gaussian)性质(对于二元奖励 $r{t,h} \in {0, 1}$,由于其取值有界于 $[0, 1]$,天然满足次高斯条件)。
- 提前终止与上下文演进映射 $g(\cdot)$:如果在第 $h$ 步获得了正向反馈($r_{t,h} = 1$),本轮交互立即成功终止,记第 $t$ 轮实际发生的步数为 $H_t \le H$;如果回答失败($r_{t,h} = 0$)且尚未达到最大步数($h < H$),系统通过一个未知的确定性转换函数 $g: \mathbb{R}^d \times [K] \times \mathcal{R} \times {0, 1} \to \mathbb{R}^d$ 更新下一步的上下文特征:
1.2 为什么放弃序列最优,转而定义“瞬时遗憾(Myopic Regret)”?
看到递推式 $x_{t,h+1} = g(x_{t,h}, a_{t,h}, R_{t,h}, r_{t,h})$,熟悉强化学习的读者第一反应通常是:这不就是一个标准的有限步马尔可夫决策过程(Finite-Horizon MDP)吗?为什么不用动态规划或强化学习去搜索一条全局最优的模型调用序列 $(a_{t,1}^, a_{t,2}^, \dots, a_{t,H}^*)$?
论文在 Section 3 的 Remark 与 Appendix A.1 中给出了极其透彻的剖析——因为转移函数 $g(\cdot)$ 内部包裹着大语言模型的自由文本生成过程 $R_{t,h}$,使得超前规划在计算和信息论上双双不可行:
- 状态转移完全不可预测(Unpredictable Transitions):在真正调用模型 $a_{t,h}$ 生成整段自由文本 $R_{t,h}$ 之前,路由器根本不可能预知模型会写出什么样的错误推导,自然也无法算出下一步的特征向量 $x_{t,h+1}$ 会落到 $\mathbb{R}^d$ 空间中的哪个位置;
- 序列策略空间随步数指数爆炸:即便强行 discrete 化文本空间,长度为 $H$ 的动作序列也有 $K^H$ 种组合,且每一步的未来状态高度依赖前序具体的模型输出文本,无法像经典树搜索那样预先展开状态树。
既然在步骤 $h$ 做出决策时,未来状态 $x_{t,h+1}$ 是不可知的,那么任何试图在步骤 $h$ 预测未来多步累积收益的“前瞻规划(Lookahead Planning)”都是在对未知的自由文本生成做盲猜。相反,在进入第 $h$ 步的时刻,前 $h-1$ 步生成的错误回答 $(R_{t,1}, \dots, R_{t,h-1})$ 已经全部尘埃落定,当前的拼接特征 $x_{t,h}$ 是一个完全确定、可直接观测的已知向量!
因此,论文果断采用了瞬时遗憾(Myopic Regret,即单步贪心遗憾)作为优化目标:在每一个实际到达的步骤 $(t, h)$,将算法选出的模型 $a_{t,h}$ 与当前已知特征 $x_{t,h}$ 下期望成功率最高的单步最优模型(Myopic Oracle)进行比较:
\[\text{Reg}_{t,h} = \max_{k \in [K]} \langle x_{t,h}, \theta_k^* \rangle - \langle x_{t,h}, \theta_{a_{t,h}}^* \rangle\]在 $T$ 轮交互上的累积瞬时遗憾定义为所有实际执行步骤的瞬时遗憾之和:
\[\mathcal{R}(T) = \sum_{t=1}^T \sum_{h=1}^{H_t} \text{Reg}_{t,h}\]这种建模方式的巧妙之处在于:它既保留了多步上下文演进带来的跨模型纠错红利(因为 $x_{t,h}$ 实打实地编码了前 $h-1$ 步的失败文本与模型身份),又把原本不可解的未知文本 MDP 降维成了可以在线精确求解的条件线性赌博机问题。
2. 源码级拆解:$1159$ 维动态上下文向量 $x_{t,h}$ 与 Prompt 演进是如何构造的?
读论文时最容易产生困惑的地方,莫过于公式 $x_{t,h+1} = g(x_{t,h}, a_{t,h}, R_{t,h}, r_{t,h})$ 到底是怎么算出来的。论文正文只在实验部分提了一句“使用 384 维的 BAAI/bge-small-en-v1.5 提取问题嵌入”,并没有写出特征拼接的具体长相。
我们直接打开官方代码仓库的 Algorithm/Algo2.ipynb 与 Algorithm/Algo3.ipynb,可以看到非结构化上下文演进 $g(\cdot)$ 在工程实现上由文本层的 Prompt 动态重写与向量层的 $1159$ 维特征拼接两部分共同组成。
2.1 文本层演进:将历史失败尝试转化为“负样本提示”
当第 1 步选中的模型回答错误时,系统如何把失败历史喂给第 2 步的模型?查看源码中的 BatchBudgetCascade.format_prompt 方法以及论文 Appendix C,Prompt 的演进规则非常清晰:
- 第 $h = 1$ 步(初始 Prompt):只包含原始问题 $Q_t$ 与格式指令,要求模型在指定字数内给出结构化推导,并将最终答案放在
\boxed{}中以便程序自动判分:Solve the following problem clearly and concisely. Provide a structured derivation within 50 words, and format the final answer in \boxed{}. Problem: {Q_t} - 第 $h > 1$ 步(追加失败历史的演进 Prompt):系统把前 $h-1$ 步所有失败模型的名称
failed_llm_id及其给出的错误回答failed_answer逐条列在原题下方,显式要求当前模型避开这些错误路径:Solve the following problem clearly and concisely. Provide a structured derivation within 50 words, and format the final answer in \boxed{}. Problem: {Q_t} Note: The following previous attempts were incorrect. Please provide a different solution: - Attempt 1 (by {failed_llm_id_1}) led to: {failed_answer_1} - Attempt 2 (by {failed_llm_id_2}) led to: {failed_answer_2}
2.2 向量层演进:FeatureExtractor 的 $1159$ 维特征拼接实现
Prompt 变长之后,路由器看到的状态特征 $x_{t,h} \in \mathbb{R}^d$ 并不是简单地把整段新 Prompt 重新丢进编码器算一个 384 维向量——如果那样做,原始问题的语义很容易被长篇累牍的错误回答稀释,且路由器无法区分“刚才是哪个模型答错了”。
源码中的 FeatureExtractor.construct_feature_vector 设计了一套结构化的 5 段式特征拼接方案。下面是从官方仓库提取并加上维度注释的核心实现:
# file: Algorithm/Algo3.ipynb | class FeatureExtractor
class FeatureExtractor:
    def __init__(self):
        # 加载 BAAI/bge-small-en-v1.5 编码器,单次输出维度 FEATURE_DIM = 384
        self.tokenizer = AutoTokenizer.from_pretrained("BAAI/bge-small-en-v1.5")
        self.model = AutoModel.from_pretrained("BAAI/bge-small-en-v1.5").to(device)
        self.model.eval()

    def extract_single_feature(self, text: str) -> np.ndarray:
        """提取单段文本的 384 维句向量(Mean Pooling + L2 归一化)"""
        encoded = self.tokenizer(
            [str(text)], padding=True, truncation=True, max_length=512, return_tensors="pt"
        ).to(device)
        with torch.no_grad():
            model_output = self.model(**encoded)
            token_embeddings = model_output[0]
            input_mask_expanded = encoded["attention_mask"].unsqueeze(-1).expand(token_embeddings.size()).float()
            sum_embeddings = torch.sum(token_embeddings * input_mask_expanded, 1)
            sum_mask = torch.clamp(input_mask_expanded.sum(1), min=1e-9)
            embeddings = F.normalize(sum_embeddings / sum_mask, p=2, dim=1)
        return embeddings.cpu().numpy()[0]  # shape: (384,)

    def construct_feature_vector(
        self,
        base_features: np.ndarray,      # 1. 原始问题 Q_t 的句向量, shape: (384,)
        step_i: int,                    # 当前级联步索引 (代码中从 0 到 H-1)
        failed_Verify_answers: list,    # 前序所有失败回答文本列表 [R_{t,1}, ..., R_{t,h-1}]
        failed_llm_ids: list,           # 前序所有失败模型的名称列表 [a_{t,1}, ..., a_{t,h-1}]
    ) -> np.ndarray:
        """构造第 h 步的完整上下文特征向量 x_{t,h},总维度 d = 1153 + K"""
        # 2. 归一化级联步数: [step_i / CASCADE_LENGTH], shape: (1,)
        normalized_step = np.array([step_i / CASCADE_LENGTH], dtype=np.float32)

        # 3. 最近一次失败回答 R_{t,h-1} 的 384 维句向量, shape: (384,)
        if len(failed_Verify_answers) > 0:
            last_answer_features = self.extract_single_feature(failed_Verify_answers[-1])
        else:
            last_answer_features = np.zeros(FEATURE_DIM, dtype=np.float32)

        # 4. 最近一次失败模型 a_{t,h-1} 的 One-Hot 编码, shape: (K,)
        last_llm_onehot = np.zeros(NUM_MODELS, dtype=np.float32)
        if len(failed_llm_ids) > 0:
            last_llm = failed_llm_ids[-1]
            if last_llm in MODEL_TO_IDX:
                last_llm_onehot[MODEL_TO_IDX[last_llm]] = 1.0

        # 5. 所有历史失败回答句向量的逐元素均值, shape: (384,)
        if len(failed_Verify_answers) > 0:
            all_answer_features = [self.extract_single_feature(ans) for ans in failed_Verify_answers]
            avg_answer_features = np.mean(all_answer_features, axis=0)
        else:
            avg_answer_features = np.zeros(FEATURE_DIM, dtype=np.float32)

        # 拼接 5 个部分: 384 + 1 + 384 + K + 384 = 1153 + K (当 K=6 时 d=1159)
        augmented_features = np.concatenate([
            base_features,
            normalized_step,
            last_answer_features,
            last_llm_onehot,
            avg_answer_features,
        ])
        return augmented_features  # shape: (1159,)
对照上面的代码,在主实验 $K = 6$ 个候选模型的配置下,状态特征向量 $x_{t,h} \in \mathbb{R}^{1159}$ 的物理结构一目了然:
| 特征分块 | 变量名 | 维度 | 在 $h=1$ 时的取值 | 在 $h > 1$ 时的物理含义 |
|---|---|---|---|---|
| 原始问题语义 | base_features | $384$ | $\phi(Q_t)$ | 锚定原始问题所属的学科、题型与基础难度 |
| 级联深度进度 | normalized_step | $1$ | $0.0$ | 当前处于第几轮重试(如 $0.25, 0.50, 0.75$) |
| 最近失败语义 | last_answer_features | $384$ | $\mathbf{0}_{384}$ | 紧挨着的上一步错误推导 $R_{t,h-1}$ 的文本表征 |
| 最近失败模型 | last_llm_onehot | $K=6$ | $\mathbf{0}_{6}$ | 标记上一步是哪个模型失败了,捕捉模型间的互补关系 |
| 累积失败语义均值 | avg_answer_features | $384$ | $\mathbf{0}_{384}$ | 前 $h-1$ 步所有错误回答表征的中心,反映整体卡壳方向 |
这套 $1159$ 维特征设计非常讲究:当 $h = 1$ 时,后 $775$ 维全为 $0$,线性参数 $\theta_k^* \in \mathbb{R}^{1159}$ 的前 $384$ 维专门负责评估模型 $k$ 裸做原题的先验能力;一旦进入 $h \ge 2$ 的重试步,后 $775$ 维被激活,$\theta_k^*$ 的后半段参数就能直接学出“当模型 $j$ 刚刚失败、且给出了某种特定类型的错误回答时,换模型 $k$ 接手能不能救回来”的跨模型协同权重。
3. 三代在线路由算法演进:从 Greedy LinUCB 到位置感知背包(PAKH)
有了 $1159$ 维的动态上下文向量 $x_{t,h}$,接下来的核心问题是:在每一拍 $(t, h)$,路由器该如何挑选模型 $a_{t,h}$?论文遵循“无预算约束 $\to$ 引入预算与随机成本估计 $\to$ 消除位置偏差”的脉络,依次推演出了三代在线算法。
3.1 第一代:无预算约束的 Greedy LinUCB
在不考虑 API 调用成本的基础设定下,我们的唯一目标是最大化每一拍选出正确模型的概率。由于每个模型 $k \in [K]$ 的期望奖励满足 $\mathbb{E}[r_{t,h} \mid x_{t,h}, a_{t,h}=k] = \langle x_{t,h}, \theta_k^* \rangle$,论文首先给出了基于线性置信上界(Linear Upper Confidence Bound, LinUCB)的贪心算法。
在看下面的伪代码框时,重点关注第 7 行的参数估计 $\hat{\theta}k$ 与置信上界 $\text{UCB}_k$ 计算、第 11 行的岭回归矩阵增量更新,以及第 12~15 行根据二元反馈 $r{t,h}$ 决定提前跳出(break)还是演进上下文 $x_{t,h+1}$:
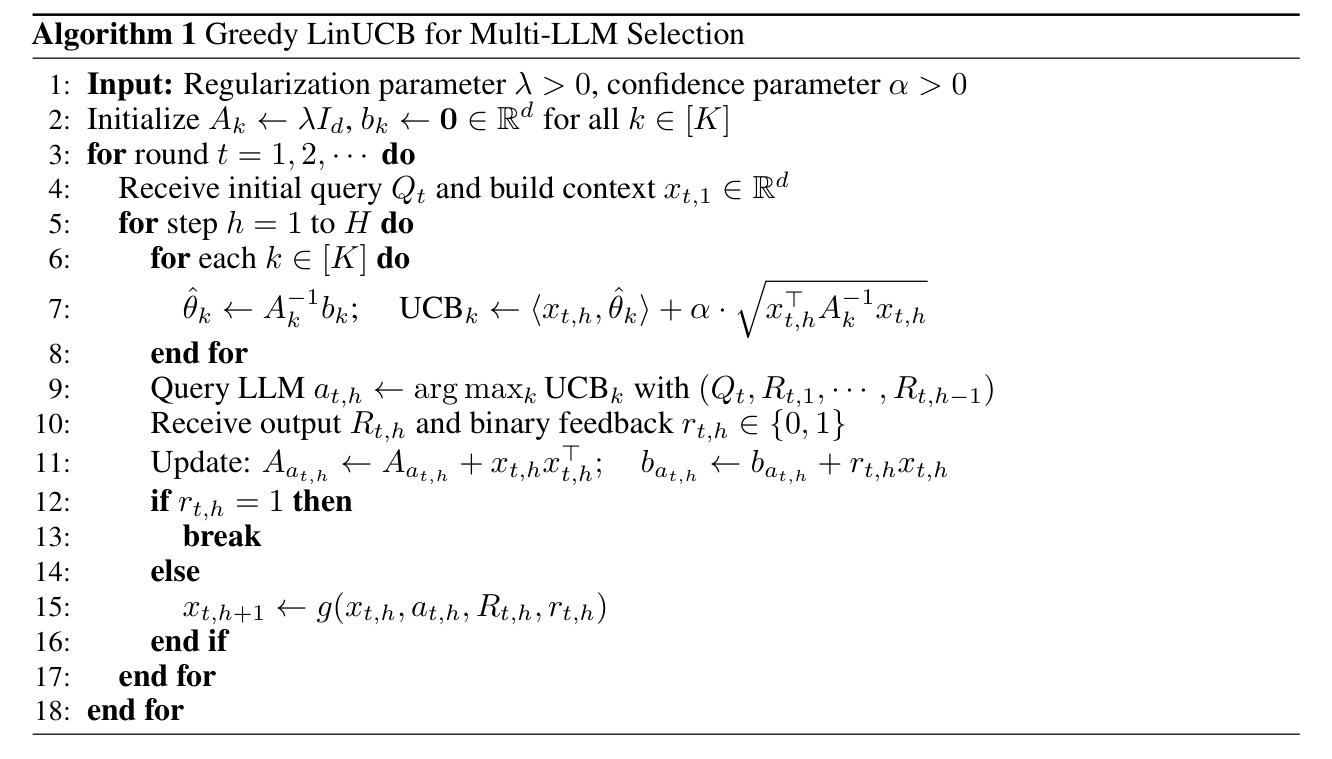
我们结合源码把上述 Greedy LinUCB 伪代码的执行细节拆开:
- 初始化(第 1~2 行):对于每个候选模型 $k \in [K]$,维护一个正则化设计协方差矩阵 $A_k \in \mathbb{R}^{d \times d}$(初始化为 $\lambda I_d$,源码中正则化系数设为 $\lambda = 0.45$)和一个历史奖励加权特征累积向量 $b_k \in \mathbb{R}^d$(初始化为 $\mathbf{0}_d$);
- 闭式岭回归与乐观探索打分(第 6~8 行):在第 $t$ 轮第 $h$ 步,给定当前特征 $x_{t,h} \in \mathbb{R}^{1159}$,对每个模型 $k$ 计算其参数向量的岭回归(Ridge Regression)估计值 $\hat{\theta}_k = A_k^{-1} b_k$,并加上椭球置信区间宽度作为探索奖励(Exploration Bonus):
源码中探索系数设为 $\alpha = 0.675$。如果某个模型 $k$ 在当前特征方向 $x_{t,h}$ 上很少被调用,二次型 $x_{t,h}^\top A_k^{-1} x_{t,h}$ 就会很大,从而推高 $\text{UCB}_k$ 促使系统去试探它的能力;
- 执行调用与在线增量更新(第 9~16 行):选择得分最高的模型 $a_{t,h} = \arg\max_{k \in [K]} \text{UCB}k(x{t,h})$ 发起请求。观测到二元判分结果 $r_{t,h} \in {0, 1}$ 后,仅对刚被选中的模型 $a_{t,h}$ 做秩一更新(Rank-1 Update):
若 $r_{t,h} = 1$,立刻结束本轮(break);若 $r_{t,h} = 0$ 且 $h < H$,则按第 2 节的规则拼接失败回答,构造 $x_{t,h+1}$ 进入下一步。
理论保障:为什么非结构化上下文演进不会破坏 LinUCB 的收敛界?
直觉上可能会担心:每一步的特征 $x_{t,h}$ 都是由上一步大模型的自由文本回答动态拼出来的,不同步骤的特征之间存在强相关性,这会不会导致最小二乘估计发散?
论文在 Theorem 1(完整证明见 Appendix A.2)中严格证明了:在置信水平 $1 - \delta$ 下,若取 $\alpha = \sqrt{\lambda} S + \sqrt{2 \log(K/\delta) + d \log\left(1 + \frac{T H L^2}{\lambda d}\right)}$,Greedy LinUCB 在 $T$ 轮交互上的累积瞬时遗憾满足:
\[\mathcal{R}(T) \le O\left(\sqrt{K d T H} \cdot \left(S L + \sqrt{\lambda} S\right) \cdot \log\left(\frac{K T L^2}{\lambda \delta}\right)\right)\]这个界之所以依然成立,核心原因在于自归一化向量鞅不等式(Self-Normalized Vector-Valued Martingale Inequality)只需要**给定历史滤子 $\mathcal{F}{t,h-1}$ 时的条件次高斯性**。在进入 $(t, h)$ 这一步时,无论之前的文本演进 $g(\cdot)$ 多么复杂,当前特征 $x{t,h}$ 相对于 $\mathcal{F}{t,h-1}$ 都已经是确定可测的常量,而当前的奖励噪声 $\eta{t,h}$ 条件于 $\mathcal{F}_{t,h-1}$ 依然是零均值次高斯的。因此,高维椭球势引理(Elliptical Potential Lemma)照常生效,单步后悔以 $\tilde{O}(\sqrt{K d T H})$ 的次线性速度快速收敛。
3.2 第二代:Budget-Aware Greedy LinUCB(双乐观性价比路由)
Greedy LinUCB 虽然准确率极高(在 Math500 上达到 96.25%),但它完全无视 API 调用价格。在真实业务中,每道题通常有一个预算上限 $B_t$(例如单题最多花 $$0.001$)。设模型 $k$ 单次调用的真实期望成本为未知常数 $\mu_k = \mathbb{E}[c_{t,h} \mid a_{t,h} = k] > 0$(单次成本有界于 $[0, C_{\max}]$),第 $h$ 步之前的剩余预算记为 $b_{t,h}$(初始 $b_{t,1} = B_t$,每步扣除实际开销 $b_{t,h+1} = b_{t,h} - c_{t,h}$)。
当存在预算约束时,单步最优策略不再是单纯选成功率最高的模型,而是要在买得起的模型里选单位美元成功率(性价比 / 价值密度 Value Density)最高的模型:
\[k_{t,h}^* = \arg\max_{k \in [K],\, \mu_k \le b_{t,h}} \frac{\langle x_{t,h}, \theta_k^* \rangle}{\mu_k}\]为了在 $\theta_k^*$ 和真实平均成本 $\mu_k$ 双双未知的情况下逼近这个目标,论文在 Section 5.1 提出了基于双乐观原则(Double Optimism Principle)的 Budget-Aware Greedy LinUCB:
- 对奖励取置信上界(UCB):分子依然采用乐观预测 $\text{UCB}k(x{t,h})$;
- 对成本取置信下界(Lower Confidence Bound, LCB):记模型 $k$ 被历史调用的次数为 $N_k(t,h)$,历史经验平均成本为 $\hat{c}k(t,h)$,根据 Hoeffding 集中不等式构造半径 $\beta_k(t,h) = C{\max}\sqrt{\frac{\log(2 T K / \delta)}{2 N_k(t,h)}}$。分母采用乐观的低成本估计 $\max{\hat{c}_k(t,h) - \beta_k(t,h), \varepsilon}$($\varepsilon > 0$ 防止除零),从而让调用次数少、成本尚不确定的模型也能获得探索机会;
- 安全预算过滤:只允许经验成本上界不超过当前剩余预算(即 $\hat{c}k(t,h) + \beta_k(t,h) \le b{t,h}$)的模型参与竞争,综合打分公式为:
论文在 Theorem 2(证明见 Appendix A.3)中证明了该算法在预算约束下的累积瞬时遗憾界:
\[\mathcal{R}_{\text{budget}}(T) = \tilde{O}\left(S L \sqrt{K d T H} + \sum_{k=1}^K \frac{C_{\max}}{\mu_k^2}\sqrt{T \log\left(\frac{T K}{\delta}\right)}\right)\]上式非常清晰地将误差分解为两项:第一项 $S L \sqrt{K d T H}$ 来自学习 $1159$ 维奖励参数 $\theta_k^*$ 的探索代价,第二项 $\sum_{k=1}^K \frac{C_{\max}}{\mu_k^2}\sqrt{T \log(TK/\delta)}$ 来自在线估计各模型未知成本 $\mu_k$ 的采样代价。
源码精读:ModelCostEstimator 如何把确定性输入成本与随机输出成本拆开?
在翻阅官方仓库 Algorithm/Algo2.ipynb 时,我们发现作者在代码实现中做了一个比论文公式更符合 LLM 计费特性的工程优化:大模型的 API 账单分为 Input Token 费用和 Output Token 费用;在发出请求的那一刻,当前 Prompt 的长度(即 Input Token 数量与输入费用)是 100% 确定已知的,唯一随机未知的只有模型即将吐出多少个 Output Token!
不仅如此,随着级联步数 $h$ 增加,模型的输出长度分布也会变化。因此源码中的 ModelCostEstimator 专门按 (model_name, position) 统计历史输出成本的均值与标准误,并用“确定性输入成本 + 乐观输出成本下界(LCB)”来组装总预估成本:
# file: Algorithm/Algo2.ipynb | class ModelCostEstimator
def estimate_cost(self, model_name: str, position: int, prompt: str, use_ucb: bool = True) -> float:
    # 1. 确定性部分:根据当前拼接后的 Prompt 估算输入 Token 数与输入成本
    estimated_input_tokens = len(prompt) // 4
    input_cost = (estimated_input_tokens / 1000) * MODELS_CONFIG[model_name]["input_cost"]

    # 2. 随机部分:优先查询该模型在当前级联步 position 下的历史输出成本统计量
    pos_stats = self.position_cost_stats[model_name][position]
    overall_stats = self.overall_cost_stats[model_name]

    if pos_stats["count"] >= 3:
        mean_cost = pos_stats["mean_cost"]
        if use_ucb and pos_stats["count"] > 1:
            std_dev = np.sqrt(pos_stats["m2"] / (pos_stats["count"] - 1))
            std_error = std_dev / np.sqrt(pos_stats["count"])
            # 对随机输出成本取 LCB(均值减去 beta 倍标准误),截断下限为均值的 10%
            lcb_output_cost = max(mean_cost - self.beta * std_error, mean_cost * 0.1)
        else:
            lcb_output_cost = mean_cost
    elif overall_stats["count"] > 0:
        # 若当前步数样本不足 3 个,回退到该模型全局历史输出成本统计量
        mean_cost = overall_stats["mean_cost"]
        lcb_output_cost = mean_cost
    else:
        # 冷启动默认兜底:按 200 个输出 Token 估算
        lcb_output_cost = (200 / 1000) * MODELS_CONFIG[model_name]["output_cost"]

    return input_cost + lcb_output_cost
3.3 第三代:Positionally-Aware Knapsack Heuristic(PAKH,位置感知背包启发式)
Budget-Aware Greedy LinUCB 把 API 成本压到了极致,但在实际跑分和用户体验上却暴露出一个致命缺陷——位置偏差(Positional Bias)。
为什么除以成本的贪心打分 $\frac{\text{UCB}_k}{\hat{c}_k}$ 会引发位置偏差?我们算一笔简单的账: 假设候选池里有一个极其便宜的轻量模型 Mistral-Small-3.1(单次调用仅需 $$2.0 \times 10^{-5}$,在 AIME 上的真实准确率只有 1.67%)和一个主力模型 Gemini-2.0-Flash(单次调用约 $$3.0 \times 10^{-4}$,准确率 20.00%,贵 15 倍)。即便 LinUCB 已经学出 Gemini-2.0-Flash 的预测质量 $\text{UCB}$ 是 Mistral 的 5 倍,一旦除以相差 15 倍的成本,Mistral 的单位美元性价比依然比 Gemini 高出 3 倍!
结果就是:只要预算还够,Budget-Aware Greedy LinUCB 在第 1 步永远会优先派上最便宜的弱模型去“碰运气”。只有当弱模型在第 1、2 步接连败下阵来,它才会在第 3、4 步慢吞吞地请出真正能解决问题的大模型。这不仅白白浪费了前几步的延迟和 Token 费,还可能像我们在第 5.4 节即将看到的那样——弱模型生成的错误推导反而把后续的大模型带进沟里!
怎么才能既不超出总预算 $B_t$,又把真正高质量的模型排在第 1 步优先出场?论文提出了整篇工作的核心算法创新——位置感知背包启发式(Positionally-Aware Knapsack Heuristic, PAKH)。
在阅读下面的 PAKH 伪代码时,请注意它如何通过两阶段操作实现“预算规划与调用顺序解耦”:第 3 行先用 0-1 背包(0-1 Knapsack)在剩余预算 $b$ 内圈出总价值最高的候选子集,第 4 行再从被圈出的子集中直接挑出预测质量 $\widehat{r}_k$ 最高(不除以成本!)的模型作为下一步调用对象 $k^{\text{next}}$:
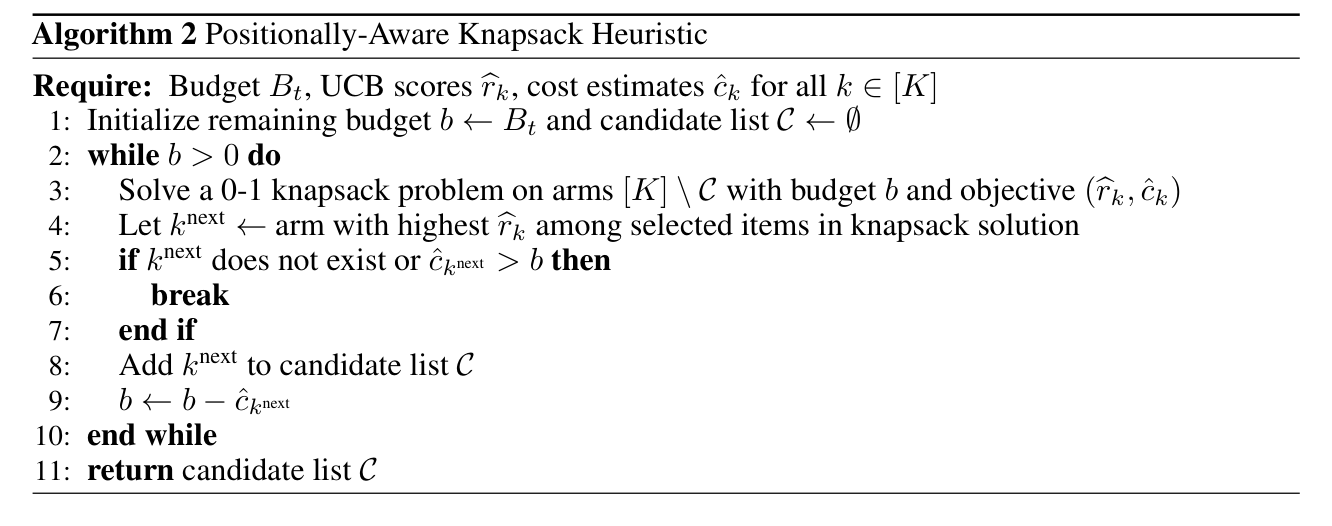
我们来拆解 PAKH 的核心设计逻辑与源码实现:
- 第一阶段:用 0-1 背包锁定“预算内总质量最高”的模型组合(第 3 行) 在剩余预算 $b$ 下,将每个尚未调用的候选模型 $k \in [K] \setminus \mathcal{C}$ 看作一件物品:
- 物品价值(Value):该模型在当前上下文下的预测质量上界 $\widehat{r}k = \text{UCB}_k(x{t,h})$;
- 物品重量(Weight):该模型的预估调用成本 $\hat{c}_k$;
- 背包容量(Capacity):当前剩余预算 $b$。
求解如下 0-1 背包整数规划问题,选出一组在预算内能使总期望成功率之和最大的模型子集 $S^* \subseteq [K] \setminus \mathcal{C}$:
\[\max_{z_k \in \{0, 1\}} \sum_{k \notin \mathcal{C}} \widehat{r}_k z_k \quad \text{s.t.} \quad \sum_{k \notin \mathcal{C}} \hat{c}_k z_k \le b\] -
第二阶段:在入选子集内按绝对质量 $\widehat{r}_k$ 降序排定出场位置(第 4~9 行) 拿到背包选出的最优模型组合 $S^$ 后,彻底抛弃“除以成本”的排序逻辑,直接从 $S^$ 中挑出预测质量 $\widehat{r}_k$ 绝对值最大的模型:
\[k^{\text{next}} = \arg\max_{k \in S^*} \widehat{r}_k\]将其排入候选执行队列 $\mathcal{C}$ 的当前首位,并从预算中预扣其成本 $b \leftarrow b - \hat{c}_{k^{\text{next}}}$。
在官方仓库 Algorithm/Algo3.ipynb 中,作者将上述 0-1 背包求解器与在线单步级联紧密结合:由于美元成本是微小的浮点数(如 $$0.0003$),源码先用自适应缩放因子 scale_factor = int(10000 / max(min_cost, 1e-8)) 将成本与剩余预算映射为整数,再通过动态规划表 dp[n+1][scaled_capacity+1] 精确求解 0-1 背包,随后按入选模型的 ucb_score 从高到低依次取用(一旦某一步模型回答正确,整个级联立刻终止,后续未调用的背包模型根本不会产生实际开销):
# file: Algorithm/Algo3.ipynb | solve_0_1_knapsack & select_models_knapsack
def solve_0_1_knapsack(weights: list, values: list, capacity: float) -> list:
    """使用动态规划求解浮点权重的 0-1 背包问题,返回入选模型的索引列表"""
    n = len(weights)
    if n == 0 or capacity <= 0:
        return []
    # 将微小的美元浮点成本缩放为整数权重,保留足够精度同时控制 DP 表大小
    min_cost = min([w for w in weights if w > 0], default=1e-6)
    scale_factor = int(10000 / max(min_cost, 1e-8))
    scaled_weights = [max(1, int(w * scale_factor)) for w in weights]
    scaled_capacity = int(capacity * scale_factor)

    # 限制最大背包容量维度,保证毫秒级求解速度
    if scaled_capacity > 100000:
        scale_factor = int(100000 / capacity)
        scaled_weights = [max(1, int(w * scale_factor)) for w in weights]
        scaled_capacity = 100000

    dp = [[0.0 for _ in range(scaled_capacity + 1)] for _ in range(n + 1)]
    for i in range(1, n + 1):
        w, v = scaled_weights[i - 1], values[i - 1]
        for c in range(scaled_capacity + 1):
            if w <= c:
                dp[i][c] = max(dp[i - 1][c], dp[i - 1][c - w] + v)
            else:
                dp[i][c] = dp[i - 1][c]

    # 回溯找出入选的最优模型子集 S*
    selected_indices = []
    c = scaled_capacity
    for i in range(n, 0, -1):
        if dp[i][c] != dp[i - 1][c]:
            selected_indices.append(i - 1)
            c -= scaled_weights[i - 1]
    return selected_indices

def select_models_knapsack(models, features, step_i, prompt, remaining_budget, cost_estimator, exclude_models):
    """PAKH 核心选模逻辑:背包锁预算组合 + 按 UCB 绝对质量降序出场"""
    eligible_models, weights, values = [], [], []
    for name in MODELS_CONFIG.keys():
        if name in exclude_models:
            continue
        est_cost = cost_estimator.estimate_cost(name, step_i, prompt, use_ucb=True)
        if est_cost <= remaining_budget:
            ucb_score = models[name].predict_ucb(features)
            eligible_models.append((name, ucb_score, est_cost))
            weights.append(est_cost)
            values.append(max(0.0, ucb_score))

    selected_idx = solve_0_1_knapsack(weights, values, remaining_budget)
    selected_items = [eligible_models[i] for i in selected_idx]
    # 关键一步:在背包选出的买得起的组合内部,直接按 ucb_score 从高到低排序!
    selected_items.sort(key=lambda x: x[1], reverse=True)
    return [item[0] for item in selected_items]
3.4 手算级端到端数值推演:看懂三种算法为何走出截然不同的轨迹
为了彻底打通直觉,我们用一个具体的 AIME 数学竞赛题场景,手算对比三个算法在第 $1$ 步的决策差异。
假设当前有一道 AIME 几何题,给定单题预算上限 $B_t = $0.0010$。在第 $h = 1$ 步,路由器提取出 $1159$ 维初始特征 $x_{t,1}$,并算出 4 个代表性候选模型的质量上界 $\text{UCB}k(x{t,1})$ 与预估成本 $\hat{c}_k$ 如下表所示:
| 候选模型 $k$ | 预测质量上界 $\text{UCB}_k$ | 预估成本 $\hat{c}_k$(美元) | 预算可行性($\le $0.0010$) | 性价比得分 $\text{UCB}_k / \hat{c}_k$ |
|---|---|---|---|---|
$M_1$: Mistral-Small-3.1 | $0.15$ | $$0.0001$ | 可行 | $1500.0$(最高) |
$M_2$: Llama-4-Maverick | $0.45$ | $$0.0004$ | 可行 | $1125.0$ |
$M_3$: Gemini-2.0-Flash | $0.65$ | $$0.0005$ | 可行 | $1300.0$ |
$M_4$: GPT-4.1-Nano(长输出) | $0.70$ | $$0.0015$ | 超预算出局 | $466.7$ |
现在看三种算法分别会怎么选:
- Greedy LinUCB(无视预算): 它不看成本,直接挑 $\text{UCB}_k$ 最大的 $M_4$($0.70$),单步花掉 $$0.0015$,第 1 步就直接击穿了 $$0.0010$ 的预算红线;
- Budget-Aware Greedy LinUCB(按性价比贪心): 先踢掉超预算的 $M_4$,然后在 ${M_1, M_2, M_3}$ 中比较单位成本得分 $\text{UCB}_k / \hat{c}_k$。由于 $M_1$(
Mistral-Small-3.1)极其便宜($$0.0001$),哪怕它的预测成功率只有可怜的 $0.15$,其性价比得分 $0.15 / 0.0001 = 1500$ 依然力压 $M_3$($1300$)夺冠!于是系统在第 1 步派上最弱的 $M_1$,几乎必然答错;不仅浪费了第 1 步的延迟,还把 $M_1$ 凑出来的错误推导塞进了第 2 步的 Prompt; - Positionally-Aware Knapsack(PAKH,背包组合 + 质量优先):
- 第一步解 0-1 背包:在容量 $b = $0.0010$ 下,从 ${M_1, M_2, M_3}$ 中挑选子集最大化 $\sum \text{UCB}_k$。组合 ${M_1, M_2, M_3}$ 总重 $$0.0001 + $0.0004 + $0.0005 = $0.0010 \le $0.0010$,总价值 $0.15 + 0.45 + 0.65 = 1.25$(若预算再紧一点,比如 $b = $0.0009$,背包则会选出 ${M_2, M_3}$,总重 $$0.0009$,总价值 $1.10$,直接把凑数的 $M_1$ 踢出局);
- 第二步按质量降序出场:在背包选出的买得起的组合内部,直接按 $\text{UCB}_k$ 从高到低排序:$M_3\ (0.65) \to M_2\ (0.45) \to M_1\ (0.15)$。因此 PAKH 在第 1 步直接派出预算内最强的 $M_3$(
Gemini-2.0-Flash)!一旦 $M_3$ 在第 1 步直接答对(概率高达 $0.65$),本轮立刻以 $$0.0005$ 的成本完美收官,排在后面的 $M_2, M_1$ 根本不需要实际调用。
4. 源码踩坑指南:官方仓库中的三处关键细节与论文出入
如果读者准备基于官方仓库 EntroShape/Online_LLM_Selection 复现或改造代码,下面三处通过逐行比对源码发现的细节能帮你省下大量排查时间:
- 仓库
README.md中的文件名与算法描述写反了: 在官方README.md的说明表格中,作者把Algo1.ipynb描述成了 Budget-Aware 算法、把Algo2.ipynb描述成了 Greedy LinUCB。但核对代码实现可以确认:-
Algorithm/Algo1.ipynb(保存日志为M91.json)实际上是无成本约束的 Greedy LinUCB(对应前文第 3.1 节); -
Algorithm/Algo2.ipynb(保存日志为M92V2.json)才是包含ModelCostEstimator和select_model_value_density的 Budget-Aware Greedy LinUCB(对应前文第 3.2 节); -
Algorithm/Algo3.ipynb(保存日志为M93.json)则是包含solve_0_1_knapsack的 Positionally-Aware Knapsack Heuristic(PAKH)(对应前文第 3.3 节)。
-
- 前 20% 探索预热期与后 80% 预算受限评估期的两阶段划分: 论文理论分析是在 $t = 1, \dots, T$ 全程施加预算 $B_t$,但在源码
BatchBudgetCascade.process_dataset中,作者将数据集按train_ratio = 0.2切分为前 20% 的在线预热期(Training Phase)与后 80% 的在线测试期(Testing Phase):- 在前 20% 预热期,系统令
remaining_budget = float('inf')(不设预算上限),并且强制要求同一次级联的 4 步内不重复选择同一个模型(exclude_models = used_models),只按纯 LinUCB 分数广泛探索,快速更新各模型的 $(A_k, b_k)$ 矩阵并积累各模型在不同位置 $h$ 上的真实输出 Token 成本分布; - 在后 80% 测试期,系统正式开启严格的固定单题预算
remaining_budget = self.budget_per_question,调用select_model_value_density(Algo 2)或select_models_knapsack(Algo 3)执行受限路由,并持续在线更新模型参数。论文汇报的所有主实验指标均统计自这 80% 的评估集。
- 在前 20% 预热期,系统令
- 同轮模型是否允许重复调用的差异: 在测试期(Testing Phase),
Algo2.ipynb和Algo3.ipynb传入了exclude_models = [],意味着如果某一个强模型在第 1 步失败了,但在拼接了它自己的错误回答生成新特征 $x_{t,2}$ 后,如果它的 $\text{UCB}$ 依然最高且预算够用,系统允许它在第 2 步进行“自我纠错(Self-Refinement)”;而在Algo3.ipynb的单次背包规划内部,由于是 0-1 背包,每个模型在同一步生成的候选队列中最多出现一次。
5. 实验全解:准确率、成本控制、首步命中率与上下文双刃剑效应
论文在 6 个异构候选大模型和 4 个高区分度推理基准上进行了系统评测:
- 6 个候选 LLM:
Mistral-Small-3.1、Phi-4、Llama-4-Maverick、Gemini-2.0-Flash、GPT-4.1-Nano、DeepSeek-V3-Chat(统一通过 OpenRouter API 调用并按实时 Token 价格计费); - 4 个推理评测基准:
- MMLU-Pro(Massive Multitask Language Understanding Professional,涵盖 14 个专业学科的高难度多选推理基准,随机采样 2,500 题,单题预算设为 $$9.278 \times 10^{-5}$);
- AIME(American Invitational Mathematics Examination,2024 与 2025 年美国数学邀请赛全部 60 道竞赛真题,单题预算设为 $$2.1437 \times 10^{-3}$);
- GPQA(Graduate-Level Google-Proof Q&A Benchmark,博士级物理、化学、生物高难问答基准,随机采样 200 题;作者特意将原版的多选题改造成开放式生成问答 Open-Ended QA,用
GPT-4.1-Nano作为裁判模型核对生成答案与标准答案是否一致,极大增加了盲猜难度,单题预算设为 $$9.7955 \times 10^{-4}$); - Math500(500 道涵盖代数、几何、数论、微积分的数学推理题,单题预算设为 $$2.4217 \times 10^{-4}$)。
- 4 个对比基线:
Voting(6 个模型全量调用后多数投票)、MixLLM(融合查询特征与延迟/成本惩罚的 SOTA Bandit 路由器)、MetaLLM(基于单步上下文 Bandit 的路由器)、Random(随机选择单模型)。
5.1 主实验:准确率与 API 成本的帕累托跃升
我们先看官方仓库汇总的整体性能对比图(左表整合了各方法在 4 个数据集上的准确率与美元成本,右图展示了“平均成本对数坐标 vs. 平均准确率”的帕累托散点分布,越靠近左上角代表“既准又省”):
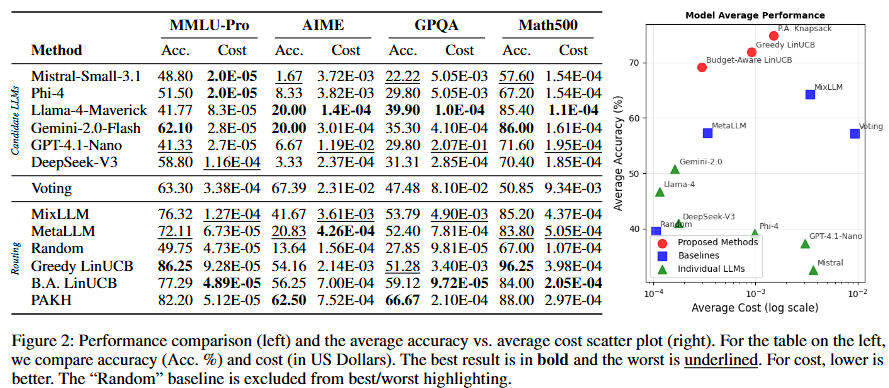
为了方便逐项核对四个评测集上的具体数值,下面依次给出准确率明细表与单题平均美元成本明细表。在阅读这两张表时,建议先看上半区 Candidate LLMs 的单模型天花板,再对比下半区 Routing 中单步基线(MixLLM、MetaLLM)与本文三代算法的差异:
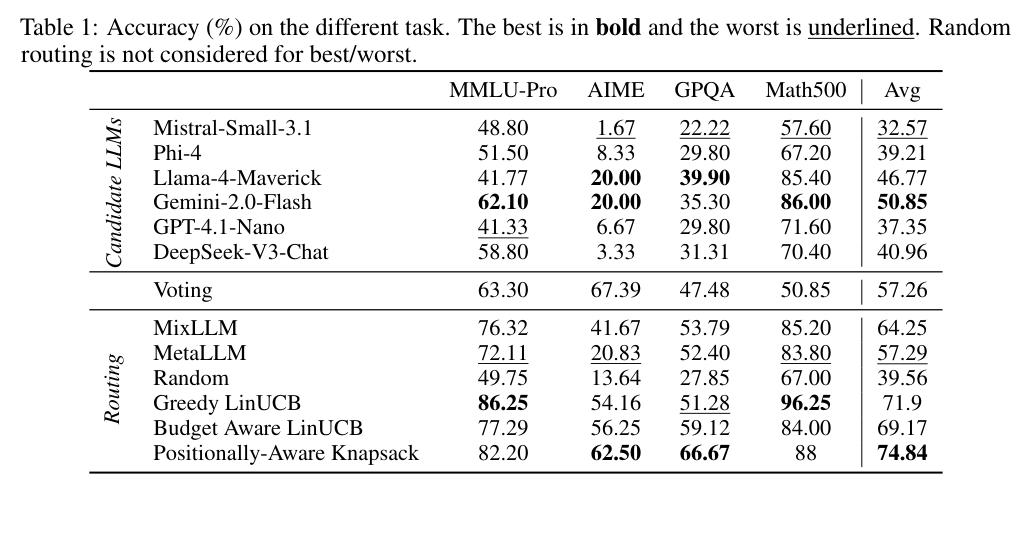
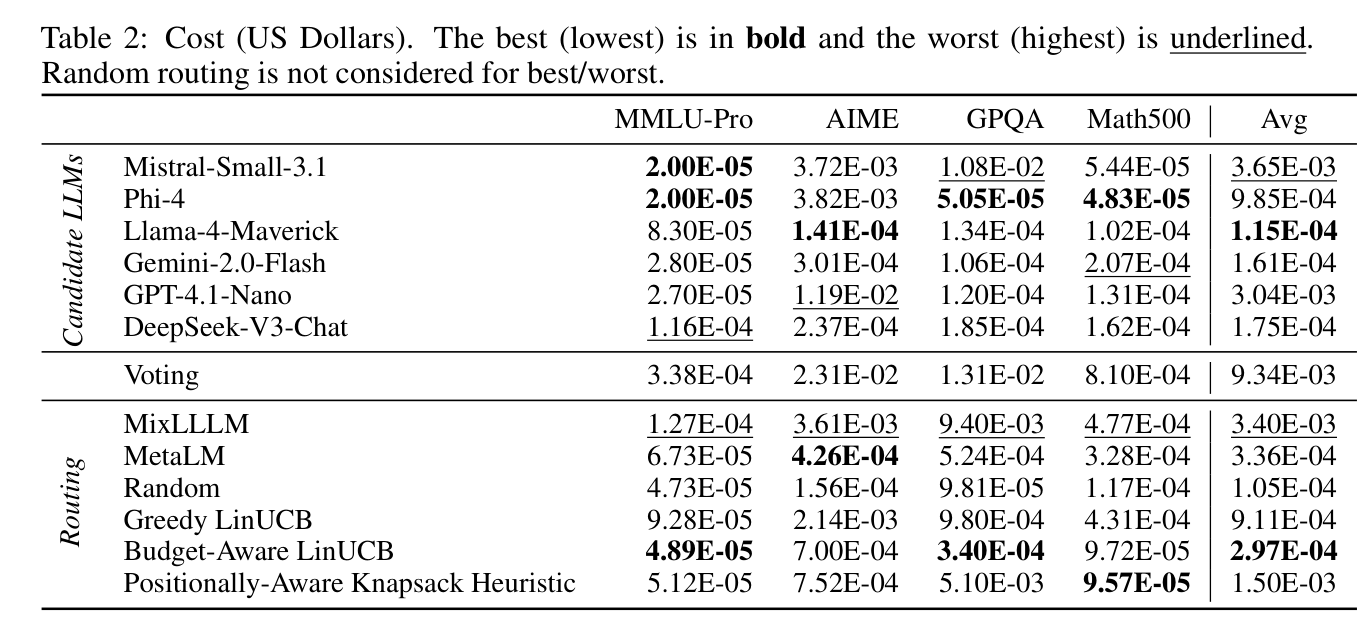
从上面三张图表中可以提炼出四组硬核结论:
- 单模型不存在“全能冠军”,且在硬核推理上普遍吃紧: 6 个候选模型中综合表现最好的是
Gemini-2.0-Flash(平均准确率50.85%),但它在 GPQA(35.30%)上不如Llama-4-Maverick(39.90%),在 AIME 上两者更是双双卡在20.00%。全量调用的Voting(多数投票)虽然把 AIME 提到了67.39%,但在 Math500 上反而被多数弱模型带偏跌至50.85%,且平均单题成本高达 $$9.34 \times 10^{-3}$(比单模型贵近 60 倍); - Greedy LinUCB 充分释放了多步上下文演进的威力: 仅靠 $1159$ 维动态上下文特征与最多 4 步的级联重试,
Greedy LinUCB就将平均准确率从单模型最高的50.85%拉升到了71.99%(在 MMLU-Pro 上达86.25%,Math500 上达96.25%),比最强路由基线MixLLM(64.25%)高出 +7.74 个百分点,而平均成本($$9.11 \times 10^{-4}$)仅为MixLLM($$3.40 \times 10^{-3}$)的 26.8%; - Budget-Aware LinUCB 拿下全场最低路由成本: 引入双乐观成本约束后,
Budget-Aware LinUCB的平均单题成本骤降至 $$2.97 \times 10^{-4}$——比Greedy LinUCB便宜 3.07 倍,甚至比单步静态路由基线MetaLLM($$3.36 \times 10^{-4}$)还要便宜 11.6%,同时平均准确率达到69.17%(领先MetaLLM整整 +11.88 个百分点); - PAKH(Positionally-Aware Knapsack)实现全局综合制霸: 通过 0-1 背包消除位置偏差后,
PAKH取得了全场最高的平均准确率74.84%!尤其是在最难的竞赛数学AIME(62.50%)和博士级科学问答GPQA(66.67%)上,PAKH 分别比单模型最高水平高出 +42.50 和 +26.77 个百分点,同时平均成本($$1.50 \times 10^{-3}$)依然比MixLLM低 55.9%。在散点图右上角,代表本文三个算法的红点稳稳占据了帕累托前沿的左上方。
5.2 位置消融实验:PAKH 是如何把首步命中率推到 71.10% 的?
第 3.3 节我们从理论上分析了 Budget-Aware Greedy LinUCB 的“位置偏差”以及 PAKH 的纠偏机制。实验数据是否真的如理论预期那样,让强模型在第 1 步就顶上去?
下表把三个算法在 1st、2nd、3rd、4th 四个级联步上分别贡献的准确率比例以及平均调用步数(Avg. Step)全部拆了出来。阅读下表时,请重点纵向对比三个算法的 1st 行(首步直接答对的百分比)和 Avg. Step 行:
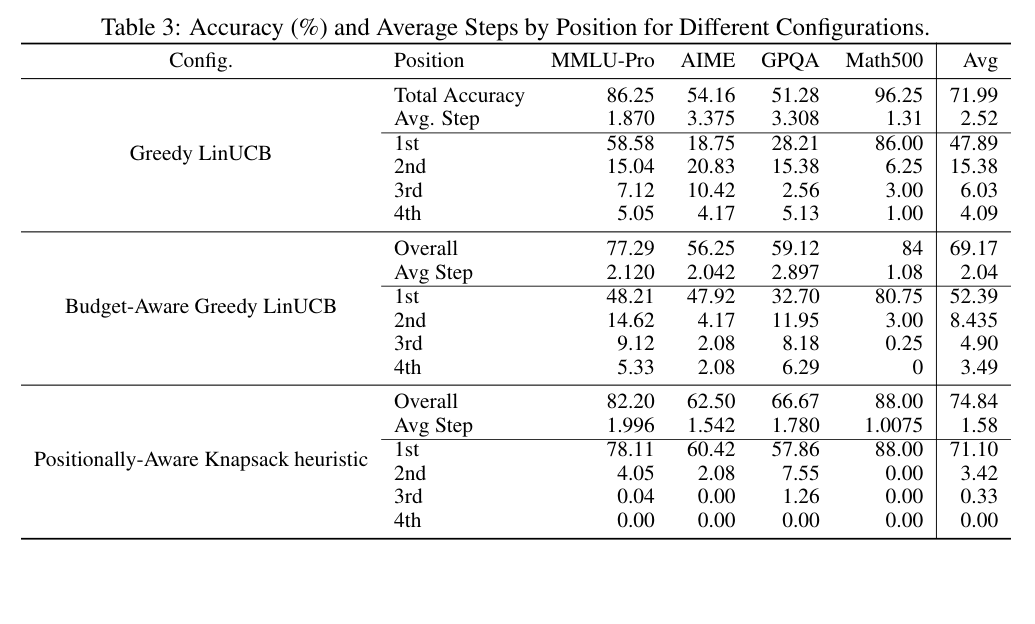
这张表的数字对比极具说服力:
- Greedy LinUCB 与 Budget-Aware LinUCB 严重依赖后序重试补救:
Greedy LinUCB的总准确率虽然有71.99%,但第 1 步只答对了47.89%,剩下的24.10%全靠第 2 步(15.38%)、第 3 步(6.03%)和第 4 步(4.09%)一步步试出来,平均每道题要调用2.52步(在 AIME 上平均要调3.375步)。Budget-Aware Greedy LinUCB同样如此,第 1 步仅命中52.39%,平均调用2.04步; - PAKH 在第 1 步就直接解决了 95% 的可解问题: 切换到
Positionally-Aware Knapsack heuristic后,第 1 步的直接准确率暴涨至71.10%(占其总准确率74.84%的 95.0%!),第 2 步仅需补救3.42%,第 3 步仅0.33%,第 4 步更是降到了0.00%!平均每题调用步数从2.52步直接压缩到了1.58步(在 Math500 上平均只需1.0075步,几乎全部一击必杀)。
这组细粒度位置数据铁证如山地表明:将“背包选预算组合”与“按质量排先后顺序”解耦,不仅没有因为首步调用好模型而破产,反而因为第 1 步极高的命中率避免了后续第 2、3、4 步的无效重试与错误上下文污染,实现了准确率与交互延迟的双赢。
5.3 单题成本分布(CDF)与预算敏感性拐点分析
为了检验预算感知算法是否真的在单题粒度上守住了预算红线,论文绘制了四个数据集上单题实际开销的累积分布函数(CDF,横轴为单题美元成本 $x$,纵轴为实际成本 $\le x$ 的题目比例 $P(\text{Cost} \le x)$,黑色虚线为设定的单题固定预算上限 $B_t$):
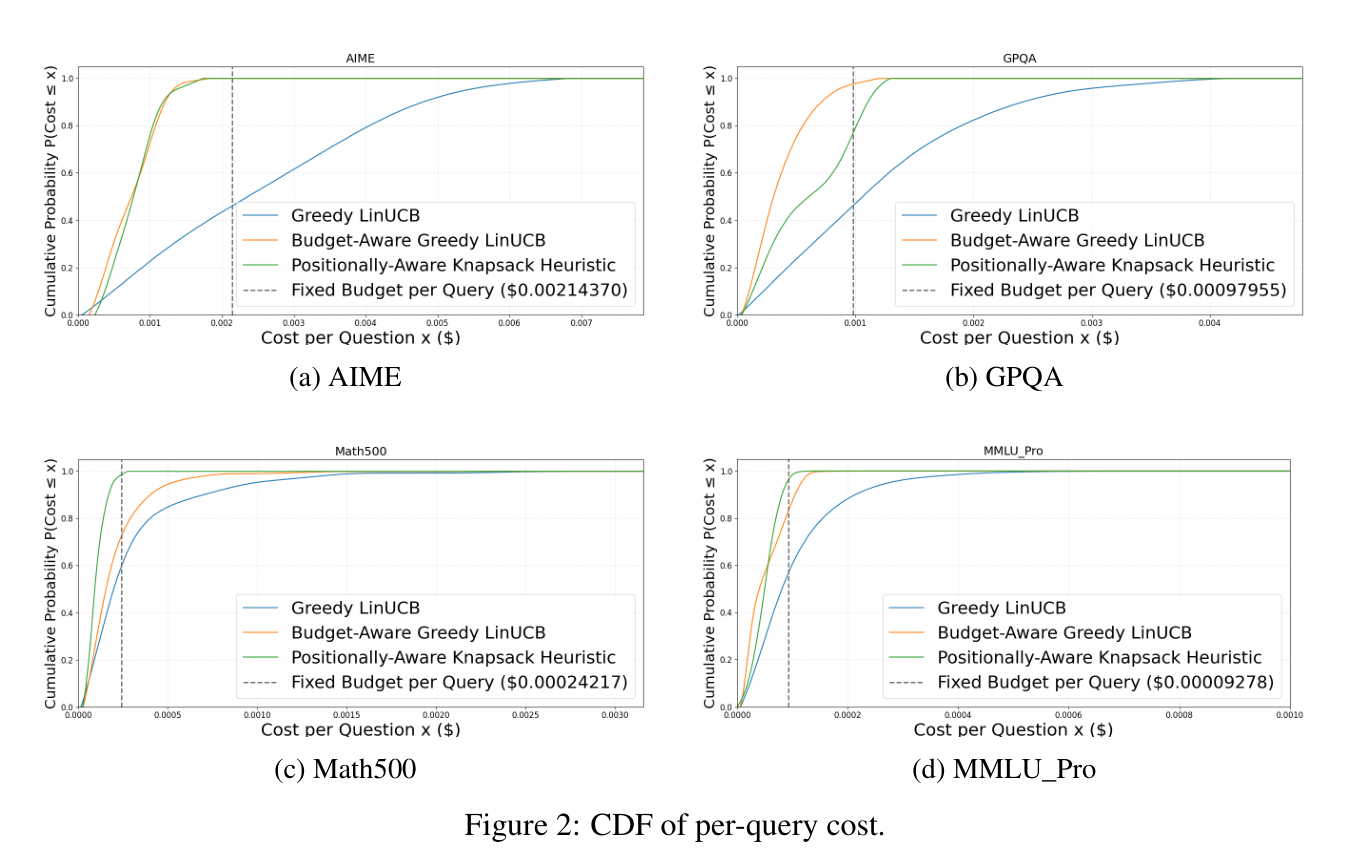
观察上图中的四张子图:
- 蓝线(
Greedy LinUCB)由于完全没有预算概念,其成本分布拖出了一条长长的右尾——在(a) AIME和(b) GPQA上,有超过 55% 的题目实际开销突破了黑色虚线标注的预算红线; - 橙线(
Budget-Aware Greedy LinUCB)与绿线(Positionally-Aware Knapsack Heuristic)则在接近黑色虚线的位置迅速爬升至1.0(在 AIME、Math500、MMLU-Pro 上超过 90%~99% 的题目严格控制在预算线以内;仅有极少数题目因为模型偶发吐出超长推理文本,导致实际 Output Token 略微超出预估成本)。
更有趣的是论文在 AIME 数据集上做的预算敏感性消融实验。在下图中,横轴从极度紧缺的 $$0.00005$ 一路放宽到充裕的 $$0.020$,纵轴对比了 Budget-Aware LinUCB(蓝线)与 PAKH(橙线)的准确率变化趋势:
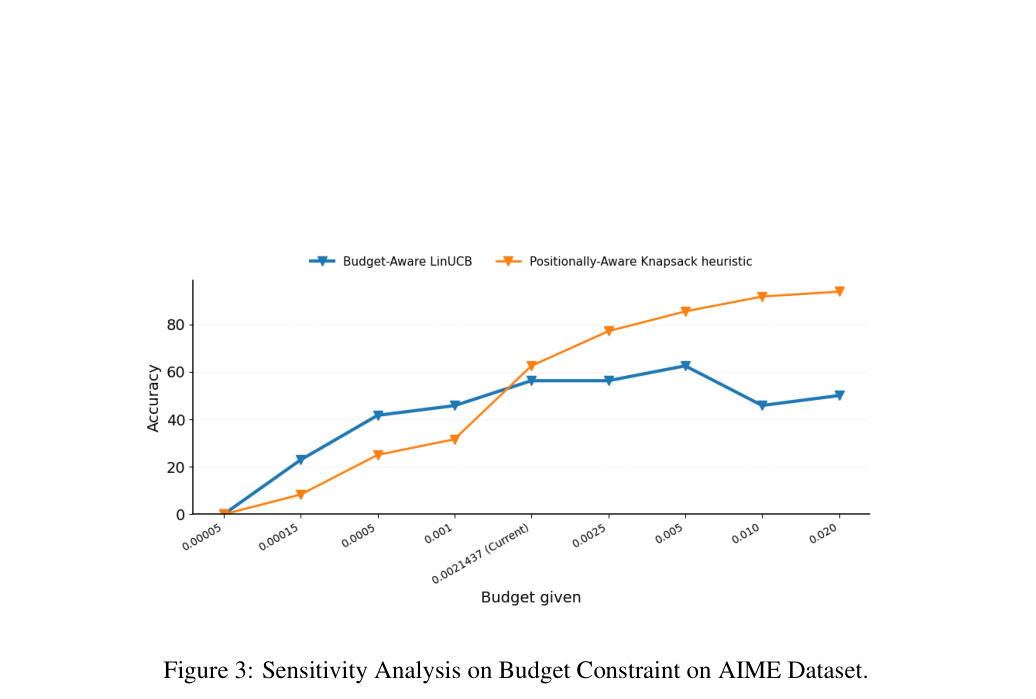
仔细看上图中两条曲线在 $$0.0021437$(Current 基准线)处发生的交叉反转现象(Crossover Phenomenon),这揭示了两种算法在预算光谱两端的互补本质:
- 极低预算区间(预算 $< $0.002$):此时单题预算甚至不够调用一次中等规模的强模型,0-1 背包能装进去的候选集非常受限,而
Budget-Aware LinUCB(蓝线)凭借对单位美元性价比的极致精打细算,在超低价模型里挑出相对契合的模型多试两次,准确率反而高于PAKH(橙线); - 中高等预算区间(预算 $\ge $0.0021437$):一旦预算跨过基准线进入合理区间,
PAKH(橙线)的准确率便一路飙升并突破90%+;反观Budget-Aware LinUCB(蓝线),即便给它再多预算(比如 $$0.010$ 或 $$0.020$),它的准确率依然死死卡在46%~62%之间停滞不前!原因正是前面剖析过的:无论预算多富裕,$\text{UCB}_k / \hat{c}_k$ 这个性价比公式永远会把便宜但平庸的模型排在第 1 步,导致充裕的预算根本花不到刀刃上。
5.4 附录宝藏实验:前序错误回答到底是“垫脚石”还是“毒药”?
读到这里,一个关乎本文根基的问题浮出水面:把前序失败模型的错误推导拼进 Prompt,真的能帮后续模型把原本做不出题做出来吗?会不会反而产生误导?
为了干净地剥离出“错误上下文”本身的净效应,作者在论文 Appendix B 中设计了一个受控对比实验(Controlled Context Experiment):在全部 60 道 AIME 数学竞赛真题上,固定对比以下两种策略:
- Strategy 1(
Gemini-Only):直接让Gemini-2.0-Flash独立做题(无任何前序上下文),准确率为20.0%(12 / 60 题),平均单题成本 $$0.000229$; - Strategy 2(
Mistral -> Gemini w/ Context):第 1 步先固定调用弱模型Mistral-Small-3.1(其独立准确率为1.67%);若Mistral答错,将Mistral的错误解答按第 2.1 节的模板拼入 Prompt,在第 2 步交给Gemini-2.0-Flash重做。结果总准确率提升到了25.0%(15 / 60 题),净增 +5.0 个百分点,平均成本 $$0.000712$。
更重要的是,作者对这 60 道题的逐题成败做了交叉比对,发现了极具启发性的上下文双刃剑效应:
| 逐题对比类别 | 题目数量 | 物理机制解读(结合 Appendix B 真实案例) |
|---|---|---|
| 正向纠错(Context Helped) | 8 题 | Mistral 与 Gemini-Only 单独做全都做错;但当 Gemini 看到 Mistral 的错误推导后,反而做对了!例如在求共线正方形与圆交点构成的三角形 $\triangle BGE$ 面积一题中,Gemini-Only 在建立坐标系求解交点时算错代数式得出 780;而 Mistral 用勾股定理硬凑底和高算出 695.75。在 Strategy 2 中,Gemini 看到 Mistral 的勾股定理路线行不通,果断改用参数化坐标 $B=a+18, E=a+57, G=(a+58,24)$ 配合鞋带公式(Shoelace Formula),一举算出正确答案 \boxed{468}。 |
| 负向污染(Context Hurt) | 3 题 | Gemini-Only 原本自己能独立做对,但看了 Mistral 的错误回答后反而被带偏做错!例如在求单位长度线段族包络线上点 $C$ 到原点距离平方 $OC^2 = p/q$ 一题中,Gemini-Only 直接写出包络线条件算出 $C=(1/8, 3\sqrt{3}/8)$,正确得出 $p+q=23$;但在 Strategy 2 中,Mistral 错误地将条件写成“点 $C$ 距离原点大于 1($\sqrt{x^2+y^2}>1$)”并解出一串带 $\sqrt{7}$ 的二次不等式,Gemini 在第 2 步试图顺着 Mistral 的不等式框架做修正,结果同样陷进了根号运算的死胡同。 |
这组 8 题正向启发 vs. 3 题负向误导(净赚 5 题,使得准确率从 12/60 涨到 17/60 附近,扣除波动后稳定在 15/60)的对照实验,把本文为什么需要用 Contextual Bandits 学习 $1159$ 维特征向量的底层逻辑彻底讲透了:
多步上下文演进并不是无脑叠加——前序模型的错误文本既是帮后续模型排除死胡同的“探路石”,也可能是污染推理链条的“噪声源”。 正因如此,固定死板的级联规则(比如永远先调 Mistral 再调 Gemini)注定无法达到最优;只有把原始问题特征、当前刚失败的模型身份以及失败回答本身的语义向量联合编码进 $x_{t,h} \in \mathbb{R}^{1159}$,让在线 Bandit 在交互中动态识别“什么样的错误上下文对哪个后续模型是有益的”,才能最大化跨模型协同的正向增益。
6. 总结
回顾整篇论文与源码实现,这项工作在多 LLM 路由与级联协作方向上立住了三个非常扎实的支点:
- 用“条件于已观测上下文的瞬时遗憾”破局非结构化文本演进:在多步 LLM 交互中,由于自由文本生成导致状态转移核未知且不可预测,强行套用全轨迹强化学习既难收敛又缺乏理论保障。将该过程转化为在每一拍真实观测到的 $1159$ 维拼接特征 $x_{t,h}$ 上最小化瞬时遗憾(Myopic Regret),既吃到了前序错误回答带来的跨模型纠错红利,又保留了 LinUCB 严格的 $\tilde{O}(\sqrt{KdTH})$ 有限样本后悔界;
- 揭示并根治了带预算多步路由中的“位置偏差(Positional Bias)”:直接按“预测得分 / 预估成本”做性价比贪心选择,虽然能省钱,但会诱导系统在第 1 步总是派上极其便宜却能力平庸的弱模型。PAKH 算法通过第一阶段用 0-1 背包锁定预算内总价值最高的模型子集、第二阶段在子集内按绝对质量 $\text{UCB}_k$ 降序排列出场顺序,把首步命中率从
52.39%直接拉升到了71.10%; - 工程实现细腻务实:无论是源码中将 $x_{t,h}$ 拆解为 5 个物理意义明确的拼接块,还是
ModelCostEstimator将确定性 Input Token 成本与位置相关的随机 Output Token 成本 LCB 分离建模,都具有很强的工业落地参考价值。
同时,在将这套方案迁移到实际生产环境时,也有两处边界值得注意:
- 即时二元反馈信号 $r_{t,h} \in {0, 1}$ 的获取:在竞赛数学、代码生成(可通过单元测试编译器判分)或带有显式用户重试按钮(点击“重新生成”即视为 $r_{t,h}=0$)的产品形态中,二元反馈是现成的;但在缺乏客观标准答案的开放式长文创作场景中,工程上需要额外部署一个轻量级的质量判别器(Verifier / Reward Model)来充当在线反馈源;
- 高维协方差矩阵求逆的计算开销:当特征维度 $d = 1159$ 时,维护 $K=6$ 个 $1159 \times 1159$ 矩阵并借助 Sherman-Morrison 秩一更新公式维护 $A_k^{-1}$,单步耗时仅在毫秒级;但如果未来接入 4096 维的大尺寸 Embedding 或将更多轮历史回答独立拼接,建议对 $A_k$ 采用对角近似(Diagonal Approximation)或低秩投影以控制内存与计算开销。
多模型在线路由、基于 Bandit 的探索-利用权衡以及预算受限下的组合优化,本质上都是自动机器学习(AutoML)在后大模型时代的自然延伸——从早期在候选算子与网络拓扑之间搜索最优架构,到如今在异构大模型池与动态 Prompt 空间中做在线自适应调度,底层的数学工具一脉相承。如果你想系统掌握从经典超参数优化、神经网络架构搜索(NAS)到大语言模型推理加速与路由优化的完整算法体系与代码实战,欢迎阅读我编写的《动手学 AutoML:从 NAS 到大语言模型优化实战》(京东、当当、淘宝各大平台均有售):
