ICLR'25 | RouteLLM 技术拆解:四种 LLM 路由算法的输入输出、维度与代码
ICLR’25 | RouteLLM 技术拆解:四种 LLM 路由算法的输入输出、维度与代码
原文:RouteLLM: Learning to Route LLMs with Preference Data
官方实现:lm-sys/RouteLLM。本文对照论文 v4,以及代码提交
0b64fda;涉及已发布分类器的维度,另外核对了 Hugging Face 的模型配置。论文的简写与开源实现有几处区别,后面会分别说明。
1. 同一个聊天入口,有些问题值得用贵模型,有些不值得
一个聊天服务收到的请求,可能是“把这句话改得礼貌一点”,也可能是“检查这段并发代码有没有竞态条件”。
全部交给能力最强的 LLM,大语言模型,简单省心,但账单也会把简单任务按贵的价格算。全部换成便宜模型,成本降了,难题的回答质量又可能掉下去。
最自然的想法是:简单问题用便宜模型,难题用贵模型。
但问题马上来了:在答案还没生成的时候,怎么知道便宜模型够不够用?
可以让便宜模型先答,再检查,不行就升级。但这会增加一次生成和检查。RouteLLM 选择另一条路径:从历史偏好数据里学习,只看当前问题,先决定交给谁,然后让选中的回答模型生成。
本文里的 router,就是这个选择回答模型的小模块。strong / weak 分别表示当前配置里较强、较贵与较弱、较便宜的两个模型。它们是相对关系,不意味着 weak 每道题都输。
RouteLLM 讨论的是请求级的两模型路由。每个请求先得到一个分数,再选一个回答模型;这个分数怎么计算,论文比较了四种算法。
读完以后,应该能把下面这条链路完整写出来:
问题字符串
  → router 的输入表示
  → 一个 [0,1] 范围的 strong 路由分数
  → 与阈值比较
  → strong 或 weak 的模型名称
  → 被选模型生成回答文本
后面统一跟踪同一个新请求,把每个方案每一步的计算目的、输出维度和结果含义连起来。代码是可运行的教学实现,不需要下载完整权重;其中的历史权重是为了演示计算流而设定的,不代表已发布模型的真实预测。
2. 先拆清两个输出:router 输出选择,回答模型才输出答案
2.1 训练时看过胜负,推理时只看到问题
一条历史数据可以写成:
\[(q,m_a,m_b,y).\]$q$ 是问题,$m_a,m_b$ 是参与比较的模型身份,$y$ 是用户选择:A 胜、平局或 B 胜。回答文本在收集偏好时当然存在,但本文讨论的 router 不把这些回答当作推理输入。
训练和上线分别做什么,可以放在一张表里:
| 阶段 | 输入 | 输出或监督信号 |
|---|---|---|
| 收集偏好 | 问题、两个模型的回答 | 人类或裁判给出胜负 |
| 训练 router | 问题表示,部分方法还使用模型身份 | 用胜负监督打分函数 |
| 在线路由 | 新问题,外加已配置的模型对 | strong 路由分数,再得到模型名称 |
| 回答生成 | 原始请求上下文 | 所选回答模型生成文本 |
router 不是先看两份答案再挑一份。 它要从问题本身预测:在这类请求上,多花钱调用 strong 有没有价值。
2.2 统一接口是一个标量,内部不一定都是二分类
论文把这个分数记为:
\[p(q)=P_\theta(\mathrm{win}_s\mid q).\]可以先理解成“强模型在这个问题上胜出的预测概率”。部署时更稳妥的说法是 strong 路由分数:它的排序能力可以有效,但未必已经校准成真实频率,尤其是换了回答模型对之后。
给定阈值 $\alpha$,路由规则为:
\[R^\alpha(q)= \begin{cases} M_s,&p(q)\geq\alpha,\\ M_w,&p(q)<\alpha. \end{cases}\]例如,预测分数为 0.7,阈值为 0.6,就选 strong;把阈值提高到 0.8,同一个问题就选 weak。
因此,阈值越高,通常调用 strong 越少。而 $\alpha=0.7$ 并不表示“70% 的流量走 strong”,流量比例取决于所有问题的分数分布。
官方的接口 Router.calculate_strong_win_rate(prompt) 返回 Python float;Router.route(...) 把它变成一个模型名,相等时走 strong。最终聊天响应由 controller 调用回答模型后返回。
2.3 同一个请求,四种方案要回答的是同一个问题
先固定这条新请求:
q = "这段 Python 代码里有没有竞态条件?请指出具体行并给出修复。"
它进入 router 时还是一个字符串,长度记为 $L$ 个字符。四种方案不会直接拿字符串做加减,而是先转成不同表示:
| 方案 | 请求进入计算时的表示 | 这个表示的作用 |
|---|---|---|
| SW / MF | 外部文本 embedding $e_q$,形状 [1536] | 用固定语义空间比较问题,不再处理原始文字 |
| BERT/XLM-R | token ID,形状 [1,T] | 由微调后的文本模型自行提取语义 |
| Causal LLM | 包装成指令后的 token ID,形状 [1,T'] | 让语言模型按评分指令预测评分 token |
为了把数字算完,下面把真实的 1536 维问题向量压缩成一个可手算的 4 维例子,并明确它只用于演示:
e_q = [0.80, 0.50, 0.10, 0.30] # [4]
四个数可以分别想象成“代码语义、推理难度、闲聊语义、格式改写”方向上的强度。0.80 和 0.50 较大,说明这是代码推理请求,不是闲聊。真实系统没有这种手工命名的坐标,但计算作用相同:后续每一步都在利用这个请求表示,估计 strong 比 weak 更有价值的程度。
统一使用阈值 $\alpha=0.60$。因此每个方案最后都要产生一个标量 $p(q)$:大于等于 0.60 就调用 strong,否则调用 weak。中间出现的 [N]、[128]、[3]、[5] 都只是为了得到这个标量,不是最终路由结果。
2.4 四条路径最终都汇聚到这个标量
下文用 $B$ 表示问题批大小,$T$ 表示分词后的长度,$N$ 表示历史比较条数,$K$ 表示模型 tier 数。tier 就是把历史能力相近的模型合成一档,默认分成 10 档。
| 方法 | 核心输入 | 中间表示 | 最终输出 |
|---|---|---|---|
| SW ranking,相似度加权排名 | 新问题向量、全部历史比较 | 相似度 [N] → 权重 [N] → tier 分数 [K] | 一个 strong 胜率 |
| MF,矩阵分解 | 问题向量 [B,1536]、模型 ID | 问题投影 [B,128],模型向量 [B,2,128] | [B] 的 strong 胜率 |
| BERT 类分类器 | token ID、attention mask [B,T] | 隐藏状态 [B,T,768] → 三类 logits [B,3] | [B] 的 strong 分数 |
| Causal LLM,因果语言模型分类器 | 包装成指令的 token ID [B,T] | 隐藏维度 4096 → 五档评分 logits [B,5] | [B] 的 strong 分数 |
logit 是尚未归一化的分数;softmax 把一组 logits 转成和为 1 的概率,sigmoid 则把单个实数压到 0 到 1。
表里 MF 的 2 是两个候选模型,BERT 的 3 是三个胜负类别,Causal 的 5 是五档评分。它们不是同一种维度。 官方在线接口一般一次接收一个问题;表里的批量形式是便于理解的展开。
3. 先把稀疏胜负变成可用监督,再谈选什么网络
3.1 为什么不能只收集 GPT-4 对 Mixtral 的比赛
论文最初使用 Chatbot Arena 的约 80K 场比较。Arena 是一个用户对两份匿名模型回答投票的平台。
问题是,模型多,两两组合更多。论文报告,任意模型对的比较标签平均占比不到 0.1%。只保留目标模型对,会丢掉大量数据。
于是作者根据 Arena 评分,把模型划到 10 个 tier。最前两档代表 strong 类,第三档代表 weak 类;以附录从 0 开始的编号看,就是 tier 0/1 与 tier 2。
但要区分两种训练方式:
- BERT 等分类方法可以学习 strong 类相对 weak 类的胜负。
- MF 的公开训练脚本保留具体模型 ID,学习多模型之间的成对比较;SW 的代码则在排名时把模型归并到 tier。
所以“分成 strong/weak 两类”不等于“所有算法都只训练两个可学习向量”。
3.2 分 tier 的动态规划,具体在优化什么
动态规划可以理解成:把一大串连续切分问题,拆成“前面已经切好了,最后一段从哪里开始”。
将 $M$ 个模型按评分排好,得到 $r_1,\ldots,r_M$。公开 compute_tiers() 的优化目标是划分连续 tier,让各组内部的方差之和尽量小。划成 $K$ 个非空组的标准递推可以写为:
$D(k,j)$ 表示前 $j$ 个模型切成 $k$ 组的最小代价,初始条件是 $D(1,j)=C(1,j)$,回溯最优切点就得到分组。
例如评分为 [1000,1010,1300,1310],切成两组时,[1000,1010] 和 [1300,1310] 的组内波动明显比从中间某一对硬拆开小。
这里对应的是源码里的各组方差之和,不能悄悄改成“按组大小加权的平方误差和”,两者的最优切点不一定相同。这一步是 SW 的初始化处理,不是每个请求都重新分 tier。
标准递推还要求将不可达状态设为无穷大。固定提交的代码把整个 DP 表初始化为零,没有完整屏蔽非法状态,特定评分分布下可能回溯出空 tier;因此不能把它视为“严格保证恰好 $K$ 个非空组”的实现。
3.3 新增数据的作用,是让 router 见过目标问题
清洗短于 16 个字符的问题,并留出约 5K 验证数据之后,论文报告约 65K 条比较、涉及 64 个模型。
作者又增加了两类数据:
| 数据 | 标签怎么来 | 规模与目的 |
|---|---|---|
| $\mathcal D_{\mathrm{gold}}$ | 对照标准答案,比较 strong/weak 是否答对 | 约 1500 道 MMLU 验证集问题,补学科选择题分布 |
| $\mathcal D_{\mathrm{judge}}$ | 用 GPT-4 对两份回答做偏好判断 | 约 120K 条,约 700 美元的数据收集成本 |
MMLU 是涵盖多个学科的选择题评测;Nectar 则提供大量问题与现成模型回答。作者利用 Nectar 中已有的 GPT-4 回答,再生成 Mixtral 回答并做裁判判断,减少重复生成费用。
这些回答只在离线构造标签时使用,上线 router 不需要重新生成一遍。
4. SW ranking:先找相似历史,再为当前请求重算实力差
SW 是 similarity-weighted,相似度加权。它要回答的是:如果更相信与当前请求相似的历史比赛,strong 是否仍然明显强于 weak?
整条链路只有三个阶段,后一阶段直接消费前一阶段的输出:
① 当前请求与每条历史请求的相似度 [4]
        ↓ 决定每条历史胜负有多大话语权
② 每条历史比赛的权重 [4]
        ↓ 带入四条胜负记录拟合
③ 两个 tier 的实力 beta [2]
        ↓ 只取差值并做 sigmoid
   当前请求的路由分数 0.689 → 走 strong
beta 不是请求的属性,也不是提前训练好的网络参数。它是第③步根据第②步的权重临时拟合出来的两个实力值。
4.1 第一步:衡量每条历史比赛和当前请求有多像
同一个 $e_q$ 进入 SW 时,系统已经保存了历史比赛。这里取 4 条,真实维度 1536 先压缩成 4:
历史问题:代码调试、数学推理、闲聊、文字润色
E = [[0.90, 0.30, 0.10, 0.20],     # [4,4]
     [0.20, 0.80, 0.10, 0.10],
     [0.10, 0.10, 0.90, 0.20],
     [0.20, 0.10, 0.20, 0.90]]
e_q = [0.80, 0.50, 0.10, 0.30]      # [4]
embedding 就是把一段文字映射成数值向量,让语义相近的文字在向量空间里靠近。论文的 SW 和 MF 都调用 text-embedding-3-small,真实输出是 [1536];这里只保留计算结构。
余弦相似度只看方向:
$ c_i=\frac{E_i^\top e_q}{\lVert E_i\rVert_2\lVert e_q\rVert_2}. $
两个向量 [1,0] 与 [2,0] 长度不同但方向相同,余弦为 1;[1,0] 与 [0,1] 垂直,余弦为 0。当前请求得到:
cosine = [0.969, 0.721, 0.302, 0.530] # [4]
这四个数回答“哪些历史胜负值得参考”:代码调试最相近,闲聊最不相近。
4.2 第二步:把相似度变成比赛权重
有了 [0.969, 0.721, 0.302, 0.530],还不能直接拟合,因为 BT 需要的是每条比赛的损失权重。公开代码按当前请求自己的最大相似度缩放:
$ \tilde c_i=\frac{c_i}{\max_j c_j}, \qquad w_i=10^{1+\tilde c_i}. $
代入四个相似度得到:
weight = [100.0, 55.4, 20.5, 35.2] # [4]
代码比赛的话语权是 100,闲聊比赛只有 20.5。权重不要求和为 1,也不是只保留最近邻。真实数据把 $N=4$ 换成数万条,输出仍然是每条历史比较一个权重。
论文公式的分母写成历史问题自身对训练集的最大相似度;上面按代码,分母使用当前请求对全部历史问题的最大相似度。原实现没有保护最大值为零的情况,教学代码会拒绝这种无法缩放的输入。
4.3 第三步:用加权胜负解出 beta
现在才进入 beta。四条历史比赛的结果是:
1. strong 胜 weak,权重 100.0
2. weak 胜 strong,权重 55.4
3. 平局,权重 20.5
4. strong 胜 weak,权重 35.2
BT 假设两个 tier 各有一个实力标量,胜率只由实力差决定:
$ P(\text{strong 胜})=\sigma(\beta_s-\beta_w),\qquad \sigma(x)=\frac1{1+e^{-x}}. $
比如差值为 0,胜率是 0.5;差值为 1.1,胜率约 0.75。平局的目标直接记为 0.5。
拟合就是调整 $\beta_s,\beta_w$,让加权预测误差最小:
$ \mathcal L=-\sum_{i=1}^{4}w_i\left[y_i\log p_i+(1-y_i)\log(1-p_i)\right]. $
权重大的比赛预测错了,损失会更重,所以代码比赛对结果影响最大。
由于四条比赛都是 strong 对 weak,预测始终使用同一个差值 $g=\beta_s-\beta_w$。逐条计算:
| 比赛 | 结果 $y$ | 权重 | 这一条如何惩罚 $g$ |
|---|---|---|---|
| 代码 | 1 | 100.0 | $g$ 越大,strong 胜的概率越高,损失越小 |
| 数学 | 0 | 55.4 | $g$ 越大,反而更不符合 weak 获胜,损失越大 |
| 闲聊 | 0.5 | 20.5 | 平局希望概率接近 0.5,即 $g$ 接近 0 |
| 润色 | 1 | 35.2 | 同样鼓励 $g$ 变大,但话语权只有 35.2 |
正向证据的总权重是 $100.0+35.2=135.2$,反向证据是 55.4,平局证据是 20.5。正向证据更重,因此最优差值应当为正,但不能大到忽视第二场 strong 的失败。
把四项损失对 $g$ 求导并令总导数为零,得到:
$ \frac{100.0}{1+e^{g}}-\frac{55.4}{1+e^{-g}}+20.5(0.5-\sigma(g))=0. $
解这个一元方程得到 $g=0.794$。再取一个以零为中心的代表解:
beta = [beta_s, beta_w] = [0.397, -0.397]    # [2]
0.397 - (-0.397) = 0.794
这里可以看出 beta 的准确含义:
-
0.397是 strong tier 的相对实力。 -
-0.397是 weak tier 的相对实力。 - 同时加 10 变成
[10.397, 9.603],差值仍然是 0.794,预测完全不变。所以单个 beta 的绝对大小没有意义,只有 $\beta_s-\beta_w$ 有意义。 - 当前请求并没有单独进入这个方程。它的作用已经发生在上一步:决定了 100.0、55.4、20.5、35.2 这四个权重。换一个请求,权重改变,方程的解和 beta 都会改变。
最后只把实力差送进 sigmoid:
p_sw(q) = sigmoid(0.794) = 0.689
0.689 超过阈值 0.60,当前请求走 strong。若错误地让四条比赛等权,方程解会变成约 0.498,路由分数约 0.622。从 0.622 升到 0.689,就是更高的代码比赛权重改写 beta 的结果。
官方实现会把实力转换成 Elo 分。设 $r_s-r_w=400g/\ln 10$,则:
$ P(s>w)=\sigma\left(\frac{\ln10}{400}(r_s-r_w)\right). $
400 分差值对应胜率 $10/11\approx0.909$。论文的指数写法使用了相反符号;这里统一采用代码中“分数越高越强”的约定。
4.4 用同一数值把三步连成代码
下面的优化器负责自动寻找上一节手算方程的解。它实现标准 BT 的含义;官方使用无正则逻辑回归,并在设计矩阵中加入 Elo 尺度。
# 教学实现:sw_score(E, e, a, b, y, strong, weak)
# 输入:历史向量、当前向量、双方 tier ID、A 胜标签
# 输出:当前问题的 strong 胜率 float
import torch
import torch.nn.functional as F

def sw_score(E, e, a, b, y, strong, weak):
    E, e = F.normalize(E, dim=-1), F.normalize(e, dim=-1)
    cosine = E @ e                              # 第一步,[N]
    if cosine.max().item() <= 0:
        raise ValueError("示例要求最大 cosine > 0")
    weight = 10 ** (1 + cosine / cosine.max())  # 第二步,[N]
    K = int(torch.cat([a, b]).max()) + 1
    X = F.one_hot(a, K).float() - F.one_hot(b, K).float()
    beta = torch.zeros(K, requires_grad=True)   # 第三步要优化的 [K]
    opt = torch.optim.LBFGS([beta], max_iter=60)

    def closure():
        opt.zero_grad()
        per_row = F.binary_cross_entropy_with_logits(
            X @ beta, y, reduction="none"       # [N],允许 y=0.5
        )
        loss = (weight * per_row).sum() / weight.sum()
        loss.backward()
        return loss

    opt.step(closure)
    return torch.sigmoid(beta[strong] - beta[weak]).item()

E = torch.tensor([
    [0.90, 0.30, 0.10, 0.20],
    [0.20, 0.80, 0.10, 0.10],
    [0.10, 0.10, 0.90, 0.20],
    [0.20, 0.10, 0.20, 0.90],
])                                              # [4,4],四条历史请求
e = torch.tensor([0.80, 0.50, 0.10, 0.30])    # [4],当前代码请求
a = torch.tensor([0, 0, 0, 0])                # strong tier
b = torch.tensor([1, 1, 1, 1])                # weak tier
y = torch.tensor([1., 0., .5, 1.])            # 胜、负、平、胜
p = sw_score(E, e, a, b, y, strong=0, weak=1)
print(round(p, 4))                            # 0.6890
代码输出的 beta 可能是 [0.397,-0.397],也可能是整体平移后的另一组值;只要差值保持 0.794,路由分数就一样。固定提交还有一个边界情况:同 tier 的两列被连续赋值时,后一次会覆盖前一次。标准 BT 的同 tier 差值应为零,上面的 one-hot 相减保留了这个含义。
SW 不需要离线训练一个神经网络,但每个新问题都要重新求解一次 beta。 “不用训练”并不意味着推理免费,计算负担被放到了请求到来之后。
5. MF:把历史比较提前压缩进参数,线上只做一次对齐
SW 的 beta 要在每个请求到来后重新求解。MF 把这个经验提前训练进一个小参数模型,线上不再翻历史比赛,只回答“当前请求更贴近哪个模型的特长”。
它的主线是:
请求向量 [4]
  → 投影到模型特长空间 z_q [4]
  → 与 strong、weak 的特长向量逐项对齐
  → 两个适配分 0.941、0.540
  → 分差 0.400 做 sigmoid,得到 0.599,走 weak
下面先看每一项乘法在对齐什么,再回到真实模型的 1536 和 128 维实现。
5.1 为什么叫矩阵分解,又为什么没有直接做 SVD
想象一张表:行是问题,列是模型,每个格子是“这个模型回答这个问题有多好”。
大部分格子没观测到。即使观测过两份回答,往往也只知道谁更好,没有绝对分数。
MF 的想法是让问题和模型各自带一个短向量,通过它们的组合预测格子的分数。可以类比推荐系统:“用户喜欢什么”和“物品有什么特点”在同一个空间里匹配。
这里没有先构造完整矩阵,再做奇异值分解 SVD。它直接学习模型向量和问题投影,用偏好比较训练。
论文写的打分函数是:
\[\delta(m,q)= w_2^\top\left[ v_m\odot(W_1^\top v_q+b) \right].\]$\odot$ 是逐元素乘法,比如 [2,3] 与 [4,5] 相乘得到 [8,15],不是点积后的一个数。
不过,公开推理代码没有这里的偏置 $b$,并且额外对模型向量做了 L2 归一化。按实际实现,下面使用:
\[\hat v_m=\frac{v_m}{\lVert v_m\rVert_2}, \qquad z_q=Wv_q,\] \[\delta(m,q)=w^\top(\hat v_m\odot z_q).\]问题向量和投影后的问题向量没有在这段代码里做同样的归一化,所以这个分数也不能直接叫 cosine similarity。
5.2 同一个 4 维请求,如何变成两个模型分数
MF 不再读取那 4 条历史比赛,而是使用训练后压缩进参数的经验。把隐藏维度也取成 4,设投影暂时为单位变换,于是:
z_q = [0.80, 0.50, 0.10, 0.30] # [4]
它仍然表示当前请求在四个特征方向上的强度。两个模型的归一化向量分别表示它们擅长的方向:
v_s = [0.784, 0.588, 0.196, 0.000]      # [4],strong 更偏代码和推理
v_w = [0.196, 0.196, 0.588, 0.756]      # [4],weak 更偏闲聊和文字改写
逐元素相乘的目的,是让请求特征与模型特长逐项对齐:
v_s ⊙ z_q = [0.627, 0.294, 0.020, 0.000]  # [4]
v_w ⊙ z_q = [0.157, 0.098, 0.059, 0.227]  # [4]
strong 的前两项很大,因为代码请求恰好撞上它擅长的方向;weak 虽然在文字改写方向有 0.756 的特长,但当前请求这一项只有 0.30,所以乘积只有 0.227。
最后一层 $w=[1,1,1,1]$ 把四个对齐结果相加:
delta_s = 0.941     # strong 对当前请求的适配分
delta_w = 0.540     # weak 对当前请求的适配分
gap     = 0.400     # strong 比 weak 多出的适配程度
p_mf(q) = 0.599     # sigmoid(0.400)
0.941 和 0.540 不是胜率,只是两个适配分;只有差值 0.400 进入 sigmoid。结果 0.599 刚刚低于阈值 0.600,所以这条请求走 weak。SW 给出 0.783 却走 strong,并不矛盾:SW 现场使用了“strong 赢得多数代码比赛”的历史结果,而这个 MF 例子设定的模型向量只表达了中等幅度的特长差异。
真实默认模型只是把请求表示从 [4] 扩展到 [1536],再投影成 [128]。新增的 128 个坐标没有手工名称,作用同样是保存不同的请求特征和模型特长。
5.3 真实默认模型的批量形状
核实后的默认参数是:
| 参数 | 数值 | 含义 |
|---|---|---|
text_dim | 1536 | 外部文本 embedding 的长度 |
hidden_size | 128 | 模型向量与投影后问题向量的长度 |
num_models | 64 | 可学习模型 embedding 表的行数 |
num_classes | 1 | 对一个“问题、模型”组合只打一个分数 |
比如一批有 $B=4$ 个问题,每个问题比较 strong 与 weak:
| 步骤 | 张量形状 | 发生了什么 |
|---|---|---|
| 问题 embedding | [4,1536] | 每个问题一个外部文本向量 |
Linear(1536,128,bias=False) | [4,128] | 投影到共同空间 |
| 候选模型 ID | [4,2] | 每个问题配置两个模型编号 |
Embedding(64,128) | [4,2,128] | 查出两侧模型向量并归一化 |
| 问题向量增加候选轴 | [4,1,128] | 准备广播给两个候选 |
| 逐元素乘法 | [4,2,128] | 同一问题分别匹配两个模型 |
Linear(128,1,bias=False) | [4,2,1] | 每个候选得到一个分数 |
| 去掉最后一维 | [4,2] | 两个模型的分数 |
| strong 分数减 weak 分数 | [4] | 每个问题一个分差 |
| sigmoid | [4] | strong 胜率 |
这里的模型 ID 是模型表的行号。例如固定源码里 GPT-4 的编号是 24,Mixtral 是 36。它们不是文本 token ID,也不表示模型有 24 或 36 个参数。
官方单问题代码实际用 [1536] → [128],然后广播给 [2,128] 的两个模型向量。上表是同一计算的批量版本。
5.4 一个三维算式,只为看清逐元素对齐
把上面的对齐计算再缩成三维,数字可以口算。设:
\[\hat v_s=(0.6,0.8,0),\qquad \hat v_w=(0,0.8,0.6),\qquad z_q=(2,1,-1).\]strong 的三项对齐结果是 $(1.2,0.8,0)$,求和为 2;weak 的结果是 $(0,0.8,-0.6)$,求和为 0.2。差值 1.8 经过 sigmoid 得到:
\[p(q)=\sigma(2-0.2)\approx0.858.\]这个例子的目的不是提供另一套参数,而是看清每一维乘法都在问“模型是否具备请求所需特征”。三维能看懂,扩展到 128 维也没有新增数学步骤。
5.5 训练时比较两个模型,推理时只剩一次前向
公开训练脚本先丢弃平局和同模型比较,再把每条数据排列成“赢家 ID、输家 ID、问题索引”。
因此训练损失可以写成:
\[\mathcal L_{\mathrm{MF}} =-\frac1B\sum_{i=1}^B \log\sigma\left[ \delta(m_i^+,q_i)-\delta(m_i^-,q_i) \right].\]不用两个标签:因为输入已经把赢家放在前面,目标全是 1。
下面保留实际的 1536、128、64,顺便演示一次反向传播。BCEWithLogits 直接吃分差,数值上比先 sigmoid、再取对数稳定。
# 教学批量实现,对应官方 MFModel.forward / pred_win_rate
import torch
from torch import nn
import torch.nn.functional as F

class TinyMF(nn.Module):
    def __init__(self):
        super().__init__()
        self.P = nn.Embedding(64, 128)
        self.proj = nn.Linear(1536, 128, bias=False)
        self.head = nn.Linear(128, 1, bias=False)

    def forward(self, query_embedding, model_ids):
        z = self.proj(query_embedding)            # [B,128]
        v = F.normalize(self.P(model_ids), dim=-1) # [B,2,128]
        scores = self.head(v * z[:, None, :])      # [B,2,1]
        return scores.squeeze(-1)                 # [B,2]

torch.manual_seed(0)
router = TinyMF()
query = torch.randn(4, 1536)  # 实际使用时来自文本 embedding
pair = torch.tensor([[24, 36]]).expand(4, -1)  # [4,2]
scores = router(query, pair)
logit = scores[:, 0] - scores[:, 1]             # [4]
p_strong = logit.sigmoid()                     # [4]

# 通用 A/B 顺序的教学标签;1 表示第一侧胜,0 表示第二侧胜
y = torch.tensor([1., 0., 1., 1.])
loss = F.binary_cross_entropy_with_logits(logit, y)
loss.backward()
print(scores.shape, p_strong.shape, round(loss.item(), 4))
# torch.Size([4, 2]) torch.Size([4]),最后一个是标量损失
实际赢家在前的训练中,只需把 pair 按每条比较重排,y 换成全 1。公开训练实现还会在冻结的问题 embedding 上加入高斯噪声;这个演示省去了数据加载和噪声增强。
可训练参数量为:
\[64\times128+1536\times128+128=204928.\]约 20.5 万参数,不包含外部文本 embedding 模型。因此它不是从原始字符串开始、只靠 20 万参数就独立完成语义理解。
5.6 这套 MF 实际有多强,又有什么表达限制
把逐元素乘法改写一下:
\[\delta(m,q)= (\hat v_m\odot w)^\top Wv_q.\]对于固定模型,它是文本 embedding 的线性打分。再固定 strong/weak 对:
\[p(q)= \sigma\left[ \left(W^\top((\hat v_s-\hat v_w)\odot w)\right)^\top v_q \right].\]也就是说,在固定的外部问题表示上,默认 MF 对固定模型对的决策边界是线性的。
如果把所有问题堆成 $Q\in\mathbb R^{N\times1536}$,所有归一化模型向量堆成 $V\in\mathbb R^{64\times128}$,分数矩阵是:
\[S=(QW^\top)\operatorname{diag}(w)V^\top, \qquad S\in\mathbb R^{N\times64}.\]这就是“矩阵分解”的具体含义:问题与模型通过 128 维中间表示组合。矩阵的秩可以粗看成其中有多少个独立变化的方向,这里的秩最多为 $\min(N,128,64)$,因此不超过 64。未知分数来自共享表示对稀疏比较的泛化。
6. BERT 分类器:让文本模型直接判断三种胜负结果
前两种方法都从外部 embedding 出发。BERT 类方法改成把原始请求送进文本模型,目标直接是三种互斥结果:strong 胜、平局、weak 胜。
计算主线是:
原始请求 → token 表示 [1,T]
  → 768 维上下文隐藏状态
  → 三个原始证据 logits [3]
  → softmax 概率 [0.637, 0.234, 0.129]
  → 取 strong 胜概率 0.637,走 strong
6.1 论文写单 sigmoid,发布模型实际是三分类 XLM-R
论文用 BERT-base 描述,并写成:
\[p(q)=\sigma(Wh_{\mathrm{CLS}}+b).\]$h_{\mathrm{CLS}}$ 是用来概括整段输入的特殊位置向量。这个表达解释了“文本表示接分类头”的想法,但发布的默认 checkpoint 是 XLMRobertaForSequenceClassification,底座为 xlm-roberta-base。
核实配置后,它的隐藏维度是 768,输出三个类别:
| 类别下标 | 含义 | 路由时怎么处理 |
|---|---|---|
| 0 | strong 一侧胜 | 计入 strong 分数 |
| 1 | 平局 | 计入 weak-or-tie |
| 2 | weak 一侧胜 | 计入 weak-or-tie |
配置文件只写了通用的 LABEL_0/1/2,上面的语义来自 router 源码的概率合并逻辑。
6.2 同一个请求如何被分成三类胜负概率
BERT/XLM-R 不再接收外部的 [1536] 或演示用 [4],而是接收原始字符串。分词后加上首尾特殊 token,得到形状 [1,T] 的 token ID。隐藏状态 [1,T,768] 中,每个 token 都有一个 768 维上下文表示;取第一个 <s> 位置的 [768],用它汇总整个请求。
分类头把它变成三个未归一化分数。沿用同一条代码请求,设结果为:
logits = [1.20, 0.20, -0.40] # [3]
三项依次表示 strong 胜、平局、weak 胜的原始证据。1.20 最大,说明模型找到的主要证据支持 strong;0.20 和 -0.40 保留了平局与 weak 胜的可能性。softmax 后:
probabilities = [0.637, 0.234, 0.129]    # [3]
p_bert(q) = 0.637
0.637 是 strong 胜的概率,0.234 是平局概率,0.129 是 weak 胜概率。路由时平局和 weak 胜合并成“不值得调用 strong”的概率 0.363,最后仍取补集 0.637。它高于阈值 0.60,因此走 strong。
这里的 [768] 不是 768 个可直接命名的语义槽,而是微调后形成的请求摘要;真正进入决策的是随后压缩出的三种互斥结果。三类概率之和必须为 1,所以增加 strong 证据必然降低另外两类的概率。
6.3 [B,T] → [B,T,768] → [B,3] → [B]
以 $B=4,T=128$ 为例:
input_ids / attention_mask       [4,128]
XLM-R 隐藏状态                  [4,128,768]
取首个 <s> 位置                 [4,768]
Dropout → Linear(768,768) → tanh [4,768]
Dropout → Linear(768,3)          [4,3]
沿类别维 softmax                [4,3]
取第 0 类                      [4]
input_ids 是整数词表索引;attention_mask 通常以 1 表示有效 token、0 表示补齐位置。它不会把输入变成两份候选回答。
XLM-R 的 <s> 在这里承担类似 BERT [CLS] 的作用。发布 tokenizer 的默认最大长度是 512,通常包括起止 token;配置里的位置 embedding 数 514 不是“可以直接塞 514 个正文 token”。
6.4 平局不拆半,softmax 也不沿 token 维做
若 logits 为 [2,1,0]:
代码取:
\[p(q)=1-(p_t+p_w)=p_s.\]如果阈值是 0.7,这次就走 weak。虽然三类里 strong 的概率最大,它仍然没有达到路由阈值。三分类 argmax 和路由决策是两回事。
三分类的训练目标是一个整数类标,形状 [B],配合三类交叉熵;不需要像 BERT 预训练那样随机遮掉词。
# 计算示例:对应 BERTRouter.calculate_strong_win_rate 的聚合
import torch
import torch.nn.functional as F

logits = torch.tensor([[2., 1., 0.]], requires_grad=True) # [1,3]
prob = logits.softmax(dim=-1)  # 在“类别”上归一化
p_strong = prob[:, 0]          # [1]
label = torch.tensor([0])      # [1],这条训练样本 strong 胜
loss = F.cross_entropy(logits, label)
print(round(p_strong.item(), 4), round(loss.item(), 4))
# 0.6652 0.4076
把三类 softmax 写成单 sigmoid 也可以,但对应的是:
\[p_s=\sigma\left(z_s-\log(e^{z_t}+e^{z_w})\right).\]这显然不是简单地对一个线性头的输出再接 sigmoid,所以讲实际网络结构时不能只照抄论文的简式。
7. Causal LLM:把判断写成五档评分,再汇总路由分数
BERT 用一个三分类头直接输出胜负。Causal LLM 继续增加模型容量,但不再加单独的分类头,而是让 Llama 3 8B 在回答位置输出一个评分 token。评分越高,表示 weak 越可能独立完成请求;最后把低分三档的概率加起来,得到 strong 路由分数。
它的主线是:
原始请求 + 评分指令
  → token 序列 [1,T']
  → 4096 维隐藏状态
  → 五个评分 logits [5]
  → 五档概率 [0.6239, 0.2295, 0.0844, 0.0311, 0.0311]
  → 前三档相加 0.938,走 strong
7.1 问题先包装成指令,输出被压缩成五档评分
默认发布模型把问题放进类似下面的模板,前面再加评分 system instruction:
[Question]
用户的问题

Prediction:
它在原始词表后追加五个 token:[[1]] 到 [[5]]。每个是一个新增 token,不是让模型逐字符生成五六个符号。
评分越高,代表弱模型越可能处理好。代码把 1/2/3 分归到 strong 一侧,4/5 分归到 weak 一侧。
这里的五档评分不是五种胜负类别,中间的 [[3]] 也不能直接称为“平局类”。论文把方法概括成标签 token 分类,公开 checkpoint 的实际接口更具体。
7.2 同一个请求如何变成五档评分分布
Causal LLM 先把原始请求包装进评分指令,再编码成 [1,T']。模型在每个位置产出 [4096] 的隐藏状态,但路由并不直接解释这 4096 个数;LM head 把预测评分 token 的那个位置投影成词表分布,再只取出五个新增评分 logits。
设当前请求得到:
rating_logits = [2.0, 1.0, 0.0, -1.0, -1.0] # [5]
五个位置对应 [[1]] 到 [[5]],分数越高代表 weak 越可能独立完成请求。当前最大证据出现在最低档 [[1]],说明模型认为这道代码题不适合交给 weak。仅在五档内 softmax:
rating_prob = [0.6239, 0.2295, 0.0844, 0.0311, 0.0311] # [5]
前三档表示需要 strong,概率分别为 0.624、0.230、0.084;后两档表示 weak 足以处理,概率均为 0.031。所以:
p_causal(q) = 0.6239 + 0.2295 + 0.0844 = 0.9379
这个 0.938 是“评分落在 1/2/3 档”的总概率,不是某一个 token 的词表概率。它明显高于 0.60,请求走 strong。五档保留了不确定性:模型虽然倾向 1 分,仍用 0.230 表达“有可能只是 2 分”;聚合后这些档位才形成统一路由分数。
7.3 4096 维隐藏状态,为什么最后会看到 128261 维
发布配置的隐藏维度为 4096,原词表大小为 128256,新增 5 项后为 128261。
以 $B=1,T=128$ 为例,普通完整前向的维度是:
| 步骤 | 形状 |
|---|---|
包装后的 input_ids | [1,128] |
| Llama 隐藏状态 | [1,128,4096] |
| LM head 投影到词表 | [1,128,128261] |
| 某一个生成步骤的 scores | [1,128261] |
| 取五个新增评分位置 | [1,5] |
| 五类 softmax,再合并 | [1] |
128261 是词表大小,4096 是每个 token 的特征维度。两者通过 LM head 的权重矩阵 [128261,4096] 连接,不能混为一谈。
官方代码最多贪心生成 6 个新 token,找其中第一个评分 token,然后取生成该评分 token 的那个步骤对应的分数。所以不保证一定直接读取 scores[0]:前面可能还生成了格式相关 token。
7.4 只在五个标签上做 softmax,再把前 3 档相加
设选中生成步骤的五个评分 logits 是 $a_1,\ldots,a_5$:
\[u_i=\frac{e^{a_i}}{\sum_{j=1}^5e^{a_j}}, \qquad p(q)=u_1+u_2+u_3=1-u_4-u_5.\]这里是在评分 token 集合内部重新归一化。如果先对整个词表做 softmax,再只取五个概率而不归一化,算出来会不同。
下面假设已经定位到评分步骤,用一个极简 logits 演示后半段:
# 计算示例:对应 CausalLLMClassifier 中评分步骤的概率聚合
import torch

rating_logits = torch.tensor([[2., 1., 0., -1., -1.]])  # [1,5]
rating_prob = rating_logits.softmax(dim=-1)
p_strong = rating_prob[:, :3].sum(-1)                  # [1]
print([round(x, 4) for x in rating_prob[0].tolist()], round(p_strong.item(), 4))
# [0.6239, 0.2295, 0.0844, 0.0311, 0.0311] 0.9379
在完整推理接口中,这里的 step_scores 来自 out.scores[k],其中 $k$ 是首个评分 token 的生成步骤;找不到评分 token 时,外层 router 的默认分数是 1,倾向走 strong。
代码里的 score_threshold=4 是把五档评分切成两组,不是前面 $p(q)\geq\alpha$ 的概率阈值。一个切评分类别,一个切最终路由分数。
7.5 训练时谁预测谁:标签位置要向前错一格
因果语言模型在位置 $t-1$ 预测位置 $t$ 的 token。因此训练序列如果是:
system instruction + 问题 + Prediction: + [[2]]
预测 [[2]] 的是它前一个位置的输出,不能拿 [[2]] 自己位置上的隐藏状态去预测自己。
一个教学实现可以把无关位置的标签置为 -100,只监督评分 token:
# 教学函数:score_token_loss(logits, input_ids, score_pos)
# logits [B,T,V];input_ids [B,T];score_pos [B] 为评分 token 下标
# 返回:完整词表交叉熵的标量损失
import torch
import torch.nn.functional as F

def score_token_loss(logits, input_ids, score_pos):
    B, T, V = logits.shape
    rows = torch.arange(B, device=input_ids.device)
    labels = torch.full_like(input_ids, -100)
    labels[rows, score_pos] = input_ids[rows, score_pos]
    return F.cross_entropy(
        logits[:, :-1, :].reshape(-1, V),  # 前一个位置的预测
        labels[:, 1:].reshape(-1),        # 后一个位置的真实 token
        ignore_index=-100,
    )
注意两个不同的“mask”:attention_mask 控制哪些输入位置有效,labels=-100 控制哪些位置计算损失。
上面演示的是常见的评分 token 监督方式。RouteLLM 公开入口把分类器训练交给 llmforge,没有展示完整的底层训练循环;因此不能把这段教学 mask、完整词表损失的细节,写成已核实的 checkpoint 历史训练配置。能直接核实的是发布模型与推理时的五档聚合方式。
8. 回到同一请求:四种分数为什么会不同
四种方案处理的是同一条代码请求,阈值也都取 0.60:
| 方案 | 关键中间结果的含义 | 路由分数 | 决策 |
|---|---|---|---|
| SW | 相似度先变成四条比赛的权重,再解出实力差 0.794 | 0.689 | strong |
| MF | 请求特征与两个模型特长对齐后,适配分差为 0.400 | 0.599 | weak |
| BERT/XLM-R | 三类互斥结果中,strong 胜占 0.637,平局占 0.234 | 0.637 | strong |
| Causal LLM | 五档评分里,前三档累计概率为 0.938 | 0.938 | strong |
数值不同是合理的,因为中间量本来就不是同一件事。SW 的权重描述历史比赛的相关性,MF 的逐项乘积描述请求特征与模型特长是否匹配,BERT 的三项直接表示胜负关系,Causal 的五项表示 weak 能否胜任的评分档位。
因此维度不能脱离含义理解。[4] 在 SW 中是四条历史比赛的权重,在演示版 MF 中却是四个请求特征;[3] 是三种胜负结果,[5] 是五档评分。它们都必须先转换成同一个问题的答案:当前请求值不值得调用 strong。上面为了手算而设定的权重和向量,只说明计算流,不代表论文里的真实模型会对这句代码请求给出相同分数。
9. 四种方法究竟在何时计算,平局又怎么处理
把训练与推理放到一起,算法差异会更清楚:
| 方法 | 离线阶段 | 在线阶段 | 平局处理 |
|---|---|---|---|
| SW | 存比较、存 embedding、构造 tier | 当前问题算相似度,再拟合加权 BT | 拆成一胜一负,等价二元目标 0.5 |
| MF | 学模型向量、问题投影和打分层 | embedding → 两侧分数差 → sigmoid | 公开训练脚本丢弃 |
| BERT/XLM-R | 微调文本编码器与三类分类头 | 三类 softmax → 取 strong 胜概率 | 保留独立 tie 类,决策时并入 weak-or-tie |
| Causal LLM | 微调指令式评分模型 | 找评分 token → 五档 softmax → 聚合 | 推理接口没有独立 tie token,不能套用三类映射 |
统一接口不代表统一标签空间。 这是复现时最容易被一句“都是预测 strong 胜率”掩盖掉的差异。
训练资源也不是一个数量级。论文报告 MF 约 10 epochs、batch size 64,用 8GB GPU;BERT 约 2000 steps、最大长度 512,用 2 张 L4;Causal 约 2000 steps、最大长度 2048,用 8 张 A100 80GB。论文报告值与公开脚本示例要分开看,例如 MF 示例脚本设的是 100 epochs,不能把它当成论文实验配置。
9. 分数算出来之后,还要校准阈值,才能控制账单
9.1 想让 30% 的请求走 strong,就取分数的 70% 分位数
假设在一批有代表性的请求上得到分数 $p_1,\ldots,p_n$。希望 strong 调用比例为 $\rho$,可先选:
\[\alpha=\operatorname{Quantile}_{1-\rho}(p_1,\ldots,p_n).\]这一步不需要答案标签,也能按分数分布控制近似流量比例;但要判断质量是否达标,仍然需要回答质量评估。
例如:
# 计算示例:calibrate_threshold(scores, target_fraction)
import numpy as np

scores = np.array([.05, .1, .2, .4, .7, .9])
alpha = np.quantile(scores, 1 - 1/3)
use_strong = scores >= alpha
print(round(alpha, 2), round(use_strong.mean(), 3))
# 0.5 0.333
分数大量相同时,>= 会让实际比例跳变;流量分布变化后,原阈值也不再保证同样比例。不是抄一个论文阈值就能永久省钱。
9.2 胜率不等于质量增益,调用比例也不等于真实费用
假设 A 类问题上 strong 以 0.9 的概率略好一点,B 类问题上 strong 以 0.6 的概率好很多。如果业务计的是质量提升幅度,B 未必比 A 更不值得花钱。
因此 RouteLLM 的分数是一个有用的代理目标,不直接等于每个请求的经济价值。更一般的决策可以写成:
\[\Delta U(q)= \mathbb E[U(M_s(q))-U(M_w(q))\mid q],\] \[\text{选择 strong,当 } \Delta U(q)>\lambda\,[C_s(q)-C_w(q)].\]$U$ 是业务质量,$C$ 是费用,$\lambda$ 是对额外费用的惩罚。这是理解原方法边界的扩展表达,不是论文声称实现了逐请求效用最优。
同理,若每次 strong/weak 的费用近似固定,总成本可以粗写为:
\[C_{\mathrm{avg}}\approx \rho C_s+(1-\rho)C_w+C_{\mathrm{router}}.\]真实 API 账单还受输入输出长度、缓存、不同端点定价影响。论文用 strong 调用比例作主要成本代理,是因为当时两者费用差距很大,不意味着线上永远只数请求条数就够。
10. 看实验之前,先把 PGR、APGR 和 CPT 算明白
10.1 “恢复 50% 差距”不等于“达到 strong 的 50%”
PGR 是 performance gap recovered,恢复的性能差距比例,越高越好:
\[\operatorname{PGR}= \frac{r_{\mathrm{router}}-r_w}{r_s-r_w}.\]如果 weak 得 70 分,strong 得 90 分,router 得 80 分,那么:
\[\operatorname{PGR}=\frac{80-70}{90-70}=50\%.\]router 的绝对分数已经是 strong 的 $80/90\approx88.9\%$,但只恢复了两者差距的一半。
这个比例要求 $r_s>r_w$ 才方便解释;它也不是数学上必定处于 0 到 1。若错误选择导致更差表现,可以小于 0;若能利用互补性超过全 strong,也可以大于 1。
APGR 在不同 strong 调用比例下,对 PGR 曲线求面积,越高越好:
\[\operatorname{APGR}= \int_0^1\operatorname{PGR}(c)\,dc.\]$c$ 是 strong 调用比例。论文用 10 个调用比例点的 PGR 均值做近似。理想化随机路由的期望 PGR 约等于调用比例,所以面积约为 0.5;有限样本结果会有波动。
CPT 是 call-performance threshold,表示达到指定 PGR 所需的最小 strong 调用比例,越低越好。例如 CPT(50%) 是恢复一半性能差距需要调用多少 strong。
下面这张原图先看右侧:横轴是 strong 调用比例,绿色虚线标出 CPT(50%),蓝色阴影对应 APGR 的面积;再看左侧和中间,相同调用比例下曲线越高,路由越有效。
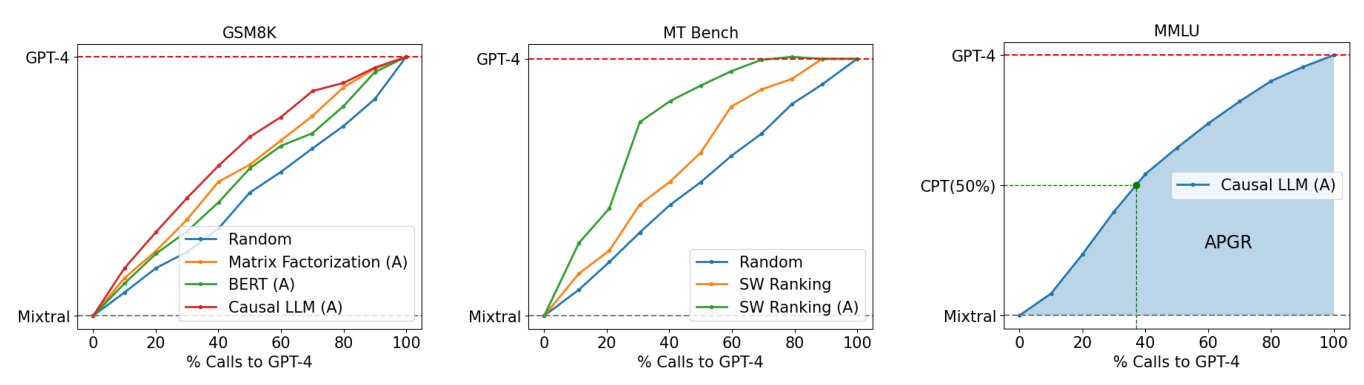
右侧绿线大约在 37% 的调用比例处达到一半性能差距,说明把贵模型用在更合适的问题上,能比随机分流更有效。中间带 (A) 的曲线表示加入增强数据,局部提升来自训练分布改善,不是单纯调整阈值。
10.2 同样的数据增强,在聊天、学科题和数学题上效果不同
先看 MT Bench,开放式对话评测,由模型裁判打分。下图左边只有 Arena 数据,右边加入裁判增强数据,横轴都是 GPT-4 调用比例。
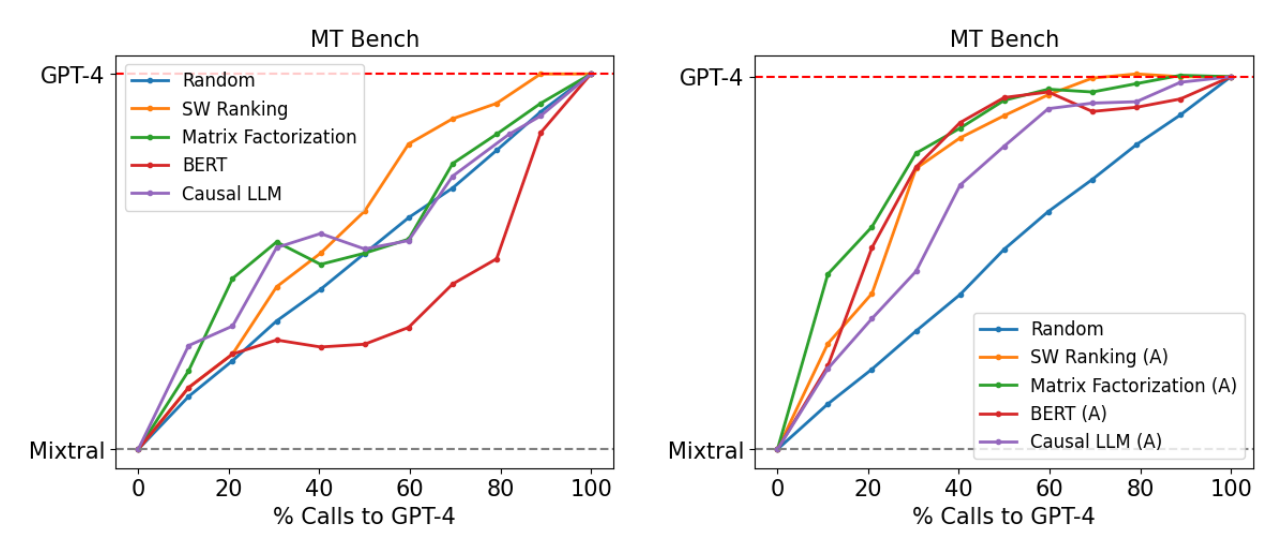
左侧 BERT 红线在不少区间甚至低于随机;右侧增强之后,MF、SW、BERT 都明显高于随机。更大的编码器不天然等于更好的 router,数据不足时反而容易学不好。
原文 MT Bench 的关键数字如下,CPT 越低越好,APGR 越高越好:
| 方法 | 训练数据 | CPT(50%) | CPT(80%) | APGR |
|---|---|---|---|---|
| 随机 | — | 49.03% | 78.08% | 0.500 |
| MF | Arena | 25.32% | 74.26% | 0.580 |
| MF | Arena + judge | 13.40% | 31.31% | 0.802 |
| SW | Arena + judge | 23.21% | 36.04% | 0.759 |
| BERT | Arena + judge | 19.58% | 34.02% | 0.751 |
| Causal LLM | Arena + judge | 31.50% | 48.75% | 0.679 |
其中 CPT(50%) 对应的 MT Bench 分数约为 8.8,strong 的分数约为 9.3,所以“95% 的 GPT-4 分数”与“50% 的差距恢复”可以同时成立。
再看 MMLU。下面左边只有 Arena,右边补充约 1500 道 MMLU 验证集问题构造的标签。
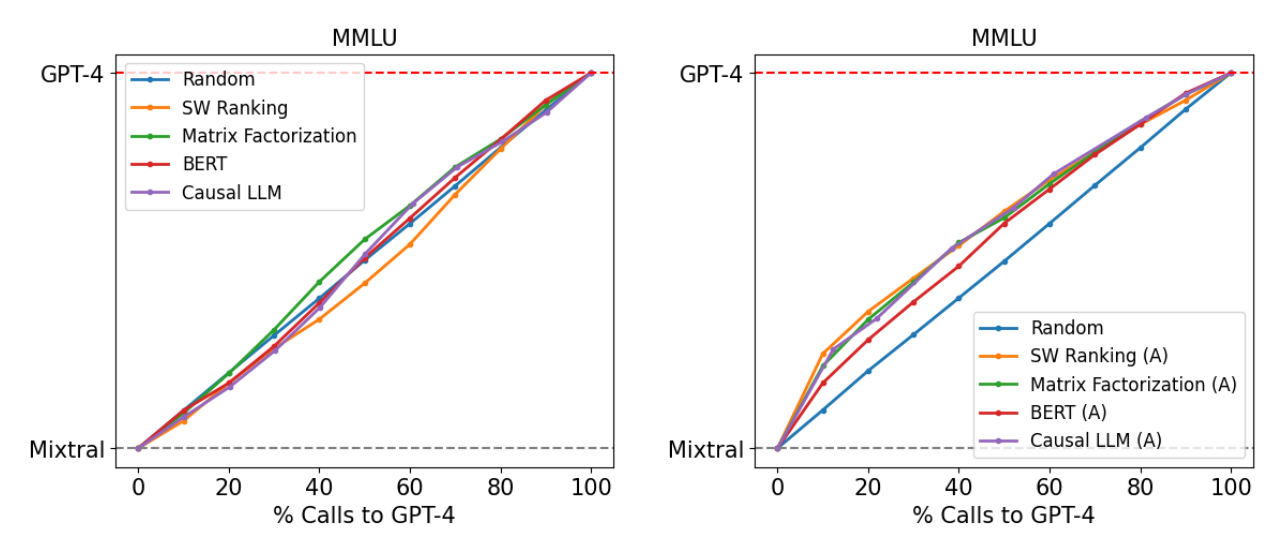
左侧几条线基本贴着随机走;右侧才拉开差距。MF 的 CPT(50%) 从 45.00% 降到 35.46%,但仍不像聊天任务那样只需 13.40%。不能把某个数据集上的省钱比例直接搬到另一个业务。
最后看 GSM8K,小学数学应用题评测。左边只有 Arena,右边加入 judge 数据。
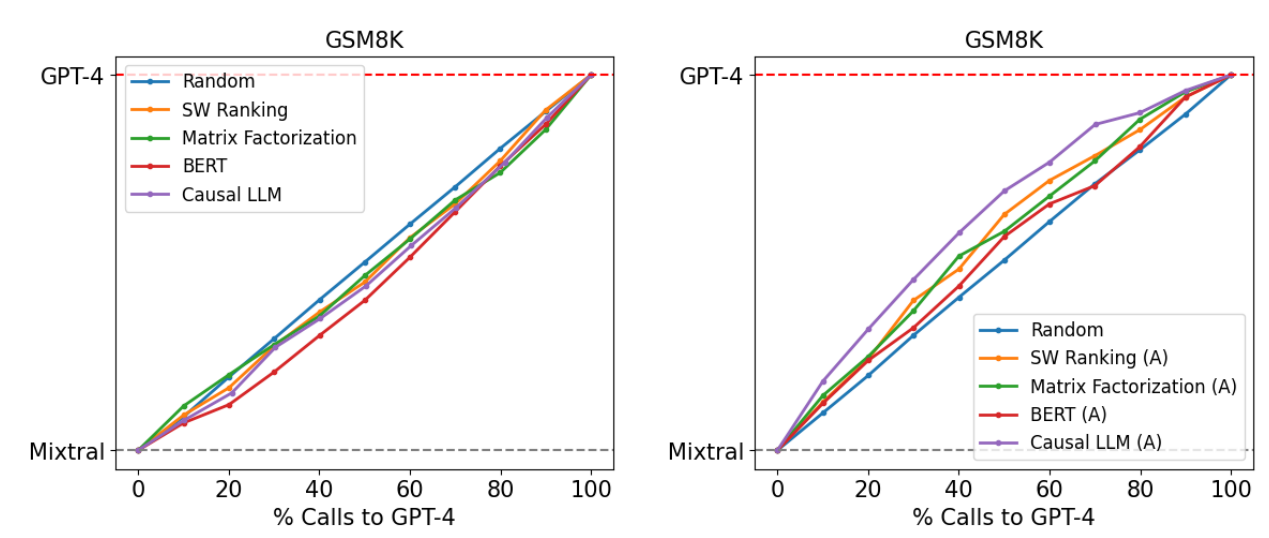
左侧几种方法大多低于随机;右侧 Causal LLM 的紫线表现最好。它的 CPT(50%) 为 33.64%,CPT(80%) 为 63.26%,APGR 为 0.622。MF 在这里的 APGR 为 0.565。
这说明不同方法的容量和偏置会影响不同任务,但更一致的现象是:router 有没有见过目标请求分布,比“它是不是更大的模型”更基础。
10.3 “3.66 倍省钱”需要把比较对象说完整
论文成本分析里的 3.66 倍,可以从 MT Bench 上的数字直接看出:
\[\frac{49.03\%}{13.40\%}\approx3.66.\]它比较的是:达到同样的 PGR=50% 时,随机路由与最佳 router 的 strong 调用比例。在 strong 费用占主导的假设下,换算为约 3.66 倍的成本改善。
因此不能把这个数字直接写成“相对全量调用 GPT-4,所有场景费用统一除以 3.66”。论文当时的费用估计约为 GPT-4 每百万 token 24.7 美元、Mixtral 0.24 美元,这些是历史实验假设,不是当前 API 报价。
11. 换一对模型仍然能用,但迁移的是查询排序能力
论文还测试了两组未在原训练数据里出现的回答模型:
- Claude 3 Opus / Claude 3 Sonnet。
- Llama 3.1 70B / Llama 3.1 8B。
不重新训练 router,仅替换最终选择的回答模型,仍然观察到有效的质量与成本权衡。
这个结果在代码里如何发生,需要讲清楚。
Controller 负责配置实际回答出口,例如新的 strong / weak API;MF 和 SW 内部则仍可以按原 GPT-4/Mixtral 对计算分数:
新问题
  → 原内部模型对的路由分数
  → 与阈值比较
  → 新 strong / 新 weak 出口
所以“能换模型对”不等于 MF 自动给任何新模型生成了一个能力向量。显式改内部打分模型时,MF 仍要求名称存在于模型 ID 表里,SW 则要求模型已存在于对应的 tier 映射中。
迁移成功,说明原分数对“哪些问题更需要强模型”的排序有一定共性。它不能证明原来 0.8 的分数,换到新模型对后仍然是准确的 80% 胜率。
11.1 用训练集相似度诊断分布差异
论文给了一个数据分布诊断指标:对每个测试问题,找训练集中最相似的问题,再对这些最大相似度取平均:
\[\mathcal S(B,D)= \frac1n\sum_{i=1}^n \max_{1\leq j\leq m} \cos(b_i,d_j).\]$B$ 和 $D$ 分别是测试问题集与训练问题集,$b_i,d_j$ 是文本向量。一次性写成矩阵是:
归一化测试向量 [n,1536]
  × 归一化训练向量转置 [1536,m]
  → 相似度 [n,m]
  → 每行 max [n]
  → mean []
比如 100 道测试题,65000 条训练比较,会得到 [100,65000] 的相似度矩阵。大数据时应分块计算,保留每行最大值即可,不需要把整个矩阵一直放在内存中。
原文中,Arena 与 MMLU 的这个指标为 0.4823,加入 gold 数据后变为 0.5678。它与路由表现改善相关,可以用来发现覆盖不足;它不是回答质量指标,也不能单独证明没有数据泄漏。
论文另用 embedding 相似度阈值 0.95 检查潜在污染,并移除命中的评测样本。加入的 MMLU 数据来自验证集,不应混成测试题。
12. 真正落地时,最后还要对齐三件事
12.1 router 自己也要花时间和钱
下面是原文测得的吞吐和成本。先对比每秒请求数,再看每百万请求的 router 成本;这些是特定硬件与实现下的测量,不是单请求延迟承诺。
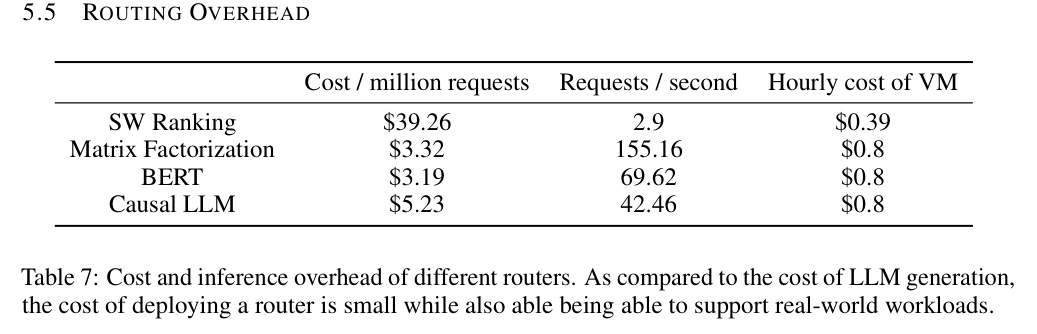
SW 约 2.9 requests/s,MF 约 155.16,BERT 约 69.62,Causal LLM 约 42.46。SW 的每百万请求成本约为 39.26 美元,MF 为 3.32 美元。
SW 没有离线神经网络训练,却在每次请求重新拟合,在线开销反而最大。MF 的小前向很便宜,但要把外部 embedding 的调用也算进去。这里的吞吐还受批处理、服务并发等影响,不能直接取倒数就当端到端延迟。
12.2 多轮对话中,路由看到的上下文可能比回答模型少
固定提交的 controller 用:
# routellm/controller.py
# class Controller
# def _get_routed_model_for_completion(...)
prompt = messages[-1]["content"]
它直接取最后一条消息的 content,没有把整段聊天历史拼给 router,也没有搜索“最后一条 user 消息”。选好模型后,完整 messages 仍会传给回答生成接口。
所以对“那刚才第二种方案呢?”这种请求,router 可能只看到这一小句,而回答模型能看到前文。理解输入输出时,这个边界比多记一个网络层名更重要。
12.3 先在自己的请求分布上确认,再决定用哪个 router
最值得先试的通常是 MF:实现简单,计算链路短,官方也推荐。随后应在自己的代表性问题上比较不同 strong 调用比例下的质量,而不是仅检查分类准确率。
只有当需要更强的文本表示,并且有足够贴近业务的偏好数据时,更大分类器的训练与部署开销才更容易合理化。新模型对、长上下文、不同语言或多轮对话,都需要重新确认分数排序与阈值。
13. 总结
RouteLLM 最容易被一句“训练一个模型,判断问题难不难”带过去。但沿着实际计算往下走,四种方法解决的是同一个接口问题,内部机制差得很大:
- SW 用问题相似度改变历史比赛的权重,在线重算一张局部排行榜。
- MF 把 1536 维问题向量投影到 128 维,与模型向量逐元素组合,最后用两个分数的差预测胜负。
- 发布的 BERT 类模型是 XLM-R 三分类,softmax 后取 strong 胜出那一类。
- Causal LLM 用五个新增评分 token 表达判断,在五档内部归一化后再聚合。
训练标签、模型分数、路由选择、最终答案,是四个不同的东西。 把它们的输入输出和维度分开,算法就没那么绕了。
从实验看,真正值得记住的也不只是 MT Bench 上的 13.40% strong 调用比例,而是同一个 router 换到学科题和数学题,效果就会明显变化。路由不是脱离数据分布的一套固定规则:它是在用历史比较,预测当前问题上多花钱有没有价值。
参考资料与代码核对
以下源码链接固定到本文核对的提交,方便后续对应实现;Hugging Face 链接也固定到配置版本。
- 论文 v4:方法、实验与附录。
- 四种 router、阈值比较与默认维度。
- SW 的 BT 拟合、平局处理与 tier 动态规划。
- MF 推理模型与模型 ID 表、MF 训练脚本。
- BERT/XLM-R 发布配置。
- Causal LLM 推理与评分聚合、发布模型配置。
- Controller:选择模型与保留完整 messages、公开分类器训练入口。
顺带一提,模型路由是在服务时决定“这次用哪个模型”,AutoML 则把类似的取舍往前移,研究模型架构、压缩和配置该怎么自动寻找。我们把后一个方向的积累整理进了《动手学 AutoML:从 NAS 到大语言模型优化实战》,其中包括 NAS 搜索、LLM 剪枝量化与模型融合,也有从零动手的实现。书里没有 RouteLLM 这套路由工程,关注的是另一侧的模型优化问题。
