arXiv'26 | RSI-Router:让 LLM Agent 的多模型路由不只省钱,还能越跑越会做
arXiv’26 | RSI-Router:让 LLM Agent 的多模型路由不只省钱,还能越跑越会做
原文:RSI-Router: Evolving Subtask-Level LLM Routing and Skills for Cost-Efficient Agents
作者:Hao Li 等,上海人工智能实验室。本文基于论文 v1(2026-09-28)整理;论文页未给出公开代码链接,文中实现细节均以作者披露的协议为准。
1. 一个 Agent 最贵的时刻,往往不是它把事情做错了
想象你让一个 coding agent 修一个 bug。它先读 repo,接着定位文件,再试一次 patch,跑测试,发现失败,继续翻日志,再改一次。最后成功与否先不说,光是这条轨迹就已经调用了十几次 LLM。
这时候最直觉的做法,是让最强的模型从头跑到尾:能力强,少翻车。但长程 agent task 的问题恰恰在这里——真正贵的不是“调用一次强模型”,而是把每一个很机械的小步骤,也都交给强模型。搜一个文件名、检查命令输出、跑一个针对性测试,这些活并不都需要最贵的脑子。
反过来,若把整件事交给小模型,账单确实好看,结果却很容易不好看。论文里 Qwen3.5-9B 单独执行 Terminal-Bench 2.0 的成功率只有 5.33%,而 DeepSeek-V4.1-Flash 是 40.00%。小模型不是不能干活,只是很难独立扛住一整条长轨迹里所有高难环节。
于是,多模型路由(multi-model routing)真正要解决的不是“省一点 token 钱”,而是一个更像组织问题的矛盾:不同模型各有擅长的工作,怎样让它们在同一个任务里接力,而不是二选一?
RSI-Router 这篇工作有意思的地方,是它不满足于训练一个“此刻该挑大模型还是小模型”的分类器。它把路由看成一个会积累经验的 agent 系统:能把任务切成子任务,能从失败轨迹里总结规则,还能不断修正“谁该做什么”。所以它的名字里有 RSI——recursive self-improvement,递归式自我改进。
先给结论:在作者选的五个 agent benchmark 上,RSI-Router 相比全程 DeepSeek-V4.1-Flash,性能均持平或更好,测试期推理成本下降 8.1% 到 82.2%。更值得讲的并不是这个数字,而是它怎么把“路由”从一次性的模型选择,变成了一套会长经验的分工机制。
2. 多模型路由不是挑模型,而是在给一条长任务拆工序
给定一个请求,系统手里有大模型 $L$ 和小模型 $S$:$L$ 能力更强、价格更高,$S$ 更便宜、但会在复杂推理或长链执行里掉队。路由器的职责,是决定每次该叫谁。
这个定义听上去简单,实际差别全在“每次”到底有多大。
任务级路由把整条请求当成一个整体:像 HybridLLM 看难度、RouteLLM 看模型偏好,最后给这个任务选一个模型;FrugalGPT 则像一道关卡,先调用便宜模型,置信度不够再级联到更贵的模型。它们解决的是一个很实际的问题:简单请求没必要用 GPT-5 级别的配置。
问题是,Agent 的任务不像一道单选题。修 bug 的“读代码—改代码—验证”的难度根本不是一个常数;购物 agent 的“搜索商品—过滤条件—确认结算”也一样。整件事对小模型过难,不代表其中每一步都过难。任务级方法一旦把一个任务判成难,就往往全程上大模型;判成简单,又可能把关键一步交错人。论文把这类现象叫作 routing collapse:看起来有路由,落到执行时却退化成“全大”或“全小”。
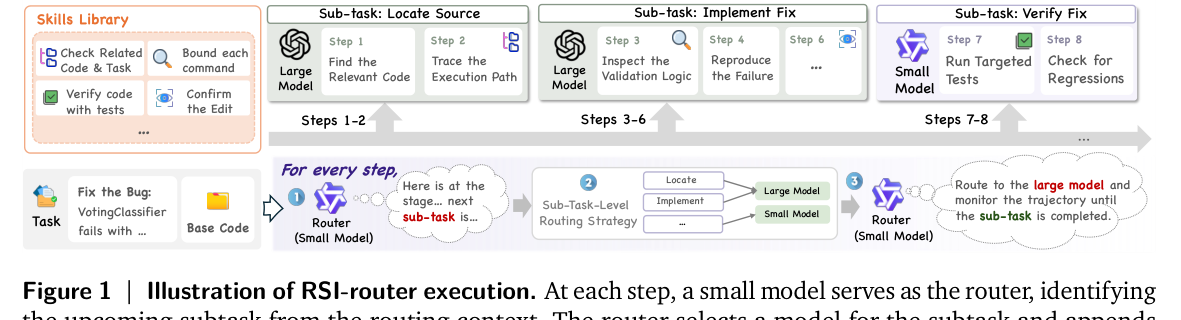
上图正好把这个差别画出来。读图时先看底部的一条任务轨迹:同一个“修 bug”请求,被分成 Locate Source、Implement Fix、Verify Fix 等子任务。中间那层是小模型 Router,它不亲自完成所有工作,而是判断下一个工序是什么,再按预先学到的分工把工作发给大模型或小模型。图里的大模型负责定位和实现,小模型接管验证。
这就是本文的粒度:子任务级路由(subtask-level routing)。它不是把每个 token 都做一次调度,也不是整件事只选一次模型,而是按“有稳定目标、可跨轨迹复用的一段工序”分配模型。把它类比成软件团队会更直观:不是让高级工程师全天候敲每一条 shell 命令,也不是让实习生独立接一个复杂需求,而是把排障、实现、回归各自交给更合适的人。
这个粒度也解释了为什么只让小模型“判断难不难”不够。难度是一个很模糊的标签;“此刻在定位源码”“此刻在复现失败”“此刻在跑回归”则是有操作语义的工作单元。论文的一个重要消融也很扎心:给 Qwen3.5-9B 同样的上下文、直接让它判断下一步难度并选择模型,五个 benchmark 的平均表现都不如 step-level random。模型显然不擅长凭空给自己估难度,但更擅长识别自己正在做的工序。
3. Related Work 其实在回答三件事:怎么分工、怎么进化、怎么让经验留下来
论文的 Related Work 没有简单罗列方法,而是沿着 RSI-Router 的三个部件来组织:LLM routing、self-evolving agents 与 agent skills。这个划分很重要,因为它也把本文的“新东西”讲清楚了。
3.1 路由方法:从整题选人,到每一步选人
第一条线是 LLM routing。任务级方法已经覆盖了难度估计、回答偏好预测、级联推理、模型表征预测、图匹配和 cluster 级性能—成本估计等路线。它们通常用一条 query 的质量、偏好或预测成功率做决策,评估时则画出质量—成本曲线,或者在“达到某个质量门槛”下比较最低成本。
面向多步推理和 Agent,近期方法开始把选择推到轨迹内部:MTRouter 从采样到的 trajectory 学模型选择;Router-R1 和 Budget-Aware Agentic Routing 用 reinforcement learning 优化策略;SWE-Router 观察部分 trace 后决定是否切换到更贵的模型;Agent-as-a-Router 与 Gated-Memory Routing 则把历史结果或选择性的历史记忆放回决策上下文。SkillOrchestra 更靠近本文:它从预先收集的轨迹里抽取 skills 来帮助路由。
RSI-Router 对这些工作的判断很克制:离线 trajectory 学习受已有数据覆盖限制;RL 要在每一步探索模型分配,成本高,而且最终成败的 credit assignment 很难。更关键的是,大多数路由把“模型能力”当成一个不变的常量——默认小模型能干什么、不能干什么已经定了。本文要动的正是这块:如果给小模型一条合适的操作规则,它能做的事会变;那路由本身也必须跟着重新学。
3.2 自我进化:反馈不该只用来改 prompt
第二条线是 self-evolving agents。GEPA、ACE 用执行反馈改 prompt 或 context;ADAS 搜索 agent program;Darwin Gödel Machine 直接修改 agent code,并维护候选方案的 archive;Meta-Harness、自进化 harness 以及 HarnessBank 等工作,则把改进对象扩大到 agent 的执行框架。
这些方法共同的出发点是:跑出来的结果不是一次性日志,而是下一轮设计的训练信号。RSI-Router 沿用了这个思路,但把进化对象换成了路由系统本身:哪些子任务存在、每个子任务谁做、给谁附加什么 skill,都要从前一轮执行结果里修订。
3.3 Skills:不是通用知识库,而是模型专属的操作说明书
第三条线是 agent skills。它们是从经验中蒸馏出的可复用 procedural knowledge——不是“Python 是什么”这类通识,而是“出现某种环境状态时,先检查什么、不要重复做什么、再执行哪一步”的操作规则。已有工作做 skill 的提取、检索、编排,或训练 agent 把 skill 内化。
RSI-Router 的关键取舍是:skill 不绑定抽象任务,而绑定 subtask–model pair。同一条建议对大模型可能是多余的,对小模型却能显著补短板;反过来也一样。论文中有一句很短的话把这个意思说透了:“their benefits vary across models”。技能不是万能外挂,它能不能带来收益,取决于给谁、在什么工序、以什么方式挂上去。
4. RSI-Router 的核心:分出工序,试出分工,把踩坑变成可复用 skill
这套方法分成训练期的演化和测试期的执行两部分。测试期其实很轻:小模型做 Router,根据上下文识别下一个子任务,选择被分配的执行模型,只把匹配的 skill 文本拼到该模型输入里。真正复杂的是前面的演化过程。
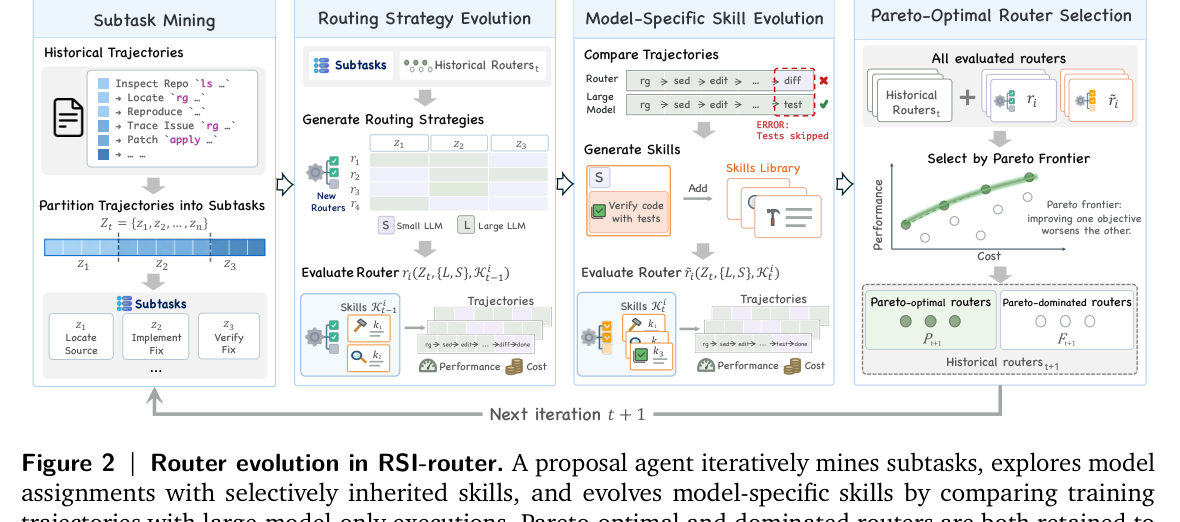
这张图建议从左向右看。最左边不是神秘的初始化,而是一批历史轨迹:大模型单独执行、小模型单独执行,以及此前候选路由器留下的执行记录。中间三栏是生成和验证,最右一栏是选择;底部箭头又把结果送回下一轮。它不是只挑出一个“冠军策略”,而是在维护一个不断更新的 router population。
4.1 第一步:Subtask Mining,把长轨迹切成能被提前识别的工序
在第 $t$ 轮,proposal agent 先读训练轨迹,按执行目标切段,再把跨轨迹相似的段聚成子任务集合 $Z_t$。比如修代码可以自然分出 Locate Source、Implement Fix、Verify Fix。每个子任务不只有名字,还要有定义和 identification rule:在真正执行之前,Router 应该根据什么证据判断“接下来是它”。
这里有个很容易被忽略的约束:子任务必须在执行前识别出来。作者会 replay 一部分训练轨迹,让小模型只看 user query、最近几步 interaction history 和上一轮预测的子任务标签,去预测下一步标签;proposal agent 再根据标注修订模糊规则。不能提前识别的标签,做得再细也无法拿来在线路由。
第二轮开始,这套工序表不是冻结的。旧子任务可以被保留、拆开、合并,识别规则也随之变化。说白了,系统先学会“怎么描述工作”,再学“谁更适合做这份工作”。
4.2 第二步:Routing Strategy Evolution,不押一把,而是并行试多种分工
有了 $Z_t$,proposal agent 每轮生成 $N$ 个不同的 routing strategy。每个 strategy 给每个子任务指定执行模型,还会从历史 skill library 中挑选与当前子任务定义、模型分配相符的 skills。论文用的是 $N=4$:不是单线往前爬,而是一轮保留四种成本—性能取舍。
候选 router 会同时在 train 和 validation 任务上跑。训练集的完整 trajectory 与逐任务 feedback 可被拿去继续反思;validation 则主要负责守住泛化,不让系统只对自己见过的失败轨迹背答案。
这个设计比“让模型即时挑模型”多了一层很工程化的约束:一次决策不是只看这个 step 的局部 reward,而是看这套分工能否在一批任务上稳定成立。
4.3 第三步:Model-Specific Skill Evolution,真正把失败日志变成操作手册
这是本文最有辨识度的地方。对于每个候选 router $r_i$,系统把它在训练任务上的轨迹,与同一任务中大模型单独执行的轨迹 $r_L$ 对齐比较。比较的不是一句“成功/失败”,而是模型在什么子任务失败、绕了什么路、产生了哪些 redundant actions。
若小模型在“放置物体”时失败,大模型的轨迹却表明它漏掉了环境状态检查,proposal agent 就把这种差异蒸馏成可复用的执行 skill;若旧 skill 已经不适配拆分后的子任务,也会被修订。更新后得到 $\tilde r_i$,子任务和模型分工不变,只重跑评估来测 skill 的净效果。
这里可以把 skill 想成给不同同事写的 runbook。同一句“先跑测试”对资深工程师没有帮助,对一个总是忽略回归范围的初级执行者却可能非常关键。但 runbook 写得太长、太死,也会让人变慢甚至做错;后面的消融实验正好证明了这一点。
4.4 第四步:Pareto Selection,保留好方案,也保留坏方案
每轮结束,所有历史 router、当前策略、skill 更新后的策略,一起按 validation performance 和 cost 做 Pareto 筛选。所谓 Pareto frontier,可以理解成“再省钱就会更差、再提分就会更贵”的那条边界:如果一个 router 在性能不低于另一个的同时成本也不高于另一个,它就支配后者。
非支配 router 进入 $\mathcal{P}{t+1}$,被支配的进入 archive $\mathcal{F}{t+1}$。离谱但很有效的一点是,后者并不删掉。坏策略会作为 negative example 留给下一轮 proposal agent,也会让系统知道“这类分工以前试过,为什么不行”。论文的表达是:“retaining dominated routers as experience”。
这比只保留 best checkpoint 更像真实工程迭代。踩坑不是垃圾;只要坑里记录了失败原因,它就是下一轮搜索的护栏。
5. 从论文到系统:在线路由很轻,离线演化才是重活
论文在五个 benchmark 里固定使用 DeepSeek-V4.1-Flash 作为大模型 $L$,Qwen3.5-9B 作为小模型 $S$。执行 harness 建在 mini-SWE-agent 上,再针对家庭环境交互、科学实验、在线购物、代码修复与 terminal 操作适配工具环境。proposal agent 用 Codex;每次在线识别子任务时,Router 看 user query、前 3 步交互记录、上一子任务预测。
最终在线执行的路径可以压缩成四步:
- 小模型 Router 根据上下文与 $Z_t$ 的识别规则,预测下一子任务;
- 查当前 router 给该子任务指定的是 $L$ 还是 $S$;
- 只检索这个“子任务 + 被选模型”对应的 skills,并拼进执行模型输入;
- 调用执行模型,拿到工具调用或自然语言输出,再进入下一步。
重点是第 3 步的“只”。如果把历史 skill 全塞进上下文,省下来的执行成本很容易被 prompt 本身吃掉,模型还可能被相互矛盾的经验干扰。RSI-Router 的 library 是共享的,但注入是选择性的。
离线阶段更像一个小型 AutoML loop。初始 population 是无 skill 的全大模型 router $r_L$ 和全小模型 router $r_S$;作者跑 $G=6$ 轮,每轮提议 4 个策略。训练、验证、测试集完全分开:ALFWorld、ScienceWorld、WebShop 各有 64 个任务/划分;SWE-bench Verified 是 32 个;Terminal-Bench 2.0 为 32/32/25。训练集才提供 trajectory 和逐样本 feedback,validation 只用聚合性能/成本来选 Pareto population,最后才碰 test。
这套隔离很重要。否则系统很容易在同一批失败样本上不断写“经验总结”,最后测到的只是一份越来越精致的答案册。
不过也要把可复现性说清楚:截至本文整理时,论文页没有代码仓库链接,以精确标题检索 GitHub 也未发现官方实现。因此这里能复述的是执行 harness、模型选择、迭代轮数、上下文窗口和评估协议;proposal prompt、skill 的具体文本格式、数据处理细节仍需要作者开源后才能逐行核验。
6. 怎么评测才不把“省钱”说成玄学
这类论文最容易犯的错误,是只报一个“成本下降 70%”,却不交代是不是同时把任务做坏了。RSI-Router 的评估至少把这件事讲清了。
五个 benchmark 分别覆盖:ALFWorld 的家庭环境操作、ScienceWorld 的科学实验、WebShop 的在线购物、SWE-bench Verified 的 repo 修复,以及 Terminal-Bench 2.0 的终端操作。除 WebShop 用 0 到 1 的 reward 外,其他四个报告 task success rate;也就是说,前者衡量购物轨迹的最终奖励,后者衡量任务成功的比例,二者不能直接混着读。
成本按美元报告:DeepSeek-V4.1-Flash 使用官方 input/output 价格;Qwen3.5-9B 的价格则由 H200 GPU-hour 测量给出的 1:30 参考比率估计。所有测试期 LLM 调用都计入,包括 Router 判断子任务、附加 skill 造成的上下文 token,以及真正执行的调用。每个 test task 跑三次取平均;有学习过程的 baseline 还跨三个 training seed 取平均。
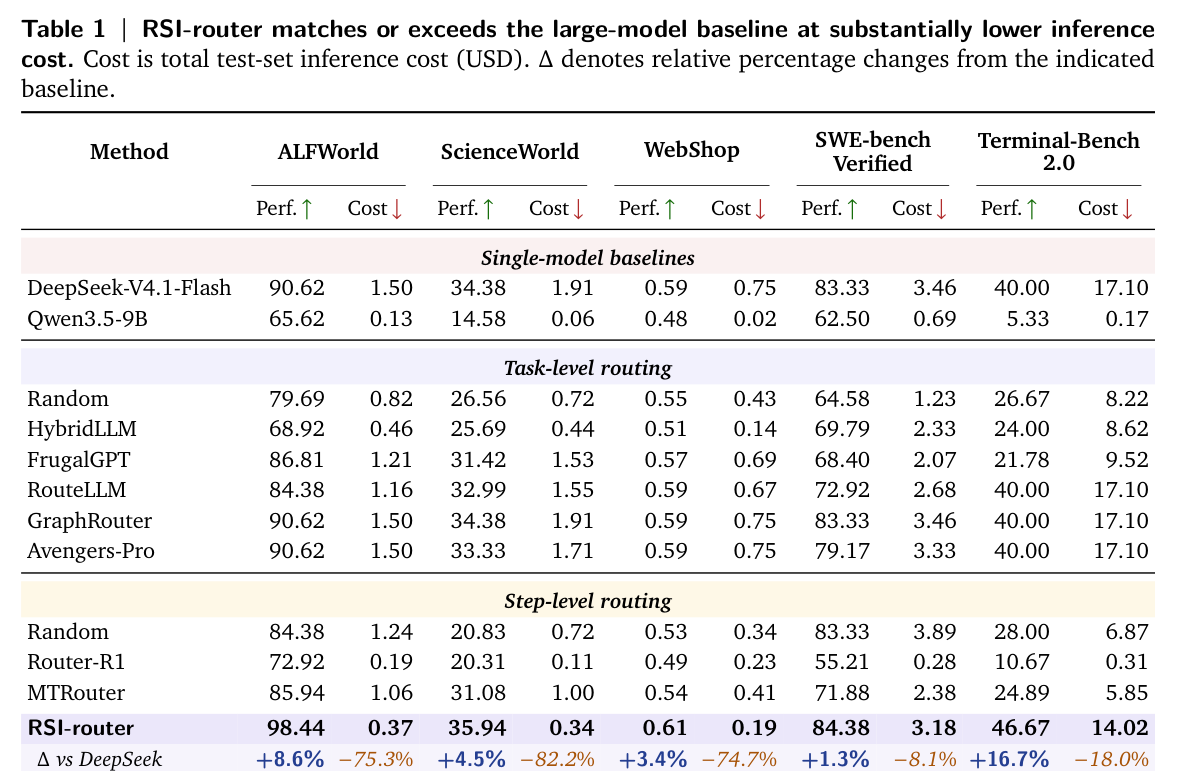
这张主结果表的阅读方式是:每个 benchmark 有一列表现、一列 test-set 总成本;上半部分是单模型和任务级路由,下半部分是 step-level routing,最后一行才是 RSI-Router。不要只盯着紫色最后一行的成本。更关键的是,它在五个数据集上都高于 DeepSeek-only 的表现线,而不是靠牺牲成功率买到便宜。
| Benchmark | DeepSeek-only | RSI-Router | 对大模型表现变化 | 对大模型成本变化 |
|---|---|---|---|---|
| ALFWorld(成功率) | 90.62 / $1.50 | 98.44 / $0.37 | +8.6% | -75.3% |
| ScienceWorld(成功率) | 34.38 / $1.91 | 35.94 / $0.34 | +4.5% | -82.2% |
| WebShop(reward) | 0.59 / $0.75 | 0.61 / $0.19 | +3.4% | -74.7% |
| SWE-bench Verified(成功率) | 83.33 / $3.46 | 84.38 / $3.18 | +1.3% | -8.1% |
| Terminal-Bench 2.0(成功率) | 40.00 / $17.10 | 46.67 / $14.02 | +16.7% | -18.0% |
表里 “$a / $b” 分别表示性能和测试集成本。最值得停一下的是两端:ScienceWorld 从 $1.91 降到 $0.34,同时 34.38% 升到 35.94%;而 SWE-bench Verified 只省了 8.1%。这说明多模型协作不是一个到处 80% 折扣的魔法。任务的工具环境、长轨迹结构、各子任务的能力差异,决定了小模型到底有没有足够多能安全接手的工序。
论文为了做公平对比,还有一个很容易被漏掉的规则:对能产生多个 routing strategy 的方法,它不随便挑一个点,而是在性能至少达到 DeepSeek-only的策略中,报告最低成本。这避免了某个 baseline 故意走极低成本、但已经明显掉分的点来“赢”成本。
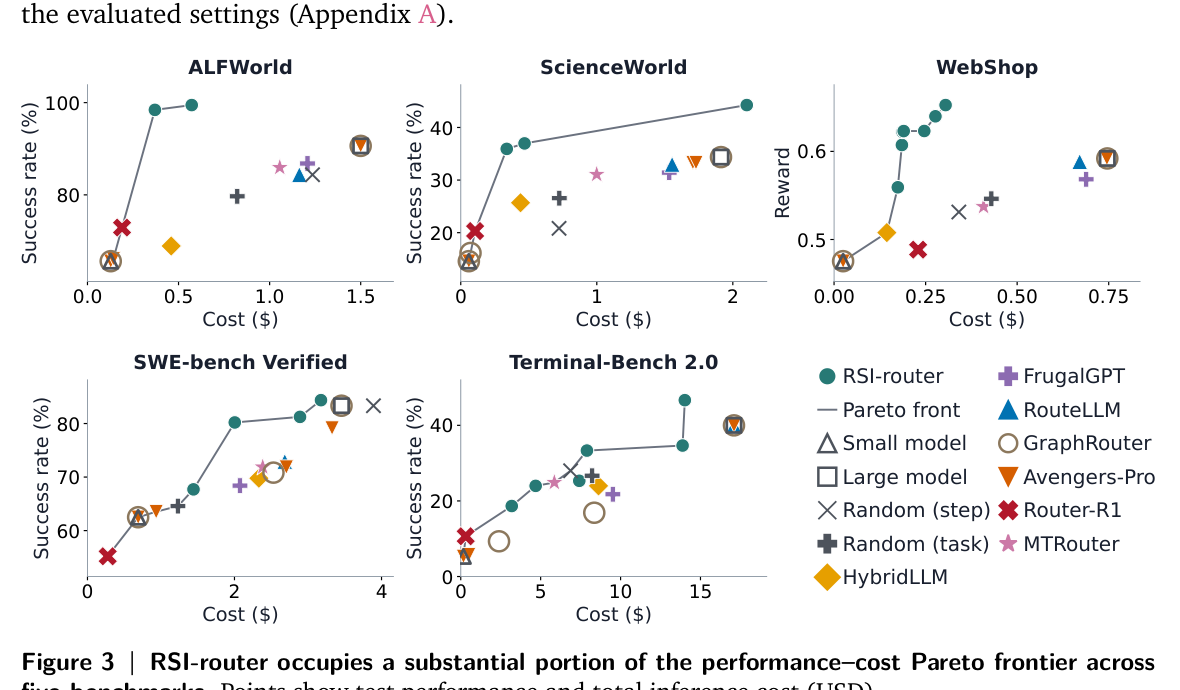
这张散点图把刚才被表格压扁的信息摊开了。读图时每个点是一种已评估策略,横轴成本越左越好,纵轴性能越高越好;能同时向左上推进的点才真正有意义。深绿色点是 RSI-Router,多数 benchmark 上它们连成了 Pareto frontier 的很大一段。任务级 router 的不少点会突然跳到全小或全大,step-level 的 Router-R1、MTRouter 虽然能把成本拉下去,但在作者的设定下,没有一个点在五个数据集上达到大模型的表现线。
7. “会进化”到底有没有证据:不是只跑得久,而是每轮真的学到了东西
只报最终最优值,还不足以证明 recursive self-improvement 有意义。作者又给了三组更有解释力的证据。
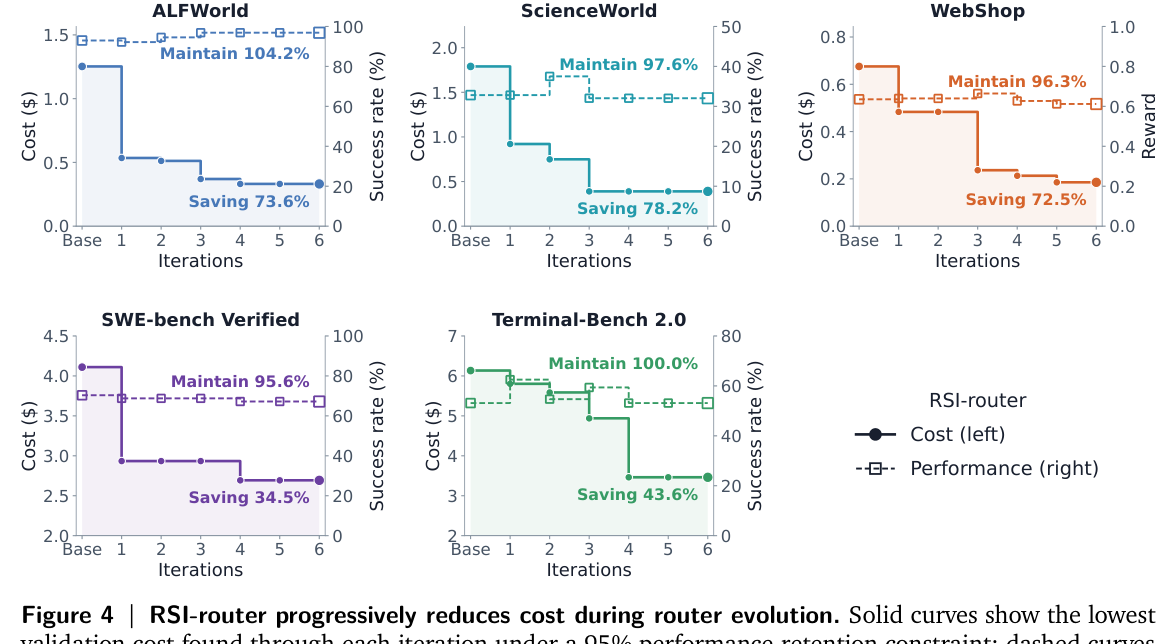
先看这张演化曲线。实线是每一轮中、在至少保留大模型 95% 性能的约束下,找到的最低 validation cost;虚线是相应性能。WebShop 的例子尤其直观:第一轮只省下 28.5%,后续继续降到 65.0%、68.4%、72.5%。这不是一次搜索碰巧找了个便宜点,而是有后续迭代带来的边际发现。
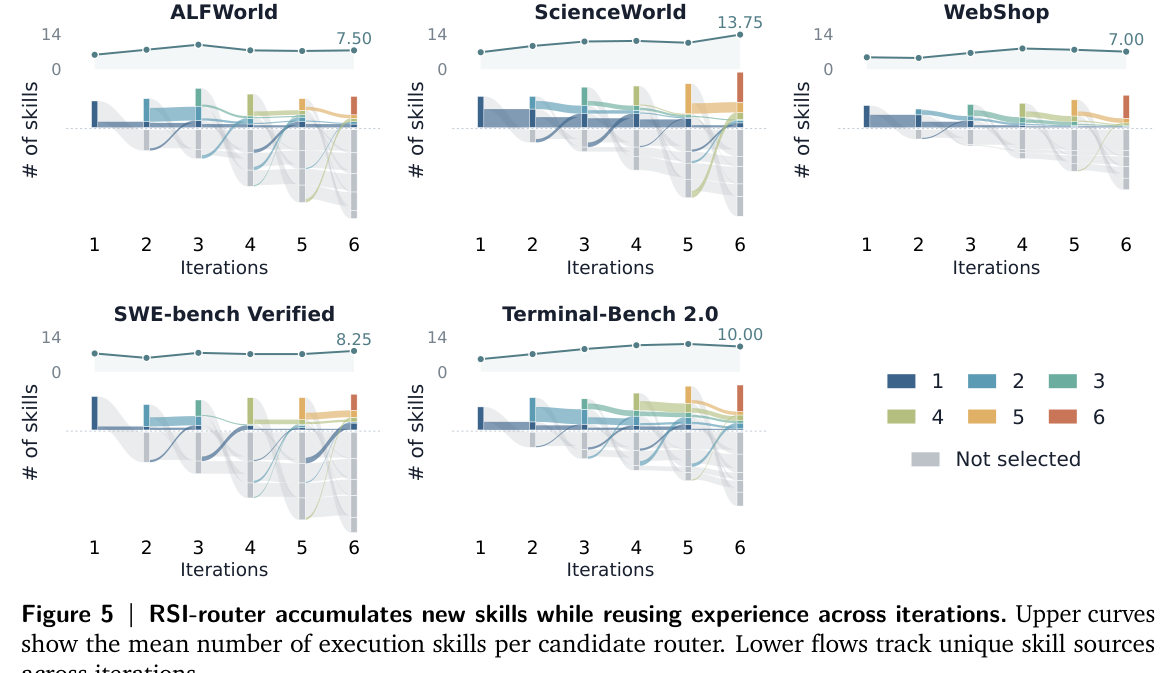
第二张图看 skill 的来源。上面的线是每个候选 router 平均携带多少 execution skills,下面的流线记录这些 skills 首次出现在哪一轮、后面是否继续被挑中。ScienceWorld 最后一轮四个候选里共选出的 48 个独特 skill 来源中,有 22 个来自更早的迭代。经验不是每轮清空重写,而是像一套逐渐长出来的 runbook。
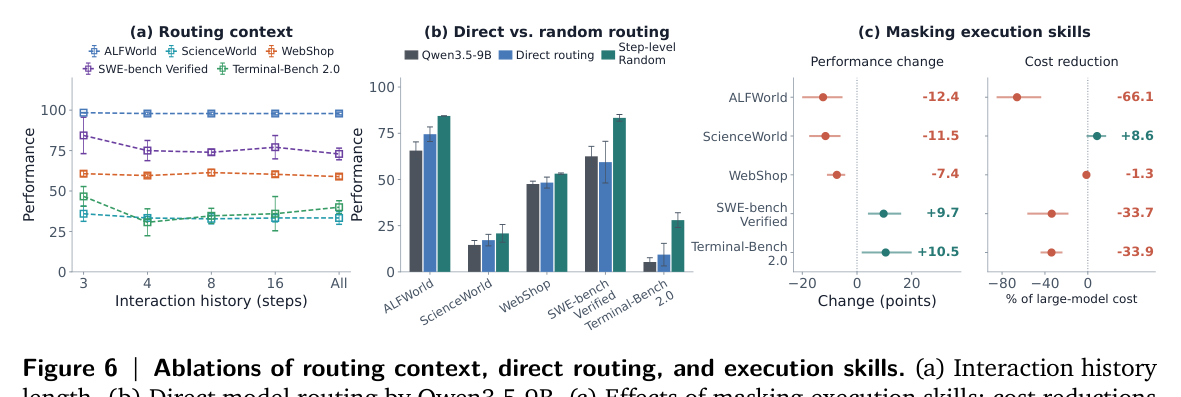
第三张是最应该读的消融。它给出的结论并不都顺着“组件越多越好”的直觉走:
- 把 Router 的 history 从 3 步拉长到 4、8、16,甚至全部历史,五个 benchmark 的表现都没有提升。短上下文已经够识别工序,更多上下文反而不是免费午餐。
- 直接让小模型根据难度挑执行模型,五个 benchmark 的均值低于 step-level random。前面讲的“难度标签太虚、子任务标签更可操作”得到了实证支持。
- 去掉 execution skills 后,ALFWorld、ScienceWorld、WebShop 分别掉 12.4、11.5、7.4 个点;但 SWE-bench Verified 和 Terminal-Bench 2.0 的表现反而升 9.7、10.5 个点,同时成本相对全大模型多出 33.7%、33.9%。
最后一条尤其重要:skill 不是只会提分,它改变的是性能—成本的交易方式。在 coding/terminal 这类任务上,skill 可能让模型更节制地执行,从而更便宜;拿掉它后,系统愿意烧更多大模型调用来买更高成功率。把所有收益总结成“skills 有用”就太粗了,正确说法应该是:它让每个 subtask–model pair 的有效能力与行为成本一起发生变化。
8. 这篇工作的边界,也正是下一步最难做的地方
第一,论文只验证了一对大—小模型:DeepSeek-V4.1-Flash 与 Qwen3.5-9B。两者的能力断层、工具使用偏好和价格差,对子任务划分都很关键。换成三四个模型、混入不同 provider、模型版本频繁变化时,Router 如何处理能力漂移、价格波动和 API failure,仍没有答案。
第二,成本报告是严谨的 test-time inference cost,但离线演化本身也要 proposal agent 读轨迹、生成策略、反复执行候选;论文没有把这部分改进开销摊销进一个端到端 TCO。对于反复执行同类任务的大规模业务,离线成本可能很快被摊平;对一次性任务或任务分布变化极快的场景,先花钱“养出” Router 是否划算,需要单独算账。
第三,skill 的生成质量和可审计性还很关键。论文已经证明某些任务中拿掉 skill 反而会更高分但更贵,这说明 skill 不是客观真理,而是一种策略性约束。未来系统若进入有安全边界的生产环境,skill 的版本、适用范围、冲突检测和回滚机制,不能只靠自然语言 prompt 管。
第四,公开实现尚未出现。这不否定论文的实验,但会限制可复现性:proposal prompt、skill 具体样例、tool harness 的细节、成本估计的工程实现,都需要代码或更完整 appendix 才能严谨复查。这里尤其不该把论文里的机制图,误读成已经开箱即用的 production router。
9. 总结:真正值钱的不是把小模型塞进流程,而是知道什么时候该让它接班
RSI-Router 的价值不在于发明了一种“更聪明的选模型按钮”。它把多模型 Agent 当成一个需要持续组织的协作系统:先用可识别的子任务描述工作,再用候选策略探索分工,用大模型轨迹诊断小模型在哪儿掉队,把诊断写成模型专属 skills,最后用 Pareto frontier 守住性能—成本边界。
这条路线有点像把一个 agent 从“单兵作战”改造成“有工序、有 SOP、会复盘的小团队”。最强模型不再被迫承担每一件琐事,小模型也不再被丢进一个超出能力范围的长任务里自生自灭。
对实际做 agent 系统的人来说,最值得带走的结论很简单:成本优化不是把更多步骤丢给小模型,而是把每一步变成小模型真正能可靠接住的工作。
顺带一提,这篇文章和《动手学 AutoML:从 NAS 到大语言模型优化实战》的关系是相邻而不是重合:书里并不讲 RSI-Router 这套 agent routing 工程,但模型选择、搜索与性能—成本 trade-off 背后的思路是相通的。书中第 9 章讨论 LLM 驱动的 AutoML 与 LLM Agent + AutoML,第 8、11 章也覆盖 LLM 压缩和后训练剪枝这些同样绕不开的资源约束。

本文根据论文公开内容重新表述和整理;图片均引自原论文 RSI-Router。