ICML26|RandOpt:基于预训练权重不用 RL ,随机猜也能后训练出强 LLM
ICML26|RandOpt:基于预训练权重不用 RL ,随机猜也能后训练出强 LLM
原文:Neural Thickets: Diverse Task Experts Are Dense Around Pretrained Weights(ICML26 Spotlight)
1. 后训练到底在做什么:从一句”随机猜不可能 work”的旧论断说起
2001 年 Schmidhuber、Hochreiter、Bengio 有一句被反复引用的话:“随机猜不能算是一种合理的学习算法。” 道理很直白——你要靠纯随机去撞出一个十亿维、行为像 ChatGPT 的参数向量,概率小到可以忽略不计。这个直觉几乎刻在每个做深度学习的人脑子里:参数空间太大,不用梯度这种”结构化搜索”根本找不到好解。
这篇论文想掰扯的,恰恰是这句旧论断在预训练之后是不是还成立。
先把今天的痛点摆出来。现在把一个 base model(基础模型,指预训练完、还没针对具体任务调过的那个模型)调成”更会做数学题/更会写代码/更听话”的过程,叫 post-training(后训练)。主流做法是 RL(强化学习)那一套,典型就是 PPO 和 GRPO——PPO(Proximal Policy Optimization)要同时维护一个 policy 模型、一个 critic 评价网络和一个 reference 参考模型,用带裁剪的目标函数一步步更新;GRPO(Group Relative Policy Optimization)砍掉了 critic,用一组回答的组内相对奖励来估优势,省点显存。但它们有个共同的工程特征:要跑几百个前后依赖的 sequential update step(论文里 PPO 跑 600 步、GRPO 跑 200 步),每一步都要反向传播、要维护额外的模型、要在多卡之间同步梯度。换句话说,后训练在工程上一点都不轻。
这篇论文给出的”反常识”结论是:预训练之后,在权重附近随机猜,居然 work。 具体说,给预训练好的大模型的权重加一批随机扰动,就能采样到一批在下游任务上明显变强的模型——不做任何梯度更新。Schmidhuber 他们当年其实也观察到随机猜能解当时的一些 benchmark,但他们把这解读成”benchmark 太水”。这篇则在当下真正有实用价值的场景(LLM 在推理、编程等任务上的后训练)里复现了同一现象,并把它当成一个值得认真对待的信号。
为什么随机猜能 work?关键只有一句话:好解必须在采样分布下足够”密”。 如果在预训练权重周围一个高斯球里,随手一撒就有不低的概率撞到”比原模型更强”的点,那随机猜当然就不再是碰运气。这篇论文的核心发现就是:在足够大、预训练足够充分的模型周围,各具专长的 task expert(任务专家,指只在某个具体任务上表现突出的那一组权重)密集地分布在预训练权重附近。作者给这片”又密又杂的解”起了个名字——Neural Thickets(神经灌木丛)。
这件事如果成立,意义不只是”又多了一种后训练方法”:
- 工程上:随机猜天然是 embarrassingly parallel(彻底可并行)的。N 个扰动互不依赖,可以同时在 N 台机器上评估,训练的 wall-clock(墙上时钟时间,即你实际等待的时间)从 RL 的 $\mathcal{O}(T)$(T 个串行步)压到 $\mathcal{O}(1)$(一步)。而且各个 worker 之间几乎不用通信,天然适合去中心化、甚至联邦学习的场景。
- 认知上:我们习惯把”预训练模型”当成一个确定的点——the base model。这篇把它重新理解成一个分布:预训练权重只是这个分布的均值,而它真正的内容是周围那一大片性格各异的专才。
- 方法论上:它顺手给”为什么 PPO/GRPO/ES 这些差别很大的方法,最后效果都差不多”提供了一个解释——一旦进入 thicket regime,用什么搜索算法都无所谓,因为好解到处都是。
想清楚动机之后,后面的顺序就很自然:先把”密”和”杂”这两个现象讲扎实(第 2、3 节),再用一个最小实验看看 thicket 是怎么长出来的(第 4 节),然后才是具体方法 RandOpt(第 5 节)、它的源码实现(第 6 节),最后是和 RL 基线的硬碰硬对比(第 7 节往后)。
2. 先看现象:预训练权重附近是”针尖”还是”灌木丛”
论文开篇用一张示意图把整篇的 insight 先立住了。怎么读这张图:左右两块对比的是小模型和大模型各自的”权重空间”(weight space,就是把所有参数拉平成一个高维向量后所在的空间),黑色五角星是预训练权重,虚线圆圈是随机扰动能够到的”高斯搜索窗口”,彩色小块是”能把某个任务做好的那组权重”。
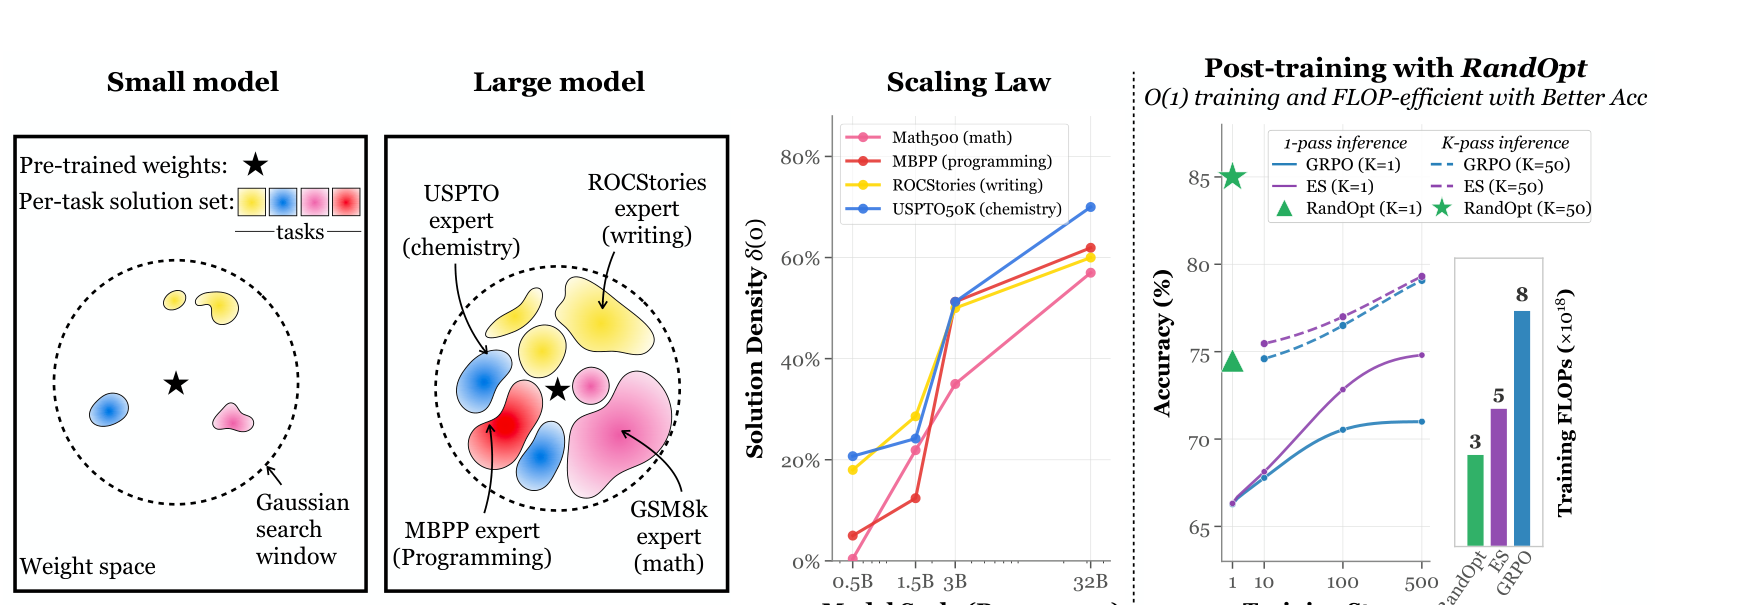
对着图走一遍:左边小模型里,彩色小块零零散散、面积极小,预训练权重(星)孤零零地待在一片”没什么好解”的区域里——这就是 needle in a haystack(大海捞针)regime,想找到那几个针尖般的好解,必须靠梯度下降这类”聪明”的结构化搜索。右边大模型完全是另一幅景象:星星周围被一大片彩色区域包住,USPTO(化学)、ROCStories(写作)、MBPP(编程)、GSM8k(数学)各自的专家区连成一片灌木丛——这就是 thicket regime,在这里随手一撒就能撞到某个专家区,撞到之后再把它们集成起来,就能得到很强的整体行为,这套”撒点 + 集成”就是作者要讲的 RandOpt。最右边两个小图顺带剧透了结论:随模型变大,solution density(好解的密度)在涨;而 RandOpt 在训练步数上是 $\mathcal{O}(1)$、更省 FLOP,收敛精度还能跟 GRPO、ES 掰手腕。
示意图是手画的,得有真实数据撑着才算数。为了量化”密度”,论文定义了 solution density(解密度) $\delta(m)$:在预训练权重 $\boldsymbol{\theta}$ 周围撒一个高斯扰动 $\boldsymbol{\epsilon}$,它把模型得分至少抬高 $m$ 的概率有多大:
\[\delta(m)=\mathbb{P}_{\boldsymbol{\epsilon}\sim\mathcal{N}(\mathbf{0},\sigma^{2}\mathbf{I})}\left[s(\boldsymbol{\theta}+\boldsymbol{\epsilon})\geq s(\boldsymbol{\theta})+m\right]\]这里 $s(\cdot)$ 是任务得分函数(比如准确率),$\sigma$ 控制高斯球的大小(这一节实验用 $\sigma=0.005$)。直白点说,$\delta(m)$ 就是”随机猜的命中率”——周围有多大比例的点,能让性能至少涨 $m$。
接下来是真实数据版。下面这张图把 Qwen2.5 从 0.5B 到 32B 四个尺寸、在几个推理任务上的”准确率地形图”画了出来。怎么读:每一行是一个模型尺寸(从上到下 0.5B、3B、7B、32B),每一列是一个任务(Pretrain NLL、GSM8K、Countdown、OlyBench,最后一列是 RGB 合成);颜色表示相对预训练模型的准确率变化,蓝色是变差、白色是持平、红色是变好;黑色星是预训练权重,黄色星是最好的那个扰动,虚线圆是平均扰动距离。
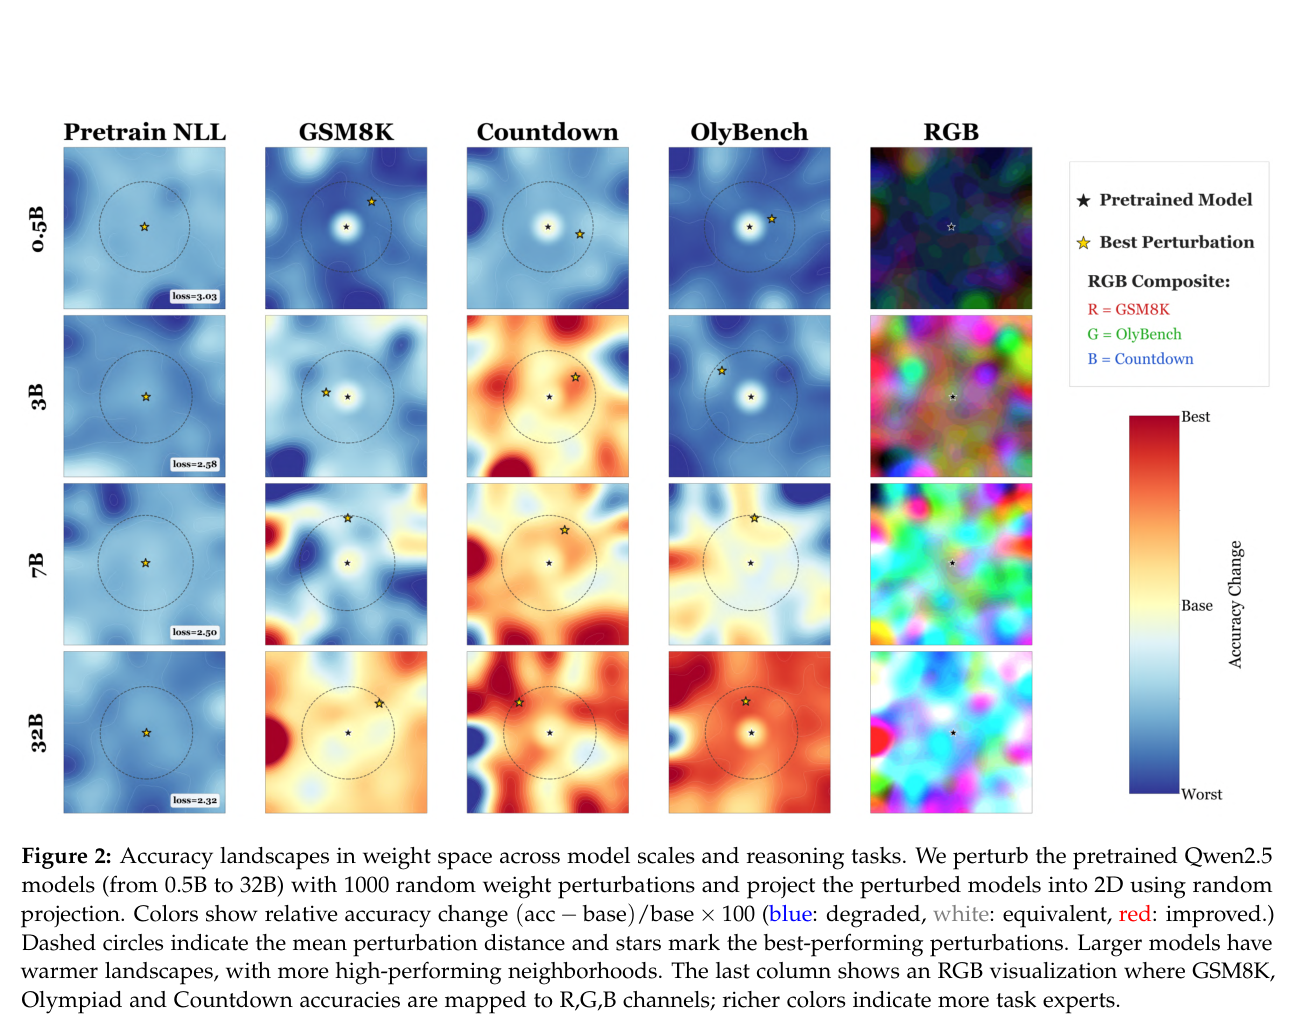
对着图从上往下看,会看到一个很明显的”地形翻转”:最上面的 0.5B,星星基本坐在一小片白色/浅色的局部高点上,周围一圈都是蓝的——小模型就在准确率的山顶上,往哪个方向扰动都变差。往下到 7B、32B,画面整个”变暖”了,星星反而落在一片偏蓝的”山谷”里,但四周散布着大量红色的高准确率峰——大模型自己不在最高点,可它周围却围着一圈比它更强的解。最后一列 RGB 把 GSM8K、OlyBench、Countdown 三个任务的准确率分别映射到红绿蓝三个通道,小模型那格几乎是灰黑的(到处没好解),大模型那格五彩斑斓(不同区域擅长不同任务)——这个”花花绿绿”后面第 3 节还要用到。
把 $\delta(m)$ 对模型尺寸画出来,就是一条清清楚楚的 scaling law。下图左边两格是 solution density 随尺寸的变化(GSM8K 和 Countdown),不同颜色对应不同的提升阈值 $m$。
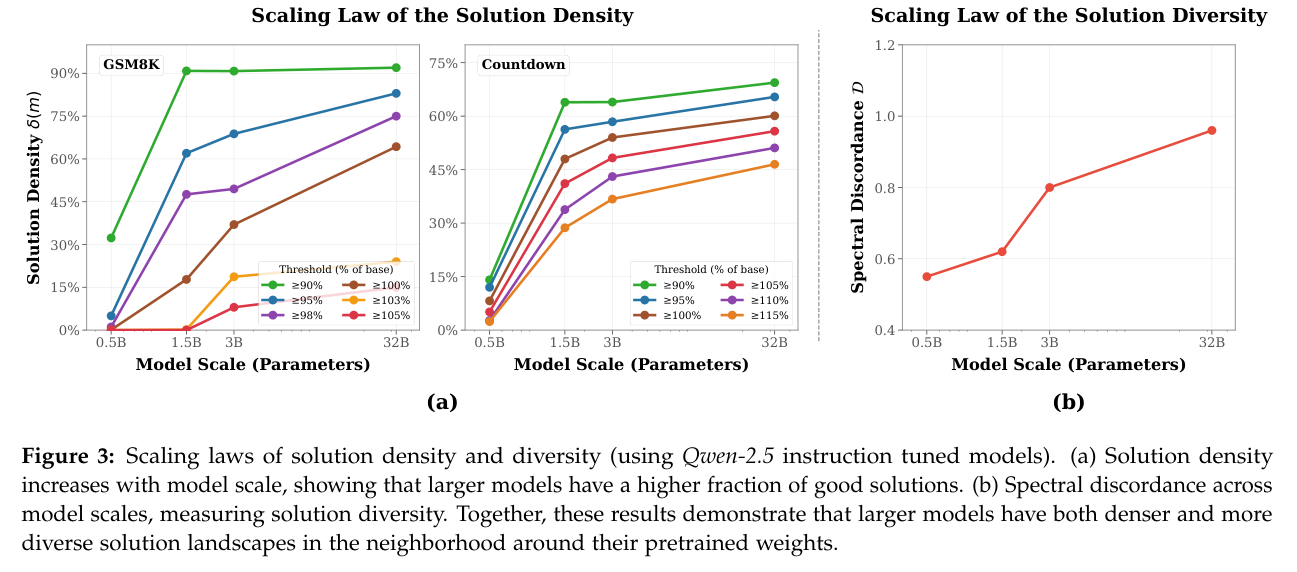
走读左半边:无论阈值取多严(比如要求”至少涨到基线的 103%、105%”这种苛刻档位),density 都随模型变大而单调上升。GSM8K 上,要求”至少达到基线 90%”的那条绿线,从 0.5B 的约 32% 一路涨到 32B 的 90% 以上;Countdown 上也是同样的趋势。附录里还有更极端的数字:“能追平或超过基线”的扰动比例,在 GSM8K 上随尺寸从 0% 涨到 64%,在 Countdown 上从 8% 涨到 60%。 到了大模型这一端,随机撒一个扰动有过半概率不输给原模型——这就是为什么”随机猜”在大模型上不再是碰运气。
这条密度曲线,就是”针尖 → 灌木丛”转变的量化证据:小模型停在 needle-in-haystack regime,大模型进入了 thicket regime。
3. 不只是”密”,还很”杂”:这些解是专才不是通才
密度解决了”随机猜能不能撞到好解”,但还有个更关键的问题决定了方法该怎么设计:撞到的这些解,彼此是一回事吗?
有两种可能。假设一(通才论):预训练权重其实是个平庸的点,附近存在一个”样样都更好”的全能模型,所有有益的扰动其实都在往同一个方向改进。假设二(专才论):预训练权重是个”样样通、样样松”的 jack of all trades,而附近的扰动各有偏科——某个扰动把数学做好了,但同时把化学做差了。这两种情况下,正确的策略完全不同:如果是通才,那就该老老实实找那个全局最优点;如果是专才,那就该撒一批互补的专才,再把它们的长处集成起来。
为了判断是哪种,论文定义了一个衡量”偏科程度”的指标 Spectral Discordance(谱失调度) $\mathcal{D}$。做法是:把 $N$ 个随机种子在 $M$ 个任务上的表现排成一个百分位矩阵 $\mathbf{P}$,算出任务之间的皮尔逊相关矩阵 $\mathbf{C}$,然后看相关性整体有多弱:
\[\mathcal{D}=1-\frac{1}{M(M-1)}\sum_{j\neq k}\mathbf{C}_{jk}\]$\mathcal{D}\to 1$ 表示任务之间的排名几乎正交(典型的专才:在 A 上排第一的种子,在 B 上可能垫底),$\mathcal{D}\to 0$ 表示排名高度一致(通才:在 A 上好的在 B 上也好)。论文在数学(Countdown、GSM8K、MATH-500、OlympiadBench)、代码(MBPP)、写作(ROCStories)、化学(USPTO)这七个任务上,评估了 500 个随机扰动。
结论站在假设二这边。先看最直观的证据,下面这张图把专才性画得很清楚。怎么读:左边每条细线是一个随机种子,横轴是七个任务,纵轴是它在该任务上的百分位排名(越高越好),加粗的四条线是挑出来的例子;右边是把每个种子的”七维表现向量”用 PCA 降到二维后的聚类。
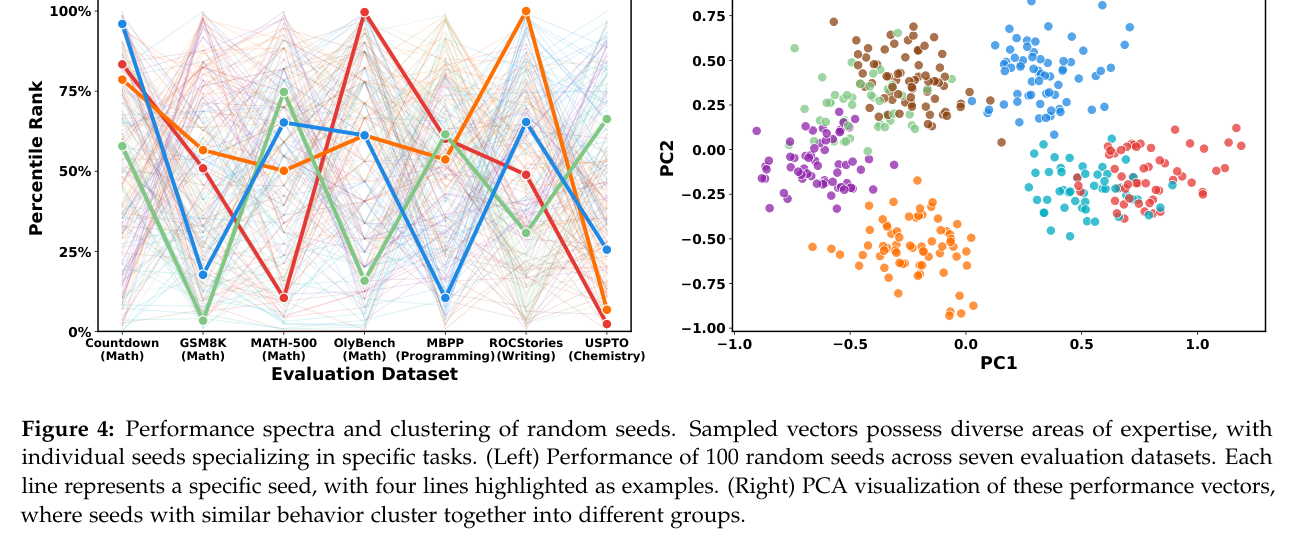
走读左半边:那些加粗的线不是平的,而是尖刺状的——红线在 OlyBench 上冲到接近 100%,却在 GSM8K 和 MATH-500 上掉到很低;橙线在 ROCStories 上封顶,在 USPTO 上却垫底。每个种子都有自己的”主场”和”软肋”,这正是专才的样子。再看右半边的 PCA:这些表现向量明显聚成了好几坨不同颜色的簇,同一簇里的种子共享某种特长(比如都擅长数学但不擅长化学),不同簇之间能力互补。这也解释了第 2 节 RGB 图里那种”花花绿绿”——如果所有扰动都是通才,三个任务的地形图应该高度相关,叠起来是灰度的;正因为它们各管一摊,叠出来才五颜六色。
而且”杂”和”密”一样,也随规模增长。前面那张 scaling law 图的右半边画的就是 $\mathcal{D}$ 随尺寸的变化:从 0.5B 的约 0.55,一路爬到 32B 的接近 0.96。模型越大,周围的解不仅越多,而且越”分化”、越互补。
到这里,方法的轮廓其实已经被现象逼出来了:既然好解又密又杂、而且是一群互补的专才,那正确的玩法就不是”费劲找一个全局最优点”,而是”随机撒一把,把挑出来的专才集成起来”。这正是 RandOpt 的设计动机——不过在讲它之前,先回答一个更根本的问题:这片灌木丛到底是怎么长出来的?
4. 一个最小复现:1D 信号上为什么会长出 thicket
LLM 太大、变量太多,很难说清”thicket 到底是被什么逼出来的”。论文的做法很聪明:在一个小到可以完全掌控的设定里把同样的现象复现出来。
设定是这样的:构造一个”一维信号”的训练分布,信号类型混合了正弦、线性、谐波、sigmoid、锯齿波、方波等好几种函数,每种函数的参数(相位、幅度、斜率、截距……)都随机取。然后训一个很小的 MLP 当”下一个值预测器” $f_\theta:\mathbf{y}{\textsc{ctx}}\to y{\textsc{next}}$——给它一段上下文,让它预测下一个值,这样它就能像 LLM 自回归生成 token 一样,顺着一段观测把后续曲线”续写”出来。接着拿一个简单的线性测试信号去探:在预训练权重附近随机撒 $N=1000$ 个高斯扰动($\sigma=0.002$),看这些扰动续写出来的曲线,有没有哪条能贴合真实的线性延拓。
关键是对比三种预训练设定,它们恰好对应前面说的三种 regime。怎么读下图:蓝色实线是给定的上下文、蓝色虚线是真实的延拓;灰色是各个随机扰动续写的曲线;黑色是没扰动的 base model;红色是最贴合真值的 top-K 扰动。
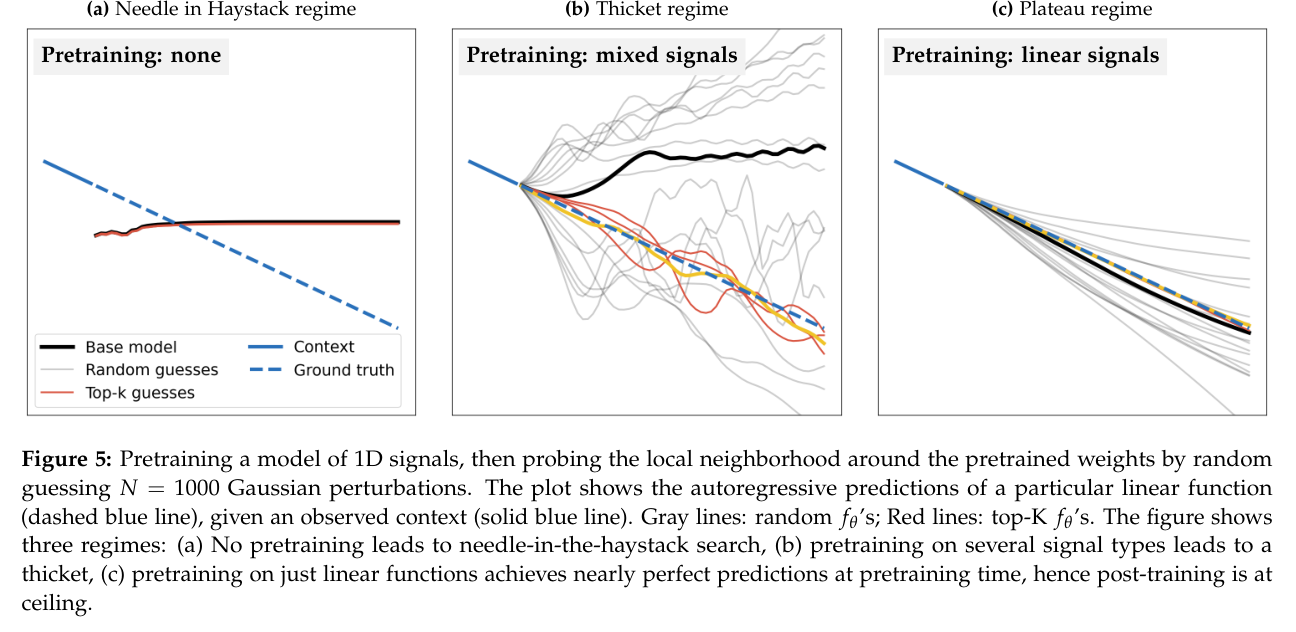
对着三格走一遍:
- (a) 没有预训练(Xavier 随机初始化):灰线几乎缩成一团,扰动对输出形状基本没影响,更别说贴合蓝色虚线了——好解离得太远,这就是 needle-in-haystack,随机猜彻底没戏。
- (b) 在混合信号上预训练:灰线像一把打开的扇子,向各种可能的函数形状发散,其中有几条红线已经相当贴近真实的线性延拓——这就是 thicket,预训练让”各式各样的合理续写”都密集地分布在了附近,随机猜自然能撞到对的那种。
- (c) 只在线性信号上预训练:base model(黑线)本来就几乎完美贴合了真值,扰动帮不上什么忙——这是 plateau(高原)regime,预训练已经把这个任务做到天花板,后训练没有发挥空间。
这个最小实验给出的机制性线索很明确:长出 thicket 的关键,是在”足够多样”的任务上做了”足够充分”的预训练。 预训练太少(a)周围没有好解,预训练太单一(c)周围只有一种解、没有多样性可言。只有在多样信号上充分预训练,才会在权重附近同时得到”又密又杂”的那片灌木丛——这跟第 2、3 节在 LLM 上看到的”density 和 diversity 都随规模增长”是一回事。
5. RandOpt:随机猜 N 个,挑 top-K,集成投票
现象铺完,方法就是水到渠成的一句话:既然好解又密又杂,那就随机猜一批扰动(利用”密”),再把挑出来的几个专才集成起来(利用”杂”)。 论文把这个方法叫 RandOpt(Random Guessing & Ensembling,随机猜测与集成)。
先把符号对齐。base model 记作 $f_{\boldsymbol{\theta}}$,参数 $\boldsymbol{\theta}\in\mathbb{R}^d$。一个扰动由一个随机种子 $s$ 和一个噪声尺度 $\sigma$ 决定:
\[\boldsymbol{\theta}^{\prime}=\boldsymbol{\theta}+\sigma\cdot\boldsymbol{\epsilon}(s)\]其中 $\boldsymbol{\epsilon}(s)\sim\mathcal{N}(\mathbf{0},\mathbf{I}_d)$ 是由种子 $s$ 生成的标准高斯噪声向量。为了同时探测不同大小的邻域,$\sigma$ 从一组尺度 $\Sigma={\sigma_1,\dots,\sigma_M}$ 里取(论文实验里 $\Sigma$ 用的是 ${1,2,3}\times10^{-3}$ 这个量级)。
RandOpt 分成训练和推理两个阶段。
训练阶段(随机猜 + 筛选):采 $N$ 个种子 ${s_1,\dots,s_N}$,每个配一个从 $\Sigma$ 里取的 $\sigma_i$,得到 $N$ 个扰动模型 $\theta_i=\theta+\sigma_i\boldsymbol{\epsilon}(s_i)$。每个模型在一个很小的训练/验证集 $\mathcal{D}_{\text{train}}$ 上评估,拿到分数 $v_i$,然后选出分数最高的 $K$ 个:
\[\mathcal{I}_{\text{top}}=\mathop{\mathrm{arg\,topK}}_{i\in[N]}(v_i)\]注意这里的”训练”没有任何梯度、没有任何串行依赖——$N$ 个评估完全独立,这是它能彻底并行的根本原因。
推理阶段(集成投票):对一个测试输入 $x$,只用选出来的那 $K$ 个模型各自生成一个答案,再用多数投票(majority vote)取众数作为最终输出:
\[\hat{y}=\mathop{\mathrm{mode}}\left(\left\{\mathop{\mathrm{arg\,max}}_{y}f_{\boldsymbol{\theta}_i}(y\mid x)\mid i\in\mathcal{I}_{\text{top}}\right\}\right)\]论文给的伪代码其实非常短,我按它的逻辑重写成带中文注释的版本,变量名对齐上面的数学符号:
# RandOpt 核心逻辑(对照论文 Algorithm 1 重写)
# N: 种群大小(撒多少个扰动,论文主实验 N=5000)
# K: 集成大小(最后留几个做投票,论文主实验 K=50)
# sigmas: 噪声尺度集合 Σ,例如 [1e-3, 2e-3, 3e-3]
# theta: 预训练权重(base model 参数)

# ---------- 训练:在 D_train 上挑出 top-K 个种子 ----------
seeds = [sample_seed() for _ in range(N)]          # 采 N 个随机种子 s_1..s_N
# 给每个种子分一个 σ(这里按 i 均匀地分到 sigmas 里的某一档)
sigmas_per_seed = [sigmas[i // (N // len(sigmas))] for i in range(N)]

# 逐个评估:theta + σ_i·ε(s_i) 在 D_train 上的得分 v_i
scores = [evaluate(theta + sigmas_per_seed[i] * eps(seeds[i]), D_train)
          for i in range(N)]                       # N 个评估互相独立 → 可完全并行

top_indices = topk(scores, K).indices              # 选分数最高的 K 个 → I_top

# ---------- 推理:对测试输入 x 做多数投票集成 ----------
answers = [generate(theta + sigmas_per_seed[i] * eps(seeds[i]), x)
           for i in top_indices]                   # K 个专才各出一个答案
prediction = majority_vote(answers)                # 取众数作为最终输出 y_hat
和 RL 后训练比,RandOpt 有两个结构性区别,这也是它整篇的立意所在:
- 没有梯度、没有串行步。PPO/GRPO 要跑几百个前后依赖的更新步,RandOpt 的”训练”就是 $N$ 次独立评估 + 一次 top-K 排序,训练的 wall-clock 是 $\mathcal{O}(1)$。
- 找的是”一组解”而不是”一个点”。标准做法最后收敛到一个 $\boldsymbol{\theta}$,RandOpt 保留 $K$ 个解做集成——这点和进化算法、quality-diversity 那一脉(维护一个种群而不是坍缩到单点)是相通的。
代价也很明确:推理时要跑 $K$ 次前向(因为要 $K$ 个模型各出一个答案再投票),比单模型贵 $K$ 倍。这个成本怎么降,第 9 节会讲蒸馏。
有意思的是,论文反复强调不是要推销 RandOpt 比别的方法强,而是把它当一个”探针”:它能 work 本身就说明——一旦你有了足够强的预训练表征,后训练就变得很容易,用什么算法差别不大。
6. 源码走读:一个 seed 就是一个”虚拟 checkpoint”
RandOpt 有官方开源(github.com/sunrainyg/RandOpt),而且代码读起来比论文还直白。这一节结合源码把方法真正落到地面上。
先交代一个工程上绕不过去的问题:论文主实验 $N=5000$,也就是要评估五千个扰动。如果老老实实地给每个扰动都存一份 7B 模型的权重,那是五千份 checkpoint——显存和磁盘直接原地爆炸。RandOpt 怎么解决的?答案很漂亮:根本不存扰动权重,只存一个整数种子和一个 $\sigma$。 一个 (seed, sigma) 二元组就是一个”虚拟 checkpoint”,需要用的时候现场把它”长”出来,用完再精确地”抹掉”。
6.1 整体架构:主控 + 一堆各持一份 base model 的 vLLM worker
代码分三层。最上面是主控脚本 randopt.py,负责发种子、收分数、挑 top-K;中间用 Ray 把若干个 vLLM 推理引擎(engine)摊到多张卡上;每个 engine 内部挂了一个 WorkerExtension(在 utils/worker_extn.py),提供”给自己的权重加扰动 / 还原”这几个底层操作。
引擎启动时,每个 worker 先把自己的 base 权重存一份作底(core/engine.py 里 launch_engines 启动完每个 engine 就调一次 store_base_weights)。之后所有扰动都是在这份底的基础上临时加减,不再复制整模型。
6.2 核心 trick:用 seed 现场生成噪声,加得上也减得掉
整个方法的工程命门就在这两个函数上。它们都在 utils/worker_extn.py 的 class WorkerExtension 里:
# utils/worker_extn.py
# class WorkerExtension
# def perturb_self_weights(self, seed, noise_scale, negate=False)
def perturb_self_weights(self, seed, noise_scale, negate=False):
    self._set_seed(seed)
    scale = float(noise_scale)              # 就是 σ,例如 0.001
    sign = -1.0 if negate else 1.0
    for name, p in self.model_runner.model.named_parameters():
        gen = torch.Generator(device=p.device)
        gen.manual_seed(int(seed))          # ★ 关键:每个参数都用同一个 seed 重新播种
        noise = torch.randn(p.shape, dtype=p.dtype, device=p.device, generator=gen)
        if self._should_perturb(name):      # VL 模型里默认跳过视觉编码器
            p.data.add_(sign * scale * noise)   # 原地:θ ← θ + σ·ε(s)
        del noise
    return True
这段怎么理解:seed 来自主控发下来的那个随机整数(取值例子:seed=1734829301,noise_scale=0.001)。对模型里的每一个参数张量 p,都用这个 seed 新建一个 torch.Generator 重新播种,再 torch.randn 出一个和 p 同形状的高斯噪声。举个具体例子:假设 p 是某层的 q_proj.weight,p.shape = [2048, 2048],那 noise 就是一个 [2048, 2048]、每个元素独立采自 $\mathcal{N}(0,1)$ 的张量;p.data.add_(0.001 * noise) 就把这层权重原地挪动了 $\sigma=0.001$ 这么大的一步。整个循环走完,模型就从 $\boldsymbol{\theta}$ 变成了 $\boldsymbol{\theta}+\sigma\cdot\boldsymbol{\epsilon}(s)$。
评估完这个扰动,要把模型还原回 base,才能接着评估下一个。还原函数几乎是上面的镜像:
# utils/worker_extn.py
# class WorkerExtension
# def restore_self_weights(self, seed, SIGMA, negate=False)
def restore_self_weights(self, seed, SIGMA, negate=False):
    self._set_seed(seed)
    sign = -1.0 if negate else 1.0
    for name, p in self.model_runner.model.named_parameters():
        gen = torch.Generator(device=p.device)
        gen.manual_seed(int(seed))          # 同一个 seed → 生成一模一样的 noise
        noise = torch.randn(p.shape, dtype=p.dtype, device=p.device, generator=gen)
        if self._should_perturb(name):
            p.data.add_(-sign * float(SIGMA) * noise)   # 原地:θ' ← θ' − σ·ε(s) = θ
        del noise
    return True
这里是整个 trick 的精髓:因为噪声完全由 seed 决定,restore 用同一个 seed 能生成逐比特一致的 noise,于是 θ + σ·ε(s) 再 − σ·ε(s) 就精确回到了 $\boldsymbol{\theta}$。所以主控全程只需要在手里攥着 (seed, sigma) 这几十字节的信息,就能随时复现、随时抹掉任意一个扰动,一份权重反复用。这也顺带解释了论文反复强调的”去中心化、低通信”:worker 之间要交换的不是几十 GB 的权重,而是 (seed, sigma, score) 这种小到可以忽略的元信息。
(一个实现细节:循环里每个参数都用同一个 seed 重新播种,所以不同形状的参数是从同一条随机流的开头各取所需。这不影响正确性——只要 perturb 和 restore 用的是同一套规则,加减就能精确抵消,可复现性才是这里唯一重要的东西。)
6.3 训练主线:perturb → 生成 → 打分 → restore 的循环
有了”虚拟 checkpoint”这个底座,训练主线就非常清爽。randopt.py 的 run_sampling 先一次性把 $N$ 个种子和 $\sigma$ 都定好,再分批(每批塞满所有 engine)跑评估:
# randopt.py
# def run_sampling(args, engines, handler, train_prompts, train_datas, sampling_params)
rng = np.random.default_rng(seed=args.global_seed)
# 一次性预生成 N 个不重复的种子,和每个种子对应的 σ
all_seeds  = rng.choice(2**31, size=args.population_size, replace=False).tolist()
all_sigmas = rng.choice(args.sigma_list, size=args.population_size).tolist()

while samples_evaluated < args.population_size:
    batch = [(all_seeds[seed_idx + i], all_sigmas[seed_idx + i]) for i in range(batch_size)]

    # 1) 给每个 engine 的权重各加一个扰动:θ → θ + σ·ε(s)
    ray.get([engines[i].collective_rpc.remote("perturb_self_weights", args=(int(s), sig, False))
             for i, (s, sig) in enumerate(batch)])
    # 2) 在 200 条 train_prompts 上生成(temperature=0 贪心解码)
    outputs = ray.get([engines[i].generate.remote(train_prompts, sampling_params, use_tqdm=False)
                       for i in range(len(batch))])
    # 3) 还原回 base:θ' → θ,engine 复用,不复制权重
    ray.get([engines[i].collective_rpc.remote("restore_self_weights", args=(int(s), sig, False))
             for i, (s, sig) in enumerate(batch)])

    # 4) 打分:perf[(seed, sigma)] = 该扰动在 train 集上的得分 v_i
    for i, (seed, sigma) in enumerate(batch):
        perf[(seed, sigma)] = handler.postprocess_outputs(outputs[i], train_datas)
这段的输入输出讲清楚:train_prompts 是从训练集里取的前 200 条(args.train_samples 默认 200,对应论文 “用训练集前 200 条做 RandOpt 的选择集”);sampling_params 用的是 temperature=0.0 的贪心解码,保证每个扰动的得分是确定的。handler.postprocess_outputs(...) 的返回值就是数学里的 $v_i$——这个扰动模型在这 200 条上的平均”奖励”(对 Countdown/GSM8K 这类任务,基本就是答对的比例)。整个 perf 字典最终是 {(seed, sigma): v_i},一共 $N$ 项。
挑选这一步就是一次排序,对应公式里的 $\mathcal{I}_{\text{top}}$:
# randopt.py / def main(...) 里的 SELECTION 段
sorted_perturbs = sorted(perf.items(), key=lambda x: x[1], reverse=True)   # 按得分降序
top_k_perturbs  = [(seed, sigma) for (seed, sigma), _ in sorted_perturbs[:args.max_top_k]]
# top_k_perturbs: list[(seed, sigma)],长度 K(如 50);只存种子和 σ,不存权重
top_k_perturbs 的类型是 list[(int, float)],长度就是 $K$。再次强调:这个”训练好的模型”落到磁盘上只是一个 top_k_seeds.json,里面是 $K$ 个 {seed, sigma, train_reward},几 KB 而已——这就是 RandOpt 的”checkpoint”。
6.4 推理主线:top-K 逐个复现,多数投票
推理阶段 run_ensemble_evaluation 把 top_k_perturbs 里的 $K$ 个种子逐个”复活”,在测试集上生成,再对每个样本做多数投票:
# randopt.py
# def run_ensemble_evaluation(...)
# all_answers[model_idx][sample_idx] = 该模型在该样本上抽取出的答案字符串
for k_value in eval_k_values:                 # 支持一次评估多个 K,如 [50, 25, 5, 1]
    correct = 0
    for idx, data in enumerate(test_datas):
        # 收集 top-k 个模型在第 idx 个样本上的答案(丢掉空答案)
        answers = [all_answers[m][idx] for m in range(k_value) if all_answers[m][idx]]
        if answers:
            final = Counter(answers).most_common(1)[0][0]   # ★ 多数投票取众数 = y_hat
            is_correct = handler.is_voted_answer_correct(final, data["ground_truth"])
            correct += int(is_correct)
    acc = correct / num_samples * 100
这里 Counter(answers).most_common(1)[0][0] 就是数学公式里的 $\mathop{\mathrm{mode}}(\cdot)$——把 $K$ 个专才各自抽出来的答案(比如 Countdown 里从 <answer>...</answer> 标签里扒出来的算式结果)数一下,哪个出现最多就取哪个。代码里特意把每个模型的完整文本生成后立刻只保留抽取出的答案字符串、丢掉原文(del batch_outputs; gc.collect()),也是为了省显存——毕竟 $K$ 个模型 × 整个测试集的文本不是小数目。
一个值得注意的设计:它一次性支持多个 $K$ 值(eval_k_values),所以能直接看到”从 $K=1$ 到 $K=50$ 集成规模怎么影响精度”——这正是论文反复强调的”集成是 RandOpt 吃饭的家伙”(第 7 节会看到 $K=1$ 和 $K=50$ 差距有多大)。
6.5 顺带一提:ES 变体复用了同一套 noise 基建
论文表格里其实有两个 RandOpt 变体:RandOpt (random) 用纯随机选择(就是上面讲的),RandOpt (ES) 则在同一批扰动上套一层 Evolution Strategies(进化策略)的更新。代码里对应 worker_extn.py 的 update_weights_from_seeds,它复用了”seed → noise”这套基建,把一堆种子的噪声按奖励加权累加,一次性更新权重:
# utils/worker_extn.py
# class WorkerExtension / def update_weights_from_seeds(self, seeds, coeffs, alpha, population_size)
for name, p in self.model_runner.model.named_parameters():
    update = torch.zeros_like(p.data, dtype=torch.float32)
    for i, seed in enumerate(seeds):
        gen = torch.Generator(device=p.device); gen.manual_seed(int(seed))
        noise = torch.randn(p.shape, dtype=p.dtype, device=p.device, generator=gen)
        update.add_(noise.to(torch.float32).mul_(coeffs[i]))   # Σ_i coeff_i · ε(s_i)
    update.div_(population_size).mul_(alpha)                    # 乘学习率 α / N
    p.data.add_(update.to(p.dtype))                            # θ ← θ + (α/N)·Σ coeff_i·ε_i
这就是经典的 ES 梯度估计(Salimans 等人那一套):coeffs[i] 是第 $i$ 个扰动归一化后的奖励,整条式子 $\boldsymbol{\theta}\leftarrow\boldsymbol{\theta}+\frac{\alpha}{N}\sum_i r_i\,\boldsymbol{\epsilon}(s_i)$ 相当于”用噪声方向按奖励加权,估一个梯度再走一步”。RandOpt(random) 和 RandOpt(ES) 的区别只在”怎么从种群里选/更新”,底下那套”只存种子、现场生成噪声”的机制是完全共享的。这也呼应了论文的核心论点——在 thicket regime 里,纯随机筛选和 ES 这种更”聪明”的更新,最后拉不开差距。
7. 和 PPO/GRPO/ES 比,到底谁强
方法讲完,该看硬碰硬的数据了。论文在 Qwen2.5、Llama3.1、OLMo3 一系列 0.5B 到 8B 的模型上,跨数学(Countdown、GSM8K、MATH-500、OlyBench)、代码(MBPP)、写作(ROCStories)、化学(USPTO)四类任务做了评估。顺手把几个任务名解释清楚:Countdown 是”给几个数字凑出目标值”的算式游戏,GSM8K 是小学应用题,MATH-500/OlyBench 是更难的竞赛数学,MBPP 是 Python 编程题,USPTO 是化学反应预测。
对比的 baseline 有五个,第一次出现先说清楚各自是什么:
- TT-MV(Test-Time Majority Vote,测试时多数投票):同一个模型用不同随机种子多采几次,取出现最多的答案。不改参数,纯靠采样多样性涨分。
- Best-of-N:同样多采几个回答,但按某个打分/奖励挑最高分的那个(而不是取众数),也就是常说的 Pass@k 里”N 选 1”的思路。
- PPO / GRPO:前面讲过的两种主流 RL 后训练方法。
- ES(Evolution Strategies at Scale,大规模进化策略):无梯度优化,用高斯噪声扰动参数、按 fitness 加权更新——注意它和 RandOpt 的训练阶段其实是近亲,区别是 ES 要串行迭代很多步(论文里 167 步),RandOpt 一步到位。
公平性上论文做了关键的一刀:所有方法对齐总训练 FLOPs。因为算法开销差别很大(附录给了公式:GRPO 每步 $8\cdot B\cdot G\cdot PL$、PPO 要带 critic 所以 $14\cdot B\cdot G\cdot PL$、ES/RandOpt 只有前向所以 $2\cdot N\cdot D\cdot PL$),所以用 batch size 和迭代步数去配平——比如让 ES 的”30 种群 × 167 步”和 RandOpt 的”5000 种群 × 1 步”消耗差不多的总评估量。
先看总览。下面这张图把所有 (模型, 任务) 组合画成散点,三格分别是 RandOpt 和三组对手比:和 base model 比、和”1-pass 的 PPO/GRPO”比、和”ES + 测试时投票”比。怎么读:每个点是一个 (模型, 任务),纵轴是 RandOpt 的准确率、横轴是对手的准确率,落在对角线左上方就是 RandOpt 更强;点的大小表示模型规模,形状表示任务类别。
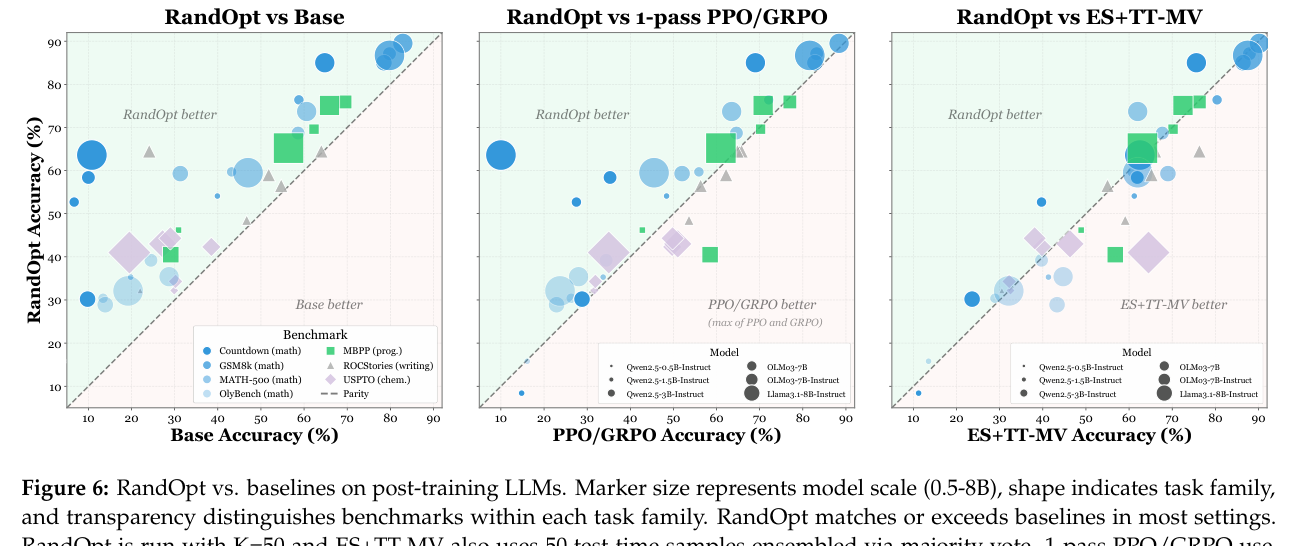
对着图走读:左格(vs base)几乎所有点都在对角线上方,说明 RandOpt 普遍比原模型强,这是意料之中。中格(vs 1-pass PPO/GRPO)和右格(vs ES+TT-MV)才是关键——大部分点仍落在对角线上方或贴着对角线,说明 RandOpt 在同等 FLOPs 下追平、很多时候还超过这些成熟方法。注意中格对手用的是”1-pass”(单次采样、不做测试时投票),这其实对 baseline 不太公平,但论文说这反映了这些方法当前的标准用法。
具体数字看完整结果表。怎么读:每个大块是一个模型,行是方法,列是七个任务,加粗是最好、下划线是次好。
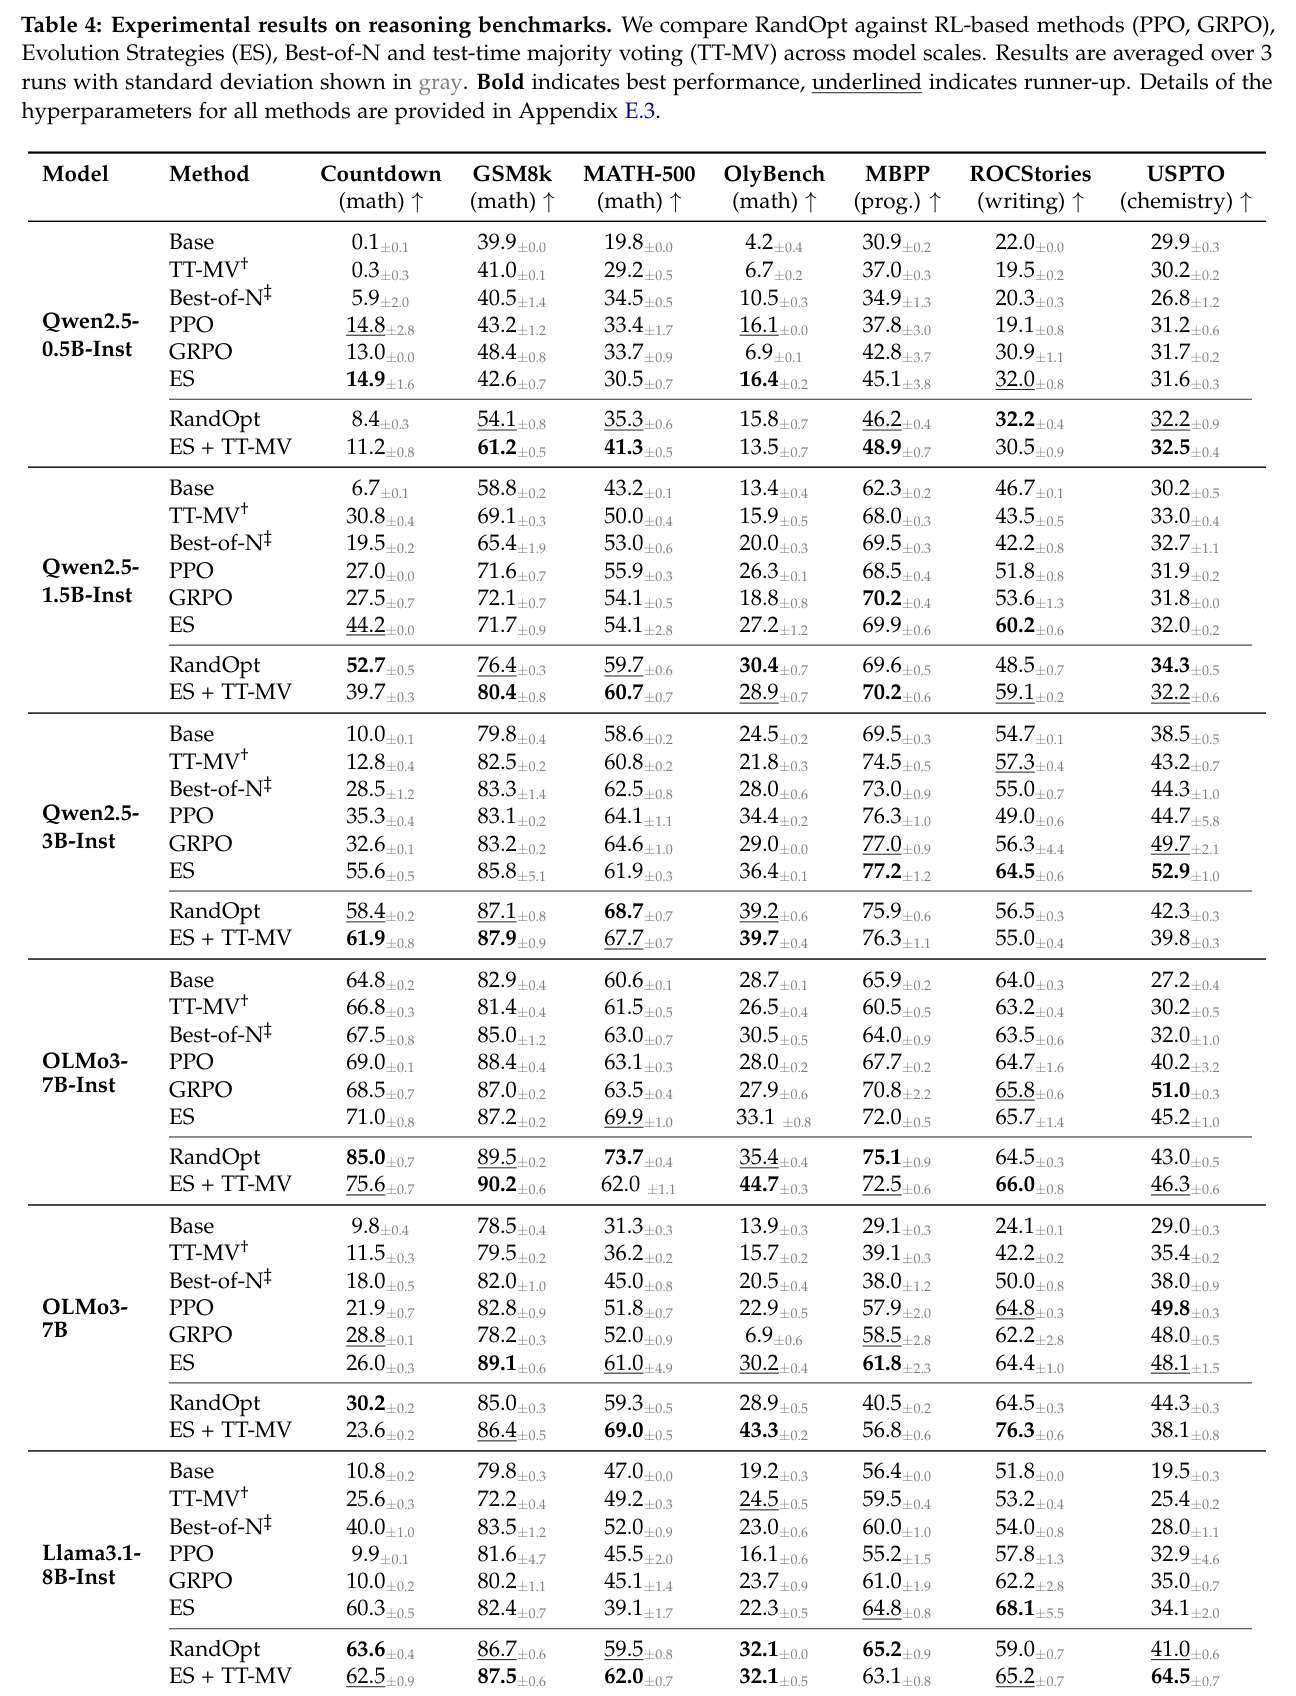
挑几个有代表性的走一遍(都是准确率 %,越高越好):
- Qwen2.5-1.5B-Inst / Countdown:base 只有 6.7,PPO 27.0、GRPO 27.5、ES 44.2,RandOpt 直接干到 52.7(全场最高)。
- Qwen2.5-3B-Inst / GSM8K:base 79.8 → RandOpt 87.1;MATH-500 上 base 58.6 → RandOpt 68.7(最高)。
- OLMo3-7B-Inst / Countdown:base 64.8 → RandOpt 85.0(最高);MATH-500 上 60.6 → 73.7。
- Llama3.1-8B-Inst / Countdown:这一行最离谱——base 10.8,PPO 只有 9.9、GRPO 只有 10.0(基本没学会),ES 60.3,而 RandOpt 冲到 63.6。在这个任务上 RL 几乎失灵,随机猜反而稳稳拿分。
当然论文没有报喜不报忧。Qwen2.5-0.5B-Inst 上 RandOpt 在 Countdown 上只有 8.4,还不如 PPO 的 14.8、ES 的 14.9——小模型周围的 thicket 还没长起来,密度不够,随机猜自然吃亏。这跟第 2 节”density 要靠规模撑起来”是自洽的,不是 bug。
两个额外亮点:
- Wall-clock:论文把 RandOpt 铺到 200 张 GH200 的集群上,用 $N=2000, K=50$ 训 Olmo-3-7B-Instruct 做 Countdown,3.2 分钟拿到 70% 准确率。因为 $N$ 个评估纯并行,墙上时钟时间几乎只取决于单次评估。
- VLM 也吃这一套:在 Qwen2.5-VL-3B-Instruct 这个视觉语言模型上(冻结视觉编码器、只扰动语言模型部分,$N=5000, K=50$),GQA 这个视觉推理数据集的准确率从 56.6 涨到 69.0,+12.4 个点。
还有一个贯穿全表的细节:集成是 RandOpt 的命根子。 论文和 Figure 1(c) 都显示,RandOpt 在 $K=1$(只取最好的那个扰动、不投票)时比 $K=50$ 差一大截;而且集成这招对 baseline 也管用——ES 叠上 50-pass 的 TT-MV 后,Qwen2.5-0.5B 的 GSM8K 能从 42.6 抬到 61.2。有意思的是,训练跑得越久,不同方法集成后的差距越小——又一次印证”进了灌木丛,用什么方法都差不多”。
8. 增益从哪来:真·推理变强,还是只是改对了格式
这节是论文最诚实、也最该较真的地方。随机扰动涨的这些分,到底是模型”真的会做题了”,还是只是”输出格式蒙对了”?要知道,很多 benchmark 用严格的答案检查器,一个 JSON 格式不对、答案没放在 #### 后面,哪怕算对了也判错。那随机扰动会不会只是碰巧把输出格式修好了?
论文在 GSM8K 的 1319 条测试样本上,把相对 base model 的变化拆成四类:原本就对的(retained)、base 做错但调完做对的(reasoning thicket,推理灌木丛)、base 其实算对了只是格式不对被判错、调完格式对了的(format thicket,格式灌木丛)、以及 base 对但调完反而错了的(regression,退化)。
下图怎么读:每一行是一种方法的准确率条,灰色是严格全对,浅蓝是”推理被修对”的增量,紫色是”只是格式被修对”的增量,红色虚线框是退化。
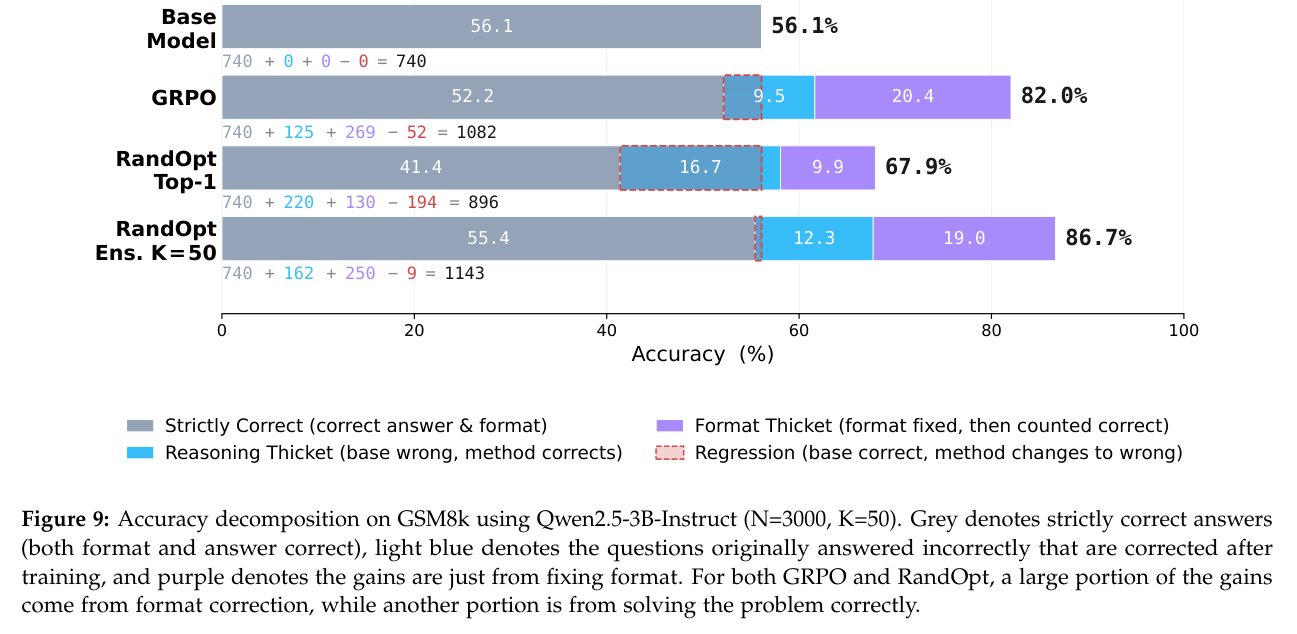
对着图走读(Qwen2.5-3B-Inst,$N=3000, K=50$,严格检查器下 base 只有 56.1%):
- RandOpt 集成 $K=50$:总准确率冲到 86.7%,其中格式修对贡献了 19.0%、推理修对贡献了 12.3%,退化只有 0.7%。
- 作为对照,GRPO 的增益同样有一大块来自格式(紫色那段 20.4%),推理修对反而只有 9.5%。
所以结论要摆正:RandOpt 的增益里,格式修复确实占了相当大的比例,但推理层面的真实提升也实打实存在——而且这个”靠格式吃分”的毛病,GRPO 这类正经 RL 方法同样有,不是 RandOpt 独有的锅。 论文顺势把 thicket 的概念推广开:既然”任务专家”的定义就是”在这个 benchmark 上得分高”,而 benchmark 本身混合了格式、技能、知识、风格等多个维度,那自然会有”格式灌木丛”“推理灌木丛”“知识灌木丛”甚至(在扩散模型里的)”颜色灌木丛”等各种类型。这是对现象的如实描述,不是给方法贴金。
顺带回应一个常见质疑:会不会是 sandbagging(藏拙)? 也就是说,某些模型可能在对齐/指令微调时被”训得故意表现差”,随机扰动只是破坏了这种抑制、把本来就有的能力放出来了。论文认为不是:最硬的证据是 OLMo3-7B 这个 base 模型——它的训练数据和流程全开源、可验证没有刻意 sandbagging,RandOpt 在它身上照样有效(Countdown 从 9.8 涨到 30.2)。而且 sandbagging 一般被认为是大模型的毛病,可 RandOpt 在 0.5B 这种小模型上也有稳定增益,和”策略性藏拙”的假设对不上。
9. 推理成本和可扩展性:K 次前向怎么省,能 scale 多远
RandOpt 最明显的代价是推理贵——要跑 $K$ 次前向做集成,比单模型贵 $K$ 倍。论文给的解法是蒸馏(distillation):把 top-K 这个集成”压”回一个单模型。具体做法是用 top-50 个模型在 500 道训练题上生成 25000 条回答,只挑”难样本”(八个候选里过半答错的题),把 (问题, [推理过程; 答案]) 这样的序列拿去对 base model 做 2 轮监督微调(SFT),损失就是标准的对推理过程和答案部分求负对数似然:
其中问题 $x$ 的那部分 loss 被 mask 掉,模型只学着自回归生成后面的推理和答案。效果如下:
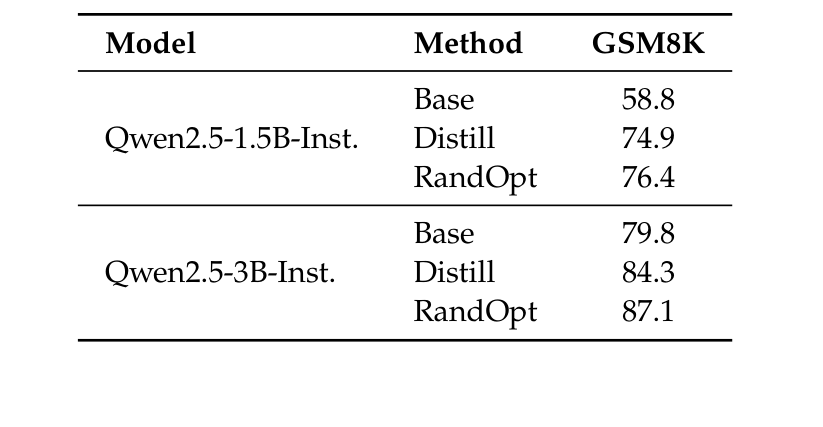
读一下这张表:Qwen2.5-1.5B-Inst 在 GSM8K 上,base 58.8,蒸馏后 74.9,很接近集成版 RandOpt 的 76.4;3B 上 base 79.8、蒸馏 84.3、集成 87.1。蒸馏基本吃到了集成七八成的收益,却回到了单模型的推理成本。 而且蒸馏本身很便宜——训练用了 5000 的种群,蒸馏只用 top-50 跑十来步 SGD,成本约为训练的 2%。代价是:蒸完就不再是”完全并行”了,而且这套蒸馏方式是为”推理任务 + 离散最终答案”量身定做的,换个场景未必适用。
再看可扩展性。下图左边是在 Countdown 上扫 $N$(种群大小)和 $K/N$(选择比例)的热力图,右边是把模型从 GPT-2 0.1B 一路换到 Qwen 32B 看 RandOpt 的表现。
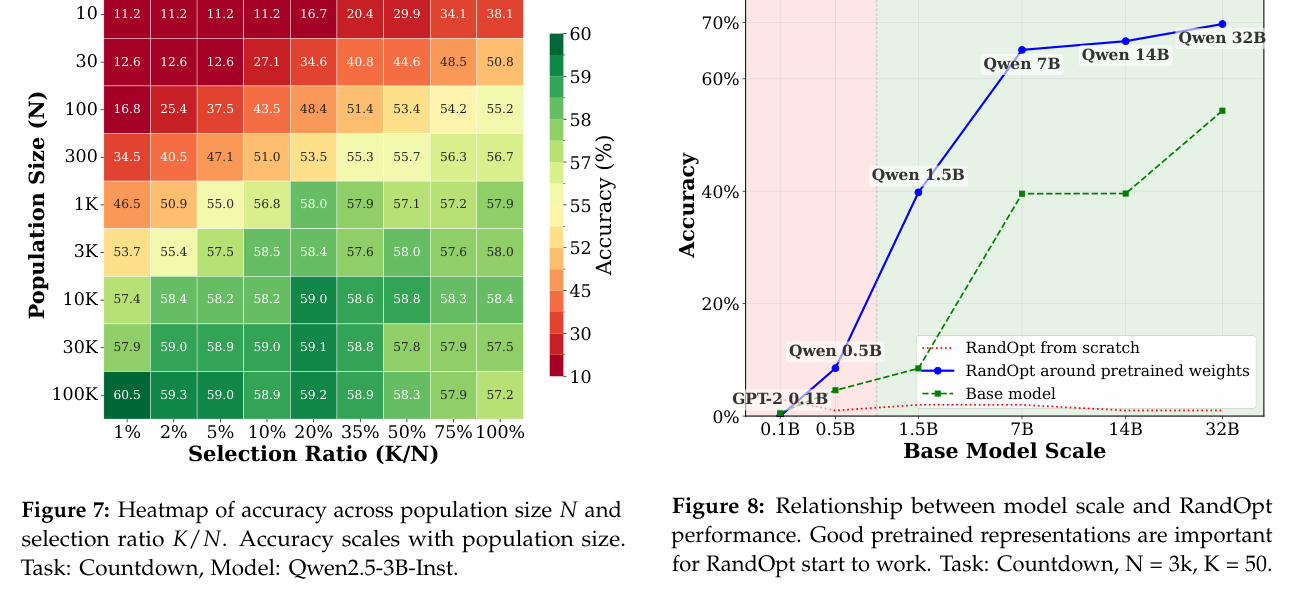
对着两张图走读:
- 左边热力图:纵轴 $N$ 从 10 一路到 100K,横轴是选择比例。规律很干净——只要选择比例别太高,精度随 $N$ 单调上升($N=100\text{K}$、只选最好的 1% 时能到 60.5%);而且 $N$ 越大,最优的选择比例越小。这给了一个很省心的用法:$K$ 设小、$N$ 开到预算允许的最大即可。
- 右边模型规模曲线:蓝线是 RandOpt 作用在预训练模型上的表现。GPT-2 0.1B 这种太小的,RandOpt 几乎不涨;Qwen 0.5B 也只有一点点;但到 1.5B 左右精度突然起飞,7B/14B/32B 稳在 65%~70%。而红色点线是”从零开始、没预训练就直接 RandOpt”——全程贴着 0。绿色虚线是 base model,随着模型变大自己也追上来,RandOpt 的相对增益随之收窄。
这张图把全文的边界讲得很清楚,也正好对上论文的 Limitations:
- 预训练仍然是前提。RandOpt 救不了没预训练的模型,也救不了太小的模型——它只在”你已经有了足够好的表征”之后才 work;而找到那个好表征本身,可能还是得靠结构化的搜索(梯度下降那套)。
- 会饱和。无论是加大 $N$ 还是加大模型,增益都会随 log 资源饱和——想再突破,可能得走出当前这片灌木丛去更远处找解,那又会回到 needle-in-haystack 的困境。
- 多数投票撑不起结构化预测。目前的集成假设答案是单个离散类别(整数、选项),对”写一个故事”“生成一张图”“设计一个分子”这种结构化输出,怎么集成/蒸馏还是个开放问题(附录里对扩散模型试了”逐步去噪时做均值集成”,只当是个 proof of concept)。
10. 总结
把这篇的脉络收一下。它先给出一个反直觉的观察——预训练之后,在权重附近随机猜居然能撞到大量好解;然后用 solution density 和 spectral discordance 两个指标,把这片解证明成又密又杂的一群专才,并命名为 Neural Thickets;再用 1D 信号的最小实验说明 thicket 是”在多样任务上充分预训练”长出来的;最后用 RandOpt 这个”随机猜 + 集成”的极简方法当探针,证明一旦进了灌木丛,纯随机筛选都能跟 PPO/GRPO/ES 掰手腕。
真正值得记住的不是 RandOpt 这个方法本身——论文自己都说不想推销它——而是它逼出来的三个认知转变:预训练模型与其说是一个点,不如说是一个分布;后训练与其说是在”学习新能力”,不如说是在从预训练分布里”挑选/锐化”已有的能力;以及 RL 不是后训练的唯一路,在 thicket regime 里,搜索算法的选择没那么重要。
从 NAS/AutoML 的视角看,这篇其实很”亲切”。它干的事情本质是在权重空间里做搜索,而且用的是进化策略和随机搜索这类无梯度方法——这正是 NAS 领域几十年来反复打磨的工具箱,只不过搜索对象从”网络结构”换成了”预训练权重的扰动”。它跟几条老线索也接得上:ES 能媲美 RL(Salimans 那套在控制问题上早有结论)、MAML 在找”一步可适应的初始化”(论文直接说预训练在隐式地找一个 MAML-like init)、以及 LLM 微调的 intrinsic dimension 很低(Aghajanyan 那条线,甚至有工作说 13 个参数就能学会数学推理)。把这些拼起来看,”随机扰动能 work”就不那么突兀了:低维有效子空间 + 过参数化带来的宽盆地,交叠出的那一大片方向,随机投影本来就有不低的概率命中。
当然要清醒:这套方法吃预训练、会饱和、只擅长离散答案的任务。它更像是给”预训练到底学到了什么结构”开了一扇窗,而不是一把能替掉 RL 后训练的瑞士军刀。但作为一个 probe,它确实把”后训练在干什么”这个问题问得更锋利了。
扯一句题外话。这篇的工具箱——在权重空间里用进化/随机搜索找解、用 ES 替代 RL、再把 top-K 蒸馏回单模型——几乎每一块都落在我们整理《动手学 AutoML:从 NAS 到大语言模型优化实战》时反复写的那几章里。书里”搜索策略”一章专门讲了进化、贝叶斯、强化学习、DARTS 这几条路线各自的适用场景(RandOpt 本质就是把其中的随机/进化搜索搬到了权重扰动上),实战篇还有”随机搜索 NAS 从零实现”和”进化压缩”两章可以对着代码跑;而它关于 LLM 后训练、把集成蒸馏回单模型的那部分,和书里 LLM 压缩、LLM 驱动的 AutoML 几章的思路也是相邻的。角度不太一样,但目标很接近——都是在问”能不能用更省、更并行的搜索,换来和精调一样的效果”。感兴趣的话可以当延伸读物翻翻。