ICML'26 Spotlight | ThunderAgent:用“LLM Program”抽象治好 agentic 推理的 KV cache 颠簸
ICML’26 Spotlight | ThunderAgent:用“LLM Program”抽象治好 agentic 推理的 KV cache 颠簸
原文:ThunderAgent: A Fast, Simple, and Program-Aware Agentic Inference System
1. agentic workflow 火了,但推理系统还在“按单请求”调度
你把一个 coding agent 跑起来,让它去修 SWE-Bench 上的 GitHub issue。单条跑的时候一切都顺:模型读代码、想一步、调一次编译器、看结果、再想一步,一步步把 bug 修好。
真正上量才知道坑在哪。把并发从 24 条拉到 96 条,吞吐不升反降——本以为堆机器就能线性扩,结果 vLLM 的吞吐从并发 48 开始就往下掉,到 96 直接腰斩。这里说的 agentic workflow(多轮 agent 工作流),指的是 LLM 一边做长链条推理、一边调用外部工具(编译器、检索器、浏览器 sandbox),自己走完一个多步任务、中途基本不用人介入的这种跑法。它不是某一个产品,SWE-Agent、OpenHands、ToolOrchestra 都是这类工作流的具体实例。
为什么要盯着吞吐不放?因为 agent 跑到规模化、自动化之后,整个系统的效率是由持续吞吐决定的,而不是单条请求的尾延迟——没有人在屏幕前等它一个字一个字蹦,它是后台自己跑的。吞吐越高,同样的硬件能跑完越多 workflow,单位成本就越低。更关键的是强化学习:RL 训练里有个环节叫 rollout,就是拿当前策略模型去把 agent 跑一遍、采集轨迹数据,这个环节能占到 RL 墙钟时间的 70% 以上。rollout 吞吐上去了,数据新鲜度(policy lag)才压得住,收敛速度和最终策略质量都跟着受益。
那吞吐为什么会崩?根因在于现在的 agentic 推理系统是拿零件松散拼出来的:一个现成的推理引擎(vLLM 或 SGLang)接一个通用的工具编排器(tool orchestrator,典型就是 Kubernetes,负责拉起/销毁 sandbox、分配端口)。一条 workflow 明明要来回很多轮模型请求和工具请求,可这两个零件各管各的,都是以单个请求为粒度去调度和分配资源的,谁都没有一整条 workflow 的全局视角。结果就是 KV cache 和工具执行环境都被管得很糟。
ThunderAgent 这篇 ICML’26 Spotlight(top 2.2%)的做法,一句话概括:别再把每一次模型调用、每一次工具调用当成互不相关的独立请求,而是把一整条 workflow 打包成一个“程序”(论文叫它 LLM Program / Agentic Program),让调度器以程序为单位,统一地去看待 KV cache、系统状态和外部工具资源(磁盘、网络端口)。至于这个抽象具体怎么帮上忙,得先看清现在的系统到底卡在哪三个地方。
2. 把 vLLM + Kubernetes 拼起来,到底差在哪
论文把 vLLM + Kubernetes 这套最有代表性的组合拿来做 profiling,默认跑 GLM-4.6 模型、OpenHands 的 RL rollout、两台 8×H100。结论很干脆:这几个毛病换个推理引擎根本解决不了,它们是“按单请求调度”这个范式本身带来的,得靠新的程序级抽象。
先看第一张图。这是把三个现象画在一起的动机图,从左往右读:(a) 吞吐随并发怎么变、(b) 吞吐崩的锅是谁、(c) ThunderAgent 相比两个基线的加速比。
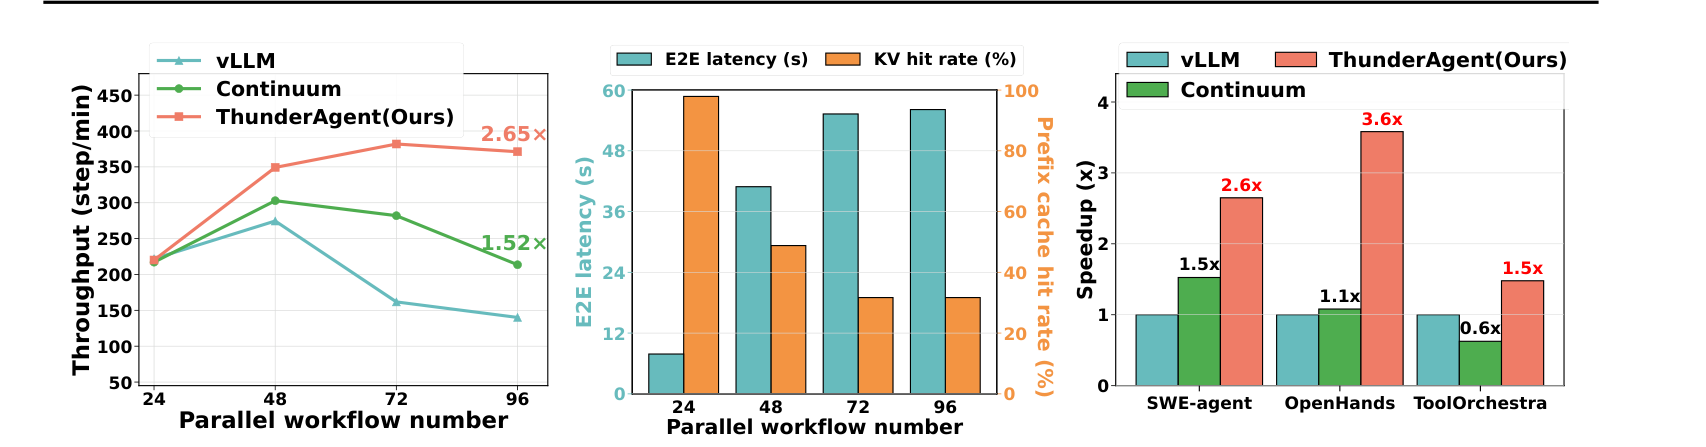
左图里,并发从 24 涨到 96,vLLM(蓝)在 48 之后一路下滑,到 96 并发时 ThunderAgent(橙)的吞吐是它的 2.65×,连 Continuum(绿,一个专门做多轮 agent 的 SOTA 服务系统)也只有 1.52×。中间那张双轴图是关键证据:橙色柱是 prefix cache 命中率(新一轮请求的 prefix 有多少比例能直接命中已缓存的 KV、不用重算,越高越好),蓝色柱是端到端延迟。可以看到并发一大,命中率从 ~95% 掉到 ~30%,延迟同步飙起来——吞吐崩的直接原因就是 KV cache 命中率崩了。右图是最终战绩预告:在 SWE-agent / OpenHands / ToolOrchestra 上,ThunderAgent 分别拿到 2.6× / 3.6× / 1.5× 的加速,而 Continuum 在 ToolOrchestra 上甚至只有 0.6×(反而更慢)。
为什么命中率会崩?这就是第一个困境:KV cache 颠簸(thrashing)。先说清楚 KV cache 是什么——自回归生成时,把每个已处理 token 的 Key/Value 向量缓存下来,避免下一步重复计算;在 agent 场景里,这块缓存其实就是这条 workflow 的“记忆”,存着它从第一步到现在的完整交互历史。理论上,agent 每多走一步,新的上下文都是旧上下文的前缀延长,KV 几乎可以 100% 复用。可现在的系统把每一步都当成独立的无状态请求:当一条 workflow 进入工具执行阶段(在等编译器返回),它那块“正占着显存却暂时不干活”的 KV,在高并发、显存吃紧时就会被反应式地驱逐掉,腾给别的请求 decode。等工具一返回,这条 workflow 要继续推理,却发现历史没了,只能把整段上下文重新 prefill 一遍(re-prefill / 重算)。这种“驱逐→重算→再驱逐”的反复横跳,就是颠簸,概念上跟操作系统里的内存抖动一模一样。论文测出来,这个重算会把单请求的端到端延迟最高拉大到 7.14×。
第二、第三个困境,看下面这张图。同样从左往右:(a) 两个节点的显存占用随时间怎么分化、(b) 磁盘占用随处理过的 workflow 数怎么涨、(c) 工具环境的平均准备时间随并发怎么变。
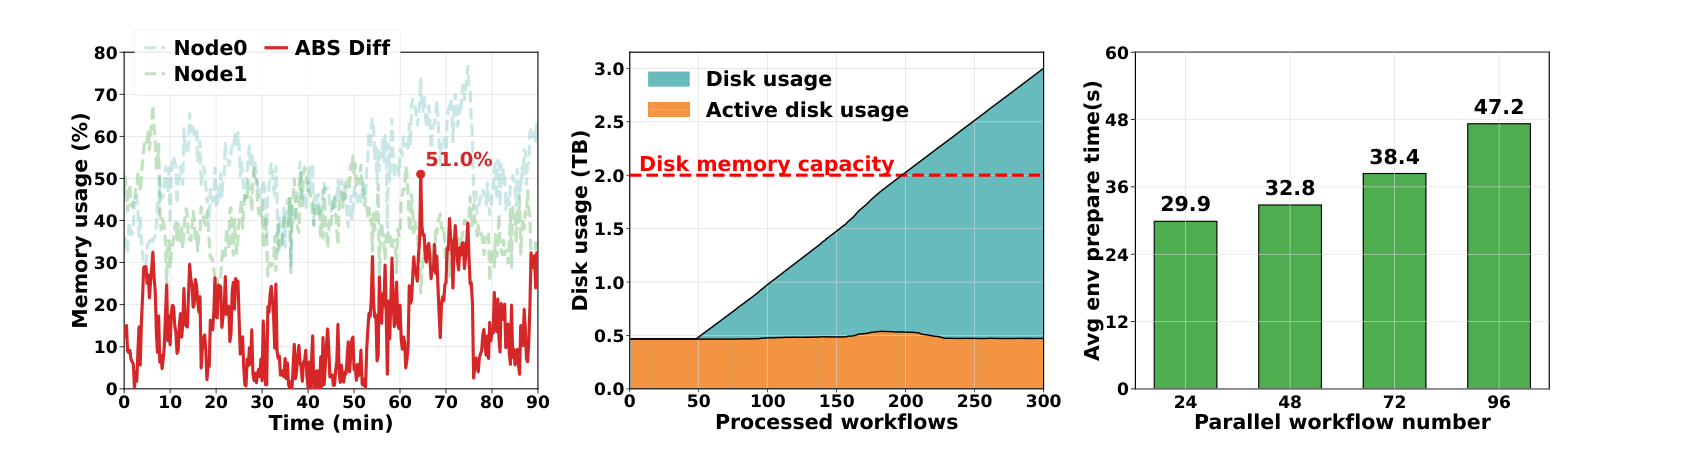
左图是第二个困境:跨节点内存不均(memory imbalance)。多节点部署时,现有引擎为了最大化 KV 命中率,会把同一条 workflow 的所有请求都钉死在同一个节点上(KV-aware routing)。但不同 workflow 的上下文长度涨得又快又没法预测,于是出现图里的局面:Node0(蓝)和 Node1(绿)的显存占用一个高一个低,红线是两者的绝对差——在 90 分钟的快照里,两节点差距超过 20% 的时间有 37 分钟以上,峰值差到 51%。一边已经在颠簸了,另一边却闲着,这部分闲置就是纯浪费。
中图和右图是第三个困境:对工具生命周期失明(tool lifecycle obliviousness)。工具编排器不知道 LLM 这边 workflow 到底结束没有,于是两头都出问题。一头是资源泄漏:中图里蓝色面积(累计磁盘占用)随处理过的 workflow 数线性往上涨,很快就顶穿红色虚线标的磁盘容量——因为跑完的 workflow 的 Docker 镜像、sandbox 根本没人回收,而真正在用的(橙色 active 部分)其实一直很低。长时间跑下来,磁盘爆了系统就挂。另一头是启动开销:右图里工具环境的平均准备时间随并发从 29.9s 涨到 47.2s——coding agent 开跑前得拉 Docker、装依赖、build 仓库,如果推理引擎傻等环境就绪,这段时间全算进端到端延迟里。
三个困境,一个共同的病根:系统没有“一整条 workflow”这个概念,它只看得见一个个孤立的请求和一个个孤立的 sandbox。
3. 核心抽象:把一整条 agentic workflow 看成一个“LLM Program”
病根找到了,解法自然浮出来:给系统补上“一整条 workflow”这个一等公民(first-class)的概念。ThunderAgent 把它叫作 Agentic Program(也就是摘要里的 LLM Program)。
这里要先澄清一个容易被误读的词。LLM Program 不是某个具体的模型、框架或产品,它是论文提出的一个调度抽象——把“一条会持续很多轮、横跨多次模型调用和多次工具调用的 agent 任务”抽象成一个带状态的调度单元。你可以类比成操作系统里的“进程”:操作系统不是以“单条指令”为单位调度 CPU 的,而是以“进程”为单位,因为进程才携带了完整的上下文(内存、打开的文件、运行状态)。ThunderAgent 做的事情几乎一样,只不过把“进程”换成了“一条 agent workflow”,把“内存/文件句柄”换成了“KV cache / 工具 sandbox / 端口”。
形式化地,一个 agentic program 被定义成一个六元组:
\[P = \langle ID,\ c,\ \mathcal{T},\ \mathcal{L},\ \tau,\ s \rangle\]每个符号的含义见下表。读这张表的时候,重点体会它刻意把四类信息塞进了同一个对象里:身份、执行阶段、工具环境、资源足迹、调度状态——正是前面三个困境各自缺失的那些信息。
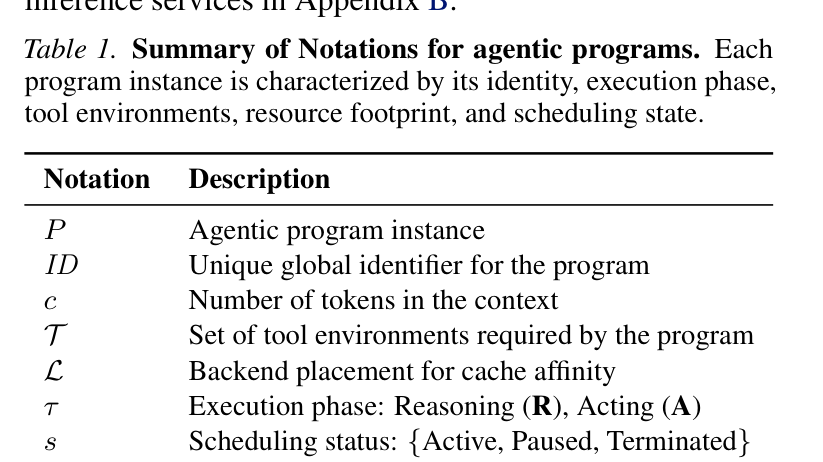
逐个走一遍:$ID$ 是全局唯一标识,系统靠它把来自同一条 workflow 的不同请求认出来、串成一条;$c$ 是上下文的 token 数,直接对应这条 workflow 当前占用的 KV cache 大小;$\mathcal{T}$ 是这条 workflow 用到的工具环境集合(哪些 sandbox、哪些端口),有了它才能在 workflow 结束时精确回收;$\mathcal{L}$ 是它当前落在哪个后端(backend placement),用于 KV 缓存亲和性;$\tau$ 是执行阶段,只有两种——Reasoning(R,在 GPU 上做推理)和 Acting(A,下了 GPU 在等/跑工具);$s$ 是调度状态,三选一:Active(正常运行)、Paused(被挂起、在等待队列里)、Terminated(已结束、可回收)。
别小看这个六元组。前面说的三个困境,之所以无解,本质都是因为“按单请求调度”的系统根本拿不到这些字段:它不知道 $c$(所以无法判断该驱逐谁的 KV 代价最小),不知道 $\tau$(所以分不清一个请求是“真结束了”还是“只是暂时在等工具”),不知道 $\mathcal{T}$(所以不知道该回收哪些 sandbox)。把这些信息显式建模出来之后,调度和资源管理才第一次有了“下判断的依据”。ThunderAgent 还有个很实用的设计:它直接包在现有 LLM 引擎和工具编排器外面,靠 OpenAI 风格的接口对接,接入几乎零成本——这点第 7 节看源码时会具体展开。
4. 有了抽象,调度就能写成一道“省内存”的优化题
有了 program 抽象,调度目标就能被量化。论文借用了一个很老的指标——Space-Time Product(STP,空间-时间乘积,Belady 1966),直觉是“占了多少内存 × 占了多久”,形式上是内存占用对处理时间的积分:
\[\text{Cost}_x = \int_0^{t_x} M(t)\, dt\]其中 $t_x$ 是某个过程 $x$(比如 prefill)的时长。因为 LLM 里的内存占用 $M(t)$ 可以直接用 KV cache 的 token 数来量化,所以这个 cost 实际就是“token 数对时间积分”。
把一次完整 agentic 推理的总开销按过程拆开,得到这个分解式:
\[\text{Cost}_{\text{total}} \approx \text{Cost}_{\text{decode}} + \text{Cost}_{\text{prefill}} + \text{Cost}_{\text{recompute}} + \text{Cost}_{\text{unused}} + \text{Cost}_{\text{caching}}\]这个式子是整篇文章的“棋盘”,值得停下来看清楚每一项是谁:前两项 $\text{Cost}{\text{decode}}$、$\text{Cost}{\text{prefill}}$ 是真正干活、贡献吞吐的有效开销,是要留的;后三项全是浪费,而且刚好一一对应第 2 节的三个困境——$\text{Cost}{\text{recompute}}$ 是 KV cache 颠簸带来的重算开销,$\text{Cost}{\text{unused}}$ 是跨节点内存不均里那些闲置显存,$\text{Cost}_{\text{caching}}$ 是 workflow 在跑工具期间“白占着显存却不干活”的那块缓存。
于是调度目标被精确地写成了一句话:在不爆显存的约束下,尽量把 $\text{Cost}{\text{recompute}}$、$\text{Cost}{\text{unused}}$、$\text{Cost}_{\text{caching}}$ 这三项浪费压到最小,从而把有效吞吐顶上去。 接下来的调度器和工具管理器,就是分别去削这三项。
5. program-aware 调度器:按状态暂停、按最短上下文驱逐、全局排队
调度器的全景在下面这张总览图里。先说怎么读:顶上是全局等待队列(Global Waiting Queue),中间一排是三个数据并行后端(Backend,可以理解成同一个模型的多个推理副本),右侧放大的是某个后端内部的程序状态和一个 Thrashing Monitor。颜色约定在图例里——青色方块是 Reasoning Program(在 GPU 上推理),橙色是 Acting Program(在跑工具);红箭头是 Pause,蓝箭头是 Restore。
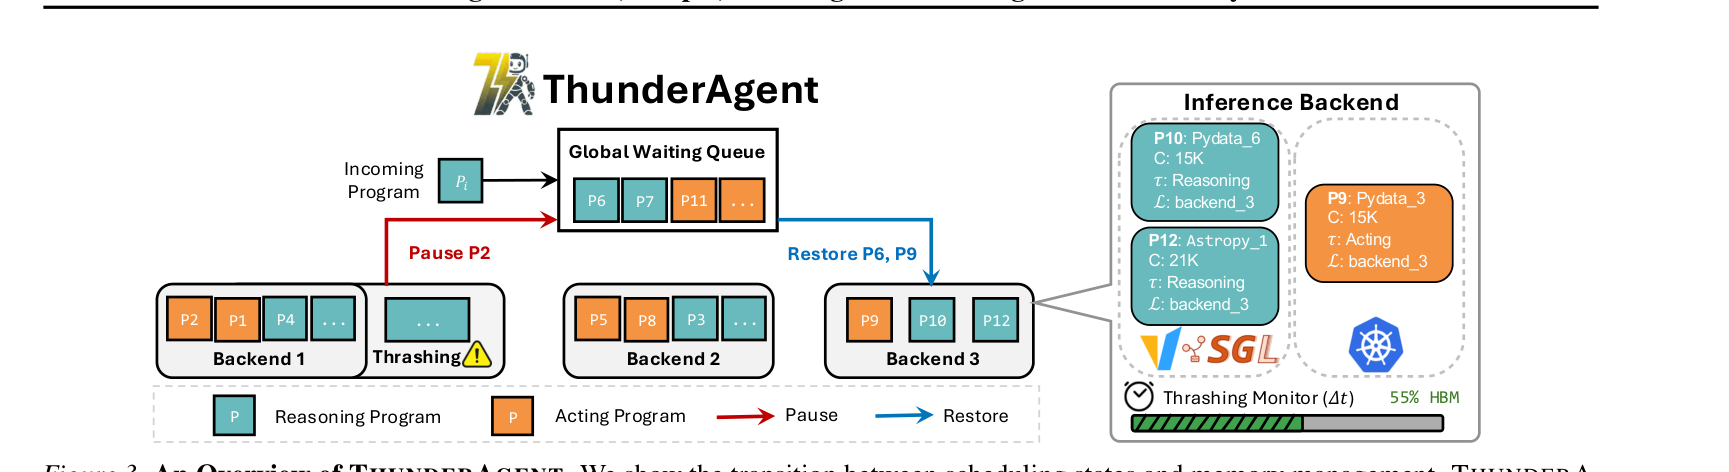
对着图走一遍一个完整的调度 tick:右下角的 Thrashing Monitor 每隔 $\Delta t$ 周期性地去查每个后端的显存状态(图里显示 HBM 用了 55%)。它发现 Backend 1 已经触发颠簸(显存需求超了容量,图上打了 Thrashing 警告),而 Backend 3 还很空。于是全局队列做两件事:一是对 Backend 1 执行 Pause P2(红箭头),把正在 Acting 的程序 P2 收回队列、释放它的 KV;二是把队列里的 Reasoning 程序 Restore P6、P9(蓝箭头)放到还有余量的 Backend 3 上去。右侧放大框里能看到每个程序携带的元数据,比如 P10: Pydata_6, C:15K, τ:Reasoning, L:backend_3——这正是第 3 节那个六元组的实例。一次 tick 同时干掉了 Backend 1 的颠簸和 Backend 3 的闲置。
把这张图拆成三个机制来讲。
机制一:周期性颠簸检测 + 按状态暂停(削 $\text{Cost}_{\text{recompute}}$)。 对某个后端 $\mathcal{L}$,颠簸条件就是程序的内存需求超过了容量:
\[\mathcal{C}_{\text{total}} < \sum_{p \in \mathcal{L}} c_p\]$\mathcal{C}{\text{total}}$ 是该后端 KV 缓存池的固定 token 容量。注意这里有个和基线的关键差别:像 Continuum 这类系统只在程序到达时检查一次要不要收它,而 agent 的上下文 $c_p$ 在 decode 过程中涨得飞快,可能跑到一半才突然把显存顶爆。ThunderAgent 改成每隔 $\Delta t$ 周期性地查,才能提前发现、提前缓解。一旦判定要颠簸,就调 Pause 挂起程序、释放显存,直到占用降回水位线以下;反过来后端有空间了,就从等待队列里 Restore 程序回来。论文用了高/低两条水位线 $\lambda{\max}$、$\lambda_{\min}$ 组成一个滞回窗口(hysteresis window),避免在临界点反复抖动(实测里两条线都设成 1 就够,因为程序间共享的 system prompt 本身预留了缓冲)。
机制二:时间衰减 + 最短优先驱逐(在“缓存”和“重算”之间做权衡)。 这是最精巧的一处。颠簸检测里,Acting 程序的那份 KV 要不要留?留着是 $\text{Cost}{\text{caching}}$(白占显存),扔了将来是 $\text{Cost}{\text{recompute}}$(工具一回来要重算)。论文用一个时间衰减函数 $f(t)$ 来动态权衡,把检测条件改写成:
\[\mathcal{C}_{\text{total}} < \sum_{p \in \mathcal{L},\, \tau=R} c_p + \sum_{q \in \mathcal{L},\, \tau=A} c_q \cdot f(t)\]$t$ 是 Acting 程序当前这步已经跑工具的时长。直觉是:一个工具调用等得越久,它那份缓存“马上就能用上”的指望越小,就该把它的有效内存权重调低、更倾向于驱逐它。论文还证明了一个漂亮的结论——当工具执行时间满足无记忆性(memoryless,剩余时长和已等时长无关)时,指数衰减是 $f(t)$ 唯一可取的形式。
那具体驱逐谁?这里有个反直觉但很硬的结论。先给引理:重算一个上下文长度为 $c_i$ 的程序,代价是随 $c_i$ 平方增长的:
\[\text{Cost}_{\text{recompute}} = \int_0^{t_{\text{recompute}}} c(t)\, dt \propto c_i^2\]于是“挑哪些程序暂停、既能腾够内存 $\Delta\mathcal{C}$ 又让重算代价最小”就变成一道优化题:
\[\min_{S}\ \sum_{i \in S} c_i^2 \quad \text{s.t.} \quad \sum_{i \in S} c_i \ge \Delta\mathcal{C}\]因为目标是平方和、约束是一次和,解是贪心地优先驱逐上下文最短的程序(短的重算便宜)。但光看长度不够,还得叠加状态优先级,于是恢复/暂停各用一个打分:
\[S_{\text{restore}}(P) = \frac{1}{c_P} + \mathbb{I}(\tau=R), \qquad S_{\text{pause}}(P) = \frac{1}{c_P} + \mathbb{I}(\tau=A)\]指示函数 $\mathbb{I}(\cdot)$ 让“状态”压过“长度”:暂停时优先挑 Acting 程序(它们在等工具、留着就是 $\text{Cost}_{\text{caching}}$),恢复时优先挑 Reasoning 程序(它们有待处理请求,放回去立刻能贡献 decode/prefill 吞吐)。
机制三:全局 program-aware 等待队列(削 $\text{Cost}{\text{unused}}$)。** 这招专治跨节点内存不均。关键洞察是:$\text{Cost}{\text{unused}}$ 只在“有程序被挂在等待队列里、同时某些副本却有空闲显存”时才产生;而一个程序一旦被 Pause,它的 KV 就已经被当作驱逐掉了,重算代价和落在哪个节点无关**(node-agnostic)。既然如此,就没必要再把它钉回原节点——把所有后端的等待队列合并成一个全局队列,恢复时按负载均衡放到任意有空余的副本上就行。这就实现了图里 P6、P9 从队列被 Restore 到 Backend 3 的“迁移”,在不牺牲 KV 亲和性的前提下把内存重新摊平。论文给了个上界:每个节点在 $\Delta t$ 周期内的闲置开销被压到 $\mathcal{C}{\text{unused}} < c{\min}\cdot\Delta t$,$c_{\min}$ 是被挂起程序里最短的那个上下文长度。
6. 工具资源管理:用程序终止信号回收 sandbox,异步预热环境
调度器削的是 GPU 显存那三项浪费,但第 2 节还有一类问题在 GPU 之外——工具侧的磁盘泄漏和启动开销。program 抽象在这里同样派上用场:既然程序显式带着 $\mathcal{T}$(它用到的工具环境集合)和 $s$(调度状态),工具资源的生命周期就能和程序状态严格绑定。
第一招,钩子式垃圾回收(hook-based GC)。 把工具资源的存续和程序的调度状态 $s$ 挂钩:当一个程序变成 Terminated,回收器立刻触发拆除序列,系统性地回收它的 sandbox、网络 socket、计算槽位。效果就是第 2 节图里那条橙色的 active 曲线——真正在用的磁盘始终维持在低位、近乎常数,不再有跑完却没人清理的 Docker 镜像线性堆积。
第二招,异步环境准备(asynchronous environment preparation)。 coding agent、science agent 开跑前要拉 Docker、装依赖,这段 I/O 密集的初始化很慢。ThunderAgent 的做法是追踪程序的执行依赖,趁 LLM 还在 Reasoning 的时候,就把下一步要用的工具环境异步地提前准备好,等真正需要分配 GPU 内存时环境已经就绪。本质是把环境初始化的时间藏到推理时间后面(overlap),对那种工具调用很频繁的 workflow,端到端延迟能省下一大截。
这两招都不需要用户改工具代码,只要在程序结束时给一个显式的 release 信号即可——怎么给,下一节看接口。
7. 从源码看 ThunderAgent:一个夹在 agent 和 vLLM 中间的调度代理
ThunderAgent 已经开源(ThunderAgent-org/ThunderAgent,MIT),还被 NVIDIA Dynamo 和 SkyRL 集成了进去。读一遍代码会发现,它的工程形态其实很轻:一个夹在 agent 客户端和 vLLM/SGLang 之间的 FastAPI 代理,自己不碰模型权重,只负责按 program 调度请求、管工具资源。
先看 program 抽象在代码里长什么样。论文那个六元组落到实现里,就是一个 dataclass:
# ThunderAgent/program/state.py
# class Program  (dataclass)
@dataclass
class Program:
    program_id: str                              # 对应 ID
    backend_url: Optional[str] = None            # 对应 L(落在哪个后端,paused 时为 None)
    status: ProgramStatus = ProgramStatus.ACTING # 对应 τ:REASONING / ACTING
    state: ProgramState = ProgramState.ACTIVE    # 对应 s:ACTIVE / PAUSED / TERMINATED
    context_len: int = 0
    total_tokens: int = 0                        # 对应 c(当前上下文 token 数)
    acting_since: Optional[float] = None         # 进入 ACTING 的时刻,用于算 f(t) 的 t
    marked_for_pause: bool = False               # REASONING 程序先标记、下轮再暂停
一一对得上:status 是 $\tau$(ProgramStatus 只有 REASONING/ACTING),state 是 $s$(ProgramState 是 ACTIVE/PAUSED/TERMINATED),total_tokens 就是 $c$。有意思的是 acting_since——它记下程序进入 Acting 的墙钟时刻,第 5 节那个 $f(t)$ 衰减里的 $t$ 就是用“现在 − acting_since”算出来的。
容量判断在 BackendState 里。下面这个 remaining_capacity 回答的是“这个后端还能塞多少 token”,返回负数就意味着已经超容(也就是颠簸条件 $\mathcal{C}_{\text{total}} < \sum c_p$ 成立):
# ThunderAgent/backend/state.py
# class BackendState
# def remaining_capacity(self) -> int   返回剩余可用 token 数(可为负 = 已超容)
def remaining_capacity(self) -> int:
    buffer = self.active_program_count * BUFFER_PER_PROGRAM   # 每个程序留 100 token decode 余量
    used = self.active_program_tokens - self.shared_tokens + buffer
    return self.cache_config.total_tokens_capacity - used
这里 shared_tokens 是程序间共享 prefix(system prompt 那段)省下来的 token,active_program_tokens 则是 reasoning_tokens + tool_coefficient × acting_tokens——注意 acting 程序的 token 带了个系数,这正是论文里给 Acting 程序打折的落点。举个具体例子:某后端容量 total_tokens_capacity = 200000,上面挂了 10 个程序、合计 active_program_tokens = 195000、shared_tokens = 20000,那么 used = 195000 − 20000 + 10×100 = 176000,remaining = 24000 > 0,还没颠簸;要是上下文再涨到 active = 225000,remaining 就变成 −21000,调度器下一个 tick 就会动手暂停程序。
第 5 节那个指数衰减,在代码里是实打实的 $2^{-t}$:
# ThunderAgent/backend/state.py
# class BackendState
# def remaining_capacity_with_decay(self) -> int   恢复逻辑用的"乐观"容量估计
for p in self._programs.values():
    if p.status == ProgramStatus.ACTING and p.acting_since is not None:
        t = now - p.acting_since
        acting_decayed += p.total_tokens * (2.0 ** -t)   # 等得越久,权重越小
论文配置里写的 $f(t)=x^{-t}$、默认 $x=2$,和这里的 2.0 ** -t 正好对上;默认检测周期 $\Delta t$ 对应 config 里的 scheduler_interval = 5.0 秒。
核心的调度循环在 MultiBackendRouter 里,是一个每隔 scheduler_interval 秒跑一次的后台协程。每个 tick 干三件事,顺序和论文完全一致:
# ThunderAgent/scheduler/router.py
# class MultiBackendRouter
# async def _scheduled_check(self)   周期性调度:拉指标 -> 恢复 -> 检测颠簸并暂停
async def _scheduled_check(self):
    for backend in self.backends.values():
        await backend.fetch_metrics()                 # 1. 拉最新显存指标
    await self._greedy_resume()                       # 2. 从全局队列恢复等待程序
    for url, backend in self.backends.items():        # 3. 逐后端检测颠簸
        if backend.cache_config and backend.remaining_capacity() < 0:
            await self._pause_until_safe(backend)
_pause_until_safe 把“最短优先 + 状态优先”这条策略写得很直白——先暂停 token 最少的 Acting 程序,Acting 没得暂停了才去标记 token 最少的 Reasoning 程序:
# ThunderAgent/scheduler/router.py
# class MultiBackendRouter
# async def _pause_until_safe(self, backend)   把后端挂到不超容为止
while backend.remaining_capacity() < 0:
    acting = self._get_acting_programs_sorted(backend.url, ascending=True)  # 升序=最短在前
    if acting:
        program_id, state = acting[0]
        self._pause_program(program_id, state)        # 真正释放 KV、挪进全局队列
        continue
    reasoning = self._get_reasoning_programs_sorted(backend.url, ascending=True)
    if reasoning:
        program_id, state = reasoning[0]
        self._mark_program_for_pause(program_id, state)  # Reasoning 在 GPU 上,先标记下轮再收
        continue
    break
这里 ascending=True 就是对应打分公式里 $1/c_P$ 的最短优先,而“先 Acting 后 Reasoning”就是指示函数 $\mathbb{I}(\cdot)$ 那层状态优先级。被暂停的程序通过 _pause_program 挪进 self.global_waiting_queue(一个所有后端共享的 dict)——这就是第 5 节那个全局等待队列的实体。恢复侧的 _greedy_resume 则用 Best-Fit-Decreasing 装箱,把等待程序按“Reasoning > 新程序 > Acting”的优先级、挑剩余容量最大的后端放回去,这就实现了跨节点迁移。
最后看接入成本,这是它敢自称 simple 的底气。对使用者来说,只要在原本的 OpenAI 请求里多塞一个 program_id,再在 workflow 结束时打一个 release 信号就行:
# README:改造一个已有 agent 的 OpenAI 调用,只加 extra_body
extra_body = {"program_id": "unique_id"}
# 如果工作流用到 docker,可一并声明,交给 ThunderAgent 回收
# extra_body["docker_ids"] = ["docker_id1", "docker_id2"]
openai.client.chat.completions.create(model=..., messages=messages, extra_body=extra_body)
服务端 app.py 里,get_program_id() 会依次从 payload["program_id"]、extra_body、X-Session-ID 请求头里把 id 解析出来(SkyRL 这类已经按 session 路由的框架可以直接复用 session id),再走 /v1/chat/completions;程序结束时 POST 一下 /programs/release 带上 program_id,就触发第 6 节的钩子式回收。OpenAI 风格的接口和其它请求字段原样不动——这就是为什么它能近乎零成本地插到 vLLM/SGLang 和现成 agent 框架之间。
8. 实验:吞吐 1.5-3.6×、KV 命中率拉回 ~100%、磁盘省 4.2×
实验覆盖了 coding(SWE-Agent、OpenHands)、routing(ToolOrchestra)、科学发现(ScienceAgent)多类 agent,模型从 GLM-4.6 到 Qwen3-235B,硬件从 RTX 5090 到 H100 集群,吞吐指标统一用 steps/min(一个 step = 一轮 reasoning + acting)。默认配置 $\Delta t=5$、$f(t)$ 取 $x=2$,推理引擎用 vLLM。
先看服务(serving)吞吐。下面这张六宫格,每格是一个“工作流 × 模型”组合,横轴是并发数,三条线分别是 vLLM(蓝)、Continuum(绿)、ThunderAgent(橙)。怎么读:盯住橙线在高并发端相对蓝线的倍数标注,再对比绿线能追到多少。
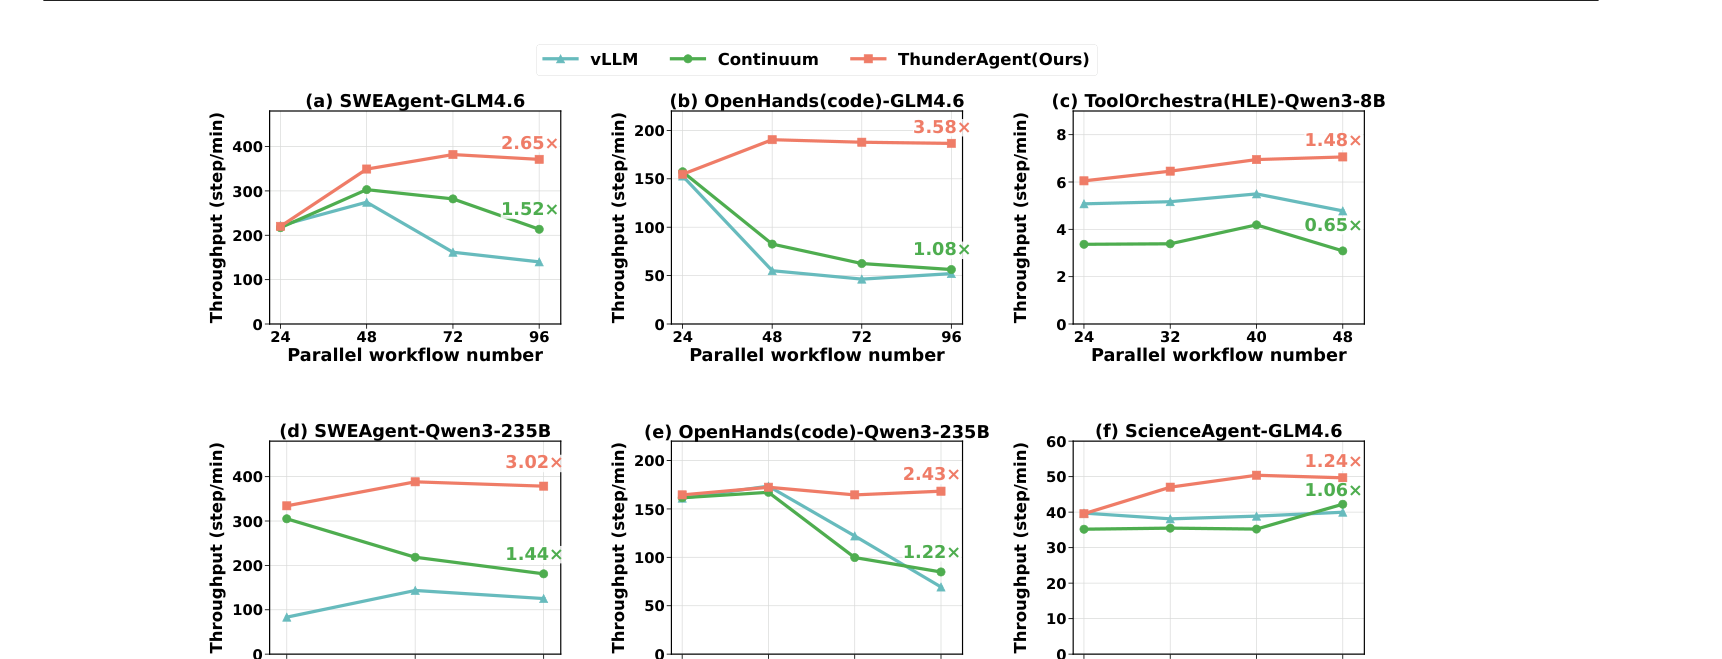
规律很清楚:ThunderAgent(橙)几乎在每一格、每一个并发点都压在最上面。在工具调用时间可预测的那几格(a/b/d/e),相对 vLLM 的加速能到 2.43-3.56×——比如 (b) OpenHands-GLM4.6 到 3.58×、(d) SWEAgent-Qwen3-235B 到 3.02×;而 vLLM 从并发 48 开始就因为颠簸往下掉。在工具时间随机的那两格(c ToolOrchestra、f ScienceAgent),因为工具时长没法预测、缓存该不该留更难判断,提升收窄到 1.24-1.48×,但依然是最好的。整体上,论文给的区间是比 vLLM 快 1.48-3.58×、比 Continuum 快 1.17-3.31×。
吞吐为什么能上去,答案在 KV 命中率这张图。读法和上面一样,纵轴换成了 KV cache 命中率。
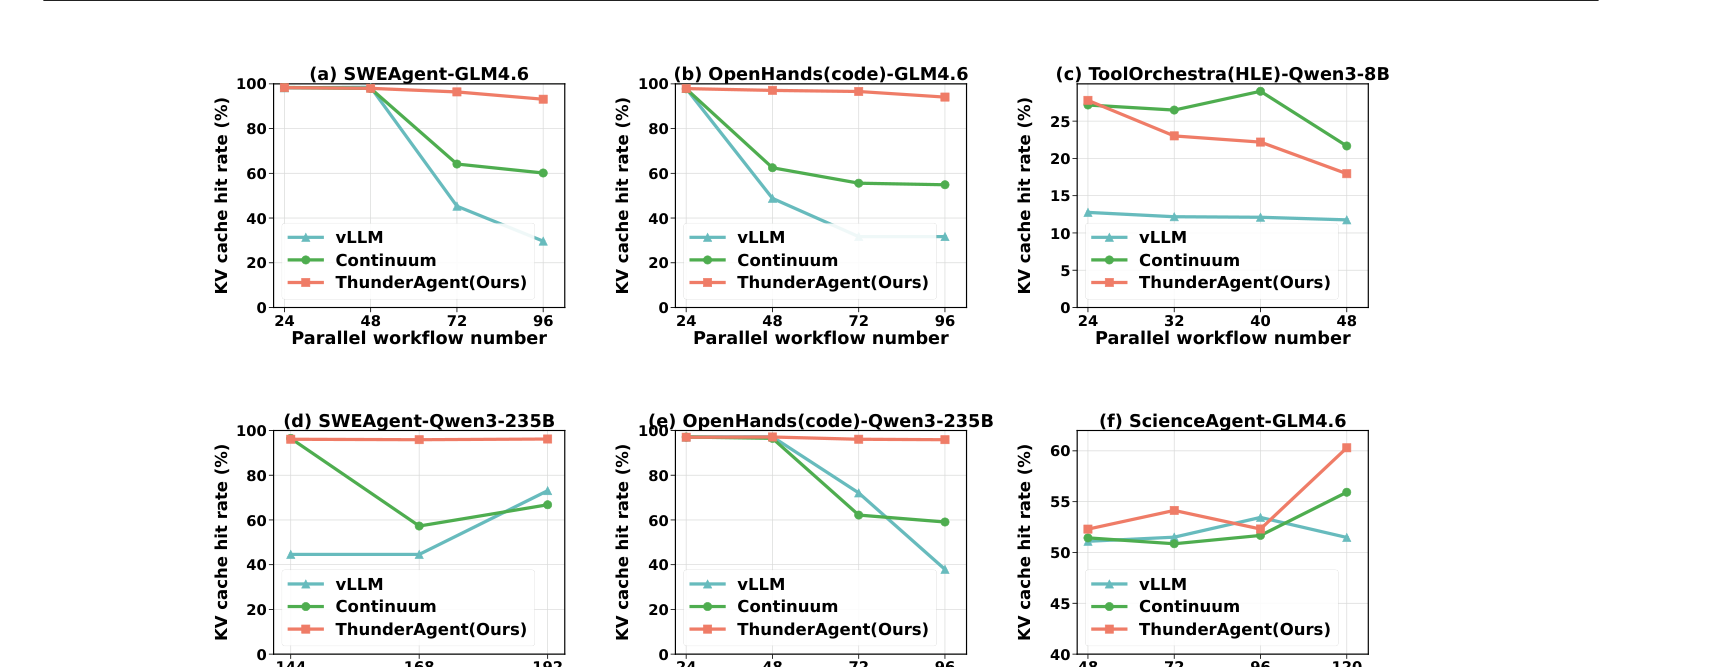
在可预测的 a/b/d/e 四格里,ThunderAgent(橙)稳稳贴着顶部、维持在近乎 100%(Mini-SWE-Bench 和 OpenHands 上 ≈100%),而 vLLM(蓝)和 Continuum(绿)随并发一路下滑——(a) 里 Continuum 从 >90% 掉到 ~60%,vLLM 更是掉到 ~30%。这张图和吞吐图是因果关系:命中率守住了,重算就省了,吞吐自然顶上去。值得一提的是 c、f 两格——这里 ThunderAgent 的命中率反而不是最高的。这不是 bug 而是设计:面对随机工具时间,它会主动用一部分 KV 命中率去换更高的算力利用率(宁可少缓存点、也别让 GPU 空等),所以命中率让一让,总吞吐反而更高。这种“该缓存时缓存、该重算时重算”的动态权衡,正是第 5 节那个 $f(t)$ 在起作用。
延迟拆解和参数敏感性在下面这张图。左边 (a) 把端到端延迟按 Decode / Env / Prefill / Disk 拆开对比 vLLM 和 ThunderAgent,右边 (b) 扫 $\Delta t$ 和 $f(t)$ 里的 $x$ 看吞吐稳不稳。
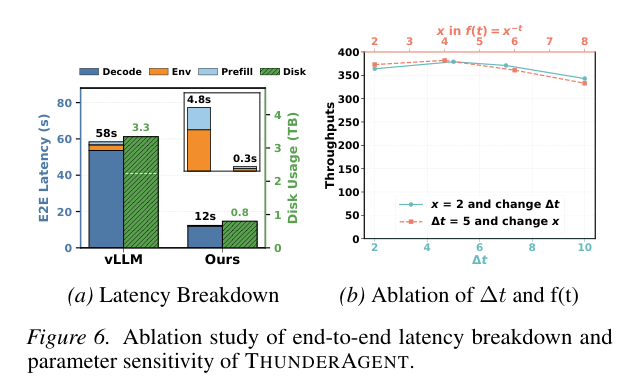
左图读下来:vLLM 的端到端延迟 58s、ThunderAgent 只要 12s,省下来的主要就是 prefill 和 decode(颠簸没了,重算就没了)。右上角那个小插图是工具侧——Env+Prefill 从 4.8s 压到 0.3s,靠的是第 6 节的异步环境预热。磁盘占用从 3.3 TB 降到 0.8 TB,也就是约 4.2× 的磁盘节省,来自钩子式回收;论文还点明工具资源管理这块单独贡献了大约 10% 的延迟改善。右图 (b) 想说明的是鲁棒性:$\Delta t$ 在 2-10、$x$ 在 2-8 的范围内扫,吞吐都稳在高位,不用精调超参——对真实部署很重要。
RL rollout 这条线收益更大。在 GLM-4.6、$N=144$、两台 8×H100 的设置下,mini-SWEAgent 的吞吐从 vLLM+Gateway 的 375.4 提到 671.8(1.79×),OpenHands 从 69.1 提到 270.8(3.92×)。整体 RL rollout 的区间是 1.79-3.92×。OpenHands 收益更夸张,是因为它是重初始化工作流(每个 sandbox 磁盘占用超过 10GB,而 mini-SWEAgent 才 2GB),异步预热和资源回收在它身上省得最多。
扩展性方面,论文测到 ThunderAgent 的吞吐能在最多 64 张 H100 上近线性扩展;相比 SGLang 的 Cache-Aware Routing 基线,加速比从 2 节点的 1.79× 拉大到 8 节点的 2.39×——节点越多,跨节点内存不均越严重,全局队列的价值越凸显。而全局调度器本身不是瓶颈:每个 tick 的通信延迟从 2 节点的 13.5ms 亚线性涨到 8 节点的 22.7ms,远低于秒级的单步推理延迟。
9. 总结
ThunderAgent 真正值钱的不是哪个具体机制,而是那个 program 抽象本身。它点破了一件被忽视很久的事:当 LLM 从单轮 chatbot 变成多轮 agent,推理系统的调度单元也该跟着从“请求”升级到“程序”。一旦系统拥有了“一整条 workflow”这个一等公民,三件原本各自为战的苦差——KV cache 颠簸、跨节点内存不均、工具生命周期失明——就能被收进同一个成本模型里统一优化:按状态暂停、按最短上下文驱逐、按时间衰减权衡缓存与重算、全局排队摊平内存、按程序终止信号回收 sandbox。
这套思路和 MoE 推理里“全量加载 vs 稀疏激活”的那个核心矛盾其实同源——瓶颈往往不在算子有多快,而在系统有没有恰当的抽象去描述真实负载的结构。agent 负载的结构就是“长程、多轮、带状态、工具交织”,而请求级系统恰恰把这个结构抹平了。把结构还给调度器,收益就自己长出来了。它能被 NVIDIA Dynamo、SkyRL 直接吸纳,也说明这个抽象确实踩中了工程落地的真需求。
顺带扯一句题外话。我们前阵子把 AutoML、神经架构搜索和 LLM 优化方向的一些积累整理成了一本《动手学 AutoML:从 NAS 到大语言模型优化实战》。这本书的落点更偏“模型本身怎么被自动设计和压缩”(NAS、剪枝量化、模型融合、LLM 驱动的 AutoML),和这篇讲的 agentic 推理系统、KV cache 调度算是相邻但不同的方向——一个在优化“模型长什么样”,一个在优化“模型怎么被高效地服务起来”,角度不同,但追求“把算力花在刀刃上”的目标是一致的。对自动化模型设计这条线感兴趣的朋友可以翻翻。
