ICML'26 | UniBoost:抛开长度预测,用软优先级调度治 LLM 推理的“尾延迟”
ICML’26 | UniBoost:抛开长度预测,用软优先级调度治 LLM 推理的“尾延迟”
原文:Beyond Prediction: Tail-Aware Scheduling for LLM Inference
1. LLM 服务的用户体验,是被“尾延迟”卡住的
你让一个 LLM 写代码补全,或者跑一个 agent 任务,大多数时候几秒就回来了,可偶尔会卡住转圈十几秒——更离谱的是,同一个 prompt 跑两次,等待时间可能差一个数量级。对线上 serving 系统来说,决定口碑的从来不是”平均快不快”,而是”最慢的那一小撮请求有多慢”。
这件事在系统领域有个专门的名字:尾延迟(tail latency)。它不看平均值,而是把所有请求的延迟从小到大排好,专门盯住排在 90%、95%、99% 位置上的那几个值,记作 P90、P95、P99。举个例子,P99 延迟 = 2 秒,意思是”每 100 个请求里,有 99 个都比 2 秒快,只有最惨的 1 个会更慢”。平均延迟漂亮没用,用户记住的是他正好撞上的那次长时间卡顿。
LLM 推理的延迟还得拆开看,因为一个请求的生命周期分成性质完全不同的两段:
- prefill 阶段:把你的 prompt 一次性并行编码进模型,算力密集、一轮就能跑完。从请求到达、到模型吐出第一个 token 的这段时间,叫 TTFT(Time To First Token,首 token 时延),越低越好——它对应你盯着屏幕”还没开始出字”的那段干等。
- decode 阶段:之后模型自回归地一个 token 接一个 token 往外蹦,每一步都要读一遍历史的 KV(后面会细讲),显存和带宽密集。相邻两个输出 token 之间的间隔叫 TBT(Time Between Tokens,也有人叫 TPOT),越低越好——它决定了”打字机”吐字顺不顺。
把这两段加起来,从请求到达到最后一个 token 吐完的端到端总时长,叫 TTLT(Time To Last Token,端到端时延),同样越低越好。对聊天这种流式场景,用户可能只在乎 TTFT 和 TBT;但对代码生成、agent、推理(reasoning)这类”要等一个完整结果才能用”的任务,真正决定体验的是 TTLT,而且是 P95/P99 的 TTLT。
为什么偏偏是尾部?因为线上 serving 基本都是 SLO(Service Level Objective,服务质量目标)约束的——运营方会定一条线,比如”P99 TTLT 必须压在 X 秒以内”,然后在这个前提下尽量多塞请求。能扛多大的负载,取决于系统在突发流量和长短混杂的请求下,尾延迟会不会爆。于是衡量一个调度器好不好,关键指标就成了 SLO attainment(达标率,满足 SLO 的请求占比,越高越好)和高分位的 TTLT。
论文一开始就点出一个很多人会忽略的坑:只盯平均 TTFT/TBT 会被带偏。原因有两条。第一,token 级的平均值不会”组合”成端到端的好结果——每个 token 慢一丁点,均摊下来 TBT 看着还行,可一旦生成很长,这些小延迟累加起来,P99 的 TTLT 就塌了。第二,平均值会把分布的病态藏起来——一个偏爱短请求的策略,可能让长请求饿死、或者制造队头阻塞,平均 TTFT 很好看,尾部 TTLT 却惨不忍睹。一句话:平均最优不等于尾部稳健,这正是这篇论文要翻的那块地。
2. 主流调度都在押注同一件事:decode 长度可预测
要理解这篇论文在跟谁较劲,得先看看现在的 LLM 调度器都怎么做。
排队论里有个经典结论:当每个任务的大小已知时,短作业优先能最小化平均响应时间。对应两个策略:SJF(Shortest Job First,短作业优先)——谁短谁先跑;以及它的抢占式版本 SRPT(Shortest Remaining Processing Time,剩余处理时间最短优先)——谁剩得少谁先跑,必要时把正在跑的长请求踢开。这两个策略在”任务大小已知”的理想世界里是均值最优的。
问题是,LLM 请求的”大小”= prefill 长度 + decode 长度,而 decode 长度在请求到达时是未知的(模型没生成完,谁也不知道它要吐多少字)。于是这几年的调度器几乎都在做同一件事:想办法预测 decode 长度(或者请求之间的长短排序),再去近似 SJF/SRPT。代表作有几类:
- LTR(Learning-to-Rank,Fu et al. 2024):训一个模型预测生成长度,按预测长度排序来近似 SJF,论文里报了平均和 P90 的 TTFT、TBT 改善。
- TRAIL(Shahout et al. 2024):用 embedding 预测”还剩多少 token”,据此做抢占式调度,并加一个阈值来减少后期抢占。
- SPF(Shortest Prefix First):vLLM/SGLang 里的启发式,干脆不预测 decode,直接拿已知的 prefill 长度当总长度的代理。省事,但 TTLT 和吞吐都保不住。
这些方法有两个共同点:都依赖”预测”或”排序”,也都主要汇报均值类指标。而这篇论文要攻的第一个点就是:decode 长度这个东西,本质上就预测不准。
2.1 请求长度不只是”变化大”,而是分布会在轻尾和重尾之间漂移
先看请求长度到底有多野。下面这张图把两种 workload 的 token 分布画出来了,怎么读:每个子图左边是 CDF(累积分布,纵轴是”有多少比例的请求长度不超过横轴值”),右边是概率密度;蓝色是 prefill 长度,橙色是 decode 长度;每条分布上的四条竖线从左到右分别是均值、中位数、P95、P99。重点看橙色 decode 这条,以及 P99 竖线被甩出去多远。
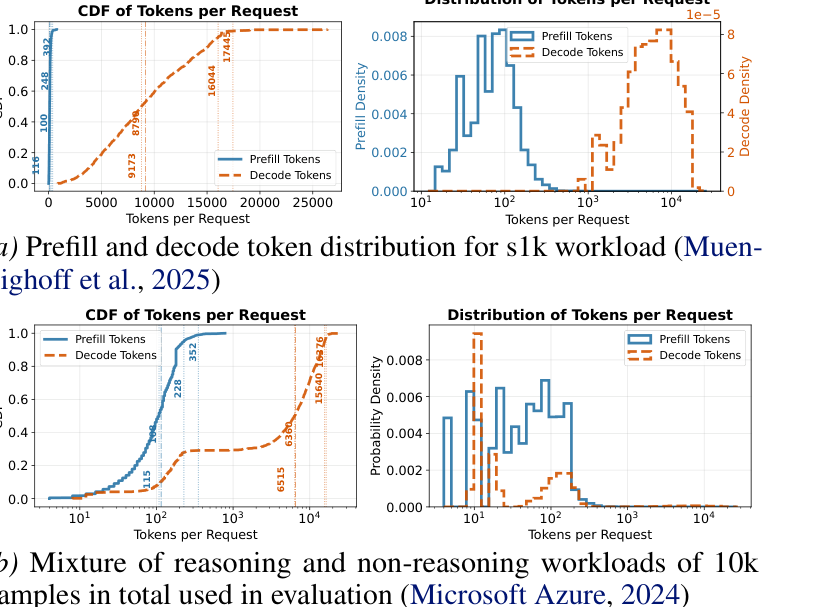
上面一行 (a) 是 s1k 推理 workload:decode 长度相对集中,属于轻尾(light-tailed)——绝大多数请求长度都在一个量级内,P99 没被甩太远。下面一行 (b) 是推理+非推理混合的 workload(评测里用的那种):decode 分布明显重尾(heavy-tailed)——大部分请求不长,但尾巴拖得极远,P99 能到一万六千多个 token。轻尾和重尾是两种性质完全不同的分布,一个策略在其中一种上好用,换到另一种上可能就翻车(这个坑第 3 节会展开)。更麻烦的是,线上流量会在这两种形态之间漂移,白天聊天多、半夜 reasoning 任务多,分布一变,调度策略的最优选择也跟着变。
2.2 就算模型和 prompt 都固定,输出长度照样抖得厉害
有人会说:分布漂移可以靠在线重新预测嘛。但论文接着给了一个更扎心的证据——哪怕锁死模型、锁死 prompt,同一个输入重复跑,输出长度依然抖得没法预测。
下面这张图怎么读:横轴是从三个数据集(WildChat 聊天、BigCodeBench 代码、S1K 推理)里随机挑的几个 prompt,纵轴是输出 token 数;上下两行分别是 Qwen-2-7B 和 DeepSeek-R1-Distill-Llama 两个模型;每个 prompt 用同样的配置、温度 0.6 跑了 20 次,画成小提琴图(violin plot,越胖的地方表示落在该长度的次数越多)。
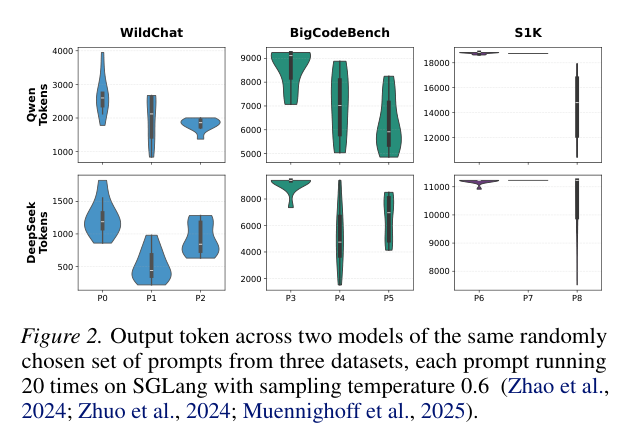
小提琴越”高瘦”说明方差越大。可以看到几乎每个 prompt 的输出长度都散成一条,而不是集中在一个点。论文用变异系数 CV(Coefficient of Variation = 标准差/均值,衡量相对波动,越大越不稳定)量化了一下:聊天任务里 Qwen 的 CV 落在 $[0.10, 0.35]$、DeepSeek 在 $[0.22, 0.47]$;代码任务 Qwen 稳一点($[0.10, 0.20]$),DeepSeek 却能飙到 $[0.07, 0.46]$;推理任务 S1K 比较分裂,有的 prompt 想法发散、有的被系统约束卡成死循环或者直接拒答,CV 反而低一些。但总体结论很硬:输出长度的方差来自采样本身的随机性和数值不确定性,是生成式模型的固有属性,不是换个更好的预测器就能消掉的。
换句话说,预测驱动调度押的那个注——”decode 长度可预测”——地基本身就是松的。但真正有意思的还在后面:退一万步,哪怕给你一个完美的长度预言机,尾延迟也治不好。
3. 更麻烦的是:就算预测完美,尾延迟照样失控
这一节是整篇论文的”痛点源头”,值得慢慢讲。
先把问题摆正:SJF/SRPT 是均值最优的,但它们对尾部不提供任何保证。这不是实现问题,是理论性质——队列论早有结论,在一些温和条件下,处理器共享(PS)和 SRPT 的”逗留时间衰减率”可以差到和 PLCFS(抢占式后到先服务)一个水平,也就是最差的那一档。直觉上也说得通:一个一门心思把短请求往前塞的策略,必然要反复牺牲长请求,而尾延迟恰恰是被长请求、被那些被反复打断的请求定义的。
所以这里的核心矛盾是:预测驱动调度优化的是均值,用户体验卡的是尾部,这两个目标在关键时刻是打架的。 下面这张表把各类调度器摊开对比,怎么读:每一行是一类策略,列从左到右是几个关键能力——能不能扛重尾/轻尾分布、要不要依赖长度预测(No Size Prediction 打勾表示”不需要预测”)、抢占开销、是不是天生面向尾部、以及有没有真的拿 TTLT 做过评测。勾是满足,叉是不满足,三角是部分满足。
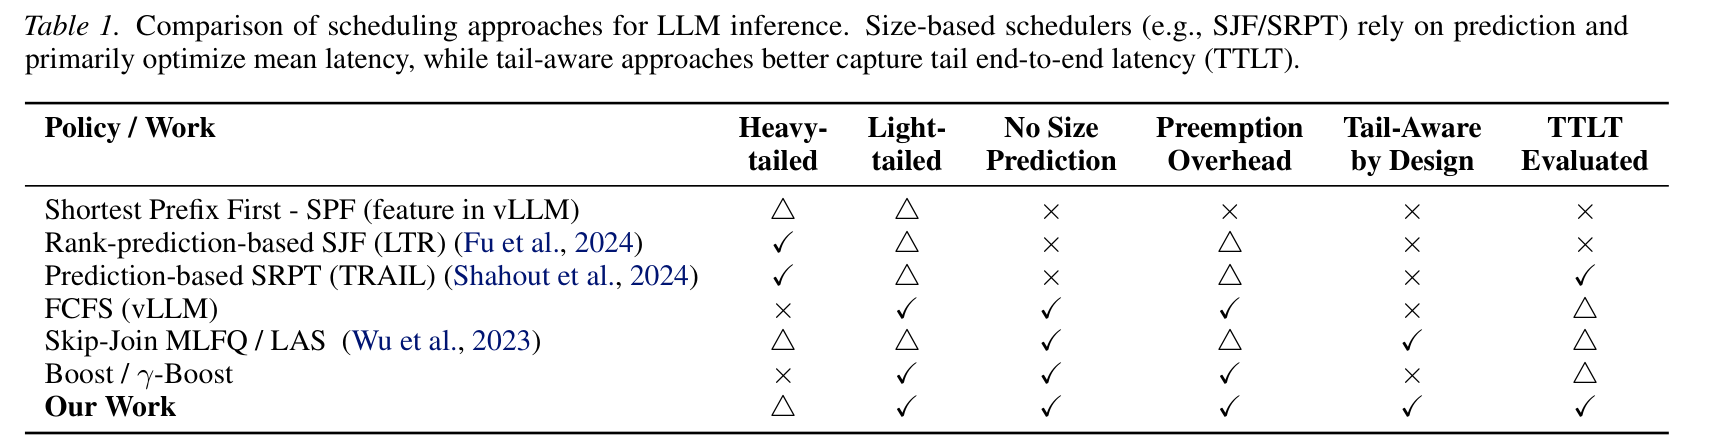
顺着这张表扫一眼就能看出格局:SPF、LTR、TRAIL 这些预测驱动的方法,”No Size Prediction”那列全是叉——它们都得靠预测;而且”Tail-Aware by Design”那列也基本是叉——它们天生不是为尾部设计的。FCFS 和 γ-Boost 走的是另一路,不需要预测,但各有短板。最后一行 Our Work(也就是 UniBoost)是唯一一个在”不需要预测”“抢占开销可控”“天生面向尾部”“真的测了 TTLT”四项上都占住的。
那为什么不预测反而可能更稳?关键在于——没有任何一个策略能通吃。论文用一组很精巧的调度时序图把这件事画死了。下面这张图怎么读:左右两个场景,每个场景里竖着排了 5 行,分别是 FCFS、SRPT、LAS、Boost($\gamma$=0.01)、Boost($\gamma$=100)五种策略;横轴是执行步(一个个 batch);每个小格子是某个请求在该步被处理的 token(橙色是 prefill、蓝色是 decode、绿色是混合);右侧标了每种策略的 Mean(平均延迟)和 Max(最大延迟)。先看左场景的 FCFS 和 SRPT 的 Mean,再看右场景它们的 Max。
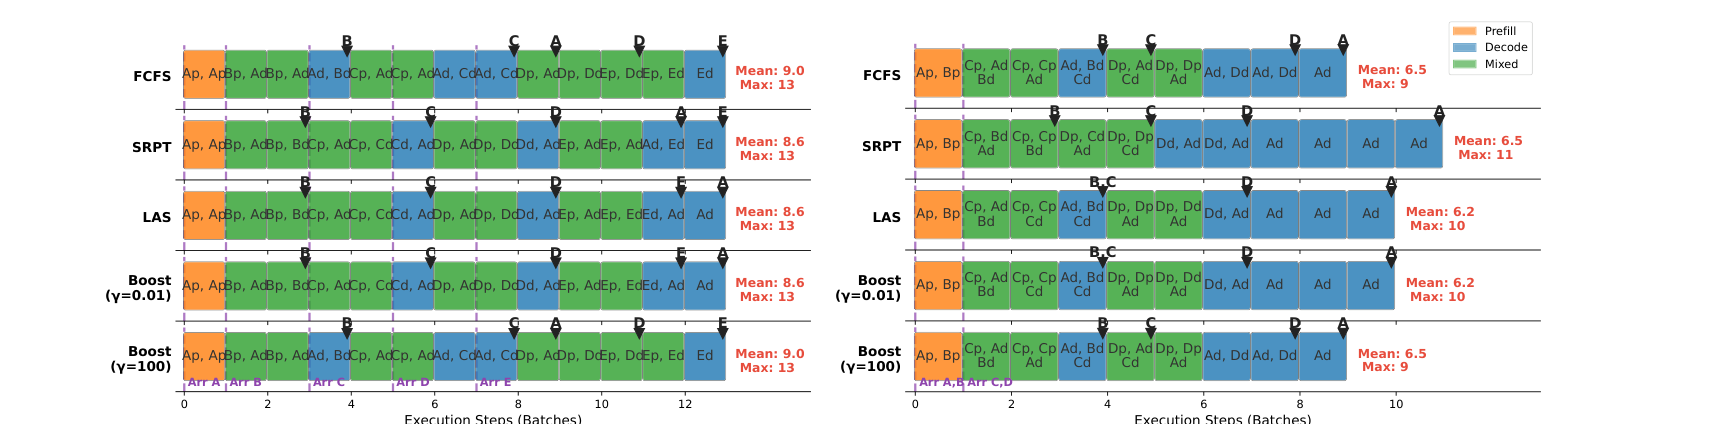
五行策略里,FCFS 和 SRPT 前面已经交代过,Boost 待会儿细讲,还剩一个 LAS(Least-Attained-Service,已服务最少优先)要补一下:谁到目前为止被服务得最少,就优先谁,等价于操作系统里 Foreground-Background 调度、也就是多级反馈队列 MLFQ 的理想连续形式。它的特点是不需要知道任务大小(non-clairvoyant),靠”已经跑了多久”这个可观测量来逼近”谁更短”,但它在轻尾分布下没有保证,道理和 SRPT 类似。
左场景——队头阻塞(HoL blocking),这是 FCFS 的软肋。 一个长请求 A(decode=8)在 $t=0$ 先到,后面陆陆续续来了 B、C、D、E 几个短请求。这里要先解释一个行话:队头阻塞(Head-of-Line blocking)就是”一个长请求堵在队头,后面的短请求全得排队干等”。FCFS 老老实实先来后到,A 把路堵死,Mean 被抬到 9.0。SRPT 和 LAS 看出 A 很长,果断把它抢占(preempt)掉、先服务短请求,Mean 降到 8.6。这一局,预测/抢占类策略赢。
右场景——抢占惩罚(preemption penalty),这是 SRPT 的软肋。 现在换成一批短请求 B、C、D 几乎和 A 同时涌进来(突发到达)。SRPT/LAS 死守”短的优先”的教条,于是反复抢占 A——每次有短请求进来就把 A 踢下去,A 的完成被一拖再拖,Max 被顶到 11。反观 FCFS,不折腾 A,Max 只有 9。这一局,老实排队的 FCFS 反而赢了,而且 SRPT 多付出的抢占没换来任何 Mean 上的好处。
把两个场景并在一起看,结论就立住了:FCFS 在”长请求挡路”(convoy)时死于均值,SRPT/LAS 在”突发短请求”时死于尾部。没有赢家。 而且注意,右场景里 SRPT 用的是完美的长度信息——它就是知道 A 长、B/C/D 短,照样把尾部搞砸了。这就印证了那句话:尾延迟失控的根子不在”预测得准不准”,而在”要不要为了短请求去反复牺牲长请求”这个策略取向上。 预测得再准,只要你的策略是”硬排序、短的无条件优先”,突发一来尾部照炸。
那条出路,图里其实已经埋好了:Boost 这一族。$\gamma$=100 时它的行为和 FCFS 一模一样(左场景 Mean 9.0、右场景 Max 9,都和 FCFS 齐平),$\gamma$=0.01 时它又退化成 LAS(左场景 Mean 8.6、右场景 Mean 6.2)。同一个策略,靠调一个参数 $\gamma$ 就能在 FCFS 和 SJF/LAS 两个极端之间平滑地滑动。 既然没有哪个极端能通吃,那能不能根据当前分布,自动滑到合适的位置?这正是 UniBoost 的出发点。
4. 换个赌注:不预测长度,用“软优先级 boosting”盯住尾部
UniBoost 的核心主张可以一句话概括:不要去硬预测谁长谁短,而是以”先到先服务”为底盘,叠加一层平滑的、连续的优先级微调,专门把尾部压下去。 这个思路来自近几年队列论里”尾最优调度(tail-optimal scheduling)”的进展,论文把它工程化落到了 LLM 引擎上。
4.1 boost:给每个请求一个”软加分”,而不是硬排序
先讲理论里的那个关键武器——γ-Boost(Yu & Scully 2024)。它的做法是:每个请求不按预测长度排序,而是按一个叫 boosted arrival time(提升后的到达时间)的量来排——也就是”到达时间减去一个 boost 加分”,谁的值小谁先服务。boost 加分越大,相当于把它的”虚拟到达时间”往前挪,优先级越高。
boost 加分怎么算?对一个已经被服务了 $w$ 单位(在 LLM 里就是已经处理/生成的 token 数,叫 attained service)的请求,boost 函数定义为:
\[b_\gamma(w) = \frac{1}{\gamma} \log\left(\frac{1}{1 - e^{-\gamma w}}\right), \quad \gamma > 0\]请求 $i$ 在时刻 $t$ 的优先级分数就是:
\[\phi_i(t) = a_i - b_\gamma(w_i(t))\]其中 $a_i$ 是到达时间,$w_i(t)$ 是它到目前为止被服务的量,调度器每次挑 $\phi_i(t)$ 最小的那个请求服务。
这个式子长得吓人,但它的直觉非常漂亮。$b_\gamma(w)$ 对 $w$ 是单调递减且凸的——在 $w$ 接近 0(请求刚进来、还没怎么跑)时很陡,跑了一会儿之后就趋平。意思是:刚进来的新请求会拿到一个较大的 boost,被稍微往前照顾一下;但一个请求跑得越久,它继续获得的额外加分越少。 这就实现了”适度偏向短请求,但不至于让一个老长请求被无限插队”的效果——这正是第 3 节两种失败模式之间的那条中间道路。
而参数 $\gamma$ 就是那个”滑块”,它控制”已服务量换算成优先级”的速率,两个极端是:
- $\gamma \to \infty$:$b_\gamma \to 0$,于是 $\phi_i \to a_i$,优先级完全由到达时间决定——这就是 FCFS,老实排队,不折腾长请求,保护尾部。
- $\gamma \to 0$:boost 的主导项变成 $\frac{1}{\gamma}\log\frac{1}{\gamma w}$,两个请求之间的 boost 差距约为 $\frac{1}{\gamma}\log(w_2/w_1)$,当 $\gamma$ 很小时这个差距趋于无穷,于是已服务最少的请求永远赢——这就退化成 SJF/LAS,一门心思追均值。
在合适的服务分布和到达率条件下,这类 boost 策略能做到强尾最优(strongly tail-optimal)。论文用了一个很硬核的定义——尾最优常数:
\[K_\pi = \sup_{\pi^* \in \Pi_{\text{blind}}} \limsup_{t \to \infty} \frac{P[T_\pi > t]}{P[T_{\pi^*} > t]}\]这里 $\Pi_{\text{blind}}$ 是所有”不知道精确任务大小”的策略集合,$T_\pi$ 是策略 $\pi$ 下的响应时间。直白说,$K_\pi$ 衡量的是”策略 $\pi$ 的尾部,比最优的盲策略差多少倍”。$K_\pi = 1$ 就意味着:你不需要知道任务大小,也能把尾部做到和最优盲策略一样好。 γ-Boost 在适当条件下就能拿到 $K_\pi = 1$(Harlev et al. 2025 把它推广到了未知大小的情形)。这从理论上回答了第 2 节结尾那个问题:优化尾延迟,确实不需要预测。
4.2 四阶段设计:从 strawman 到完整的 UniBoost
理论很美,但直接把 γ-Boost 搬进 LLM 引擎会撞上一堆现实问题。LLM 推理和经典队列有三点本质不同:它是有状态、显存耦合的(decode 中的请求攒着大 KV cache,抢占贵);它是并行批处理的(continuous batching 让”服务速率”一直在变,违反经典 M/G/1 假设);它的 workload 还混着轻尾和重尾。所以论文没有一步到位,而是分四个阶段,一层层把问题补上。下面这张总览图怎么读:左边方框是四个阶段(Phase 1-4)层层递进,中间是 $\gamma$ 如何在两种分布间插值,右边是最终落到的两种调度目标。
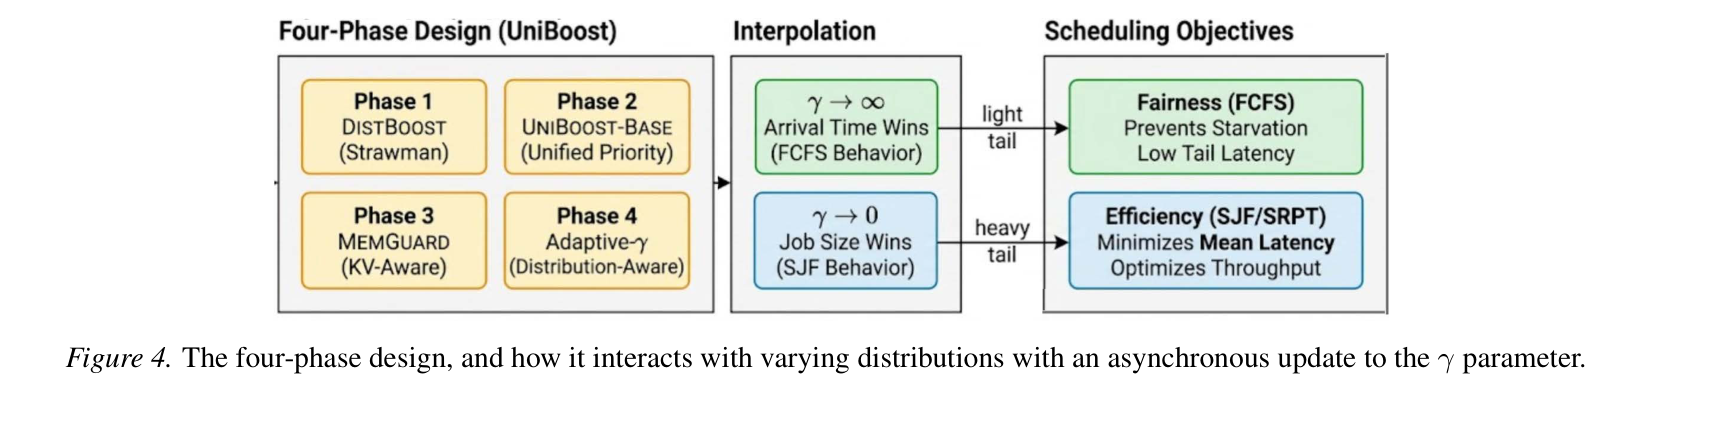
顺着图从左到右走一遍:四个阶段分别是 Phase 1 的 DistBoost(strawman 原型)、Phase 2 的 UniBoost-Base(统一优先级)、Phase 3 的 MemGuard(KV 感知)、Phase 4 的 Adaptive-$\gamma$(分布感知)。中间的插值说的就是上一节那个滑块:当分布偏轻尾时,$\gamma$ 往大走($\gamma \to \infty$),”到达时间说了算”,表现为 FCFS,防饿死、压尾部;当分布偏重尾时,$\gamma$ 往小走($\gamma \to 0$),”任务大小说了算”,表现为 SJF,追均值、保吞吐。右边的两个目标框——Fairness(FCFS) 和 Efficiency(SJF/SRPT)——正是这根滑块的两端。下一节逐个拆这四个阶段。
5. 把 boosting 塞进 LLM 引擎,要跨过四道坎
5.1 Phase 1:DistBoost——把 prefill 和 decode 分开排的 strawman
第一版最朴素的想法(论文叫它 strawman,稻草人原型)是沿用 Sarathi 的 chunked prefill 思路,把 prefill 和 decode 当成两个独立的调度问题。这里先把两个工程词交代清楚:continuous batching(连续批处理)是 vLLM 的核心,每一轮 iteration 都能动态地往 batch 里加入新请求、移除已完成的请求,而不是等整批跑完;chunked prefill(分块预填充,Sarathi 提出)是把一个长 prompt 的 prefill 切成固定大小的小块,和正在 decode 的请求塞进同一个 batch 跑,用来平衡 TTFT 和 TBT。
DistBoost 把请求按阶段分进两个队列:prefill 队列 $Q_p$(还没填完 prompt 的)和 decode 队列 $Q_d$(已经在生成的),各算各的优先级——prefill 请求用 $\phi^{\text{pre}}i(t) = a_i - b\gamma(s^{\text{pre}}i)$($s^{\text{pre}}_i$ 是已知的 prefill 长度),decode 请求则简单按它进入 decode 队列的时间排。每轮先从 $Q_d$ 里选最多 $B{\max}$ 个 decode 请求,剩下的空位再用 chunked prefill 填(每块最多 $C$ 个 token)。
它的毛病很快暴露:两个队列各自为政,会产生跨队列的队头阻塞。如果 decode 队列里堆了一堆长 reasoning 请求把带宽占满,一批本该很快的短 prefill 请求就卡在 $Q_p$ 里出不来——TTFT 直接崩。根子在于 prefill 和 decode 被切成了两个互不相让的世界。
5.2 Phase 2:UniBoost-Base——把两个队列合并成一个统一优先级空间
Phase 2 的修法很直接:不要两个队列,合成一个统一的优先级空间,允许跨阶段的抢占和提升。 关键是定义一个”有效工作量” $\tilde{w}_i(t)$,把 prefill 和 decode 两段统一成同一把尺子:
\[\tilde{w}_i(t) = \max\left(w_i(t),\, s^{\text{pre}}_i\right)\]直觉是:一个请求”已经干了多少活”,要么看它已处理的 token 数 $w_i(t)$,要么看它至少得先填完的 prefill 长度 $s^{\text{pre}}_i$,取大的那个。于是全局优先级就统一成一个式子:
\[\Phi(i, t) = a_i - b_\gamma\left(\tilde{w}_i(t)\right)\]调度器每次在整个活跃集合 $A(t) = Q_p(t) \cup Q_d(t)$ 里挑 $\Phi$ 最小的请求。prefill 和 decode 现在排在同一个序里竞争,谁该优先一目了然,跨阶段的队头阻塞就消了。
合并之后要处理抢占。朴素做法是”只要有人优先级更高就抢”,但这样会抖——两个请求优先级在临界线上反复横跳,就会反复抢占。所以 Phase 2 加了一个迟滞(hysteresis)保护:只有当某个请求 $j$ 的优先级比当前正在跑的 $i_{\text{curr}}$ 高出一个阈值 $\delta_{\text{hyst}}$ 时,才真的触发抢占:
\[\exists j \in A(t): \Phi(j, t) < \Phi(i_{\text{curr}}, t) - \delta_{\text{hyst}}\]这就像恒温器留一个温差死区,不让它一到临界点就疯狂开关。但光有这个阈值还不够——真正贵的是 KV cache 的搬运,这就要靠 Phase 3。
5.3 Phase 3:MemGuard——用”量化优先级”把抢占次数压成对数级
这是整个设计里和 LLM 系统耦合最深的一层,也是”cache-aware preemption(抢占时考虑 KV 搬运成本)”的落点。
先说清楚为什么 LLM 的抢占特别贵。decode 阶段每个请求都在往 KV cache 里攒东西——KV cache 是注意力机制里缓存的 key/value 向量,每生成一个 token 就追加一份,请求跑得越久它越大。一旦要抢占一个 decode 中的请求,它的 KV 要么被 swap 到 CPU 内存(之后再 swap 回来),要么干脆丢掉等重算,这两种都是实打实的开销。这就是论文反复强调的 memory-coupled decode(显存耦合的 decode):请求的”抢占代价”随它已跑的时长线性增长。如果像 Phase 2 那样允许每个 token、每个 microbatch 都重算优先级,显存一紧,就会频繁换入换出,KV cache 被反复搬运,throughput 直接被 thrashing(抖动/颠簸)吃掉。
MemGuard 的办法是离散化”优先级允许变化的时机”。它对已服务量 $w_i$ 做一个几何量化(geometric quantization),$k$ 是粒度参数:
\[\hat{w}_i = k \cdot 2^{\lfloor \log_2(\max\{w_i, k\}/k) \rfloor} \in \{k, 2k, 4k, \ldots\}\]也就是把连续的”已跑了多少 token”砍成 $k, 2k, 4k, 8k, \dots$ 这样成倍增长的台阶。只有当 $\hat{w}_i$ 跨过一个台阶时,才重新计算这个请求的优先级 $\Phi$;而且一旦某个请求被派去执行,在它到达下一个台阶之前不可被驱逐(non-evictable),保证它至少跑够一个”最小服务量”再说,把 KV 搬运的成本摊薄。
这个几何台阶带来一个很漂亮的性质——抢占机会是对数级的。因为台阶是成倍涨的,一个 decode 长度为 $S_i$ 的请求,一辈子最多只会触发 $1 + \lfloor \log_2(S_i/k) \rfloor$ 次优先级修订(也就是最多被重新考虑抢占这么多次)。论文取 $k = 256$(对齐 GPU 内部的 tile 结构)。代入算一下:一个 decode 长达 10000 token 的超长请求,$1 + \lfloor \log_2(10000/256) \rfloor = 1 + \lfloor \log_2 39 \rfloor = 1 + 5 = 6$,最多只被换进换出 6 次。相比”每 token 都可能被抢”,这是天壤之别。
下面这张图把 MemGuard 的效果画出来了,怎么读:横轴是已完成的 token 数,纵轴是 boost 值;虚线是连续的 boost 曲线,粗实线/粗虚线是量化后的阶梯曲线;深浅两组对应两个不同的 $\gamma$。看阶梯是怎么”咬住”连续曲线的。
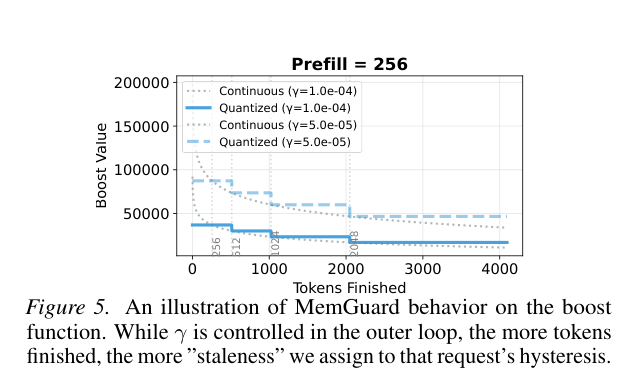
对着图走一遍:平滑虚线是原始 γ-Boost 的 boost 值,随 token 增加平滑衰减;MemGuard 把它替换成那条阶梯状的粗线——在 256、512、1024、2048 这些台阶之间,boost 值保持不变,优先级就不会重算,请求也不会被抢。只有跨过台阶的那一刻才”跳”一下。论文把这个效果形象地叫做:请求完成的 token 越多,我们就给它的迟滞分配越多”staleness(陈旧度)”——跑得越久的请求越”黏”在当前位置,越不容易被反复折腾。这正好对应了”长请求抢占贵、就少折腾它”的物理直觉。
5.4 Phase 4:Adaptive-γ——让滑块自己跟着分布走
最后一块拼图回到那个滑块 $\gamma$。第 4 节说了 $\gamma$ 大像 FCFS、小像 SJF,但最优的 $\gamma^*$ 到底取多少,取决于到达率 $\lambda$、系统利用率 $\rho$、以及任务大小分布的尾部指数——这些都是随时间漂移的。拍一个固定值,分布一变就次优。
Phase 4 的做法是在线估计:它不预测任何单个请求的长度(继续保持 prediction-free),而是盯着整体响应时间的尾部形状。具体地,在 P95 到 P99 这段上界尾部 $[t_{95}, t_{99}]$ 里,对经验尾分布做对数线性拟合,估一个有效的指数尾率,更新式为:
\[\hat{\gamma}_{t+1} = -\frac{\ln \bar{F}_T(t_{99}) - \ln \bar{F}_T(t_{95})}{t_{99} - t_{95}}\]其中 $\bar{F}T$ 是响应时间的经验尾分布,$t_p$ 是经验 P 分位延迟。拿到新估计后再用 EMA(指数滑动平均)平滑一下、裁剪到 $[\gamma{\min}, \gamma_{\max}]$ 区间,避免抖动。注意这几个量——P95、P99 分位,是系统自己就在统计的轻量运行时信号,不需要任何额外的预测模型,这正是”用统计信号代替预测”的字面意思。
下面这张图展示它在真实突发流量下的行为,怎么读:左边是 Azure Function Trace 的请求到达率随时间变化(可以看到极度突发,尖峰能冲到 50+ req/s),右边是 UniBoost 的 $\gamma$ 跟着这股流量自动调整的轨迹。对照着看两条曲线的起伏关系。
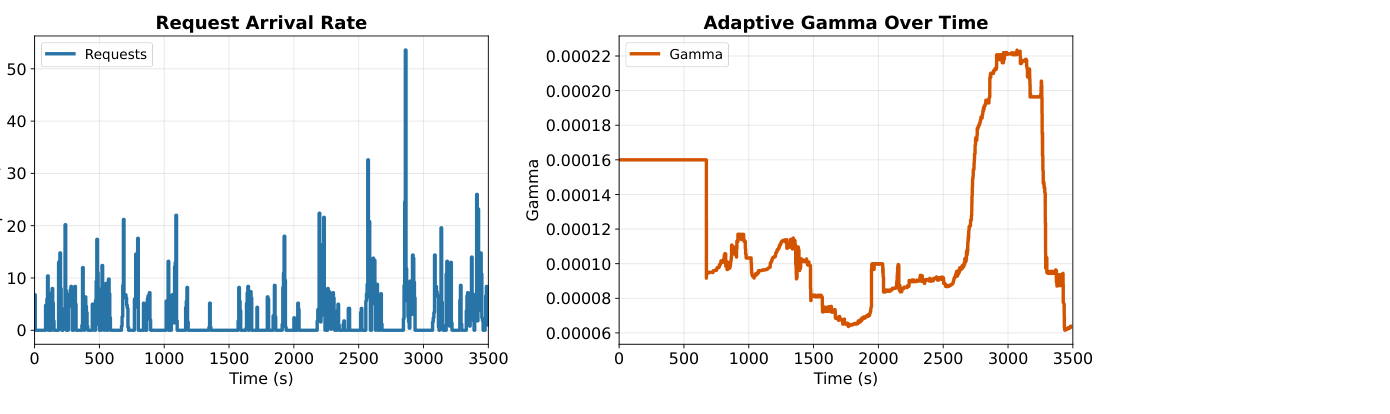
对着图走一遍:左图那些密集的尖刺就是突发到达,流量忽高忽低;右图的 $\gamma$ 不是一条直线,而是在 $0.00006$ 到 $0.00022$ 之间来回爬动——流量平稳时它待在一个水平,一旦负载和分布形态变了,它就顺势滑到新的工作点。整个过程没有人工调参,也没有预测任何请求的长度,全靠对尾部分位的在线观测。 这就是论文说的”distribution-aware(分布感知)”:策略跟着分布漂移自动走,而不是赌一个固定的分布。
5.5 合起来:一页算法看全貌
把四个阶段拼起来,就是完整的 UniBoost。下面这张算法图可以对照着看它一轮调度到底干了什么,怎么读:Require 行是输入参数(KV 容量 $B$、microbatch 上限 $M$、chunk 大小 $c$、bin 粒度 $k$、初始 $\gamma$),然后是一个 while 大循环,重点看第 4 行的 $\gamma$ 更新、第 6-10 行的优先级计算、以及第 13-25 行的”按 KV 预算组 batch + 必要时换出”逻辑。
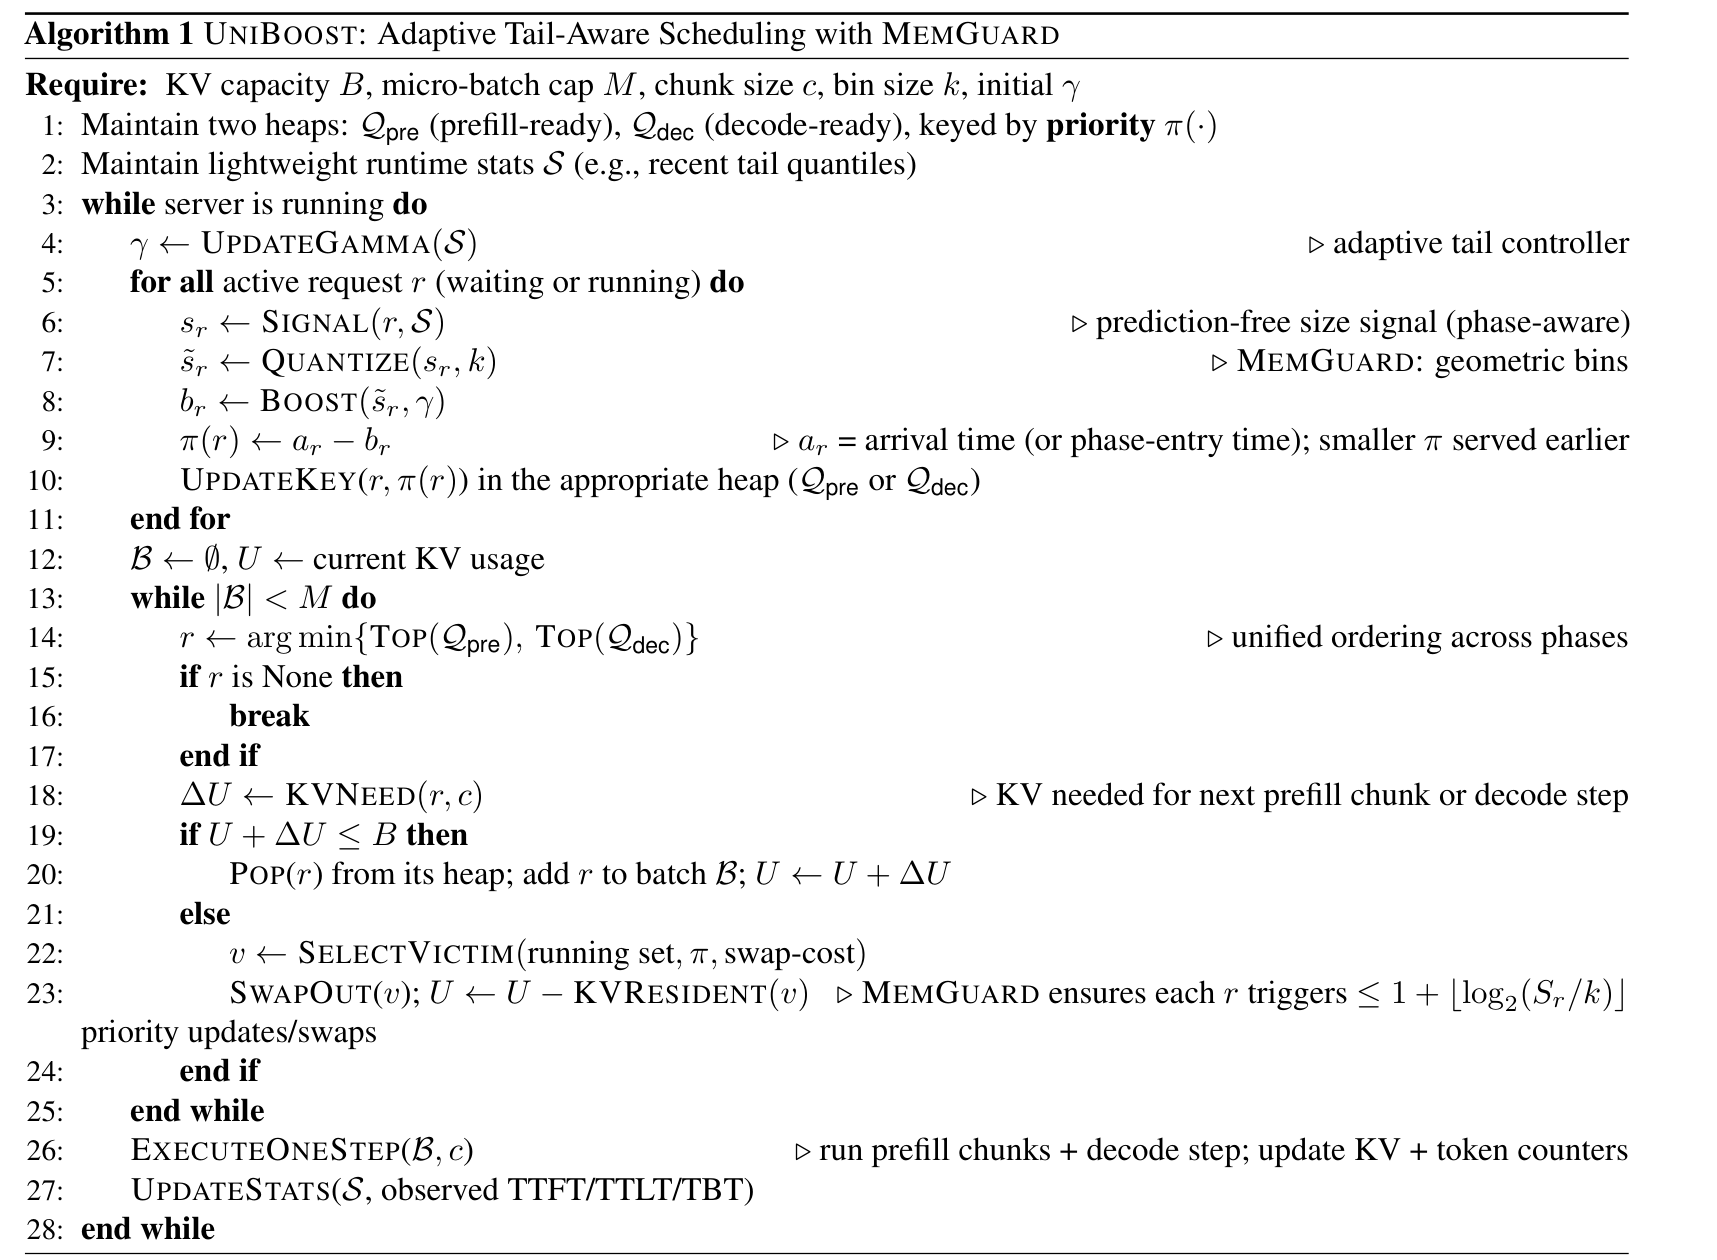
对着算法走一遍主线:每一轮先 UpdateGamma(第 4 行,Phase 4 的自适应控制器)更新滑块;接着对每个活跃请求,用 Signal 取一个prediction-free 的大小信号(第 6 行——prefill 阶段就用已知的 prompt 长度,decode 阶段就用”已生成的 token 数”,全是可观测量,不预测未来),再 Quantize 成几何台阶(第 7 行,Phase 3),算出 boost(第 8 行),得到优先级 $\pi(r) = a_r - b_r$(第 9 行,越小越先服务)。然后进入组 batch 的内层循环(第 13-25 行):从 prefill/decode 两个堆里按统一优先级取堆顶(第 14 行,Phase 2),算一下它这一步需要多少 KV(KVNeed,第 18 行),如果 KV 预算够就加进 batch,不够就按优先级 + 换出成本选一个”受害者”swap 出去(第 22-23 行)——而 MemGuard 保证了每个请求触发的换出次数是对数级的(第 23 行的注释)。最后执行一步、更新统计量(第 26-27 行)供下一轮的 UpdateGamma 用。整个闭环只依赖”到达时间、已处理 token 数、近期尾分位”这几个轻量信号,没有任何长度预测模型。
6. 效果:尾延迟、SLO、吞吐,还有“会不会饿死长请求”
实验在一台 8×A100-80GB 的 DGX 上做,模型覆盖 Llama-3-8B、CodeLlama-34B、QWen-72B,workload 用了 Azure 对话 trace、ShareGPT、s1k 推理数据集,还特意造了两个混合流量(mix-1 两成推理、mix-2 七成推理)。为了只考察调度器本身,他们关掉了 radix cache 和 prefix caching。基线是一组很强的对手:Sarathi(vLLM v1 / SGLang 的默认连续批处理)、SJF(LTR+,带完美预测)、LAS(MLFQ+)、SRPT(TRAIL+,带完美预测)。注意后两个 oracle 基线是”开了天眼”的——给它们完美的长度信息,就是要证明 UniBoost 在不预测的情况下也能打赢开天眼的对手。
6.1 主结果:和”完美预测的 SRPT”正面刚
下面这张表是和 TRAIL+(完美预测的 SRPT,作为 0% 基准)比的相对表现,怎么读:行是各调度器,列分成 End-to-End(TTLT)、TTFT、TBT 三组的 Mean/P95/P99 再加吞吐;正值表示比 TRAIL+ 更好,绿色是改善、黄/橙/红是不同程度的退化。重点看最后一行 UniBoost 的 TTFT 和 P99 TTLT 那几格。
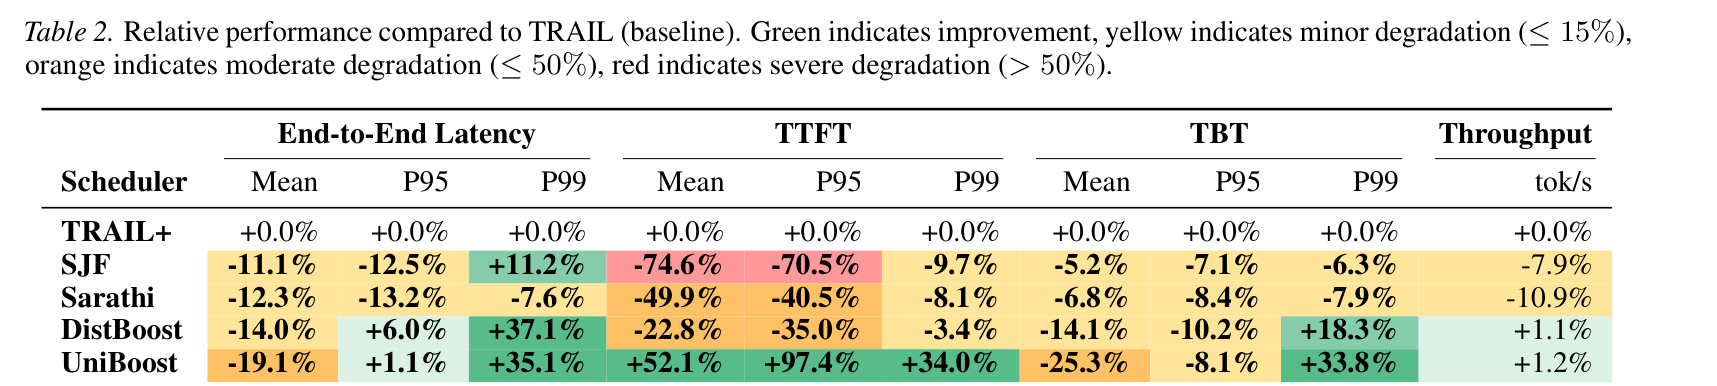
对着表走一遍,先说漂亮的地方:UniBoost 在 P99 TTLT 上 +35.1%(端到端尾延迟比开天眼的 SRPT 还低三成半),P95 TTFT 高达 +97.4%、Mean TTFT +52.1%、P99 TTFT +34.0%——首 token 时延几乎是碾压式的改善,吞吐还小涨 +1.2%。这对应论文摘要里那句”P99 TTLT 比完美预测的 SRPT 低 35–50%、TTFT 低 34–47%”。
但要诚实地看另一面:UniBoost 在 Mean E2E 上是 −19.1%、Mean TBT −25.3%,也就是说它主动牺牲了一部分均值指标去换尾部。这其实完全符合它的设计取向——它是 tail-aware 的,均值不是它的优化目标。放在”用户体验由尾部决定”的前提下,这个取舍是划算的:拿你本来就不太在乎的平均 TBT,换回了尾部 TTFT/TTLT 的大幅改善。表里 DistBoost(strawman)也能在 P99 TTLT 上拿 +37.1%,但它 TTFT 退化(−22.8%),因为它偏袒 decode 队列、把 prefill 饿着了——这也反过来说明 Phase 2 把两个队列合并是必要的。
6.2 鲁棒性:三种失败模式,UniBoost 一个都不犯
主结果是单一 workload,论文还想证明这套方法在不同失败模式下都稳。下面这张图把各基线相对 UniBoost 的”落后幅度”按分位画出来(QWen-72B 推理 workload,$\rho = 0.99$ 的高负载),怎么读:三个面板分别是 TTFT、TTLT、TBT,横轴是分位(P50 到 P99.9),纵轴是”比 UniBoost 慢多少百分比,越高说明那个基线越拉胯”,UniBoost 自己是贴着 0 的那条灰线。看每条曲线在高分位(右侧)是怎么甩上去的。
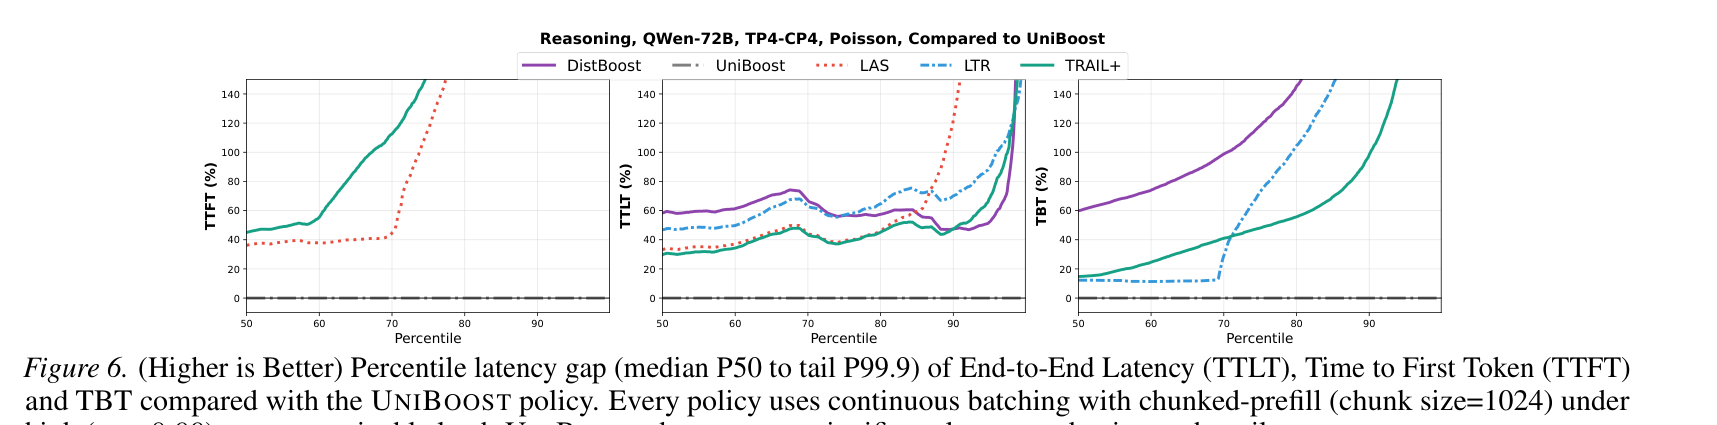
三个面板对应论文总结的三种失败模式:
- TTFT 面板(左):大多数基线从 P50 就开始落后,而且越到尾部掉得越狠。原因是”prefill 准入病”——prefill 不被显式保护时,会被 decode-heavy 的 microbatch 反复往后挤,一旦来一波长 reasoning 的 decode,新请求连第一个 token 都迟迟吐不出来。UniBoost 靠分布感知的优先级不让 prefill 被 decode 无限推迟。
- TTLT 面板(中):所有基线在中段还勉强,一到尾部就分叉暴涨。这是典型的”attained-service 反转 + 显存耦合”正反馈——LAS/SRPT 偏爱已服务少的请求,新请求不断插队到长 decode 前面,活跃请求数变多 → KV 压力变大 → 驻留更久 → 吞吐更低、排队更长 → 尾部 TTLT 更糟,恶性循环。
- TBT 面板(右):DistBoost 全程偏慢,LTR 则是先平后崩——过度偏袒 decode 会让并发 decoder 变多、每 token 争用加剧;而 LTR 这种基于长度排名的阈值切换很脆,一旦越过某个负载/混合阈值就”翻盘”,触发尾部爆炸。
一句话:这三种模式分别对应 prefill 被饿、长 decode 被反复打断、以及 decode 过度集中,UniBoost 用一个平滑的 $\gamma$ 旋钮同时把这三头都按住了。
6.3 消融:四个阶段各自贡献了多少
既然是四阶段层层叠加,自然要看每一层到底值不值。下面这张图用负载-延迟曲线做消融,怎么读:三个面板是 P90、P99、Mean 延迟,横轴是实际承受的负载(QPS,每秒请求数),纵轴是延迟(对数轴,ms)。曲线有个急转弯叫”膝点(knee)”——过了膝点延迟就垂直飙升、系统崩掉。看谁的膝点更靠右(能扛更高负载),以及膝点处谁的尾部更低。
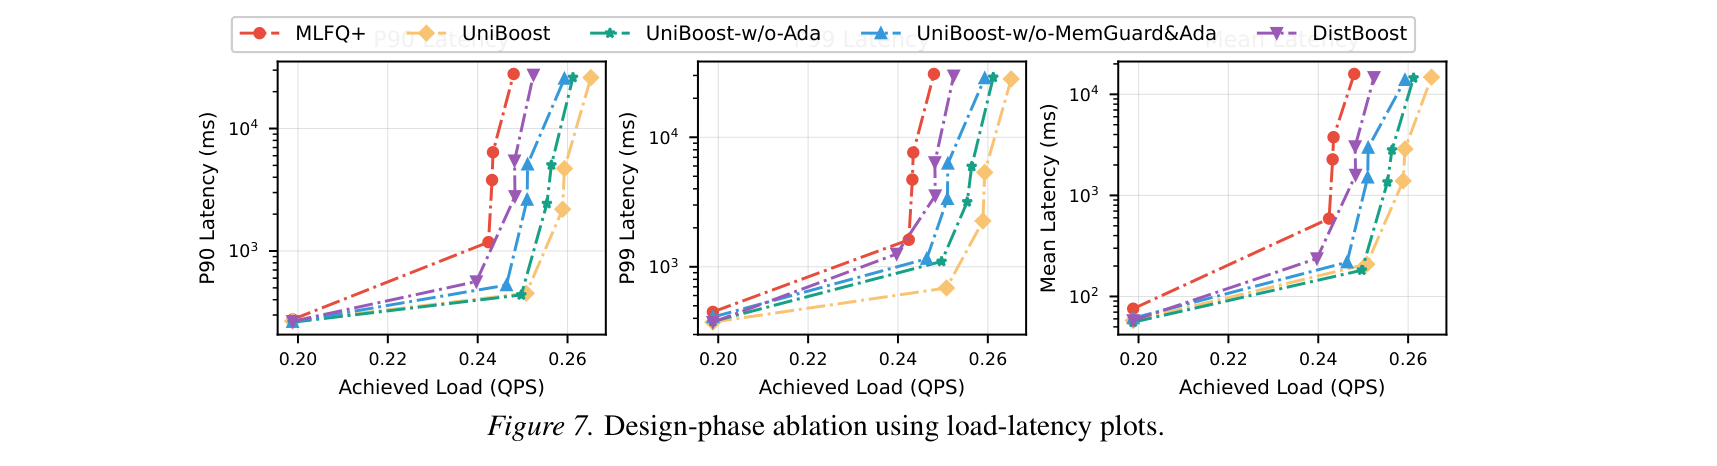
对着图从差到好走一遍(CodeLlama-34B,单 GPU):DistBoost(strawman)最先崩,0.24 QPS 时 P90/P99 就从几百毫秒蹿到好几秒;换成 Phase 2 的统一优先级,膝点往后推,0.248 QPS 附近 P99 大致砍半;再加上 Phase 3 的 MemGuard,抑制住了 KV swap 的 thrashing,尾部又降了约 1.5–2 倍;完整的 UniBoost(加上 Phase 4 自适应)最稳,0.255 QPS 时 P99 还在亚秒级,而别的变体已经是多秒级了。整体上 UniBoost 把膝点右移 4–6%,在接近饱和处把 P90/P99/Mean 相比 MLFQ+ 压低了最多 10 倍。每加一个阶段都有实打实的收益,没有凑数的模块。
6.4 SLO 达标率:能扛多严的目标
对服务商来说,最实在的问题是”在保证达标率(比如 99%)的前提下,我能把 SLO 定得多严”。下面这张图怎么读:两组数据集(上 (a) 聊天+推理混合,下 (b) 纯推理),每组左边是 TTLT 达标率、右边是 TTFT 达标率;横轴是 SLO scale,越往右表示 SLO 越宽松(注意是倒数刻度,SLO = Base/x),纵轴是达标率(越高越好)。看 UniBoost(CombinedBoost)的曲线能在多严的 SLO 下仍然压住高达标率。
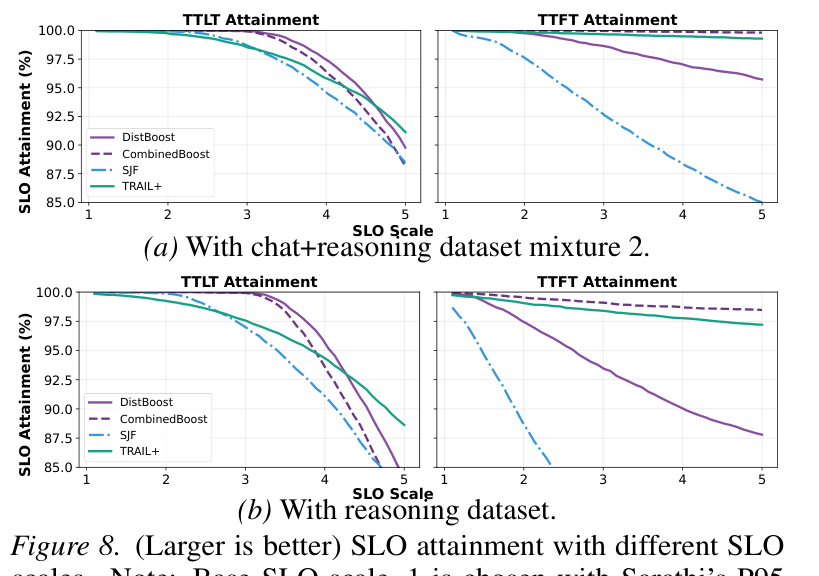
对着图走读:在 TTFT 上,UniBoost 在最宽的 SLO 范围内维持最高达标率,相比之下 SJF 对严格 SLO 最不耐受、很快掉下来;平均而言 UniBoost 能达到的 SLO 比基线严 2.9–8.7 倍(mix-2 因为更动态,差距更大)。在 TTLT 上,99% 达标率对应的 SLO 阈值能收紧 1.7–4.3 倍;有意思的是这里 DistBoost 略微更好一点——因为它偏袒 decode、牺牲了 TTFT 去换 TTLT。这个诚实的细节也说明:到底偏向哪个指标,本就是 $\gamma$ 这根旋钮在调的事,没有免费的午餐。
6.5 不预测,会不会把长请求饿死?
这是面对”软 boosting”最该追问的一句:你偏向短请求,会不会让长请求永远排不上队(starvation,饿死)?论文专门做了个压力测试——九成短请求(约 125 prefill / 100 decode)掺一成长请求(2k prefill / 6k decode),泊松到达压到 $\rho \approx 0.99$,然后统计长请求的抢占情况。
最有说服力的是这张长请求抢占次数的 P99 对比表:
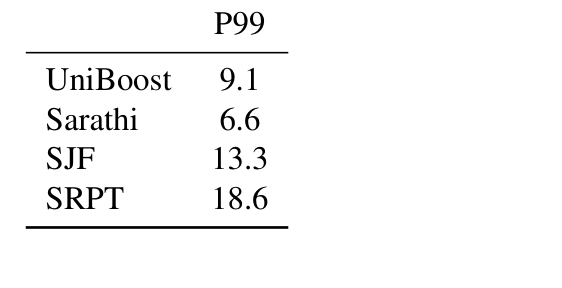
对着表看:长请求被抢占后累计耽误的时长,P99 上 UniBoost 是 9.1 秒,而两个开天眼的预测基线——SJF 是 13.3 秒、SRPT 更是高达 18.6 秒。也就是说,恰恰是”完美预测 + 硬排序”的 SRPT,把长请求折腾得最惨(反复抢占,正是第 3 节右场景那个失败模式的真实复现);UniBoost 不预测,反而抢占温和得多,只比完全不折腾长请求的 Sarathi(6.6 秒)略高。配合论文另外两张表的数字:短请求 E2E 的 P99,UniBoost 做到 3.62 秒,是所有方法里最低的(Sarathi 3.84、SRPT 3.69);长请求 E2E 则和 SJF/SRPT 相当——在不借助任何长度预言机的前提下,拿到了和开天眼基线相当的公平性和长请求延迟,同时短请求尾部还更好。他们还对长请求延迟随到达顺序做了线性回归,斜率只有约 $0.0003$ 秒/请求,几乎为零,说明 $\rho < 1$ 下没有饿死现象。
7. 总结
这篇论文最有意思的地方,不在于又提了一个更准的长度预测器,而在于它换了个赌注:
- 挑战了一个几乎成为默认的范式——”要优化 LLM 调度,就得先预测 decode 长度,再近似 SJF/SRPT”。论文从两个层面把这个范式拆了:一是输出长度的方差来自采样和数值不确定性,是模型固有属性,本质上预测不准;二是更深一层,就算给你完美预测,均值最优的硬排序策略在突发到达时照样把尾部搞砸——因为尾延迟的敌人不是”预测不准”,而是”为了短请求反复牺牲长请求”这个取向本身。
- 给出的解法是 prediction-free 的:以 FCFS 为底盘,叠加一层由 boost 函数 $b_\gamma$ 定义的软优先级,用一个旋钮 $\gamma$ 在 FCFS(保尾部)和 SJF/LAS(追均值)之间平滑插值,并让 $\gamma$ 跟着在线观测到的尾分位自动漂移。整条链路只吃”到达时间、已处理 token 数、近期 P95/P99 分位”这几个系统本就在统计的轻量信号。
- 真正把它落到了 LLM 引擎上:统一 prefill/decode 优先级(Phase 2)、用几何量化把抢占次数压成对数级来对冲 KV 搬运成本(Phase 3 MemGuard)、再加自适应 $\gamma$(Phase 4)。效果是在不预测的情况下,P99 TTLT 比完美预测的 SRPT 还低 35–50%、尾部 TTFT 低 34–47%,而且长请求没被饿死、抢占反而比 SRPT 温和得多。
工程上它也挺克制:整套东西是对现有连续批处理栈(vLLM、SGLang、p/d 分离)的轻量叠加,$k=256$ 这类参数对齐 GPU 的 tile 结构、对取值不敏感;它还能和更强的全局路由组合(配 JSQ 这种”发给最短队列”的路由时尾部收益更明显),在 32× 到 512× 的集群规模上收益稳定;prefix caching 也只需把有效工作量换成 $\tilde{w}_i(t) = \max(w_i(t),\, s^{\text{pre}}_i - h_i)$($h_i$ 是命中的缓存 token 数)就能接上。
当然局限也摆在那:理论保证建立在 M/G/1 之上,而连续批处理更像 M/G/k,论文自己也说 M/G/k 下的 Boost 理论还很薄;它主动牺牲均值去换尾部,是否划算取决于你的 SLO 到底卡在哪个指标上。但”用统计信号代替预测来治尾延迟”这个方向,确实给过度依赖预测器的 LLM 调度提供了一条更稳的退路。
扯一句题外话。顺着这篇的研究背景——我自己平时的方向是 LLM 推理效率、MoE 系统和自动化机器学习,调度这类系统工作算是相邻但不同的切面:它优化的是”请求怎么排队”,而我更常碰的是”模型本身怎么变小、变快”。我们把后面这块(NAS、模型压缩/剪枝/量化、LLM 架构自动化)的积累整理成了一本书,《动手学 AutoML:从 NAS 到大语言模型优化实战》。它不覆盖推理服务调度这类系统话题,但如果你读完这篇对”LLM 怎么在工程上更高效”感兴趣,书里从搜索空间、搜索策略讲到 LLM 压缩与后训练剪枝实战的部分,大概是另一个角度的补充。
