FAST'26 | SolidAttention:把 KV cache 丢到 SSD,让内存受限的 PC 也能“低延迟”跑大模型
FAST’26 | SolidAttention:把 KV cache 丢到 SSD,让内存受限的 PC 也能“低延迟”跑大模型
原文:SolidAttention: Low-Latency SSD-based Serving on Memory-Constrained PCs(USENIX FAST’26,上海交通大学 IPADS)
1. 想在自己的笔记本上跑大模型,先过内存这一关
越来越多人想把大模型跑在自己电脑上——不走云端 API,数据不出本机,隐私和定制化都是实打实的好处。厂商顺势推出了所谓 AI PC(AIPC,宣称能本地跑 AI 推理的个人电脑)。听起来很美,真上手你会发现第一道坎根本不是算力,而是内存。
问题出在 KV cache 上。先把两个词说清楚。attention(注意力)是 Transformer 的核心运算,每生成一个新 token,模型都要拿当前 token 的 query 去跟前面所有 token 的 key、value 做一遍加权求和:
\[S=\frac{QK^\top}{\sqrt{H}},\quad P=\mathrm{softmax}(S),\quad O=PV\]这里 $Q,K,V \in \mathbb{R}^{N\times H}$,$N$ 是序列长度、$H$ 是隐藏维度,$S$ 是注意力分数、$P$ 是归一化后的权重。KV cache 就是把前面所有 token 已经算好的 $K$、$V$ 向量缓存起来,省得每一步都重算一遍。好处是省掉重复计算,代价是这块缓存会随上下文长度线性膨胀——你聊得越久、喂进去的文档越长,它就越大。
下面这张图分两块看,左边 (a) 是显存/内存怎么被吃掉的,右边 (b) 先按下不表,等讲到 SSD 再回来看。
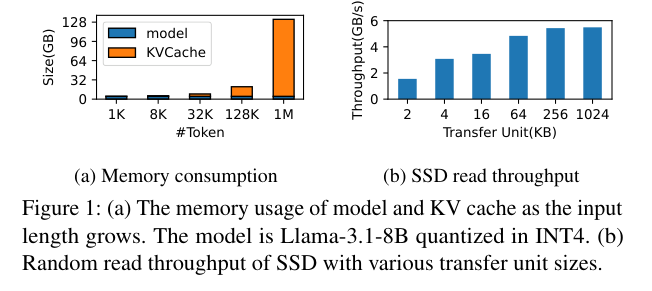
看 (a):模型是 INT4 量化的 Llama-3.1-8B,权重本身也就 4GB 出头。可一旦上下文拉到 128k,KV cache 直接涨到 16GB,是模型权重的 4 倍还多;要是上到 1M token,更是飙到 128GB。而市面上大多数笔记本只有 8GB 或 16GB 的内存/显存——这意味着连 KV cache 单独都塞不下,更别说还要留地方给模型权重和其他进程。
既然内存装不下,一个自然的念头冒出来:把 KV cache 挪到硬盘上去。1TB 的 SSD 放个几十上百 GB 的缓存绰绰有余。可事情要是这么简单,这篇论文也就不用写了。
2. 把 KV cache 挪到 SSD,就得先摸清 SSD 的脾气
把放不下内存的数据搬到更大更慢的存储层,这个操作叫 offload(卸载)。这里的目标层是 SSD——现在笔记本上普遍是 NVMe SSD(走 PCIe 总线、协议比老式 SATA 盘快得多的固态硬盘)。容量管够,但它终究不是内存,有自己的脾气,摸不清就会被它拖垮。
最要命的一条,是它喜欢大块顺序读写、讨厌小块随机读写。所谓顺序读(sequential read)是连续地址一气读一大段,随机读(random read)是东一下西一下地读很多小块。现在回头看上面那张图的 (b):横轴是单次传输的数据块大小,纵轴是随机读的吞吐。块只有 2KB 时吞吐才 ~1.5GB/s,一路加到 256KB 以上才爬到 ~5.5GB/s。为什么?因为 SSD 内部是多通道(channel)并行的,只有传输块足够大,才能把这些通道同时喂满、把带宽榨出来;小块随机读根本调动不起这份并行度。
这里要分清两个常被混为一谈的指标:带宽(bandwidth)是单位时间能搬多少数据(GB/s),延迟(latency)是发一次请求到拿到数据要等多久。云端做吞吐,关心的是带宽;本地推理是延迟敏感的——用户在等着一个字一个字往外蹦,哪一步卡住了都直接体现在体感上。
还有一个绕不开的坑叫写放大(write amplification):SSD 不能像内存那样原地改写,要先擦除整块再写入,于是实际写进闪存的数据量往往比你逻辑上要写的多。频繁的小粒度写既慢又折寿命。把不断新生成的 KV 往 SSD 回写,这件事做不好同样会拖后腿。
一句话:SSD 的容量正好补上内存的短板,但它的访问特性和大模型推理想要的东西,天生拧着来。
3. 已有做法为什么一到个人电脑就翻车
好在 attention 本身有个性质能帮上忙——稀疏性。每生成一个 token,真正对结果有贡献的其实只有一小撮历史 token,剩下的权重接近 0。顺着这个性质就有了 attention sparsity(注意力稀疏):别让所有 KV 都参与计算,只挑重要的。它分两类:
- 静态稀疏(static):prefill(预填充,即一次性处理完输入 prompt、吐出第一个 token 的阶段)结束后,一次性把看起来不重要的 token 永久踢出 KV cache。SnapKV、StreamingLLM 的 “attention sink”(开头少数 token 天然吸走大量注意力的现象)都属于这路。省事,但永久删除有风险——现在看着没用的 token,后面可能恰恰有用。
- 动态稀疏(dynamic):KV cache 全留着,在 decode(解码,即逐 token 自回归生成)阶段每一步都重新挑 top-k 个重要的块参与计算。更准,但有个尴尬:既然每步都可能用到任意历史 token,就得把整份 KV cache 随时可取地放着——稀疏省下的内存又还回去了。
把动态稀疏和 SSD offload 接起来,就是 FlexGen 这类做法:整份 KV cache 丢 SSD,每步只按需取回关键 KV。为了藏住 SSD 的慢,它靠批处理——攒一批并发请求,用别的请求的计算盖住当前请求的 I/O 等待。
下面这张图把这个思路的软肋画得很清楚。怎么读:上半是高并发、下半是低并发,时间轴从左往右,每个请求占一行,橙色块是 KV cache loading(从 SSD 加载缓存)。
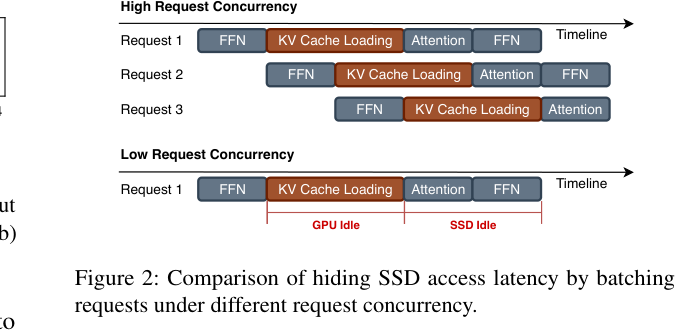
高并发时,request 1 在等 KV 加载的工夫,GPU 可以去算 request 2、request 3 的 FFN 和 attention,谁也不闲着,I/O 延迟就被别人的计算盖住了。可本地场景几乎永远是 batch size = 1——就你一个人在用。看下半部分:只有一个请求,FFN 算完就得干等 KV cache loading(这段 GPU idle,显卡空转),等加载完轮到 GPU 算 attention,SSD 又没事干了(SSD idle)。本地推理的计算量太小,算得比 I/O 快得多,根本没有足够的活儿去填满等待。论文给了个具体数字:从 SSD 加载一个 1k-token 的 KV cache(128MB)大约要 40ms,能占到一个 decode step 近一半的时间——这一半时间 GPU 就在那儿空等。
把问题刨到根上:稀疏注意力的访问模式(细粒度、随机)和 SSD 的特性(偏爱大块、顺序)之间,存在一个根本矛盾。过去的方案把“稀疏算法”和“存储管理”当成两件互不相干的事各自优化,谁也没管两者接起来会互相拖累。这也是把大模型塞进内存受限设备这件事上,一直没被正面解决的核心矛盾。SolidAttention 的立场很明确:把稀疏注意力算法和存储管理放在一起协同设计(co-design)——对齐数据访问的粒度,再精细地编排计算与 I/O 的重叠,才能真正把 SSD 的访问延迟压下去。
4. SolidAttention 总览:三个组件各治一个病
co-design 听着抽象,落到工程上,SolidAttention 把“在 SSD 上做低延迟稀疏注意力”拆成了三个具体的病,再用三个组件分别去治。先把病说清楚,组件的设计才立得住:
- 精度损失(accuracy loss):要喂饱 SSD 就得把零散 KV 攒成大块传输,但动态稀疏是靠“给每个块抽一个代表向量、拿它跟 query 比相似度”来选块的。块太大,一个代表向量糊进去的 token 太多,选得就不准、精度掉;块太小,又退回到细粒度随机读、带宽喂不满。两头为难。
- 预取不确定(prefetching indeterminacy):动态稀疏每一层选哪些块,取决于这一层的输入,而下一层要哪些块,得等这一层算完才知道。于是没法提前把下一层的块从 SSD 取上来,只能临到用时现取、现等。
- 数据不一致(data inconsistency):想让计算和 I/O 重叠,就会出现对 KV cache 的并发访问。比如 GPU 正从 DRAM 读这一层的 KV,后台又在把下一层的 KV 从 SSD 预取进来——内存紧张时,预取可能直接覆盖掉 GPU 还没读完的数据。
对应的三个组件如下图。怎么读:中间那条竖线是三层 buffer(VRAM 显存 → DRAM 内存 → SSD),整份 KV cache 常驻最底下的 SSD,推理时按需往上搬;左上是 KV Consolidator,左下是 Speculative Prefetcher,右边是 SSD-aware Scheduler。
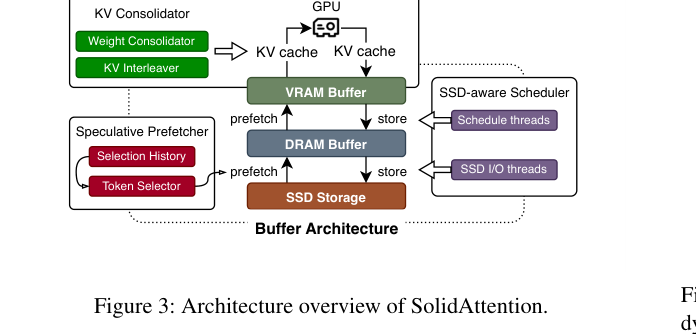
顺着图走一遍:KV Consolidator(KV 整合器)里有 Weight Consolidator 和 KV Interleaver,负责把 K、V 攒成适合 SSD 的大块、并交错排布(治病 1);Speculative Prefetcher(投机预取器)里有 Selection History 和 Token Selector,根据历史选择结果提前把块预取上来(治病 2);SSD-aware Scheduler(SSD 感知调度器)用 Schedule threads 和 SSD I/O threads,编排 prefetch(预取)和 store(回写)在三层 buffer 之间的流动,并保证不打架(治病 3)。
在进组件之前,先看稀疏到底怎么选块。SolidAttention 沿用并改良了块级(block-wise)的动态稀疏。下图怎么读:K cache、V cache 都被切成一个个块(图里编号 0~4),颜色区分角色——绿色是 init、蓝色是 local、红色是被选中的、白色是没选中的。
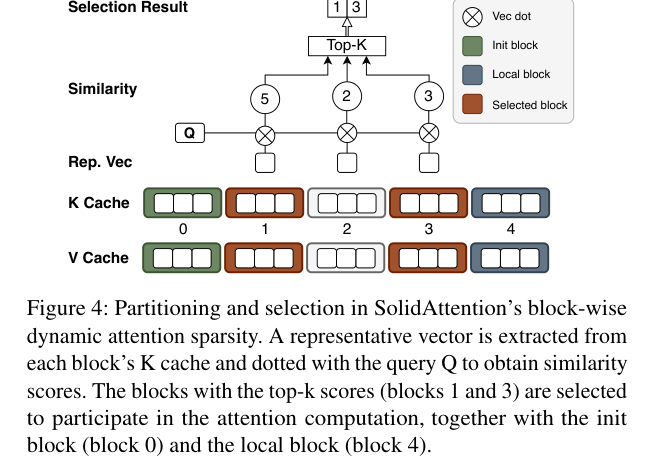
走读一遍选块过程:每个块从它的 K cache 里抽出一个代表向量(Rep. Vec),拿 query $Q$ 跟各个代表向量做点积,得到相似度分数(图里是 5、2、3),再取 Top-K 选分数最高的——这里选中了 block 1 和 block 3,block 2 分数低(2)被跳过。除了这些动态选出来的块,还有两类块是必选的:Init Block(初始块,block 0)是开头固定窗口的 token,专门伺候前面说的 attention sink;Local Block(局部块,block 4)是最近的滑动窗口,保住眼前最新的上下文。两个常用参数也在这里定义:block size(块大小)是每块装多少 token,context budget(上下文预算)是一步里一共保留多少 token 参与计算。
把这些块在三层 buffer 之间怎么流动串起来,就是下面这张单层数据流图。怎么读:三行分别是 VRAM / DRAM / SSD,时间从 $t_1$ 走到 $t_5$,最下面标着每段在干嘛(attention / FFN / select / kv proj.)。
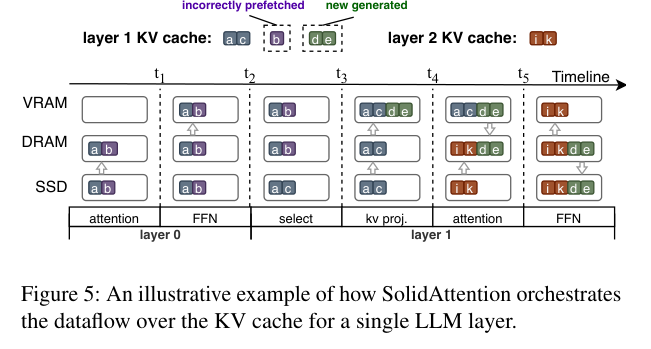
跟着时间线走一遍 Layer 1:它从上一层算完才开始。先把预测会用到的 KV 块预取、加载进 VRAM($t_1\to t_2$);接着做 select,对一下哪些块预取对了、哪些漏了($t_2\to t_3$),漏掉的(图里标 “incorrectly prefetched” 的 b)从 SSD 补;与此同时 GPU 把当前 token 新算出的 KV(kv proj.,图里 “new generated” 的 d、e)算好并转到 DRAM,准备回写($t_3\to t_4$);轮到算 attention 时,顺手把下一层要用的块从 SSD 预取到 DRAM($t_4\to t_5$);最后趁 FFN 计算的工夫,把预取块搬进 VRAM、把这一层的新 KV 写回 SSD,进入下一轮。整张图的精髓就一句话:所有 I/O 都尽量塞进 GPU 正在算别的东西的空当里。后面三节就是在讲这三个“塞”字具体怎么做到的。
5. KV Consolidator:把零散 KV 攒成大块,又不牺牲精度
先把病 1 的两难摆到台面上。SSD 想要大块,而块一大、代表向量糊的 token 就多、选块就不准。下图量化了这个代价。怎么读:左右两个子图分别是 Llama-3.1-8B 和 Qwen-2.5-7B,横轴是 block size 从 32 加到 256,纵轴是 recall rate(召回率)——稀疏选出来的块里,真正该选的占比,越高越好;en、zh 是英文和中文检索任务。
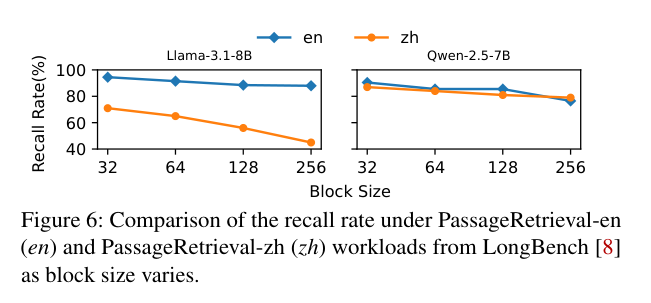
走读:block size 从 32 涨到 256,召回率一路往下掉,其中 Llama 在中文(zh)任务上最惨,从 ~70% 跌到 ~45%。原因正如前面所说,块越大,一个代表向量要替越多 token 发言,自然越选越偏。如果就在“块大小 vs 精度”这条线上纠结,怎么调都是按下葫芦浮起瓢。
SolidAttention 的巧劲在于换一条轴:在不增加每块 token 数的前提下,把传输单元做大。靠的是一个朴素观察——$K$ 和 $V$ 的形状完全一样(都是 $N\times H$)。那就把 K、V 在 token 粒度上交错(interleave)排在一起。下图怎么读:上面 Typical 是传统布局,下面 Interleaved 是交错布局。
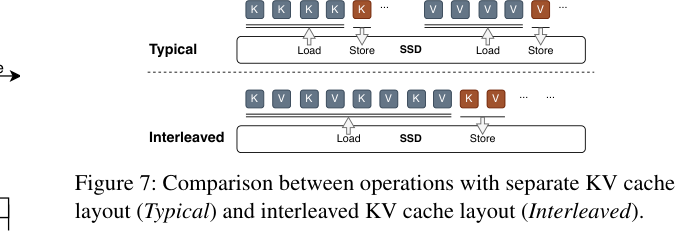
走读:传统布局里 K 是一片、V 是一片,分开存,于是读的时候要分别 Load、写的时候要分别 Store,I/O 次数翻倍;交错之后变成 K V K V K V……一次 Load 就能连着把 K 和 V 都拿回来,一次 Store 也一样。效果是传输单元直接翻倍、I/O 次数减半,SSD 带宽利用率顺势上去。关键是——交错并没有改变一个块里装多少 token,所以前面那张召回率图的精度代价,这里一分钱不用付。
不过天真地做交错有个暗坑:K、V 本来是两次独立的矩阵乘算出来的,想交错就得在运行时把它们重排一遍,这个 reorder 并不便宜。SolidAttention 把它挪到了初始化阶段去做。下图怎么读:上面 Typical 是两次独立投影后再 Copy 拼接,下面 Interleaved 是预先把权重拼好。
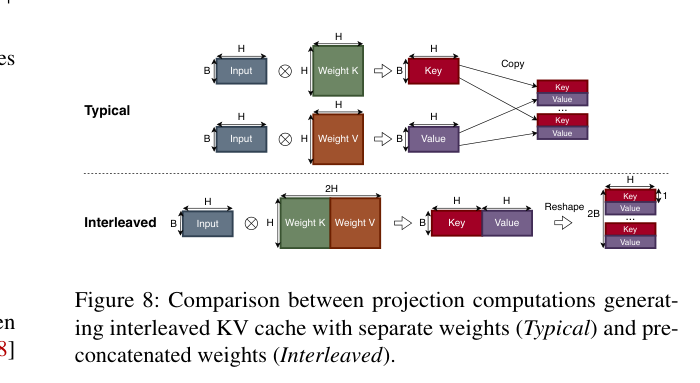
走读维度:输入 Input 形状 [B, H]($B$ 是 batch),K、V 的投影权重各是 [H, H]。传统做法是 Input × Weight_K → Key、Input × Weight_V → Value,再 Copy 交错。SolidAttention 在模型加载时就把两个权重沿列拼成一个 [H, 2H] 的大权重,一次矩阵乘直接吐出 [B, 2H] 的 [Key | Value],再 Reshape 成交错好的布局。这样运行时既不用额外 Copy、也不用 reorder,而且对自注意力计算本身不增加任何计算复杂度。消融实验显示,光这一手交错布局,就把 attention 的延迟最多压掉了 22%。
6. Speculative Prefetcher:用时间局部性赌下一层要哪些块
病 2 的死结是:下一层选哪些块,得等这一层算完才知道,没法提前取。SolidAttention 的破法是赌一把——赌相邻两步选的块高度重合。这个赌有没有依据?看下图。怎么读:横轴是 LongBench 的 8 个任务,纵轴是相邻两次迭代选择结果的平均相似度(%),两根柱分别是 Llama-3.1-8B 和 Qwen-2.5-7B。
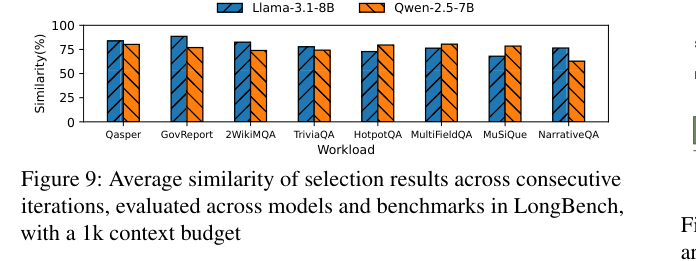
走读:在 1k context budget 下,相邻迭代选中的块相似度大多落在 63%~88% 区间,GovReport 任务上接近 88%。换句话说,上一步选了哪些块,这一步大概率还选它们——这就是时间局部性(temporal locality),熟悉 CPU cache 的同学对这个词不会陌生,只不过这里局部性发生在“注意力选块”这件事上。有了这个规律,预取就有了下注的底气。
具体怎么预取、赌错了怎么办,看下图。怎么读:(a) 是预取阶段、(b) 是纠正阶段,每个小格是一个块,绿色 init、红色 selected、蓝色 local。
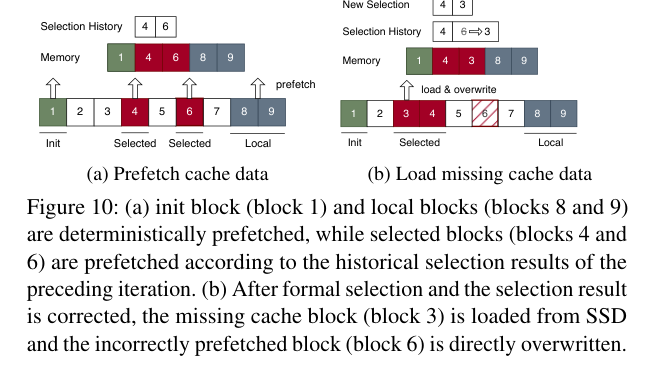
走读:(a) 阶段,Selection History(历史选择)记着上一步选了 {4, 6}。init 块(block 1)和 local 块(block 8、9)是确定性的,直接预取;selected 块就按历史先把 block 4、6 预取上来。(b) 阶段,这一层正式算完 select,得到 New Selection = {4, 3}——6 变成了 3。于是做两件事:漏掉的 block 3 从 SSD 补上(load & overwrite),预取错的 block 6 直接被覆盖掉。这里有个关键前提让纠错变得很便宜:attention 对 KV 的先后顺序不敏感(relaxed ordering),所以覆盖掉一个错块不需要把整份缓存重排,misprediction 的代价被压到很低。靠这套“先赌后纠”,I/O 请求能提前发出去,把等 KV 加载的 blocking latency(阻塞延迟)提前消化掉。
7. SSD-aware Scheduler:把 attention 拆成微任务,让算和搬真正并行
前面预取解决了“提前取”,但计算和 I/O 一旦真正并行起来,病 3(数据不一致)和另一个隐形开销——频繁同步(sync)——就冒出来了。最笨的办法是:等所有 I/O 串行做完再算,这当然不会出错,但 GPU 就一直停着,等于白搭了前面的功夫。
调度器的做法是把一层 attention 拆成一堆微任务(microtask):q proj.(算 query)、kv proj.(算新的 KV)、select(选块)、prefetch(预取)、load(补漏块)、store(回写)、attention(算注意力)。然后把这些微任务和它们之间的数据依赖建成一张 DAG(有向无环图)——节点是微任务,边是“谁依赖谁”。基于这张图,调度器守两个原则:细粒度重叠和同步点复用。
- 识别关键路径(critical path):也就是那条最长的依赖链,它决定了理论上的最小延迟。落在关键路径上的任务(比如 selected 块的 prefetch)优先级最高,依赖一满足就立刻跑;而非关键任务(比如把新算的 KV store 回 SSD)有延迟容忍度,不急,尽早发起、搭车同步就行。
- 多个任务同时就绪时按 LST 排序:LST(latest start time,最晚开始时间)通过反向遍历 DAG 估出来,表示“这个任务最晚什么时候开工还不拖累总延迟”。LST 越小越等不起,优先跑——因为它八成卡在关键路径上。
效果直接看三张时间线的对比。怎么读:从上到下是 (a) 不带稀疏的典型实现、(b) 带稀疏的朴素实现、(c) SolidAttention 的 SSD 感知调度;每张图里有 GPU、GPU→CPU、CPU→GPU、SSD→CPU、CPU→SSD 五条通道,顶上的 Sync 图标是一次 CPU-GPU 同步。
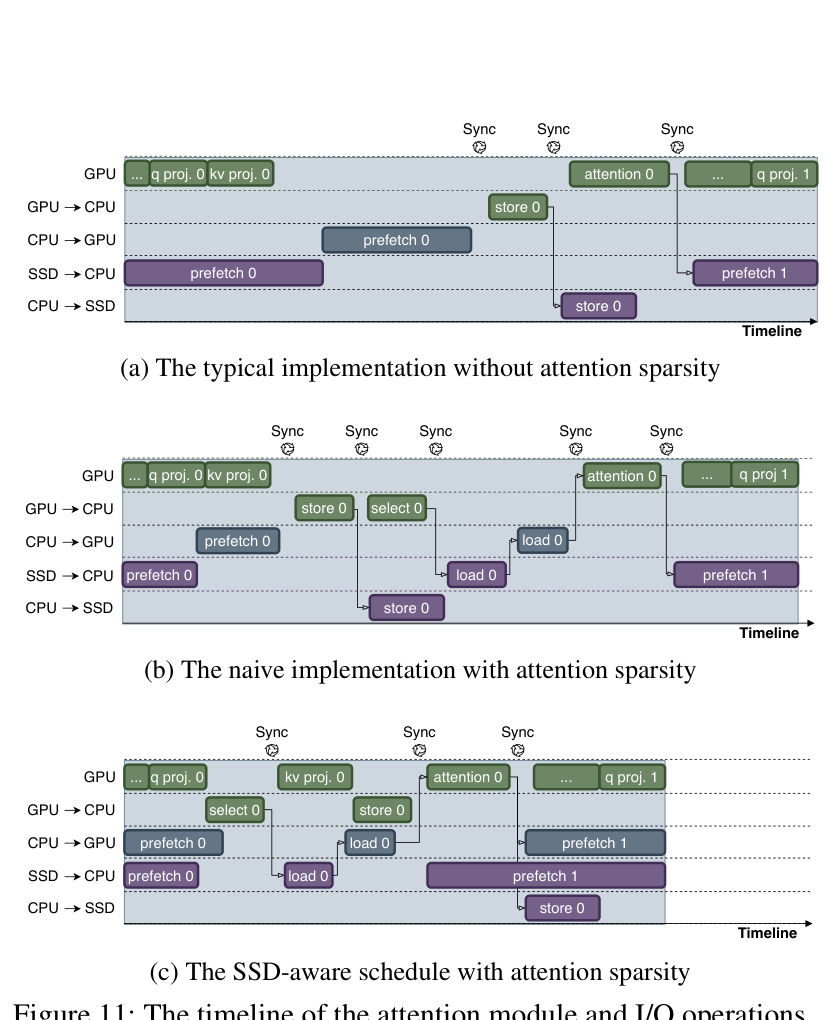
逐张走读:(a) 没有稀疏,一层就一次 prefetch、一次 store,同步点少,但代价是每层都要搬整份 KV,I/O 量巨大。(b) 加上稀疏后,select、load、store 一下冒出来一堆小操作,顶上的 Sync 密密麻麻——每次细粒度交接都要同步一次,GPU 频繁被打断停下来等,稀疏省下的 I/O 又被同步开销吃回去不少。(c) SolidAttention 把 select 提到紧跟 q proj.(因为 select 只依赖 query,不必等 kv proj.),让 load 和 kv proj. 并行跑,再把非关键的 store 搭上 attention 那次同步的“顺风车”——Sync 从 (b) 的 5 个减到 3 个,五条通道基本都忙起来了,中间的气泡被挤掉。至于病 3 的数据覆盖问题,也正是在这套依赖关系里被理顺的:预取写入的时机被安排在 GPU 读完对应数据之后,不再抢在前面。
8. 效果:128k 上下文最高 3.1× 提速、KV cache 省 98%
实验用两台笔记本代表两类 AIPC。CUDA 后端:Intel Ultra 9 185H + NVIDIA RTX 4070 Laptop(8GB 独显);SYCL 后端:Intel Ultra 7 255H + Intel Arc 140T 核显(iGPU,集成在 CPU 里、跟 CPU 共享内存的显卡)——后者其实更贴近普通轻薄本的真实样子。两台都是 64GB DDR5 内存 + 1TB 三星 990 PRO PCIe 4.0 SSD,但实验里刻意把 DRAM 用量限制在 16GB,来模拟内存受限。模型是 INT4 权重的 Llama-3.2-3B / Llama-3.1-8B / Qwen-2.5-7B,KV cache 用 FP16。对比的 baseline 有三个:Offload(整份 KV 丢 SSD)、Offload+Sparse(再加 InfLLM 稀疏)、FlexGen。整套系统用约 25k 行 C++/CUDA 代码实现。
先看端到端速度(throughput,吞吐,这里按 token/s 计)。两张图分别是 CUDA 和 SYCL 后端,横轴是输入长度 1k→128k,蓝色菱形那条是 SolidAttention。
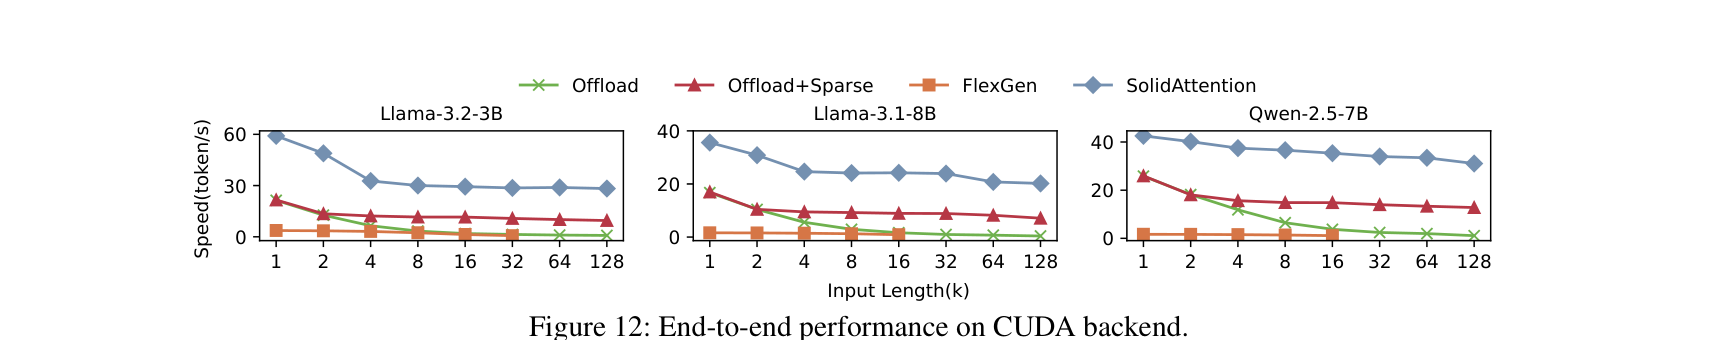
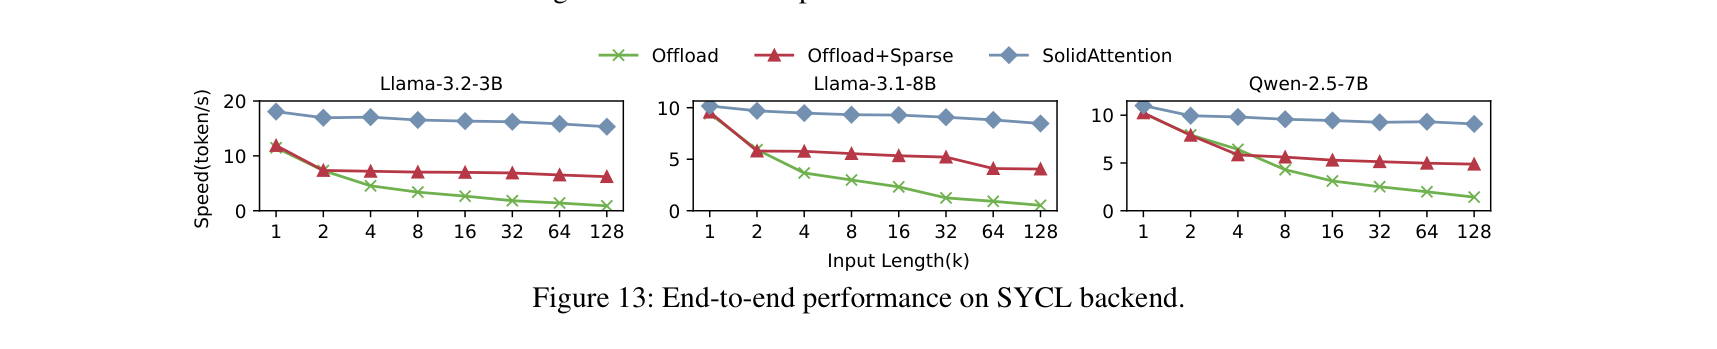
走读:蓝线全程压在最上面。CUDA 上,128k 上下文时 SolidAttention 对 Offload+Sparse 分别提速 2.8× / 3.1× / 2.4×(三个模型),对 FlexGen 在 16k 时最高拉开 58.9×——而且 FlexGen 一过 16k 就直接 CUDA OOM(显存溢出)跑不动了。换到核显的 SYCL 后端,对 Offload+Sparse 也有最高 2.1× / 2.5× / 1.9×。还有个值得注意的形状:输入超过 4k 之后,SolidAttention 和 Offload+Sparse 的曲线都趋平(稀疏让 KV 需求不再随长度猛涨),而 Offload、FlexGen 则随长度一路下滑——没有稀疏,长上下文就是纯粹的 I/O 灾难。
省了多少内存?看下图,橙色是 llama.cpp、蓝色是 SolidAttention,纵轴是 KV cache 占的内存(GB)。
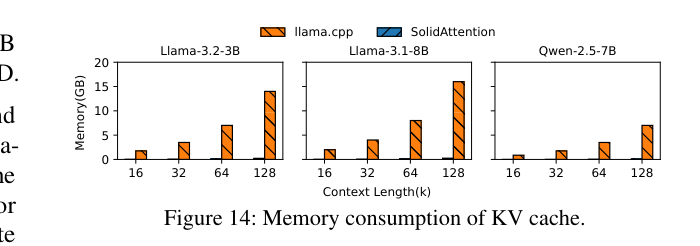
走读:SolidAttention 只给“一层、1k-token 预算”的那点 KV cache 开 buffer,其余全躺在 SSD 上,所以蓝柱几乎贴着地面;llama.cpp 则随上下文一路涨到十几 GB。论文给的数字是 KV cache 内存最多省 61.9× / 62.0× / 61.9×,也就是摘要里说的最高省 98%。
省内存不稀奇,难的是省内存还不掉精度。这正是动态稀疏相对“粗暴量化”的价值所在。下表怎么读:三个模型 × 三种配置——Origin(原始模型)、Quant(把 KV cache 也 INT4 量化)、Ours(SolidAttention);列是 Winogrande、Arc-Challenge、MMLU、GSM8K、LongBench 几个评测,数字都是准确率,越高越好。
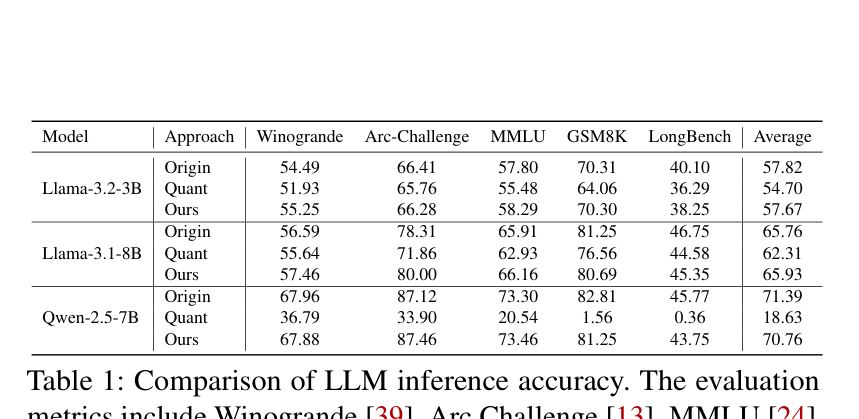
走读,重点看 Qwen-2.5-7B 那三行:粗暴地把 KV cache 量化到 INT4,平均分从 Origin 的 71.39 直接砸到 18.63,其中 GSM8K 掉到 1.56——基本废了,因为 KV cache 里存在离群值(outlier),激进量化扛不住这点数值精度损失。而 SolidAttention 走的是动态稀疏、根本不碰数值精度,平均分 70.76,几乎追平原始模型。Llama 的两个模型上,Ours 和 Origin 也都咬得很紧。一句话:它省内存靠的是“只算重要的”,不是“把每个数都压扁”,所以精度不塌。
那投机预取到底值不值?单独做个消融。下图纵轴是 blocking latency(阻塞延迟,越低越好),蓝色开预取、橙色关预取。
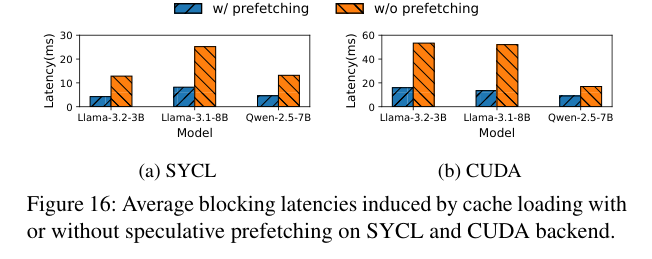
走读:开了投机预取,阻塞延迟在 SYCL 上最高降 3.1×、CUDA 上最高降 3.9×;即便是 KV cache 较小、本来就没那么吃 I/O 的 Qwen-2.5-7B,也还有 2.9×(SYCL)和 1.9×(CUDA)的改善。这说明“先赌后纠”确实把等 KV 加载的时间大段大段地藏掉了。
还有几个零散但有意思的结论,顺手记下来:和把 KV cache 全放内存的理想上界比,SolidAttention 跑在 SSD 上吞吐只掉 ≤11%,可以说基本追平了纯内存;换上带宽更低的 SSD(KIOXIA BG6,~5.0GB/s 对比三星 990 PRO 的 ~7.5GB/s),1k context budget 下两块盘差不多,4k budget 下低端盘才多出约 45% 延迟——也就是说它对盘的依赖没那么极端;block size 取 32 比取 16 吞吐高约 14%(块更大才喂得饱 SSD 并行度),再往上就趋于饱和;在更大的 INT4 Qwen2.5-14B 上同样省 98% 内存、拿到 1.7× 提速,说明方法的收益来自 I/O 与计算的比例,而非绝对的内存大小。
对靠电池吃饭的笔记本,能耗也值得扫一眼:
| 框架 | 峰值功率 (W) | 每 token 能耗 (J/token) |
|---|---|---|
| llama.cpp | 32.98 | 5.37 |
| SolidAttention | 36.27 | 3.68 |
SolidAttention 峰值功率略高(毕竟 SSD 和流水线都更满),但因为跑得快,每 token 能耗反而降了约 31%(5.37 → 3.68 J/token)——单位产出更省电,这对续航是实打实的好处。
9. 总结
SSD-based serving 的本质瓶颈,从头到尾就是一对矛盾:稀疏注意力的访问是细粒度随机的,而 SSD 偏爱大块顺序。过去的 offload 方案慢,大多不是因为某个单点没调好,而是把“算法层的稀疏”和“系统层的存储”切开各做各的,忽略了两者接起来会互相拖累。
SolidAttention 的解法是把这两层当成一个联合问题来设计:KV Consolidator 用“K/V 交错 + 权重预拼接”把传输粒度对齐到 SSD 的脾气上,还不动精度;Speculative Prefetcher 抓住注意力选块的时间局部性,先赌后纠地把 I/O 请求提前发出去;SSD-aware Scheduler 把 attention 拆成微任务、用 DAG 和 LST 精细编排计算与 I/O 的重叠,并复用同步点把开销榨干。三者合起来,在内存受限的 PC 上做到了 128k 上下文最高 3.1× 提速、KV cache 省 98%、精度基本不掉。
对做 LLM 推理效率的人,这篇最值得抄走的不是某个单独的技巧,而是那句核心主张——把算法层的稀疏性和系统层的存储特性放到一张图里一起设计。很多看起来“应该快”的 offload 方案最后不快,恰恰栽在把这两层拆开各自为战上。
扯一句题外话:SolidAttention 是实打实的存储/系统方向,和我们整理的《动手学 AutoML:从 NAS 到大语言模型优化实战》话题隔得比较远——那本书讲的是 NAS、AutoML,以及 LLM 的压缩、剪枝、量化这类“把模型本身变小变快”的自动化方法。角度不一样,但目标其实挨着:都是想让大模型在有限的资源里跑得更顺。顺带贴出来,感兴趣的可以当相邻方向翻翻。
