ICML'26 | KVP:把 KV Cache 驱逐变成一个“学会排序”的强化学习问题
ICML’26 | KVP:把 KV Cache 驱逐变成一个“学会排序”的强化学习问题
原文:Learning to Evict from Key-Value Cache(Apple,ICML 2026)
1. KV cache:推理时省了计算,却省不下显存
先交代下背景。现在的 LLM 几乎都是基于 Transformer 的自回归模型——一个 token 一个 token 往外吐,每吐一个新 token,都要让它去”看”前面所有 token。为了不让每一步都把前文重算一遍,推理框架会把前面每个 token 算出来的 key 向量和 value 向量缓存下来,这块缓存就是 KV cache(键值缓存)。有了它,生成第 1000 个 token 时就不用把前 999 个 token 的注意力再算一次,直接查缓存即可。
问题在于,KV cache 的大小是跟着序列长度线性增长的。上下文越长、对话轮数越多,这块缓存就越大。原文给的数字是:长上下文场景下,KV cache 能吃掉几十甚至上百 GB 显存,很快就把现代加速卡的显存顶爆。这就是整个 LLM 推理落地里绕不过去的一个核心矛盾——计算是省下来了,显存却成了新的天花板。
所以业界冒出来一堆”管理” KV cache 的办法。大致分几类:一类是量化(quantization),把 key/value 从 16-bit 压到 8-bit 甚至更低,省的是每个 token 占的字节数;一类是低秩近似,用低维投影去表示整个缓存;还有一类是直接把一些 token 的 KV 整个扔掉,这就是本文的主角——eviction(驱逐):从缓存里挑出”不那么有用”的 token,删掉它们腾显存。
驱逐的好处很直接:它不改变保留下来的 token 的表示,省的是 token 数量,和量化、低秩这些手段是正交的,可以叠着用。但它也有个最要命的前提——你得知道哪些 token 可以安全地扔掉。扔错了,信息就永久丢了,再也找不回来,生成质量直接崩。
2. 现有驱逐策略的共同假设:过去重要的,未来还重要
那现有方法是怎么判断”谁该扔”的?基本都是手工启发式(heuristic),也就是人拍脑袋定的规则。举几个这篇论文反复拿来对比的 baseline:
- StreamingLLM:只留最前面几个 token(叫 attention sink,注意力汇聚点,模型天然会把大量注意力分给开头那几个 token)加上最近的一个滑动窗口,中间一律扔。规则极简,但一刀切。
- H2O / SnapKV / TOVA / KeyFormer:这几个更聪明一点,它们去看过去的注意力分数(attention score),谁历史上被关注得多就留谁。
- KeyDiff / K-Norm / LagKV:这几个是attention-free(不看注意力)的变体,只拿 key 向量的统计特征(比如 key 和”锚点”的余弦相似度、key 的范数)来打分。
这些方法推动了 state-of-the-art,但它们骨子里共享同一个假设:一个 token 过去重要,未来就还重要。换句话说,它们用”过去”当作”未来价值”的间接代理(proxy)。
这个假设有两个硬伤。
第一,它不总是成立。生成过程中模型需要什么信息是动态的、依内容而变的。一个 token 的真实价值,取决于它对未来解码步骤有没有用,而不是它过去被关注过没有。拿过去猜未来,必然会有猜错的时候,而驱逐一旦猜错就是不可逆的信息损失。
第二,那些靠注意力分数的方法还有额外的工程代价:它们得反复重算注意力统计量,这本身就有 overhead;更麻烦的是,它们和 FlashAttention(现在 LLM 推理里几乎标配的高效注意力实现,它为了省显存根本不显式地把完整的注意力矩阵算出来)不兼容——你想拿注意力分数,就得放弃 FlashAttention 的加速,这在实际部署里几乎是不可接受的。
把这两点摆在一起,一个问题自然就浮出来了:既然”过去被关注”只是”未来有用”的一个蹩脚代理,那能不能干脆别用代理,直接去学”未来到底有没有用”这件事本身? 如果能,那驱逐就不用再靠任何手工规则,也不用在推理时碰注意力矩阵了。这正是 KVP 要赌的方向。
3. 把“该留谁”重新定义成“按未来价值排序”
KVP 的全名是 KV Policy,核心的一步,是把”驱逐哪些 token”这个二元的 keep/evict 决策,重构成一个排序(ranking)问题:训练一个策略,把缓存里所有 token 按”预测的未来价值”从高到低排好序。一旦有了这个排序,驱逐就变得极其灵活——给定任意显存预算 budget,只保留排在最前面的那些、把排在尾巴上的砍掉就行。预算紧就多砍点,预算松就少砍点,同一个排序适配所有 budget。
这里顺着带出几个强化学习(RL)里的基本概念,因为 KVP 整个就是按 RL 的框架搭的:
- state(状态):agent 能看到的东西。这里就是缓存里每个 token 的 key 向量、value 向量和它的原始位置——注意,只有缓存里有的信息,没有未来 token,没有注意力分数,也没有 query 向量。
- action(动作):agent 输出的决策。这里是产出一个 token 的排列(permutation),也就是那个从最该留到最该扔的完整顺序。
- reward(奖励):对这个排序打的分。定义是——对任意一个 cache 大小,如果最有价值的信息都被保住了,就算是个好排序。reward 的具体设计是这篇最精巧的地方,第 5 节细讲。
那”未来价值”到底长什么样?这就是下面这张论文开篇图想说的事。怎么读:三栏画的是同一段对话(用户在问去罗马怎么安排行程),每一栏是一种策略对这段文本里 token 的”重要性”判断,颜色越深代表这个 token 越应该被保留、越亮(白)代表越该被扔。中间那栏是真值——作者把这段缓存真实地往后 roll out 一遍,统计每个 token 实际收到了多少未来注意力,据此排出的”标准答案”。
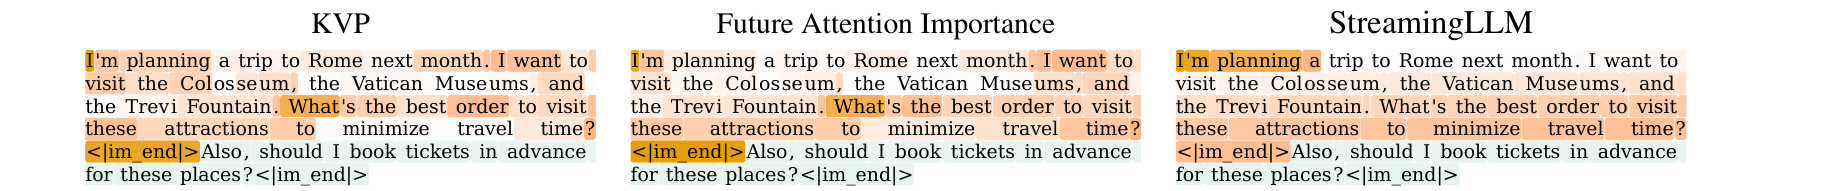
对着图走一遍就看明白了。中间”Future Attention Importance”是 oracle 真值:被标深的 token 散落在各处,是一种复杂的、非局部的(non-local)结构——重要的 token 不是集中在开头或结尾,而是零散分布在”next month”“Colosseum”“best order”这些真正承载语义的词上。左边”KVP”几乎复刻了这个结构,深色块的分布和中间高度一致——而它用的只有过去的 key/value,压根没看未来、没看注意力分数。右边”StreamingLLM”就很典型地露馅了:它只会把开头(sink)和结尾(recent window)整片标深,中间大段按固定规则均匀处理,完全抓不到那种非局部的重要性。
这张图其实就把整篇论文的赌注讲清楚了:未来价值是一种学得会、但手工规则抓不住的复杂结构。接下来三节,依次拆开 KVP 的三个部件——怎么打分(agent)、怎么评价排序(reward)、怎么训出来(training)。
4. 打分器:一个只吃 key、value、position 的小 MLP
先说打分器本身,也就是那个给每个 token 算”价值分”的评分函数 $f(x_i;\theta)$。
每个 token 的输入表示很简单,就是它的 key 向量、value 向量和原始位置拼起来:$x_i=(k_i, v_i, \text{pos}i)$。评分函数就是一个小 MLP(多层感知机,几层全连接 + 非线性,最朴素的那种神经网络):$f(x_i;\theta)=\text{MLP}\theta(k_i, v_i, \text{pos}_i)$。关键在于它只依赖缓存里现成的信息,不需要未来 token,不需要历史注意力分数,也不需要任何 query embedding——这正是它能绕开 FlashAttention 那个坑的根本原因。
有了每个 token 的分数,怎么变成一个排列?这里用的是 Plackett-Luce 模型(一个经典的”从分数生成排序”的概率模型,可以理解成反复做带权重的无放回抽样:谁分高谁越可能被先抽中)。形式化地,一个排列 $\sigma=(\sigma_1,\dots,\sigma_N)$ 被这样逐步采样出来:
\[\pi_\theta(\sigma \mid x_1,\dots,x_N) = \prod_{i=1}^{N} \frac{\exp\!\big(f(x_{\sigma_i};\theta)\big)}{\sum_{j=i}^{N}\exp\!\big(f(x_{\sigma_j};\theta)\big)}\]每一步 $i$,下一个被选中的元素 $\sigma_i$ 的概率,正比于它的分数、在剩下还没被选的 token 上做 softmax 归一化。这就定义了一个合法的”排列上的概率分布”——评分函数 $f$ 加上这个采样策略,合在一起就是 KVP 的 agent。
但按上面这个公式一步步顺序采样太慢了。论文用 Gumbel-Sort 一步到位:给每个 token 的分数加一份独立的 Gumbel 噪声,然后直接对”加噪后的分数”排序,排出来的顺序就等价于从上面那个分布里采样出的一个排列:
\[\sigma = \text{argsort}_{i\in[N]}\big(f(x_i;\theta) + g_i\big),\quad g_i \sim \text{Gumbel}(0,1)\]这步非自回归、完全可以在 GPU 上并行,一次前向 + 一次排序就能采出整个排列,训练效率全靠它。
打分器的代码实现也确实就是个小 MLP,来看核心的前向:
# 文件:src/kvcompression/rl/agents/kv_sorting_agent.py
# class KVSamplingGroupedQueryAgent
# def forward(self, observation)  —— 给每个 token 打分
keys   = observation["keys"]    # [B, S, D_head],例如 [128, 4500, 128]
values = observation["values"]  # [B, S, D_head],同上
seq_lengths = observation["seq_lengths"]  # [B],每条样本真实长度(去 padding)

# key / value 各过一个 Linear 投到 processing_dim=256,再 LayerNorm
norm_keys   = self.norm_key(self.key_projection(keys))      # [128, 4500, 256]
norm_values = self.norm_value(self.value_projection(values))# [128, 4500, 256]

# 位置:查一张 Embedding 表(nn.Embedding(max_seq_length=6000, 32))
pos_indices = torch.arange(S, device=keys.device)
norm_pos = self.norm_pos(self.pos_embedding(pos_indices))   # [4500, 32] → 广播到 [128, 4500, 32]

# 三样拼起来:256 + 256 + 32 = 544 维
combined = torch.cat([norm_keys, norm_values, norm_pos], dim=-1)  # [128, 4500, 544]

scores = self.mlp(combined).squeeze(-1)                     # [128, 4500],每个 token 一个标量分
scores = scores.masked_fill(~padding_mask, -float("inf"))  # padding 位置置 -inf,排序时自然沉底
return {"scores": scores}
几个变量讲清楚来源:keys/values 的 D_head=128,是 Qwen2.5-7B 每个注意力头的维度;B 是 batch,训练配置里是 128;S 是这个 batch 里最长的 prompt 长度,RULER-4k 场景下大约 4500。中间的 processing_dim=256、pos_embedding_dim=32、mlp_hidden_size=256、num_mlp_layers=2 全是开源配置 configs/train_single_head.yaml 里写死的。按这套配置把参数量加一下,一个 agent 大约 47 万参数,其中快一半还是那张 6000×32 的位置 embedding 表——放在 7B 模型旁边,这打分器小到可以忽略,这也是论文反复强调的 “lightweight”。
注意最后一行 scores 的形状是 [128, 4500]——每个 token 一个分,正好喂给上面的 Gumbel-Sort 去排序。这个 scores 的去向有两个:训练时加 Gumbel 噪声采样排列(第 6 节),推理时直接 argsort 定驱逐顺序(第 7 节)。
5. reward:一次性评价一个排序在所有 budget 下的好坏
打分器负责产出排序,但”这个排序好不好”得有人来评判——这就是 reward 的活。这篇论文 reward 的设计有两个硬要求:第一,它要全局地评价整个排序的质量,而不是单看某一个 budget;第二,它必须能在不跑任何 LLM 推理的前提下算出来(为什么这点关键,第 6 节讲)。论文把它叫作 holistic reward(整体奖励),意思就是”一把尺子量所有 budget”。
先定义”代价”。设当前有 $n$ 个 token $X={x_i}$,训练数据里还跟着 $f$ 个未来 token $x_{n+1},\dots,x_{n+f}$,用 $A(x_i,x_j)$ 表示未来 token $x_j$ 对 $x_i$ 的注意力。给定排序 $\sigma$,如果 budget 是 $b$,就保留排在前 $b$ 的 token、驱逐其余的。那么这个 budget 下的代价,定义为”所有被驱逐的 token 的未来注意力之和”——也就是你本该保住、却被扔掉的那部分未来价值:
\[C_b = \sum_{i=b+1}^{n}\sum_{j=n+1}^{n+f} A(x_{\sigma_i}, x_j)\]单看一个 $b$ 还不够,holistic 的意思是把所有 budget 的代价累加起来,也就是这条”代价–预算”曲线下的面积(AUC,Area Under Curve)。论文给了一个很漂亮的改写:这个 AUC 等价于一个按排名加权的求和——
\[C(\sigma;X) = \sum_{b=0}^{n-1} C_b = \sum_{b=1}^{n} b \cdot \sum_{j=n+1}^{n+f} A(x_{\sigma_b}, x_j)\]为什么能这么写?因为排在第 $b$ 位的 token $\sigma_b$,在所有小于 $b$ 的 budget 下都会被驱逐,一共被”扔”了 $b$ 次,所以它的未来注意力正好被乘上它的排名 $b$。这个改写是整篇的关键:它意味着代价只取决于”每个 token 的未来注意力”和”它被排在第几位”,不需要真的去枚举每一个 budget。排名越靠后(越该扔)的 token,如果它其实很重要(未来注意力大),惩罚就越狠。
最后做个归一化,让不同样本之间可比。用最优排序 $\sigma^\star$(把未来注意力从大到小排)的代价当分母,reward 定义成”负的、归一化的 AUC”:
\[R(\sigma;X) = -\frac{C(\sigma;X)}{C(\sigma^\star;X)} \le -1\]分数永远 $\le -1$,当且仅当排序就是最优排序时取到 $-1$。所以 agent 的目标就是把 reward 往 $-1$ 顶。另外对 GQA 这种一组 query 共享一个 KV 头的结构,$A(x_i,x_j)$ 取的是组内所有 query 的注意力最大值。
代码里这套逻辑在 costs.py 里,核心就三步,我把关键片段简化并加了注释:
# 文件:src/kvcompression/costs.py
# def batched_compute_cost(kv_rankings, kv_rankings_length, attention_weights, seq_lengths)
# kv_rankings: [B, S] 每条样本 agent 排出来的 token 顺序(index 0 = 最该留)
# attention_weights: [B, T, L] 由 oracle 用完整 Q/K 现算的注意力(含未来)

# ① reverse_cumsum:对注意力按"被谁 attend"的维度做反向累加,
#    得到每个 token 收到的【未来累计注意力】——这就是公式里的内层 ∑_j A(x_i, x_j)
future_attention = reverse_cumsum(attention_weights, dim=-2)   # [B, T, L]

# 按 agent 的排序把每个 token 的未来注意力取出来,并按序列长度归一化(训练稳定)
continuous_costs = future_attention[..., kv_rankings] / (seq_lengths + 1e-8)  # [B, S]

# ② 按排名加权求和:weights = [1, 2, 3, ..., n],正好对应公式 (5) 里的那个 b
n = continuous_costs.shape[-1]
weights = torch.arange(1, n + 1, ...)                          # [S]

# ③ 分母:最优排序的 AUC(把未来注意力从大到小排再加权)
ideal, _ = torch.sort(continuous_costs, dim=-1, descending=True)
ideal_auc = (ideal * weights).sum(-1)                          # [B],即 C(σ*)

# agent 排序的归一化 AUC —— 这就是 -R,返回后取负号即 reward
cost = ((continuous_costs * weights) / ideal_auc[..., None]).sum(-1)  # [B]
# 文件:src/kvcompression/rl/rewards/basic_strategies.py
# class FutureAttentionAucNormalizedReward
def compute_reward(self, cost_result):
    return -cost_result.cost.squeeze(-1)   # reward = 负的归一化 AUC,对应公式 (7)
走一遍形状:attention_weights 是 [B, T, L],比如 [16, 4600, 4600](T、L 都是含未来的完整序列长),reverse_cumsum 之后 future_attention 还是 [16, 4600, 4600],取出每个 token 的未来累计注意力得到 [16, 4600],加权求和压成 [16]——每条样本一个标量代价,取负就是 reward。这里 attention_weights 是 oracle 临时用 float32 现算的(见 oracle.py 的 materialize_attention_weights),只在训练时、在算 reward 这一步用一次,训练完的 agent 推理时根本不碰它。
6. 训练:用预先录好的 KV 轨迹,离线训 112 个 per-head agent
现在把打分器和 reward 接起来训练。这一节是 KVP 工程上最聪明的地方——整个训练过程完全离线,训练循环里一次 LLM 推理都不跑。
能做到这点,正是因为上一节的 reward 用的是静态的未来 token,而不是模型当场生成的文本。具体流程是:先拿基座 LLM(Qwen2.5-7B)在训练语料上跑一遍,把每条序列完整的 query、key、value 张量都存下来——注意只存 Q/K/V,不存注意力矩阵(那玩意儿是 $O(L^2)$ 的,太大了存不下,需要时由 oracle 用 Q/K 现算)。这些存下来的 Q/K/V 轨迹就是训练集,论文叫 pre-computed generation traces(预计算生成轨迹)。之后训 agent 时,数据管线里再也不需要那个 7B 模型了。
per-head agent(每个注意力头一个 agent) 是另一个设计选择。不同注意力头干的活儿差别很大,有的头负责局部、有的头负责长程检索,用一个统一的策略去套所有头显然不合适。所以 KVP 给每个 KV 头单独训一个 agent。Qwen2.5-7B 用的是 GQA(Grouped Query Attention,分组查询注意力——多个 query 头共享一组 KV 头,省 KV cache 的一种结构),28 层、每层 4 个 KV 头,于是一共 $28\times4=112$ 个 agent,每个用 8 张卡 DDP 训。好在每个 agent 都是上面那个 47 万参数的小 MLP,112 个加起来也不算什么。
训练用的是 RLOO(REINFORCE Leave-One-Out,留一法基线的 REINFORCE)。REINFORCE 是最基础的策略梯度算法,但方差大,RLOO 的改进是:一个 batch 里对同一条样本采 $K$ 个排列,评价第 $k$ 个排列好不好时,拿其余 $K-1$ 个排列的平均 reward 当基线 $\bar R$ 去减——相当于”你比你的同类平均水平好多少”,这样能大幅降方差。由于 reward 是只在整个排列生成完才给的终局奖励(terminal reward),梯度估计就是:
\[\nabla_\theta J(\theta) \approx \frac{1}{K}\sum_{k=1}^{K}\Big[\big(R(\sigma^k)-\bar R\big)\sum_{i=1}^{n}\nabla_\theta \log \pi_\theta(\sigma_i^k \mid X)\Big]\]整个训练循环就是论文的 Algorithm 1。怎么读:从上到下 7 行,是一个标准的”采样–评分–更新”循环,重点看第 3、4、5、6 行。
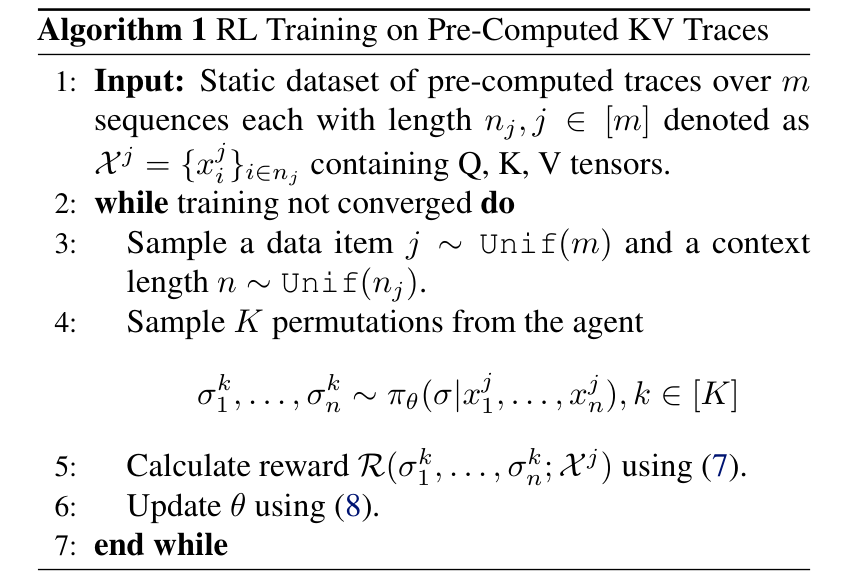
逐行走一遍:第 1 行,输入是上面那批预计算的 Q/K/V 轨迹;第 3 行,每步随机抽一条序列 $j$、再随机抽一个上下文长度 $n$(这样 agent 能见到各种长度,泛化更好);第 4 行,从当前 agent 采 $K$ 个排列 $\sigma^k$(就是上一节的 Gumbel-Sort);第 5 行,用公式 (7) 给每个排列算 reward;第 6 行,用公式 (8) 的梯度更新 $\theta$;跑到收敛为止。全程没有第 7B 模型什么事。
对应到代码,采样 + 算 reward 在 Gumbel trainer 里:
# 文件:src/kvcompression/rl/trainers/rloo_gumbel_terminal_trainer.py
# class RLOOGumbelTrainer
# def collect_trajectories(self)
scores = self.agent(initial_obs)["scores"].to(torch.float32)   # [B, S],打分器出分

# 对每个 chunk 加 Gumbel 噪声再 argsort —— 对应公式 (3)
noise = torch.rand_like(scores_chunk).clamp_(min=eps, max=1-eps)
gumbel_noise = -torch.log(-torch.log(noise))                   # 标准 Gumbel(0,1)
perturbed = scores_chunk + gumbel_noise
perturbed[~padding_mask_chunk] = -1e9                          # padding 沉底
actions_chunk = torch.argsort(perturbed, dim=-1, descending=True)  # [chunk, S] 一个排列

# 用上一节的 oracle/cost 算这批排列的终局 reward
terminal = self.env.compute_rewards_for_chunk(actions_chunk, batch_indices_chunk)
rewards[start:end] = terminal.pop("rewards")                   # [chunk]
RLOO 的基线和 advantage 在这里,一看就懂:
# 文件:src/kvcompression/rl/trainers/compute_advantages.py
# def compute_returns_and_advantage_vec(rewards, episode_lengths, normalize_advantages)
# rewards: [N],一个 batch 内 N 条有效样本各自的终局 reward
batch_sum = rewards.sum()
baselines = (batch_sum - rewards) / (N - 1)   # 留一法:每条样本的基线 = 其余样本的平均 reward
advantages = rewards - baselines              # 对应公式 (8) 里的 R(σ^k) - R̄
# (可选)再做零均值单位方差归一化,然后 clamp 到 [-2, 2] 防爆
举个具体例子帮理解 baselines:假设一个 batch 有 $N=4$ 条样本,reward 分别是 [-1.2, -1.5, -1.1, -1.8],那么第 1 条的基线就是 (-1.5-1.1-1.8)/3 = -1.47,它的 advantage = -1.2 - (-1.47) = +0.27——比同类平均好,梯度就鼓励这种排序。训练配置里 K(并发排列数)落在 batch 维度上,batch_size=128,优化器 AdamW、学习率 5e-5、跑 4000 步、entropy_coef=0、梯度裁剪 5、还挂了个 EMA(decay 0.99)做评估。
7. 推理:给每个 head 的 token 排个序,砍掉尾巴就行
训练阶段那些花活儿(Gumbel 噪声、reward、oracle)到了推理阶段全不要了,推理极其朴素。每个 head 的 agent 对它那组 KV 里的每个 token 打分,按分数从高到低排序,排在尾巴上的(分数最低的)就是要驱逐的。代码里这叫一个 press(压缩策略):
# 文件:src/kvcompression/presses/sampler_agent_press.py
# class SamplerAgentPress
# def sort(self, hidden_states, keys, values, queries, attention_weights=None)
# keys/values: [B, num_kv_heads, S, head_dim],例如 [1, 4, 4500, 128]
scores = self.agent({                       # 训练好的那个小 MLP
    "keys":   keys.view(-1, seq_len, head_dim),    # [B*4, 4500, 128]
    "values": values.view(-1, seq_len, head_dim),
    "seq_lengths": torch.tensor([seq_len]).expand(batch_size),
    ...
})["scores"]                                 # [B*4, 4500],每个 token 一个分

kv_ranking = scores.argsort(dim=-1, descending=True)   # [B*4, 4500],index 0 = 最该留

# 可选:强制保留前 n_sinks 个 sink token 和最近 n_running_window 个 token
if self.n_sinks > 0 or self.n_running_window > 0:
    kv_ranking = self._apply_sink_and_window(kv_ranking, seq_len)

return kv_ranking.view(batch_size, n_heads, seq_len)   # [1, 4, 4500]
注意函数签名里虽然收了 queries 和 attention_weights,但 sort 里压根没用它们——默认配置 use_kv_queries=false,requires_attention_weights() 返回 False。这正是前面反复铺垫的那个卖点落地的地方:排序只靠 key/value/position,不碰注意力矩阵,所以和 FlashAttention 完全兼容,也不给推理加额外的注意力重算开销。返回的 kv_ranking 形状 [1, 4, 4500]——1 条样本、4 个 KV 头、每个头一份独立的 token 排序,拿着它按 budget 砍掉尾部,就是最终的驱逐决定。
真正落地时有两种压缩时机(compression schedule):短上下文(RULER-4k、OASST2、BoolQ 这些)用 compress-after-prefill,即 prefill 把完整缓存建好后,一次性压到目标 budget,再自回归生成;长上下文(RULER-128K、LongBench 检索)单次 prefill 会直接 OOM,所以改成 chunked prefill-compress,分块 prefill、每块之后都对”已保留的缓存 + 新来的 token”重新压一次,全程把缓存钉在目标 budget 上。两种方式评测的是同一个排序策略,后者额外压了压”反复驱逐”的鲁棒性。
另外一个容易被忽略的好处:agent 的打分只依赖 token 的静态特征(key/value/position),所以一个 token 一旦进了缓存、它的分数就固定了,序列继续变长也不用重算旧 token 的分,只给新生成的 token 打分即可——这让 KVP 天然适配边解码边压缩的连续场景。
8. 效果:同分布领先、128K 外推不崩、换任务也能打
实验基座是 Qwen2.5-7B-Instruct(附录还验了 Phi-4 14B)。训练和同分布评测用两个长上下文 benchmark:RULER-4k(一个合成的长上下文推理测试集,序列约 4500 token,专门考长程信息的提取与推理)和 OASST2-4k(OpenAssistant 多轮对话数据的一个子集,长度相近)。对比的 baseline 分两档——带虚线的是 attention-based(TOVA、SnapKV,它们在压缩时能看到注意力分数,等于拿了 KVP 看不到的特权信息);实线的是 attention-free(KeyDiff、LagKV、K-Norm、StreamingLLM、Random)。为公平起见,所有方法对所有 head/layer 用统一 budget,不掺”预算分配”的技巧。
先看同分布。怎么读这张图:左图横轴是绝对 cache size(保留多少 token),纵轴是 RULER 的准确率(越高越好);右图纵轴换成 OASST2 的 perplexity(困惑度,PPL,衡量模型预测下一个 token 的能力,越低越好)。重点看橙色的 KVP 这条线相对其他线的位置。
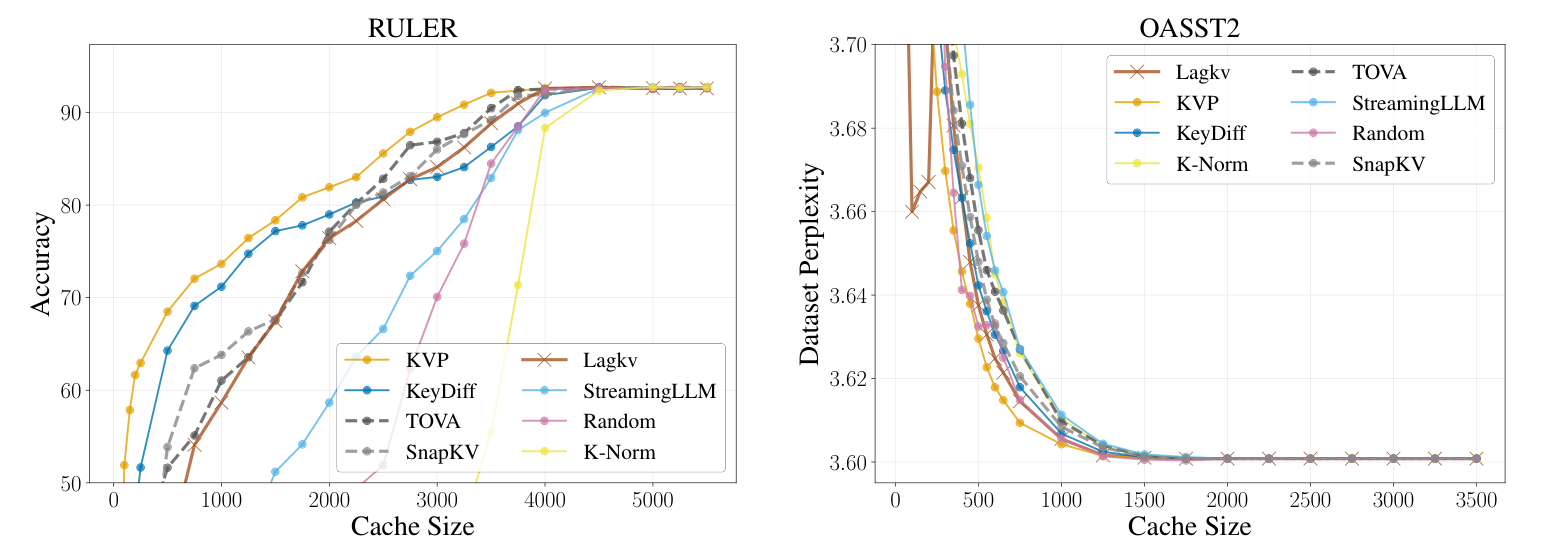
走读一下:左图里 KVP(橙)在绝大部分 cache size 上都是最高的那条,尤其在 budget 被压到 1000 以下的时候,它的准确率明显甩开其他方法——这正是驱逐策略最该发力的区间(预算越紧,扔错的代价越大)。更值得注意的是,几条虚线(TOVA、SnapKV 这些有特权信息的)也被 KVP 压在下面。右图 OASST2 上 KVP 的 PPL 几乎全程最低(只有 LagKV 在最极端的小 budget 处略好一点),而像 StreamingLLM 这种固定规则的方法,budget 一小 PPL 就陡增,脆性暴露无遗。
接着是让人眼前一亮的一个结果——长度外推。KVP 只在约 4K 的序列上训过,直接拿去测 RULER-128K(128K token,是训练长度的 32 倍)。怎么读:横轴是对数坐标的 cache size,纵轴是 13 个子任务的平均准确率,看 KVP 和其他所有线的间距。
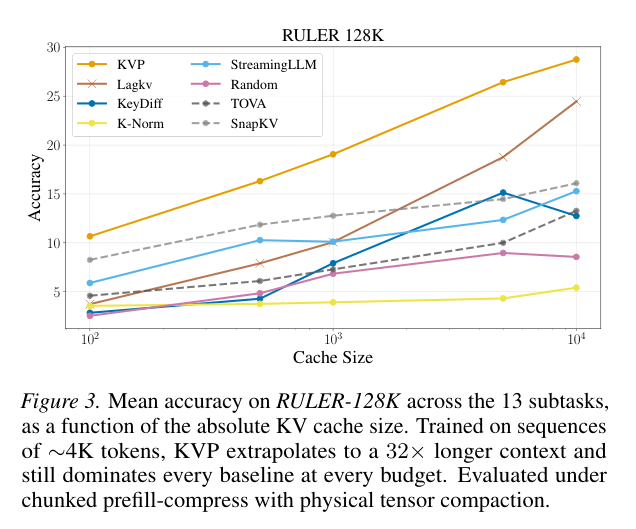
走读:橙色 KVP 这条线在每一个 budget 上都稳稳压住所有 baseline,而且随着 budget 增大领先幅度还在拉开。一个只在 4K 上训出来的策略能干净地外推到 128K,说明它学到的”token 未来价值”是一种与长度无关的内在属性,而不是训练长度上的某种 artifact(巧合规律)。这点对实际部署很重要——你不用为每种上下文长度各训一套。
最后看跨任务的 zero-shot 泛化:把在 RULER 上训的 agent(记作 KVPR)和在 OASST2 上训的(KVPS)直接拿去测完全没训过的下游任务。怎么读:左图 BoolQ(阅读理解判断题,准确率越高越好),右图 GovReport(长文摘要,用 L-ROUGE 分,越高越好),绿色虚线是不压缩的上界。
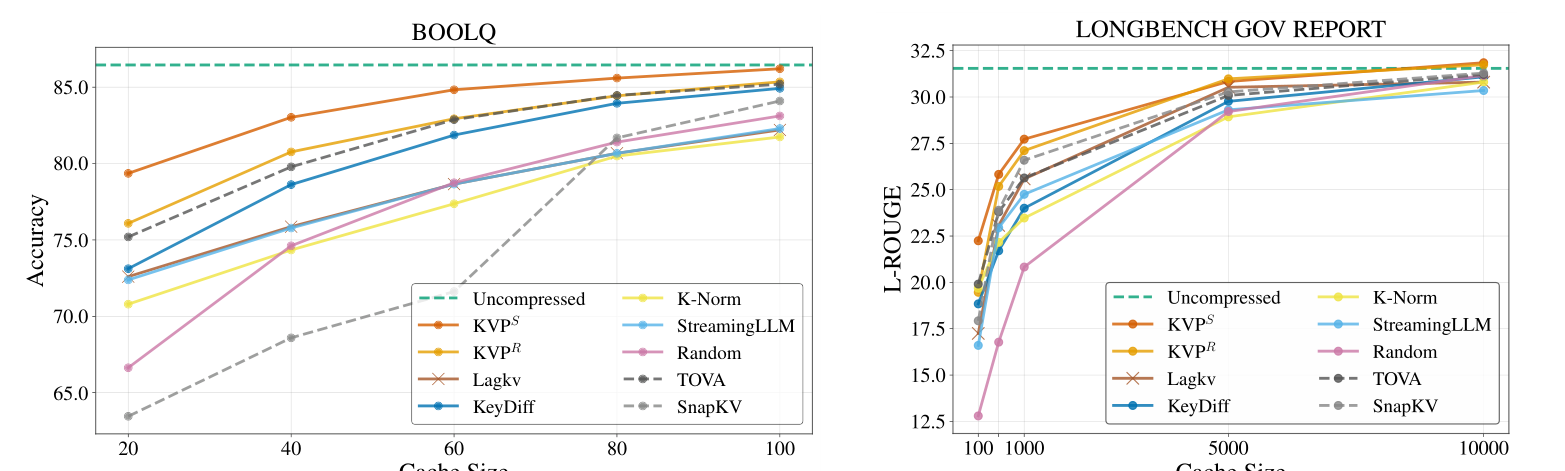
走读:两张图里 KVPS 和 KVPR(两条橙色)基本都贴着最上面那条”不压缩”虚线走,明显高过各路启发式。还有个有意思的专业化(specialization)现象:KVPS 是在对话数据 OASST2 上训的,它在 BoolQ、GovReport 这类更偏自然语言的任务上更强;而论文里另一张图显示 KVPR(RULER 训练)在 LongBench 的段落检索任务上更占优,和它检索式的训练分布对得上。这不是缺点,反而说明一件实用的事:你可以拿贴近自己业务的数据训一个专属 KVP 策略,同时还继承了跨任务的整体鲁棒性。
9. 消融:既然 reward 退化成加权求和,为什么还要 RL
这是全文最该深挖的一个消融,也是审稿人一定会问的。回看第 5 节,holistic reward 最后退化成了一个”按排名加权的未来注意力求和”——它看起来就是个有监督的目标啊,那为什么非得用 RL,而不是直接拿监督式的 learning-to-rank 去拟合?
论文很诚实地把这个对比做了:用同样的网络、同样的数据、同样的输入特征,换五种监督式排序目标——(i) Pointwise 回归(直接回归每个 token 的未来注意力 $u_i=\sum_{j} A(x_i,x_j)$)、(ii) Pairwise 的 RankNet、(iii) Listwise 的 ListNet、(iv) 用可微排序器做的 Soft-Sort、(v) 按真值重要性加权的 Weighted Soft-Sort。先看怎么读这张图:两个子图都是 OASST2 上某个代表性 head(layer 10, head 0)的每 budget 代价 $-R_b$(越低越好)随 cache size 的变化;左图 (a) 是 KVP 和各路 baseline 的对比,右图 (b) 是 KVP(图里写作”RL Agent”)和那五种监督式方法的对比。
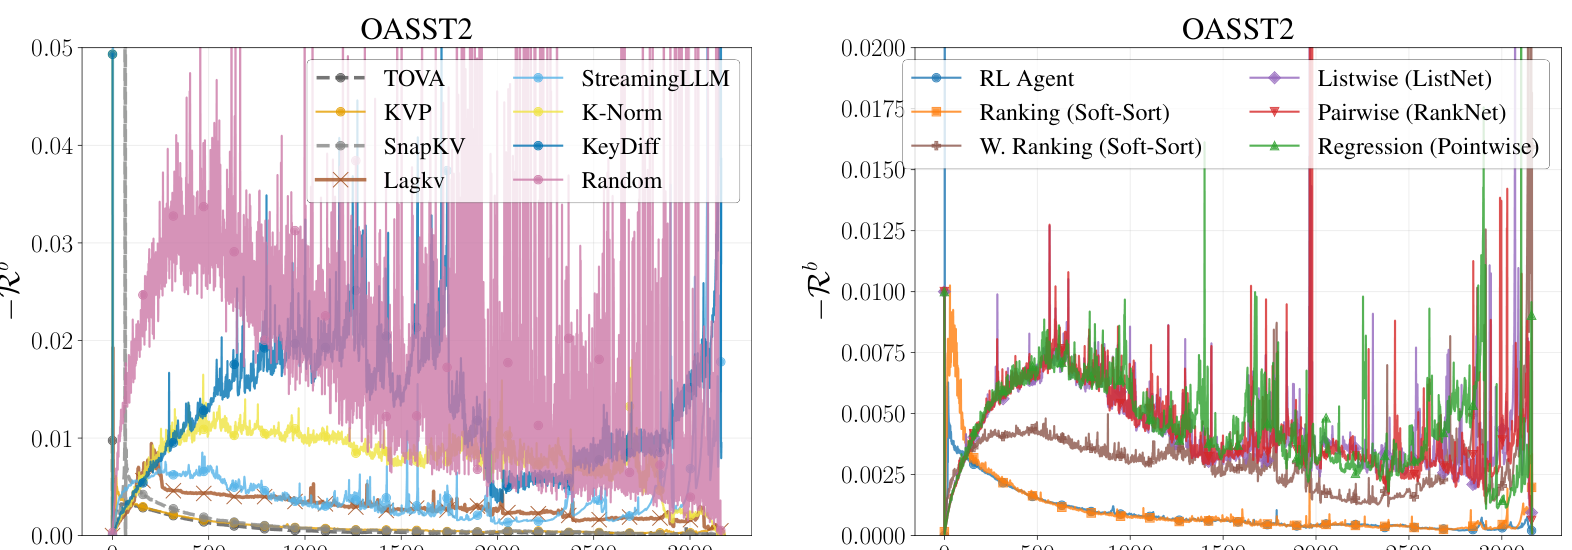
先走读左图 (a):所有方法清晰地裂成两簇——用了注意力特权信息的(虚线,TOVA/SnapKV)聚成低代价的一簇,纯 attention-free 的启发式聚成高代价的一簇。而 KVP(橙/黄)直接挤进了低代价那一簇,和 TOVA、SnapKV 并肩,却完全没用它们的特权信息。换句话说,离线 RL 把”基于注意力的排序”那套本事,蒸馏进了一个只看 key/value 的静态策略里。
右图 (b) 才是回答”要不要 RL”的关键。原因出在注意力分布是重尾的(heavy-tailed,近似 Zipfian 分布)——极少数 attention sink 占了绝大部分注意力值。这一下就把监督式方法的毛病逼出来了:
- 对数值敏感的损失(Pointwise 回归、Pairwise、Listwise、Weighted Soft-Sort)会把模型容量都砸在那几个数值巨大的 sink 上。结果就是:在最小 budget 下还行(反正那时候留住 sink 就够了),但 budget 一放大,代价就一直压不下来——因为它根本没学会 sink 以外那些普通 token 之间的相对顺序。
- 对数值不敏感的 Soft-Sort(纯排名损失)正好相反:它在曲线主体部分能贴着 RL 走,但在最紧的 budget 处猛地翘起来——恰恰是最重要的 token 扎堆的地方。因为纯排名损失对”任意两个 token 换位”一视同仁地惩罚,分不清谁是真正该排最前的那几个。
- Weighted Soft-Sort 想两头讨好,结果把数值权重一加回来,又塌回”过度关注 sink”的老路了。
论文的结论下得很到位:理论上一定存在某种”随排名重新加权”的损失能同时搞定两头,但它的形状依赖每个 head、每个输入的重要性分布,而这个分布 head 与 head 之间差异极大,等于要给每个 head、每个 cache 都重新调一遍。而直接用策略梯度去优化那个 AUC就一劳永逸地绕开了这件事:每一次换位带来的惩罚,天然正比于它对总 AUC 的贡献,学习信号自带代价权重、且与分布无关。这就是 RL 在这里不可替代的理由——不是因为 RL 玄学更强,而是因为策略梯度恰好匹配了这个重尾、按 budget 加权的目标结构。
10. 总结
KVP 把 KV cache 驱逐从”手工启发式”彻底搬到了”可学习的排序策略”上,整条逻辑链是自洽的:用一个只看 key/value/position 的小 MLP 给 token 打分 → 用 Plackett-Luce + Gumbel-Sort 把分数变成排列 → 用一个一次性评估所有 budget 的 holistic reward(负的归一化未来注意力 AUC)来评价排列 → 全程离线、用预录的 Q/K/V 轨迹 + RLOO 训练 → 推理时每个 head 排序砍尾、不碰注意力矩阵、不改原模型、不加推理开销。
几个最值得记住的点:一是它把”未来价值”这个过去只能用启发式近似的量,变成了可以直接学的目标,并且学出来的策略能从 4K 干净外推到 128K;二是 per-head 专业化 + holistic reward 的组合,让它在不用注意力特权信息的前提下追平甚至反超了 TOVA/SnapKV 这类方法;三是”为什么要 RL”这个问题被认真回答了——重尾分布下,策略梯度对 AUC 的直接优化是监督式排序损失难以替代的。
局限论文自己也摆得很清楚:目前对所有 head/layer 用统一 budget,没做自适应的非均匀分配;per-head 独立训练,没建模 head 之间的依赖;reward 用未来注意力当任务效用的代理,而非直接的下游任务反馈;以及还缺一套端到端优化过的推理工程,所以论文报的是策略层面的 wall-clock,而不是整系统延迟。这几条每一条都是现成的后续方向。对想做 LLM 推理效率的人来说,这篇最大的启发或许是:很多我们习惯用启发式去拍的地方,其实都可以退一步问一句”这个量能不能直接学”。
扯一句题外话。KVP 这种”把一个本来靠手工规则做的取舍,改成让模型自己学出一个策略”的思路,和我们之前整理《动手学 AutoML:从 NAS 到大语言模型优化实战》时的一条主线其实是相通的。书里讲 NAS 搜索策略那章,专门写过怎么用强化学习去搜索一个离散的结构选择(哪条边、哪个算子该留下)——本质也是”在一个组合空间里学会做保留/丢弃的决定”,和 KVP 学 token 的去留是一个味道;另外第 8、11 章讲 LLM 压缩(剪枝、量化),目标同样是”尽量不掉点的前提下把模型变小”。当然对象不一样:KVP 压的是 KV cache、搜的是 token 顺序,书里压的是权重、搜的是网络结构。角度不同,目标相近,感兴趣的话可以当扩展读物翻翻。
