DuetServe:单张 GPU 内自适应切 SM,让 prefill 和 decode 不再“互相拖累”
DuetServe:单张 GPU 内自适应切 SM,让 prefill 和 decode 不再“互相拖累”
原文:DuetServe: Harmonizing Prefill and Decode for LLM Serving via Adaptive GPU Multiplexing(arXiv 预印本,USC / UC Riverside / UW–Madison)
1. 在线 LLM 服务的两难:既要吞吐,又要守住每个 token 的延迟
你有没有仔细想过,当一个 LLM 服务同时顶着几千条并发会话时,机房里那张 GPU 到底在同时干两件什么性质完全不同的活?
一次 LLM 推理,通常被拆成两个阶段,这两个阶段对硬件的要求几乎是对立的。第一个阶段叫 prefill(预填充):把用户输入的整段 prompt 一次性喂进模型,做一遍前向,算出所有 token 的 key/value 并写进缓存。这一步要同时处理成百上千个 token,矩阵乘法又大又密,是典型的 compute-bound(算力受限)——只要 batch 够大,就能把 GPU 的计算单元喂满。第二个阶段叫 decode(解码):一个 token 一个 token 地往外蹦,每生成一个新 token,都要把前面所有 token 的 KV cache(键值缓存,attention 里缓存下来的 key/value,省得每步重算)从显存里读一遍。它每步真正要算的东西很少,瓶颈全在显存读写上,是典型的 memory-bound(访存受限),卡在 HBM(High Bandwidth Memory,GPU 的高带宽显存)的容量和带宽上。
这两个阶段的性格差异,直接决定了衡量一个服务好不好用的两个核心指标:
- TTFT(Time-to-First-Token,首 token 延迟):从请求到达到吐出第一个字要多久,主要由 prefill 决定——prompt 越长、prefill 越慢,用户等得越久。
- TBT(Time-Between-Tokens,token 间延迟):生成过程中相邻两个 token 之间隔多久,主要由 decode 决定——它直接决定了用户看到的”打字机”流畅不流畅,一卡顿体验就崩。
线上服务通常会给这两个指标各压一条 SLO(Service Level Objective,服务级别目标,说白了就是”延迟不能超过某个红线”),比如一个常见的要求是 TBT 不超过 100 ms。问题就出在这里:吞吐和延迟是一对冤家。为了把吞吐做上去,现代推理框架普遍用 continuous batching(连续批处理,ORCA 提出的做法:在每个 decode 步都能动态塞进新请求、踢掉已完成的请求,这样短输出的请求不用陪着长输出的一起等)把尽量多的请求攒成一个大 batch 一起算。但一旦把一段很长的 prefill 塞进一个正在 decode 的 batch 里同步执行,这段又重又慢的 prefill 就会把整个 batch 卡住,正在流畅输出的那些 decode 请求的 TBT 瞬间被拉爆,SLO 直接击穿。
所以 LLM serving 的核心矛盾,本质上是把两个性格相反的阶段放在同一张卡、同一个 batch 里同步执行时的互相干扰。 DuetServe 这篇 ICML’26 的工作,想解决的就是这个干扰——而且它的解法有点反直觉:不买更多卡、不做物理隔离,而是在单张 GPU 内部动态地把计算核心切成两块,让 prefill 和 decode 真正并行。下面先把现有两条路为什么都不干净讲清楚,这个解法的价值才立得住。
2. 现有两条路都不干净:aggregate 会互相干扰,disaggregate 在浪费显卡
面对这个干扰,业界目前有两条主流路线,分别叫 aggregate(聚合,prefill 和 decode 共享同一张 GPU)和 disaggregate(分离,prefill 和 decode 拆到不同 GPU 上)。两条路都能跑,但各有各的死穴。
2.1 aggregate 路线:chunked prefill 治标不治本
aggregate 这条路最有代表性的优化是 chunked prefill(分块预填充,Sarathi-Serve 提出)。它的想法很朴素:既然一整段长 prefill 会把 batch 卡住,那就别让它一次做完——设一个 token budget(token 预算,每次迭代最多处理多少 token),把长 prefill 切成一小块一小块,分几次迭代做,每次只占用预算里剩下的额度。预算怎么定?按经验是去 profile 一个 linear 层,找 roofline 曲线(屋顶线模型,横轴是计算强度、纵轴是可达性能,低强度区被带宽卡住、高强度区被算力卡住,中间那个拐点就是”刚好把算力喂饱”的甜点)的那个”膝盖拐点”,让 linear 层利用率最大化。GPU 换代,这个预算也跟着涨:A100 上大概 2048 token,到 H100 就涨到 8192。
但这套逻辑有两个漏洞,论文用下面这张图点出来了。先说怎么读这张图:三个子图从左到右,(a) 是 linear 层随 token 预算的性能/延迟曲线,(b) 是 prefill 阶段的延迟构成,(c) 是 decode 阶段的延迟构成;(b)(c) 里堆叠的颜色是各类算子(linear / norm / silu / attn)各占多少延迟,黑线是 attention 占总延迟的百分比(右轴)。
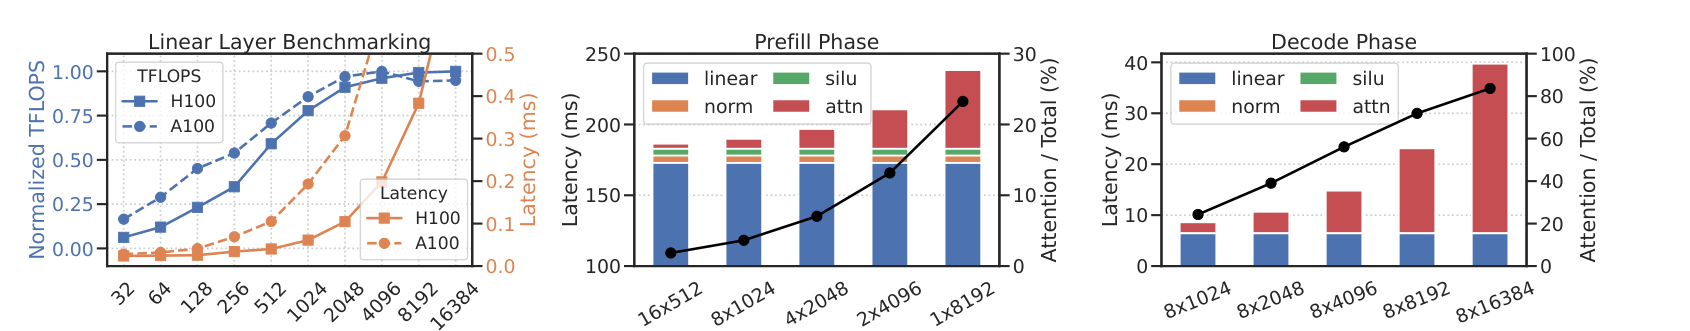
第一个漏洞:把预算吃满,照样会违反 TBT。 看 (a),4096×4096 的 linear 层确实在 A100 上约 2048 token、H100 上约 8192 token 处”饱和”(曲线到顶),这就是大预算的来由。但看 (b),H100 上用 8192 的预算跑纯 prefill batch,单次迭代延迟稳稳超过 180 ms——这还只是 prefill 自己。一旦这个 batch 和 decode 混在一起同步执行,decode 的 TBT 也会被抬到 180 ms 这个量级,直接把 100 ms 的 TBT SLO 顶穿。想守住 SLO 就得调小预算,可预算一小,linear 层利用率又掉下来,吞吐跟着牺牲。这就是论文的 Observation 1:吃满预算会违反 TBT,调小预算又拖垮吞吐,两头不讨好。
第二个漏洞:token 预算这套算账,压根没把 attention 的成本算进去。 prefill 的 attention 成本是随 prompt 长度平方增长的,固定 token 预算根本摁不住它。看 (b) 最右边那根柱子,当这 8192 个 token 来自单条序列(1x8192)而不是摊在多条短序列上时,attention 一下子吃掉了约 25% 的前向延迟——而这部分是预算完全没管的。decode 阶段更夸张,看 (c):所有设置都用同样小的 token 预算(8),但随着上下文变长,延迟出现了 4 倍以上的波动,attention 占比从约 20% 一路爬到 80% 以上。原因很直接:decode 每步都要把越来越长的 KV cache 读一遍,上下文一长,访存就彻底主导了运行时间。这是 Observation 2:token 预算这套调度策略在 prefill 和 decode 两头都忽略了 attention 成本,根本给不出稳定的 TBT 控制。
2.2 disaggregate 路线:隔离干净,但在白白烧卡
既然同一张卡上会互相干扰,那就物理隔离——这就是 disaggregate 路线:拿一部分 GPU 专做 prefill,另一部分专做 decode,两边井水不犯河水(DistServe、Splitwise、Mooncake、Dynamo 都是这条路)。隔离确实干净了,但代价是资源利用率。论文拿 Qwen3-8B 在两张 H100 上做了对照:aggregate 版用 vLLM(两张卡各放一份完整模型、轮询分发请求,预算 8192),disaggregate 版用 Dynamo 的 1P+1D 配置(一张卡专做 prefill,一张卡专做 decode)。
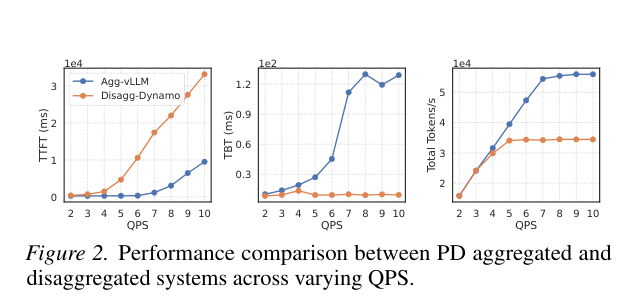
这张图三个子图分别是 TTFT、TBT、总吞吐(Total Tokens/s)随 QPS(Queries Per Second,每秒请求数,衡量负载压力)的变化,蓝线是 aggregate 的 vLLM,橙线是 disaggregate 的 Dynamo。怎么读:先看中间的 TBT 子图,disaggregate(橙线)的 TBT 确实一直压得很平很稳——这是物理隔离的好处。但代价全写在另外两张图上:左边 TTFT 子图里,disaggregate 在 QPS 超过 4 就开始飙升,而 aggregate 要到 QPS=7 才开始饱和;右边吞吐子图里,disaggregate 的总吞吐还不到 aggregate 的一半。
根因是资源失衡:aggregate 版两张卡都能并发做 prefill,等于把 prefill 吞吐翻了倍;而 disaggregate 版只拿一张卡做 prefill,这张 prefill 卡就成了整个系统的瓶颈,QPS 一高,prefill 跟不上 decode,整体吞吐就被拖垮。这是 Observation 3:disaggregate 系统能满足 TBT SLO,但 GPU 没吃满,整体请求吞吐反而更低。更麻烦的是,prefill 和 decode 的最优配比取决于输出长度分布,而这个分布在服务时根本事先不知道;配比一旦不匹配就得切 GPU 的角色,而切角色要重新加载模型、重建 KV cache,慢得追不上请求级的流量波动。
两条路摊开看就很清楚了:aggregate 利用率高但隔离不了干扰,disaggregate 隔离干净但在烧卡。有没有办法”只在真的要打架的时候才隔离,平时还是合着跑把卡吃满”?这就引出了 DuetServe 的切入点。
3. 转机在于:prefill 吃算力、decode 吃带宽,正好互补
DuetServe 能”单卡内隔离”的底气,来自一个硬件层面的观察:prefill 和 decode 对 GPU 两类资源的需求,恰好是互补的。要讲清楚这件事,得先引入 SM 和 TPC 这两个粒度。SM(Streaming Multiprocessor,流多处理器)是 GPU 里真正干计算的核心单元,一张 H100 有一百多个;而 TPC(Texture Processor Cluster,纹理处理器簇)是比 SM 更粗一级的分组,每个 TPC 包含 2 个 SM,是做 SM 切分时的最小单位(H100 上一共 66 个 TPC 组)。
下面这张图把互补性摆了出来。怎么读:(a) 是单看硬件——横轴是激活的 TPC 数量,两条线分别是实测的 HBM 带宽(橙,左轴)和算力 FLOPs(蓝,右轴);(b)(c) 是跑真实负载——分别是 prefill 和 decode 阶段里,SM 占用率(蓝)和 HBM 读带宽占用率(橙)的对比。
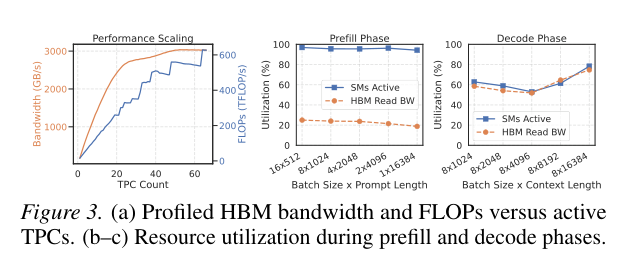
先看 (a) 这个关键的非线性现象:HBM 带宽随 SM 数量是超线性上涨的——只用 20% 的 SM,就能跑到约 60% 的峰值带宽;而 FLOPs 则是随 SM 数量大致线性增长的(除了 TPC 离散激活带来的小台阶)。这意味着什么?访存密集的活儿,用一小撮 SM 就能把带宽基本吃满;而算力密集的活儿,SM 给得越多算得越快。
再看 (b)(c) 的互补:compute-bound 的 prefill 阶段(b),SM 占用率顶满了,但 HBM 带宽大片闲置;memory-bound 的 decode 阶段(c)正好反过来,HBM 流量很高,SM 却大量空转。一个把算力吃满、带宽空着,一个把带宽吃满、算力空着——把它俩塞到同一张卡上并行,让 prefill 用大头 SM 去啃算力、decode 用一小撮 SM 去走带宽,两类资源就都能更充分地复用。 这就是 DuetServe 的物理基础。
但光有互补性还不够,得有办法在”同一个进程、同一张卡”内部,把 SM 真正切开分给不同的计算流。论文梳理了几种现成机制,都不太趁手:MIG(Multi-Instance GPU)把一张卡静态切成几个隔离实例,粒度粗且重配昂贵;MPS(Multi-Process Service)支持粗粒度的空间共享,但只能跨进程、不能在单进程内用,重配开销也高;GreenContext 能做进程内 SM 切分,但要快速重配就得预先创建多个 context,带来额外显存开销。
DuetServe 用的是 libsmctrl(Bakita & Anderson, RTAS 2023 的一个底层库,开源,仓库里就是把 SM/TPC 掩码喂给 CUDA 的那套实现)。它的本事是:在 kernel 或 stream 启动时,直接控制这个 kernel 能看见多少个 SM——相当于给每条计算流发一张”你只能用这些 SM”的掩码。它工作在驱动层(基于 libcuda.so),对应用和模型代码完全透明,不用改一行模型实现,重配开销也极低。这把”在单卡内按 SM 粒度随时切分”从理论变成了工程上可行的事。这种”把一张卡的 SM 切成几块、让不同 kernel 并发跑在不相交的 SM 子集上”的做法,就是本文反复说的 spatial multiplexing(空分复用)/ SM partitioning(SM 切分)。
4. DuetServe 的总思路:默认合着跑,预测要超时才在单卡内切 SM
有了”互补”和”能按 SM 切”这两块基础,DuetServe 的整体策略就可以用一句话概括:默认让 prefill 和 decode 合着跑(aggregate),把卡吃满;一旦预测到这次迭代会把 TBT 顶穿,才临时在单卡内切 SM,把两阶段隔离开并行执行(相当于片内的 disaggregate);等干扰过去再切回合着跑。 这样平时拿的是 aggregate 的高利用率,关键时刻又能临时获得 disaggregate 级别的隔离,还不用长期背着模型复制、KV cache 跨卡搬运这些 disaggregate 的固定成本。
下面这张总览图把整条决策链画出来了。怎么读:左边是一条自上而下的调度主干,中间那个菱形是整个系统的”开关”,右边两张小图是开关两个分支各自对应的执行形态(上半是 Temporal Sharing,下半是 Spatial Sharing)。
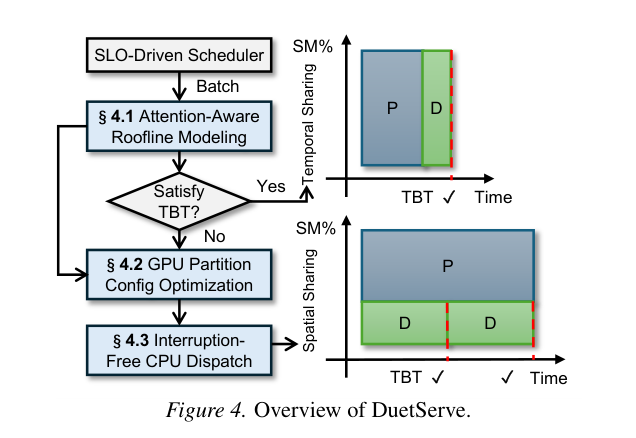
顺着主干走一遍:
- SLO-Driven Scheduler(SLO 驱动调度器):每轮迭代先按常规的 chunked prefill 攒 batch——优先把正在进行的 decode 请求排上,再用剩下的 token 预算去接等待中的 prefill 请求;如果剩余预算装不下一整条 prompt,就把它切块做部分 prefill。到这一步为止,和普通 aggregate 调度没区别。
- §4.1 Attention-Aware Roofline Modeling(attention 感知的屋顶线建模):拿到这个 prefill-decode 混合 batch 后,用一个把 attention 成本也算进去的 roofline 模型,预测这次迭代大概要跑多久。
- Satisfy TBT?(能满足 TBT 吗):这就是那个菱形开关。如果预测延迟没超 TBT 红线(Yes),走右上角的 Temporal Sharing(时分共享)——所有 SM 不切,prefill(P) 和 decode(D) 像平时一样在一个统一上下文里顺序执行,一次迭代内就能满足 TBT。
- 如果预测会超(No),就触发 §4.2 GPU Partition Config Optimization(GPU 分区配置优化):把 batch 拆成纯 decode 和纯 prefill 两组,解一个优化问题,决定该把多少 SM 分给 prefill、多少分给 decode。对应右下角的 Spatial Sharing(空分共享)——P 独占一块 SM,D 独占另一块,两条流并行,decode 不再被 prefill 每层卡一下,于是能在约束内连吐好几个 token。
- §4.3 Interruption-Free CPU Dispatch(免打断的 CPU 调度):真要让两条流并行起来,还得解决 CPU 侧每步同步造成的空泡,这是让空分真正跑出效率的工程保障。
这里有个容易被忽略但很关键的设计选择:切不切、怎么切,不是靠跑完一轮测出来再回头调,而是靠一个解析模型提前预测。因为 decode 的 TBT 是硬实时约束,等它真超了再反应就晚了。所以整套方法的第一块硬骨头,是那个”预测得准不准”的 roofline 模型。
5. 怎么预测一次迭代要多久:attention-aware roofline 模型
roofline 模型的核心思想很简单:任何一个算子,要么卡在算力上、要么卡在带宽上,它的延迟就取”算完要多久”和”搬完数据要多久”里更大的那个。写成一行就是
\[t = \max\left(\frac{F}{\Pi_{\text{SM}}},\ \frac{B}{\mathcal{B}_{\text{HBM}}}\right),\]其中 $F$ 是这个算子的 FLOPs(要算多少),$B$ 是要搬的字节数(要读写多少),$\Pi_{\text{SM}}$ 是当前这批 SM 能提供的算力吞吐,$\mathcal{B}{\text{HBM}}$ 是这批 SM 能达到的 HBM 带宽。注意 $\Pi{\text{SM}}$ 和 $\mathcal{B}_{\text{HBM}}$ 都是 SM 数量的函数——这正是它能用来指导”切多少 SM”的关键:给的 SM 不同,算力和带宽都变,预测出的延迟也跟着变。
Sarathi-Serve 那套只盯着 linear 层,而 DuetServe 这个模型的”attention-aware”就体现在:它把算子分成三类,分别建模,attention 被单独拎出来认真算。
第一类,token-level 算子(linear 投影、layernorm、激活函数等),它们的成本只跟 batch 里的总 token 数有关,不管这些 token 是 prefill 来的还是 decode 来的。以 linear 算子为例,给定总 token 数 $n$、输入维度 $d_i$、输出维度 $d_o$、元素字节 $b$:
\[F_{\text{lin}} = 2 n d_i d_o,\qquad B_{\text{lin}} = n d_i b + d_i d_o b + n d_o b.\]$F_{\text{lin}}$ 就是矩阵乘的标准 FLOPs;$B_{\text{lin}}$ 的三项分别对应读输入、读整块权重、写输出。QKV 投影、输出投影、gate-up、down 投影都套这个式子,只是 $d_i, d_o$ 取值不同。
第二类,sequence-level 算子,也就是 attention——这是 Sarathi-Serve 漏掉、而这篇补上的大头。attention 的成本同时取决于每条请求的 query 长度 $q$ 和已缓存的 KV 长度 $c$。记 query 头数 $h_q$、KV 头数 $h_{kv}$、头维度 $d_h = d/h_q$,单条请求的 FLOPs 和访存字节是:
\[F_{\text{attn/req}}(q,c) = 4 h_q q (q+c) d_h + 2 h_q q (q+c),\] \[B_{\text{attn/req}}(q,c) = 2 h_q q d_h b + 2 h_{kv} (q+c) d_h b.\]$F_{\text{attn/req}}$ 第一项是 query-key 相似度和 attention-value 聚合这两个主导矩阵乘,第二项是 softmax、scaling 这些逐元素操作;$B_{\text{attn/req}}$ 则涵盖 query、key、value、output 的读写。整个 batch 的 attention 延迟是逐请求套 roofline 再加起来:
\[t_{\text{attn}} = \sum_{r=1}^{|\mathcal{R}|} \max\left(\frac{F_{\text{attn/req}}(q_r,c_r)}{\Pi_{\text{SM}}},\ \frac{B_{\text{attn/req}}(q_r,c_r)}{\mathcal{B}_{\text{HBM}}}\right).\]这个 $(q,c)$ 的参数化很巧,它一套式子覆盖了三种形态:$q>1, c=0$ 是普通 prefill,$q>1, c>0$ 是 chunked prefill(前面已经做过一部分,有缓存了),$q=1, c>0$ 正好是 decode(每步只处理 1 个新 query token、但要读一长串缓存)。第 2 节说的”decode 延迟随上下文平方级增长”,在这里就是 $c$ 变大时 $B_{\text{attn/req}}$ 跟着涨、延迟被访存项主导——模型天然能预测到。
第三类,communication 算子,只在多卡 TP(tensor parallelism,张量并行,把一层的权重切到多张卡上、算完再同步)时才有。这时每层要为 attention 输出和 FFN 输出做一次 ring AllReduce 同步,论文用一个三项式建模它的延迟:
\[t_{\text{allreduce}} = 2(N-1)\alpha + \frac{2(N-1)B_{\text{lin},o}}{N \mathcal{B}_{\text{NVLink}}} + \frac{N(N-1)B_{\text{lin},o}}{\Pi_{\text{SM}}},\]$N$ 是卡数,$\alpha$ 是启动延迟(H100 上实测约 3 μs),三项分别对应固定启动开销、受 NVLink 带宽约束的数据传输、以及每张卡上的本地归约。最后把每个 Transformer block 的各类算子成本加起来,整模型延迟近似为 $t_{\text{total}} = L \cdot t_{\text{block}} + t_{\text{cls}}$($L$ 是层数,$t_{\text{cls}}$ 是最后那个分类头,按 $d_o = \text{vocab_size}$ 的 linear 算)。
模型准不准,直接决定了后面切 SM 切得对不对。论文在附录里做了验证。怎么读下面这张图:上面两张是 prefill、下面两张是 decode,横轴都是分给这条流的 TPC 数量,蓝实线是实测延迟、橙虚线是 roofline 预测。
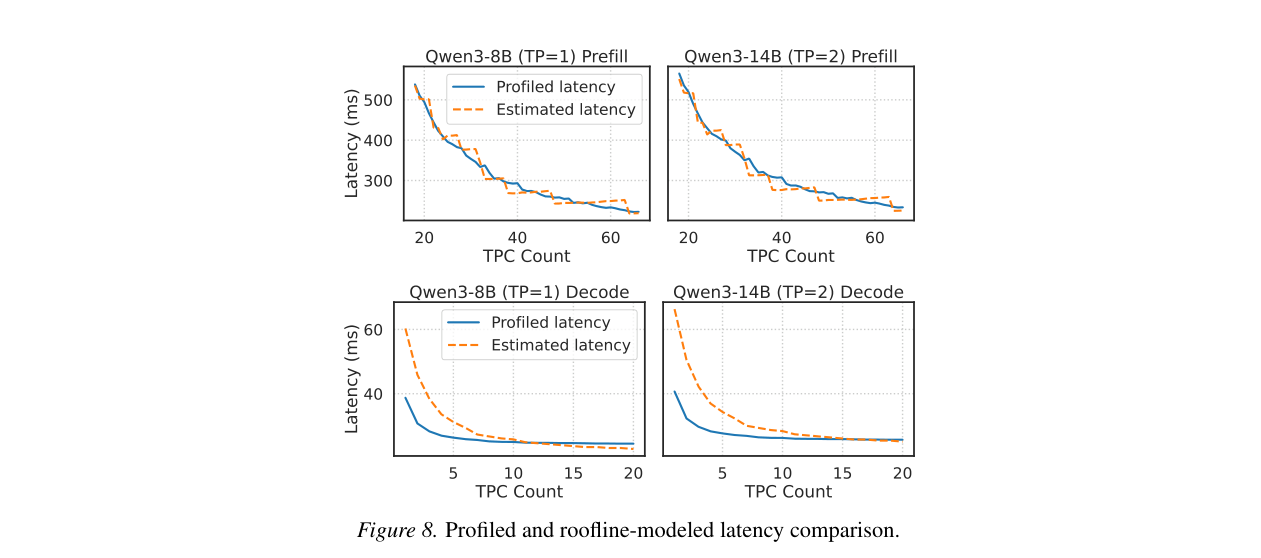
prefill 这边(上排),预测几乎贴着实测走,而且能清楚看出延迟随 TPC 数先近乎线性下降、到约 40 个 TPC 后曲线变平——这正印证了 prefill 是被 SM 算力卡住、不是被带宽卡住。decode 这边(下排)有意思:当分给 decode 的 TPC 很少时,模型是故意保守的,倾向于高估 decode 延迟。为什么要这么设计?论文讲得很实在:高估 decode 顶多在 decode 侧留一点计算空泡,而 decode 本来对总吞吐贡献就小(每步才产 1 个 token);但反过来低估 decode 更危险——那样优化器会给 decode 分太少的 SM、给 prefill 分太多,结果 prefill 要在同步点等 decode,在 prefill 侧憋出空泡,反而拖垮整体吞吐。所以宁可保守高估,不可冒进低估。
6. 怎么切 SM 最划算:TBT 约束下的分区优化器
roofline 一旦预测这次迭代要超 TBT,优化器就得回答一个具体问题:这张卡总共 $S$ 个 SM,分给 decode 多少(记 $S_d$)、分给 prefill 多少($S_p = S - S_d$),才能在守住 TBT 的前提下把总吞吐做到最大?
先把并发执行的形态讲清楚。触发切分时,decode 的 TBT 已经濒临违约,系统通常处在 $t_p(S_p) > t_d(S_d)$ 的区间——也就是一个 prefill batch 比一个 decode step 慢。为了别让快的那条流干等,DuetServe 的做法是:让 decode 在它那块 $S_d$ 上连跑 $k$ 个 step,同时 prefill 在它那块 $S_p$ 上跑一个 batch,两条流并行。这个配置的总延迟是
\[t(S_p, S_d, k) = \max\big(k\, t_d(S_d),\ t_p(S_p)\big),\]取 max 是因为两条流并行、以慢的那条为准,快的那条跑完会留一点空泡。设 $T_{\text{decode}}$ 是一个 decode step 产出的 token 数、$T_{\text{prefill}}$ 是这个 prefill batch 的 token 数,优化目标就是在 TBT 约束下最大化单位时间 token 产出:
\[\max_{S_p, S_d, k}\ \frac{k\, T_{\text{decode}} + T_{\text{prefill}}}{\max\big(k\, t_d(S_d),\ t_p(S_p)\big)}\quad \text{s.t.}\quad t_d(S_d) \le \tau_{\text{TBT}}.\]这个目标函数值得多看一眼:分子是这段并发里总共吐出的 token($k$ 步 decode 加一个 prefill batch),分母是这段并发实际花的时间,整体就是”有效吞吐”。约束 $t_d(S_d) \le \tau_{\text{TBT}}$ 保证分给 decode 的那块 SM 至少能让 decode 的 TBT 不超红线。论文点明了这个优化的一个自然倾向:它会尽量多给 prefill 分 SM 来压它的延迟,而只给 decode 分”刚好够满足 TBT”的最少 SM——因为 prefill 对总吞吐的贡献大得多,decode 够用就行。
具体求解就是把这套逻辑写成一个枚举过程,见下面的调度算法。怎么读:第 2–4 行是”不用切”的快路径,第 5 行往后才是切分优化,核心是第 8 行那层对 $S_d$ 的循环。
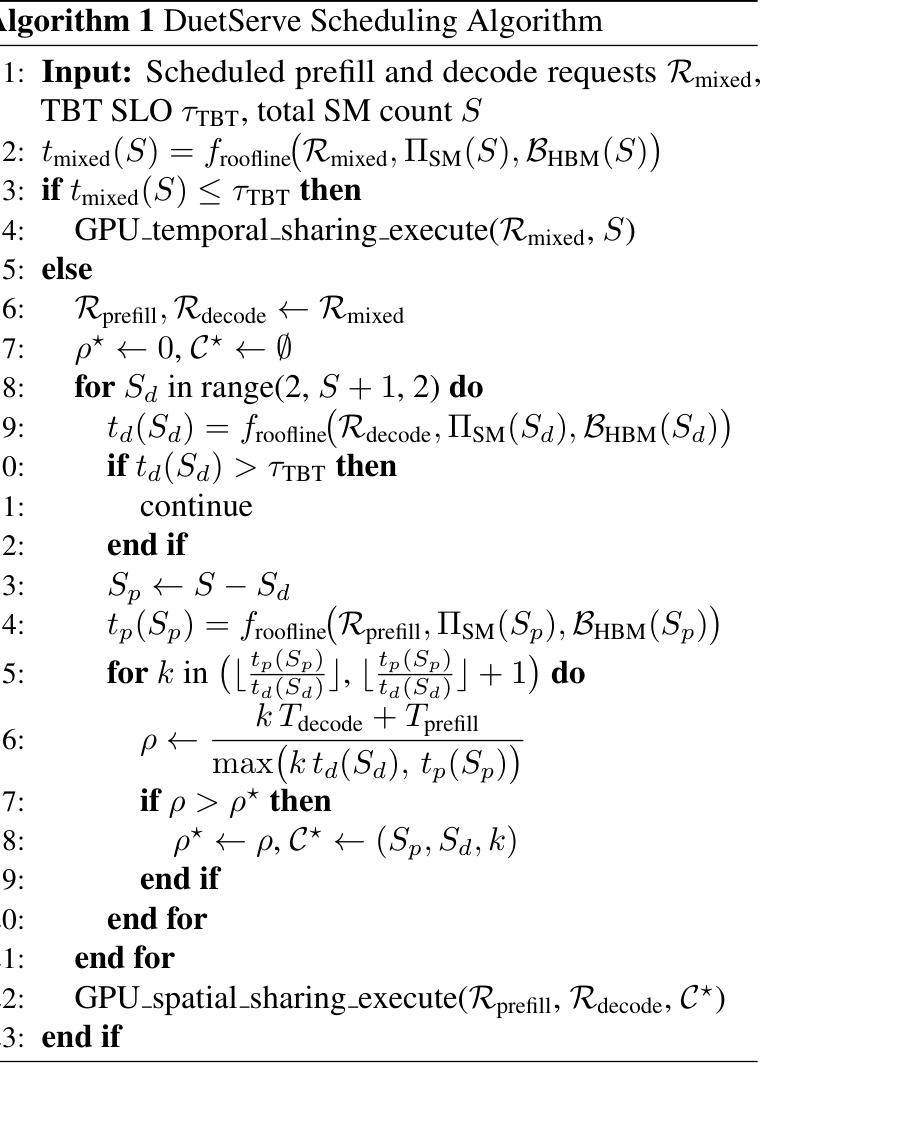
逐步走一遍:
- 第 2–4 行(快路径):先用 roofline 算整个混合 batch 用全部 $S$ 个 SM 跑要多久 $t_{\text{mixed}}(S)$;如果 $\le \tau_{\text{TBT}}$,直接
GPU_temporal_sharing_execute——不切,全卡合着跑,这就是默认的 aggregate 时分模式。 - 第 6–7 行:否则把混合 batch 拆成纯 prefill 组 $\mathcal{R}{\text{prefill}}$ 和纯 decode 组 $\mathcal{R}{\text{decode}}$,初始化最优吞吐 $\rho^\star = 0$。
- 第 8 行:
for Sd in range(2, S+1, 2)——注意步长是 2,因为切分的最小单位是 TPC(1 个 TPC = 2 个 SM),所以 $S_d$ 只能按 2 递增。 - 第 9–12 行:对每个候选 $S_d$,先算 decode 在这块 SM 上的延迟 $t_d(S_d)$;如果连它都 $> \tau_{\text{TBT}}$,这个配置连 TBT 都保不住,直接
continue跳过。 - 第 13–14 行:剩下的 SM 全给 prefill($S_p = S - S_d$),算出 $t_p(S_p)$。
- 第 15–20 行:枚举 decode 连跑的步数 $k$——只试 $\lfloor t_p(S_p)/t_d(S_d)\rfloor$ 和它 +1 这两个值(也就是”prefill 跑完的时间里 decode 大约能塞几步”的上下取整),算出有效吞吐 $\rho$,比历史最优好就更新 $\rho^\star$ 和最优配置 $\mathcal{C}^\star = (S_p, S_d, k)$。
- 第 22 行:拿着最优配置
GPU_spatial_sharing_execute,进入空分并行模式。
整个枚举的候选空间很小($S_d$ 按 2 步长、$k$ 只试两个值),所以 CPU 开销可以忽略——后面的 profiling 显示连带求解在内,调度开销控制在 1 ms 以内。
那么,为什么非要动态求解,不能像有些工作那样固定一个比例切好算了?论文做了对照:拿三种固定切分(Sd22-Sp44、Sd33-Sp33、Sd44-Sp22,分别是给 decode/prefill 固定分 22/44、33/33、44/22 个 TPC)去打 DuetServe 的动态切分。怎么读下面这张图:左右两组分别是 Qwen3-8B 和 Qwen3-14B,每组里按 Azure-Code / Azure-Conv / Mooncake 三种负载分簇,蓝柱是 DuetServe、其余三色是固定切分,纵轴是输出请求吞吐。
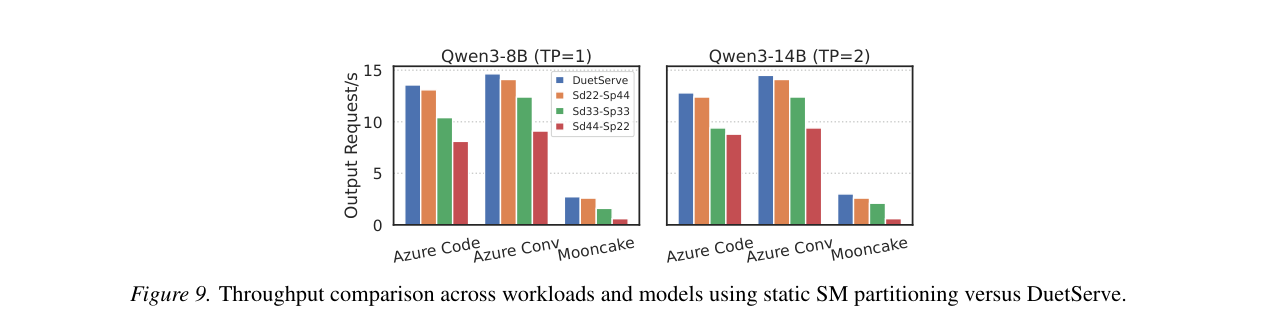
规律很清楚:没有哪个固定比例能通吃所有负载。对 prefill 重的负载,给 prefill 多分 SM 的 Sd22-Sp44 还行;换到别的负载它就不是最优了。固定切分的本质问题是,它要么让某一相闲着、要么让另一相拥塞,持续失衡。而 DuetServe 每轮迭代都重新解一次最优配置,在不同流量下都能贴着当前负载把 SM 掰到最划算的比例,所以蓝柱基本总是最高或并列最高。
7. 怎么让两条流真的并行起来:免打断调度 + look-ahead decode
算法算出了”该怎么切”,但要让 prefill 和 decode 两条流真的在物理上并行跑满,还隔着一层工程障碍:CPU 侧的同步开销。DuetServe 为此开两条独立的 CUDA stream,一条跑 decode、一条跑 prefill,用前面说的 libsmctrl 把每条 stream 绑到它那块 SM 区域上,两边互不干扰地并发派发 kernel。
但光开两条流还不够。传统 decode 有个老毛病:每生成一个 token,CPU 都要和 GPU 同步一次——采样出 token、过滤掉已完成的请求、更新 KV cache 的映射、准备下一步的输入 metadata。这一来一回会在 CPU–GPU 之间反复制造停顿(stall),GPU 频繁空等,根本没法和 prefill 持续重叠。下面这张图把问题和解法画在同一条时间轴上,怎么读:上半是传统做法、下半是 DuetServe 的做法,每半里从上到下三行分别是 CPU dispatch、GPU 的 prefill 流(stream_p)、GPU 的 decode 流(stream_d),灰色 Bubble 就是空等。
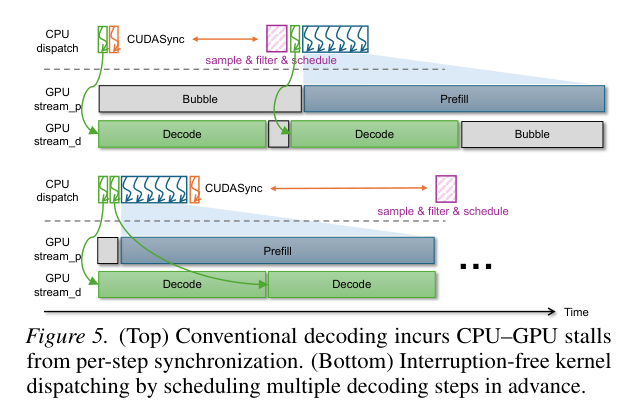
先看上半的传统做法:CPU 每派发一步就要 CUDASync 等 GPU 回来,做一轮 sample & filter & schedule,这期间 GPU 的 prefill 流只能挂着 Bubble 干等,decode 流也走走停停。这些空泡就是 CPU 每步同步逼出来的。
DuetServe 用两招把这些空泡挤掉:
第一招,让 decode 走 CUDA Graph,而且永远先发 decode。 CUDA Graph 是把一串固定的 kernel 预先录制成一张可重放的图,重放时启动开销极低。decode 每步的 kernel 序列是固定的,正好能录成 CUDA Graph;而 prefill 的 attention kernel 形状多变、控制流也不固定,没法这么录,只能让 CPU 一个个单独发。关键的数字是:重放一张 CUDA Graph 的开销不到 0.5 ms,而 CPU 单独派发 prefill kernel 要几十毫秒。所以调度器总是先启动 decode(图下半 stream_d 先动),再去慢慢发 prefill,这样 decode 不会被 prefill 那漫长的 CPU 派发过程堵在后面。
第二招,look-ahead decode(前瞻式解码),这是真正把 decode 从”每步同步”里解放出来的设计。既然优化器已经决定了 decode 要连跑 $k$ 步,那就一次性把这 $k$ 步要用的东西全准备好——给每条请求预分配 $k$ 个 KV cache 槽位,把未来 $k$ 步的 metadata 一次备齐。然后 CPU 把 $k$ 张预录的 CUDA Graph 连续发出去,中间不等任何同步。对照图下半:CPU 一口气把多个 decode step 排下去(那串连续的小块),GPU 的 decode 流就能连续执行好几步而不被打断,稳稳地和 prefill 流重叠。
这三块(roofline 预测、分区优化、免打断执行)合起来,才构成一个能真正落地的”按需单卡隔离”系统。
8. 实测:TBT 压得住,吞吐还更高
先交代下实验环境:两张 NVLink 互联的 H100(80 GB),配 96 核 Xeon Platinum 8480C,CUDA 13.0、PyTorch 2.8.0。DuetServe 从零实现,约 3000 行 Python,通过 Python API 调 libsmctrl 来控制每条 CUDA stream 的 SM 分配,并集成了 paged KV cache(PagedAttention 那套分块显存管理)、continuous batching、CUDA Graph、torch.compile 算子融合、FlashAttention-3,多卡用 NCCL 做 TP。模型是 Qwen3-8B(TP=1)和 Qwen3-14B(TP=2)。对比对象有四个:vLLM、SGLang-Default、SGLang-Chunked(开 chunked prefill,预算 8192)、Dynamo(1P+1D disaggregate,用 NIXL 搬 KV)。衡量指标是 mean TTFT、mean TBT、以及输出请求吞吐(完成的请求数 / 端到端服务时长)。
负载用了三个真实 trace,特征差异很大,见下表:
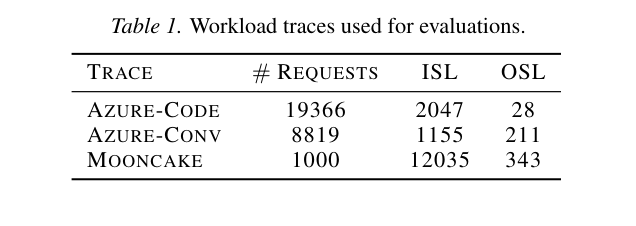
怎么读:ISL 是输入序列长度、OSL 是输出序列长度。Azure-Code(19366 条请求,ISL 2047 / OSL 28)是典型的 prefill 重、decode 极短——补全代码,输入一大段上下文、输出几十个 token;Azure-Conv(8819 条,ISL 1155 / OSL 211)输入输出相对均衡;Mooncake(1000 条,ISL 12035 / OSL 343)则是超长上下文。请求到达按 Poisson 过程模拟。这三种分布正好能检验 DuetServe 在不同 prefill/decode 配比下的表现。
先看 Qwen3-8B 单卡的端到端结果。怎么读下面这张大图:三列分别是 Azure-Code / Azure-Conv / Mooncake,三行分别是 Mean TTFT / Mean TBT / Output Requests/s,横轴都是 QPS,橙色方块是 DuetServe,另外三条是基线。
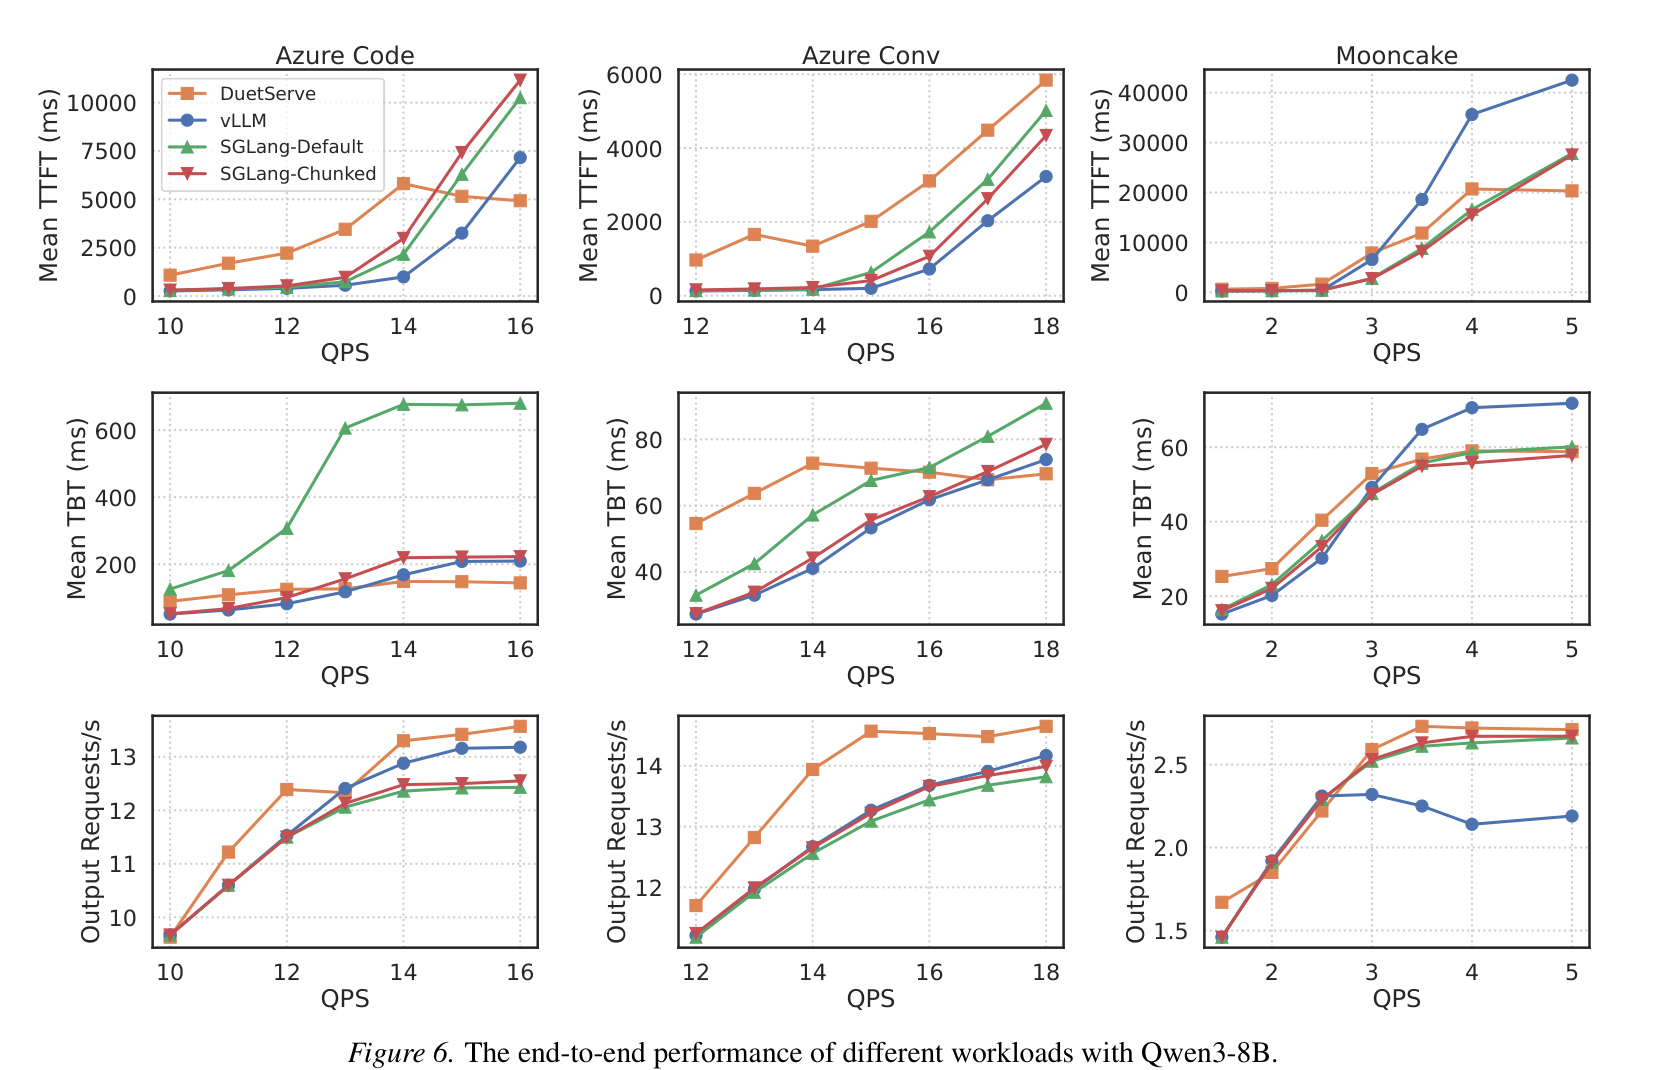
重点看中间那行 TBT(这是 DuetServe 要守的红线)和最下面那行吞吐。在 Azure-Code 这个 prefill 重的负载上,QPS 打到 16 时,DuetServe 的 TBT 稳稳压在 150 ms 以下,而 vLLM 和 SGLang-Chunked 都冲破了 200 ms,SGLang-Default 更是失控飙到 680 ms 以上(它会机会性地插入纯 prefill batch,频繁打断 decode)。吞吐上,DuetServe 在 QPS=16 做到 13.57 req/s,比 SGLang-Default 的 12.43 req/s 高约 1.1×。到了 Mooncake 这种超长上下文负载,优势更明显:vLLM 在 QPS=5 时是 2.14 req/s,DuetServe 做到 2.72 req/s,高约 1.3×。
这里有个诚实的权衡要说清楚:DuetServe 在轻载时的 TTFT 略高于 vLLM(看最上面那行)。这是它有意为之的设计取舍——优先护住 decode 的 TBT SLO,用剩余的 GPU 资源机会性地推进 prefill,所以 prefill(以及 TTFT)在重载时会被适当放后。换来的是重载下 decode 延迟稳定、吞吐更高。
多卡(Qwen3-14B,TP=2)的结论一致。下图是 Azure-Code 负载、三个子图分别是 TTFT / TBT / 吞吐,多了一条 Dynamo-1P1D(disaggregate 基线)。
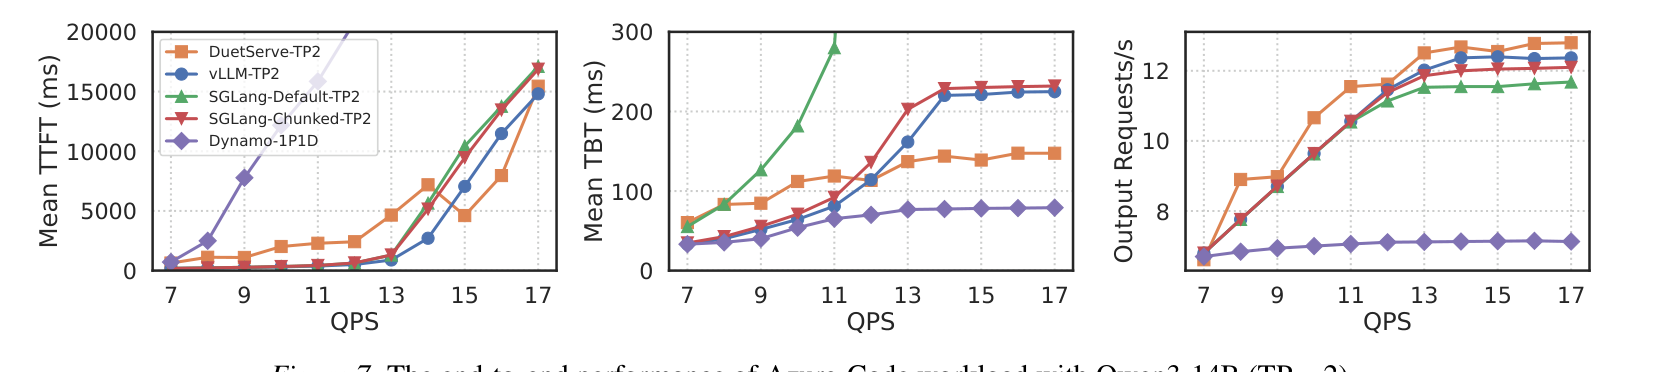
DuetServe-TP2(橙)拿到了第二低的 TBT,同时吞吐最高。vLLM-TP2 和 SGLang-Chunked-TP2 的 TBT 在 QPS 超过 13 后冲破 200 ms,DuetServe 仍压在 150 ms 以下。值得玩味的是 Dynamo-1P1D(紫):它的 TBT 最低——这正是物理 disaggregate 的隔离优势——但吞吐垫底,因为那张专做 prefill 的 GPU 成了瓶颈,追不上 decode 的节奏,印证了第 2 节的 Observation 3。换句话说,DuetServe 用单卡内的按需切分,拿到了接近 disaggregate 的 TBT,却没付出它那份吞吐代价。
那么 DuetServe 的收益到底在什么场景最大?论文用合成负载做了个干净的拆解:固定输入长度 ISL=4096,只变输出长度 OSL,看吞吐和 TBT 怎么变。
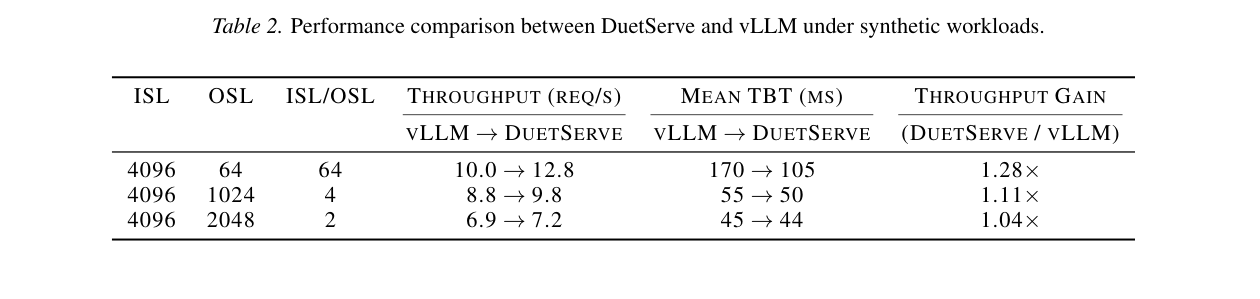
怎么读:ISL/OSL 这一列是输入输出比,比值越大越 prefill 重。三行从上到下,OSL 从 64 涨到 2048(越来越 decode 重)。看最上面一行(OSL=64,最 prefill 重):吞吐从 vLLM 的 10.0 提到 DuetServe 的 12.8 req/s,TBT 从 170 ms 降到 105 ms,增益 1.28×。往下走,OSL=1024 时增益掉到 1.11×(55→50 ms),OSL=2048 时只剩 1.04×(45→44 ms)。
这个趋势和论文整体的 insight 完全自洽:prefill 占迭代延迟比重越大,把 prefill 从 decode 里隔离出来的收益就越大;而 decode 重的场景本来 prefill-decode 之间的争用就少,自然就接近 aggregate 的行为了。 这也正是 DuetServe 默认 aggregate、只在必要时才切分的合理性所在——在 decode 重、没什么干扰的场景,它基本就一直合着跑,不去背 disaggregate 那份复制模型、搬 KV cache 的固定成本。
光看端到端数字还不够,论文用 profiler 抓了两轮连续迭代的真实执行,验证”两条流到底有没有真并行、模式切换顺不顺”。怎么读下面这张时间线图:横轴是时间,上半是 CPU 活动、下半是 GPU 的 SM 效率/利用率以及 prefill 流(stream 39)和 decode 流(stream 43)的占用。
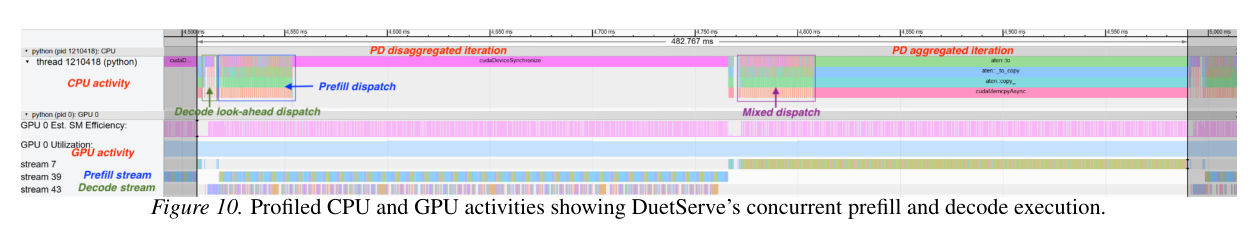
左半边标着 PD disaggregated iteration:这一轮触发了切分,调度器给 prefill 流分了 48 个 TPC、给 decode 流分了 18 个 TPC,decode 连跑 5 步再和 prefill 同步一次(对应优化器解出的 $k=5$)。可以看到 decode 流先启动(”Decode look-ahead dispatch”),prefill 稍后跟上,两条流大面积重叠,SM 效率稳定;而包含求解最优切分在内的 CPU 调度开销,整体控制在 1 ms 以内。右半边标着 PD aggregated iteration:下一轮 roofline 预测不会超 TBT,执行就切回了统一上下文的合着跑。这张图把”自适应地在空分和时分之间来回切”这件事坐实了——不是纸上的状态机,是真能按预测延迟逐迭代切换。
最后是扩展性。论文在 8 张 H100 上用 Qwen3-32B 跑 Azure-Conv(QPS=24),把 DuetServe(TP=8)和 Dynamo 正面对了一次。
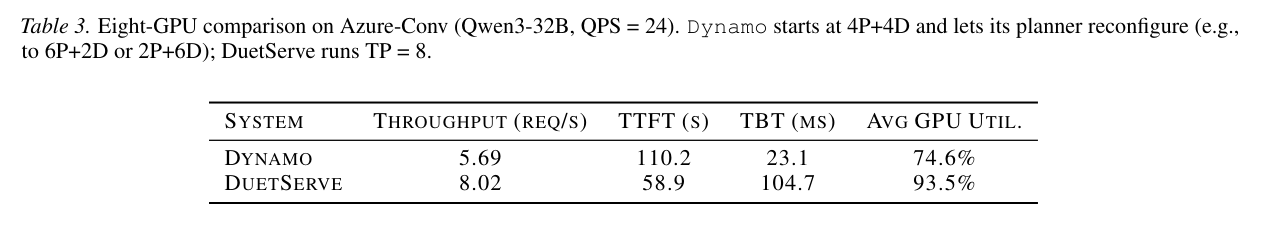
Dynamo 从 4P+4D 起步、让它的 planner 运行时重配到最优比例(比如 6P+2D 或 2P+6D)。结果:吞吐 5.69 req/s,TTFT 110.2 s,TBT 23.1 ms,平均 GPU 利用率 74.6%。DuetServe 则是吞吐 8.02 req/s,TTFT 58.9 s,TBT 104.7 ms,GPU 利用率 93.5%——吞吐高约 1.4×,TTFT 几乎砍半,利用率显著更高。Dynamo 的 TBT 更低,但那是用”decode 卡没吃满”换来的(对应它 74.6% 的利用率)。Dynamo 吞吐吃亏的根子在重配代价:切一张 GPU 的角色,会打断在飞的 decode 请求,新的 prefill 卡还得重新加载模型、重建 KV cache,大约要 40 s,这期间系统降速运行。DuetServe 则在每个调度迭代里就把分配解好,重配延迟可忽略、也不丢在飞请求。这正是”SM 粒度的片内切分”相对”整卡粒度的物理 disaggregate”的根本优势——它在大集群里不是替代 disaggregate,而是正交的、更细粒度的一层。
9. 总结
把 DuetServe 这篇工作拎出来看,它真正的贡献不是提出了某个全新的架构,而是对 aggregate 与 disaggregate 这个老取舍给了一个更聪明的答案:不是二选一,而是按需在两者间切换,且把切换的粒度从”整张 GPU”降到了”SM 子集”。 默认 aggregate 吃满利用率,roofline 模型提前预测到 TBT 要崩时,才在单卡内切 SM 临时隔离,拿到 disaggregate 级的 TBT,却不长期背它的模型复制和 KV 搬运成本。
这套方案能成立,靠的是三块环环相扣的设计:一个把 attention 成本显式建模进去的 roofline,让”要不要切”能被提前预测而不是事后补救;一个在 TBT 约束下最大化有效吞吐的分区优化器,把”切多少”解成一个开销可忽略的小枚举;以及 look-ahead decode + CUDA Graph 的免打断执行,把两条流真正并行起来而不被 CPU 同步拖死。最终在 Qwen3-8B/14B 上做到最高 1.3× 吞吐、8 卡上对 Dynamo 1.4× 吞吐,同时守住 TBT。
个人觉得最值得借鉴的一点,是它对”隔离”这件事的态度:隔离不是免费的,物理 disaggregate 的隔离买的是确定性、付的是利用率。DuetServe 的做法是只在真的要打架时才付这笔钱,其余时间都省下来——而让这个”按需”变得可行的,恰恰是 libsmctrl 这种能在驱动层低开销切 SM 的底层能力。硬件可编程粒度往下走一层,上层调度的设计空间就宽了一截,这个方向后面大概率还会有更多文章。
需要说明的是,DuetServe 官方目前没有放出方法实现的代码,本文的机制细节和公式都以论文原文(arXiv:2511.04791)为准核对,没有二次脑补;文中提到的 libsmctrl 是论文引用的、真实开源的底层库(Bakita & Anderson, RTAS 2023),它的”驱动层按掩码切 SM”能力是整套方案的硬件前提。
扯一句题外话。这篇讲的是 LLM 服务里 prefill/decode 的隔离和 GPU SM 空分复用,属于偏系统、偏推理工程的方向,和我们写的那本《动手学 AutoML:从 NAS 到大语言模型优化实战》话题其实隔得有点远——书里更多是从模型侧讲 LLM 架构自动化、压缩(剪枝/量化)、模型融合这些事,并不覆盖推理服务的调度与算子级工程。真要说有什么联系,大概是殊途同归:一个在模型结构这端省算力,一个在系统调度这端把算力榨干,目标都是让大模型跑得更省、更稳。对自动化优化模型本身这条线感兴趣的,可以顺手翻翻。
