arXiv'26 | MAGA:Make AutoML Great Again,把 LLM Agent 当成一张可搜索的神经网络
MAGA:Make AutoML Great Again,把 LLM Agent 当成一张可搜索的神经网络
原文:Building LLM Agent Systems the Deep Learning Way: From Modular Design to Architecture Search(UIUC,Jiaxuan You 组)
1. Agent 还在”手搓”,可深度学习早就不这么干了
最近的 Agent 论文有一种熟悉的配方:加个 memory,再接个 retrieval,挂上 planning,最后补一段 self-reflection。每个模块单看都有道理,拼起来也经常能跑。但只要追问一句”为什么是这几个模块、这个顺序、这几个参数”,答案多半还是两个字——经验。
这几乎是深度学习爆发前的翻版。那会儿设计网络也靠手感:这层要不要加、宽一点还是深一点、激活函数换哪个,全是老中医式的调。真正让网络设计从玄学变成工程的,是三件很朴素的事:把零件标准化(卷积、attention、残差这些可复用模块),用统一的信号端到端训练(loss + 反向传播),以及当人的直觉覆盖不过来时,干脆把结构交给算法去搜(NAS,神经架构搜索)。
UIUC 这篇论文(通讯作者 Jiaxuan You)把这个类比推到了底:别再把 LLM Agent 看成一堆临时拼起来的 prompt,把它当成一张神经网络——可以用标准模块搭建、可以用反馈信号优化、还可以把配置交给搜索算法。
我不仅要直呼:MAGA!!! Make AutoML Great Again!!!。这篇论文很 AutoML,他们把”定义搜索空间、设计评估信号、自动迭代优化”这三件老本行,重新搬回到 Agent 身上。不过这篇不是一套能直接替掉 LangGraph / AutoGen 的成熟框架,实验也还很”干净”(后面会专门说它的局限)。它真正的价值,是把”Agent 结构到底该怎么设计”这个目前相当凭感觉的问题,重新表述成了一个标准的 AutoML 问题——光是这件事就值得讲清楚。
2. 第一步:把 Agent 的积木翻译成神经网络模块
论文的第一步看着像给 Agent 模块重新贴标签,但这个标签是后面一切的地基——模块有了统一坐标系,组合、比较、搜索才有依据。
下面这张图是全文的”字典”,一共四格,每格都是左边一个 Agent 模块、右边一个深度学习模块,中间用 Translate 连起来。读的时候对着看就行:左边是你平时怎么用这个 Agent 组件,右边是它在网络里对应谁。
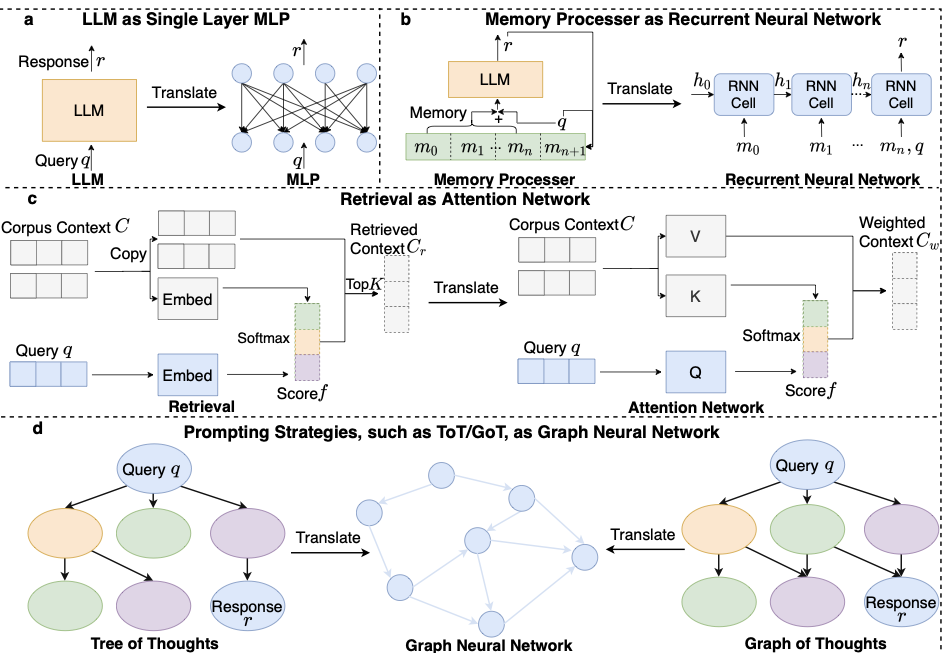
图:vanilla LLM ↔ 单层 MLP;memory processor ↔ RNN;retrieval ↔ attention;ToT/GoT ↔ GNN。这是全文用来定义 Agent 搜索空间的模块坐标系。
逐格走一遍:
-
一个光杆 LLM,就是一层 MLP(图 a)。输入 query、输出 response,中间没记忆也没外部知识,和一个单层全连接的角色一样:给定输入直接出输出。
-
memory 像 RNN(图 b)。memory processor 干的事,是把过去几轮的交互存下来、影响下一步怎么答。这正是 RNN 的套路:隐状态 $h_t$ 一路往后传,每个 cell 读入当前输入和上一步状态。图里把 $m_0, m_1, \dots, m_n$ 连同 query 一个个喂进 RNN cell,就是”状态跨时间延续”的 Agent 版。
-
retrieval 像 attention(图 c)。retrieval 是拿 query 去语料库里挑最相关的几段,而 attention 本质也是”query 和一堆 key 算相似度、再按权重取 value”。论文把这层对应说得很细:query 和 corpus 先各自 embed、算 score、softmax,再取 Top-$K$——这就是 attention 的 score→加权。更妙的是这组对照:单条 query 检索 = single-head,并行生成多条 query 去检索 = multi-head,每条 query 取回几篇(retrieve num)则对应 attention 里的 mask。
-
ToT / GoT 像 GNN(图 d)。ToT(Tree of Thoughts)和 GoT(Graph of Thoughts)是让模型把一个问题拆成一串能分叉、能回溯的 thought 节点——前者是树状展开,后者是更一般的图。节点之间有依赖、要沿着边传信息,这正好是 GNN 在做的事;而树只是图的一个特例。
这里要先按住一个误会:论文没有说 retrieval 的代码等于 Transformer 的 attention,也没有说 ToT 真变成了一层可微的 GNN。 它说的是功能同构——两边都在回答同一个问题:哪些信息该被保留、该被挑选、该被组合。
这套翻译真正值钱的地方,不在”名字取得像”,而在它把 Agent 架构变成了一组可枚举的选择:任务要啃长历史,就上 memory / RNN;要靠外部知识,就开 retrieval / attention;要发散地试探多条路径,再加 Tree 或 Graph。模块本身、怎么连、每个模块给多少预算,全都能塞进一个搜索空间。
于是 MAGA 的第一层就出来了:先别急着问”该用哪个 Agent 框架”,先问”我的搜索空间到底长什么样”。
3. 第二步:meta prompt 当权重,self-reflection 当 loss
有了模块字典,第二步是把深度学习训练那套”前向 + 反馈”也搬过来。这里是全文最容易被标题带偏的地方,得讲清楚它到底在更新什么。
论文的说法是:把 meta prompt 当成可训练的权重,把 self-reflection 当成 loss,整个循环称为 LLM 的”forward / back propagation”。听着唬人,但先看一眼它具体长什么样,就不玄了。
下面这张图从左到右是一次完整的前向推理,再从右到左是一次反馈回传。先盯住左边那块蓝色的 meta prompt——它不是什么抽象的”参数向量”,就是一段结构化的说明书。
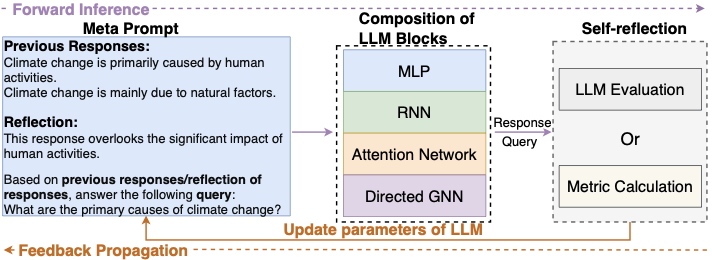
图:meta prompt(左)里塞着历史 response、上一轮 reflection 和本轮 query,喂给中间由 MLP/RNN/Attention/GNN 组合成的 LLM blocks 产出 response;self-reflection(右)用 LLM Evaluation 或 Metric Calculation 打分,再把评语写回 meta prompt。
对着图里那段蓝色文本念一遍就懂了。假设 query 是”气候变化的主要成因是什么”,这段 meta prompt 里会装三样东西:
- Previous Responses:前几轮给过的答案,比如”气候变化主要由人类活动造成”“气候变化主要是自然因素”;
- Reflection:对上一轮的点评,比如”这个回答忽略了人类活动的重大影响”;
- 最后才接上本轮要回答的 query。
说人话:系统先做一遍题,再给自己的答案打分或写评语,然后把”刚才怎么答的、哪儿错了”原样塞回下一轮的说明书里。 下一轮 LLM 读到的 prompt 变了,输出自然就变了——”参数”被更新的方式不是改权重,而是改它下一轮看到的上下文。
写成循环就是三步:
\[r_t = F_{\mathcal{A}}(q;\,P_t),\qquad e_t = E(q,\,r_t),\qquad P_{t+1} = U(P_t,\,r_t,\,e_t)\]其中 $\mathcal{A}$ 是选定的 Agent 架构,$P_t$ 是第 $t$ 轮的 meta prompt(那段说明书),$r_t$ 是本轮 response,$e_t$ 是 self-reflection 给出的评估,$U$ 负责把 response 和评语重新写进下一轮的 $P_{t+1}$。它和真正的 backprop 共享同一个骨架:前向出结果 → 外部信号打分 → 用打分改变下一轮行为;区别是这里回传的是文字和指令,不是连续的梯度。
这点要说死:这不是对 base model 做反向传播。 没有梯度穿过 API,也没有任何一个权重被更新,LLM 本身纹丝不动。所谓”back propagation”是个类比,被更新的只有 prompt。
那 loss 从哪来?论文按”反馈能不能被程序算出来”分了两种 evaluator:
- Metric Calculation:答案质量有明确指标时直接算。比如 TSP(旅行商问题,求一条最短的环路)可以直接量出路线长度,好坏一目了然;
- LLM Evaluation:开放式、写不出硬指标的 response,就再调一个 LLM 来当裁判打分。
这个区分很务实。因为一旦 evaluator 自己也在胡说,你拿到的就不是一个 loss,只是多了一位会写长评语的同事。论文实验里,这套反馈回传在多数任务上能带来至少 5% 的提升;在 TSP 上,随着反馈轮数增加,路线还会持续变短,而且 GNN-MLP、Tree-MLP 这类每轮能同时探多条路的结构收敛得更快。
当然,代价也很实在:每多一轮优化,就多一遍生成 + 一遍评估的调用。论文主要报任务指标,没把 token 成本、端到端 latency、以及 evaluator 本身的偏差放到同一张台面上对比。”prompt 能被迭代优化”和生产里”值得被迭代优化”,中间还隔着一本账。
4. 第三步:用这些积木,真的搭出一个 Transformer
光有对照表还不够,作者干脆用这套积木搭了个 cross-attention Transformer,证明它不是停在纸上的比喻。
先回忆标准的 cross-attention Transformer 在做什么:两份不同的特征先过一层 cross-attention 相互交互,结果再经一个 MLP 出输出,中间加 residual(残差)防止信息在变换里丢掉。论文把这套结构一比一翻译成 Agent。
读下面这张图的方法是:左边是教科书里的 cross-attention 模块,右边是它的 Agent 版,虚线箭头标出谁对应谁,重点看右边那条从下往上的主干。
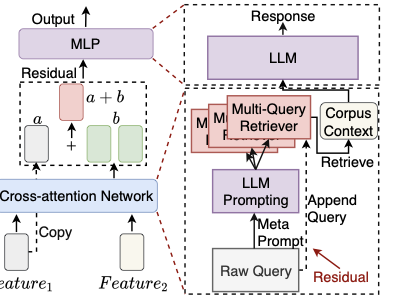
图:raw query 与 corpus 对应 Transformer 的两份输入特征;LLM Prompting 生成多条 query、Multi-Query Retriever 对应 multi-head cross-attention;把 raw query 附回生成的 query 对应 residual;最上面输出的 LLM 对应 MLP。
顺着右边主干走一遍:
- 最底下输入原始问题 $q$,先经一个 LLM,在 meta prompt 引导下改写、扩展成多条 query;
- 这几条 query 并行去语料库里检索(Multi-Query Retriever),各自捞回一批相关 context——这步就对应 multi-head cross-attention,一条 query 一个 head;
- 关键的一笔:把原始 query 原样附回这几条生成 query 里一起去检索。这正是 residual 的作用——防止系统在改写 query 时把题目本身改跑偏了;
- 最后一个输出 LLM 同时读原问题和检索结果,产出 response,扮演最上面那层 MLP。
写成抽象计算图大概是:
\[\tilde{Q}=G_{P_1}(q),\qquad C_r=\operatorname{Retrieve}(\tilde{Q}\oplus q,\;C),\qquad r=G_{P_2}(q,\,C_r)\]$\tilde{Q}$ 是改写出的多路 query,$C$ 是语料库,$\oplus q$ 就是把原题拼回检索输入(residual)。这里没有矩阵乘法,也没有 softmax,但”多路 query 去选外部信息、再把信息送进输出模块”的信息流,确实是 cross-attention 的 Agent 版。
搭完这个”基础款”,作者又换零件做出 RNN-Transformer、Tree-Transformer、GNN-Transformer:前者让历史 response 进 prompt(加记忆),后两者让 ToT / GoT 帮忙生成更丰富的检索 query(加发散)。整个过程就像搭积木——不预设”Transformer Agent 一定最强”,而是给架构换不同的 inductive bias,再让任务来回答哪种组合有用。
5. 第四步:把配置交给搜索算法——这才是 NAS 那一下
到这里才轮到最像 AutoML 的部分:前面都是人把架构搭出来,这一步让算法自己去调。
论文用 Optuna(一个轻量的超参搜索库,给定搜索空间和目标,它负责一轮轮试、朝更优的方向收敛)来优化上面那个 Transformer-style Agent,任务选在 Related-multi 上。搜什么?就是各模块的几个”旋钮”:
| 超参 | 控制的 Agent 决策 | 候选范围 |
|---|---|---|
| $m_1$ | 生成 query 的 LLM 最大输出 token | 64 / 128 / 192 / 256 / 320 |
| $m_2$ | 最终答案 LLM 的最大输出 token | 64 / 128 / 192 / 256 / 320 |
| $m_3$ | self-reflection 的最大输出 token | 64 / 128 / 192 / 256 / 320 |
| $h$ | 多 query 检索的 head 数 | 1–5 |
| $n$ | 每个 head 检索回几篇 | 1–5 |
一组配置记作 $\pi=(m_1,m_2,m_3,h,n)$,优化目标是最大化验证集上的 F1。F1 这里是检索质量的指标:把检索/引用到的内容和标准答案比,precision(挑回来的里有多少该挑)和 recall(该挑的里挑回来多少)取调和平均,越高越好。
\[\pi^{*}=\underset{\pi\in\Pi}{\arg\max}\;\mathrm{F1}_{\text{train}}(\pi)\]实验拿 30% 的 Related-multi 数据搜、70% 测,一共跑 120 次 trial。下面这张图就是这 120 次的全过程:横轴是第几次 trial,每个蓝点是一组配置试出来的 F1,红线是”到目前为止的最好成绩”。
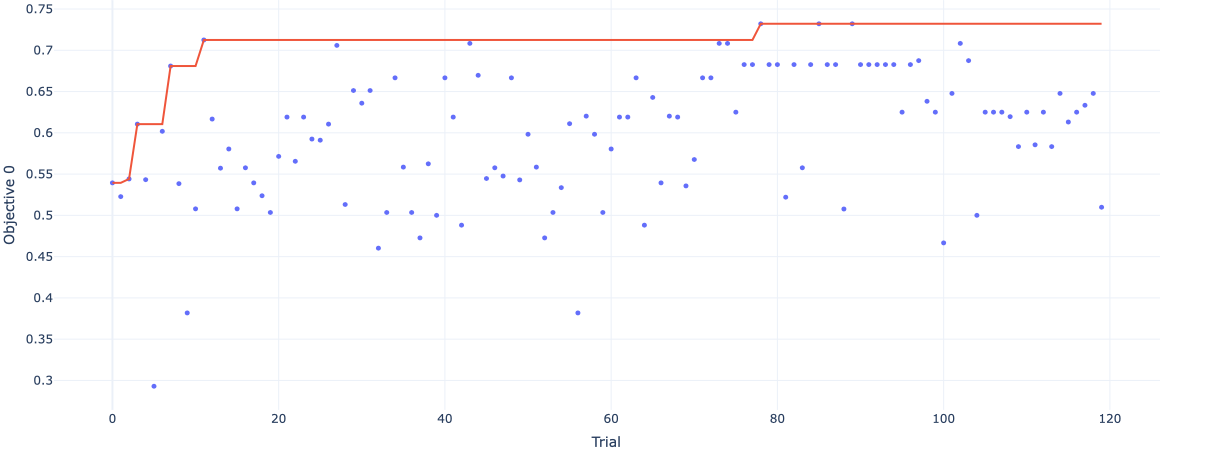
图:横轴是 trial 数,蓝点是每组配置的 F1,红线是迄今最优。F1 在前十几轮就从 0.54 爬到 0.71 附近,之后靠零星几次 trial 又拱到 0.73。
红线的形状很说明问题:开局(trial 0)随手一个配置只有 0.541,到第 7 轮已经 0.685,第 43 轮 0.694,第 78 轮附近再往上跳一档。最后搜到的配置是 $m_1=192$、$m_2=192$、$m_3=320$、$h=2$、$n=4$,测试集 F1 0.712,比随机凑出来的架构(随机抽若干组配置取平均)高了 11%。
别把这个数字读成”Optuna 一跑,Agent 就自动进化成 AGI”。它说明的是件更朴素、也更该被记住的事:Agent 的 token 预算、检索几个 head、每个 head 捞几篇,本来就不该靠人拍脑袋。 任务和预算一旦固定,这些就是标准的 configuration optimization,交给搜索比靠手感可靠。这也是 AutoML 一直被低估的点——NAS 从来不只是”搜一个新奇的网络图”,它首先在提醒你:当决策变量多到直觉罩不住,就该把经验固化成搜索空间、把好坏固化成 objective,再把试错交给算法。
6. 实验:没有”最强架构”,只有”和任务对得上的架构”
论文测了两类任务。一类不碰外部知识——TSP(旅行商,求最短环路)和 GSM8K(小学数学应用题,看答对率);另一类要查外部资料——StrategyQA(需要多跳推理的判断题)和 Related-multi(根据论文标题+摘要去检索、写 related work,用 F1 衡量检索到的参考文献对不对)。
先看不带检索的一组,比的是 MLP、RNN-MLP、Tree-MLP、GNN-MLP:
| 架构 | TSP 最优路线长度 ↓ | GSM8K 准确率 ↑ |
|---|---|---|
| MLP | 79.2 | 53.3% |
| RNN-MLP | 76.6 | 60.0% |
| Tree-MLP | 73.2 | 66.7% |
| GNN-MLP | 73.9 | 64.3% |
数学推理和组合优化这种需要”多想几步、试几条路”的任务,Tree / GNN 的多分支思考明显占便宜。尤其 Tree-MLP 把 GSM8K 从 53.3% 拉到 66.7%,这不是能忽略的小数点。
但一旦任务需要查外部知识,赢家就换人了(这组在前面加了 attention / retrieval):
| 架构 | StrategyQA F1 ↑ | Related-multi F1 ↑ |
|---|---|---|
| Att-MLP | 0.42 | 0.22 |
| RNN-Att-MLP | 0.66 | 0.24 |
| Tree-Att-MLP | 0.50 | 0.25 |
| GNN-Att-MLP | 0.54 | 0.21 |
StrategyQA 上 RNN-Att-MLP 一骑绝尘,Related-multi 上则是 Tree-Att-MLP 略胜。论文的解释也站得住:前者更吃”把历史信息连续带下去”的能力,后者是”看着标题摘要去发散地构造检索 query”,更需要分叉探索。
这恰恰是全文最有价值的结论之一:不存在一个放之四海的”最强 Agent 架构”,只有和任务结构对得上的架构。 如果每个任务最后都是最复杂的那个 All-in-One 赢,这套方法反而没说服力;现在这种”换任务换冠军”的结果,才像真实架构设计该有的样子。
7. 这套方法的边界,也正好是下一轮的题目
把问题重新表述清楚,是这篇的功劳;但它离”把 Agent NAS 做完”还很远,至少有四个缺口。
搜索空间还很浅。 现在搜的主要是输出 token、检索 head 数、每 head 检索数这几个旋钮。真正难的部分——模块拓扑本身、工具调用策略、模型路由、memory 压缩、串行还是并行编排——都还没进搜索空间。
evaluator 未必靠得住。 TSP 这种能精确计算的任务很适合做反馈闭环;可一旦 evaluator 也是个 LLM,reward hacking、偏好被放大、反思越写越自信却没更正确,这些问题都会冒出来。论文没有系统评估这一层的稳定性。
实验还很”干净”。 TSP、GSM8K、StrategyQA 都是规整的 benchmark,Related-multi 目前也只是声明”review 后再放出”。真实 Agent 常遇到的 tool 调用失败、长链依赖、环境动态变化、成本约束,基本没覆盖到。
复现性不够。 论文页面没给公开代码链接,按标题去 GitHub 搜也没找到对应仓库。对一个重度依赖 meta prompt、评估 prompt 和 search budget 的工作来说,这些不是实现细节,而是结果的一部分。
所以更稳妥的读法不是”明天所有 Agent 都该交给 NAS”,而是:它给了一张迁移路线图——先把 Agent 里的隐性经验拆成模块和变量,再把反馈信号和成本约束写明白,最后才谈自动搜索。
8. 总结
这篇论文最有意思的地方,不是把 LLM、RNN、attention、GNN 硬画成一张对照表,而是顺着这张表,把 Agent system design 重新变回一个能讨论的优化问题:
\[\text{Agent system} = \text{模块} + \text{架构} + \text{prompt 参数} + \text{评估目标}\]模块怎么选、结构怎么连、prompt 怎么跟着反馈演化、token 和检索预算怎么分配——每一项都能被定义、被评测、被搜索。
从这个角度看,Make AutoML Great Again 就不是单纯怀旧了。Agent 越堆越复杂,靠”我觉得这儿再接个 reflection 应该会更强”就越不够用。把设计判断显式化、把试错自动化,才是让 Agent 从 demo 拼装走向系统工程的那条正路——而这,恰好就是 AutoML 这些年一直在做的事。
既然聊到把 AutoML 搬回 Agent,顺带说下我们的”私货”。前面那套”定义搜索空间 → 设计评估信号 → 自动迭代优化”的方法论,正是我们团队编写、机械工业出版社出版的《动手学 AutoML:从 NAS 到大语言模型优化实战》在讲的东西。全书共 11 章,从搜索空间、评估策略、NAS 基础,一路讲到模型压缩、LLM 与 AutoML 的结合,还配了随机搜索、可微分搜索、进化压缩、LLM 剪枝的实战代码;这篇论文里 Optuna 搜配置那一下,书里有更系统的搜索策略章节能接着往下补。感兴趣的同学可以前往jd购买,配套资源见 AutoMLDemos。