ACL'26 | 从 LoraHub 到 LoGo:多 LoRA 路由离开放世界还有多远?
ACL’26 | 从 LoraHub 到 LoGo:多 LoRA 路由离开放世界还有多远?
主要论文:LoraHub(COLM 2024) · LoraRetriever(ACL 2024) · LoRA on the Go / LoGo(ACL 2026) · LLM-JEPA。本文还会联系前文讨论过的 Jev System-One 决策模型。
1. LoRA 仓库越来越大以后,固定 Router 先出了问题
想象一个企业内部的 Adapter 仓库:财务团队上传了票据 LoRA,法务团队上传了合同 LoRA,客服团队有退款、投诉和流失预测 LoRA,开源社区每天还在往 Hugging Face 或 Civitai 里塞新的 Adapter。
LoRA(Low-Rank Adaptation,低秩适配)是在冻结大模型主体参数的同时,为部分线性层增加一个低秩增量。对原始权重 $W_0$,一次前向可以写成:
\[h'=W_0h+\Delta Wh=W_0h+BAh,\]其中 $A\in\mathbb R^{r\times d}$、$B\in\mathbb R^{d\times r}$,而 $r\ll d$。一个 LoRA 只占基础模型很小一部分存储,所以它天然像一个可以插拔的“技能补丁”。
问题在于,传统 MoE-LoRA 往往把这些补丁当成训练时就确定好的 $K$ 个专家。MoE(Mixture of Experts,混合专家)里的 Router 接收 hidden state,输出一个 $K$ 维 softmax,再选 top-1 或 top-$k$ 专家。这个计算图从一开始就把专家数量和身份写死了。 第 $K+1$ 个 LoRA 上线时,Router 的输出维度、训练分布甚至负样本集合都变了,通常只能重新训练。
真实的 Adapter 生态却在同时打破三条假设:
- 候选集合不再固定。 新 LoRA 会持续加入,旧 LoRA 会升级、下架或被替换。
- 路由所需的监督不一定存在。 企业未必愿意交出 Adapter 的训练数据;社区 LoRA 也常常只有一句含糊的模型卡。
- “选中相关 LoRA”不等于“组合后一定更好”。 不同 LoRA 可能冗余、冲突、质量不一,加载与 probe 本身还要付系统成本。
这就是所谓 open-world Adapter routing。这里的 open-world 不能只理解成“池子里可以多放几个 LoRA”,它至少包含开放候选、开放任务、开放质量和动态插入四层含义。至于不同 backbone、不同 target modules、不同 rank 的 LoRA 能否混用,则是更难的一层;目前几篇工作基本都还没有跨过去。
2. 多 LoRA 为什么可能成立,又为什么经常不成立
先把最关键的问题说清楚:多个 LoRA 不是因为名字里都带 LoRA,就天然可以相加。 多 LoRA 成立至少需要三件事同时发生。
第一,池子里确实存在互补能力。比如目标任务需要“先理解土耳其语,再做自然语言推理”,而池子里分别有翻译与推理 LoRA;如果全部 Adapter 都是在重复学习 sentiment classification,多选几个不会凭空长出新能力。
第二,这些增量在当前输入上不能发生严重干扰。假设选中的集合为 $S$,output mixture 会在前向时组合各 LoRA 的输出:
\[h'=W_0h+\sum_{i\in S}\alpha_i B_iA_ih.\]它保留了每个 LoRA 自己的低秩映射,再对结果加权。parameter fusion 则先在权重空间合成一个新 Adapter。后者部署起来可能更方便,但不同低秩子空间一旦方向冲突,平均参数很容易把原本有效的能力一起抹掉。
第三,系统必须在不知道答案时识别“哪个 LoRA 有用”。这比给已有 $K$ 个专家训练一个分类器更难:新 LoRA 加入后没有 Router label,目标输入可能不属于任何已知任务,甚至最好的选择是不用任何 LoRA,退回 base model。
四篇论文里真正构成多 LoRA 技术主线的是 LoraHub、LoraRetriever 和 LoGo;LLM-JEPA 不是 Adapter routing 方法,它讨论的是如何在 embedding 空间里学习同一知识的不同 view。把它放进来,是因为 open-world routing 最终卡住的正是“query 与新 Adapter 如何在不改固定分类头的情况下建立可比较表征”。
下面这张图先给出全貌。阅读时从上往下看,主线依次去掉了固定专家、任务级固定组合和目标任务监督;右侧的 LLM-JEPA 没有参与这条演进,但为下一步的动态候选表征提供了一个可能的训练目标。
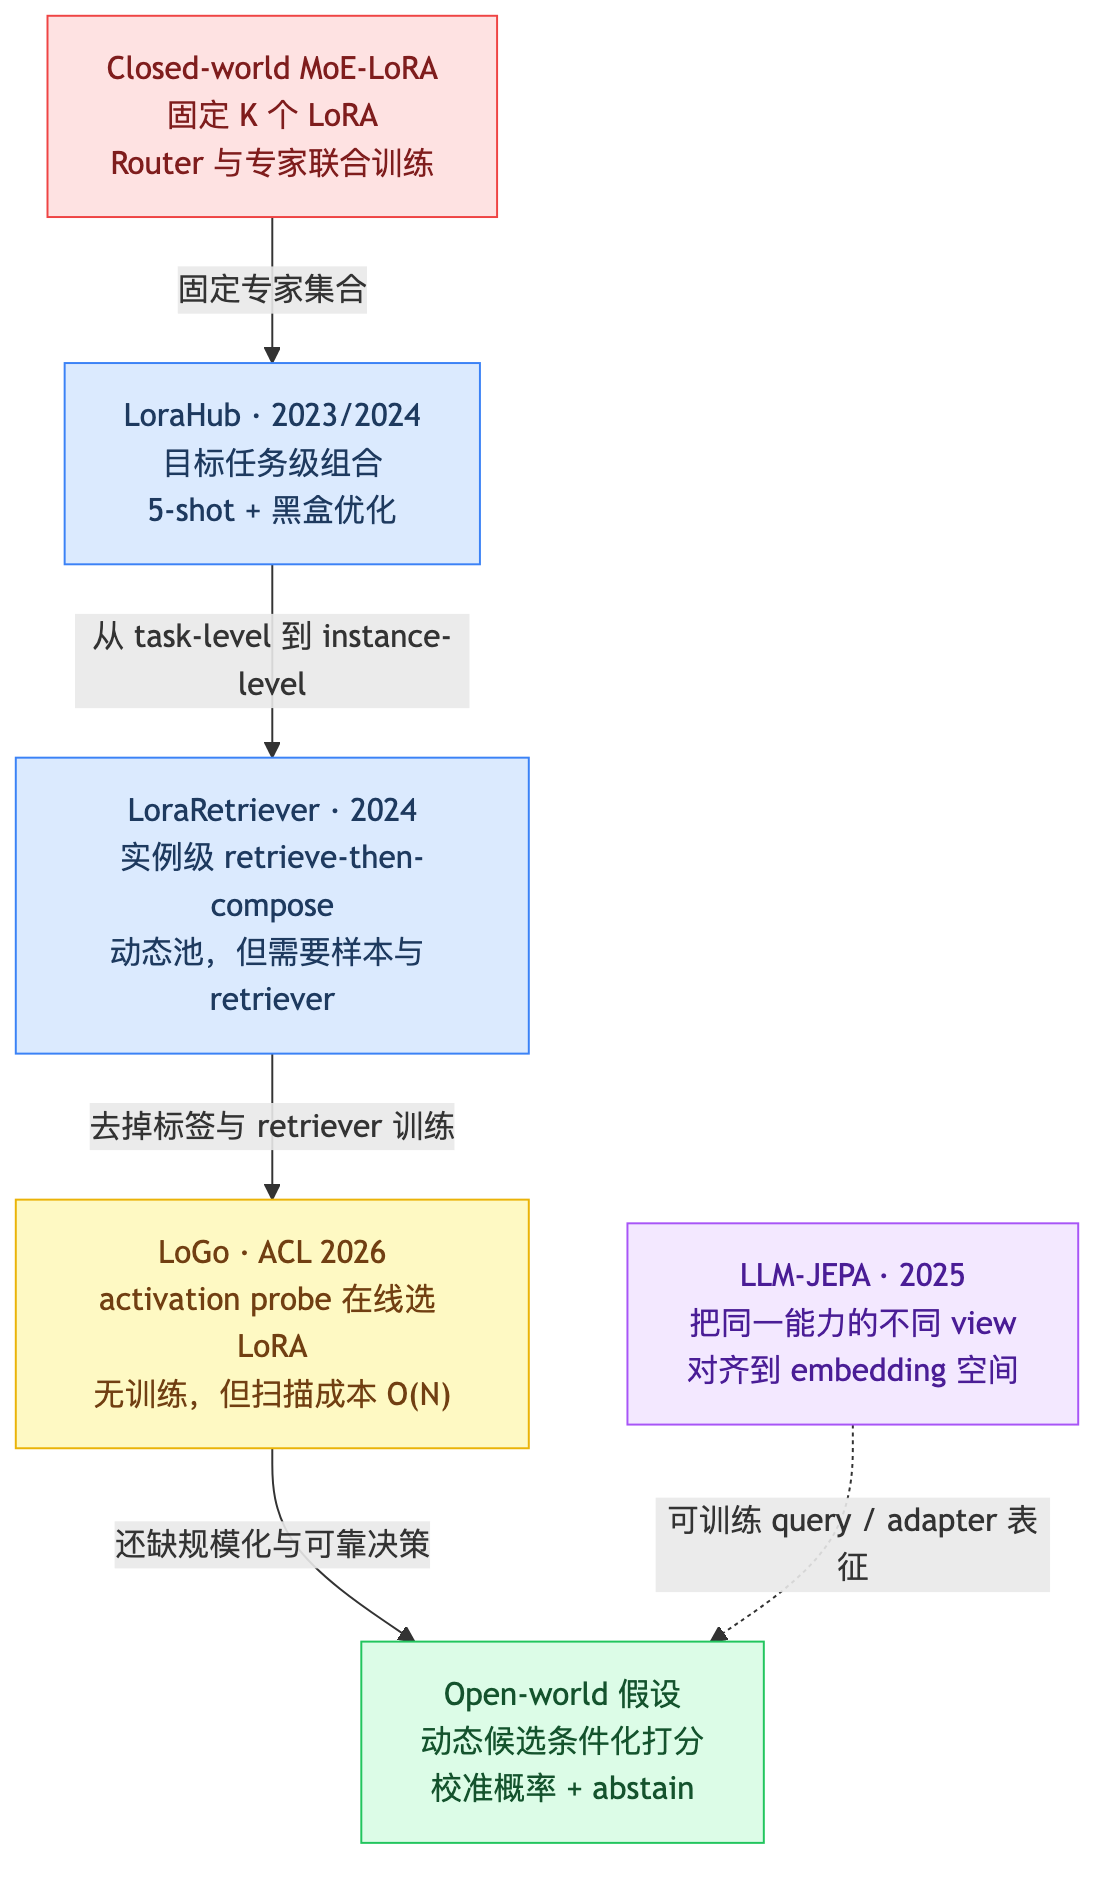
这条线并不是越往下就无条件越好。LoraHub 用目标任务样本换取任务级组合;LoraRetriever 用 Adapter 样本和一个额外 retriever 换取实例级路由;LoGo 不训练 retriever,却要让所有候选 LoRA 做一次 probe。监督成本被拿掉以后,往往会从系统成本的另一头冒出来。
2.1 Related work 看起来都在“用多个 LoRA”,实际解决的是三类问题
第一类是 jointly-trained MoE-LoRA。AdaMix、SiRA、MoLE、Mixture-of-LoRAs 和 LoRA-Flow 都借用了 MoE 的 gating:训练时已经知道有哪些 Adapter,再学习 token-level 或 instance-level 权重。它们适合固定专家集合上的 multi-task learning;优势是 Router 与专家能一起适配,短板也正来自这里——新增 LoRA 会改变输出空间,Router 通常不能零训练接住它。LoRA-Flow 更进一步为生成过程中的每个 token 计算融合权重,但仍需要为给定 Adapter 集合训练 fusion gate。
第二类是 post-hoc merging / composition。AdapterSoup 对相关 Adapter 做权重平均;Task Arithmetic、TIES-Merging 等 model merging 工作研究如何组合参数增量并处理符号冲突;SMEAR(Soft Merging of Experts with Adaptive Routing)根据输入生成参数加权结果;LoraHub 则用目标任务少样本做黑盒搜索。这条线不一定联合训练专家,但通常要目标任务数据、人工预选候选或固定结构。
第三类是 multi-LoRA serving。S-LoRA 和 FLoRA 关心的是如何把许多用户指定的 LoRA 高效装入 GPU、做 paging 和 heterogeneous batching。它们回答“已经知道用哪个 LoRA 后,怎样服务得更快”,不回答“当前请求应该选哪个”。这条系统线与 routing 正交,却决定了 open-world Router 最后能否真正部署。
LoraRetriever 的位置因此比较特殊:它把第一类的 gating 改造成可插入新候选的 retrieval,又把结果交给第二类 composition,并补上第三类需要的 mixed batch 计算。LoGo 则继续拿掉 retrieval 所需的数据与训练,但付出了全池 activation probe 的代价。
3. COLM’24 LoraHub:先证明“现成 LoRA 可以为新任务重新组装”
LoraHub 提的问题很直接:已经有一批分别在不同任务上训练好的 LoRA,面对一个从未见过的新任务,能否只用 5 个标注样本找到一组组合权重?
它会从接近 200 个 FLAN 上游任务 LoRA 中随机取 20 个候选。对新任务给出的 5-shot 样本,LoraHub 不反向传播,而是用 CMA-ES(Covariance Matrix Adaptation Evolution Strategy,一种根据历史评估结果更新搜索分布的黑盒优化算法)搜索每个 LoRA 的系数。沿用论文自己的 $A_iB_i$ 记号,组合写成:
\[\hat m=\left(\sum_{i=1}^{N}w_iA_i\right)\left(\sum_{i=1}^{N}w_iB_i\right).\]这里有个很容易忽略的细节:它不是简单的 $\sum_i w_iA_iB_i$。把括号展开后还会出现 $A_iB_j$ 形式的交叉项,因此所有候选 LoRA 必须有兼容的结构与 rank。系数可以为负,论文再用 $L_1$ 正则和 $[-1.5,1.5]$ 的范围约束避免搜索跑飞。
下面这张方法图从左往右读。左侧是一批上游任务 LoRA;右侧每轮先按权重 Compose,再让合成后的 LoRA 在 5 个目标样本上算 loss,黑盒优化器根据 loss 更新权重,循环 40 次。注意整个过程是 per-task,不是每来一个请求都重新搜索。
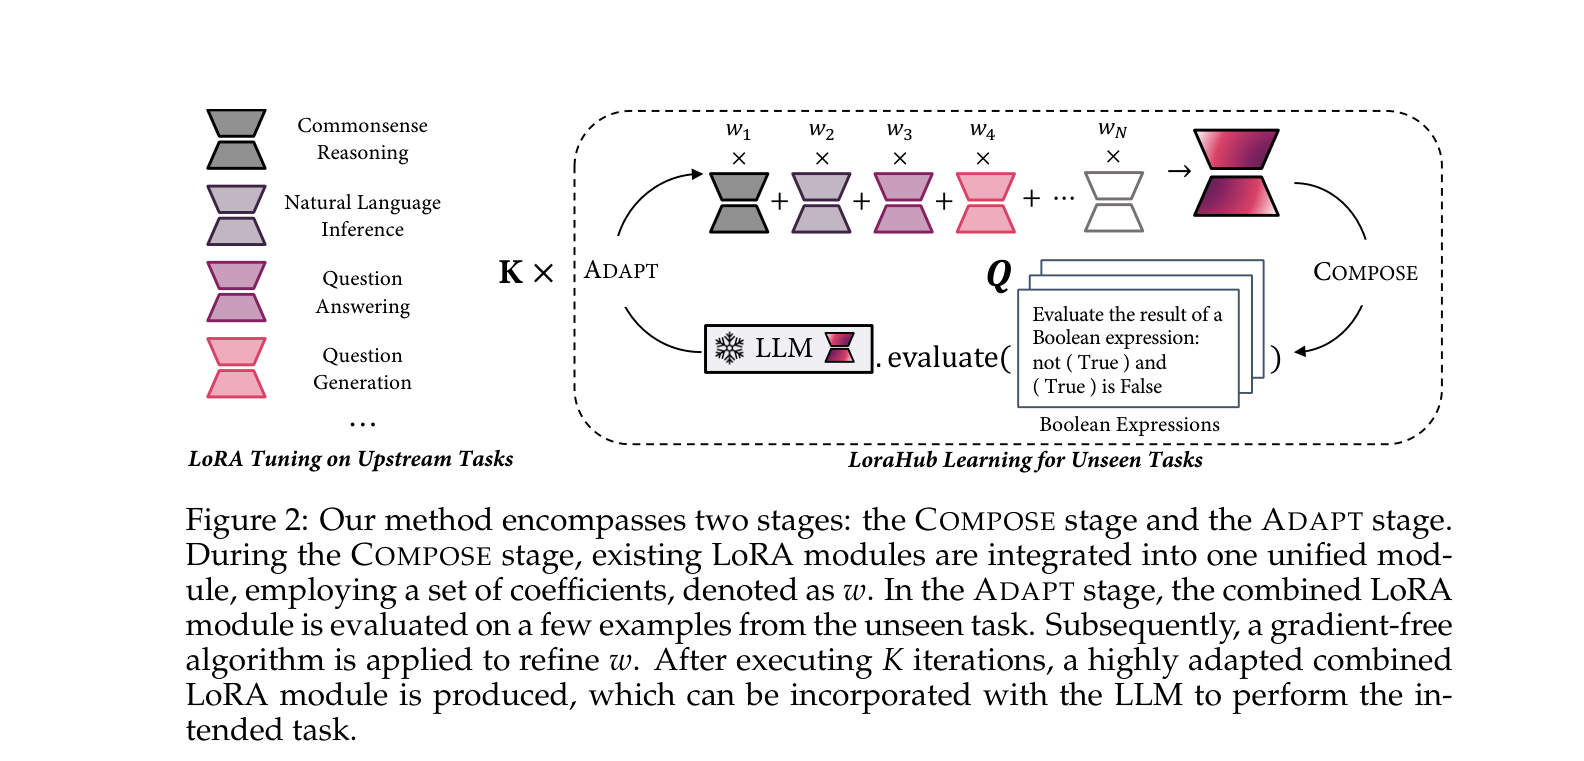
因此 LoraHub 更像“用少量样本编译出一个新 Adapter”,而不是在线 Router。它适合一个目标任务会被重复调用很多次的场景:前面多付几十轮 inference,后面每次请求不再携带 5-shot demonstration。一次性 ad-hoc 请求则更适合直接做 in-context learning(ICL,把示例放进 prompt),论文自己也明确承认这一点。
3.1 它证明了组合有信号,但没有证明组合普遍优于单 LoRA
LoraHub 在 BBH(BIG-Bench Hard,一组包含 27 个困难推理任务的 benchmark)上使用 Exact Match,输出必须与标准答案完全一致才算正确,越高越好。主结果其实相当克制:
| 方法 | BBH 平均 Exact Match | 每个样本平均输入 token | 是否梯度训练 |
|---|---|---|---|
| Zero-shot base | 27.0 | 111.6 | 否 |
| 5-shot ICL | 37.3 | 597.8 | 否 |
| IA3 fine-tuning | 31.6 | 111.6 | 是 |
| 单任务 LoRA fine-tuning | 37.7 | 111.6 | 是 |
| Full fine-tuning | 42.1 | 111.6 | 是 |
| LoraHub | 34.7 | 111.6 | 否 |
LoraHub 明显高于 zero-shot,却低于 ICL、直接在 5-shot 上训练的新 LoRA和 full fine-tuning。它最有价值的结果不是“打败所有 baseline”,而是:不用梯度、部署时也不再携带 demonstrations,仍然能从旧 LoRA 中挖出一部分跨任务迁移能力。
论文还单独比较了 best single LoRA retrieval:在 20 个候选中,用 5-shot loss 选一个最好的,平均分 31.7;LoraHub 平均 34.7。这说明组合确实比只挑一个候选多拿到了一些东西。但论文同时报告 LoraHub 三次不同 demonstrations 中的最好结果为 41.2,超过 ICL 的 best 38.4。这个数字只能说明上限,不能把 best-of-3 与前面平均 37.3 的 ICL 混在一起宣称稳定超越。
更重要的是,候选从 5 增加到 100 时,部分任务的最好结果提高,方差也明显变大。Adapter 越多,不是收益单调增加,而是搜索空间和踩雷机会一起增加。
4. ACL’24 LoraRetriever:从“每任务配一次”推进到“每个输入单独检索”
LoraHub 的组合权重在一个目标任务内固定。如果同一个 batch 里既有翻译、情感分析又有问答,一组权重显然不够。LoraRetriever 因此把问题改成 retrieve-then-compose:先根据当前 input 检索 top-$k$ LoRA,再对检索结果做 mixture 或 fusion。
它没有把 LoRA 参数直接编码。每个 LoRA 由其训练集随机抽取的约 10~20 个样本表示,先用 Instructor-XL 把样本映射到 embedding,再取平均得到 Adapter embedding。Retriever 在 40% 的任务上做 contrastive instruction tuning:同任务样本是正对,不同任务样本是负对。新 LoRA 上架时,只要还能拿到少量代表样本,就可以算出新的向量,不需要修改一个 $K$ 维分类头。
下图分三块读。上半部分先把每个 mixed-task input 与候选 LoRA 放到同一 embedding 空间检索;右侧对 top-$k$ 做 output mixture 或 parameter fusion;下半部分为 batch 中每条请求建立不同的 LoRA mapping matrix,把异构路由整理成 einsum 可以批量执行的张量计算。
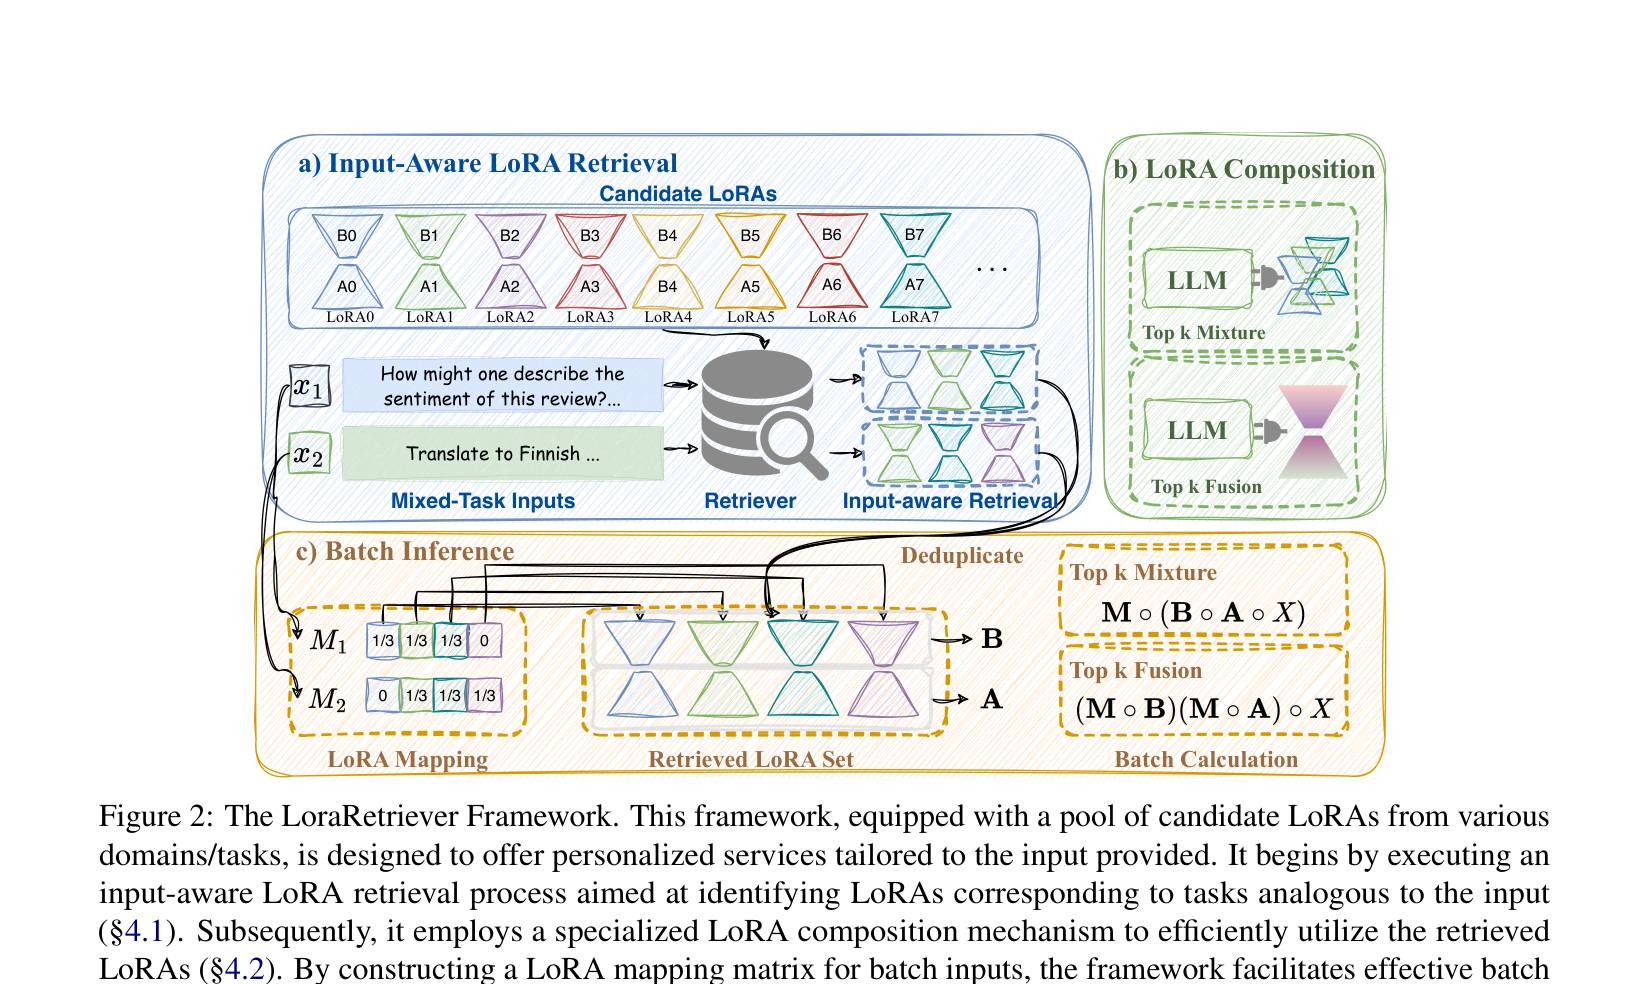
论文默认取 $k=3$。Selection 只使用 top-1;Mixture 平均多个 LoRA 子模块的输出;Fusion 平均 LoRA 参数。实验里的一个关键现象是:IID(In-Distribution,目标任务对应的 LoRA 仍在池子里)时 Selection 已经很强,Mixture 提升有限;OOD(这里特指测试时人为屏蔽目标任务 LoRA)时 Mixture 比 Selection 更稳,而 Fusion 随 LoRA 数量增加持续退化。
这说明了两个边界:
- 多 LoRA 的价值更多出现在“没有完美单专家”时。 如果 oracle LoRA 就在池子里且能被正确检索,top-1 已经够用。
- 能力组合与参数平均不是一回事。 output mixture 允许相似任务 LoRA 在各自子空间里产生增量;直接平均参数更容易互相抵消。
4.1 这篇论文最值得借鉴的是 Perfect Selection、IID 与 OOD 三层标尺
LoraRetriever 在 Llama-2-7B/13B 上训练 48 个 LoRA,覆盖 10 个 task cluster,再从每个任务测试集抽样组成 6000 条 mixed-task 数据。生成任务使用 ROUGE 或 BLEU:ROUGE 衡量生成文本与参考文本的词片段重合,BLEU 衡量机器翻译与参考译文的 n-gram 匹配,都是越高越好;理解任务使用 Exact Match。
下面的结果表不只放了几个 Router baseline。最左侧 Perfect Selection 直接使用当前任务对应的 LoRA,可以理解成 best-known single expert 标杆;Selection、Fusion、Mixture 又分别报告 IID/OOD;右侧才是 MoE top-1/top-3/soft、SMEAR、AdapterSoup 和 LoraHub。
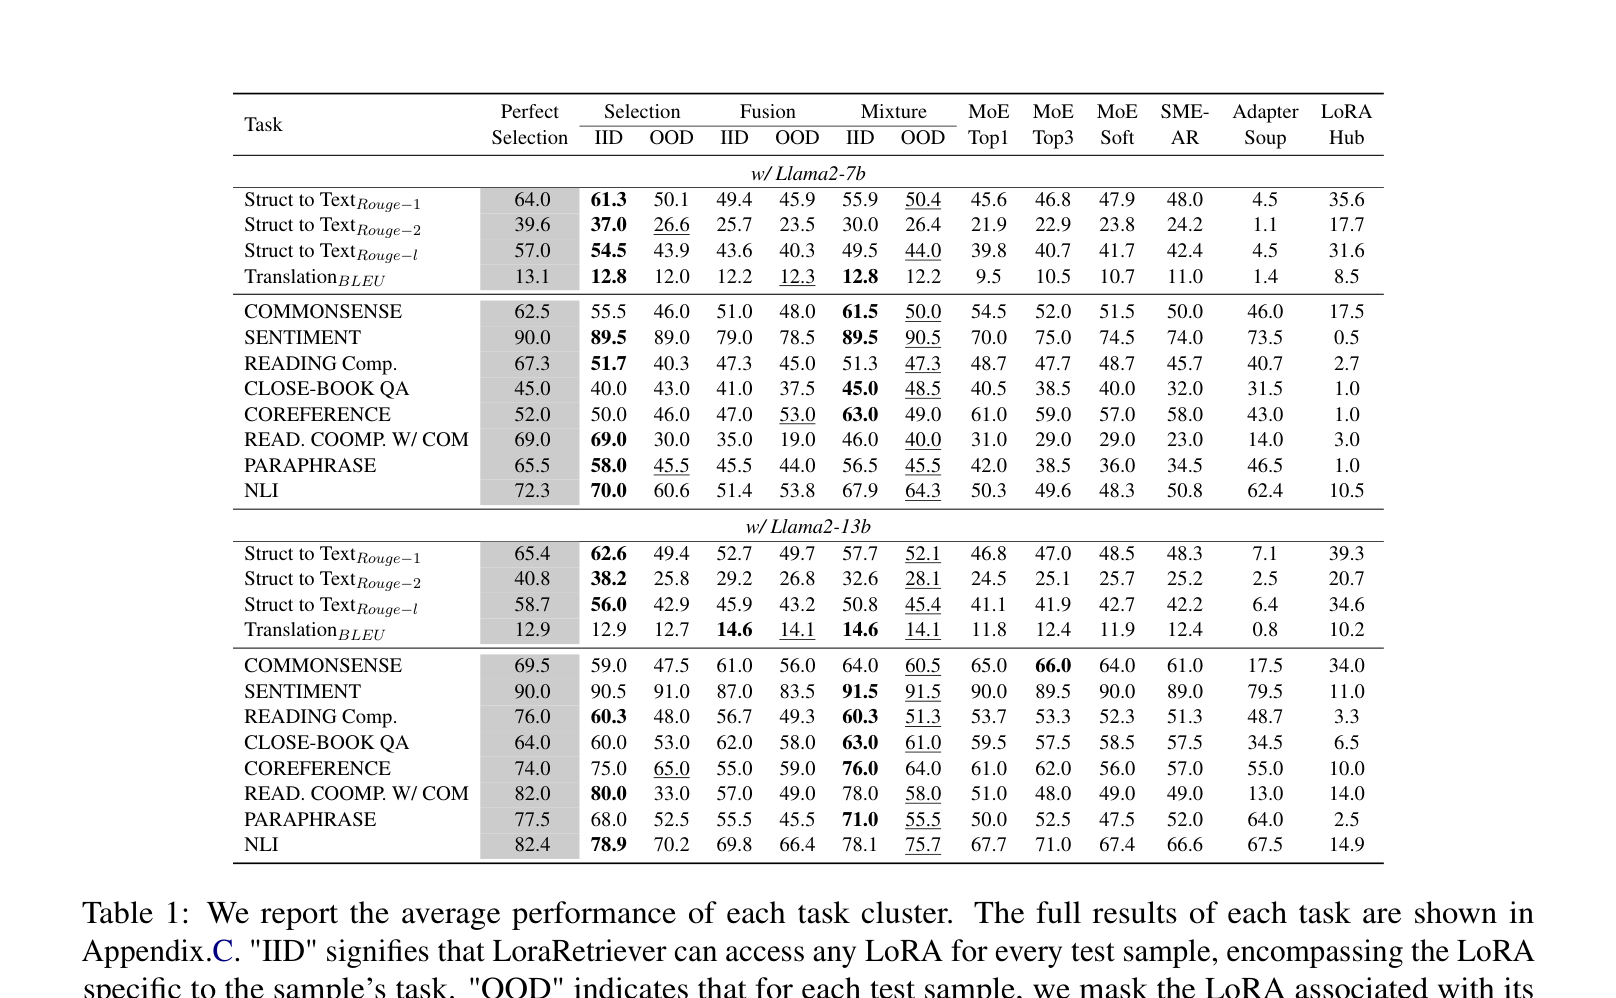
读表时不能只看粗体。比如某些 cluster 的 Mixture 可以超过 Perfect Selection,说明相似任务确有协同;另一些 cluster 离 Perfect Selection 仍有很大差距,说明瓶颈是路由;而 OOD 大幅下降则说明“能给新 LoRA 算 embedding”和“能解决池子里从来没有对应技能的新任务”完全是两件事。
这套实验比只比较 base model 完整得多,但还不是真正的开放世界:
- 48 个 LoRA 都由作者在同一 backbone、同一 recipe 上训练,兼容性非常干净。
- 新 LoRA 仍需要暴露训练样本,隐私敏感或只有权重的 Adapter 无法注册。
- OOD 是 mask 掉正确 LoRA,不是让 Router 面对社区里未知质量、未知 rank、未知领域的脏池子。
- LoRAHub、AdapterSoup 本来偏 task-level,把它们放进逐实例 mixed-task 场景会天然吃亏,所以还需要各方法原生场景内的对比。
5. ACL’26 LoGo:不看训练数据,直接看 LoRA 对当前输入“动了多大”
LoGo(LoRA on the Go)继续追问:如果新 LoRA 连 10 个代表样本也不能提供,能否只根据它在当前输入上的 activation 选择?
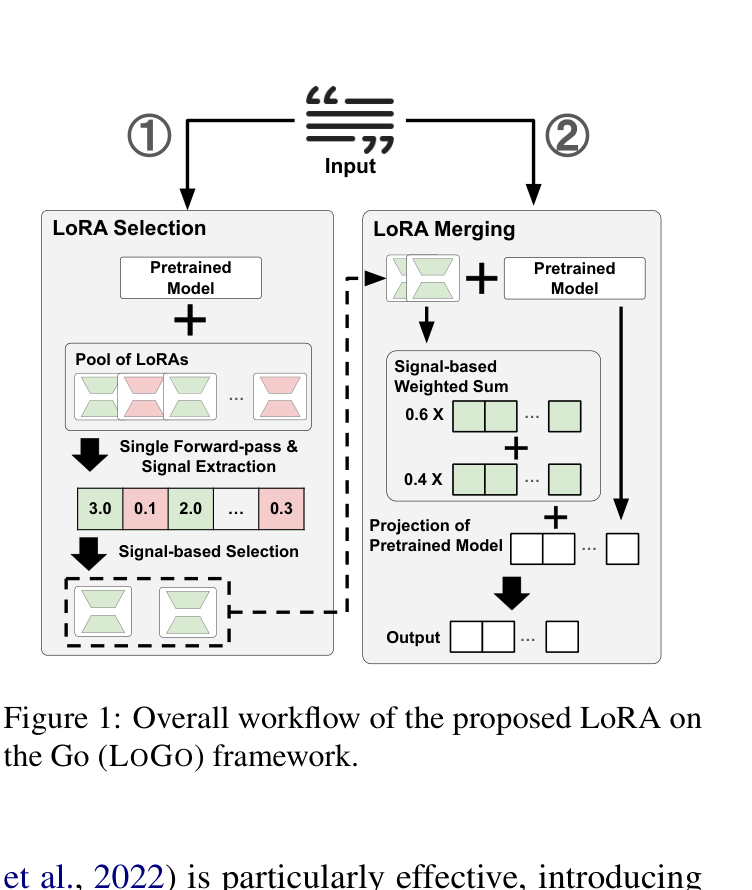
它把全部 $N$ 个候选 LoRA 挂到同一个 backbone,在一次 probe pass 中读取指定 Transformer block 的 LoRA projection。对 Adapter $i$:
\[o_i=\Delta W_i h_T.\]LoGo 用两类 training-free signal 给它打分:
\[s_i^{\text{norm}}=\lVert o_i\rVert_2,\]或者先把 activation 维度 softmax,再取 entropy 的倒数。Entropy 是分布不确定性的度量,越低表示概率质量越集中;取倒数后,越集中的 activation 得分越高。接着选 top-$k$,将分数归一化为:
\[\tilde w_i=\frac{s_i}{\sum_{j\in S}s_j},\qquad o_{\text{merge}}=\sum_{i\in S}\tilde w_io_i.\]下图从左到右正好对应两步。左边让所有 LoRA 对当前 input 做 probe,根据 norm 或 inverse entropy 选出少量候选;右边只保留选中的 LoRA,用信号归一化后的权重做 output mixture,再加回 base projection。
这里的关键假设是:相关 LoRA 会对相关输入产生更强、更集中的增量。 论文画出的热力图确实出现了块对角结构。横轴是不同任务 LoRA,纵轴是输入数据集,绿色越深表示 projection norm 越大;红框里的同类任务通常一起变亮。
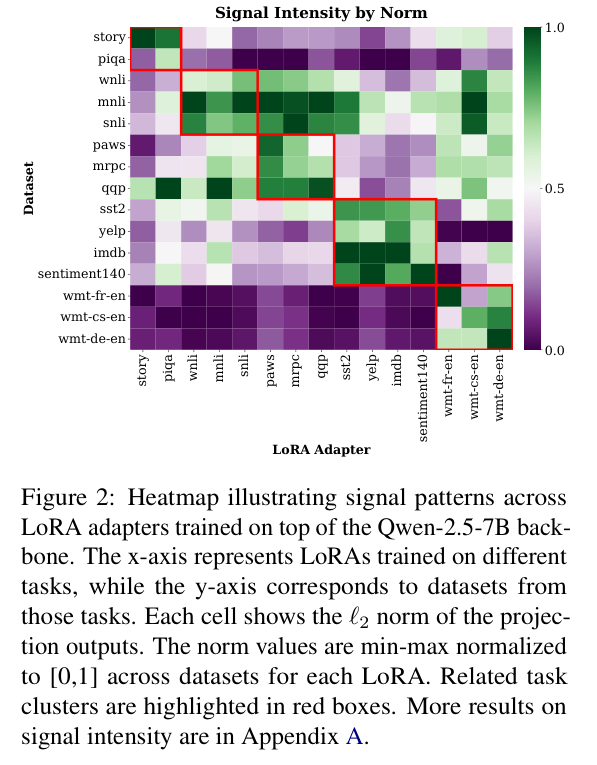
这提供了比“LoRA 参数之间 cosine 相似”更直接的 instance-level 信号。但 norm 大只说明 Adapter 改动大,不说明改动方向一定降低任务 loss。论文附录用一阶 Taylor 展开给出的也只是上界:$\lVert\Delta z\rVert$ 约束潜在 loss change 的幅度,却没有保证它与 $-\nabla_z\mathcal L$ 同向。一个不匹配、过度激进甚至恶意的 LoRA,同样可能产生很大的 norm。
5.1 LoGo 不是全表最优,“training-free”也不是“free”
LoGo 在三个 model family、27 个数据集上比较 Base、AdapterSoup、LoraHub 和 LoraRetriever。以 LLaMA-3.1-8B 为例,取 LoGo 的 entropy 版本:
| 任务组 | Base | AdapterSoup | LoraHub | LoraRetriever | LoGo |
|---|---|---|---|---|---|
| BBH(Exact Match) | 27.3 | 42.5 | 37.0 | 40.4 | 40.0 |
| Translation(BLEU) | 24.5 | 26.0 | 23.6 | 25.9 | 26.0 |
| Struct-to-Text(ROUGE 平均) | 46.4 | 49.1 | 42.1 | 47.6 | 50.7 |
| Closed-Book QA(Exact Match) | 40.4 | 43.0 | 38.4 | 43.6 | 44.3 |
| NLI(Exact Match) | 34.0 | 37.8 | 32.7 | 32.1 | 37.2 |
更准确的结论是:LoGo 在不训练 retriever、不保存 Adapter 数据的条件下,与训练式方法整体有竞争力,并在部分生成与问答任务上更好;它并没有在每个 task、backbone 和 signal 上统一获胜。DeepSeek-LLM-7B-Base 上 entropy signal 的部分结果甚至明显失效,这也说明 activation 统计依赖 backbone 的内部几何。
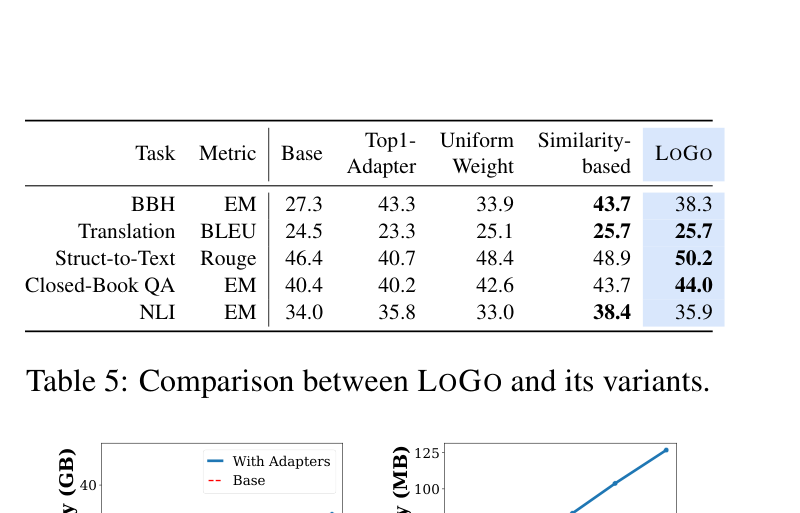
论文自己的 ablation 也很有意思。下面的表把 LoGo 与 top-1、均匀合并和基于语义相似度的选择放在一起。LoGo 在 Struct-to-Text 和 Closed-Book QA 最好,但 BBH 上 top-1 为 43.3、similarity-based 为 43.7,都高于 LoGo 的 38.3;NLI 也是 similarity-based 更高。“合并多个 Adapter 一致优于 top-1”只在部分汇总项成立,不能外推成普遍规律。
系统成本同样不能省略。LoGo 的 probe 参数和 activation memory 都随 Adapter 数量 $N$ 线性增长。LLaMA-3.1-8B 挂载 260 个 LoRA 时,额外 LoRA 参数占 6.8GB,约为 base model 30.6GB 的 22%;probe activation 为 126.7MB。论文报告每个 Adapter 约增加 0.005 秒 probe latency。
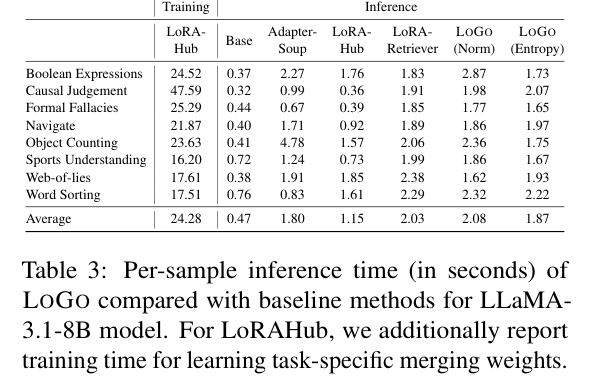
下面这张表给的是 LLaMA-3.1-8B 单卡 H100 上的每样本时间。Base 平均 0.47 秒,LoGo norm 为 2.08 秒、entropy 为 1.87 秒;它与 LoraRetriever 的 2.03 秒“可比”,并不是与 base model 一样快。LoraHub 左侧 24.28 秒是每个目标任务学习组合权重的训练时间,也不能与右侧逐样本 inference 直接相减。
LoGo 在长输出上可以摊薄 probe 的 time-to-first-token,但短分类请求摊不掉。池子从 260 扩到 2.6 万时,$O(N)$ 扫描也不会因为它是低秩矩阵就自动消失。真正的大规模开放池仍然需要“先便宜 shortlist,再对少数候选做 activation probe”。
6. LLM-JEPA 是一条旁线:它改善 LoRA 学到的表征,不负责选择 LoRA
LLM-JEPA 把 Joint Embedding Predictive Architecture 引入语言模型。JEPA 不要求从一种 view 逐 token 重建另一种 view,而是让它们在 embedding 空间里可预测。论文用自然语言描述与代码、问题与答案、上下文与正确续写作为同一知识的不同 view,在原本 next-token prediction loss 上增加:
\[\mathcal L_{\text{LLM-JEPA}} =\mathcal L_{\text{LLM}} +\lambda\,d\!\left(\operatorname{Pred}(\operatorname{Enc}(v_1)),\operatorname{Enc}(v_2)\right),\]其中 $d$ 主要使用 cosine distance,[PRED] token 让 LLM 自己充当非线性 predictor。它仍保留生成 loss;论文把 $\mathcal L_{\text{LLM}}$ 权重降到 0 时,模型只生成空字符串,所以 JEPA 在这里是表征正则,不是生成目标的替代品。
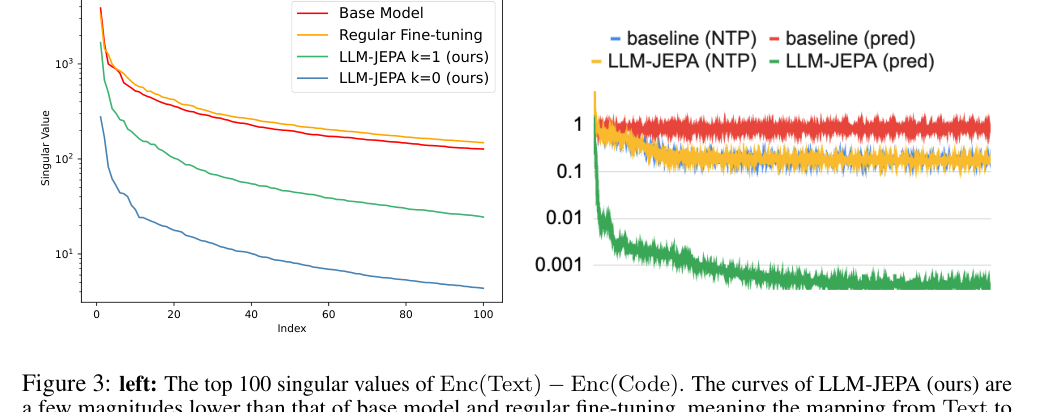
下图左侧看奇异值:LLM-JEPA 让 Text 与 Code 的 representation difference 更集中在低维子空间;右侧看训练曲线:普通 next-token training 没有顺手降低 JEPA prediction loss,而加入 JEPA 后该 loss 才真正下降。这说明“会生成对应代码”和“两个 view 在 latent space 里结构化对齐”不是同一件事。
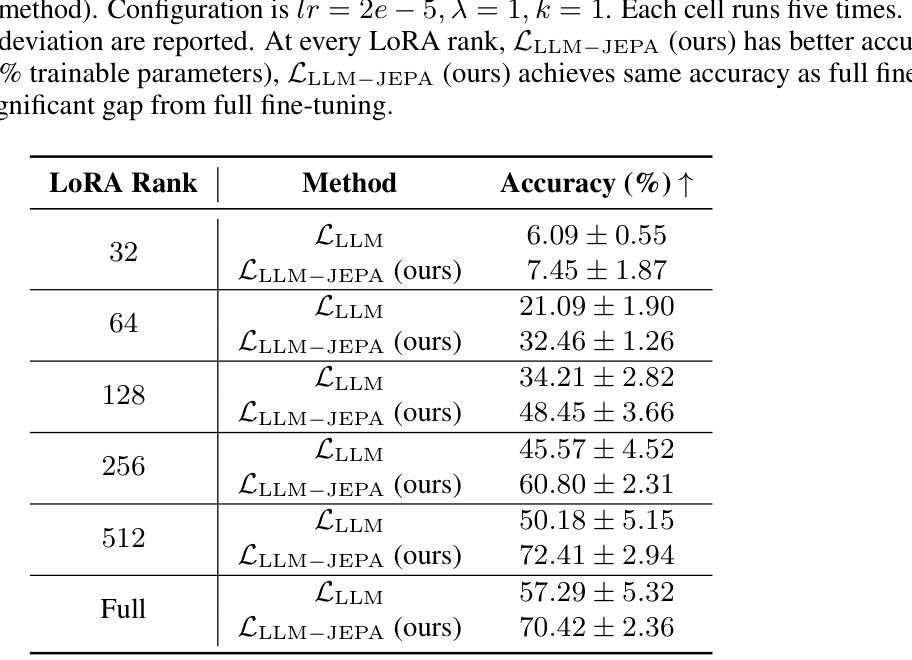
它与多 LoRA 的直接交集只有一项:论文也做了 LoRA fine-tuning。NL-RX-SYNTH 上,从 rank 32 到 512,加入 JEPA loss 的 LoRA 都比普通 next-token loss 更高;例如 rank 128 从 $34.21\%\pm2.82$ 提升到 $48.45\%\pm3.66$。但这张表证明的是单个 LoRA 可以学得更好、更不容易过拟合,不是多个 LoRA 更可组合。
真正值得借到 open-world routing 的,是“不同 view 对齐”这个思路。一个 Adapter 的自然语言模型卡、少量 probe 输入上的行为、低秩参数 sketch 和真实下游收益,可以看作同一能力的不同 view。若能把 query view 与 Adapter behavior view 对齐,新增 LoRA 就不必对应固定分类头里的一个新 class。
7. 以后比较多 LoRA Router,至少要立住六根标杆
这几篇论文最容易给人造成的错觉,是看一列 accuracy 超过 base 就认为多 LoRA 成立。一个 Router 实际上同时在回答三个问题:池子里有没有有用专家、它能不能找到、找到后能不能安全组合。只比较最终 accuracy 会把三者揉在一起。
7.1 能力下界与真实适配上界
同一 backbone、同一 prompt template、同一 decoding 设置下,至少要报告:
- Base model:完全不用 LoRA,判断 Adapter 是否真的提供增益。
- Random / mismatched LoRA 与 uniform merge:测错路由和盲目组合的伤害。
- Target-specific LoRA、full fine-tuning 或 ICL:表示拿到目标任务数据后,真正适配能达到什么水平。
第三项不一定是 Router 必须击败的 baseline,但它告诉我们“池中复用”与“针对目标重新训练”之间还差多少。
7.2 Best-single oracle:先回答池子里到底有没有正确答案
对每个样本 $x$,离线枚举全部 Adapter,按统一 utility 选最好的单 LoRA:
\[i^*(x)=\arg\max_i U(x,\phi_i).\]这里的 oracle 是评测工具,不是部署方法。分类任务的 $U$ 可以是是否预测正确,生成任务可以用样本级 metric 或 judge;若考虑系统约束,则应把质量、latency 和加载成本合成事先声明的 utility。
Router 选择 $\hat i$ 后,报告的不是只有“任务 ID 选对率”,还应该有 oracle regret:
\[\operatorname{Regret}(x)=U(x,\phi_{i^*})-U(x,\phi_{\hat i}).\]任务标签可能有多个等价 LoRA,选错 ID 也可能得到同样结果;regret 比单纯 top-1 routing accuracy 更接近最终目标。与此同时报告 Recall@$k$,表示 oracle 单专家是否进入 Router 的前 $k$ 个候选,越高越好。
7.3 Best-subset oracle:多 LoRA 到底有没有超过最佳单 LoRA
如果论文声称“组合能力”,只与 base 或 random merge 比还不够。给定最多激活 $k$ 个 Adapter 的预算,应近似搜索 best subset:
\[S^*(x)=\arg\max_{|S|\le k}U(x,\operatorname{Compose}(S)).\]再报告组合增益:
\[\operatorname{Synergy}(x,S)=U(x,\operatorname{Compose}(S))-\max_{i\in S}U(x,\phi_i).\]Synergy 大于 0 才说明组合超过了集合内最佳单专家;小于 0 就是 interference。完整枚举在大池里很贵,可以只在离线小子集上做 beam search 或受限组合,但不能完全没有这个标杆。还应报告 negative transfer rate,也就是组合比 base 或 best single 更差的样本比例。
7.4 概率可靠性:Router 的 0.9 到底能不能用于执行策略
如果 Router 输出 softmax,不能只画 top-1 accuracy。至少还要看 NLL、Brier score 与 ECE:NLL(negative log-likelihood)会重罚“给正确 Adapter 极低概率”;Brier score 衡量完整分布与真实结果的平方距离;ECE(Expected Calibration Error)比较各 confidence 区间的平均置信度与真实命中率,三者都是越低越好。
再增加 risk-coverage curve:按 confidence 从高到低只自动处理一部分请求,coverage 是系统愿意接管的比例,risk 是其中的错误率。一个 open-world Router 必须允许返回 base model、none-of-the-above 或 abstain(拒绝路由、交给后备流程),否则它面对池外任务时只能自信地选错一个。
7.5 系统账不能只算 Router forward
必须端到端报告:
- time-to-first-token、端到端 latency 与 tokens/s;
- Adapter 参数显存、probe activation、KV Cache 与临时 fused weights;
- 从 CPU/SSD 加载 Adapter 的字节数和 cache hit rate;
- mixed batch 下的吞吐,而不是单请求 microbenchmark;
- pool size 从 32、128、512 扩展到几千时的曲线。
LoraRetriever 已经注意到 heterogeneous batch,LoGo 也报告了 probe memory,但离一个统一 serving benchmark 还差很远。
7.6 “开放世界”必须用时间顺序评测,而不是随机切分
训练 Router 时只给版本 $t$ 的 Adapter 池,测试时再插入从未参与 Router 训练的 LoRA,并分开做:
- leave-adapter-out:新 Adapter,任务可能见过;
- leave-task-out:任务和 Adapter 都没见过;
- leave-domain-out:语言或领域整体没见过;
- dirty-pool:混入低质量、重复、不同 rank 和错误模型卡;
- no-match:池里没有有帮助的 Adapter。
只有新增 Adapter 后不改 Router 参数,性能仍能接近 oracle,并且 no-match 时愿意退回 base,才能叫 open-world generalization。随机把同一任务样本切成 train/test,更多是在测闭集插值。
8. Jev 的 System-One 思想可以用,但要用在“候选条件化决策”上
前文介绍 Jev 时,最有价值的不是“模型不输出 token”这个产品特性,而是三件事:调用者在请求时给候选、模型返回候选上的完整概率、低 confidence 可以触发 fallback。把这个接口移到 Adapter routing,状态和问题可以写成:
state:
  当前请求、对话历史、latency budget、已缓存 Adapter、硬件状态

question:
  在候选 Adapter 中选哪个?是否组合?还是使用 base / abstain?

candidates:
  动态传入的 Adapter capability cards
但不能直接把 Jev 当成一个已经可用的 LoRA Router。Jev 是闭源 decision model,没有证据表明它理解 LoRA 参数、activation 或组合干扰;把几十个模型卡丢进去选一个,只能算语义 Router baseline。
更自然的研究方案是一个三阶段系统。
8.1 第一阶段:给每个 Adapter 建 capability card,而不是固定 class ID
每个 LoRA 注册时生成一个向量 $z_i$,信息可以来自四种 view:
- 模型卡和训练任务描述;
- 一组公共 probe suite 上的输入输出变化;
- $A/B$ 参数的低维 sketch、rank、target modules 等结构信息;
- 历史请求上的真实 utility 与失败模式。
数据隐私敏感时不能保存训练样本,但可以保存经过聚合的 behavior fingerprint。需要明确威胁模型:参数 sketch 仍可能泄漏信息,社区上传的 LoRA 也可能通过超大 norm 欺骗 LoGo 式路由。
8.2 第二阶段:先检索,再用 JEV-like head 做动态候选打分
当池子有几万 LoRA 时,先用 query embedding 做 ANN(Approximate Nearest Neighbor,近似最近邻)检索,把 $N$ 缩到几十个候选 $C(x)$;再用一个 candidate-conditioned scorer:
\[s_i=f\big(q(x),z_i,c_i\big),\qquad p(i\mid x,C)=\frac{e^{s_i/\tau}}{e^{s_{\text{base}}/\tau}+e^{s_{\text{abstain}}/\tau}+\sum_{j\in C}e^{s_j/\tau}},\]其中 $c_i$ 包含 Adapter 是否已在 GPU cache、加载延迟和显存开销。输出不是固定 $K$ 维 head,而是对本次动态候选逐个复用同一个 scorer,并在整组候选内比较;这类结构常被叫作 pointer/listwise decision head。新 LoRA 只要能生成 $z_i$ 就能加入,不修改输出维度。
这一步可以借鉴 Jev 的 typed decision:除了 Choice(Adapter),再输出 Score(expected gain)、Score(expected latency) 和 Boolean(should abstain)。不过这些概率必须在独立 calibration split 上用 temperature scaling、Brier 或其他 proper scoring rule 校准;proper scoring rule 的特点是长期如实报告概率时期望损失最低,不能靠永远报高 confidence 占便宜。raw softmax 不能直接当成真实成功率。
8.3 第三阶段:把“选谁”和“怎么组合”拆开
先预测单 Adapter utility,再单独建模 pairwise compatibility:
\[s_{ij}^{\text{compat}}=g\big(q(x),z_i,z_j\big).\]只有当预期 synergy 大于加载与计算成本时才选多 LoRA。这样可以避免“Router top-$k$”默认等价于“前 $k$ 个都应该一起开”。组合器还要显式选择 output mixture、parameter fusion 或 sequential composition,而不是把三种操作混成一个 accuracy 数字。
低 confidence 或候选分布过平时,System One 不应该硬猜,而应升级到更贵的 System Two:对 shortlist 做 LoGo activation probe、运行小规模 shadow inference,或者请求标注/人工确认。Jev 思想最适合当快速决策层,LoGo 则可以成为不确定样本上的 verifier,而不是让所有请求都扫描全部 Adapter。
9. LLM-JEPA 可以怎样接到这个 Router 里
普通 contrastive retriever 往往把“同任务”当正样本、“不同任务”当负样本,这会遇到两个问题:不同数据集可能需要同一种能力,同一数据集也可能含多个技能;Adapter 的文本描述与真实行为还可能不一致。
可以把一次请求与某个 LoRA 产生的有效行为看成两个 view:
- query view:任务指令、输入和约束;
- Adapter view:该 LoRA 在 probe 上造成的 hidden-state delta、输出变化与 utility profile。
用 JEPA predictor 从 query embedding 预测“能带来正 utility 的 Adapter behavior embedding”,同时保留 listwise utility loss:
\[\mathcal L =\mathcal L_{\text{rank}} +\lambda_{\text{JEPA}}d\!\left(\operatorname{Pred}(q(x)),\operatorname{stopgrad}(z_i^{\text{behavior}})\right) +\lambda_{\text{cal}}\mathcal L_{\text{Brier}}.\]stopgrad 表示 target branch 不接收这条路径的梯度,用来降低两个分支一起坍缩到常数向量的风险。这里 JEPA 的作用不是替代 Router,而是让 query 和 Adapter 不必共享同一种原始输入格式,也能在 latent space 里建立可预测关系。
第一版研究不应该一上来就宣称解决所有社区 LoRA。更稳妥的范围是:同一 base model、相同 target modules、允许 rank 不同,先做动态插入与无匹配拒绝;之后再加入脏模型卡、不同训练 recipe 和 adversarial Adapter。跨 backbone LoRA 无法直接在权重空间组合,应该视为“先选模型再选 Adapter”的层级路由问题,不要硬塞进同一个 scorer。
10. 一个可以直接开做的实验协议
把研究问题压成一句话:
在 Router 参数冻结后持续加入新 LoRA,能否只根据 capability card 与当前 query,接近 best-single / best-subset oracle,同时在无匹配任务上可靠 abstain,并让候选池增长 $N$ 倍时的路由开销不再跟着线性增长?
实验可以分三层推进:
第一层:受控可证伪。 统一 backbone 和 LoRA recipe,构造 task/domain/adapter 的时间切分。完整离线枚举得到 best-single oracle,小池上近似 best-subset oracle。比较 text-card retrieval、parameter sketch、LoraRetriever、LoGo、固定 Router 和 proposed scorer。
第二层:拆开每个信号的贡献。 分别只用模型卡、只用 behavior fingerprint、只用 LoGo activation、加入 JEPA alignment、加入 calibration。报告 Recall@$k$、utility regret、synergy、negative transfer、ECE 和 risk-coverage,而不是只报最终平均 accuracy。
第三层:把系统规模拉起来。 Adapter pool 从几十扩到几千,测 ANN shortlist、GPU Adapter cache、LoGo verifier 触发率与 mixed-batch throughput。固定最终质量,比较每个方法为接近 oracle 多花了多少毫秒、显存和 I/O。
这套协议里最关键的 control 有两个:
- 永远保留 base/no-adapter 作为合法候选。 否则 Router 不可能学会“池子里没有答案”。
- sample-based 与 data-free 分赛道。 LoraHub 的 5-shot、LoraRetriever 的 Adapter 样本、LoGo 的无数据 probe 所用信息完全不同,不能只在一张 accuracy 表里排座次。
11. 总结:真正的开放世界,不是把 $K$ 从 8 改成 800
LoraHub 首先证明,旧 LoRA 里确实存在可被重新利用的跨任务信号,但它是 task-level、5-shot、黑盒搜索,平均效果仍低于 ICL 和直接训练新 LoRA。LoraRetriever 把组合推进到 instance-level,并用 Perfect Selection、IID、OOD 把“池中能力、路由能力、跨任务组合”拆开;代价是需要 Adapter 样本和额外 retriever。LoGo 再拿掉这些监督,用 activation norm 或 inverse entropy 在线选择,但它需要 $O(N)$ probe,不是每个任务都赢,也没有从理论上保证“大 activation 等于正收益”。
所以多 LoRA 最诚实的结论是:
当池中存在互补技能、Router 能找到它们、组合操作不会产生严重干扰,并且额外系统成本低于收益时,多 LoRA 才成立。任何一条失败,top-1、base model 甚至重新训练一个目标 LoRA 都可能更好。
Jev 的 System-One 思想可以提供动态候选、概率接口、校准和 abstain;LLM-JEPA 可以帮助 query 与 Adapter behavior 在 embedding 空间对齐。两者拼起来最有希望的方向,不是再训练一个固定 $K$ 维 Router,而是做一个候选条件化、成本感知、能拒绝回答的 open-world Adapter decision model。
这条路值得做,但 benchmark 必须先立住。否则很容易把“比 base 高了两个点”“在一个干净池里找到同任务 LoRA”误写成开放世界,而真正麻烦的新 Adapter、无匹配输入、组合干扰和加载成本,全部被藏到表格外面。
12. 参考资料
- LoraHub: Efficient Cross-Task Generalization via Dynamic LoRA Composition:https://arxiv.org/abs/2307.13269v3
- LoraRetriever: Input-Aware LoRA Retrieval and Composition for Mixed Tasks in the Wild:https://arxiv.org/abs/2402.09997v1
- LoRA on the Go: Instance-level Dynamic LoRA Selection and Merging:https://arxiv.org/abs/2511.07129v3
- LLM-JEPA: Large Language Models Meet Joint Embedding Predictive Architectures:https://arxiv.org/abs/2509.14252v2
- Jev 官方发布博客:https://typesafe.ai/blog/introducing-system-one-models-and-jev
- LoRA:https://arxiv.org/abs/2106.09685
- AdapterSoup:https://arxiv.org/abs/2302.07027
- AdaMix:https://arxiv.org/abs/2210.17451
- SiRA:https://arxiv.org/abs/2311.09179
- SMEAR:https://arxiv.org/abs/2306.03745
- Task Arithmetic:https://arxiv.org/abs/2212.04089
- TIES-Merging:https://arxiv.org/abs/2306.01708
- LoRA-Flow:https://arxiv.org/abs/2402.08193
- S-LoRA:https://arxiv.org/abs/2311.03285
- FLoRA:https://arxiv.org/abs/2312.05677
顺带扯一句题外话。多 LoRA routing 的核心已经不只是“微调哪几层”,而是从一组模块里搜索、组合并评估最合适的模型结构。《动手学 AutoML:从 NAS 到大语言模型优化实战》第 8 章讨论了 LLM 压缩与模型融合,前面的 NAS 和架构评估章节则对应这里的 search space、search strategy 与 oracle benchmark。书里没有这套 open-world Router,但研究问题的骨架其实非常 AutoML:候选会变、评估很贵、搜索结果还必须能泛化。
