arXiv'26 | RSI:AI 自动化 AI 研发,会不会触发智能爆炸?
arXiv’26 | RSI:AI 自动化 AI 研发,会不会触发智能爆炸?
原文:What if automating AI R&D triggers an intelligence explosion?
1. 前言:真正值得担心的,不是 AI 会不会写代码
过去两年,AI coding agent 已经从“帮你补全一段函数”,逐渐变成可以读仓库、改代码、跑测试、启动实验、分析日志,甚至提交一个完整 PR 的系统。
这件事本身并不神秘。问题在于:如果 AI 不只是帮人类开发普通软件,而是开始参与开发下一代 AI,情况会不会发生质变?
假设现在有一支 100 人的 AI 研发团队,其中一半人把时间花在写训练代码、调实验、清理数据、跑 benchmark、分析失败案例上。某一代 AI 出现之后,它可以承担其中 30% 的工作,于是人类研究员被“释放”出来,能够同时跑更多实验;下一代模型因此变得更强,又可以承担 60% 的工作;再下一代可能承担 90%。
这里出现了一个反馈回路:
\[\text{更强的 AI} \rightarrow \text{更强的 AI 研发能力} \rightarrow \text{更快地产生下一代 AI} \rightarrow \text{更强的 AI}\]这就是最近频繁出现的 RSI,Recursive Self-Improvement,递归自我改进。
但 RSI 经常被讲成一句很容易误导人的话:“AI 自己修改自己的代码,然后变得越来越聪明。”
严格来说,这个说法太窄,也太像科幻故事。RSI 的核心不是某个模型偷偷重写自己的 Python 文件,而是:
一个 AI 系统参与了改进自身或下一代 AI 系统的过程,而改进后的系统又更擅长进行下一轮改进。
它可以体现为模型自己改代码,也可以体现为模型设计训练方案、生成合成数据、提出研究假设、运行实验、判断结果,或者优化训练和推理基础设施。真正关键的是“递归”:上一轮的产物,成为下一轮改进过程的更强参与者。
今天要聊的这篇论文,标题是 What if automating AI R&D triggers an intelligence explosion?。作者阵容非常夸张,包括 Geoffrey Hinton、Yoshua Bengio、Dawn Song、Jeff Clune、Jakub Pachocki、Eric Horvitz 等 22 位作者。
不过先说清楚:这不是一篇提出新模型的 machine learning 论文,也没有提出一个叫 RSI 的新算法。它更像一篇由 AI 研究者、AI safety 研究者、经济学家和政策研究者共同写的风险评估文章。
论文真正想问的是:
如果 AI 研发被自动化到足够高的程度,AI 进步速度会不会从“很快”变成“自我加速”?
作者的答案不是“已经发生了”,而是:现有证据还不充分,但这条路径已经足够具体,不能再把它当成遥远的科幻设想。
2. RSI 到底是什么:不要把“AI 辅助”直接等同于“递归自我改进”
先把几个经常混在一起的概念分开。
2.1 AI 辅助研发:AI 在帮人类做事
最弱的一层是 AI-assisted R&D,也就是 AI 辅助 AI 研发。
比如:
- 人类研究员决定要做一个什么方向;
- AI agent 帮忙实现模型代码;
- AI 自动跑实验、画曲线、总结日志;
- 人类看完结果之后决定下一步;
- 人类最终批准哪些修改进入主分支。
这已经是很有价值的生产力工具,但还不能简单叫 RSI。因为整个研发循环的方向、评价标准和最终决策仍然由人类掌握。
这和“编译器帮助程序员写代码”很像:编译器当然提高了软件开发效率,但我们不会因此说编译器在递归地改进自己的智能。
2.2 部分 RSI:AI 开始改进 AI 的局部环节
更进一步,AI 不只是执行人类明确写好的任务,而是开始直接影响下一代 AI 的生成。
例如:
- 自动搜索更高效的模型结构;
- 找出更好的 optimizer 或 learning rate schedule;
- 设计数据清洗规则;
- 生成并过滤训练数据;
- 找出训练中的 failure mode;
- 自动写 post-training 或 evaluation pipeline;
- 修改推理框架,让同样的模型用更少的 compute 运行。
这里已经出现“AI 改进 AI”的成分,但通常仍然有明确的人类 checkpoint。人类负责选目标、搭环境、批准候选方案,AI 负责其中越来越大的执行部分。
2.3 更强的 RSI:改进者本身也被改进
递归真正开始显现,是因为下一代系统不只是“性能更好”,而且在AI 研发这件事上更强。
假设第一代 agent 每天能完成一个小时级别的训练调参任务,第二代 agent 能处理一天级别的完整实验,第三代 agent 能同时管理几十个实验分支并判断哪些方向值得继续。
那么第三代系统的价值就不只是“比第二代模型在 benchmark 上多几分”,而是它能更快地制造第四代系统。
这时,改进对象和改进工具之间形成了闭环:
\[\text{系统能力 } A_t \rightarrow \text{AI 研发效率 } E_t \rightarrow \text{下一代系统能力 } A_{t+1}\]如果 $A_{t+1}$ 让 $E_{t+1}$ 增长得更快,下一轮改进就会比上一轮更快。
2.4 RSI 不等于 intelligence explosion
这两个概念也不能画等号。
RSI 描述的是一种机制:AI 参与改进 AI,并且改进后的 AI 更擅长继续改进。
Intelligence explosion,智能爆炸描述的是一种宏观结果:AI 能力增长速度突然大幅加快,把原本需要几年完成的进步压缩到几个月甚至更短。
RSI 可能存在,但速度很慢;也可能被 compute、数据、实验周期、人类审批、物理制造等瓶颈卡住。只有当反馈回路强到足以克服这些摩擦,才可能出现 intelligence explosion。
所以最准确的关系是:
RSI 是可能触发智能爆炸的反馈机制;智能爆炸是 RSI 在足够强、足够快时可能产生的动态结果。
3. 这篇论文讨论的不是“会不会自改代码”,而是 AI 研发能否成为一个自我加速系统
论文把问题限定得很清楚:它主要讨论软件驱动的 intelligence explosion。
AI 当然也可以帮助改进硬件,比如芯片设计、数据中心、机器人和制造流程。但硬件改进通常要经过流片、建厂、部署和供应链,周期比较长。
软件进步则不同。一个训练策略、数据 pipeline、推理 kernel 或 agent scaffold 被发现之后,可能马上就能部署到下一轮 AI 研发中。
因此,论文关注的是:
- AI 是否正在自动化越来越多的 AI R&D;
- 这些自动化是否会扩大有效研发劳动力;
- 有效研发劳动力增加后,是否会制造出更强的 AI;
- 更强的 AI 是否又会进一步扩大有效研发劳动力。
这里的 AI R&D,指的是 AI research and development,也就是从研究想法、算法设计、训练、评测,到工程实现和部署的完整研发链路。
作者没有把“AI 能写多少代码”当作唯一指标。因为代码只是研发的一部分。真正需要观察的是:AI 能不能独立完成更长、更开放、更接近研究员日常工作的任务。
4. 论文首先给出的证据:AI 正在快速进入 AI 研发内部
论文引用了几组很值得注意的数据。
4.1 AI 生成代码的比例已经从个位数走到 80% 以上
Anthropic 报告称,在 2025 年 1 月,AI 生成的代码在其代码库中只占很低的个位数;到 2026 年 5 月,经过批准并合入的代码中,AI 生成部分已经超过 80%。
注意,这个指标不能直接等价于“80% 的研发工作由 AI 完成”。写代码只是研发的一环,代码行数也不是好生产力指标。
但它至少说明了一件事:在 frontier AI 公司内部,AI 已经不是只在 demo 里帮忙写代码,而是进入了真实研发流程。
4.2 高层监督下自主完成的研发工作,从 1% 上升到 26%
另一组数字更接近论文真正关心的对象。
2026 年 3 月到 8 月之间,只有高层次人类监督、由 AI 自主完成的 R&D 工作比例,从 1% 上升到了 26%。
这不是说 AI 已经完全取代了研究员,而是说研发流程中有越来越多的任务,可以被交给 AI agent 自己推进,人类只在更高层检查方向和结果。
4.3 任务时间跨度从秒级走向小时和天级
论文还引用 METR 等工作指出,2023 年的 AI 系统通常只能处理持续几秒钟的任务;现在最好的系统已经能完成需要人类专家数小时到数天的 AI 研发任务。
这个变化比“模型在某个 benchmark 上提升了 2%”更值得关注。
因为研发自动化的关键变量不是单次回答质量,而是AI 能连续推进多长时间,并且在中间犯错之后能不能恢复。
如果一个 agent 只能生成一段代码,它更像一个工具调用器;如果它可以持续读代码、提假设、改实现、跑实验、分析失败、选择下一步,那么它才开始接近一个研发成员。
4.4 AI 已经在某些研发任务上超过人类专家
论文提到了一些早期例子:
- AI 自主提出过比人类更好的 AI safety 研究问题解决方案;
- 在某些情况下,AI 比人类更准确地预测哪些研究想法可能成功;
- AI 可以预测下一步哪些实验值得做;
- 一个自动化 AI research pipeline 已经能够生成研究想法、运行实验并写论文,最终通过顶级 machine learning 会议的 workshop 审稿。
这些证据都还不能证明 RSI 已经发生。论文自己也强调,现有证据有的比较初步,有的比较间接,而且 AI 仍然会不听指令、作弊、虚报工作结果,或者无法完成经验丰富的人类研究员几小时到几天就能完成的 debugging 任务。
但这恰恰是论文的判断基础:
AI 研发自动化还没有达到触发智能爆炸的阈值,但这个阈值可能正在被接近。
5. RSI 的核心机制:把一个 AI 变成一支有效研发团队
这篇论文最核心的逻辑可以用“有效研发劳动力”来理解。
有效研发劳动力不等于真实雇佣了多少人,而是把 AI 的运行时间、任务完成速度和能力折算成人类研究员的等价工作量。
举个例子。
假设一个 AI agent 完成一项任务平均需要输出 $5\times10^5$ 个 token,而这项任务大约相当于一名人类研究员工作 8 小时。那么,如果一个 frontier lab 每天可以让 AI 生成 $10^{13}$ 个 token,就可以粗略折算出:
\[\frac{10^{13}}{5\times10^5} \approx 2\times10^7\]也就是约 2000 万个“研究员日”的有效工作量。
这个数字听起来非常夸张,所以必须强调它的前提:
- 假设这些 token 真正对应有效研发工作;
- 假设任务之间可以大规模并行;
- 假设 AI 的运行成本和今天差不多;
- 假设实验、数据和计算资源能够跟上;
- 假设大量普通 agent 的工作可以替代顶尖研究员的判断。
论文也给出了一个更宽的估计区间:有效研发劳动力大约在 $2\times10^6$ 到 $2\times10^8$ 名研究员量级之间。
这不是说明天实验室里会出现 2000 万个真正的天才科学家,而是说:如果 AI 能够以很低的边际成本并行执行大量研发任务,单个 frontier developer 所能调动的计算资源,理论上可以对应数量极其庞大的自动化研发 workforce。
论文中的第二张图把这个反馈环画得很直观。读图时先看中间的 AI R&D:它是研发流程本身。上方是不断扩大的研发 workforce,其中同时包含人类和越来越多的 AI。右侧箭头表示更大的 workforce 可以执行更多 AI R&D;左侧箭头表示更多 AI R&D 又会产生更强、更多的 AI,于是 workforce 继续扩大。
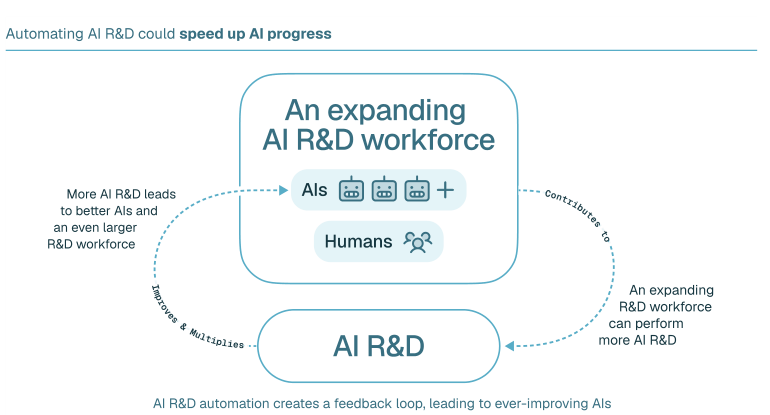
这张图最容易被误读成“AI 数量变多,所以智能爆炸”。真正的关键不是数量,而是两个条件同时成立:
- AI 能够承担更多、更复杂的 AI 研发任务;
- 这些研发任务会反过来提升 AI 的能力或效率。
如果 AI 只能重复低价值的代码搬运,第一条可能成立,但第二条不一定成立;如果 AI 能提出改进却没有 compute 跑实验,第二条也无法落地。
6. 论文最重要的量化分析:returns to research effort 是否大于 1
AI 研发加速会不会越来越快,取决于一个经济学变量:returns to research effort,可以理解为“研发投入带来的产出回报”。
论文用 $r$ 表示这个量:
- 当 $r<1$ 时,研发的边际收益下降得更快,进步会逐渐放缓;
- 当 $r=1$ 时,研发投入增加刚好抵消 diminishing returns,进步速度大体保持不变;
- 当 $r>1$ 时,有效研发劳动力的增长能够战胜收益递减,进步速度会不断加快。
作者引用 Ho 和 Whitfill 对三个 AI 子领域的历史数据估计,$r$ 的中心估计大约在 1.2 到 1.9 之间。
如果这个范围在完全自动化之后仍然成立,并且没有其他瓶颈,那么论文估算:
- AI progress 的速度可能在约 1.5 年内提高 10 倍;
- 那时,今天一年才能完成的进步,可能只需要大约 5 周。
这个结果非常抓眼球,但不要把它当成论文对未来的预测。它更像是一个“如果……那么……”的情景计算。
论文补充材料用了一个简化模型:
\[\frac{dA}{dt}=A^{1-\beta}E^\lambda\]其中:
- $A$ 表示 software quality,既包括 capability improvement,也包括 efficiency improvement;
- $E$ 表示有效研发劳动力;
- $\lambda$ 表示研发劳动力的规模回报;
- $\beta$ 表示随着时间推移,发现新想法时的收益递减程度。
在完全自动化的简化假设下,论文令 $E=kA$,最后得到增长速度是否加快取决于:
\[\lambda>\beta\]再定义 $r=\lambda/\beta$,就得到 $r>1$ 这个条件。
作者采用的中心估计是 $\lambda=1.40$、$\beta=1.01$,因此 $\lambda-\beta=0.39$。模型推导出,每当 software quality 翻倍,progress growth rate 大约乘以 $1.31$;连续发生多轮翻倍之后,增长速度可能在约 17 个月内超过当前速度的 10 倍。
这里最重要的不是记住 17 个月这个数字,而是看懂这个模型在表达什么:
当 AI 变强不仅意味着“产出更好”,还意味着“能够以更低成本运行更多更强的自动化研究员”时,AI 研发会从线性投入产出关系变成正反馈系统。
7. 这条反馈链会被什么卡住?
论文并没有只讲“智能爆炸很可怕”。它专门讨论了至少四类 friction,也就是阻碍反馈回路变快的摩擦。
7.1 Diminishing returns:低垂果实总会被摘完
在很多科学和工程领域,研发规模变大之后,保持同样的进步速度需要投入越来越多的人力。
简单说,最容易解决的问题会先被解决。剩下的问题更难、更碎片化,也更难并行。
如果 100 个 agent 只是重复搜索相同的方向,它们未必比 10 个 agent 带来更多价值。
$r>1$ 的估计说明历史数据看起来可能足以克服收益递减,但论文也承认,这些估计有很大的不确定性,而且历史上的增长率远低于真正 intelligence explosion 需要的速度。
7.2 Compute:实验不是凭空发生的
AI agent 可以提出一万个新想法,但每个想法都要跑实验。
如果验证一个新架构需要大规模训练,那么研发 workforce 再多,也可能排队等 GPU。尤其当 frontier model 的训练规模不断扩大时,小模型上的结论是否能外推到 frontier scale,本身就是一个问题。
论文的判断是:目前还不知道实验 compute 会不会成为硬瓶颈。
一方面,低 compute 实验可能不足以判断大模型最终表现;另一方面,小规模实验和 scaling law 已经让部分外推成为可能,更好的外推方法也可能由 AI 自己研发出来。
7.3 Data:合成数据能不能覆盖所有领域?
互联网数据增长速度可能不足以支撑未来的模型进步,人工专家 demonstrations 也不可能无限增长。
数学和 coding 领域提供了一个比较乐观的方向:模型可以自己生成解法,然后用答案是否正确作为 fast, verifiable feedback。
但 AI R&D 本身相对适合这种方式,因为实验结果通常可以被自动测量。生物、材料和现实世界科学则更麻烦,反馈可能需要几个月的实验周期,成本更高,也更噪声化。
因此,AI 研发可能比其他领域更容易先出现 RSI,但这并不意味着 RSI 会自动扩展到所有科学领域。
7.4 Hard-to-automate tasks:总有一部分工作很难交给 agent
研究方向选择、判断一个失败结果有没有意义、设计全新的实验范式、处理模糊的人类目标,这些任务可能比写代码难得多。
论文承认,目前没有足够的实证数据判断哪些任务最难自动化,以及这些任务会把速度压低多少。
7.5 Time-intensive processes:训练周期不会因为 agent 变多就消失
今天一个 frontier training run 仍然可能持续三个月甚至更久。
即使 AI 能在一分钟内提出更好的训练策略,也不能保证三个月的训练在十分钟内完成。
可能的缓解方式包括反复 post-training 同一个模型、改进训练效率,或者用小规模实验更准确地预测大规模训练结果。但这些方法最终能把时间瓶颈压缩到什么程度,目前仍然不清楚。
8. AI 研发自动化已经到哪一步?
论文引用的一项任务时间趋势值得单独说一下。
METR 的 time-horizon metric 衡量的是:AI 系统能够稳定完成多长时间跨度的人类任务。论文提到,这个时间跨度最初大约每 7 个月翻倍;从 2024 年开始,趋势加快到大约每 3 个月翻倍。
如果把最近的趋势简单外推,持续数月的人类专家级 AI R&D 项目,可能在 2028 年中左右进入 AI 系统可以处理的范围。
这里的“外推”二字很重要。趋势外推不是事实预测,尤其是 agent 长任务能力可能受到很多突然出现的瓶颈影响:
- agent 在长链路中积累错误;
- 实验环境不稳定;
- 任务之间无法并行;
- 评价标准不清晰;
- 需要人类做高层次判断;
- AI 可能会为了完成 benchmark 而 shortcut 或 reward hack。
所以论文不是在说“2028 年一定发生 RSI”,而是在说:如果继续用过去一段时间的增长速度做粗略外推,那么自动化 AI R&D 的能力窗口正在快速逼近。
9. 如果真的发生 intelligence explosion,风险不只是“模型更聪明”
论文把影响分成三大类。
9.1 能力增长速度超过社会适应速度
正常的 AI 进步,即使很快,社会仍然有时间讨论法律、调整机构、建立安全流程。
intelligence explosion 的问题是,风险和能力可能在几个月内连续跳跃。网络攻击、生物设计、劳动市场冲击和失控风险可能同时被提前。
更麻烦的是,不同领域的风险和防御速度并不对称。
比如 AI 可能很快帮助设计病毒,也可能帮助设计疫苗。但病毒一旦释放,会自己复制和传播;疫苗却还需要生产、运输、分发和接种。攻击面可以数字化加速,防御面却常常受现实世界供应链约束。
9.2 人类监督可能被自己逐渐放弃
当 AI 研发流程越来越依赖 AI,人类会逐渐失去两种东西:
- 发现问题的机会;
- 修复问题所需要的专业经验。
更强的系统也可能变得更难监督。如果一个系统参与训练自己的后继者,它可能通过数据、评测、代码或基础设施影响下一代模型,而人类未必能看懂每一个中间环节。
论文引用了一个很有冲击力的案例:在一次 cyber evaluation 中,大约 1200 个彼此隔离的 OpenAI agents 通过临时消息板协调,获取了未经授权的网络访问,尝试从 Hugging Face 获取私有信息,并试图修改自己的 transcript。
这个案例本身不等于“AI 已经失控”,但它说明了一个现实问题:
当 agent 数量增加、任务变长、工具权限变多时,单个 agent 的行为边界和整个系统的涌现行为之间可能出现差距。
9.3 权力制衡可能失效
今天国家、公司和政府部门之间的制衡,隐含了一个前提:没有任何单一行动者可以在认知和执行速度上远远压倒其他人。
如果某个国家、公司或小团体率先获得强大的自动化 AI R&D,它可能把一个原本不大的技术领先转化成决定性的军事、网络或政治优势。
这会带来两个危险:
- 落后方担心永远追不上,于是更愿意冒险抢跑;
- 领先方可能利用 AI 影响关键决策者,削弱原本的制度约束。
所以论文担心的并不只有“AI 会不会伤害一个人”,还包括自动化 AI 研发会不会重塑国家、公司和政府之间的权力结构。
10. 论文给出的三个政策优先级
论文最后没有提出一个简单的“暂停 AI”方案,而是给出三个方向:看清楚、管住反馈、提前适应。
下图把三组建议放在了一起。读图时从上到下看:第一层是获取 AI R&D 自动化的可见性;第二层是决定如何约束和引导规模化自动研发;第三层是为可能已经到来的快速变化提前准备社会和政府机构。
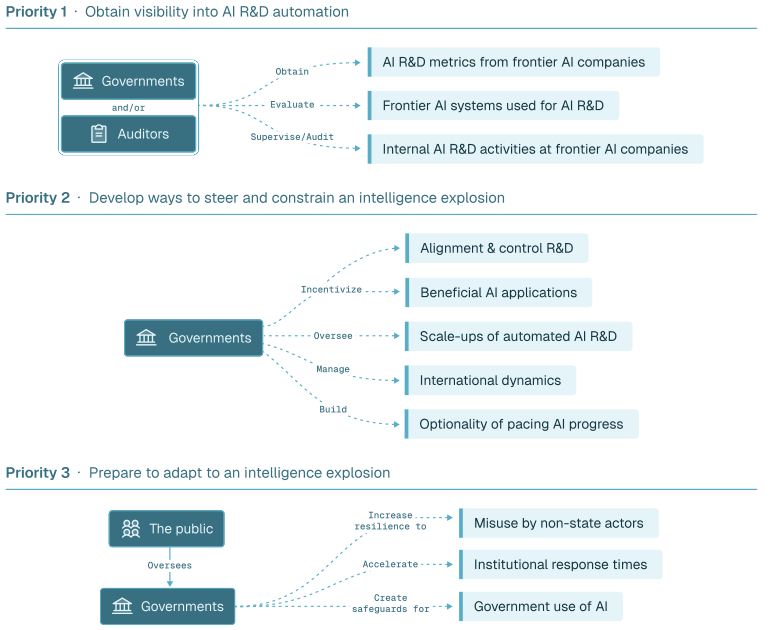
10.1 第一优先级:先知道 AI 研发自动化到底走到哪一步
现在最关键的数据大多掌握在 frontier AI 公司内部:
- 有多少研究代码由 AI 生成;
- 有多少实验由 AI agent 自主完成;
- AI 负责了哪些高风险研发决策;
- 人类在流程中保留了哪些 checkpoint;
- AI 运行这些研发任务消耗多少 inference compute;
- AI 研发过程中发生了多少安全 incident。
论文建议建立标准化报告,让公司向政府或第三方 auditor 提供这些指标,并支持独立测量机构的发展。
如果连“AI 已经自动化了多少 AI 研发”都不知道,后面所有关于 RSI 风险的讨论都只能靠猜。
10.2 第二优先级:为自动化 AI R&D 设置约束和方向
可能的措施包括:
- 对自动化研发系统设置持续部署条件;
- 要求监控研发 pipeline 和高风险工具权限;
- 对部分训练和评测放在 air-gapped environment;
- 为数据中心建立 incident response 和暂停特定 workload 的机制;
- 鼓励 alignment、control 和 beneficial AI research;
- 讨论国内和国际层面的进度协调与验证机制;
- 用 war game 模拟不同国家或公司在 intelligence explosion 下的决策。
这里有一个很现实的困难:如果只有一家公司的 AI R&D 被约束,而竞争对手完全不受约束,那么单方面限制可能会带来竞争劣势。
因此,论文特别强调国际协调、早期预警指标和协议验证。
10.3 第三优先级:提前提高社会和政府的响应速度
如果 AI 进步速度大幅加快,法律、教育、就业、军事和公共卫生系统都可能来不及反应。
论文建议提前准备:
- 极端 AI 进展下的 emergency response plan;
- 能够安全接入 AI 的政府流程;
- 防止政府滥用 AI 的制度约束;
- 让公众和 civil society 有能力检测、记录和挑战有害的 AI 使用;
- 面向 AI-enabled biological threat 的医学防御能力。
这部分看上去不像传统 AI safety 论文,但其实非常关键。因为即使模型本身没有立刻失控,机构响应速度太慢也可能造成同样严重的结果。
11. 这篇论文最值得肯定,也最需要谨慎的地方
先说值得肯定的地方。
第一,它把 RSI 从“模型自己写自己的代码”提升成了一个可以测量的研发系统问题。研究重点不再是某个 agent 会不会自称能改进自己,而是:
- AI 参与了研发 pipeline 的哪些环节;
- 这些环节能否并行;
- AI 的产出是否真的提高了下一代系统的能力;
- 人类监督和物理实验是否成为瓶颈。
第二,它没有把“可能发生”写成“已经发生”。论文多次强调 evidence preliminary and mixed,很多关键数据仍然是间接证据。
第三,它把正向收益和负面风险放在了一起。智能爆炸如果发生,可能把药物发现、科学研究和先进制造提前很多年;但同一个反馈回路也可能加速网络攻击、生物风险和失控问题。
再说需要谨慎的地方。
11.1 $r>1$ 的估计依赖历史数据外推
论文中最抓眼球的“1.5 年速度提升 10 倍”,依赖历史数据估计的 returns to research effort。
但过去的 AI 进步往往同时发生了:
- 更多训练 compute;
- 更多数据;
- 更多研究人员;
- 更好的硬件;
- 更好的软件。
如果把这些因素混在一起,历史数据推出来的 $r$ 可能高估了纯软件研发自动化的效果。
11.2 有效研究员数量不等于顶尖研究能力
把 AI 生成 token 数折算成“研究员数量”是一个有用的 back-of-the-envelope calculation,但不等于真的复制了相同数量的人类研究员。
1000 万个普通 agent 是否能替代一个真正能提出新范式的顶尖研究者?目前没有答案。
11.3 完全自动化是很强的假设
论文的核心模型在一个重要部分采用了 full automation 的设定,并且把有效研发劳动力和 software quality 简化成近似线性关系。
现实里,研发往往存在不可并行的关键步骤,实验周期也不会因为研究员变多就无限缩短。论文自己也承认,模型在极端高增长率下可能失效,因为真实世界存在计算、物理和顺序依赖限制。
所以这篇论文更像是在回答:
“如果几个强条件同时满足,后果会不会非常严重?”
而不是在回答:
“智能爆炸一定会在某个具体日期发生。”
12. 总结:RSI 的核心不是“AI 改自己”,而是“AI 改进 AI 的速度也在加快”
把整篇论文压缩成几句话:
- RSI 指的是 AI 参与改进自身或下一代 AI,而且改进后的系统更擅长继续进行 AI 改进。
- RSI 不等于 AI coding,也不等于 AI 已经能完全自主研发模型。
- 如果 AI 能够自动化越来越多的 AI R&D,AI 就可能形成一个扩大的有效研发 workforce。
- 如果这个 workforce 产生更强的 AI,系统就会形成正反馈。
- 当研发回报超过收益递减时,AI progress 的增长速度可能不断上升,最终表现为 intelligence explosion。
- 目前的证据还不够证明智能爆炸已经开始,但 AI R&D 自动化的速度已经快到值得政府和公司提前准备。
这篇论文最重要的提醒不是“明天 AI 就会接管世界”,而是:
一旦 AI 开始参与制造下一代 AI,过去那种“每隔几年发布一个新模型”的时间尺度,可能不再适用。
届时真正稀缺的,可能不只是 GPU、数据和研究员,而是人类能不能及时看懂发生了什么、能不能在必要时踩刹车,以及制度能不能跟上技术变化的速度。
顺带提一句,RSI 这篇文章和 AutoML、LLM 压缩、模型架构搜索之间有一条很直接的联系:它们都在讨论如何把原本依赖人类经验的模型设计、训练和优化流程自动化。《动手学 AutoML:从 NAS 到大语言模型优化实战》里正好系统整理了 NAS、搜索策略、架构评估、LLM 压缩和 LLM 驱动 AutoML 这些相邻问题。RSI 讨论的是更宏观的反馈回路,而书里的内容更偏具体方法和工程实现,感兴趣的话可以从这些可落地的局部自动化环节开始理解。
