arXiv'26 | Mega-ASR:用可组合声学增强和分阶段训练把 ASR 带进真实世界
arXiv’26 | Mega-ASR:用可组合声学增强和分阶段训练把 ASR 带进真实世界
原文:Mega-ASR: Towards In-the-wild^2 Speech Recognition via Scaling up Real-world Acoustic Simulation
1. 前言:ASR 真正难的不是“听清楚”,而是现实环境会同时把声音改坏
现在的 automatic speech recognition(ASR,自动语音识别)在干净语音上已经非常强了。常见 benchmark 上的 WER 已经可以做到几个百分点甚至更低。
WER 是 word error rate,也就是把模型输出改成标准答案需要多少次词级别的替换、删除和插入,再除以标准答案的词数;越低越好。
但把麦克风从实验室搬到现实世界,事情马上变味:
- 人在远处说话,直达声变弱,同时混进房间混响;
- 隔着门、墙、玻璃或者口罩,声音的高频细节被滤掉;
- 录音设备带来带宽限制、削波、失真和底噪;
- 网络传输丢帧,局部语音被重复或者直接变成静音;
- 这些问题还不是单独出现,而是可能同时发生。
结果就是,模型不只是把几个词听错,而是会出现空输出、整句遗漏、语言模型凭常识“编”出一段听起来很流畅但和音频无关的文字。
这正是 Mega-ASR 想解决的问题。它的核心判断很直接:如果训练数据只覆盖“加一点噪声”“做一次混响”这种孤立扰动,模型学到的就不是现实环境,而是一堆互相独立的 augmentation recipe。
所以这篇工作做了两件事:
- 构造一个包含 7 类基本声学现象、54 类复合场景的
VOICES-IN-THE-WILD-2M; - 在 Qwen3-ASR-1.7B 上做 acoustic-to-semantic 的渐进式训练,再用针对 ASR 错误模式设计的 RL reward 收尾。
最后的模型叫 Mega-ASR。论文报告,在 CHiME-4、VOiCES 和 NOIZEUS 这三个噪声/远场 benchmark 上,平均 WER 从 Qwen3-ASR 的 7.93% 降到 6.70%;在 NOIZEUS 的 0 dB 极端噪声条件下,WER 从 23.97% 降到 19.80%。
2. 数据集先从“现实世界的声学词汇表”开始
2.1 为什么不直接到网上抓 200 万条真实录音?
构造真实世界语音数据,大致有两条路:
- 到网上找各种真实视频、会议、街道录音,再人工清洗和标注;
- 从干净语音出发,用可控的 signal processing 模拟现实声学环境。
第一条路的问题是贵,而且很难规模化。你很容易收集到很多“有噪声的语音”,但很难保证它覆盖了远场、遮挡、回声、设备失真、丢包等各种组合,更难保证每条音频的 transcript 质量一致。
Mega-ASR 选择第二条路:干净语音负责提供 transcript,声学模拟负责制造环境。
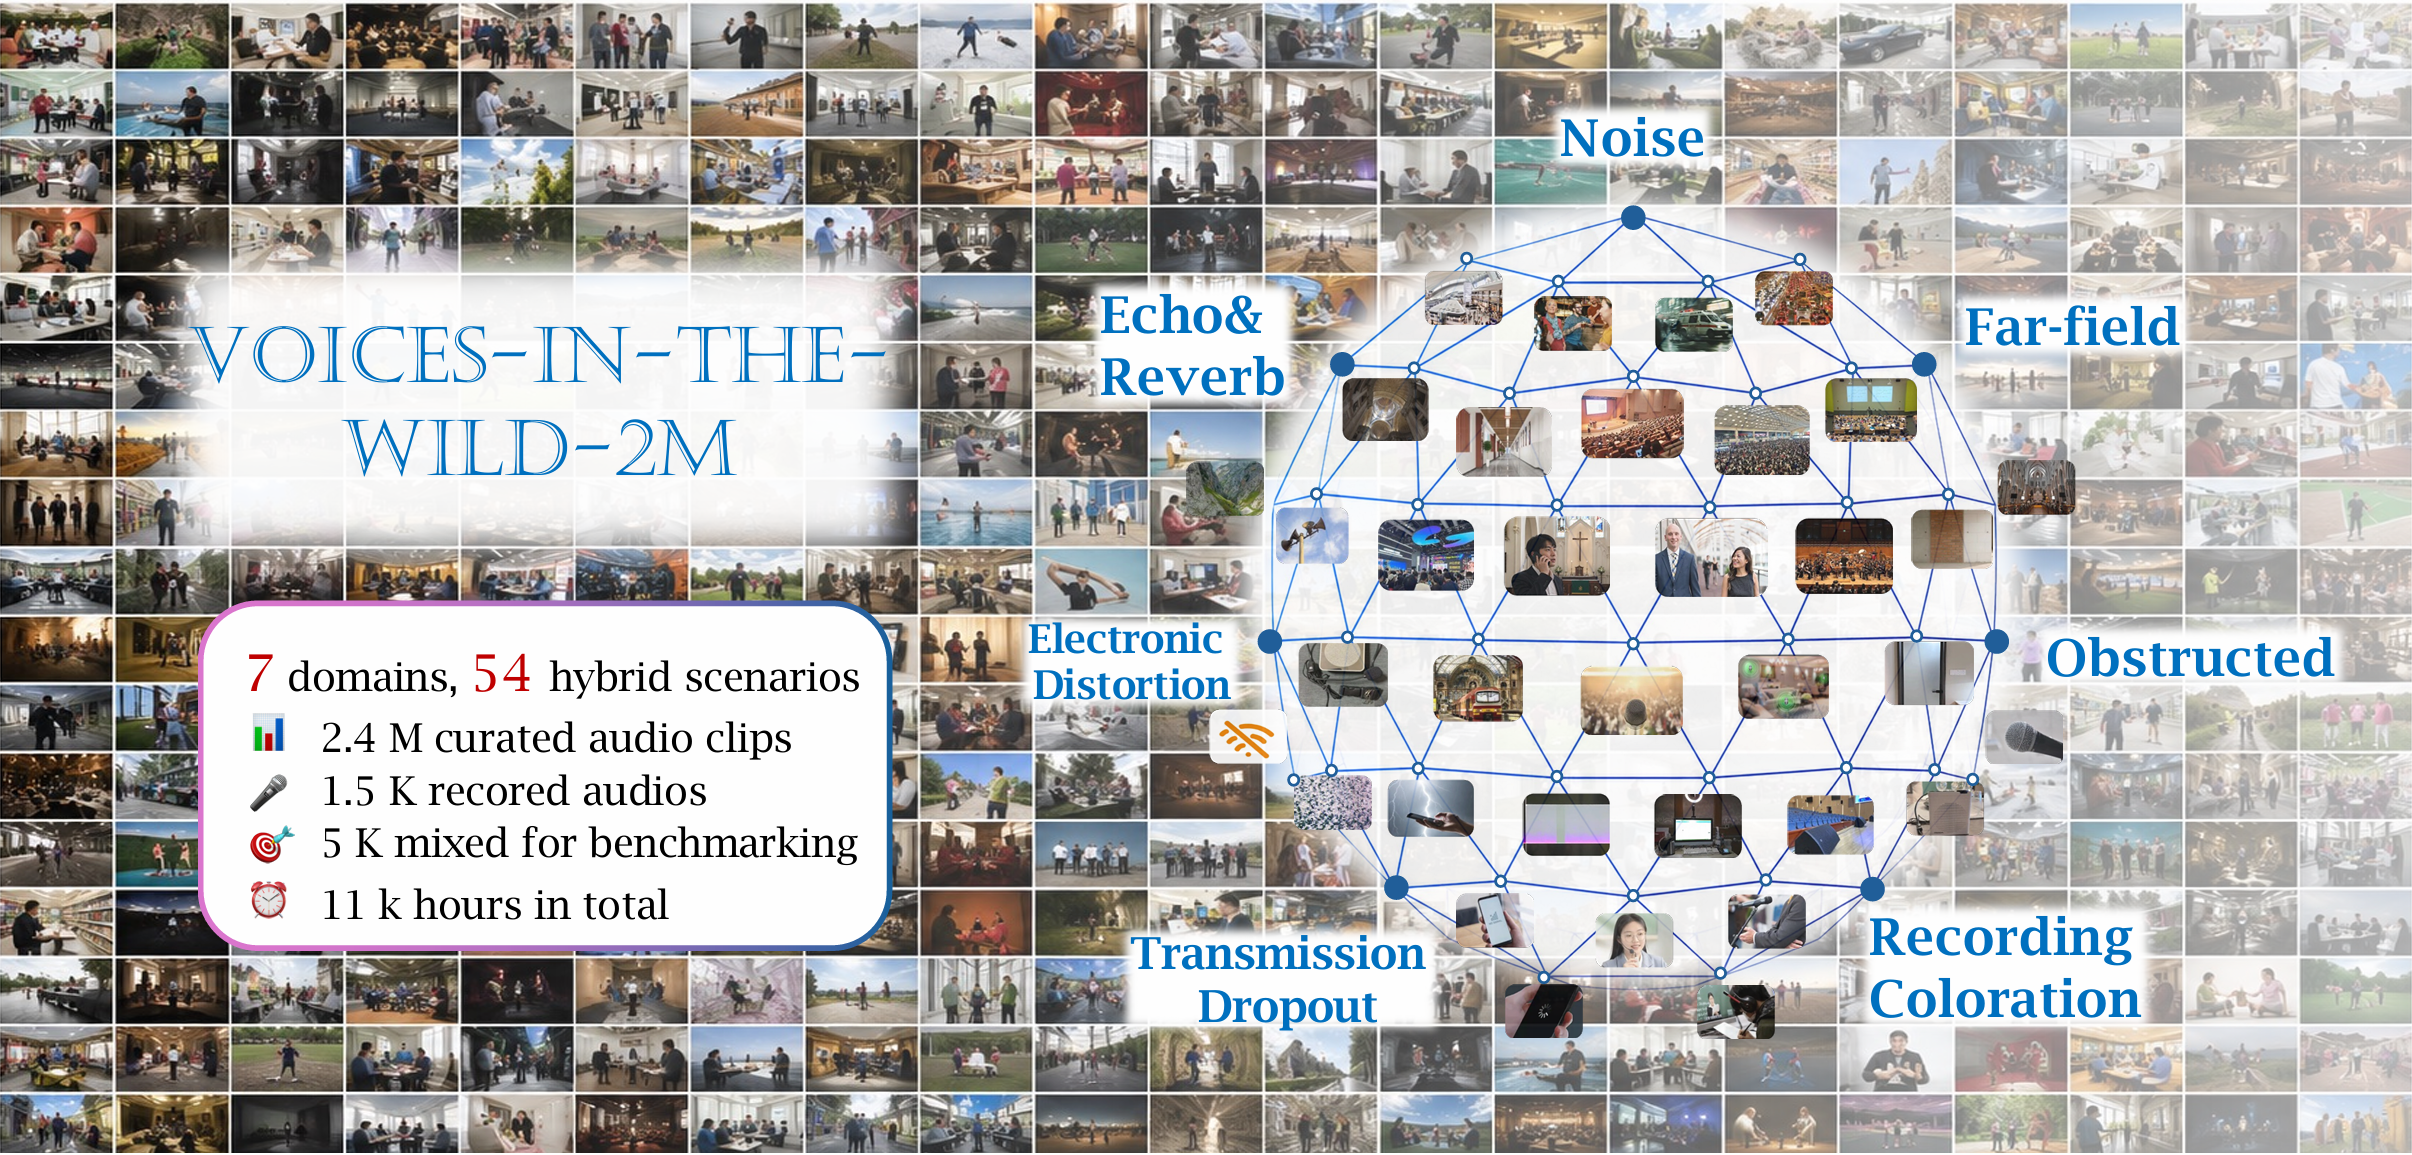
论文使用的干净语音来源包括 LibriSpeech、Common Voice、WenetSpeech 和 AISHELL-1;噪声和环境素材来自 MUSAN、DNS Challenge、ESC-50、UrbanSound8K 等数据。最终的 VOICES-IN-THE-WILD-2M 包含:
- 2.4M 条 curated audio clips;
- 约 11k 小时音频;
- 7 类 atomic acoustic effects;
- 54 类复合场景。
除此之外,作者还构造了 Voices-in-the-Wild-Bench:总共 5,000 条评测音频,其中 3,500 条是合成数据,1,500 条是真实录音,覆盖英文和普通话。真实录音来自互联网和 16 位参与者,专门用来检查“在合成数据上学到的东西能不能迁移到真音频”。
下面这张图比较直观:左边是大量真实世界的场景素材,右边是 7 个声学 effect 以及它们组合出来的环境空间。
2.2 七类 atomic effect 不是七个简单的开关
论文把现实中的声学现象归纳成七个较高层的 effect:
-
noise:背景噪声; -
far-field:远场语音; -
obstructed:被墙、门、玻璃、口罩等遮挡; -
echo&reverb:强回声和混响; -
recording coloration:播放-录音链路造成的设备染色; -
electronic distortion:过载、削波和非线性失真; -
transmission dropout:传输过程中的丢帧、重复帧和局部断裂。
但每一个 atomic effect 背后又由多个更底层的 primitive operation 组成。论文列出了 8 个基本操作:
- additive noise:把外部噪声按目标相对音量混进语音;
- echo delay:加入带延迟和 feedback 的重复语音;
- reverberation:模拟密集的房间反射;
- nonlinear distortion:模拟过载、饱和和 clipping;
- resampling:先降采样再升采样,制造带宽损失;
- spectral filtering:做 low-pass 或 high-pass filtering;
- loudness transformation:调整目标 LUFS,模拟距离衰减和增益不匹配;
- frame-level stutter:按 frame 重复上一帧或者替换成静音,模拟丢包和传输抖动。
这里的关键不是“操作越多越好”,而是每个现实场景要有一个合理的 processing chain。例如:
far-field = reverb → low-pass filter → volume attenuationobstructed = low-pass filter → reverb → volume attenuationecho&reverb = reverb → high-pass filter → echo delay → volume attenuationrecording coloration = resampling → noise → high-pass → low-pass → volumetransmission dropout = frame stutter → volume
这样造出来的远场语音,不只是简单地把音量调小;它同时拥有距离导致的能量衰减、房间反射和高频损失。隔着墙的语音也不只是加一层低通滤波,还会带上遮挡环境中的混响。
这比在 waveform 上随机调用几个 augmentation API 更接近“场景建模”。
2.3 复合场景怎么枚举:anchor + modifier
现实环境里,不同 effect 的角色不一样。Mega-ASR 把七类 atomic effect 分成两组:
- anchor effect:
far-field、echo&reverb、obstructed; - modifier effect:
recording coloration、electronic distortion、noise、transmission dropout。
anchor 决定主要的声学几何。比如远场、强回声和隔墙语音,本质上描述了三种不同的传播路径,所以它们不会直接互相叠加。
modifier 更像是可以到处附着的“现实世界副作用”:远场可以同时有噪声,隔墙语音可以同时经过低质量录音设备,任何场景都可能遇到传输丢帧。
于是 54 类场景这样得到:
- 7 个单 effect 场景;
- 18 个双 effect 场景;
- 13 个三 effect 场景;
- 16 个更高阶场景。
计算过程是:
\[7 + (3\times4 + {4\choose2}) + (3\times3 + {4\choose3}) + \left(3\times{4\choose3}+1+3\right)=54\]例如:
far-field + noiseecho&reverb + recording colorationobstructed + noise + transmission dropoutfar-field + noise + recording coloration + electronic distortion + transmission dropout
这种组合不是无脑笛卡尔积。作者还加入了 agentic check,过滤掉物理上明显不合理的组合。
更细的一点是,组合多个 atomic effect 时,论文会合并它们内部的 primitive chain:保留每个场景内部的顺序,同时删除跨场景重复的 primitive operation,只有 additive noise 允许重复。因为现实里确实可能同时存在街道噪声、人声噪声和设备噪声。
这个细节很重要。否则如果简单把多个 effect 的操作列表首尾相接,就可能出现一条完全不符合物理直觉的处理链。
2.4 难度不是每个 effect 各自随机,而是共享一个 global severity
如果每个 effect 的参数都独立随机,容易生成这种奇怪样本:
- 混响强到像教堂,但背景噪声几乎没有;
- 丢帧已经非常严重,录音却还保持着接近 CD 的带宽;
- 高频滤波极重,但音量又像近距离讲话。
为了让一条样本内部的难度保持一致,Mega-ASR 先采样一个全局变量 $x\sim U(0,1)$,再映射到统一的 severity $m\in[0,1]$:
\[m=f(x)\]论文比较了四种 $f(x)$:
- Linear:$m=x$,难度均匀覆盖;
- Sqrt Forward:$m=\sqrt{x}$,更多采样困难样本;
- Sqrt Backward:$m=x^2$,更多采样简单样本;
- Gaussian Mid:集中采样中等难度。
最终选择 Linear。原因不是它“最难”,而是它在 easy、medium、hard 三个区间之间取得了最好的 learnability 和覆盖平衡。
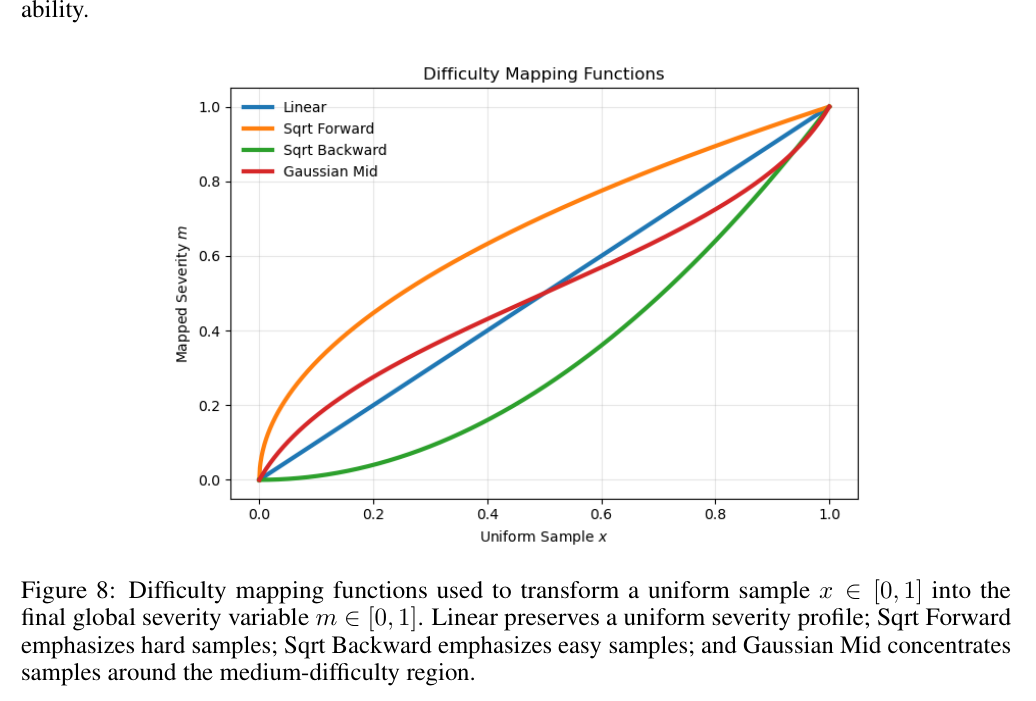
怎么读这张图:横轴是原始均匀变量 $x$,纵轴是映射后的 global severity $m$。橙色曲线会更快进入高难度区域,绿色曲线会把样本压在低难度区域,红色曲线则更偏向中间难度。蓝色 Linear 看起来最朴素,但实验证明它最适合后续训练。
然后,同一个样本中的所有 primitive 参数都共享这个 $m$。比如 $m$ 变大时,可以同时意味着:
- reverberation 的 wet level 变大;
- low-pass cutoff 变低;
- distortion drive 变大;
- target loudness 变低;
- stutter probability 变高。
最后再用 Qwen3-ASR 的 WER 检查 learnability,把 WER 超过 70% 的样本过滤掉。这里的 WER 不是评测时才计算,而是被用来控制训练样本难度:太难的样本不是越多越好,完全听不出内容时,监督信号反而会变得不稳定。
3. 模型结构:不是重新造一个 ASR,而是给 Qwen3-ASR 接上三套可训练能力
3.1 Mega-ASR 具体改了 Qwen3-ASR 的哪些部分?
基座是 Qwen3-ASR-1.7B。除去 Qwen3-ASR 自己原本的结构,Mega-ASR 主要做了三类改动:
- 对 audio encoder 的 attention 和 feed-forward 层挂 LoRA;
- 对 audio-text aligner,也就是把音频表征投到语言模型输入空间的 projection/convolution 模块挂 LoRA;
- 对 LLM 的 attention projection 和 MLP projection 挂 LoRA。
公开代码里的 LoRA target module 更具体:
- encoder:
audio_tower.layers.*里的q_proj/k_proj/v_proj/out_proj/fc1/fc2; - aligner:
audio_tower.conv_out/proj1/proj2; - LLM:
model.layers.*里的q_proj/k_proj/v_proj/o_proj/gate_proj/up_proj/down_proj。
也就是说,Mega-ASR 不是只训练语言模型,让 LLM 凭语言先验去猜;也不是只改 audio encoder,把所有问题都归咎于声学表征。它保留了三个可控的更新范围:
\[\text{audio encoder}\quad\rightarrow\quad\text{aligner}\quad\rightarrow\quad\text{LLM}\]训练时用 LoRA 做 parameter-efficient fine-tuning。LoRA 可以理解成不直接改动原始大矩阵,而是在旁边学习一个低秩增量,推理时再把增量合并或者动态加到 base weight 上。论文和公开脚本使用的典型配置是 rank $r=8$、LoRA alpha $=16$、dropout $=0.05$。
3.2 A2S-SFT:先让模型重新“听到”,再让它学会“补全”
A2S-SFT 的全称是 Acoustic-to-Semantic Progressive Supervised Fine-Tuning,也就是 acoustic 到 semantic 的渐进式 supervised fine-tuning。
它分三阶段:
Stage I:只训练 encoder + aligner
这一阶段的目标是重新建立可靠的声学接口。训练数据按 base model 的 WER 分三档扩大:
\[\text{WER}<30\%\quad\rightarrow\quad\text{WER}<50\%\quad\rightarrow\quad\text{WER}<70\%\]训练池里先抽取 30K 条 utterances 构造这个 curriculum。utterance 就是一段完整的语音片段,通常对应一条待识别的话。
为什么不能一上来把所有高难度样本都喂进去?因为此时 audio encoder 还没有适应严重失真的输入,直接 joint training 很容易让后面的语言模型先学会“猜”,而不是先把声学证据提取稳定。
Stage II:冻结声学侧,只训练 LLM
这一阶段使用完整 targeted split,冻结 encoder 和 aligner,只更新 LLM-side LoRA。
目标是让语言模型学会在声学证据不完整时做 sentence-level semantic recovery。但这里的“semantic recovery”不是鼓励模型自由发挥,而是让它在已有音频证据的约束下,恢复被噪声、混响和丢帧破坏的句子。
Stage III:三部分 joint fine-tuning
最后同时更新 encoder、aligner 和 LLM,让声学表示和语义解码重新对齐。
这一阶段 encoder 和 aligner 的学习率比 LLM 更小,目的很明确:保留 Stage I 好不容易学到的 acoustic grounding,不要在 joint training 中被语言侧梯度冲掉。
训练流程可以概括成下面这张图。
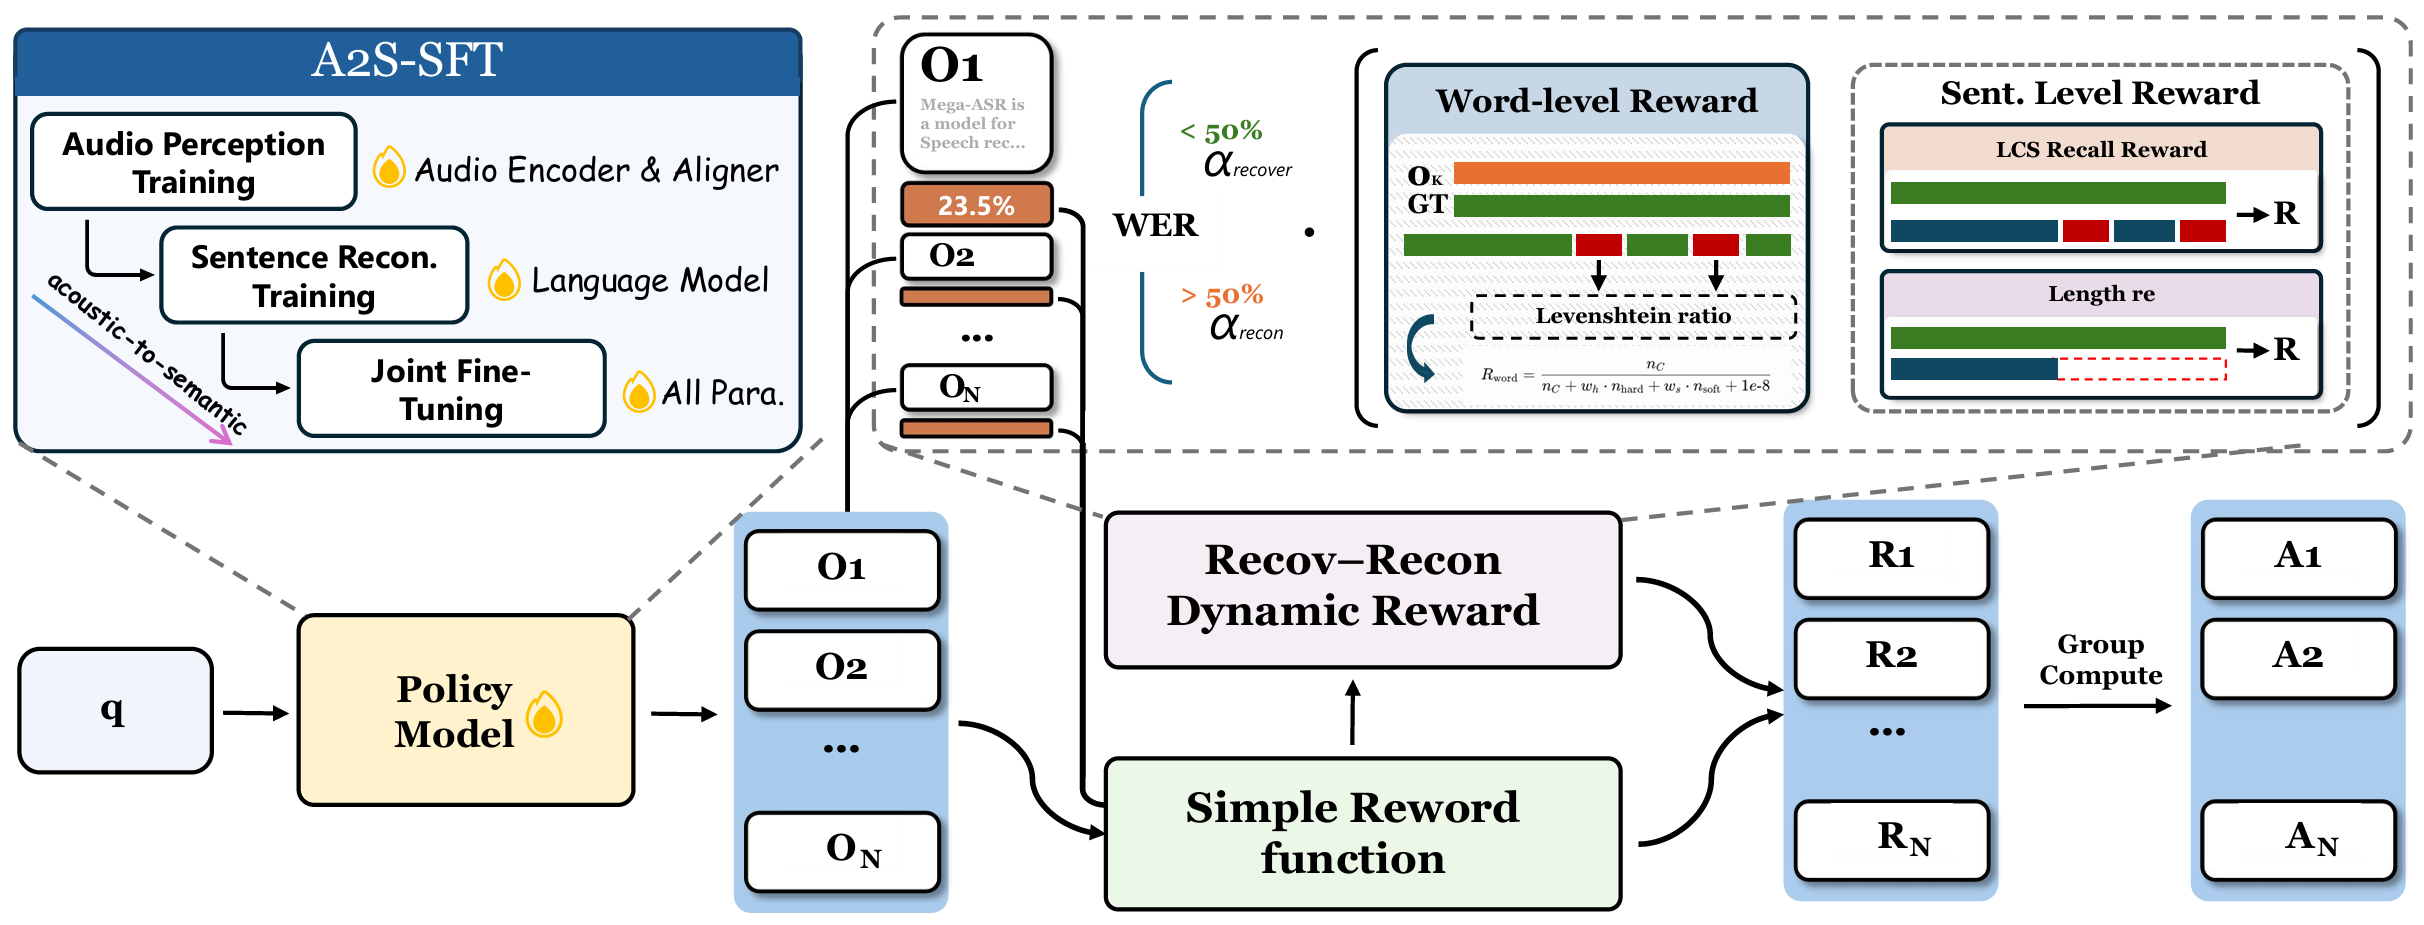
图的左上角是 A2S-SFT:先做 audio perception training,再做 sentence reconstruction training,最后 joint fine-tuning。右边进入 DG-WGPO 后,每个 prompt 会生成多条候选 transcription,再分别计算 word-level reward 和 sentence-level reward。
3.3 DG-WGPO:WER 低时修词,WER 高时保住整句话
DG-WGPO 的全称是 Dual-Granularity WER-Gated Policy Optimization。它建立在 DAPO-style policy optimization 上,使用 group-relative 的 advantage:同一个输入采样出多条候选结果,再比较它们在组内的相对 reward。
为什么还要再做 RL?
因为随着输入变难,ASR 的错误模式会发生变化:
- 中等难度时,通常是某几个词、实体或者音节听错;
- WER 很高时,模型可能直接空输出、漏掉半句话,或者生成一段完全 off-audio 的内容。
这两种错误不能用同一种 reward 处理。
第一层:static reward 负责守住 WER 和反重复
最基本的 WER reward 是:
\[R_{\mathrm{wer}}(H,R)=1-\mathrm{WER}(H,R)\]其中 $H$ 是 hypothesis,$R$ 是 reference。
另外增加 repetition gate。如果输出里出现重复 n-gram,直接把 reward 置零,避免模型通过重复少量 token 获得虚假的覆盖率。
第二层:token-level refinement reward
对于 substitution error,作者按照字符级 edit similarity 把错误分成 soft error 和 hard error:
- soft error:预测词和标准词形近,可能只是局部声学混淆;
- hard error:两者差异很大,更像是严重误识别;
- insertion 和 deletion 统一视为 hard error,因为它们通常意味着幻觉或者漏识别。
对应的 refinement reward 是:
\[R_{\mathrm{fine}} = \frac{n_C} {n_C+n_{\mathrm{hard}}+\alpha_s n_{\mathrm{soft}}+\epsilon}\]其中 $n_C$ 是正确 token 数量,$\alpha_s$ 是 soft error 的折扣系数。默认 $\alpha_s=0.4$,也就是对“差一点点”的错误保留更细的梯度信号。
第三层:sentence-level reconstruction reward
当输出已经严重偏离 reference 时,逐词比较会变得不太有用。这时作者引入 sentence-level reward,主要看两件事:
- hypothesis 和 reference 的 LCS,也就是最长公共子序列,用来衡量句子骨架保留了多少;
- 输出长度和 reference 长度是否相近,用来惩罚大段截断和无止境生成。
因此它更关心“这句话的大体结构还在不在”,而不是每个词是不是刚好对齐。
第四层:用 WER gate 动态切换两种粒度
最终 dynamic reward 不是固定比例,而是根据 WER 做 mirrored fusion:
\[R_{\mathrm{dynamic}}= \begin{cases} 0.75R_{\mathrm{fine}}+0.25R_{\mathrm{struc}}, & \mathrm{WER}<\tau\\ 0.25R_{\mathrm{fine}}+0.75R_{\mathrm{struc}}, & \mathrm{WER}\ge\tau \end{cases}\]直觉很简单:
- WER 较低,模型已经基本听懂了,重点是把局部词修准;
- WER 较高,先别纠结每一个 token,重点是避免空输出、语义漂移和长度失控。
最后把 static reward 和 dynamic reward 混合:
\[R=(1-\alpha_{\mathrm{dyn}})R_{\mathrm{static}} +\alpha_{\mathrm{dyn}}R_{\mathrm{dynamic}}\]主文给出的配置是 $\tau=0.3$、$\alpha_s=0.4$、$\alpha_{\mathrm{dyn}}=0.6$。
这个设计里真正值得注意的不是“用了 RL”,而是 reward 的粒度跟着错误模式变化。很多 speech RL 方案最后退化成一个 WER scalar,模型只知道结果好不好,却不知道是该修一个词,还是该把整句话重新组织起来。
4. 推理时再加一个 router,避免鲁棒性和干净语音能力互相伤害
在严重退化数据上训练,通常会带来一个副作用:模型的 noise robustness 变强了,但 clean speech、hotword 和 streaming 等能力可能略有回退。
Mega-ASR 的做法不是永远使用 robust adapter,而是加一个 environment-aware router:
- clean audio → 使用原始 Qwen3-ASR 权重;
- degraded audio → 激活 Mega-ASR 的 LoRA delta。
router 本身不是 ASR 模型,它只负责判断输入是否需要 robust branch。
论文表格给出的结构是 80 维 log-Mel 输入、轻量卷积前端、单层 Transformer、attention pooling 和 binary classifier。公开代码里可以看到更具体的实现:输入音频统一到 16 kHz,先过两个 stride=2 的 Conv1d,再进一个 Transformer encoder,最后用 attention pooling 汇聚成 utterance-level embedding。
这里有一个复现时要注意的版本差异:
- 论文 Table 18 写的是 hidden dimension 128、feed-forward dimension 256、temporal downsampling 2×;
- 当前公开代码的默认实现是 hidden dimension 192、feed-forward dimension 512,两个 stride=2 卷积带来 4× 时间下采样。
所以如果要严格复现 router,应该优先以代码 checkpoint 里的 config 为准,而不是只抄论文表格。
router 的训练数据是:
- 552,651 条 clean speech,来自 LibriSpeech、AISHELL-1、CommonVoice22 和 WenetSpeech;
- 674,107 条 degraded speech,来自 VOICES-IN-THE-WILD-2M;
- train/validation/test 分别是 1,104,084、61,337、61,337 条。
开发集二分类准确率超过 99.5%。推理时的阈值是 degraded probability $\ge 0.5$ 就走 Mega-ASR branch。
更妙的是,它不需要同时加载两个完整模型。公开实现会预先计算 LoRA delta,推理时对 base weight 做加法或减法来切换状态。CHiME-4 上,直接 Qwen3-ASR 用时 374 秒,带 router 和 LoRA delta switch 用时 371 秒,论文报告相对差异为 -0.8%,基本可以看作没有额外开销。
5. 训练细节:真正落地时最容易踩坑的地方
5.1 A2S-SFT 的主配置
论文 appendix 给出的逐阶段配置如下:
- 2 张 GPU;
- per-device batch size = 8;
- gradient accumulation = 8;
- effective batch size = $8\times2\times8=128$;
- Stage I / II / III 的 epoch 分别为 2 / 1 / 1;
- Stage I encoder 和 aligner learning rate 为 $1\times10^{-6}$;
- Stage II LLM learning rate 为 $1\times10^{-6}$;
- Stage III encoder、aligner learning rate 为 $5\times10^{-7}$,LLM 为 $1\times10^{-6}$;
- warmup ratio 分别为 0.05、0.05、0.03;
- weight decay = 0.01;
- maximum gradient norm = 1.0;
- LoRA rank = 8,alpha = 16,dropout = 0.05;
- 每 200 steps 保存 checkpoint。
中间阶段保存 adapter-only checkpoint,最后阶段可以保存 merged adapter,方便后续推理。
公开代码里还把 LoRA scope 做成了可选项:
encoder
aligner
encoder_aligner
encoder_b4_aligner
llm
all
这个设计很适合做 ablation。比如只训 LLM,可以观察模型是不是在依赖 language prior;只训 encoder-aligner,可以观察声学 grounding 提升了多少;三阶段全走,才是论文主线。
5.2 DG-WGPO 的主配置
appendix 里列出的 main run 是:
- 从 A2S-SFT merged checkpoint 初始化;
- 3 张 GPU;
- per-device batch size = 4;
- gradient accumulation = 16;
- effective prompt batch size = $4\times3\times16=192$;
- 每个 prompt 采样 12 个 completion;
- maximum completion length = 256 tokens;
- learning rate = $5\times10^{-5}$;
- cosine decay,warmup ratio = 0.03;
- KL coefficient $\beta=0.04$;
- DAPO upper clipping parameter = 0.28;
- RL iterations = 2;
- dynamic sampling 开启,最大重采样 4 次;
- overlong filtering 开启,超长样本直接删除;
- temperature = 0.50;
- top-p = 0.95;
- top-k = 50;
- repetition penalty = 1.08。
温度设成 0.50 也不是拍脑袋。温度过低,12 个候选几乎一样,组内 advantage 没有区分度;温度过高,又容易出现幻觉、重复和超长输出。作者比较了 0.3、0.5、0.7、0.9,最后选择 0.5 做探索和 ASR 格式稳定性的折中。
不过这里必须把论文内部的配置差异说清楚:正文的 Implementation Details 还写过 RL 6,000 steps、$K=16$、learning rate $1\times10^{-6}$ 的另一组配置,而 appendix 的 main run 是上面这组 $K=12$、$5\times10^{-5}$、3-GPU 设置。要复现结果,不能把正文和 appendix 的数字拼成一套不存在的配置,最好以作者最终代码和 checkpoint 的训练记录为准。
6. 结果说明了什么?
6.1 鲁棒性提升不是以干净语音崩掉为代价
在噪声和鲁棒性 benchmark 上,结果大致如下:
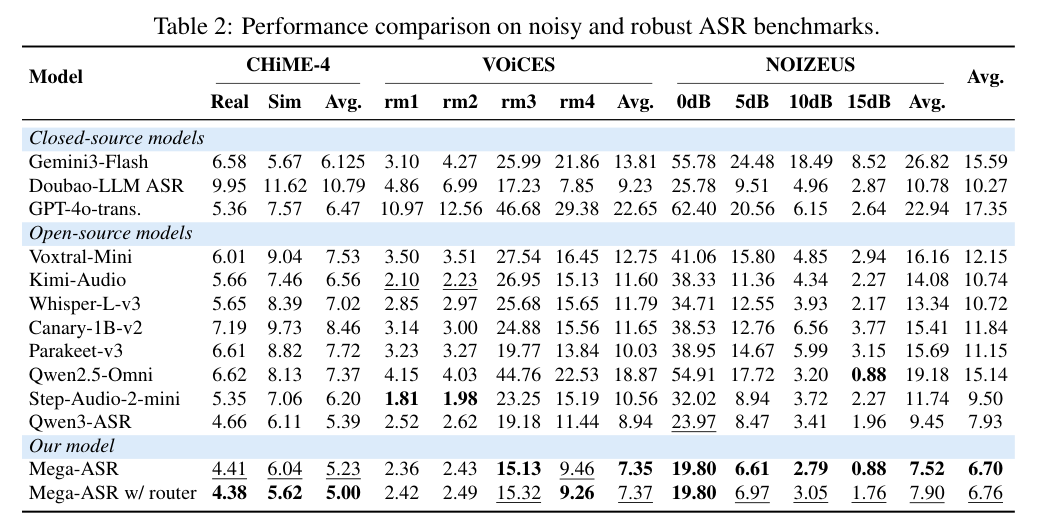
Qwen3-ASR 的整体平均 WER 是 7.93%,Mega-ASR 降到 6.70%。在 NOIZEUS 0 dB 条件下,Mega-ASR 是 19.80%,Qwen3-ASR 是 23.97%。
在标准 ASR benchmark 上,Mega-ASR 本体有一些 clean-domain 波动,所以作者提供了 router 版本,把干净语音交回 base branch。router 版本在 LibriSpeech、FLEURS、WenetSpeech 和 VoxPopuli 上基本恢复甚至略好于原始模型。
6.2 复合场景上的收益更明显
在 Voices-in-the-Wild-Bench 的 mixed degradation 场景上,Mega-ASR 的真实录音/合成录音 WER 是 2.73/4.57,而 Whisper-Large-v3 是 8.91/14.79。
这个结果比单纯的 noise benchmark 更有说服力,因为模型面对的是多种声学因素一起出现,而不是一个固定 SNR 的加噪任务。
6.3 指标下降之外,空输出和幻觉也确实减少了
LLM-as-judge 的分析里,Mega-ASR 相比 Qwen3-ASR:
- hallucination 从 18.7 降到 11.8;
- missed content 从 14.2 降到 5.9;
- semantic score 从 71.3 提升到 86.4。
这里的价值在于,Mega-ASR 不是只把 WER 的数字压低一点,而是减少了“模型说得很流畅,但根本不是音频里的内容”这种更危险的错误。
消融实验也支持这条结论:去掉 sentence-level reconstruction reward 后,性能下降比去掉其他组件更明显。说明在 medium/high-WER 样本上,模型确实需要一个“保住句子骨架”的信号,而不是继续把所有错误都当成 token-level substitution。
7. 总结:Mega-ASR 的核心不是更大的模型,而是把现实声学问题组织起来
这篇工作的贡献可以压缩成三句话:
- 数据层面:用 8 个 primitive operation 构造 7 个 atomic effect,再通过 anchor-modifier 规则组合成 54 个物理上合理的复合场景;
- 训练层面:先做 encoder-aligner 的 acoustic warm start,再做 LLM semantic adaptation,最后 joint fine-tuning;
- 优化层面:根据 WER 所处区间,在 token-level refinement 和 sentence-level reconstruction 之间动态切换 reward 粒度。
它最值得借鉴的地方,是没有把“鲁棒 ASR”简单等价成“多加点噪声”。真实世界的困难来自多个因素以结构化方式叠加,训练过程也必须对应这种结构:
- 数据要有场景;
- 难度要可控;
- 声学表征和语言先验不能同时乱跑;
- WER 低时修词,WER 高时先保住整句话;
- clean audio 和 degraded audio 最好不要强行用同一套权重处理。
当然,这个方案也有几个现实限制。首先,数据主要是合成的,虽然用真实录音 benchmark 做了验证,但合成器本身仍然决定了模型能看到哪些“现实”。其次,使用 Qwen3-ASR 的 WER 来筛选训练难度,可能会把数据分布和基座模型的错误模式绑定在一起。最后,论文正文、appendix 和公开代码之间存在若干配置差异,尤其是 router 结构和 DG-WGPO 超参数,复现时需要以代码和 checkpoint 为准。
但总体上,Mega-ASR 把一个经常被一句“做 data augmentation”带过的问题拆开了:什么是现实环境、怎么组合现实环境、样本到底难到什么程度、模型在不同难度下应该修什么。 这也是它能在真实复杂声学场景里超过单一噪声增强方案的原因。
顺带一提,数据增强、代理数据集和 LLM 后训练之间其实有一条很自然的连接:前面是在设计更适合训练的数据分布,后面是在设计更适合优化的模型更新信号。《动手学 AutoML:从 NAS 到大语言模型优化实战》里也专门整理了数据增强搜索、代理数据集、LLM 压缩和后训练优化这些相邻问题,感兴趣可以继续往这条线看。
