GitHub'26 | Laya:用 marker 把文本决策压进 BERT 一次 forward,本地平替闭源 Jev
GitHub’26 | Laya:用 marker 把文本决策压进 BERT 一次 forward,本地平替闭源 Jev
代码:NandhaKishorM/laya(本文对着 commit
6d942c9的源码读的)
1. Agent 里最高频、又最不起眼的一步,是「做个有限的决定」
先说个每天都在发生的场景。你在搭一个 Agent,跑到某一步它得拿个主意:这张工单派给 billing 还是 technical?这条消息算不算 phishing?这个动作要不要转人工?当前风险是 low、medium 还是 high?
这类决定有个共同点——答案空间是有限的,压根不需要模型「写」一段话出来,只要从几个给定选项里挑一个、或者打个分就行。
但现在的主流做法,是把这么个选择题塞给一个自回归 LLM:让它生成一段 JSON、或者「我建议派给 billing,因为……」,然后你在外面写正则/解析器把答案抠出来。这套流程别扭在哪,做过的人都懂:模型偶尔漏字段、偶尔把 JSON 写崩、偶尔多嘴解释一通;decode 又是一个 token 一个 token 蹦出来的,天然慢;更别说你还得把工单原文、内部文档发去一个 hosted API。
TypeSafe 家的 Jev 就是冲这个场景做的托管服务,可以把它理解成一个「System-1 决策 API」:给它一段状态文本和几个 typed 问题,它直接回你选择、分数、概率,不生成自由文本。这里的 System-1 不是心理学那个「快思考」的严格对应,只是借来形容「不慢慢推理、一步给结论」。
Jev 好用,但它闭源、跑在别人服务器上。Laya 就是那个开源、能塞进自己机器里跑的平替:权重自己拿着,推理在自己的 GPU / CPU 上完成,能用自己的数据 fine-tune,而且 HTTP 接口直接兼容 Jev 的 /v1/systemone,老的 Jev client 改个 baseUrl 就能接上。
真正有意思的问题在这儿:它不生成文本,那一个决定到底是怎么「算」出来的? 答案是个挺巧的小设计——给每个候选项前面插一个 marker,然后只读这些 marker 位置的向量。整篇文章就是把这个设计、以及围绕它的训练和评测,一层层拆开。
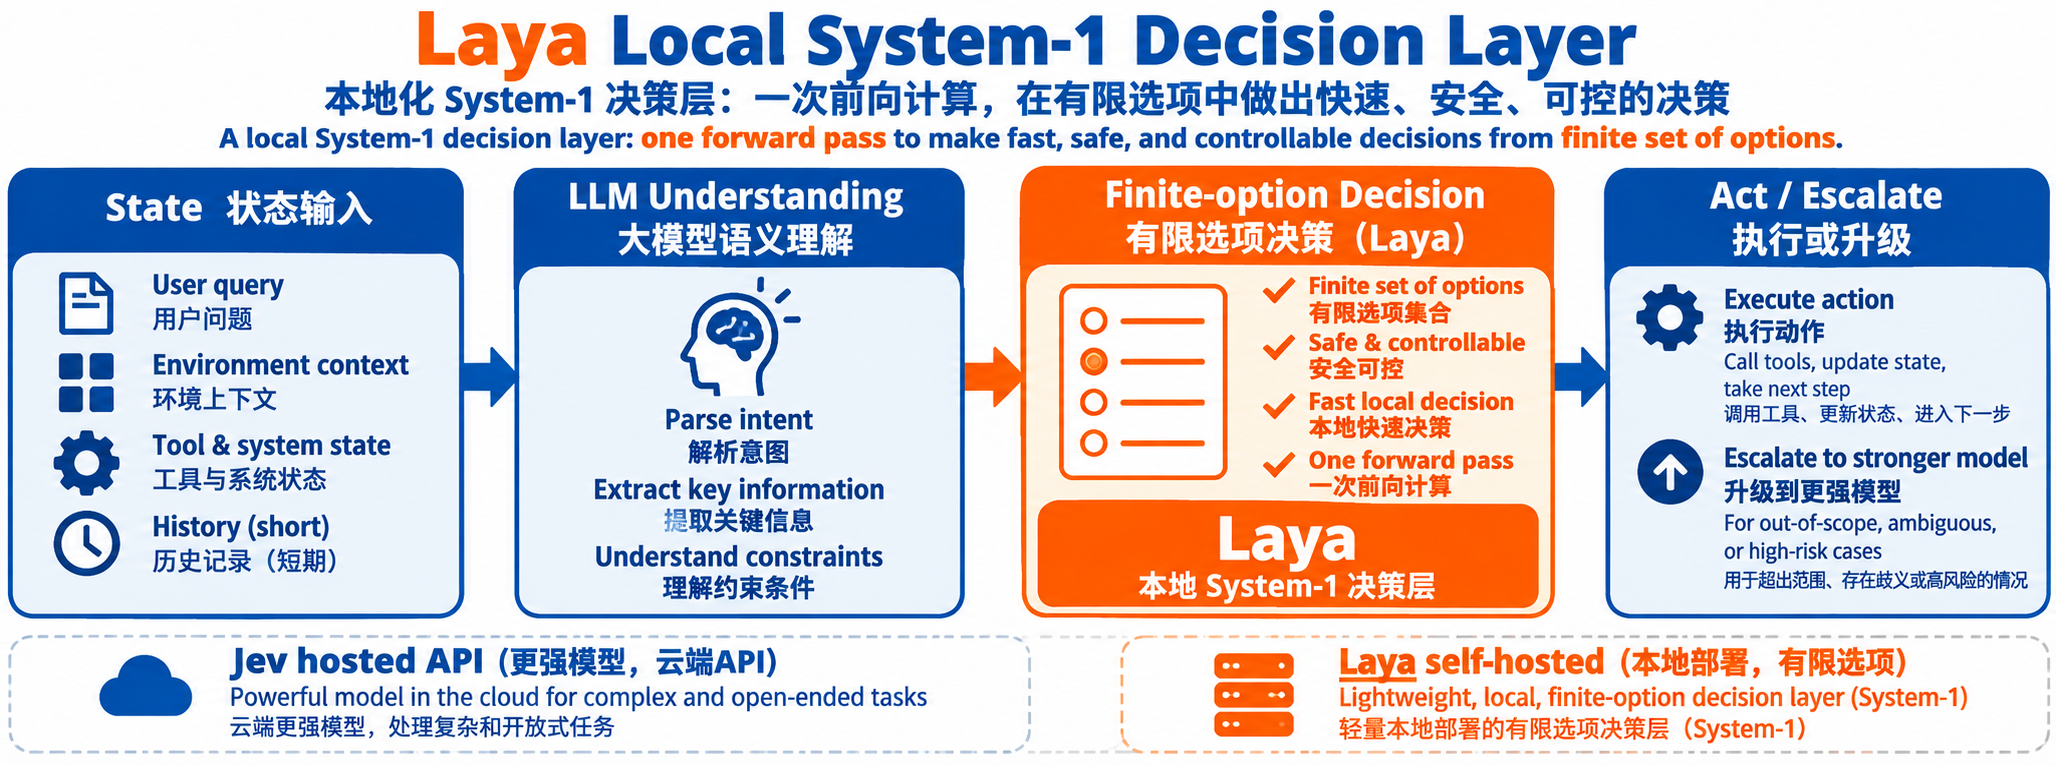
先打个预防针免得误会:Laya 对标 Jev,首先是协议和产品形态上的对标,不是把 Jev 那个闭源模型搬到了本地。 它的代码、训练流程、评测脚本都公开可读;而下文里出现的 Jev 数字,基本都是第三方公开跑的结果,不是在同一批输入上和 Laya 掰过手腕——这点后面会反复拎出来说。
2. Laya 对标的是 Jev 这一层,不是替代所有 LLM
拆模型之前得先框清楚 Laya 到底替代什么。它替代的不是「会聊天、会写代码」的通用 LLM,而是 Agent 里那层已经被约束成有限选项的决策。这层决策在 Jev / Laya 里被抽象成三种 typed 问题,一段状态上可以同时问好几个:
choice——从若干候选里挑一个。 你给一个 criteria(标签到描述的有序映射),模型给每个候选一个概率,choice 取概率最大的那个。
noul——是非题,但返回的是概率而不是布尔。 noul 是项目自己给 yes/no question 起的名字。它不直接回 True/False,而是回 $P(\text{true})$;阈值卡在 0.5、0.8 还是 0.95 由业务定,因为漏报和误报的代价往往不一样。
score——有序等级,返回期望值。 比如严重程度分五档,模型内部对 $K$ 个 level 各给一个概率,最终 score 是期望值:
所以 score = 2.9 不等于「模型选了第 3 档」,它是概率分布的期望位置;真正最可能的那一档还得看 $\arg\max_i p_i$。
这三种问题一次 forward 就能同时答完——这也是它跟自回归 LLM 的第一个根本区别:它不生成「我建议……因为……」,而是直接在固定的输出空间里算出一个决策分布。
至于「兼容 Jev」,laya/serve.py 暴露的就是 Jev 的 /v1/systemone 协议,响应里保留了 Jev client 会读的 answers / usage 字段;Jev client 继续发 model: "jev-1" 也不报错,Laya 认不出这名字,就当「没指定 checkpoint」自动路由。
但协议兼容只是请求/响应长得一样,有几样东西不能跟着一起搬过来:
- 候选数上限不同。 Jev 号称最多支持 255 个选项;Laya 的有效候选数被一个叫
head_max_len的 token 预算卡着,第 7 节会看到 77 个候选就已经开始崩了。 - 置信度公式不同。 Jev 的 confidence 是 $\frac{K p_{\max}-1}{K-1}$,Laya 的
confidence对choice/score是归一化熵——同一个阈值搬过去,含义完全变了。 - 概率默认没校准。 Laya 的
answer_confidence只有在自己的数据上重新做过 temperature scaling,才适合拿来当 gating 阈值。
一句话:把 Jev 的线上阈值原样贴到 Laya 上,是个挺危险的迁移。
3. 不生成文本,它靠给每个候选插一个 marker 来决定
Laya 的核心把戏说穿了很朴素:在每个候选项前面塞一个 [MASK] 标记位,最后只读这些标记位上的向量。
laya/common.py 里 build_sequence() 拼出来的序列长这样:
[CLS] <type> instructions [SEP] [MASK] opt0 [MASK] opt1 … [MASK] opt(K-1) [SEP] state [SEP]
这里的 [MASK] 特别容易让人误解成「模型在做 BERT 那种完形填空(masked language modeling),要预测这个位置该填哪个词」。不是的。 Laya 根本不关心 [MASK] 位置该填什么词,它把这个位置当成一个可以事后定位、取值的「插槽」:forward 完之后用 torch.gather 按记下来的位置,把这些槽的 hidden state 抠出来,送进打分头。
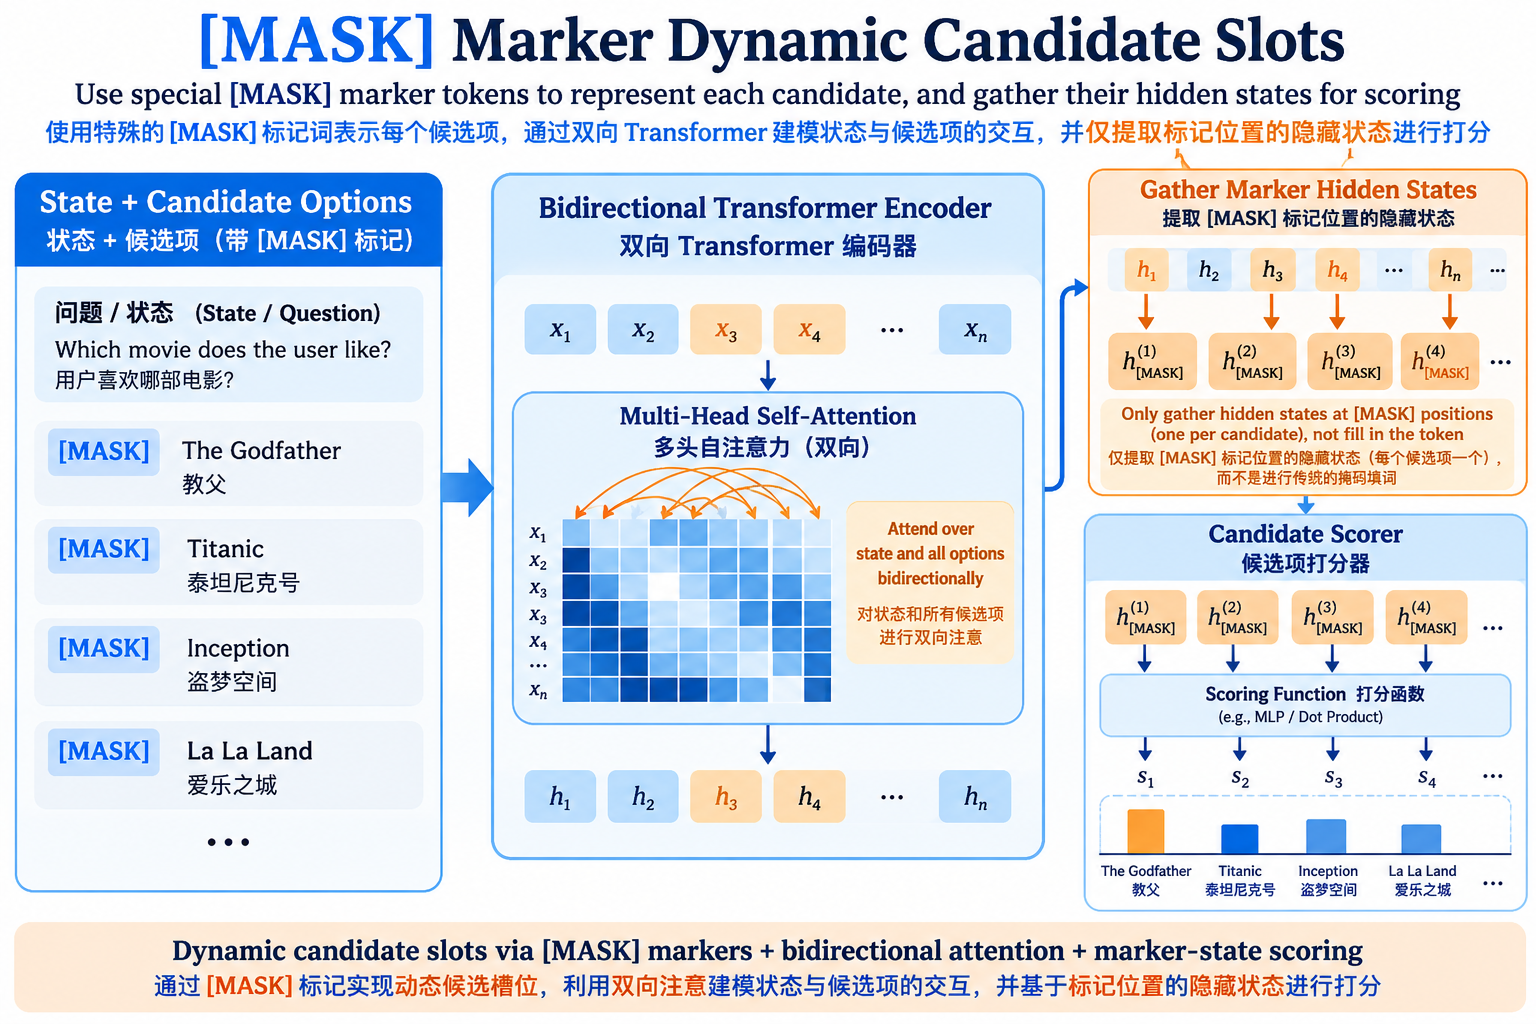
为什么这么设计管用?因为 encoder 是双向的。marker 这个位置在 attention 里能同时看到:问题类型、instructions、所有候选及其描述、还有最后那段 state。于是这个 marker 的输出向量,就不再是某个词的表示,而是「在这段 state 下,这个候选有多贴合」的打分依据。
对比一下就更清楚:普通的 sequence classification(序列分类)通常只取 [CLS] 一个向量,后面接一个类别数写死的分类器。但 Laya 不能写死类别数——每个请求的候选集合都可能不一样。所以它干脆把分类器的「类别槽位」动态摆到候选文本前的 marker 上:有几个候选,就有几个 marker,输出就有几维。
说人话:模型不是在一个固定词表上选答案,而是在输入序列里临时搭出候选槽位,再给每个槽打分。 整条链路长这样:
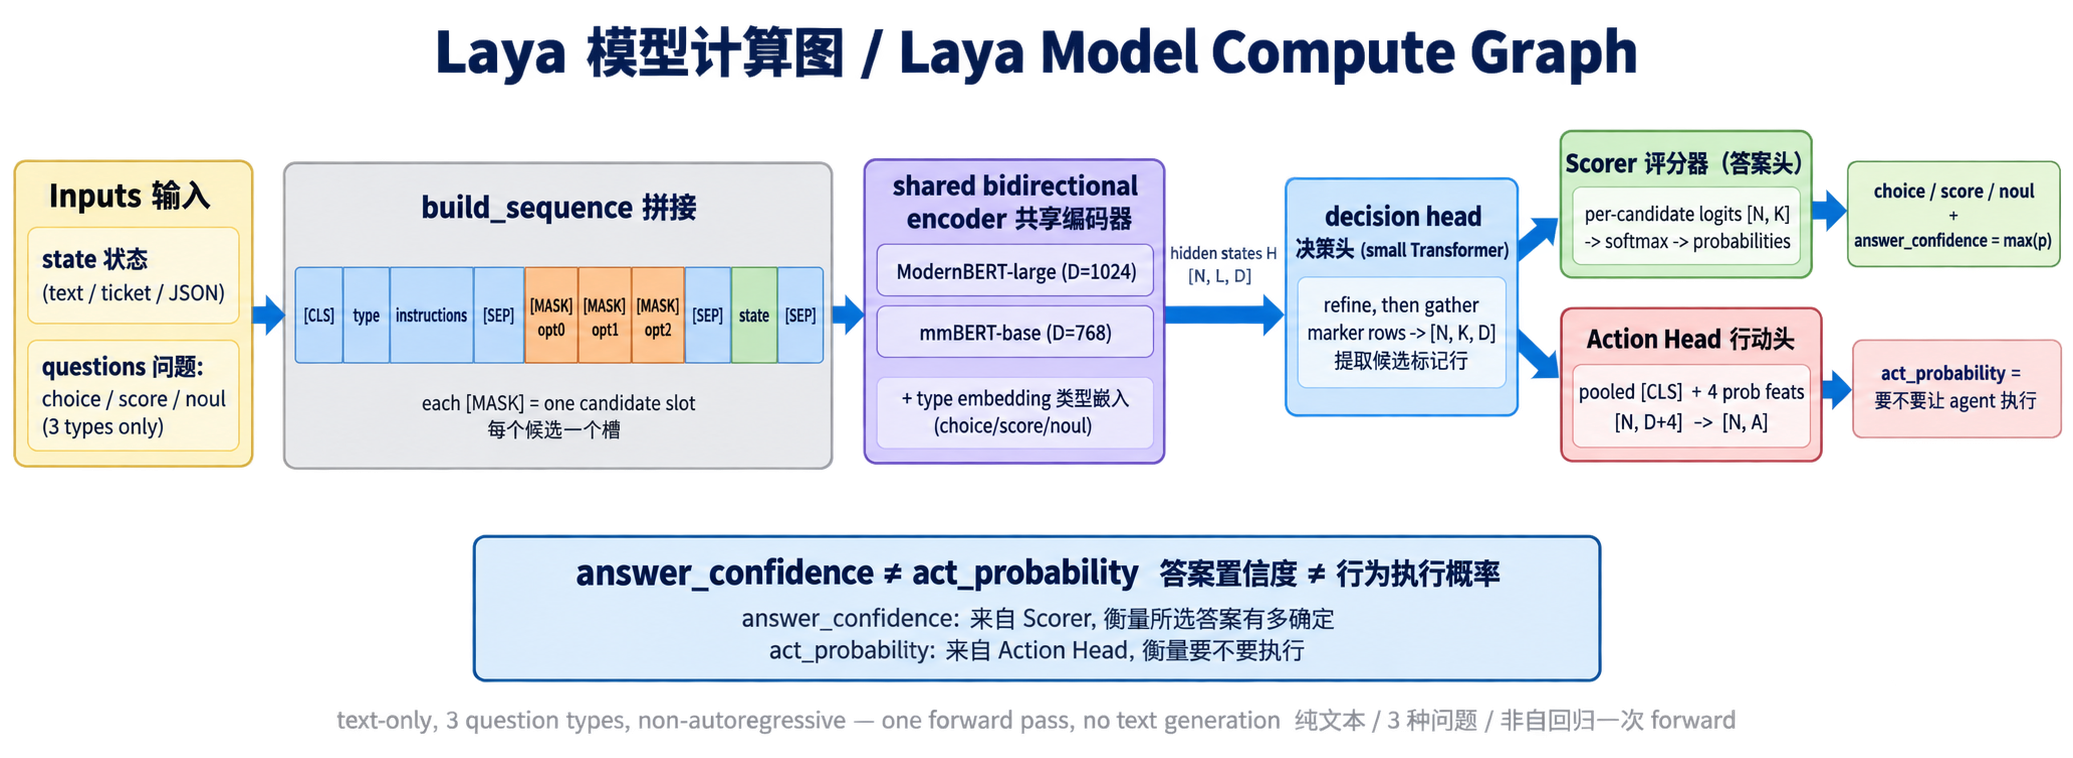
对着这张计算图从左往右看:state + 若干 typed 问题拼成一条带橙色 [MASK] 的 token 序列 → 共享双向 encoder 出每个位置的 hidden state → 决策头精炼后分两条出口:Scorer(评分器 / 答案头)把 marker 位置的向量捞出来打分、softmax 成候选概率,Action Head(行动头)另走一条支线判断「这个决定值不值得让 Agent 真去执行」。图右上角那句 answer_confidence ≠ act_probability 就是在提醒这两条出口量的是不同的事——下一节拆代码时会把它们彻底分清。注意全程没有一步在生成文本。
4. 从 init 到 forward:模块怎么搭、谁调用谁、维度怎么变
上一节看的是概念,这节把 DecisionModel 的 __init__ 和 forward 摆在一起看——__init__ 造出所有零件,forward 决定它们谁先谁后、怎么串。把工程细节(gradient checkpointing、meta device 初始化那些)删掉后,整段就这么长:
# laya/common.py — class DecisionModel(删繁就简版)
class DecisionModel(nn.Module):
    def __init__(self, encoder, head_layers=2, n_act=2):
        self.encoder  = encoder                    # 共享 backbone:ModernBERT / mmBERT
        D = encoder.config.hidden_size             # 1024 或 768
        nhead = max(1, D // 64)                    # 16 或 12 个注意力头
        self.head = TransformerEncoder(            # ① 精炼层(论文口径的 decision head)
            TransformerEncoderLayer(D, nhead, 4 * D, batch_first=True, norm_first=True),
            head_layers)
        self.type_emb = nn.Embedding(3, D)         # ② 类型嵌入:choice/score/noul 各一个
        self.scorer   = nn.Sequential(             # ③ 评分器(答案头):marker → 一个分
            nn.LayerNorm(D), nn.Linear(D, D), nn.GELU(), nn.Linear(D, 1))
        self.act_head = nn.Sequential(             # ④ 行动头:[CLS]+4特征 → 要不要动
            nn.Linear(D + 4, 256), nn.GELU(), nn.Linear(256, n_act))

    def forward(self, input_ids, attention_mask, marker_pos, marker_mask, qtype):
        h = self.encoder(input_ids, attention_mask).last_hidden_state   # [N,L,D]
        h = h + self.type_emb(qtype)[:, None, :]         # 注入「这行是哪类问题」
        h = self.head(h, src_key_padding_mask=~attention_mask.bool())   # 精炼,仍 [N,L,D]
        # —— 出口①:答案 ——
        idx    = marker_pos.clamp(min=0)[:, :, None].expand(-1, -1, h.size(-1))
        m      = torch.gather(h, 1, idx)                 # 只抠 marker 行 [N,K,D]
        logits = self.scorer(m).squeeze(-1)              # [N,K]
        logits = logits.masked_fill(~marker_mask, -1e4)  # padding 候选打成 -inf
        # —— 出口②:要不要动 ——
        p          = logits.softmax(-1)                  # 候选概率
        feats      = summarize(p)                        # 4 维:top1、top1-top2、熵、K/255
        act_logits = self.act_head(torch.cat([h[:, 0], feats], -1))     # [N,A]
        return logits, act_logits                        # 答案 logits + 行动 logits
4.1 谁是谁:五个零件先分清楚
__init__ 里就 5 个零件,forward 里的调用顺序也一目了然:encoder → 加 type_emb → head 精炼 → 然后分两条出口。别被「head」这个词绕晕——代码里带 head 字样的有好几个,先用一张表摆平:
| 模块 | __init__ 里是什么 | forward 里干嘛 | 产出 |
|---|---|---|---|
encoder | 共享 backbone(ModernBERT / mmBERT) | 把 token 编码成上下文向量 | h [N,L,D] |
type_emb | 一张 3×D 查找表(不是 head) | 加到 h 上,标明这行是 choice/score/noul | 还是 [N,L,D] |
self.head | encoder 之上的小 Transformer(论文口径的 decision head) | 再过几层 attention 精炼表示 | 还是 [N,L,D] |
scorer | LayerNorm→Linear→GELU→Linear→1 | 只读 marker 行,给每个候选打一个分 | logits [N,K] |
act_head | Linear(D+4→256)→GELU→Linear(256→A) | 读 [CLS] + 4 个概率特征 | act_logits [N,A] |
这张表能立刻消掉两个最常见的混淆:type_emb 不是 head,它是输入侧的一个标签,作用是让三类问题共用同一套 encoder+head,靠 QTYPES = {choice:0, score:1, noul:2} 区分谁是谁;self.head 也不是「出答案的头」,它只是 encoder 之上的精炼层,把表示再揉几遍,本身不产出任何答案。真正往外吐东西的,是最后那两条出口——scorer 和 act_head。
4.2 两个出口:一个出「答案」,一个出「要不要动」
最容易看懵的就是这儿:forward 结尾为什么 return logits, act_logits 两个东西?因为 Laya 的一次决策同时回答了两个不同的问题:
-
scorer(答案头)回答「选哪个 / 打几分 / 是不是」。 它把每个候选 marker 打成一个分,softmax 出候选概率——这才是choice/score/noul的答案。答案有多确定,用answer_confidence = max(p)衡量。 -
act_head(行动头)回答「这个决定值不值得让 Agent 真去执行」。 它不关心选了哪个候选,只看[CLS]的整体表示加上 4 个概率特征,输出一个act_probability。
所以「decision head / scorer / act_head」不是三个平级的分类器,而是「一条精炼层(self.head)+ 两条语义完全不同的出口(scorer / act_head)」。 这也正是那张计算图右上角红框反复强调的 answer_confidence ≠ act_probability:一个来自 scorer、量的是「答案有多确定」,一个来自 act_head、量的是「要不要动手」,来源不同、含义不同,别拿同一个阈值去卡这两个数。
4.3 forward 一路走下来,维度从 [N,L] 变到 [N,A]
forward 里每一步的形状怎么变,配着下面这张维度流转图看最直观:
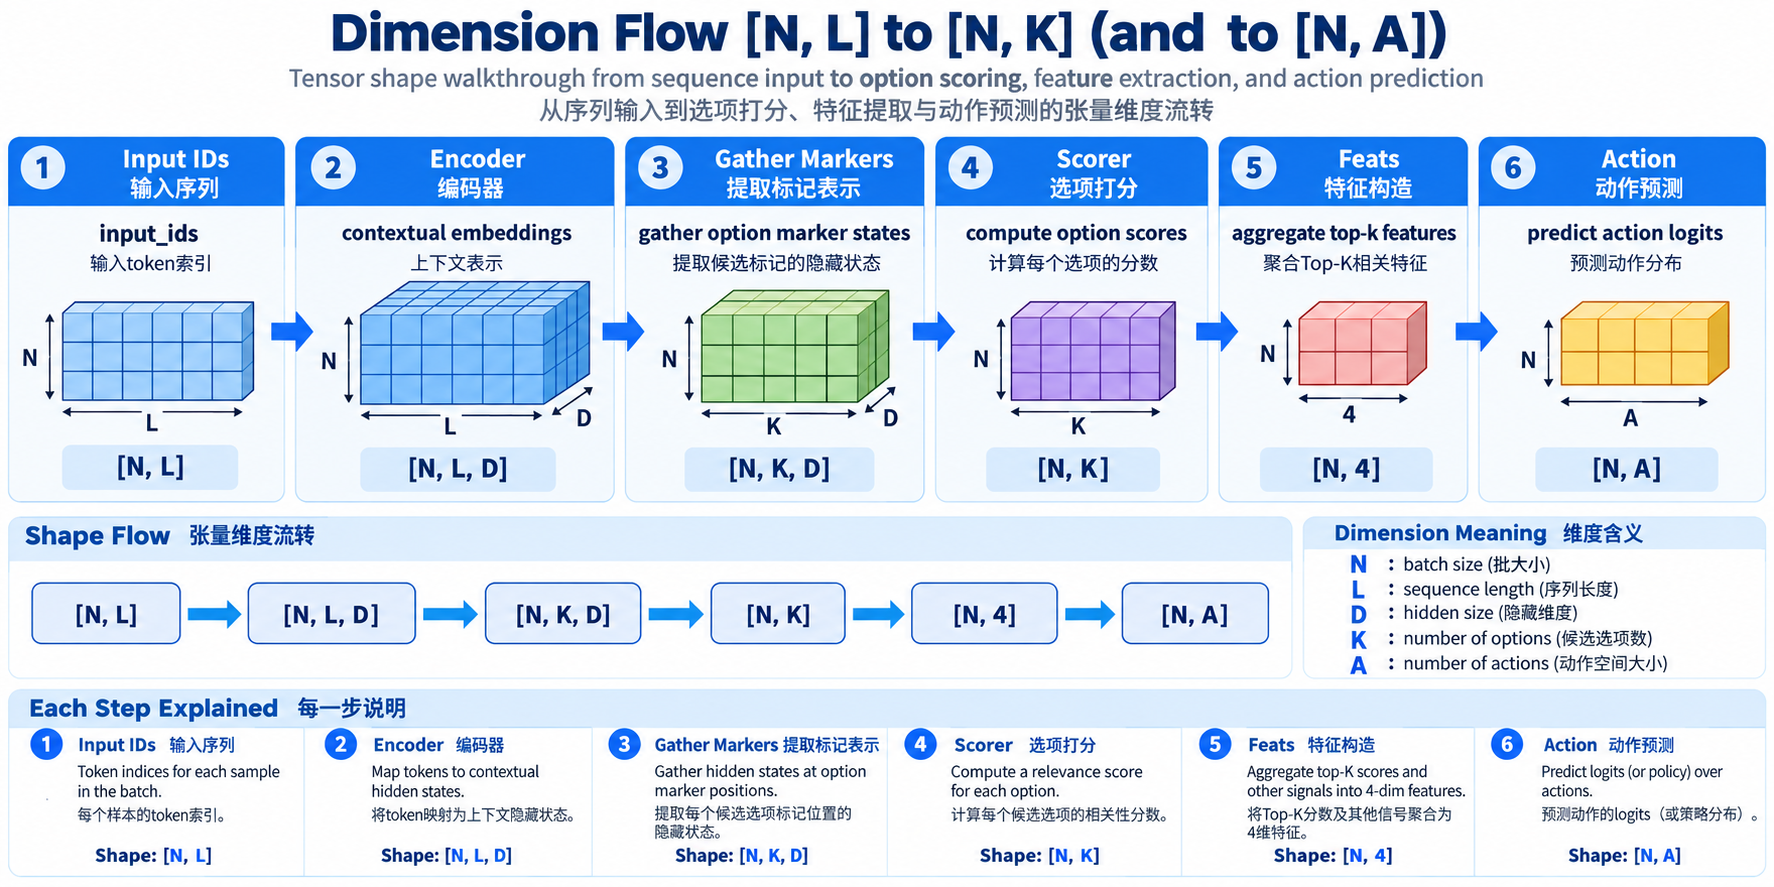
先把符号定死:$N$ 是这一 batch 的问题行数(state 数 × 每个 state 的问题数,一行一个问题、不是一个候选一行),$L$ 是 padding 后序列长度,$K$ 是这批里最多的候选数,$D$ 是 encoder 的 hidden size,$A$ 是行动头的输出类别数。举个具体的:一个 state 问 3 个问题($N=3$)、最多 4 个候选($K=4$)、英文 checkpoint($D=1024$)、padding 到 $L=128$,对着图从①到⑥就是:
- ①
input_ids[N,L]=[3,128]。 每行是一个问题拼出来的 token 序列。 - ② encoder +
type_emb→[N,L,D]=[3,128,1024]。 每个 token 一个 1024 维上下文向量;type_emb(qtype)形状[N,D],加[:,None,:]广播到每个位置,self.head精炼后形状不变。 - ③ gather markers →
[N,K,D]=[3,4,1024]。marker_pos记着每个候选[MASK]的下标,gather把这些位置的向量抠出来——第二维从「序列长度 $L$」变成「候选数 $K$」,marker 设计到这一步才真正落地。 - ④ scorer →
[N,K]=[3,4]。 每个 marker 向量压成一个分。候选不齐的行(比如某题只有 2 个候选),多出来的槽被marker_mask标无效、masked_fill(-1e4)打成 -inf,softmax 后几乎是 0,不抢概率;只有 1 个候选时topk(2)没第二名,代码显式补 0 兜底。 - ⑤ 概率特征 →
[N,4]。 softmax 后顺手算 4 个 summary:最大概率、一二名之差、归一化熵、$K/255$。 - ⑥ act_head →
[N,A]。[CLS]向量[N,D]拼上这 4 维得[N,D+4],过行动头出[N,A]。
一句话收束:分类器的输出宽度不是固定词表大小,而是「这条请求实际插了几个 marker」(也就是 $K$)——这正是 Laya 能吃动态候选集合、又不用为每套标签体系重训一个分类头的原因。
5. 三个 checkpoint 是按语言和任务分工,不是复制三份
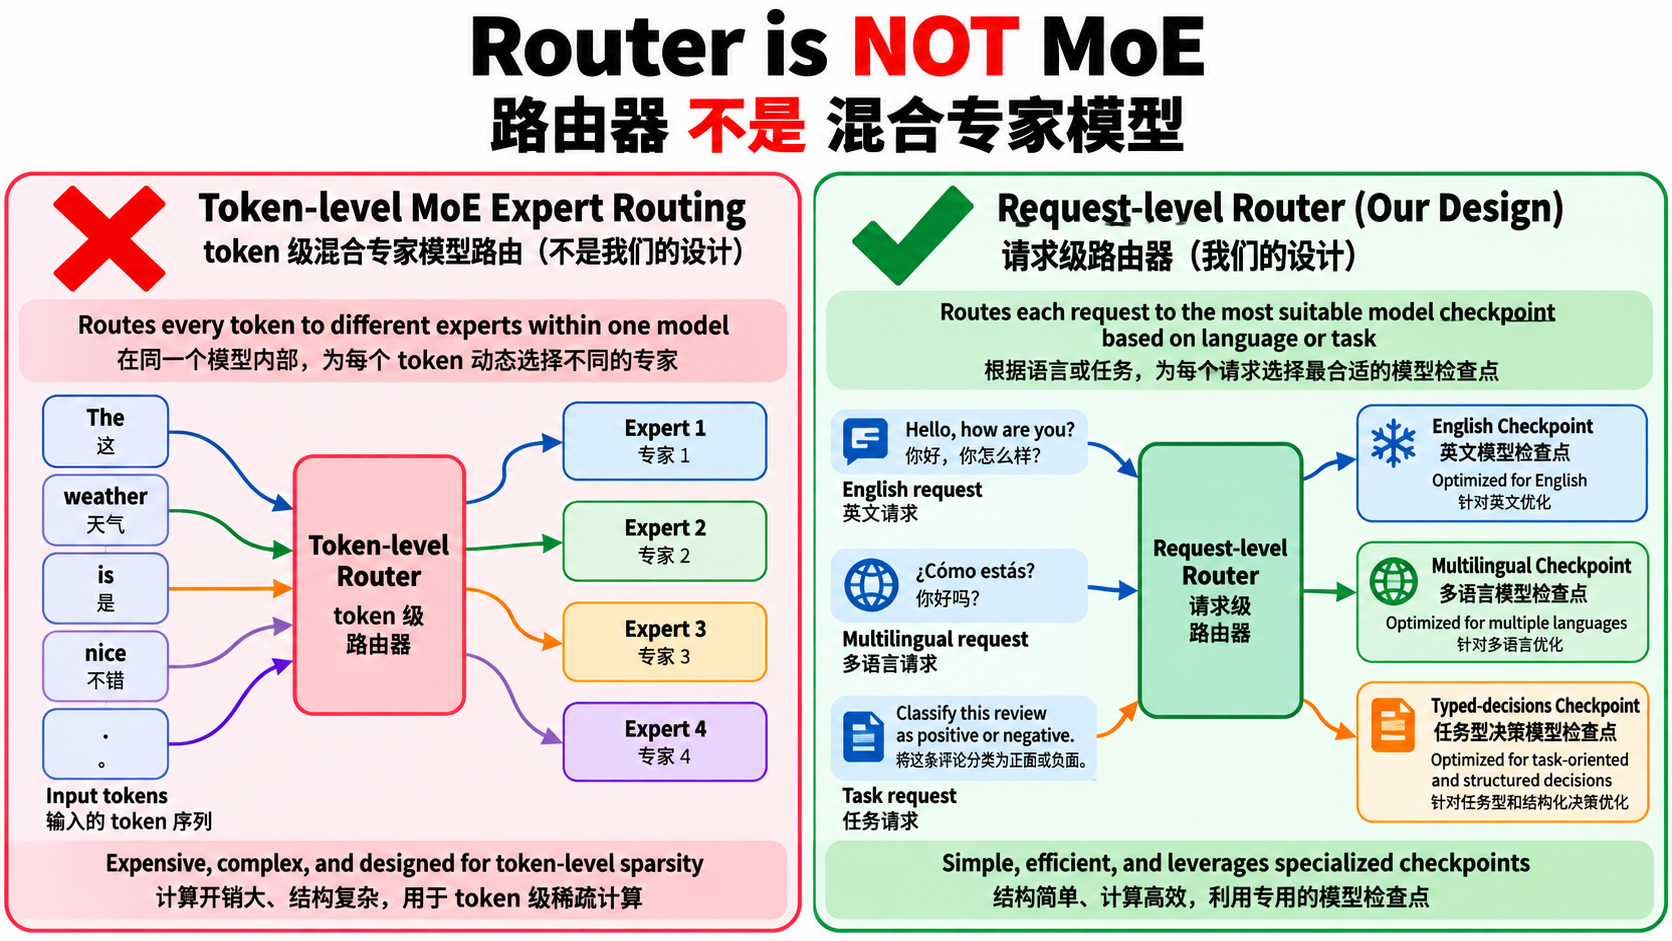
Laya 放出三个 checkpoint,光看名字容易以为是同一个模型抄了三份,其实适用范围不一样,Router 存在的意义就是替你选:
| checkpoint | encoder | 参数量 | 上下文 | 适用 |
|---|---|---|---|---|
english | ModernBERT-large | 421M | 512 | 英文场景,快 |
multilingual | mmBERT-base | 322M | 1024 | 100+ 语言 |
typed-decisions | ModernBERT-large | 421M | 1024 | 在 4 类 workflow 上微调过 |
english 在英文上更强,但对非英文不是缓慢退化,而是直接崩——仓库自己记了个扎心的数字:它在 Khmer(高棉语)上准确率 0.000,却还报着 0.95 的高置信度。这说明语言路由必须发生在 forward 之前,事后靠置信度 gating 拦不住「它根本没看懂却很自信」这种情况。
typed-decisions 不是「第三个语言模型」,而是 english 在 Agent Trace Observability、Customer Service、Invoice Processing、Security Incidents 这 4 类 workflow 上微调出来的版本,默认不会被自动选中,得显式 task="typed_decisions" 或开 auto_task_detection 才用。一个在特定 workflow 上微调过的 checkpoint,不等于对所有文本决策都更强,这点第 7 节还要再算账。
顺便澄清一个容易被名字带偏的点:这里的 Router 不是 MoE 那个 router。 它不做 token 级的专家路由、不算 gate,就是段朴素的规则代码——检测输入语种、看有没有显式指定 task,然后从三个 checkpoint 里挑一个加载、跑 system_one、把路由决策附在结果里。laya/router.py 的 DEFAULT_MODELS 就是仨 checkpoint 名字的注册表,跟「每层每 token 动态选专家」完全是两回事。
6. typed-decisions 怎么训出来的:拿 soft target 喂 RLCD
模型结构讲完,看它怎么训。公开的 fine-tune 例子用的是 HuggingFace 数据集 LocalLLaMA/typed-decisions:train 有 1200 个 case、6000 个 typed decision,test 是 400 个 case、2000 个 decision。
每个 case 不是简单的「文本→标签」,而是带了 teacher 给的软分布。预处理会把一个 case 拆成多个训练 item,每个 item 的 target 是 teacher 对各候选的概率,比如:
gold = [0.05, 0.15, 0.80] # 不是 one-hot,而是「谁赢、第二三名差多少」都告诉你
choice 按 criteria 的 key 顺序取概率,noul 固定 [false, true],score 按 level 顺序取;概率和为 0 就退化成均匀分布,marker 数和候选数对不上的 item 直接丢掉。训练目标是分布,不是标签——这也是为什么后面评测里会专门有个「soft accuracy」。
有一点得老实说清楚:基础 english / multilingual checkpoint 的预训练语料,仓库里没有完整公开。 能核对的只有 checkpoint 结构、部分训练轮数和 typed-decisions 这段专项微调;至于基础模型的数据来源、配比、去重、跟评测集有没有重叠,都无法从当前代码推出来,别靠模型名脑补。
RLCD 训的不是普通 hard-label 交叉熵,而是两项加起来:一个基于 proper scoring rule 的 policy-gradient 项,一个对着 teacher 分布的 soft cross-entropy 项。
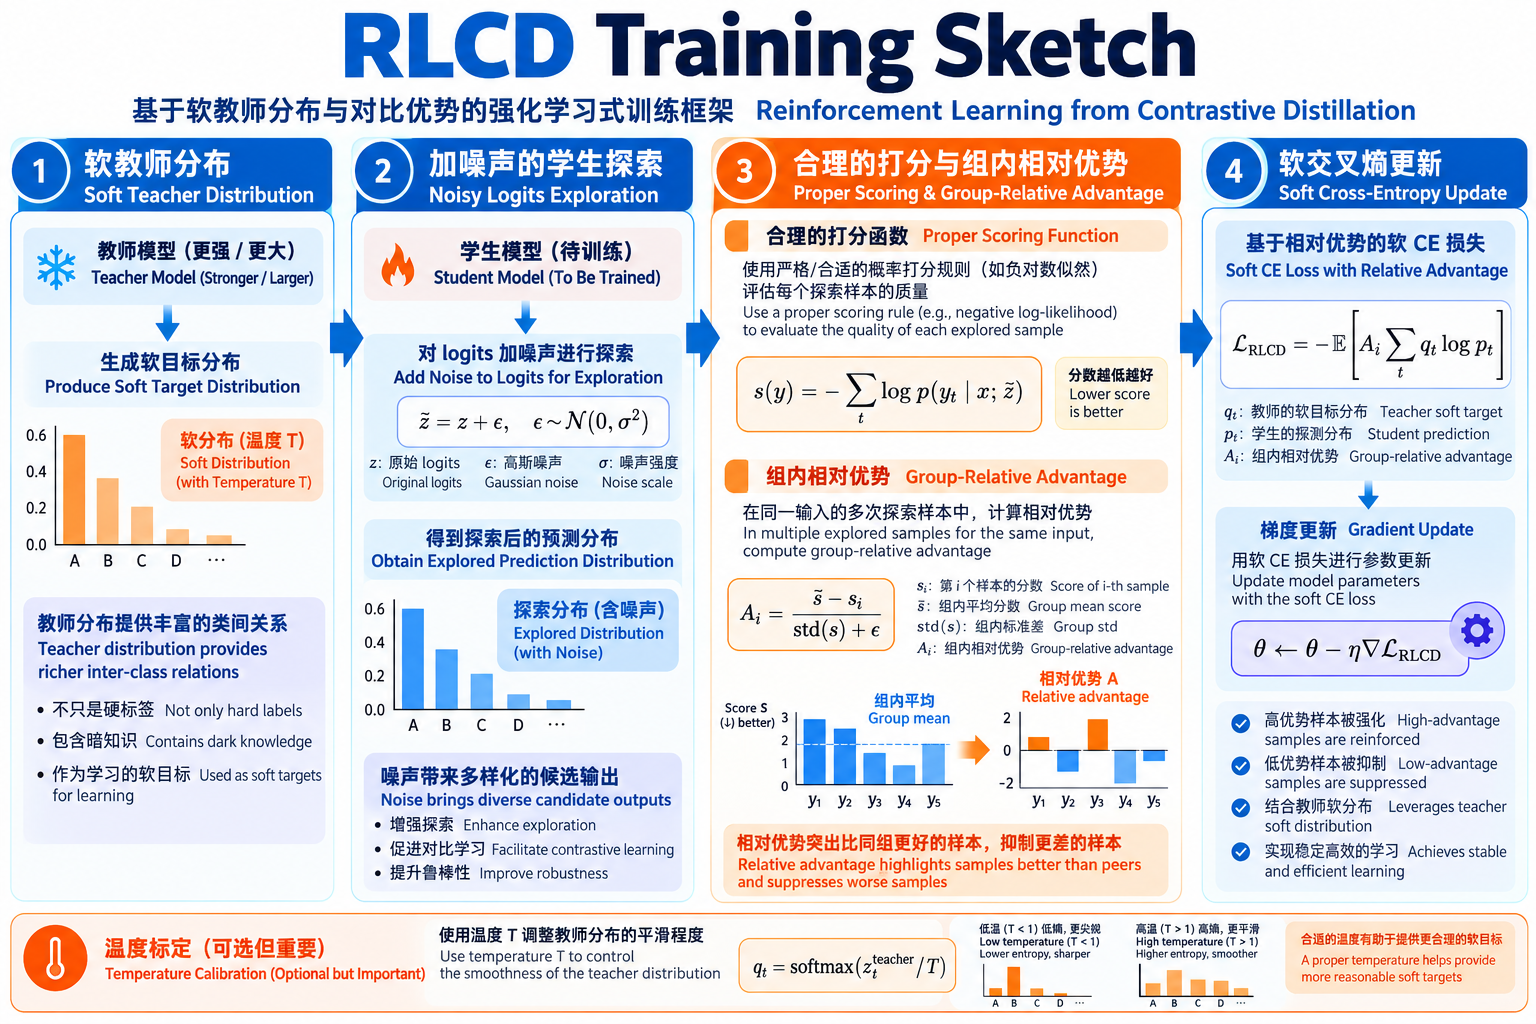
reward 用的是严格 proper scoring rule(laya/common.py 的 proper_reward),score 类型再额外减一个 ranked probability score:
其中 $t$ 是 teacher 分布、$q$ 是模型分布,默认 $w_{\text{sph}}=0.75$、$w_{\text{rps}}=1.0$。训练时对每个 item 采 4 份加了零均值高斯噪声的 logits(GRPO 那种组内做 baseline),探索强度 $\sigma$ 从 0.4 退火到 0.1,advantage 组内归一化后乘 log-prob,再和 soft CE 等权相加。比起只优化 argmax 准确率,这套目标更在乎「整个概率分布对不对」。
2×T4 的公开配方(照抄能复现那份 notebook):
| 项 | 值 |
|---|---|
| epoch / effective batch | 4 / 64(8 per-GPU × 2 GPU × 4 累积) |
| lr | encoder 2.5e-5,head 1e-4,AdamW,cosine |
| 序列预算 | max_len 1024,head_max_len 256 |
| 探索 $\sigma$ | 0.4 → 0.1 |
训完还得按问题类型各拟合一个 temperature 做校准:$p_i(T)=\mathrm{softmax}(z_i/T)$,用 LBFGS 优化 $\log T$、clamp 在 $[0.1,10]$。$T>1$ 把分布拉平、压低过度自信,但不改 argmax,所以准确率不变、变的只是置信度。有个诚实的边界要标:这份 notebook 的 calibration 切分是按「展开后的问题 item」切的,不是严格按原始 case 切,所以同一个 case 的不同问题可能一半进训练、一半进校准——不算直接泄漏到 test,但校准集的独立性没那么干净。
7. 跑分怎么看:哪些能信,哪些只是「第三方数字」
先把几个指标说清楚,不然表格看不明白:
- accuracy:
choice取 argmax 对不对,noul卡阈值,score取最可能 level 来比。 - soft accuracy:不只看 argmax,而是模型分布和 teacher 分布的点积 $\sum_i p_i q_i$——把概率押在 teacher 认为可能的几个答案上也能得部分分。
-
ECE(Expected Calibration Error,期望校准误差,越低越好):把置信度分箱,比每箱的平均置信度和实际正确率差多少,$\text{ECE}=\sum_b \frac{ B_b }{n}\bigl \text{acc}(B_b)-\text{conf}(B_b)\bigr $。 - 另外还有 Brier、KL、TV(都是量分布距离)、score MAE 等。
仓库 BENCHMARKS.md 的 headline 表:
| 任务 | Laya | Jev(公开数字) |
|---|---|---|
| typed-decisions(2000 条) | 0.766 | 0.727 |
| AG News(4 类) | 0.953 | 0.910 |
| DAIR Emotion(6 类) | 0.600 | 0.480 |
| ECE(校准后) | 0.081 | 0.246 |
| T4 单问题 p50 延迟 | 32.8 ms | 236–276 ms |
数字好看,但有三条限定必须跟表一起读,否则就是误导:
第一,0.766 是微调过的 typed-decisions 的成绩,不是基础模型的零样本能力。 基础 english / multilingual 在同一个 typed-decisions 上零样本只有 0.362 / 0.352,比 0.461 的多数类基线还低——这个 benchmark 上的能力几乎全是微调堆出来的。
第二,Jev 那一列是第三方公开数字,Laya 没在同一批输入上直接调过 Jev。 样本量、prompt、版本、硬件都可能不同,只能当方向性参考,不是受控对打。
第三,延迟是本地 T4 实测 vs 第三方测量,也不是同硬件端到端比较。
最有意思、也最能暴露 Laya 边界的是 Banking77(77 个意图类):Laya 0.425 / 0.425,Jev 0.870。这不一定是「模型不懂」,而是候选项共享一个固定的 head_max_len token 预算。build_sequence 里候选一多就触发 per-option 截断:$\text{per}=\max!\bigl(4,\lfloor(\text{head_max_len}-16)/K\rfloor\bigr)$。77 个候选摊下来每个只剩三四个 token,不同候选甚至被截成同一串——所以两个 checkpoint 都卡在一模一样的 0.425,这是预算天花板,不是能力差。仓库自己也建议 choice 别超过 ~20 个候选;候选多时先用 embedding 做 shortlist,再交给 Laya 定夺。
8. 什么时候该用 Laya,什么时候别硬上
把结构、训练、跑分串起来,边界就清楚了。
它真正值钱的地方:
- 本地自托管:工单、浏览器状态、内部文档不用发去第三方 API,对企业内部 Agent 往往比多几个点准确率更实在。
- 输入输出都是结构化的:直接吐
choice / score / noul,output_tokens = 0,没有「从生成文本里抠 JSON」这一步。 - 一次 forward 答多个问题:同一 state 的多个问题打包成多行一起过 encoder,天然好做低延迟和批处理。
- 能用自己的数据 fine-tune:训练目标天然吃 soft target,学到的不只是「答案是谁」,还有 teacher 的不确定性结构。
它替你解决不了的:
- 大候选集合会撞
head_max_len天花板(见 Banking77),几十上百个候选得先 shortlist。 - 置信度不是开箱即用的风险概率:没在自己流量上重新校准前,别把
answer_confidence = 0.95当「95% 一定对」,尤其候选数一变分布就跟着变。 - 微调结果不能外推成通用能力:换个业务标签体系,候选描述、soft target、校准、label 顺序都得重验。
落地按这个顺序来:先 shadow mode 影子跑、记录预测分布和人工结果 → 按问题类型和候选数重新校准 → 先接可逆操作 → 低置信度转人工 → 最后才接不可逆动作。别把 min_confidence 当「低于阈值就不返回」——它只是给低置信答案打个 low_confidence 标记,答案照样返回,执不执行还得业务自己判断。
9. 总结
Laya 最核心的设计,一句话能概括:
把 state 和候选拼进同一条序列,用每个候选前的 marker 当动态分类槽,一次双向 encoder forward 就输出决策分布——不生成任何文本。
它对标 Jev 有三层:HTTP 协议兼容(老 client 能迁)、产品形态相同(给 Agent 供有限选项决策)、在部分公开 benchmark 上本地微调版的成绩和延迟有竞争力。但它不是 Jev 的本地镜像,第三方 Jev 数字也别当同条件对打。真正适合它的场景很具体:候选数不大、数据要留在本地、要低延迟和批处理、有自己的标注、愿意在上线前重新校准。 反过来,77 个以上候选先 shortlist、高风险不可逆动作别只看一个高 confidence、跨语言先路由再 forward。
这类模型的价值不在取代所有 LLM,而在把 Agent 里那些不需要自由生成、却每天高频跑很多次的结构化决策,从昂贵的文本生成链路里拆出来,变成一个能本地部署、批量推理、单独校准的小决策器。
顺带一提,「用尽量小的算力预算保住够用的决策能力」这件事,本质上和模型压缩、架构搜索是同一个问题。我们把这块的积累整理进了《动手学 AutoML:从 NAS 到大语言模型优化实战》——书里 LLM 压缩(剪枝/量化)、模型融合和 NAS 那几章,讲的都是同一个立场:不是把模型堆大,而是让有限的算力花在真正影响结果的地方。 和 Laya 这种「小 encoder 干决策」的思路,算是殊途同归。
