arXiv'25 | Speculative Actions 把 Agent 的串行 API 等待变成并行预执行
arXiv’25 | Speculative Actions 把 Agent 的串行 API 等待变成并行预执行
原文:Speculative Actions: A Lossless Framework for Faster Agentic Systems(本文解读 v2)
代码:naimengye/speculative-action
1. Agent 真正慢的地方,可能根本不在模型里
一个 Agent——也就是能循环执行“观察环境、推理、调用工具、更新状态”的系统——完成一次任务到底要多久?
论文列了几个很直观的数字:操作系统(OS)任务需要 10–20 分钟,Deep Research 需要 5–30 分钟,数据流水线任务需要 30–45 分钟,一局由人工智能(AI)Agent 驱动的国际象棋甚至要 1 小时。
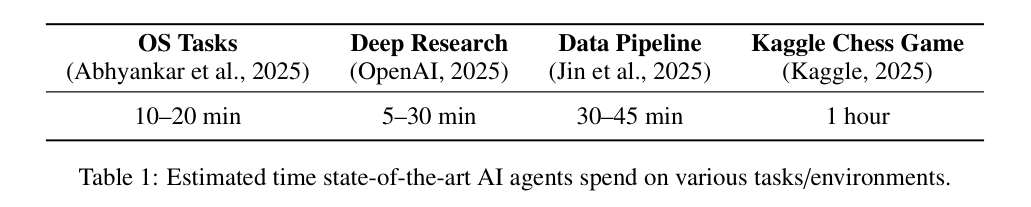
这里最麻烦的并不是大语言模型(LLM)的一次 forward(前向计算)有多慢,而是 Agent 的执行链天然长这样:
LLM 决定下一步
    ↓ 等待
调用搜索 / 数据库 / 浏览器 / MCP Server
    ↓ 等待
拿到结果,再让 LLM 决定下一步
    ↓ 等待
调用下一个工具
MCP(Model Context Protocol)可以理解成 Agent 调用外部工具的一套标准接口。无论背后接的是搜索、数据库还是浏览器,对 Agent 来说都像发起一次 API(Application Programming Interface,应用程序接口)请求:请求没回来,后续步骤通常就不知道该怎么走。
于是一个 30 步的任务,就有 30 段互相依赖的等待。模型再快,也架不住整条链路被 round-trip latency——请求发出再收到响应的往返延迟——一段段串起来。
最自然的问题这才浮出来:下一步必须等上一步完全结束以后才能启动吗?
这篇论文给出的答案是:不一定。既然下一步往往有规律可猜,就先猜、先跑;猜对了直接复用,猜错了再回到正常路径。
这其实就是中央处理器(CPU)speculative execution 和 LLM speculative decoding 的同一个思想,只不过投机的单位从“指令”或“token”抬高成了完整的 Agent action。
2. 不再猜 token,而是直接猜下一次 API 调用
Speculative decoding 会让一个便宜的小模型先生成若干 token,再由大模型一次性验证。Speculative Actions 做的事情更激进:让一个快模型预测 Agent 下一步会执行什么 action,并提前启动由这个 action 引出的后续 API 调用。
论文把系统分成两个角色:
- Actor:慢但权威的执行者。它可能是高 reasoning effort 的大模型、真实外部 API,甚至是正在输入文字的人。它给出的结果决定系统最终走哪条路径。
- Speculator:快但不权威的预测器。它可以是小模型、同一个模型配更短 prompt 和更低 reasoning budget,也可以是领域启发式规则。它只负责尽快猜出一个或多个候选 action。
如下图,上半部分是严格串行的下棋过程:Actor 算完当前落子,对手才开始计算下一步。下半部分里,Speculator 在 Actor 思考时先猜出若干可能落子,并让对手针对每个候选局面提前思考。Actor 的真实落子一回来,命中的分支已经算了一段时间。
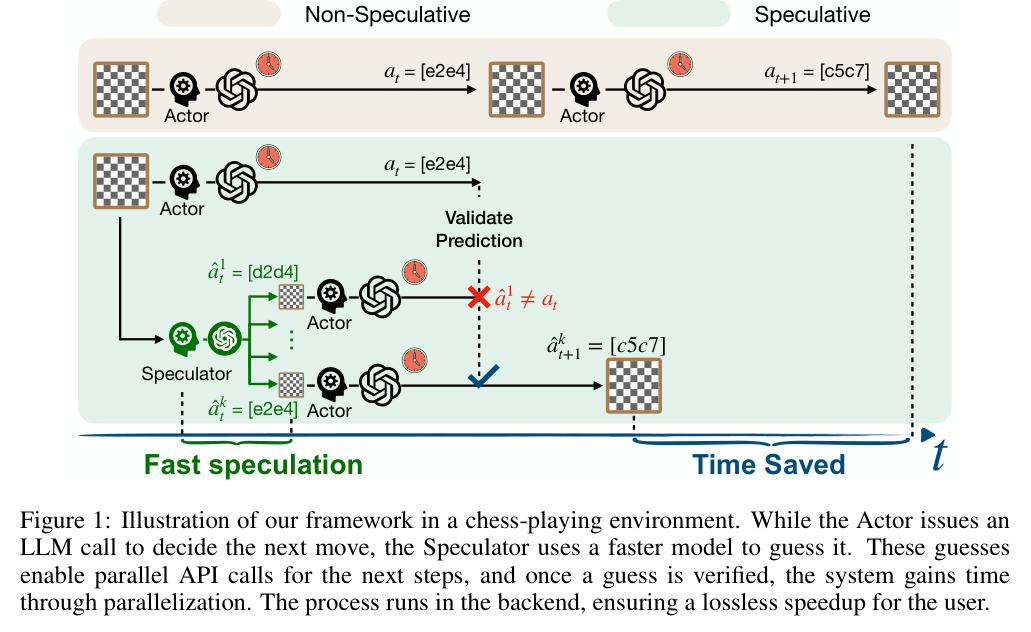
注意这里有两个很容易混淆的“猜”:
- Speculator 猜的是当前慢请求可能返回什么;
- 系统真正提前启动的是这个猜测所导出的下一次调用。
比如当前在等用户回复。Speculator 猜用户可能会说“我要退掉刚才那件衣服”,系统便可以提前调用 get_order_details 和 check_return_eligibility。等真实输入到达,如果意图和参数一致,结果直接可用;如果用户实际问的是物流,前面的预取结果全部丢弃。
它优化的不是 Actor 自己的计算,而是把原本躺在 critical path——决定总耗时的关键路径——上的下一段等待,搬到当前等待时间里重叠执行。
3. 一次完整的数据流:猜测、预启动、验证、提交
论文把每个 Agent step 抽象成状态 s_t 和 action a_t。策略 π 根据当前状态生成一次 API 调用:
其中 h_t 表示调用哪个 API,q_t 表示参数。异步调用不会立即拿到结果,而是先返回一个 future;future 可以理解成“这项任务已经启动,但结果稍后才会填进来”的占位对象。系统再用一个 cache 保存“API 名称 + 参数”到 pending future 的映射。
完整执行过程可以拆成六步:
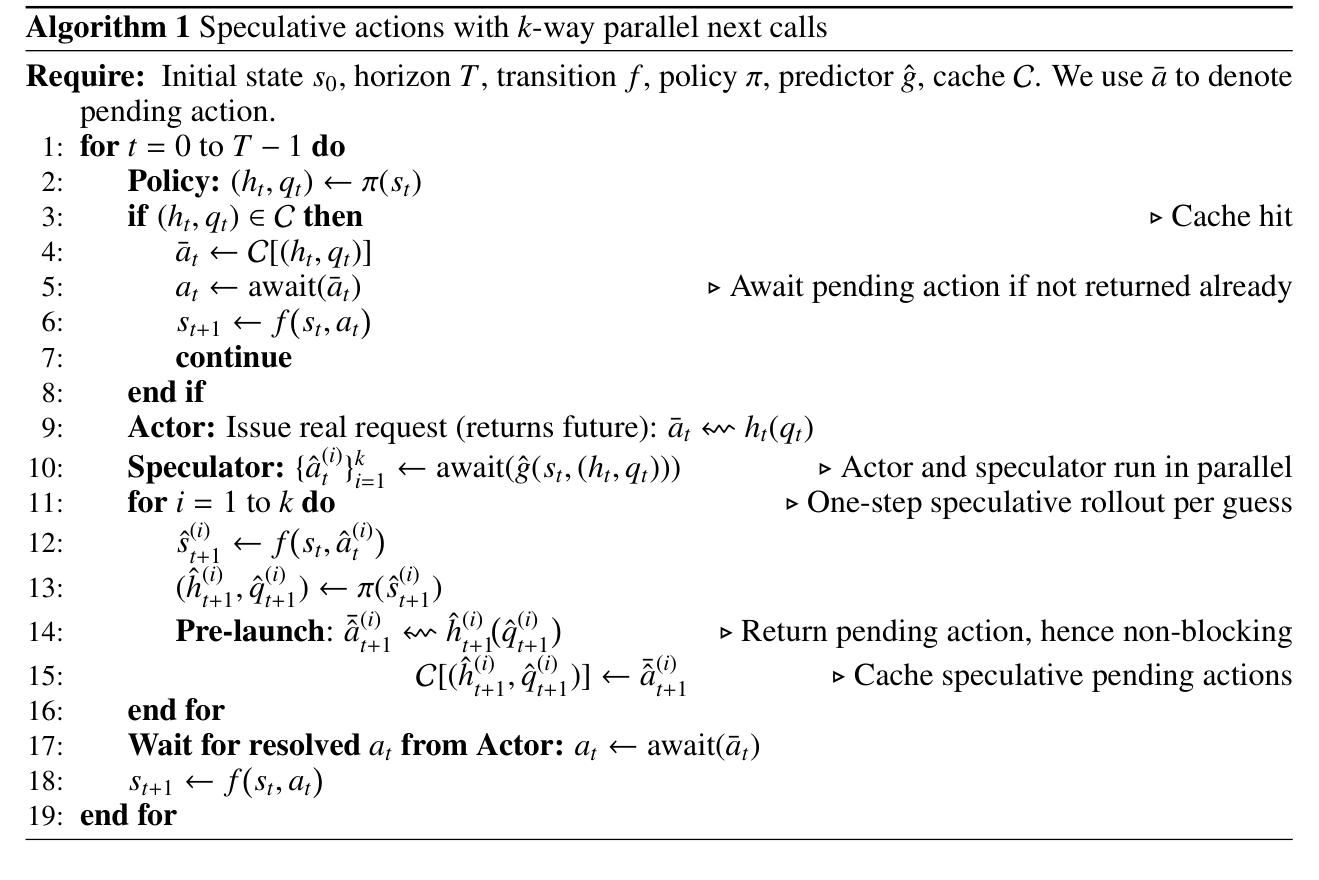
- 查 cache:如果当前
(h_t, q_t)之前已经被投机分支启动,就直接拿到对应 future;结果若已返回,等待时间近似为零。 - 并发启动:cache miss 时,Actor 发起真实请求;Speculator 同时根据当前状态生成
k个候选响应。 - 构造候选状态:把每个候选响应应用到当前状态,得到
k个可能的下一状态。 - 导出下一调用:Actor 的策略分别在这些候选状态上生成下一次 API 名称和参数。
- 预启动并缓存:
k次下一步调用立即异步执行,对应 future 写入 cache。 - 用真实结果推进:当前 Actor 返回后,系统只沿真实状态更新;到下一轮,如果真实调用恰好命中 cache,就复用已经运行中的请求。
论文的伪代码把这条链路写得很清楚:第 9、10 行让 Actor 和 Speculator 并行,第 11–15 行展开 k 个一步分支并把 future 放入 cache,第 17 行以后仍然等待 Actor 的权威结果来更新真实状态。
不同场景只是 state、action 和“如何验证”不同:
| 场景 | 当前状态 | Speculator 猜什么 | 被提前启动的工作 | 如何验证 |
|---|---|---|---|---|
| 国际象棋 | 当前棋盘 | 对手下一步落子 | 针对候选棋盘计算己方落子 | 棋步是否一致 |
| 电商客服 | 对话历史 | 用户下一句话及工具意图 | 查订单、查退货资格等 API | API 名称与参数是否一致 |
| 多跳搜索 | 推理轨迹与检索结果 | 当前搜索可能返回的信息 | 基于候选信息继续生成并调用下一条检索 | 下一次检索调用是否严格一致 |
| OS 调参 | 最近性能指标与参数历史 | 更好的调度器参数 | 立即写入候选参数 | 后续由 Actor 覆盖,不要求轨迹完全一致 |
前三个场景都是先验证再提交;最后一个场景先执行再覆盖,所以论文明确把它称为 lossy extension,不是 lossless 主框架的一部分。
4. “Lossless”不是魔法,它有三个很硬的前提
论文所谓 lossless,准确说是:用户最终观察到的状态轨迹,与不做 speculation 时保持一致。 猜错可以浪费计算,但不能改变最终语义。
这需要三层保护:
4.1 Actor 必须保留最终裁决权
Speculator 只能生成候选,真实状态仍由 Actor 的输出推进。下棋时,不能因为 Speculator 猜对手机会走 e2e4,就真的把棋盘更新了;必须等 Actor 返回 e2e4 后,才能提交对应分支。
4.2 被提前执行的 action 必须可丢弃
最安全的是 read-only API,例如搜索、读取订单、查询天气。它们猜错以后不产生外部副作用。
如果是写操作,则至少需要满足下面一种条件:
- 幂等:执行一次和重复执行多次,最终效果相同;
- 可逆:可以 rollback,也就是撤销到执行前状态;
- 沙箱化:先在隔离环境里运行,命中后再 commit;
- 可补偿:无法原地撤销,但可以执行反向操作修复。
删除数据库记录、正式下单、给用户发邮件这类不可逆或对外可见的操作,显然不能直接投机执行。论文用“退款/换货”举例说明 roll-forward repair,但这已经不是严格意义上的零副作用,工程上必须非常谨慎。
4.3 并发资源不能反过来拖慢主路径
如果预启动的三个分支把连接池、GPU(图形处理器)的 batch(批处理队列)和 API rate limit(调用限额)全占满,Actor 本身反而排队,那就不是加速,而是在花钱制造拥堵。
所以 lossless 只约束最终语义,不代表零额外成本、零资源竞争,更不代表没有隐私和安全风险。 这也是这篇论文落地时最需要补的一层系统设计。
5. 为什么 55% 的命中率只换来 20% 的加速
假设每个候选分支独立命中的概率为 p,一次并行发出 k 个候选,至少有一个命中的概率是:
例如单分支准确率 p=0.3:
-
k=1,命中率是 30%; -
k=2,命中率变成 51%; -
k=3,命中率变成 65.7%。
但命中率不是加速比。命中以后究竟省多少,还取决于 Speculator 多快、下一次调用已经提前跑了多久,以及那次调用本身是否真的很慢。
论文用指数分布建模延迟。令 Speculator 和真实 API 的速率参数分别为 α 和 β,平均延迟分别是 1/α 和 1/β;因为 Speculator 更快,所以 α > β。当任务步数 T 足够长时,单步 breadth speculation——同一层横向猜 k 个候选——的运行时间比例趋近于:
这个式子揭示了两个限制:
第一,即使 p(k)=1 且 Speculator 近似瞬时完成,单步 breadth 的理论省时上限也只有 50%。原因是一次命中会吃掉下一轮 speculation window:系统已经跳到预计算结果,不能在同一段时间里无限套娃。
第二,只要 Speculator 不够快,α/(α+β) 就会继续打折。一个准确但和 Actor 一样慢的预测器几乎没有意义。
论文还分析了 depth speculation,也就是沿一个候选连续向前猜多步。它的理想速度收益系数可从 p/(1+p) 提升到 p,理论上限从 1/2 提升到 1;代价是错误路径会积累更多调用。值得注意的是,活跃分支不会随任务长度指数爆炸,因为真实响应一回来,不一致的子树就会被立刻剪掉;可领先的深度主要由 Actor 与 Speculator 的速度比决定。
6. 国际象棋:54.7% 猜中,最终省下 19.5% 时间
国际象棋是最干净的 lossless 场景:棋盘可以复制,候选分支随时丢弃,落子也容易做 exact match。
实验在 TextArena 上进行。Actor 和 Speculator 都使用 GPT-5,但配置不同:Actor 用高 reasoning effort 深度分析,Speculator 用低 reasoning effort 和专门的快速预测 prompt。这里的 reasoning effort 指模型服务为推理分配的内部计算预算,越高通常越慢。
论文在 5 次、每次 30 steps 的运行上比较不同分支数:
- 1 个预测:命中率 31.3%,省时 11.8%;
- 2 个预测:命中率 41.3%,省时 15.0%;
- 3 个预测:命中率 54.7%,省时 19.5%。
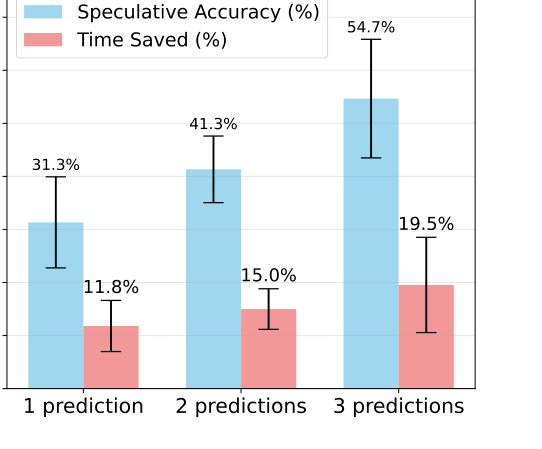
这个结果正好说明命中率和加速比不是一回事。三分支超过一半的轮次猜中,但只减少约五分之一的总时间。因为有些命中发生在简单局面,提前计算本来就不需要多久;API 服务端的瞬时负载也会让相同请求的延迟波动很大。
还有一个容易忽略的统计口径:开源实现区分 speculative-window accuracy 和 step accuracy。一次命中后,下一 step 没有新的投机窗口,所以“命中数 / 实际投机窗口数”和“命中数 / 总步数”不是同一个指标。仓库同时提供真正并发运行的 speculative pipeline,以及先生成普通轨迹、再离线补猜的分析流程。这两种结果不能混着解读。
7. 电商客服:趁用户打字时,把工具调用偷偷跑完
电商场景来自 τ-bench。它不是一个模型,而是一套评测 tool-using Agent 的 benchmark;论文使用 retail 子集,共 115 个任务和 15 个 API,其中 7 个会写数据,8 个只读。
这里的空闲窗口很有意思:不是等另一个模型,而是等用户打字。
Speculator 根据已有对话猜用户下一句话,再猜完成该请求需要调用哪些 API 以及具体参数。用户真实输入到达后,Actor 检查候选调用,命中的结果立即提交,错误分支直接丢弃。
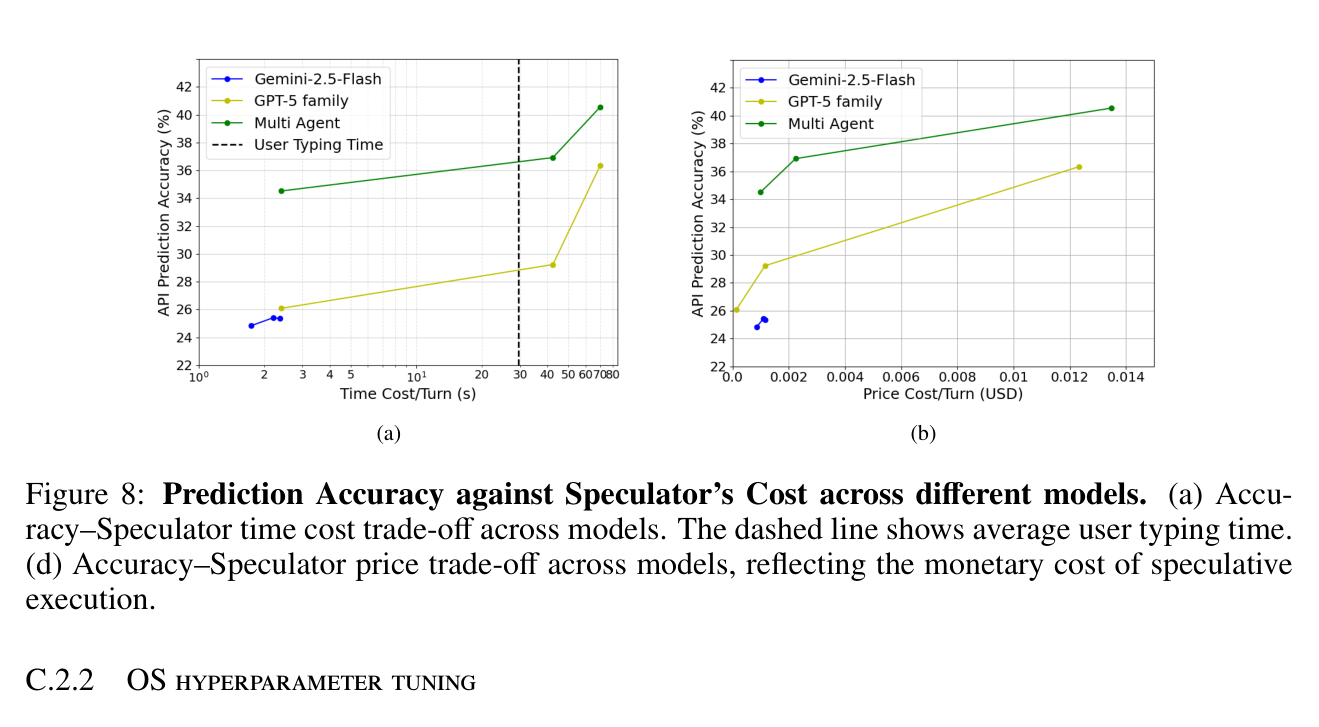
论文比较了 GPT-5-nano、GPT-5-mini、GPT-5、Gemini-2.5-flash 以及多模型组合。reasoning capability 从 low 到 high,对应 1024、2048、4096 token 的推理预算;这里的 token 是模型处理文本的基本单位,不等同于汉字或英文单词。
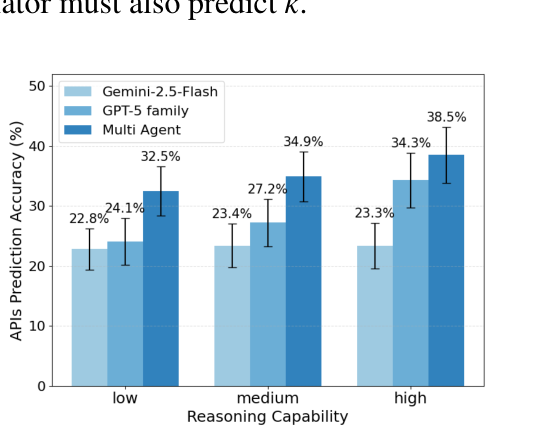
单模型命中率大约在 22%–34%,多模型组合最高达到 38.5%。低预算 Speculator 约 2–3 秒就能给出结果,而论文按每分钟 40 个词估算,用户平均输入时间约 30 秒。因此,哪怕只在三分之一左右的 turn 猜中,也可能把原本发生在用户提交之后的工具等待完全藏到打字时间里。
不过这组实验主要报告 API prediction accuracy,也就是预测 API 名称和参数与 ground truth 一致的比例,并没有像下棋那样直接给完整端到端 latency 分布。“三分之一的 turn 可以立即响应”仍是从命中率推导出的潜在收益,不应直接读成“整个客服系统加速 38%”。
8. HotpotQA:更强的模型,反而可能更难命中 cache
HotpotQA 是一个多跳问答 benchmark:回答一个问题往往要连续查多个 Wikipedia 条目。论文在 ReAct 流程上实验;ReAct 会让模型交替执行 reasoning 和 action,例如先思考该查谁,再调用 Search(entity),根据结果继续 Lookup 或 Finish。
这里的 Speculator 先猜当前检索会返回什么,再让 Actor 基于候选结果提前生成下一次 Search、Lookup 或 Finish 调用。
评测采用非常严格的 exact match:API 名称相同还不够,参数也必须完全一样。近义词、词序变化、一个更详细的搜索 query,全部算错。Top-1 表示只看第一个候选,Top-3 表示三个候选里任意一个命中都算对;两者都是越高越好。
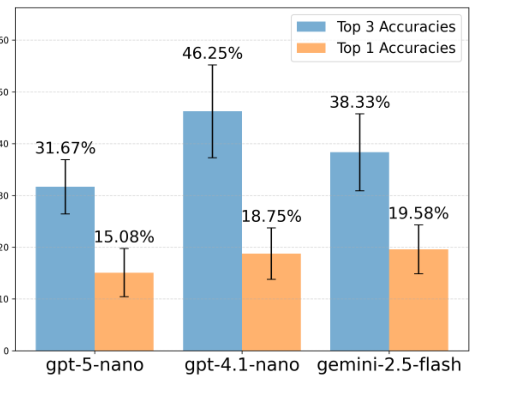
三个 Speculator 的结果分别是:
- GPT-5-nano:Top-1 15.08%,Top-3 31.67%;
- GPT-4.1-nano:Top-1 18.75%,Top-3 46.25%;
- Gemini-2.5-flash:Top-1 19.58%,Top-3 38.33%。
最有意思的不是 46.25% 这个数字,而是论文观察到:更强的模型可能因为 query 写得更丰富、更具体,反而更难通过 exact match。
比如“1970 年代诺贝尔物理学奖得主列表”和“1970s Nobel Prize Physics winners list”语义上几乎一样,但 cache key 如果直接由原始字符串构成,它们就是两次不同调用。于是系统真正需要预测的未必是自然语言文本,而是某种 canonical form——规范化后的工具意图与参数。
这引出一个比“换更强 Speculator”更实用的优化方向:在进入 cache 前先做参数标准化、实体链接和语义等价判断。否则模型越会表达,cache 反而越碎。
9. OS 调参:先让快模型动手,再让慢模型覆盖
前三个实验都坚持“验证后提交”。OS 调参则故意放宽限制:Linux 调度参数需要快速响应负载变化,如果等 Actor 思考 10–15 秒,系统可能已经在坏配置上卡了很久。
实验调整 Linux CFS(Completely Fair Scheduler,完全公平调度器)的 min_granularity_ns。这个参数规定任务获得的最小时隙:太大,短任务响应慢;太小,上下文切换开销又会上升。搜索范围是 0.05–50 ms,Linux Kernel 5.15 的实验默认值为 3 ms。
系统每秒让 Gemini-2.5-flash-lite 充当 Speculator,根据最新性能指标直接写入一个临时参数;Gemini-2.5-flash 充当 Actor,每 10–15 秒分析一段压缩历史,再用自己的决定覆盖当前值。由于写同一个参数天然是 last-write-wins——最后一次写入生效——系统不需要复杂 rollback。
这里关注的是 p95 latency:把所有请求延迟从小到大排序,第 95 百分位对应的值,越低越好。联合系统得到 37.93 ms,Actor-only 是 54.00 ms,未调优状态是 102.97 ms。
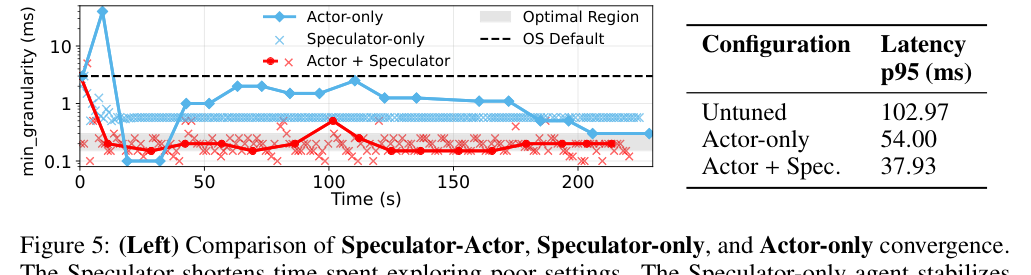
联合系统约 10–15 秒找到 0.2 ms 的最优参数,Actor-only 约 200 秒才到达;Speculator-only 虽然反应快,却停在 0.55 ms 的局部最优,对应 36.24 ms latency,而联合系统的最终 latency 是 30.26 ms。
手动把系统打到一个坏配置后,联合系统不到 1 秒就开始修正,Actor-only 要等 10 秒以上才迎来下一次决策周期。
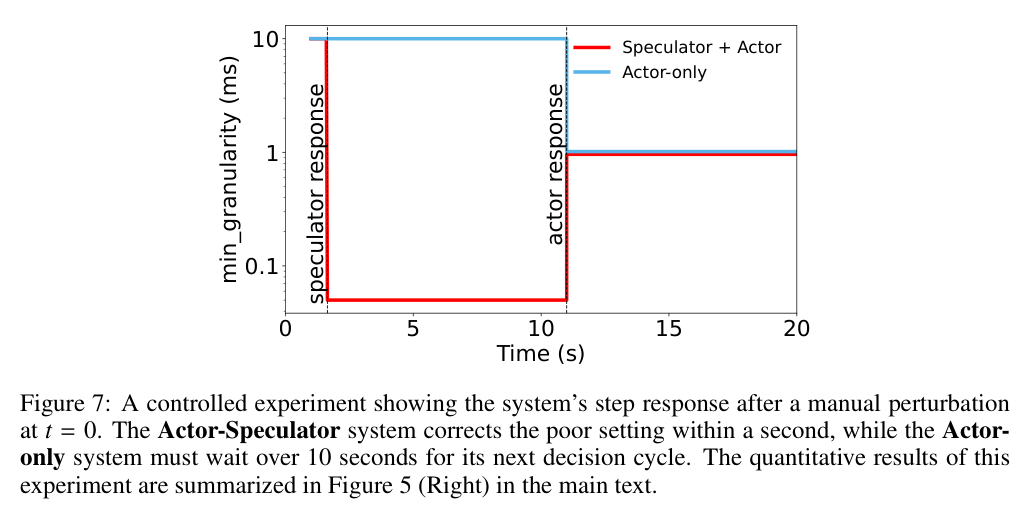
这组结果证明“快模型负责反应、慢模型负责方向”很适合控制系统。但它已经是 lossy:中间状态确实被 Speculator 改过,用户也可能观察到,只是后续会被 Actor 覆盖。
9.1 “成本和延迟同时下降”要看比较口径
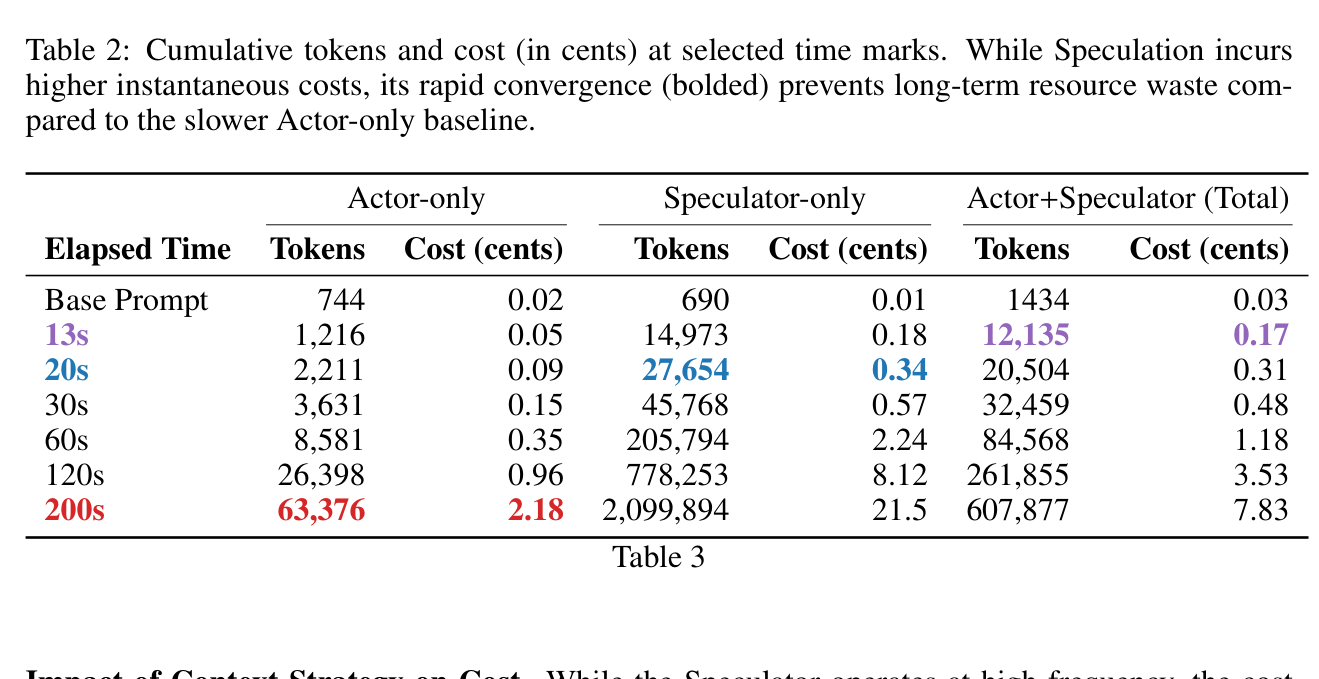
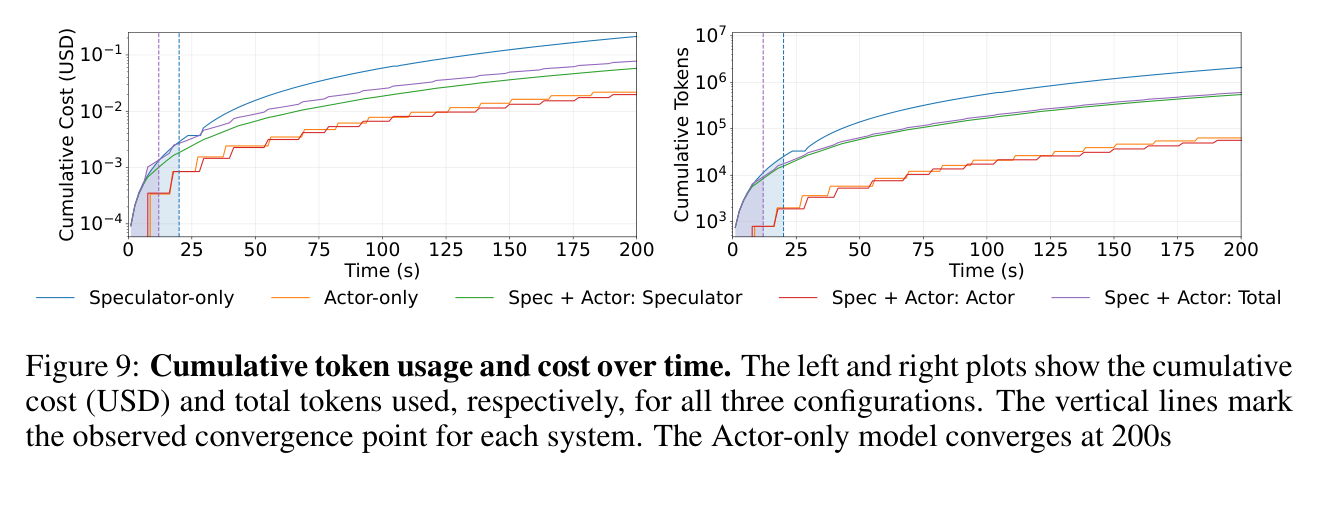
论文强调联合系统约 13 秒收敛,只花 0.17 美分;Actor-only 约 200 秒收敛,花 2.18 美分。按“达到目标就停止”的任务口径,联合系统确实又快又便宜。
但如果固定都运行到 200 秒,表里的联合系统累计成本是 7.83 美分,Actor-only 仍是 2.18 美分。换句话说:
Speculation 降低的不是单位时间 burn rate,而是 time-to-solution。只有系统在收敛后停止、降频或切回便宜模式,总成本优势才会兑现。
累计曲线也能看到,Speculator 高频调用会迅速消耗更多 token。联合系统之所以在收敛点便宜,是因为它在 13 秒附近就可以结束,而不是因为每秒调用成本更低。
开源仓库也明确提醒,这组结果高度依赖 CPU、NUMA(多路 CPU 中内存访问距离不一致的架构)拓扑、Linux kernel、HRTICK(高精度调度时钟)支持、电源管理和 Gemini API 延迟。复现实验还要写 /sys/kernel/debug/sched/* 并使用 sudo,只能放在专用测试机或 disposable VM(用完即丢的虚拟机)里跑,不能在生产机器上随便试。
10. 分支不是越多越好:把 speculation 变成一道收益题
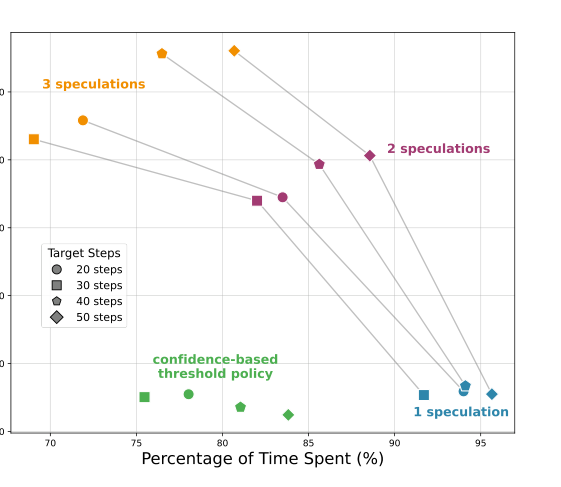
多猜几个候选通常会提高命中率,却也会增加 API 次数、token 和连接资源。论文画出的 cost–latency 曲线很直观:
- 1 个固定分支成本低,但省时有限;
- 2、3 个固定分支越来越快,额外 token 可达到原来的约 150%–190%;
- confidence-based policy 在接近 3 分支延迟收益的同时,把额外 token 压到了约 85%–90%。
这里的 confidence-based policy 是“按预测置信度决定是否启动分支”。开源实现使用一个简单近似:只保留预测正确概率超过 50% 的候选。
论文的动态规划最后收敛成一个很朴素的判断。候选按置信度从高到低排列,加入第 m 个分支带来的边际命中率提升记为 δq;只有当未来节省的延迟价值大于边际成本时,才继续加分支:
Δ* 可以理解成“在后续任务里多命中一次值多少钱”,c 是再启动一个分支的成本。这个式子说人话就是:别问能不能再猜一个,问这个候选多带来的命中概率,值不值一次真实调用。
不同 Speculator 的选择也应该看性价比,而不是只看 accuracy。如下图,多模型组合最准,但单 turn 时间和美元成本也最高;如果 Speculator 已经慢过用户打字,原本可以免费藏在输入阶段的延迟就又回到了 critical path。
11. 这篇论文真正有价值的地方
11.1 把 Agent 优化的边界从模型内部推到了环境层
过去谈推理加速,很容易只盯着 KV Cache(复用 attention 历史键值状态的缓存)、quantization(把权重和激活压到更低比特的量化)、speculative decoding,或者 kernel fusion(把多个 GPU kernel 合并执行)。它们都在优化模型内部。
但 Agent 越来越像一个分布式系统:LLM、MCP server、数据库、人类输入和远程 SaaS(软件即服务)API 串在一起。此时最大的空泡可能不在 GPU,而在不同组件之间的等待。Speculative Actions 给出了一个统一抽象:只要能把一步看成 API,就可以尝试预测、预启动和验证。
这个抽象比某个具体 prompt 或模型更重要。
11.2 “同模型、不同预算”可能比“小模型猜大模型”更稳
下棋实验里,最佳做法不是随便找个更小模型,而是让 Actor 和 Speculator 使用同一个 GPT-5,只改变 reasoning effort 和 prompt。原因也不难理解:二者共享相近的决策偏好,Speculator 更容易猜中 Actor;速度差则来自思考预算不同。
这给部署一个很实际的启发:Speculator 的优化目标不是独立任务 accuracy,而是 agreement-per-dollar——每单位成本能和目标 Actor 达成多少一致。
11.3 cache key 设计可能比模型大小更重要
HotpotQA 里,强模型因为 query 表达更多样反而吃亏,暴露出 exact-string cache 的问题。真实系统应该优先定义 action 的规范表示:
自然语言 query
    ↓ 实体链接 / 参数排序 / 默认值消除
canonical action
    ↓
cache key
如果两个调用语义等价,就应该尽量映射到同一个 key。否则所谓“预测错误”里会混进大量表达差异,既低估方法上限,也白白浪费已经完成的请求。
12. 目前还不能从实验里得出什么
这篇论文证明了想法值得做,但距离“通用 Agent 加速层”还有明显距离。
第一,端到端证据并不均衡。 下棋给出了真实省时比例,电商和 HotpotQA 主要报告 action prediction accuracy。能猜中多少不等于整个任务快多少,还缺真实网络抖动、排队、限流和资源争用下的完整 latency/cost 曲线。
第二,实验规模偏小。 下棋只有 5 次、每次 30 steps,误差条很大;电商和检索的数字也强依赖 prompt、模型版本及 API 服务状态。它更像 proof of concept,而不是稳定的 production benchmark。
第三,理论假设比较理想。 推导假设各分支独立、API 延迟服从指数分布、状态转换与参数构造开销可忽略。真实 Agent 的候选高度相关,API 还可能有 batch、cache、排队和 rate limit,公式适合提供方向,不适合直接拿来做容量规划。
第四,lossless 只覆盖了可安全预执行的那部分 action。 查询类工具最合适;写操作越多、外部副作用越重,能投机的比例越低。对支付、消息发送、权限修改这类操作,默认策略应该是禁止,而不是“先做了再回滚”。
第五,额外调用可能带来新风险。 即使错误分支最终没提交,它仍可能把数据发给第三方 API、留下访问日志、触发计费或暴露用户尚未表达的敏感意图。语义不可见不等于系统不可见。
13. 什么样的 Agent 最值得接 Speculative Actions
可以先用下面五个问题筛选:
- 下一 action 是否低熵? 历史状态下通常只有少数几种合理工具调用,才容易预测。
- Actor 与环境调用是否真的慢? 如果本地函数 10 ms 就返回,speculation 调度成本可能更高。
- 是否存在天然空闲窗口? 用户输入、远程搜索、慢 reasoning、对手回合,都是很好用的 overlap window。
- 错误分支是否安全? read-only、幂等、可逆、沙箱内执行,至少满足一个。
- 额外资源是否便宜? 需要把 token、API 费用、连接数、rate limit 和主路径干扰一起算进去。
满足前四项却不满足第五项时,优先做 confidence threshold;只有高置信候选才启动。下一步再考虑根据实时负载动态调整 k,而不是永远固定 top-3。
如果要做成真正的通用运行时,还需要补上四个模块:canonical action 表示、side-effect policy、资源预算器,以及可观测性。后者至少要同时记录 speculative-window 命中率、总 step 命中率、隐藏掉的实际 latency、被浪费的调用成本和 Actor 被拖慢的时间。只看一个 accuracy,很容易把账算错。
14. 总结
Speculative Actions 最有意思的地方,是把一个已经在 CPU 和 LLM decoding 里验证过很多次的原则,搬到了 Agent 的系统边界:
不要让昂贵资源干等确定性;先用便宜资源探索少量高概率未来,再由权威结果决定提交哪一条。
它在国际象棋里用 54.7% 的 action 命中率换来 19.5% 的真实省时,在电商和多跳检索里证明下一次 API 调用确实有相当概率可预测,又用 OS 调参展示了“快模型反应、慢模型纠偏”的控制范式。
但这不是免费的 20% 加速按钮。它把 latency 换成了并发、token、缓存一致性和副作用治理;所谓 lossless,也建立在“验证后提交”和“错误分支安全可丢弃”之上。
真正落地时,最关键的往往不是再训一个更强 Speculator,而是三件更朴素的事:把 action 规范化、把不可投机的副作用圈出来、把每个额外分支的账算清楚。
论文把门推开了,后面更像是一个系统问题。
本文依据论文 v2及其开源实现整理,原始内容均经过转述,未大段复制原文。
顺带一提,这篇工作优化的是 Agent 运行时里的等待与并发;《动手学 AutoML:从 NAS 到大语言模型优化实战》没有直接覆盖这套 Agent runtime 工程,但书里讨论了 LLM 压缩、LLM 驱动的 AutoML,以及如何把“效果、效率和搜索成本”放到同一套优化视角里。两者角度不同,目标倒是很接近:不是只追一个更大的模型,而是把完整系统的预算花在真正有收益的地方。
