说人话理解文本 Diffusion:图像去噪为什么不能直接搬到 token 上?
说人话理解文本 Diffusion:图像去噪为什么不能直接搬到 token 上?
Diffusion 最容易让人产生一种“懂了但没完全懂”的感觉。
图像里,它从一团 Gaussian noise(高斯噪声)出发,一步步去噪,最后生成一张图片。到了文本里,很多模型又从一串 [MASK] 出发,一轮轮把词填回来。两个过程看着确实很像,于是很容易得出一个结论:文本 Diffusion 不就是把图像里的像素换成 token 吗?
问题恰恰出在这里。
像素是连续数值,往里面加一点噪声,它仍然是一张合法的、只是更模糊的图;token id 只是词表里的编号,给它加上 0.1 没有任何语言学意义。cat 的 id 是 1523,dog 的 id 是 891,并不代表 1207 就是“半只猫加半只狗”。
所以真正值得讲清楚的,不是再背一遍 DDPM(Denoising Diffusion Probabilistic Model,去噪扩散概率模型)的所有公式,而是下面这条主线:
图像和文本 Diffusion 复用了同一种生成思路,但因为数据空间不同,它们必须用完全不同的方式破坏信息、预测信息和恢复信息。
本文就沿着这条线往下走:先看两者共用的骨架,再从逐步 Gaussian transition 推导出图像 Diffusion 的核心公式;接着看为什么 token 空间不能直接照搬这套公式,以及 masked text diffusion 在训练和推理时到底怎样更新每一个位置。最后再回答文本 Diffusion 和自回归 LLM 到底差在哪。
1. Diffusion 真正复用的不是“噪声”,而是“先破坏,再修复”
生成模型要学习的是真实数据分布:什么样的像素组合像一张照片,什么样的 token 组合像一句人话。
难点在于,这个分布太复杂了。让模型一步把随机变量变成一张完整图片或一段通顺文本,相当于要求它一次完成从“什么都没有”到“所有细节都正确”的大跳跃。
Diffusion 换了一种解题方式:先人为设计一条逐渐丢失信息的路径,再让模型学习如何把每一小步丢掉的信息找回来。
这套框架只有四个核心动作:
- 从真实样本 $x_0$ 出发;
- 随机选择一个破坏程度 $t$,直接构造 $x_t$;
- 让模型根据 $x_t$ 和 $t$ 预测被破坏的信息;
- 生成时从最坏的状态 $x_T$ 出发,反复调用同一个模型,逐步回到数据空间。
先看下面这张总览图。怎么读:先看上半区「训练」,再看下半区「推理」。上半区强调一次只解一道随机难度的局部题,下半区强调要从最坏状态逐步走回数据。
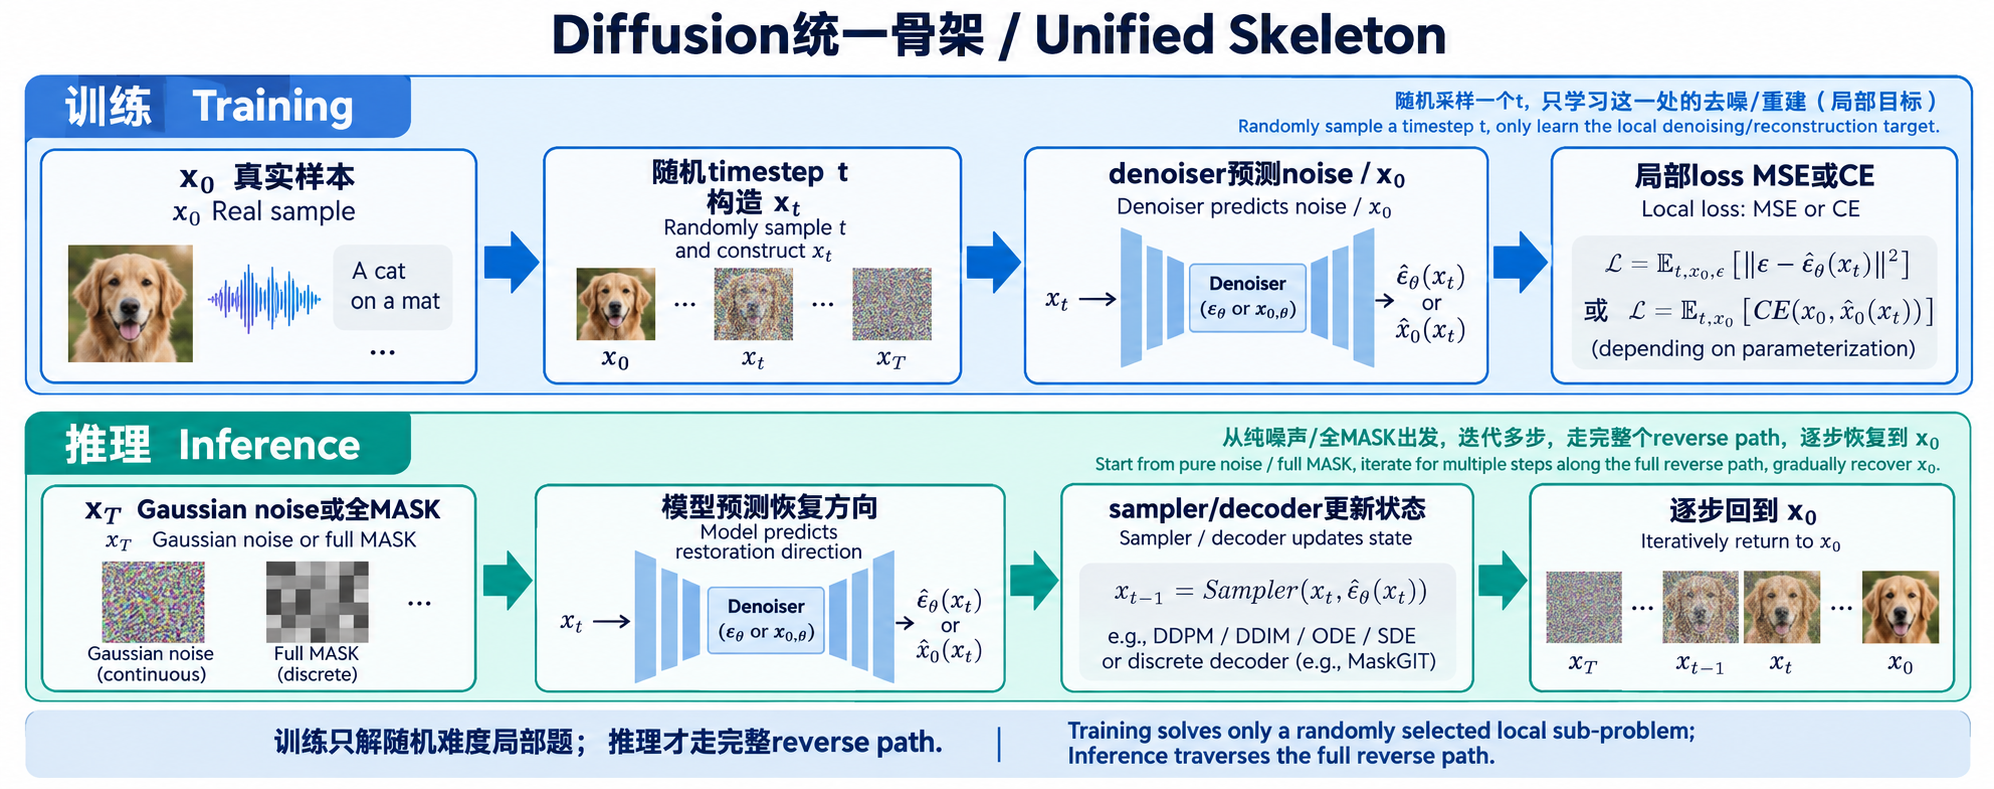
对着图走一遍:训练带从 $x_0$ 出发,随机抽 $t$ 直接构造 $x_t$,denoiser 预测被破坏的信息,再用 MSE 或 Cross-Entropy 做局部 loss;推理带则从 $x_T$(Gaussian noise 或全 [MASK])出发,反复调用同一个模型,经 sampler / decoder 更新到 $x_0$。同一套模型可以换不同的 sampler 或 decoding policy,换的是步法,不是 denoiser 本身。
这里最关键、也最容易被一堆推导淹没的事实是:
训练通常只解一道随机难度的局部恢复题,推理才需要连续走完整条反向路径。
训练时不需要先加噪 1000 次再去噪 1000 次。只要我们能直接从 $x_0$ 采样任意时刻的 $x_t$,一次训练迭代只做一次模型 forward 和一次 loss。
因此,“Diffusion 是什么”并不取决于噪声必须长什么样。Gaussian noise、[MASK]、随机类别替换都可以是 corruption——也就是人为规定的信息破坏方式。真正共用的是:把一次困难的全局生成,拆成一系列可学习的局部恢复。
这个抽象骨架解释了图像和文本为什么看起来相似。接下来真正的分岔点是:$x$ 到底生活在什么空间里?
2. 图像为什么能直接加 Gaussian noise:从逐步转移推导出 $x_t$
图像可以表示成连续像素,也可以先经过 Variational Autoencoder(VAE,变分自编码器)压缩成连续 latent。latent 可以理解成尺寸更小、但仍保留主要视觉信息的连续表示。
无论是在 pixel 还是 VAE latent 上做扩散,关键性质都一样:它是连续向量。连续向量之间存在有意义的“近”和“远”,所以可以定义一条平滑的破坏路径。
2.1 先规定每一步只破坏一点点
DDPM 的 forward process 不是一下子把图片变成噪声,而是把它拆成很多个很小的 Gaussian transition:
\[q(x_t\mid x_{t-1})=\mathcal N\left(\sqrt{\alpha_t}x_{t-1},\;\beta_t I\right),\]其中:
\[\alpha_t=1-\beta_t.\]把它展开成采样形式,就是:
\[x_t=\sqrt{\alpha_t}x_{t-1}+\sqrt{\beta_t}\epsilon_t, \qquad \epsilon_t\sim\mathcal N(0,I).\]这里的 $\beta_t$ 是第 $t$ 步的 noise schedule:它决定当前这一步加入多少噪声;$\alpha_t$ 则表示这一小步还保留多少上一时刻的信号。
为什么要这样设计?并不是因为 Gaussian 看起来高级,而是因为它有三个非常实用的性质:
- 每一步的随机扰动都很简单;
- 多个独立 Gaussian 的线性组合仍然是 Gaussian;
- 连续走很多步以后,可以解析地得到任意时刻的分布,而不必真的把前面的每一步都执行一遍。
第一点保证了 corruption 容易采样,第二点保证了公式能合并,第三点直接决定了训练效率。
2.2 两步展开:为什么噪声最后仍然可以合并
先看前两步:
\[x_1=\sqrt{\alpha_1}x_0+\sqrt{\beta_1}\epsilon_1,\] \[x_2=\sqrt{\alpha_2}x_1+\sqrt{\beta_2}\epsilon_2.\]把 $x_1$ 代进第二式:
\[\begin{aligned} x_2 &=\sqrt{\alpha_2}\left(\sqrt{\alpha_1}x_0+\sqrt{\beta_1}\epsilon_1\right)+\sqrt{\beta_2}\epsilon_2\\ &=\sqrt{\alpha_1\alpha_2}x_0 +\sqrt{\alpha_2\beta_1}\epsilon_1 +\sqrt{\beta_2}\epsilon_2. \end{aligned}\]$\epsilon_1$ 和 $\epsilon_2$ 都是独立的标准 Gaussian。两个独立 Gaussian 的加权和仍然是 Gaussian,只需要重新计算方差:
\[\alpha_2\beta_1+\beta_2 =\alpha_2(1-\alpha_1)+1-\alpha_2 =1-\alpha_1\alpha_2.\]于是可以把两份噪声合并成一份新的标准 Gaussian $\epsilon$:
\[x_2=\sqrt{\alpha_1\alpha_2}x_0+\sqrt{1-\alpha_1\alpha_2}\epsilon.\]同理,定义:
\[\bar\alpha_t=\prod_{s=1}^{t}\alpha_s,\]就能得到任意时刻的 closed form:
\[\boxed{ x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon, \qquad \epsilon\sim\mathcal N(0,I) }\]这条公式里最容易疑惑的是:为什么信号和噪声前面是平方根,而不是直接用 $\bar\alpha_t$ 和 $1-\bar\alpha_t$?
因为 $\bar\alpha_t$ 和 $1-\bar\alpha_t$ 描述的是方差比例,而 $x_0$ 和 $\epsilon$ 是向量本身,乘在向量前面的系数必须是标准差,也就是方差的平方根。这样组合之后,信号方差和噪声方差才分别对应 $\bar\alpha_t$ 与 $1-\bar\alpha_t$,总方差保持在合理尺度。
这张图把上面的推导压成三栏。怎么读:左栏看逐步 forward,中栏看信号/噪声分解和数字例子,右栏对照训练与推理为什么路径不同。
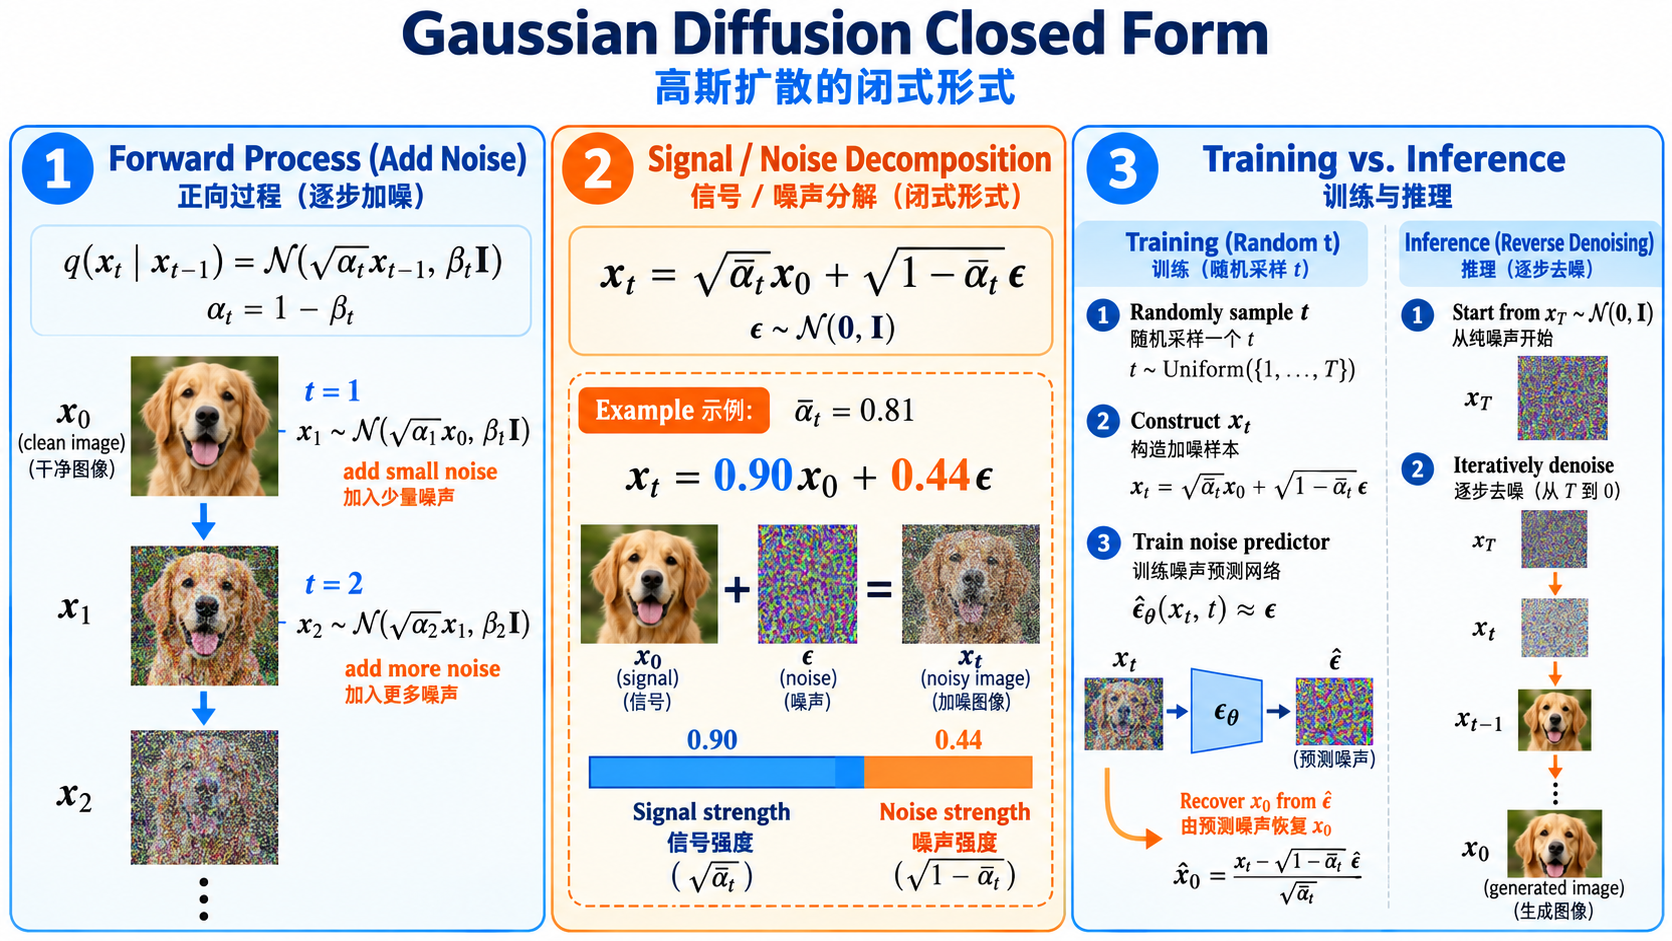
左栏对应 $q(x_t\mid x_{t-1})$ 的单步加噪;中栏就是 closed form $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon$,并用 $\bar\alpha_t=0.81$ 给出 $0.90x_0+0.44\epsilon$;右栏提醒:训练可以随机抽一个 $t$ 一次构造 $x_t$,推理却必须从 $x_T$ 一步步走回 $x_0$。
2.3 用一个数字例子看清楚 $\bar\alpha_t$
假设某个时刻:
\[\bar\alpha_t=0.81.\]那么:
\[\sqrt{\bar\alpha_t}=0.9, \qquad \sqrt{1-\bar\alpha_t}=\sqrt{0.19}\approx 0.436.\]此时:
\[x_t\approx 0.90x_0+0.436\epsilon.\]这句话可以直接翻译成人话:当前状态里,原始图像还保留了比较强的信号,另外混进了一份幅度约为 0.436 的随机噪声。
如果 $\bar\alpha_t$ 继续变小到接近 0,那么第一项会越来越弱,第二项会越来越接近一份完整的 Gaussian noise。反过来,当 $\bar\alpha_t$ 接近 1 时,$x_t$ 就接近原图 $x_0$。
所以 $t$ 本质上不是“第几次循环”这么简单,它还对应了一个信号强度:$t$ 越大,$\bar\alpha_t$ 越小,当前状态越接近纯噪声。
2.4 为什么训练时可以随机抽一个 $t$
有了 closed form,训练时可以直接根据 $x_0$、随机 timestep $t$ 和一份随机噪声构造 $x_t$:
# class GaussianDiffusionTrainer
# def q_sample(x0, t):
# 输入:x0 [B, C, H, W] 或 [B, L, D],t [B]
# 输出:xt 和本次真正加入的 eps,二者 shape 与 x0 相同

def q_sample(x0, t, alpha_bar):
    eps = torch.randn_like(x0)
    alpha_bar_t = alpha_bar[t].view(-1, 1, 1, 1)
    signal_scale = alpha_bar_t.sqrt()
    noise_scale = (1.0 - alpha_bar_t).sqrt()
    xt = signal_scale * x0 + noise_scale * eps
    return xt, eps
这里的 alpha_bar[t] 原本只有 [B] 个数,view(-1, 1, 1, 1) 是为了让它能够沿 channel、height、width 维度 broadcast。对 [B, L, D] 的 embedding 也一样,只是 reshape 成 [B, 1, 1]。
这不是一个近似技巧。因为上面的 closed form 与连续执行 $q(x_1\mid x_0),\,q(x_2\mid x_1),\ldots$ 得到的是同一个边缘分布 $q(x_t\mid x_0)$,所以训练可以随机抽 $t$,直接得到这道局部恢复题。
2.5 预测噪声为什么能帮助恢复原图
模型常见的参数化不是直接预测 $x_0$,而是预测当初混进去的噪声 $\epsilon$:
\[\hat\epsilon=\epsilon_\theta(x_t,t,c).\]其中 c 是可选条件,例如文字 prompt。训练目标是:
为什么预测噪声能和“恢复图片”连起来?直接把 closed form 移项即可:
\[x_0 =\frac{x_t-\sqrt{1-\bar\alpha_t}\epsilon}{\sqrt{\bar\alpha_t}}.\]所以模型得到 $\hat\epsilon$ 后,就能计算一个 $x_0$ 的估计:
\[\hat x_0 =\frac{x_t-\sqrt{1-\bar\alpha_t}\hat\epsilon} {\sqrt{\bar\alpha_t}}.\]对应的 PyTorch-style 代码如下:
# class GaussianDiffusionTrainer
# def training_step(x0, condition):
# 输入:x0 [B, C, H, W],condition 是可选文本条件
# 返回:用于更新 denoiser 参数的标量 loss

def training_step(model, x0, alpha_bar, condition=None):
    batch_size = x0.shape[0]
    t = torch.randint(
        low=0,
        high=len(alpha_bar),
        size=(batch_size,),
        device=x0.device,
    )

    xt, eps = q_sample(x0, t, alpha_bar)
    eps_hat = model(xt, t, condition)
    loss = F.mse_loss(eps_hat, eps)

    # 这个估计值不是额外的监督标签,而是由 eps_hat 反推出 x0
    alpha_bar_t = alpha_bar[t].view(-1, 1, 1, 1)
    x0_hat = (
        xt - (1.0 - alpha_bar_t).sqrt() * eps_hat
    ) / alpha_bar_t.sqrt()
    return loss, x0_hat
实际系统也可以预测 $x_0$ 或 v,这属于不同的 parameterization。它们改变的是网络输出代表什么,不改变“从 $x_t$ 推断更干净状态”的主线。
2.6 reverse sampling 在做什么
训练时我们可以随机抽任意 $t$,但推理时只有一份起点 $x_T$,必须逐步回到 $x_0$。因此 reverse process 需要一个条件分布:
\[p_\theta(x_{t-1}\mid x_t).\]在 DDPM 中,模型先根据 $x_t$ 预测噪声或 $x_0$,再据此计算 reverse transition 的均值和方差,然后采样出下一状态 $x_{t-1}$。常见写法是:
\[p_\theta(x_{t-1}\mid x_t) =\mathcal N\left(\mu_\theta(x_t,t),\;\Sigma_t\right).\]这里的 denoiser 负责提供“应该往哪里走”的信息,sampler 负责把这个信息变成一次具体的状态更新。DDPM、DDIM、ODE sampler 的差异,主要就在于这条 reverse path 如何更新、是否注入随机性、使用多少步。
因此要区分两件事:
- 训练:从真实 $x_0$ 随机制造一个 $x_t$,做一次局部预测;
- 推理:从 $x_T$ 开始,根据 sampler 反复计算 $x_{t-1}$。
U-Net 或 Diffusion Transformer(DiT)负责充当 denoiser,也就是“看着当前这团噪声,判断该往哪个方向修”的模型;DDPM、DDIM 或其他 sampler 则决定推理时每一步怎么走。
这两个角色不要混在一起:
- denoiser 提供方向;
- sampler 决定步法。
同一个 checkpoint 能切换不同 sampler,就是因为模型本身没换,只是反向路径的走法变了。
到这里,图像 Diffusion 的主线已经够用了:连续表示允许平滑加噪,模型回归连续目标,sampler 再用多步连续更新把噪声还原成图像。
但这套方案一旦照搬到 token id,第一步就走不通。
3. Token 没有“加一点噪声”的中间状态
图像像素从 0.7 变成 0.6,含义仍然连续;token id 从 1523 变成 1523.1,却不对应任何合法 token。
更麻烦的是,token id 之间没有语义距离。编号相邻的两个 token,语义可能毫无关系;语义相近的两个 token,编号也可能相隔很远。直接对 id 加 Gaussian noise,只是在破坏编号,不是在逐渐破坏语言信息。
因此,文本 Diffusion 必须先回答一个建模问题:
到底在哪个空间里做 Diffusion?
目前最典型的答案有两种:
- 把 token 变成连续 embedding,然后在 embedding 空间加噪;
- 始终留在离散 token 空间,用
[MASK]或类别替换来丢失信息。
第一条路线尽量继承图像 Diffusion 的数学;第二条路线则承认文本是离散对象,重新设计一套更符合 token 结构的 corruption。
这不是两种无关技巧,而是同一个矛盾下的两种取舍:要么方便扩散,要么方便落回真实 token。
4. 连续文本 Diffusion:扩散容易了,最后却要“硬着陆”
Diffusion-LM 采用的是第一条路线:先把 token id 映射成连续 embedding,再在 embedding 上使用类似图像的 Gaussian diffusion。
token ids [B, L]
    ↓ embedding
连续表示 [B, L, d]
    ↓ 加噪与多步去噪
连续表示 [B, L, d]
    ↓ 映射回词表
输出 token ids [B, L]
这样做的好处很直接:图像 Diffusion 的大量公式、训练目标和连续控制方法都能复用。模型也可以使用双向 Transformer,让每个位置同时看到左右文,而不是像自回归模型那样只能看左边。
但问题被推迟到了最后一步。
去噪完成后,每个位置得到的是一个 d 维连续向量,真正需要输出的却是某个离散 token。最直接的做法,是在整个词表的 embedding 中寻找与它最接近的向量:
这一步叫 rounding,直观上就是把连续结果“取整”回词表。
下图专门拆这一步硬着陆。怎么读:从左往右顺着 token → embedding → 加噪去噪 → rounding,重点看最后那个橙色强调框。
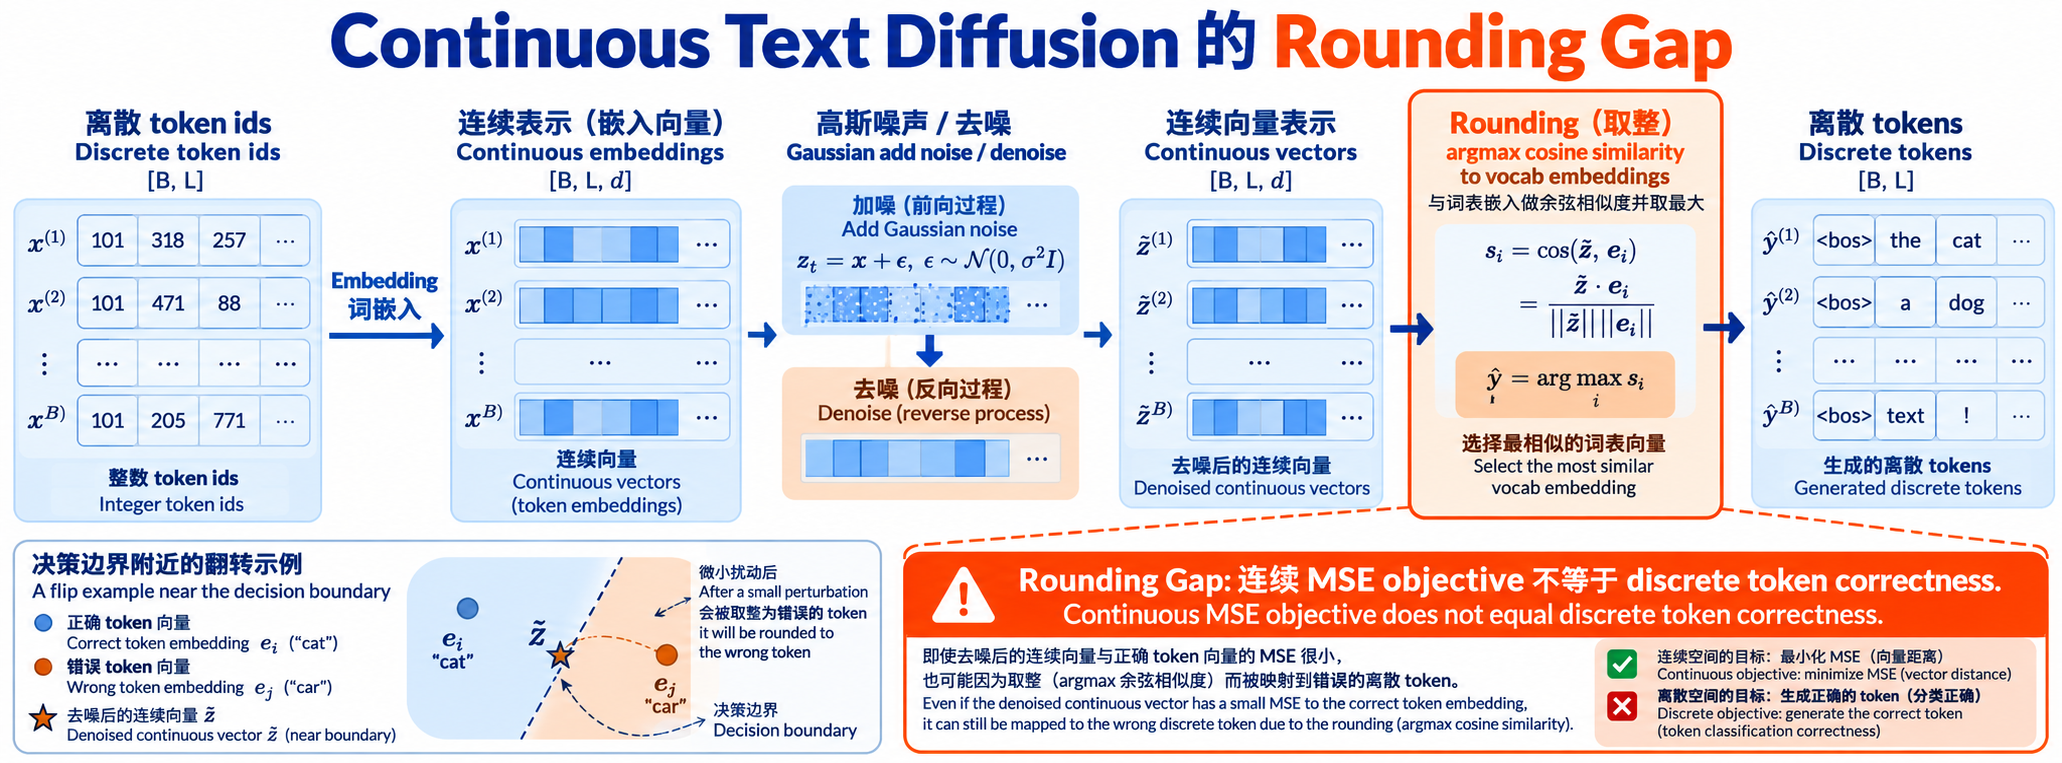
图里前半段都还在连续空间里打转,最后一跳才用最近邻把向量映射回词表。一个向量即使在连续空间里的 MSE 很小,也可能刚好跨过词表的决策边界,落到另一个 token 上。反过来,某些数值误差很大的向量,rounding 后却可能仍然得到正确 token。一个向量即使在连续空间里的 MSE 很小,也可能刚好跨过词表的决策边界,落到另一个 token 上。反过来,某些数值误差很大的向量,rounding 后却可能仍然得到正确 token。
连续空间里的优化目标,与离散文本的最终质量并不完全对齐。
这就是 continuous text diffusion 的核心矛盾:
- 搬到 embedding 空间后,加噪和去噪都顺手了;
- 但生成结果必须重新落回离散词表,中间出现了 rounding gap。
既然问题来自“连续表示最终还要转回 token”,另一条路线就干脆不离开 token 空间。
5. Masked Diffusion:不再给 token 加噪,而是逐渐拿走答案
离散 Diffusion 把“噪声”重新定义成 token 层面的信息缺失。
最直观的做法是 masked diffusion:随着破坏程度增加,每个位置以更高概率被替换为 [MASK]。
t = 0     Diffusion models generate text differently
t = 0.4   Diffusion [MASK] generate text [MASK]
t = 0.8   [MASK] [MASK] generate [MASK] [MASK]
t = 1.0   [MASK] [MASK] [MASK] [MASK] [MASK]
这里没有任何非法的“半个 token”。每个位置要么保留原 token,要么变成 [MASK],始终处于离散词表中。
5.1 forward corruption:每个位置独立决定是否丢失
如果用 $m(t)$ 表示时刻 $t$ 的 mask 概率,那么一个常见的 absorbing-mask forward process 可以写成:
\[x_t^i= \begin{cases} [MASK], & \text{with probability }m(t),\\ x_0^i, & \text{otherwise}. \end{cases}\]实现上,可以把每个位置看成一次 Bernoulli trial:
# class MaskCorruptor
# def corrupt(x0, t):
# 输入:x0 [B, L],每个元素是 token id;t [B]
# 输出:xt [B, L]、mask [B, L]

def corrupt(x0, t, mask_schedule, mask_id):
    mask_rate = mask_schedule(t)          # [B]
    random_value = torch.rand_like(x0, dtype=torch.float32)
    mask = random_value < mask_rate[:, None]
    xt = torch.where(mask, mask_id, x0)
    return xt, mask
例如,长度为 8 的序列:
x0:    Diffusion models generate text now
mask:  0        1      0       1        0    0    1   0
xt:    Diffusion [MASK] generate [MASK] text now [MASK] ...
$m(t)$ 需要随着 $t$ 增大而整体增大。线性 schedule 只是最容易说明的一种选择,实际模型也可以使用非线性 schedule,甚至直接学习破坏率。需要注意的是,Bernoulli 采样是随机的,因此“$m(t)=0.5$”表示平均一半位置被 mask,不代表每条样本都严格 mask 一半位置。
5.2 训练到底预测什么
训练时随机抽一个 $t$,根据 $m(t)$ 得到 $x_t$,然后让双向 Transformer 预测被遮住位置的原始 token。
如果 batch size 是 B,序列长度是 L,词表大小是 V,那么模型输出的 logits shape 是:
例如 logits[2, 5, 891] 表示第 3 个样本、第 6 个位置选择 token id 891 的未归一化分数。对最后一个维度做 softmax,就能得到每个位置的词表概率。
loss 通常只在 mask 位置计算:
\[\mathcal L =-\frac{1}{|M|} \sum_{i\in M}\log p_\theta(x_0^i\mid x_t,t),\]其中 M 是本次被 mask 的位置集合。原因很简单:未 mask 的位置答案已经直接放在输入里了,如果把它们也作为主要 loss,模型会得到大量“把输入复制出来”的简单题,真正需要恢复的未知位置反而被稀释。
对应的简化代码是:
# class MaskedDiffusionLM
# def training_step(x0, t):
# 输入:x0 [B, L]
# 返回:masked positions 上的标量 Cross-Entropy loss

def training_step(model, x0, t, mask_schedule, mask_id):
    xt, mask = corrupt(x0, t, mask_schedule, mask_id)
    logits = model(xt, t)                 # [B, L, V]

    masked_logits = logits[mask]          # [num_masked, V]
    masked_targets = x0[mask]             # [num_masked]
    loss = F.cross_entropy(masked_logits, masked_targets)
    return loss
这里的 Cross-Entropy(交叉熵)检查的是:模型有没有把原 token 的概率分配得足够高。它与图像 Diffusion 中的 MSE 对应,但预测对象不同:一个是词表分类分布,一个是连续噪声向量。
5.3 它和 BERT 的 Masked Language Modeling 有什么不同
看到这里很容易问:这不就是 BERT 吗?
训练形式确实很像,但目标不同。BERT 的 Masked Language Modeling(MLM,遮住部分 token 再预测)主要用来学习文本表示,mask 比例通常集中在固定范围;masked diffusion 会覆盖从轻度破坏到接近全 [MASK] 的完整噪声范围,还定义了如何从全 [MASK] 逐步生成完整序列,因此它是一个生成过程。
更准确地说:MLM 提供了一道“从局部缺失恢复文本”的训练题;masked diffusion 还需要把不同破坏程度串成一条可执行的生成路径。
6. Masked Diffusion 推理:哪些 token 会被确定,哪些 token 还能改?
推理从全 [MASK] 开始。每轮 Transformer 都会同时给所有位置输出词表分布,然后 decoder 根据候选 token 的 confidence 决定这一轮接受什么。
先看一个直观例子:
第 0 轮:[MASK] [MASK] [MASK] [MASK] [MASK] [MASK]
第 1 轮:the    [MASK] sat    [MASK] on     [MASK]
第 2 轮:the    cat    sat    [MASK] on     mat
第 3 轮:the    cat    sat    on     the    mat
但这里隐藏了一个非常关键的问题:第 1 轮写进去的 the、sat 和 on,下一轮还会不会被修改?
答案不是一个统一的“会”或“不会”,而是取决于 decoding policy,也就是推理阶段的状态更新规则。
6.1 每一轮实际上维护哪些状态
可以把 decoder 看成一个状态机。它至少要维护下面几类 tensor:
-
state_ids [B, L]:当前序列,里面既可能有真实 token,也可能有MASK_ID; -
fixed [B, L]:某个位置是否已经被当前策略冻结; -
candidate_ids [B, L]:本轮 logits 的 argmax 或采样结果; -
confidence [B, L]:候选 token 的可信程度; -
active_mask [B, L]:本轮仍允许被重新预测的位置; -
next_mask_count [B]:下一轮还准备保留多少个未知位置。
candidate_ids 不是“模型最终决定的答案”,只是模型在当前上下文下给出的候选。真正把候选写回 state_ids,还要经过 decoder 的接受策略。
下面这张对比图把两种策略画在同一串 token 上。怎么读:左边是冻结式,右边是可回滚 remask;绿色是本轮接受,琥珀色是继续保持 [MASK],锁表示已冻结。
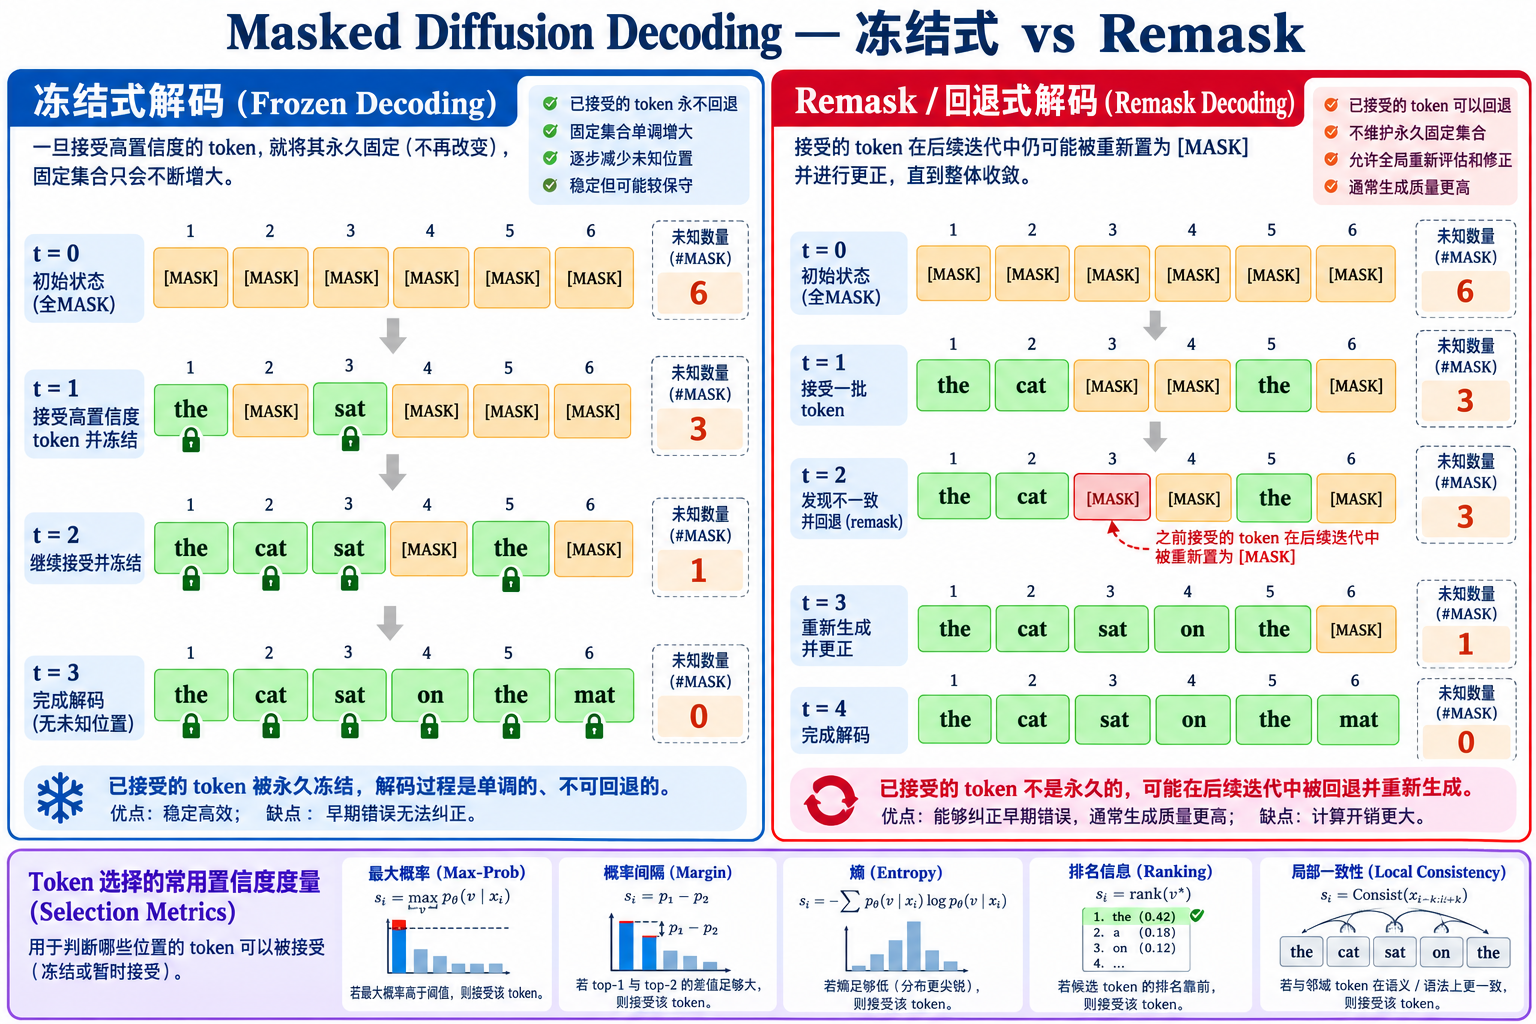
左栏里,高置信度 token 一旦写入就加锁,fixed 只增不减,未知位置数单调下降;右栏里,已经写入的 token 仍可能在后续轮次被重新 mask,然后再改。底部那条图例对应常见选择指标:max probability、margin、entropy、ranking 和局部一致性。
6.2 confidence 到底是什么
最常见的 confidence 是候选 token 的最大 softmax 概率:
\[\text{confidence}_i =\max_v p_\theta(v\mid x_t,t)_i.\]也可以使用:
- margin:第一名概率与第二名概率的差距;
- entropy:整个词表分布的不确定性,entropy 越低通常越集中;
- rank:候选 token 在词表分布中的排名;
- 局部一致性:候选 token 放回当前序列后,是否与相邻 token、语法或约束相容。
这些指标都只是“当前状态下的可信程度”,并不等于绝对正确。一个 token 可能以很高 confidence 被提前写入,但后面发现它与其他位置组合起来不一致,这也是 remask 或回滚策略存在的原因。
6.3 冻结式 decoding:一旦接受,后续不再修改
冻结式 decoding 的规则最简单:本轮在尚未冻结的位置上排名,保留一部分最低 confidence 的位置继续 [MASK],其余位置写入候选 token 并加入 fixed。下一轮只对没有冻结的位置做预测。
假设长度为 8 的序列,未知位置数可以按照:
8 -> 5 -> 3 -> 1 -> 0
逐轮减少。这个 schedule 只是示例,真实模型可以根据 timestep、预算或置信度动态决定。
# class FrozenMaskDecoder
# def decode(model, seq_len, max_steps):
# 输入:序列长度和最大去噪轮数
# 返回:state_ids [B, L],所有位置都已确定或达到停止条件

def decode_frozen(model, batch_size, seq_len, mask_id, max_steps):
    state_ids = torch.full(
        (batch_size, seq_len), mask_id, dtype=torch.long, device=model.device
    )
    fixed = torch.zeros_like(state_ids, dtype=torch.bool)

    for step in range(max_steps):
        logits = model(state_ids, timestep=step)   # [B, L, V]
        probs = logits.softmax(dim=-1)
        candidate_ids = probs.argmax(dim=-1)       # [B, L]
        confidence = probs.amax(dim=-1)             # [B, L]

        active = ~fixed
        remaining = active.sum(dim=-1)              # [B]
        next_mask_count = schedule_mask_count(
            step, max_steps, remaining
        )

        # 只在尚未冻结的位置里,选出下一轮继续保持 MASK 的位置
        active_confidence = confidence.masked_fill(~active, float("inf"))
        keep_mask = select_lowest_k(
            active_confidence, active, next_mask_count
        )                                             # [B, L]
        accept = active & ~keep_mask

        # 接受的位置写入候选 token;keep_mask 位置继续保持 MASK
        state_ids = torch.where(accept, candidate_ids, state_ids)
        state_ids = torch.where(keep_mask, mask_id, state_ids)
        fixed = fixed | accept

        if not active.any():
            break

    return state_ids
这里的核心不是 select_lowest_k 的具体实现,而是状态单调变化:
因此,在冻结式 decoding 中,已经确定的 token 不会再被修改。优点是实现简单、状态容易分析;缺点也很明显:如果早期错误地接受了一个高 confidence token,后面没有机会纠正它。
6.4 可回滚 decoding:已写入 token 也可能重新被 mask
另一类策略不维护永久的 fixed 集合,而是允许每轮重新评估已经写入的 token。某个位置即使上一轮已经有了 token,只要本轮 confidence 下降、与局部上下文冲突,或者按照 rank 被选入不稳定集合,就可以重新变回 [MASK]。
简化地说,状态更新可以是:
# class RemaskDecoder
# def decode_one_step(model, state_ids, timestep):
# 输入:当前 state_ids [B, L]
# 输出:允许下一轮继续修改的 state_ids [B, L]

def decode_one_step_remask(model, state_ids, timestep, mask_id):
    logits = model(state_ids, timestep=timestep)  # [B, L, V]
    probs = logits.softmax(dim=-1)
    candidate_ids = probs.argmax(dim=-1)
    confidence = probs.amax(dim=-1)

    # 这里的 unstable 可以由 threshold、bottom-k、entropy 等规则得到
    unstable = choose_unstable_positions(confidence, probs)
    stable = ~unstable

    next_state = state_ids.clone()
    next_state[stable] = candidate_ids[stable]
    next_state[unstable] = mask_id
    return next_state
这时上一轮写入的 token 仍可能被下一轮覆盖,所以:
\[\text{fixed}_{t+1}\not\supseteq\text{fixed}_t\]甚至可以不定义 fixed,而只维护当前 state_ids 和下一轮的 unstable positions。
可回滚策略的优点是能够修正早期错误,缺点是状态不再单调,推理轮数和行为分析都更复杂。它尤其适合那些需要多轮全局协调的场景,但也会增加重复计算。
6.5 混合策略:高置信度冻结,低置信度继续观察
实践中还经常使用混合策略:
- confidence 高于阈值的位置冻结;
- confidence 较低的位置保持
[MASK]; - 已经写入、但 confidence 后续下降的位置允许回滚;
- 或者只冻结某些 block,其他 block 保持可修改。
所以用户最关心的两个问题,可以直接回答:
- 每次哪些 token 确定不再改动?
- 冻结式策略:本轮在 active positions 中,除最低 confidence 的保留位置外,其余被接受的位置加入
fixed; - 可回滚策略:没有永久不变的位置,是否接受由下一轮状态继续决定;
- 混合策略:通常由 confidence 阈值、排名、mask schedule 和局部一致性共同决定。
- 冻结式策略:本轮在 active positions 中,除最低 confidence 的保留位置外,其余被接受的位置加入
- 确定了的 token 下次还会被修改吗?
- 冻结式 decoding:不会;
- 可回滚/remask decoding:会,低 confidence 或不稳定位置可以重新变为
[MASK]; - 训练目标本身不规定答案,冻结与否属于 decoding policy / sampler 的选择。
这也是为什么不能只看训练代码就推断推理行为。训练只定义“给定部分缺失的序列,预测原始 token”;哪些预测结果被接受、何时 remask、下一轮保留多少未知位置,是另一个层面的采样设计。
7. 图像和 Masked Text Diffusion 的训练/推理差异
到这里可以并排对照了。怎么读这张图:左列走连续图像路径,右列走 masked 文本路径;先比数据状态和 corruption,再比输出、loss 和单步恢复方式。
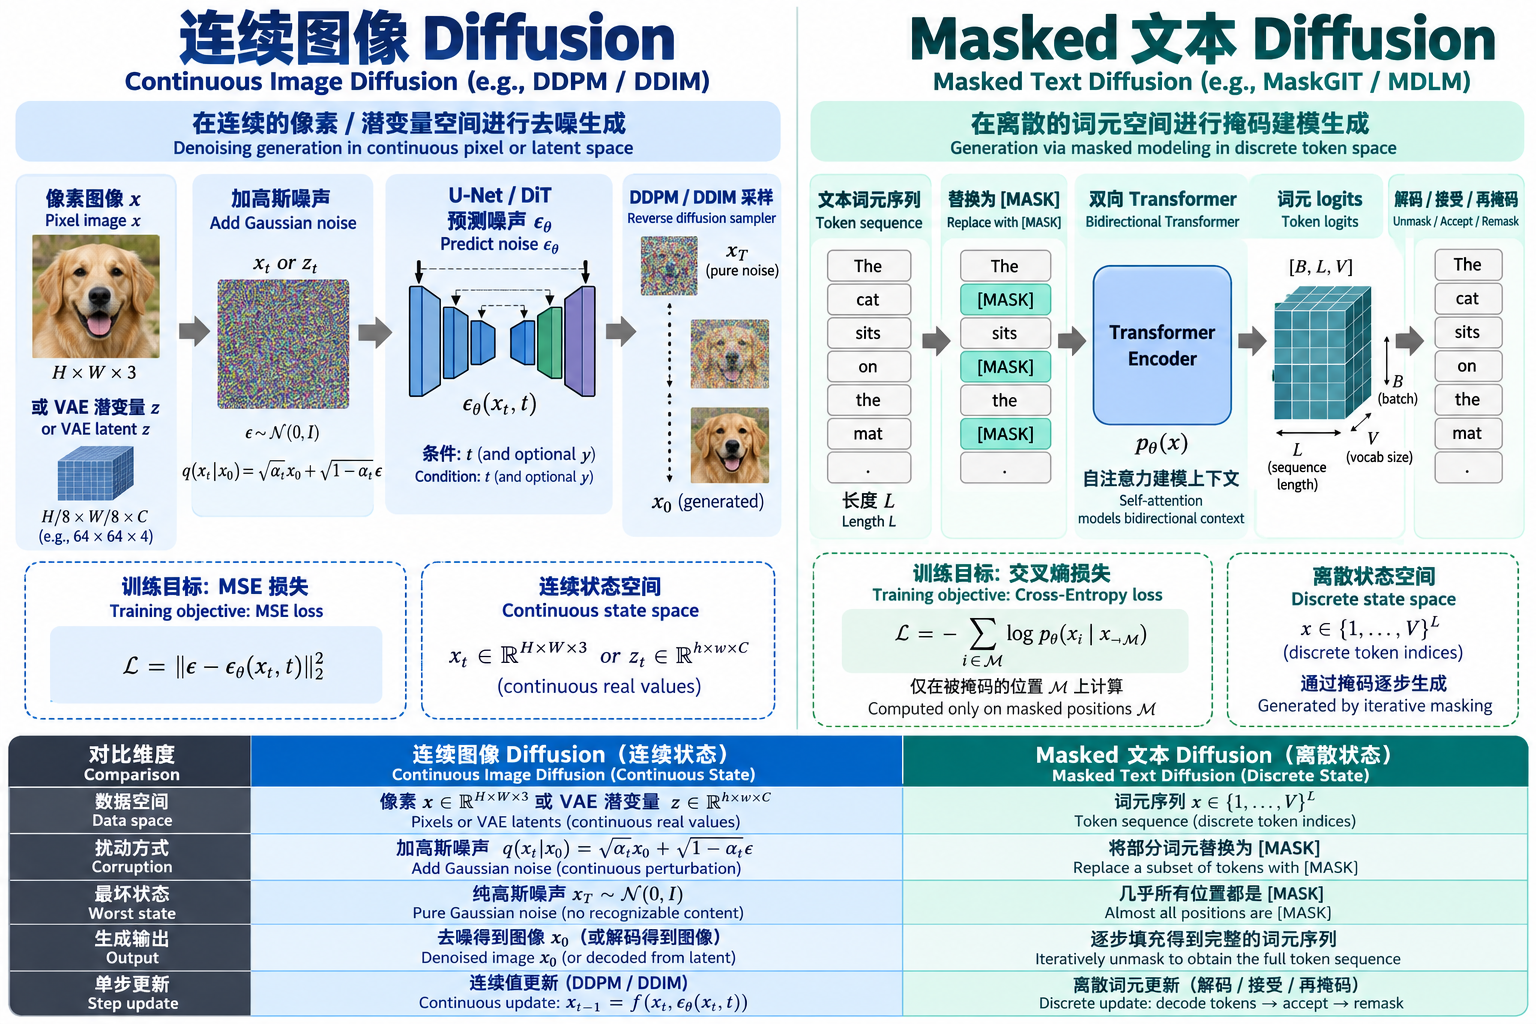
左列是 pixel / VAE latent、Gaussian noise、MSE、连续数值更新;右列是 token 序列、[MASK]、Cross-Entropy、accept / unmask / remask。两边都在恢复被破坏的信息,但概率对象已经换了。对照表把同一套差异再压成几行:
| 环节 | 连续图像 Diffusion | Masked 文本 Diffusion |
|---|---|---|
| 数据状态 | pixel 或 VAE latent | token 序列 |
| 破坏方式 | 加 Gaussian noise | 替换为 [MASK] |
| 最坏状态 | 随机噪声 | 全 [MASK] |
| 模型输出 | noise、clean data 等连续量 | 每个位置的 token logits |
| 输出 shape | 与输入连续张量相同 | [B, L, V] |
| 常见 loss | MSE | Cross-Entropy |
| 单步恢复 | 连续数值更新 | 接受、unmask、替换或 remask |
| 是否能回滚 | 由 sampler 决定连续状态更新 | 由 decoding policy 决定 token 是否冻结 |
两边都在学习“如何恢复被破坏的信息”,但具体概率对象已经不同。文本 Diffusion 不是把 U-Net 换成 Transformer 就结束了,而是连 corruption、输出空间、loss 和采样规则都一起换了。
8. 文本 Diffusion 和 AR 的真正差异,不只是“并行 vs 串行”
GPT 这类 Autoregressive(AR,自回归)模型按照固定顺序生成:
\[p(x)=\prod_{i=1}^{L}p(x_i\mid x_{<i}).\]第 i 个 token 只能依赖已经生成的左侧 token。这个顺序很强:前缀一旦确定,下一步只需要解决“接下来是什么”。但它也决定了生成天然有一条长度为 L 的串行依赖链。
Masked diffusion 没有固定的左到右顺序。一次 forward 可以同时预测所有 [MASK],而且每个位置都能利用左右两边当前可见的 token。它更像在反复修改整份草稿:先填最有把握的部分,再用这些新信息修补剩余位置。
再看一张 AR 和 masked diffusion 的并排图。怎么读:左边看串行依赖和 KV Cache,右边看多位置并行填充与 remask;底部那句结论最重要——算法并行度更高,不等于端到端一定更快。
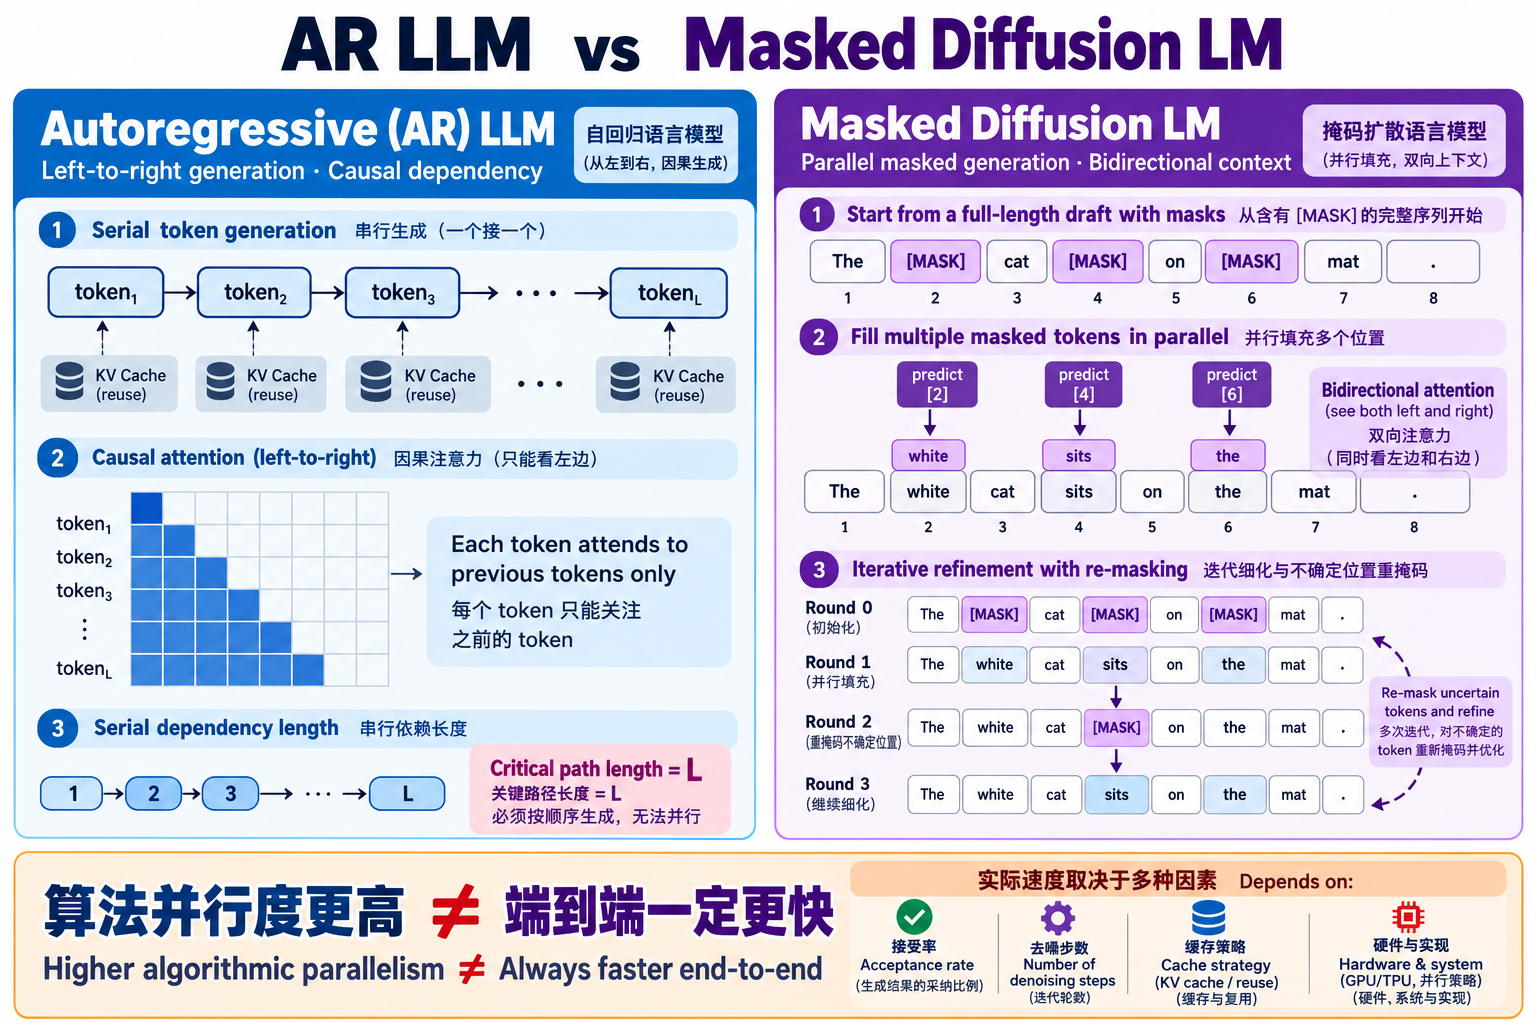
左栏是固定的左到右链,历史状态可以靠 KV Cache 复用;右栏是整份草稿多轮修订,双向 attention 让每个位置都能看见当前上下文,但不确定位置仍可能 remask。接下来的表格把这些差异压成几行对照:
| 维度 | AR LLM | Masked Diffusion LM |
|---|---|---|
| 生成顺序 | 左到右固定展开 | 多位置迭代恢复 |
| Attention | causal,只看左侧历史 | 双向,查看当前完整状态 |
| 一次 forward | 通常新增一个 token | 可预测多个位置 |
| 状态修订 | 已生成前缀通常不回头 | 可 remask 并重做低置信位置 |
| 主要难点 | 串行依赖链 | 多位置预测的一致性与迭代成本 |
但“能并行预测”不等于“端到端一定更快”。
AR 模型可以用 KV Cache 缓存历史 token 的 attention Key/Value,避免每一步重新计算整个前缀。Masked diffusion 的双向 Transformer 在每一轮去噪时,往往要重新处理整段序列;如果一轮只确认少量 token,很多计算会在下一轮重复发生。
真正决定速度的是:
- 总共执行多少次模型 forward;
- 每次 forward 处理多长的序列;
- 一轮最终能可靠确认多少 token;
- 已确认部分能不能缓存或跳过;
- 达到相同生成质量需要多少轮。
因此更准确的结论是:
文本 Diffusion 提供了更高的算法并行度,但能否变成真实加速,取决于每轮接受率、去噪步数、缓存方式和硬件利用率。
它还有两个 AR 不那么突出的困难。
第一个是长度。图像尺寸通常在采样前就确定,但一句话何时结束本身就是生成内容。文本 Diffusion 要么预先给定槽位长度并学习 [EOS],要么采用 block / semi-autoregressive 策略:块与块按顺序生成,块内再并行去噪。
第二个是全局一致性。一次预测多个位置时,每个位置单独看都可能合理,组合起来却互相冲突。比如主语和谓语分别预测得很自信,但数、时态或语义并不匹配。remask 和多轮修订,本质上就是在并行度与一致性之间找平衡。
所以文本 Diffusion 并不是把 AR 的串行瓶颈一键抹掉,而是把问题换成了:如何在少量轮次内,并行确认足够多、同时又彼此一致的 token。
9. 最后只记住四个问题
如果把数学、网络结构、维度、训练代码和推理代码一次全部展开,知识点可能都对,读完却很容易只剩下一堆零件。真正理解一个 Diffusion 方法,先抓住下面四个问题就够了。
9.1 在什么空间里生成?
$x_0$ 是 pixel、VAE latent、continuous embedding,还是 discrete token?
空间一旦确定,什么叫“邻近状态”、什么样的破坏方式才有意义,也基本确定了。图像适合连续路径;文本 token 更自然地对应离散转移。
9.2 信息是怎么被拿走的?
是加 Gaussian noise、替换类别,还是变成 [MASK]?
Corruption 不是普通数据增强。它直接规定模型训练时反复解决哪一种局部恢复题。
9.3 模型到底预测什么?
连续模型可能回归 noise 或 clean data;离散模型通常输出词表 logits,预测原始 token。预测对象决定了输出 shape 和 loss,不能只看网络叫 U-Net 还是 Transformer。
9.4 生成时如何把答案逐步确定下来?
连续空间里,sampler 决定数值更新;离散文本里,decoding policy 决定哪些 token 现在确认、哪些继续 remask、哪些允许回滚。训练目标相近,不代表推理策略相同。
把图像和文本放回这四个问题中,整件事可以压成一句话:
图像与文本 Diffusion 共享“先破坏、再学习恢复”的生成骨架;图像在连续空间中减去噪声,文本在离散空间中补回缺失 token。
它们不是同一个公式的换皮版本,但确实是在用同一种办法拆解生成难题。
所以以后再看到新的文本 Diffusion 模型,不必先钻进几十页公式。先看它在哪里扩散、怎么破坏、预测什么、如何确认 token。四个问题答完,这个方法的主干基本就立住了;剩下的破坏进度、网络结构和解码技巧,才有地方往上挂。
参考资料
- Denoising Diffusion Probabilistic Models:连续 Gaussian diffusion、forward closed form 与 noise-prediction 训练。
- Structured Denoising Diffusion Models in Discrete State-Spaces:离散类别转移与 absorbing
[MASK]。 - Diffusion-LM Improves Controllable Text Generation:continuous embedding diffusion 与 rounding。
- Simple and Effective Masked Diffusion Language Models:masked discrete diffusion 的简化训练目标。
- Large Language Diffusion Models:LLaDA 的 masking 训练与迭代生成。
顺带扯一句题外话:Diffusion 并不是《动手学 AutoML:从 NAS 到大语言模型优化实战》的直接内容,书里更聚焦 NAS、搜索策略、LLM 架构自动化,以及剪枝、量化和模型融合。不过两者有个挺相通的学习方法:遇到一个复杂系统,先拆清楚表示空间、优化目标和执行过程,再去看层出不穷的方法名,会轻松很多。
