HiSparse | 稀疏注意力省了算力却没省显存,长上下文推理的容量墙怎么破
HiSparse | 稀疏注意力省了算力却没省显存,长上下文推理的容量墙怎么破
原文:HiSparse: Scaling Sparse-Attention Decoding with Hierarchical KV Cache Management
1. 先说清楚:稀疏注意力到底省了什么
做长上下文推理,有个现象一开始挺反直觉:模型明明「算得动」,却「装不下」。
先把话题拉回到 decode 本身。大模型生成文本是一个 token 一个 token 往外蹦的,每蹦一个新 token,都要拿它去和前面所有 token 做一次 attention。为了不每步重算,系统会把每个 token 在每一层的 Key / Value 向量缓存下来,这份缓存就是 KV cache。上下文越长,KV cache 越大,每步要读的东西越多——这就是长上下文 decode 又慢又贵的根源。
top-k 稀疏注意力就是冲着「读得太多」来的。它的观察是:attention 的分布其实很稀疏,一步里真正重要的就那么几千个 token,剩下的权重接近 0。那何必每步都读全部?于是每一步只挑最相关的 k 个(论文里 k=2048)拿去算。负责「挑」的是一个叫 indexer 的小模块——给候选 token 打分、选出 top-k;DeepSeek 的 DSA、NSA、Quest 都是不同风格的 indexer(第 3 节细说)。这么一改,长上下文 decode 的计算量从「随上下文全长」降到「随 k」,一下子便宜了。
问题是,省下来的只有计算。
2. 容量墙:读得少,却要存得全
稀疏注意力每步只碰 k 个 token,但有个前提绕不过去:任意一个历史位置,下一步都可能被选中。indexer 事先并不知道哪几千个会中选,所以系统必须让所有位置都「可被选中」——也就是把整个 KV cache 原封不动留在 GPU 的 HBM 里。
这里要分清两块内存。HBM(High Bandwidth Memory)是 GPU 板上的高带宽显存,快,但容量小、又贵;host DRAM 是 CPU 那一侧的普通内存,慢一些,但容量大、便宜得多,一台 8 卡 H200 节点能配到 22TB。
于是撞上了这篇论文点出的核心矛盾:decode 每步读的 KV,scale with k(固定、很小);但 HBM 里存的 KV,scale with 全上下文长度(随对话/文档越滚越大)。同一步 decode 的两笔账,一笔小、一笔大:
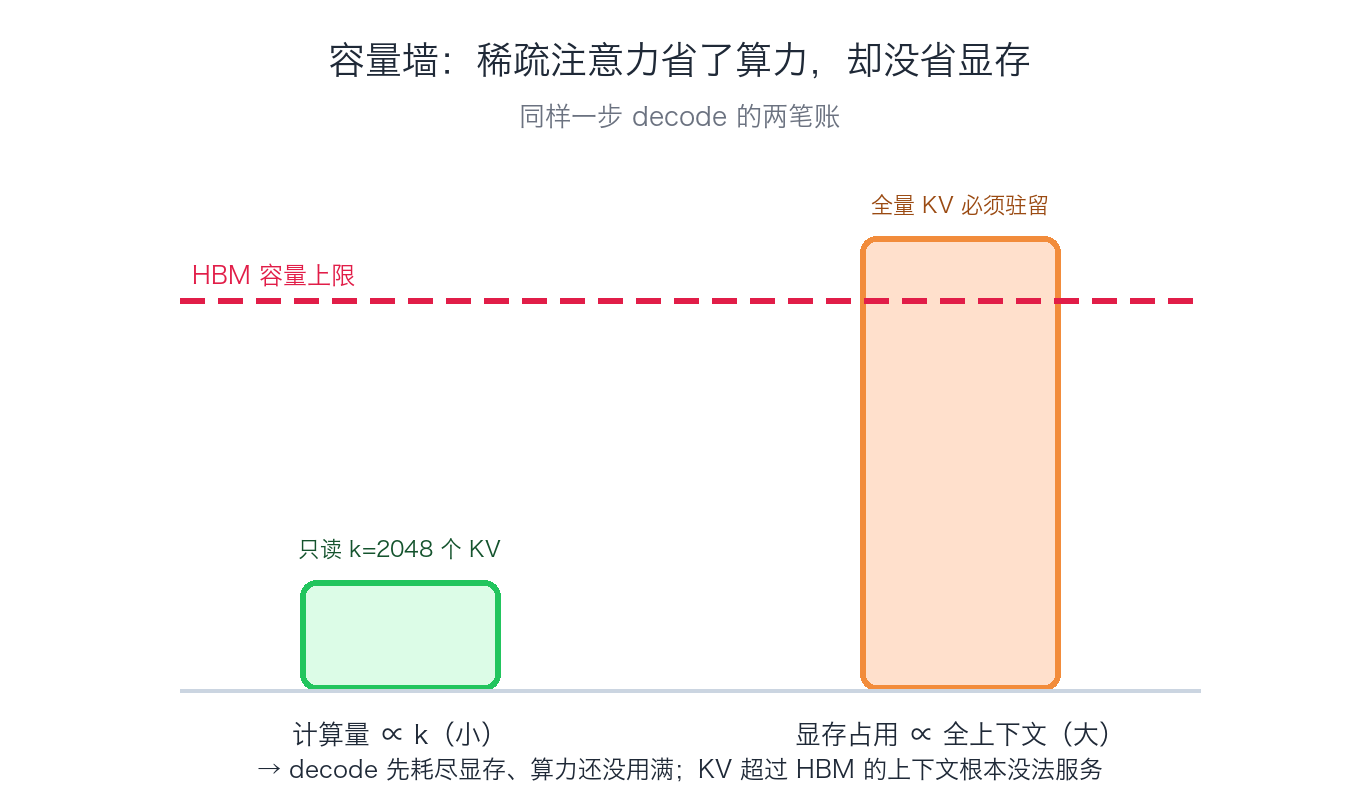
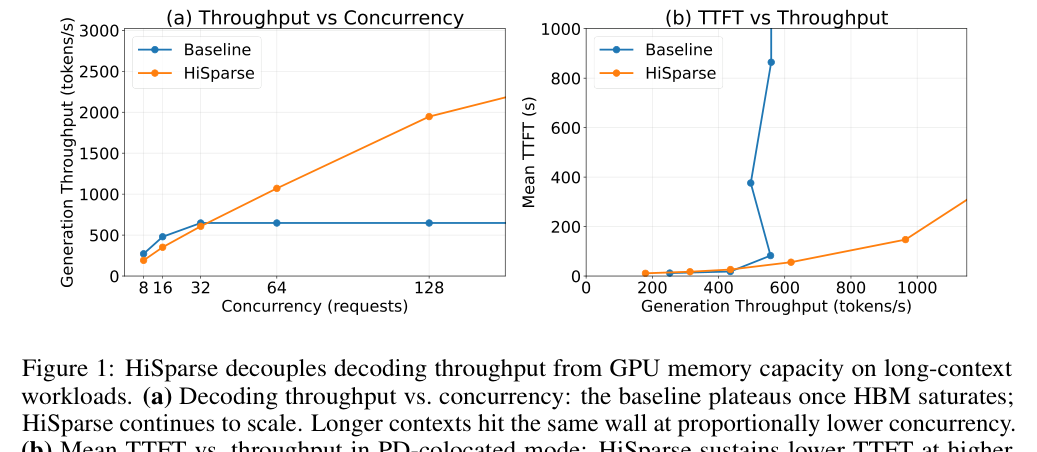
后果很直接:decode 会先撞上容量墙——显存先耗尽,算力还远没用满;KV cache 一旦超过 HBM,这个上下文根本没法服务。更糟的是在 PD-colocated 部署下(prefill 和 decode 挤在同一批 GPU 上,对应的 PD-disaggregated 是把两者拆到不同卡池),decode 的 KV 会把 prefill 的显存挤掉,TTFT(time-to-first-token,首 token 延迟)跟着飙升。
下面这张图是它的服务后果,看两条线就够了:横轴是并发请求数,纵轴是生成吞吐。baseline(全量 KV 常驻)涨到某个并发点就走平——HBM 满了,再多的请求进不来;HiSparse 则继续往上爬。右图更狠:baseline 的 TTFT 到某个吞吐后几乎垂直起飞,HiSparse 一直压在低位。
3. HiSparse 的想法:把「能不能选中」和「在不在显存里」拆开
HiSparse 的核心就一句话:解耦逻辑可用性(logical availability)和物理驻留(physical residency)。逻辑上,一个请求的全部 KV 都得可选;但物理上,它们没必要都待在 HBM。
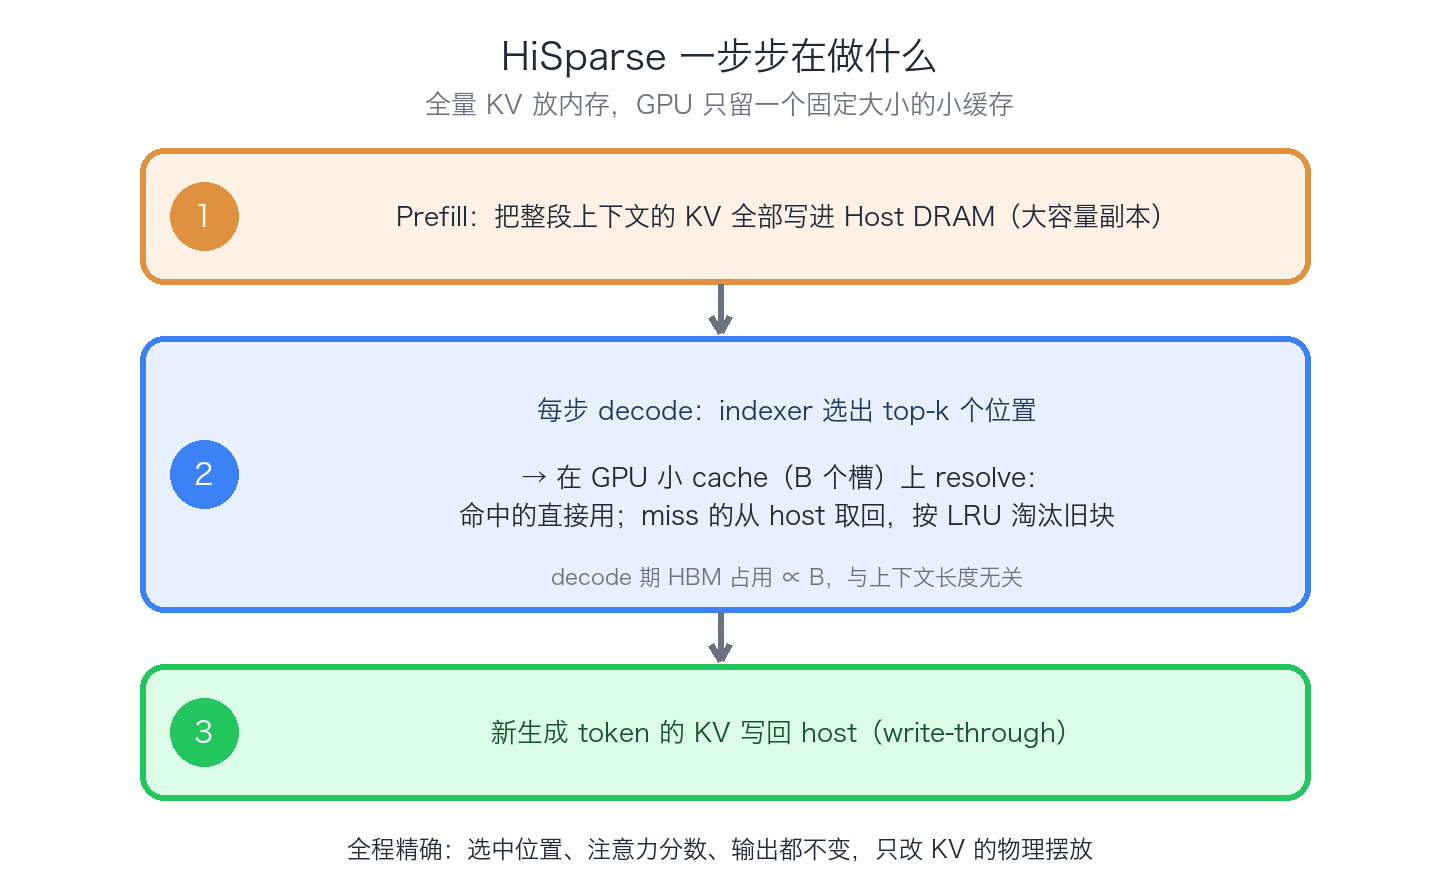
具体做法是——每个请求的完整 KV 历史放到 host DRAM(作为权威副本),GPU 里每请求、每层只给一个固定大小 B 的小 cache(B 就是 device_buffer_size,数的是能装多少个 KV 记录槽)。每一层 decode 时:indexer 照常吐出 top-k 个逻辑位置,HiSparse 拿这些位置去小 cache 上做一次「解析(resolve)」——命中的(已经在显存里)直接用,miss 的(不在)从 host 一次批量取回(swap-in),同时按策略淘汰(evict)一些旧的腾地方。
两个关键性质:
- exact(精确):选中的位置、算出的 attention 分数、最终输出,全都不变,改的只是 KV 摆在哪。所以模型输出和全量 KV 的 baseline 逐 bit 一致,不是近似。
- indexer-agnostic(与选择器无关):HiSparse 只消费 indexer 吐出来的「选中位置」,压根不关心你用什么方法选。DSA、NSA、Quest 都能直接套在它下面,不用重训、不用改模型。
这几个 indexer 长这样,可以顺带认识一下:
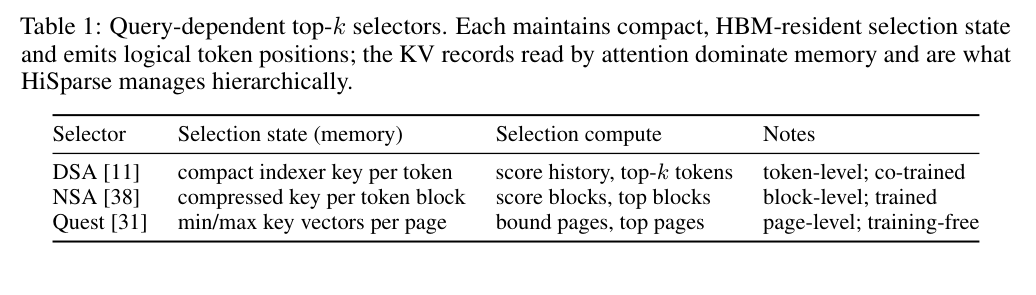
DSA(DeepSeek Sparse Attention)是 token 级选择、需要和模型一起 co-train;NSA(Native Sparse Attention)是 block 级、训练时就带着;Quest 是 page 级、免训练(training-free)直接挂上去。它们的共同点是:各自维护一小份常驻 HBM 的选择状态,吐出的是「逻辑 token 位置」;真正吃显存的是它们选中的那些 KV records——这才是 HiSparse 要分层管理的东西。
先看一眼整体在干什么,三步就讲完:
下面是论文的完整架构图,信息比较密,怎么读:左边 Host Memory 是全量 KV 的权威池,右边一整块是 GPU,只放两样东西——常驻的 indexer 状态、和那个带 page-table + LRU 元数据的小 cache(Hot Device Buffer),计算也都在 GPU 上。跟着圈里的 (1)→(5) 走一遍:(1) prefill 把每层 KV 写进 host 池;decode 时 (2) indexer 给出选中位置,融合的 RESOLVE kernel 去探测小 cache,(3) 把 miss 的记录从 host 取回、同时淘汰 LRU victim,(4) 把物理槽交给稀疏注意力后端,(5) 新生成 token 的 KV 再写回(write-through)host 池。
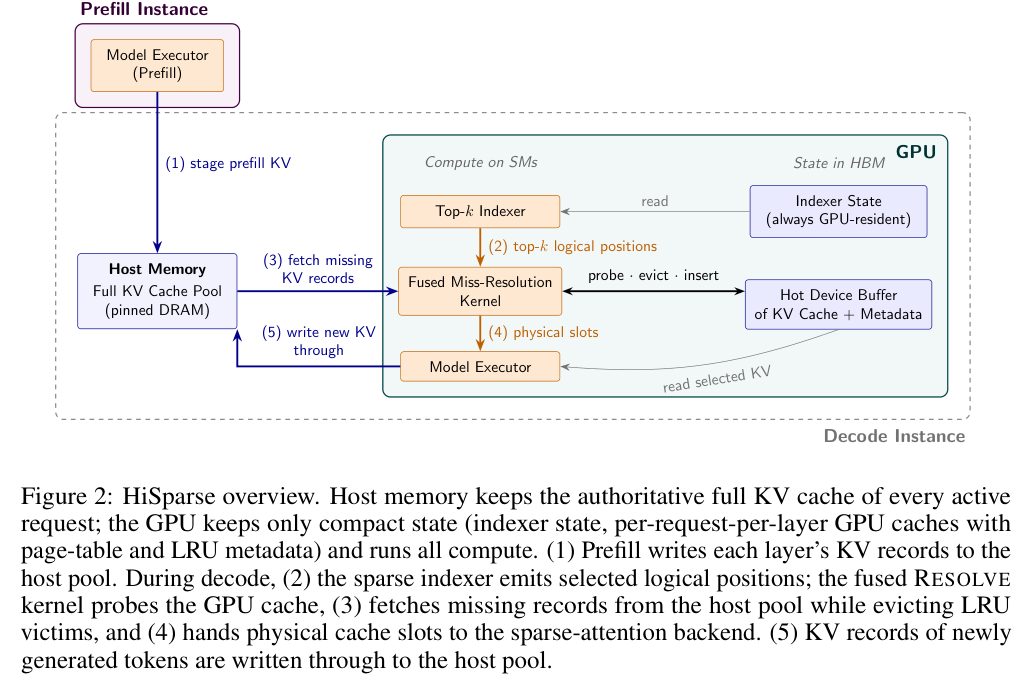
这么一来,decode 期的 HBM 占用只跟 B 走,和上下文长度彻底脱钩了。
4. 小 cache 为什么够用:选择是有 locality 的
到这儿会有个自然的疑问:每步都要 k 个,cache 才 B 个槽,会不会天天 miss、天天从 host 搬?
关键观察是:相邻 decode step 选中的 top-k 集合高度重叠,每步只漂移一点点。也就是说,这一步用到的块,下一步大概率还会用——「最近用过的」是「马上还会用」的好信号。
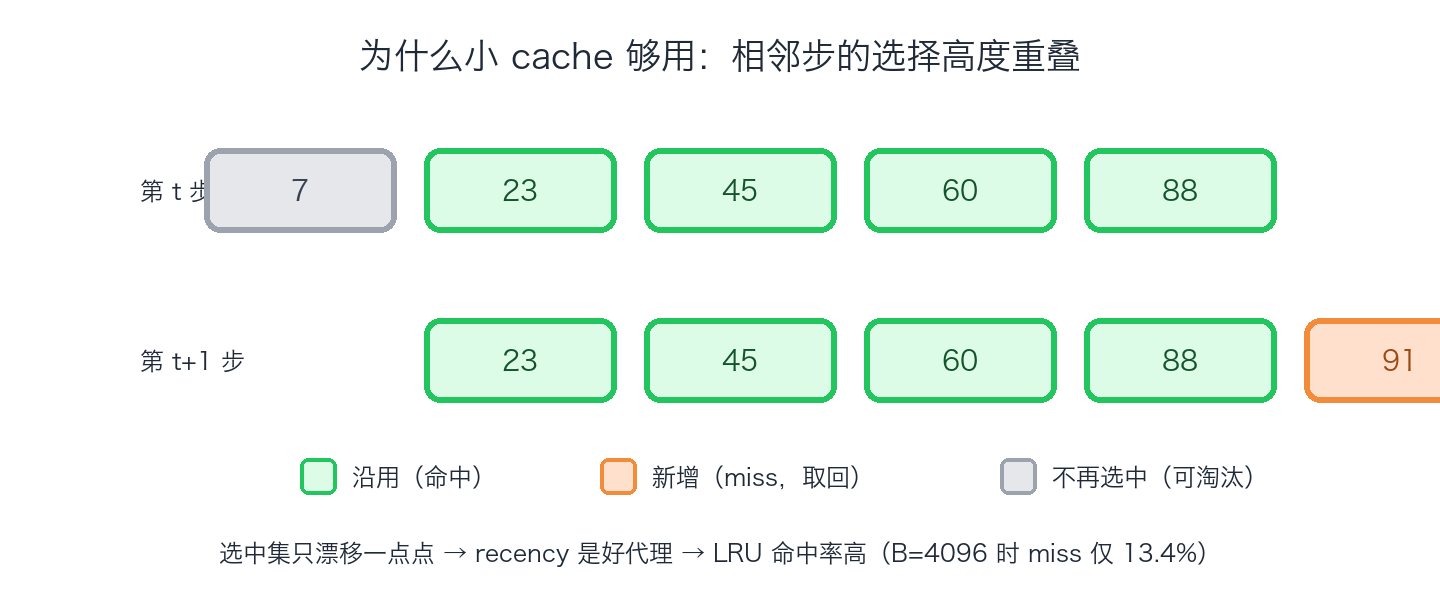
那用什么替换策略把这份 locality 吃干净?论文重放了 GLM-5.1 在 LongBenchV2(一个长上下文评测集)上的真实选择轨迹,k=2048,跑了七种 cache 配置对比。这张图怎么读:横轴是 decode 步数,纵轴是每步的 top-k miss 率(越低越好),每条线是一种配置:
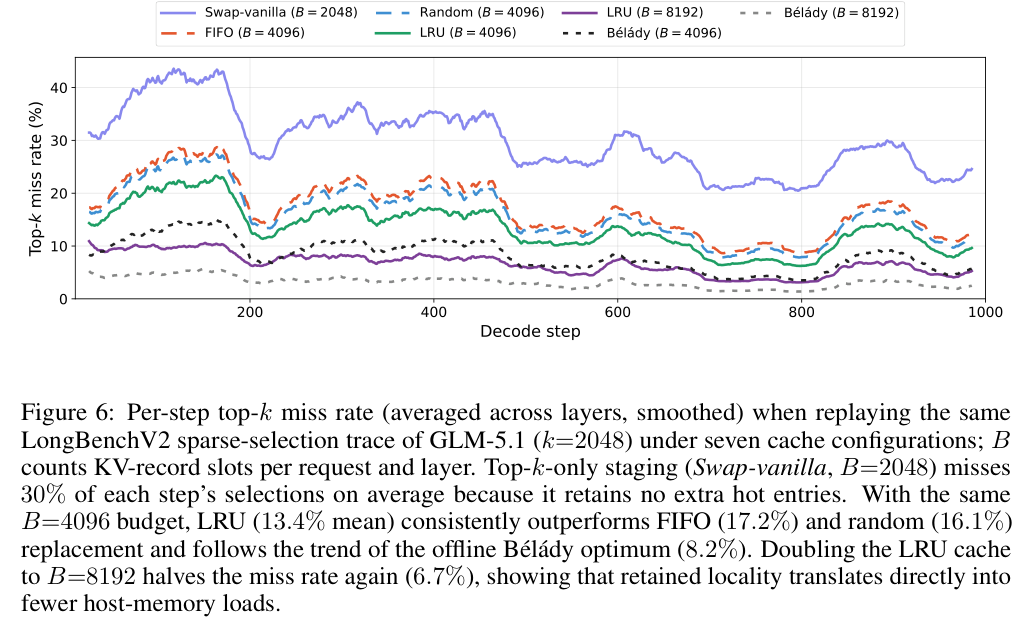
几个数字很说明问题:
- 只把当前 top-k 搬进来、不留任何热点(Swap-vanilla,B=2048),平均 miss 30%——因为选中集在步间会漂,光搬当前这批留不住。
- 同样 B=4096 的预算下,LRU 平均 miss 13.4%,稳定优于 FIFO(先进先出,17.2%)和 random(16.1%)。LRU(least-recently-used,淘汰最久没被用过的)之所以赢,是因为它顺着 recency 走。
- 更关键的是,LRU 的曲线贴着离线最优 Bélády 的形状(8.2%)走。Bélády 是上帝视角策略——它知道未来,永远淘汰「下次最晚才会用到的」,是理论下界。LRU 能贴着它,说明 recency 确实是未来选择的好代理。
- B 翻倍到 8192,miss 再腰斩到 6.7%。
保留下来的 locality,直接换成更少的 host 读取。 这也是为什么后面那个 miss-resolution kernel 要「保留已命中的槽、原地更新 LRU」,而不是每步从当前 top-k 集合把 cache 推倒重建——重建等于把攒下来的热点全扔了。
5. 把 miss 处理得便宜:一个融合的 Resolve kernel
locality 只解决了「要搬多少」,还有个「搬这件事本身贵不贵」的问题。这里有个必须先摆出来的预算:论文在 H200 上 profile GLM-5.2 的 decode(per-GPU batch 8),稀疏注意力 kernel 本身一层才 ~60µs。如果 resolve(判断命中、淘汰、取数)单独花 100–200µs 又不隐藏,一层 attention 的关键路径直接翻倍还多——那稀疏省下来的算力就被搬运吃回去了。
所以 resolve 必须满足两条:一是够便宜,二是能塞进 decode 的 CUDA graph(把一连串 kernel 录制成一张图整体重放,省掉每个 kernel 的 launch 开销;能塞进去的前提是中途不能有动态的 host 同步)。HiSparse 的做法是把「命中检测 + LRU 替换 + miss 取回」全融合进一个 CUDA kernel,针对一个请求、一层,跑完整套。
下面是这个 kernel 的内部流程,怎么读:中间虚线框是片上 SRAM(一个 CUDA block、一个请求),左右两侧是 GPU HBM,跟着 1→5 走:
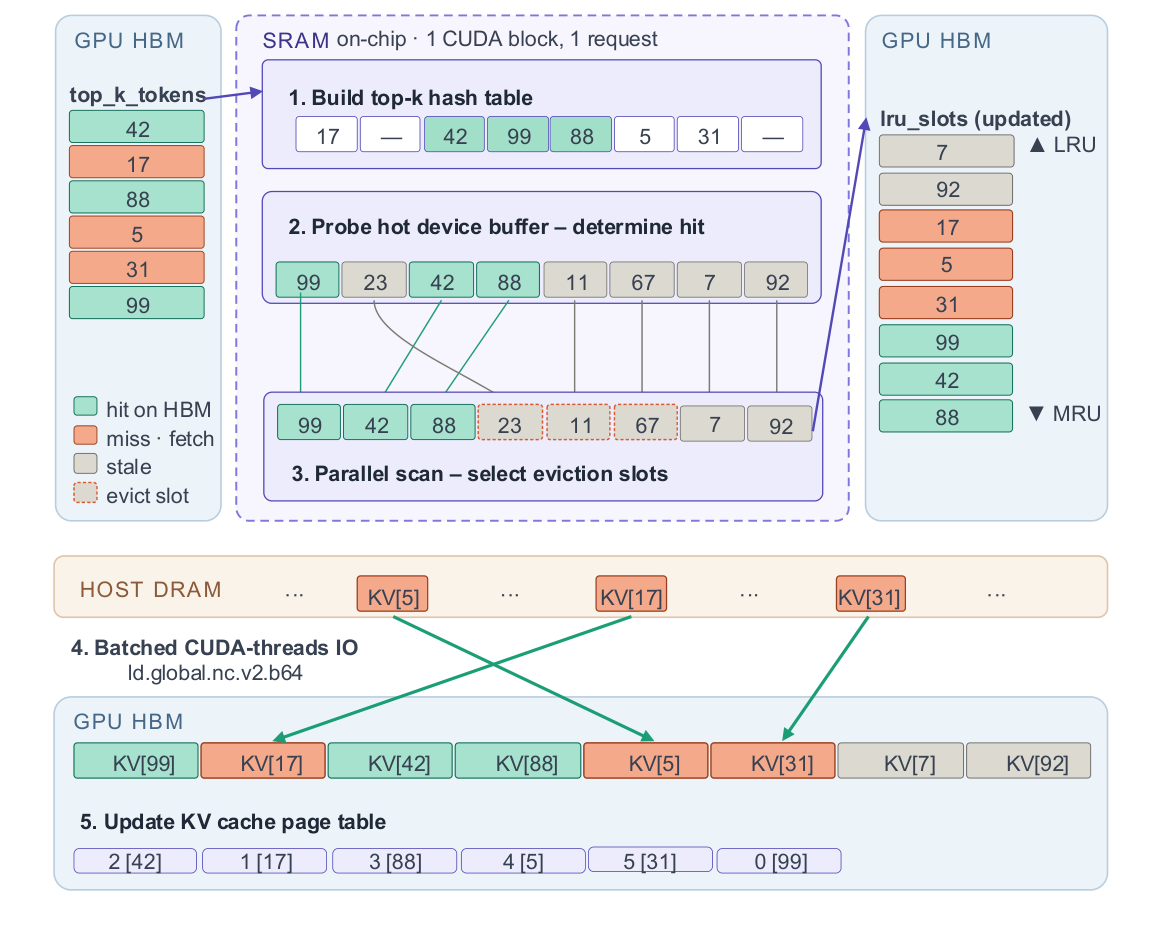
- Build top-k hash table:把这层选中的逻辑位置塞进 shared memory(片上 SRAM)里的一张哈希表。
- Probe hot device buffer:并行地拿 GPU cache 每个槽去查哈希表,标记出哪些是命中(hit)、哪些是可淘汰候选(stale)。
- Parallel scan — select eviction slots:对这些标记做一次并行 scan,选出 victim 槽,并原地更新 LRU 元数据——命中的提到最近使用端(MRU),取回的 miss 排在命中之后。
- Batched CUDA-threads IO:负责 miss 的线程用 GPU-assisted IO,直接对 pinned host memory 发向量化非一致 load(图里的
ld.global.nc.v2.b64,借鉴 Strata 的做法),把缺失的 KV records 拉进各自认领的 device 槽。per-thread 的传输块大小是调过的,让零散的 miss 读也能吃满链路带宽。 - Update page table + publish:更新 page table,产出
top_k_device_locs——一个和选中位置对齐的、稠密的物理偏移向量,下游稀疏注意力 gather 直接照着它从 GPU cache 读。
一句话:hit 检测、LRU 替换、miss 取数,全在一个 kernel 里做完,整段跑在 decode 的 CUDA graph 内,不打断关键路径。
6. 把剩下的 IO 藏起来:层间精确 prefetch
kernel 再便宜,miss 那部分的 host 读取还是会暴露 host-memory 的延迟。最自然的想法是提前 prefetch——趁着当前层在算,先把下几层要用的块从 host 搬进来。但 prefetch 的前提是能预测下一层要什么,而 indexer 每层重新选,看起来没法提前知道。
转机在于:有些模型层间共享 indexer 的选择。论文里叫 IndexShare(图里写作 IndexCache-shared),比如 GLM-5.2 的 DSA,会让一组层复用同一份 top-k 选择。这时下几层要取哪些块是已知的,prefetch 就从「猜」变成了 exact(精确):可以把这组层的取数需求先攒成一个计划(plan-then-IO prefetch groups),再统一发 IO,让搬运和当前层的计算 overlap 起来。
下面是 GLM-5.2 上的效果(8×H200,PD-colocated,32K 输入 / 8K 输出,k=2048,B=4096):
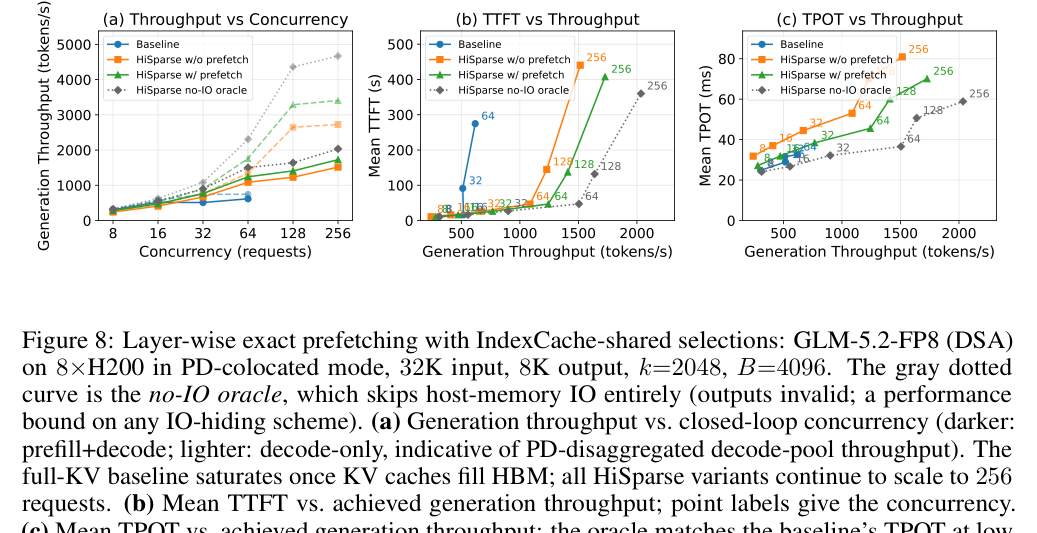
几个能落到数字上的结论:
- baseline 被显存卡死得很惨:平均 TTFT 从并发 16 时的 16s,涨到并发 32 的 91s、并发 64 的 275s;而 HiSparse 的所有变体都能一路扩到 256 并发。
- prefill 侧写 host 近乎免费:并发 8 时(此时 TTFT 里没有排队),把 prefill KV 写进 host 池,平均 TTFT 是 10.7–10.8s,和 baseline 的 10.7s 基本没差别。
- 精确 prefetch 把剩余的搬运成本又收回来一大块:同并发下,它让 TPOT(time-per-output-token,每个输出 token 的平均延迟)降 13–15%,吞吐涨 14–17%;峰值生成吞吐从 618(baseline)、1515(不 prefetch)一路抬到 1727 tok/s(精确 prefetch),相对全量 KV baseline 是 2.8×。作为参照,no-IO oracle(完全跳过 host IO 的假想上界,输出无效,只用来标定「IO 全藏住」的天花板)是 2034 tok/s——精确 prefetch 拿到了其中的 85%。
7. 效果:吞吐能扩到多大
先把增益的来源说清楚,不然容易误会:HiSparse 不会让单步 decode 变快,它做的是把更大的 batch 塞进同样的 HBM(batch-size effect)。所以只有当 baseline 被显存卡住时才有增益;上下文短、baseline 本来就装得下时,两者几乎打平。
先看 DeepSeek-V4-Flash(2×B200,32K 输入 / 8K 输出)。它用的是 NSA 式选择,只不过作用在压缩过的 KV entries 上,DeepSeek 管这叫 Compressed Sparse Attention——这里是 top-512 选择、每个 entry 压 4 个 token,合起来正好覆盖 2048 个 token。
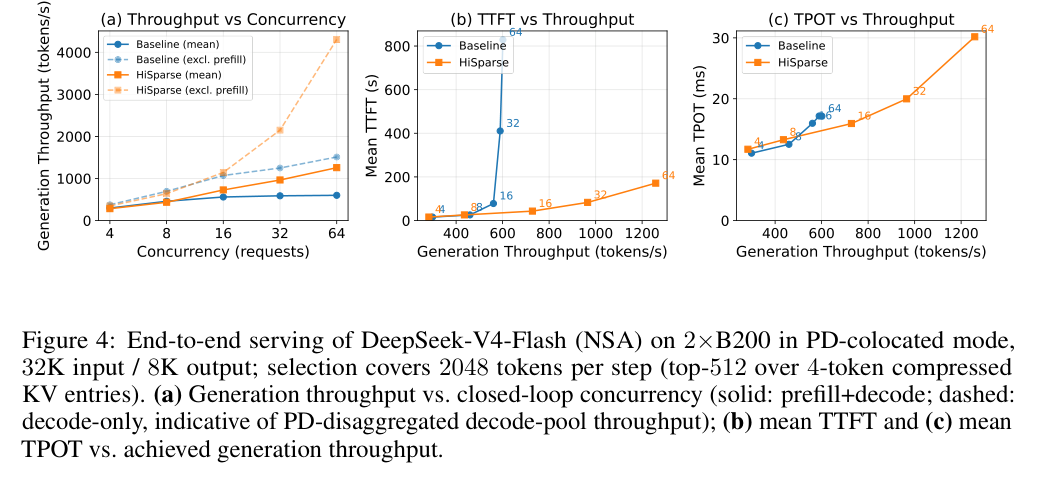
低并发时 baseline 和 HiSparse 差不多(都装得下);并发一上去 baseline 就走平(进不来更多请求),HiSparse 继续爬。并发 64 时,生成吞吐从 600 抬到 1257 tok/s(2.1×);如果只看 decode(拆掉 prefill,相当于 PD-disaggregated 里 decode 池的吞吐),是从 1511 到 4308 tok/s(2.9×)。
再看它在更长上下文、更多模型上的峰值吞吐(都取 k=2048):
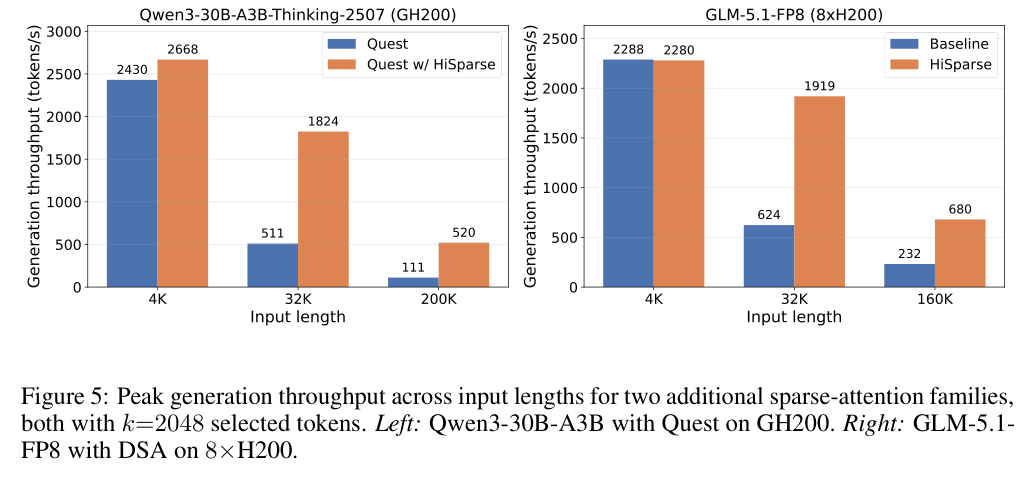
- Qwen3-30B-A3B + Quest(GH200):4K 时 2430→2668(基本打平,短上下文 baseline 够用),32K 时 511→1824(3.6×),200K 时 111→520(4.7×)。
- GLM-5.1-FP8 + DSA(8×H200):4K 时 2288→2280,32K 时 624→1919(3.1×),160K 时 232→680(2.9×)。
规律很清楚:上下文越长,baseline 能塞下的 batch 越小,HiSparse 的增益越大,峰值最高到 4.7×。
那 cache 到底开多大合适?这是个 tradeoff:
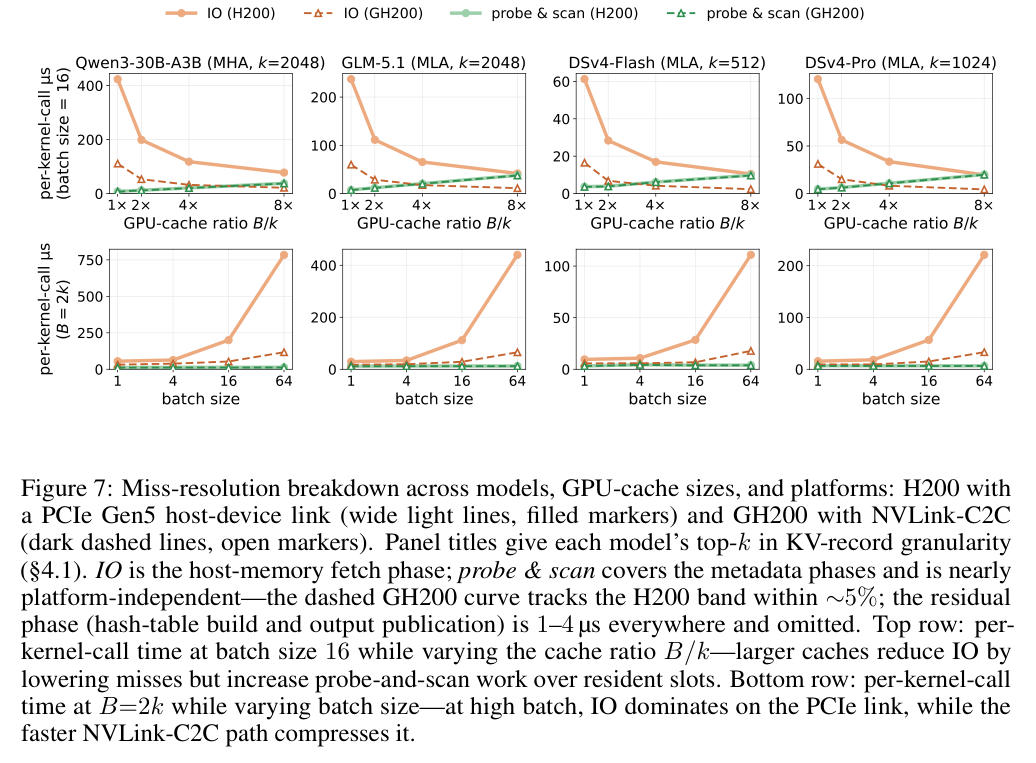
cache 越大 → miss 越少 → IO 越少;但代价是 probe/scan 要扫的槽更多,而且这块 HBM 本可以拿去装更多并发请求、更大权重、或更多 MoE expert(混合专家里每层的子网络)。实测有用区间大约在 2k–4k(选中集大小的一个小倍数)。另外 IO 会随 batch 涨——在 H200 的 PCIe Gen5 host-device 链路上,高 batch 时 IO 主导;换成 GH200 的 NVLink-C2C(更快的 CPU-GPU 直连)就能把 IO 压下去。作为规模注脚:8 卡 H200 节点配 22TB host DRAM,最大工作点(256 并发、32K/8K)下 host KV 池会涨到大约 11TB pinned 内存。
8. 落地,和我的一点看法
工程上,HiSparse 整个长在 SGLang(一个主流 LLM serving 框架)上:一个 coordinator(约 1000 行)管请求生命周期——把 prefill KV 暂存到 host 池、按需分配和扩张每请求每层的 GPU cache、做新 KV 的 write-through、编排 swap-in 和 prefetch;一组 fused kernel 管 resolve;一层 memory 管 host 池的分页分配和 device cache 池。用户侧的开关就一个 --enable-hisparse,加一份 JSON config(top_k / device_buffer_size(B)/ host_to_device_ratio / swap-in 传输块大小),不用改模型、不用改代码。
我自己的 take:这篇打的其实是 LLM 效率里一个反复出现的老矛盾——「稀疏激活,却全量驻留」。MoE 是这个病的另一种形态:每步只激活几个 expert(稀疏),但为了随时能激活,全部专家权重得常驻显存。稀疏注意力这边是每步只读几千个 token,却要求全量 KV 常驻 HBM。两者的病根一样:逻辑上要「全」,就被逼着物理上也「全」。
HiSparse 的解法很干脆:逻辑要全,物理不必都在 HBM——权威副本放便宜的大内存,GPU 只留一个吃得起的工作集,再用 locality(LRU 命中)+ kernel 融合 + 精确 prefetch,把搬运成本压到能接受的程度。这个「分层 + 热工作集」的思路,和 MoE offloading、KV cache offloading 是一脉相承的。而真正难的从来不是「放哪」,是「怎么把搬运藏进计算里、不让它爬上关键路径」——这篇在 kernel 融合和层间 prefetch 这两处的工程量,才是它能真正落地、而不是停在 idea 的原因。
如果你也在做长上下文 serving,或者被 KV cache 显存卡过,欢迎在评论区聊聊你们是怎么扛这堵墙的。
扯一句题外话:这篇是纯推理系统、KV cache 工程,和我那本讲 AutoML 的书不是一个方向,硬扯没意思。只有一个点算沾边——HiSparse 反复强调「省下来的 HBM 可以拿去装更大的权重、更多 MoE expert」,而「怎么把模型本身压小、把该保留的结构搜出来」正是《动手学 AutoML:从 NAS 到大语言模型优化实战》里 LLM 压缩(剪枝 / 量化 / 模型融合)那几章在做的事,算是从「模型侧」而不是「serving 侧」去省显存。对这个角度感兴趣可以翻翻,不感兴趣直接跳过就好。
