边听边译总在「改口」?Stable-Prefix 训练让 LLM 同传稳定又低延迟
边听边译总在「改口」?Stable-Prefix 训练让 LLM 同传稳定又低延迟
原文:Dynamic Lagging using Stable-Prefix Training for Simultaneous Translation
1. 前言:边听边译,到底难在哪
想象你在听一场跨语言的直播:台上的人英文一句话还没说完,屏幕下方的中文字幕已经开始往外蹦字了。这就是同声传译(simultaneous translation,下文简称同传)在干的事——输入还没结束,输出就得开始。
同传天生卡在一个矛盾里:你等的源文越多,翻译质量越高(极端情况是等整句说完再译,也就是普通的离线翻译);可你等得越久,延迟就越大,”边听边译”也就失去了意义。这就是同传里绕不开的质量 ↔ 延迟权衡(quality-latency tradeoff)。
先把这篇会反复出现的两个度量就地说清楚:
- 延迟这篇用 Average Lagging(AL,平均滞后):粗略理解就是”平均而言,模型的输出比理想的同步输出慢了几个词”,越小说明越跟得上、延迟越低。
- 质量这篇用 COMET:一个基于预训练模型的翻译打分,不像 BLEU 只数 n-gram 重合,COMET 会判断译文和参考在语义上有多接近,文中都 ×100 呈现,越高越好。
怎么控制这个权衡,学界有一堆办法。最经典的是 wait-k:固定先读 k 个源词再开口,之后读一个词、吐一个词,节奏卡死;k 越大等得越久、延迟越高,但信息越全、质量越好。此外还有自适应读写策略、re-translation(来一点新内容就把整句重译)、local agreement 等等。
这篇盯的是一个具体设定:级联(cascaded)同传。语音同传通常两种搭法——端到端(一个模型语音进、译文出,读写策略是训出来的)和级联(先用 ASR 把语音转成文字,再送给一个独立的 MT 模型翻译)。级联的麻烦在于:MT 这一环天生学不到”该读多少、该写多少”的策略,它面对的只是一段不断变长的文字前缀,只能靠 wait-k、砍尾巴这类硬规则来近似,缺了端到端那种”看情况动态决定”的灵活。
这篇论文要补的正是这个能力:让级联里的 MT 模型自己动态决定,对当前这段还没说完的源文,愿意”押”出去多少翻译。
2. 真正的痛点:翻译的「改口」
先看最朴素的做法有多难受。既然源文一个词一个词地来,那我每来一个词就把”目前读到的这段”整体翻一遍,行不行?
问题在于:一段话没说完的时候,它的正确翻译常常和说完之后完全不一样。论文给了一个特别形象的德语例子(如下图上半部分):
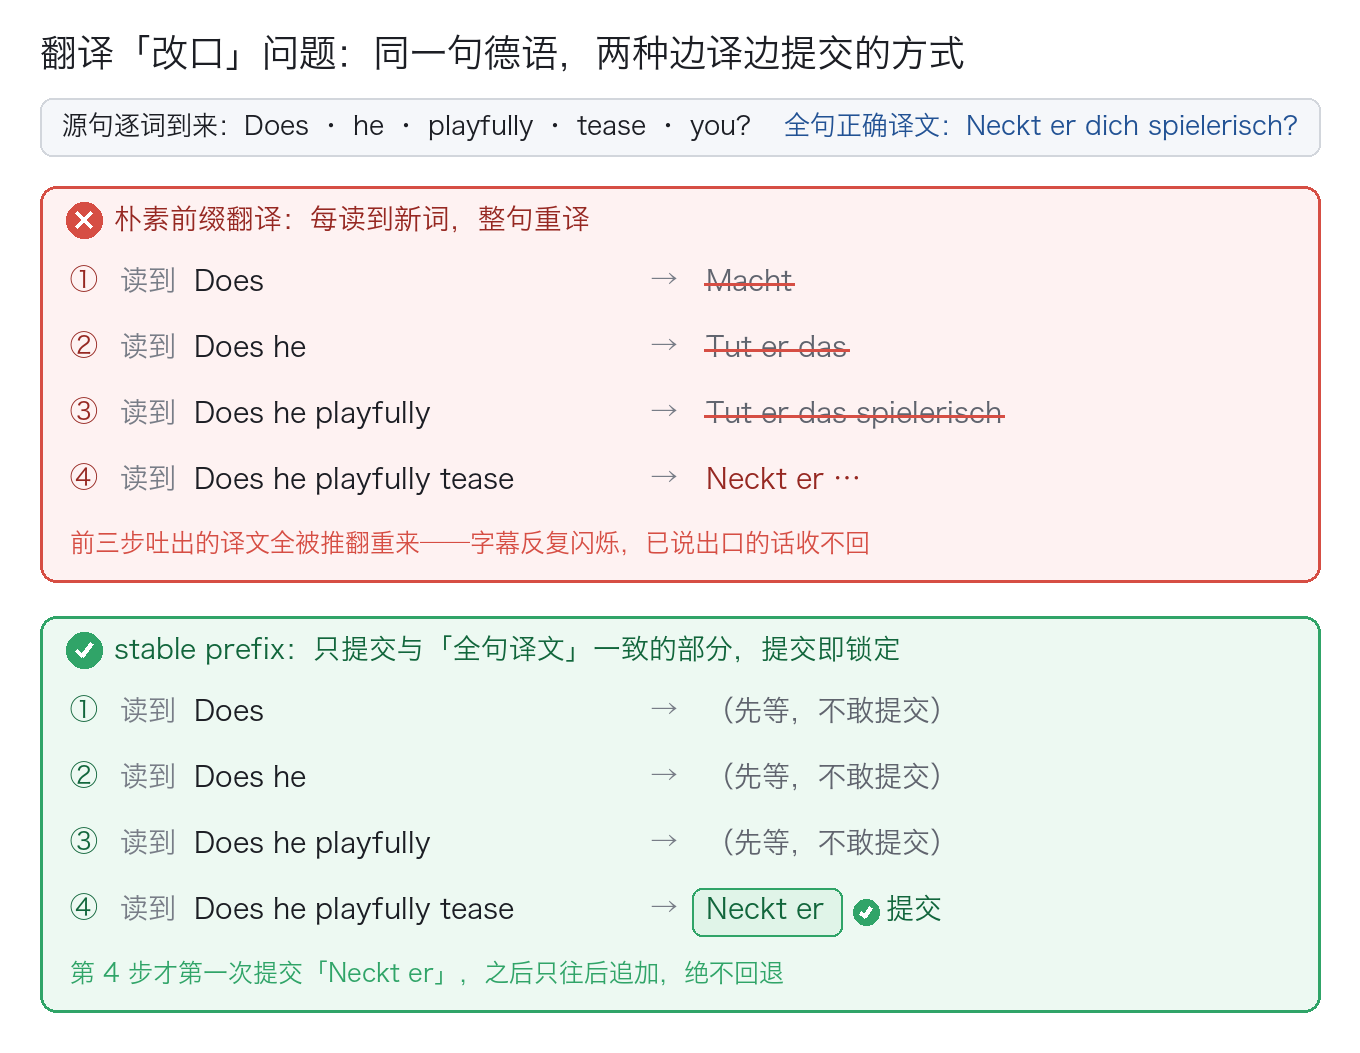
源句是英文 “Does he playfully tease you?”,完整正确的德语译文是 “Neckt er dich spielerisch?”。可你要是一个词一个词地喂进去看模型怎么翻:读到 “Does” 译成 “Macht”,读到 “Does he” 变 “Tut er das”,读到 “Does he playfully” 又变 “Tut er das spielerisch”,一直到读到 “Does he playfully tease”,才第一次吐出以 “Neckt er” 开头的译文。
直到第 4 步,部分翻译才第一次和最终译文对得上。前三步吐出来的 “Macht”、”Tut er das” 全是错的方向,得推翻重写。
这种”吐出去又反悔”的现象,就是同传里的改口(jitter / flicker)。它在两个场景下要命:
- 显示端字幕:观众眼睁睁看着字幕一直自我改写、闪来闪去,体验极差。
- commit-once(提交即定)系统:比如语音转语音,或者这套级联后面还接着别的模块——已经”说出口”的话根本收不回来,早期押错的词就是实打实的错误。
3. 核心思路:stable prefix(稳定前缀)
论文的解法叫 stable prefix(稳定前缀),思路特别干净:既然”部分翻译”会抖,那就只拿那些”迟早不会被推翻”的部分去训练模型。
具体怎么造这份训练数据(假设手头有一个翻得不错的 MT 系统 t 当”老师”):
- 先让老师把整句 s 翻出来,得到全句译文 f = t(s)。
- 再让老师把每一个源前缀都翻一遍:s 的前 i 个词记作 s_1..i,它的翻译是 p_i = t(s_1..i)。
- 对每个前缀翻译 p_i,算它和全句译文 f 的最长公共前缀长度 ℓ_i(英译德按词算,英译日、英译中按字符算——因为中日文没有天然的词边界)。
- 关键一步:源前缀 s_1..i 对应的稳定前缀取 f 的前 m_i 个单位,其中 m_i = max(ℓ_1, …, ℓ_i),也就是到目前为止所有 ℓ 的运行最大值。
第 4 步的运行最大值是精髓:它保证 m_i 单调不减——随着源文变长,已被认定”稳定”的那段译文只会往后长,绝不缩回去。一旦某段内容和全句译文对上、被提交了,后面哪怕冒出更嘈杂的部分翻译,也没法把它撤回。
对照论文里的德语例子(下表最右列就是抽出来的 stable prefix):
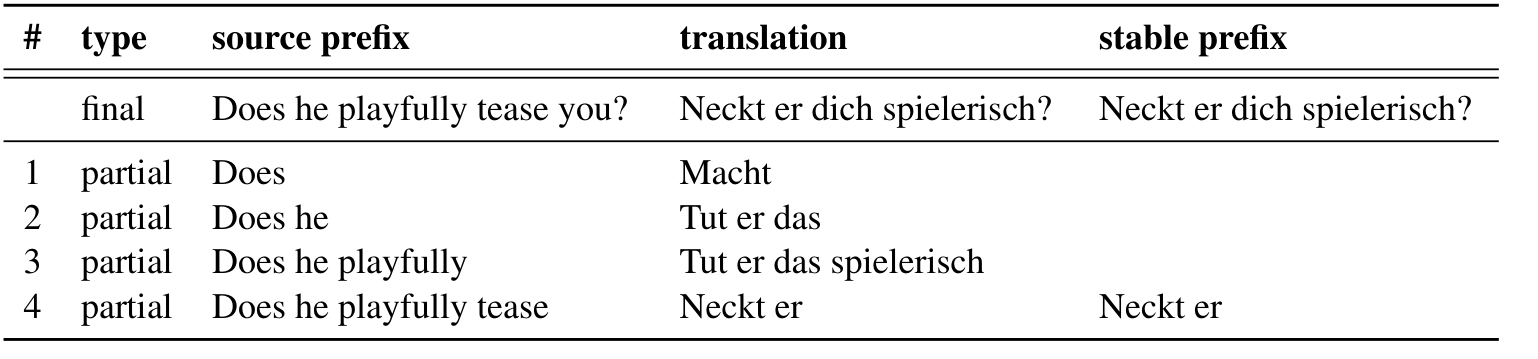
前三步因为翻译方向就是错的,和全句译文 “Neckt er…” 没有公共前缀,稳定前缀是空的(模型学到的是”这时候啥都别急着提交”);到第 4 步 “Neckt er” 对上了,稳定前缀才第一次有内容。这份”只保留稳定部分、砍掉不稳定尾巴”的语料,再和全句译文按固定比例混在一起微调,模型就学会了”对某段源文,我到底能信到哪、该提交多少”。
这也顺带回应了以往前缀训练的一个坑:过去的做法是随机采样源前缀去训练,但随机采样没考虑”前缀歧义”——它会逼着模型对一段其实还定不下来的源文也硬翻出完整结果,反而学出爱改口的毛病。stable prefix 用”和全句译文的公共前缀”这把尺子,精确地告诉模型哪些能提交、哪些该等。
4. 推理怎么跑:forced prefix + 增量提示
训练数据有了,推理时怎么把”已经提交的不许改”落地?论文用的是 forced prefix(强制前缀) 提示法(如下图):
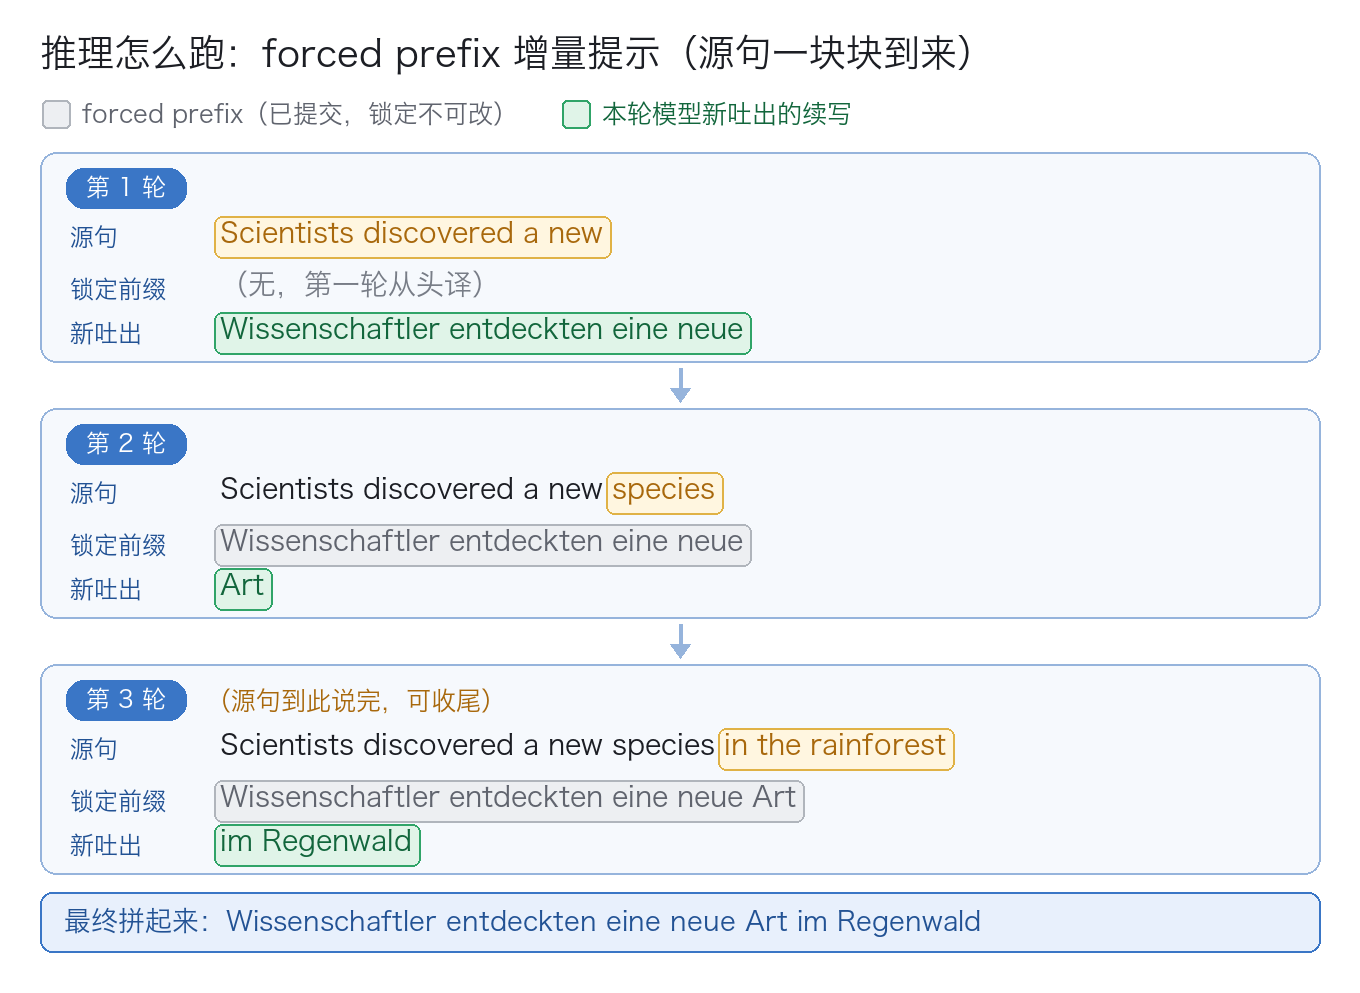
拿 “Scientists discovered a new species in the rainforest” 举例,源文分块到来:
- 第 1 轮:读到 “Scientists discovered a new”,告诉模型”这是段没说完的话”让它翻,吐出 “Wissenschaftler entdeckten eine neue”,提交。
- 第 2 轮:新块 “species” 来了,源文拼成 “Scientists discovered a new species” 重新提示;但把上一轮已提交的 “Wissenschaftler entdeckten eine neue” 作为 forced prefix 强制解码(等于告诉模型”开头这几个词照抄,不许改”),模型只需往后补新的续写 “Art”。
- 第 3 轮:源文补全成整句并标记”说完了”,同样强制解码已提交的 “…eine neue Art”,模型补上 “im Regenwald”。
整个过程 flicker-free by construction(结构上就不可能改口):模型每一轮都能看到之前的译文当上下文,但那部分是锁死的、改不了,它只能往后接。这就把”稳定”从训练阶段的数据性质,变成了推理阶段的硬约束。
论文围绕这套机制训了几个变体,后面实验会反复出现,先记住:
- base:原始 Qwen3-8B,不做任何微调(对照组)。
- prefix:在 stable prefix 数据上微调,每轮看到 forced prefix 后重新生成整句。
- continuation:微调成”给定 forced prefix,只吐新续写那一小段”。
- full-control:一个统一控制的变体,只用后面的置信度机制来评测。
5. 三个延迟旋钮:一个模型 = 一条 Pareto 曲线
有了不改口的模型,还差最后一步:同一个模型,怎么在”快但糙”和”慢但准”之间自由调档? 论文给了三个推理期(inference-time,不用重训)的”延迟旋钮”,拧一拧就能在质量-延迟平面上扫出一整条 Pareto 前沿:
- wait-k:经典 wait-k,先读 k 个词再开译,之后读一个提交一个。k 越大越靠后提交,延迟越高、质量越好。
- target suffix deletion(砍尾巴,参数 d):每一步让模型正常生成完整续写,但提交前把末尾 d 个单位删掉。越靠后的 token 越不可靠,砍掉尾巴等于”只提交比较有把握的前半段”,d 越大越保守、延迟越高。
-
confidence(置信度,阈值 τ):让模型用自己的输出置信度决定”继续提交还是停下等更多源文”。定义一个”停 vs 继续”的差值:
Δ = P(最可能的非结束符) − P(结束符 EOS)
再按阈值 τ 决策:Δ ≥ τ 就 COMMIT(提交这个词),Δ < τ 就 STOP(停下,去读更多源文)。τ 往 −1 拧,模型极其激进、几乎不等,延迟最低;往 +1 拧越来越谨慎,直到退化成”等整句说完再译”的离线翻译。
这三个旋钮的妙处在于:一份模型权重,靠一个标量就能滑出整条延迟-质量曲线,不用为每个延迟点单独训一个模型。
6. 实验结果
实验都用 Qwen3-8B,方向是英译德、英译日、英译中(EN→DE / JA / ZH)。训练数据从 WMT24(德)和 WMT25(日、中)里采源句,每个方向用 base 模型合成 2000 万条全句翻译 + 对应前缀对,再从里面抽 stable prefix。测试集用 FLEURS、WMT24++、CoVoST 2 三个。
先看部分翻译到底稳不稳。
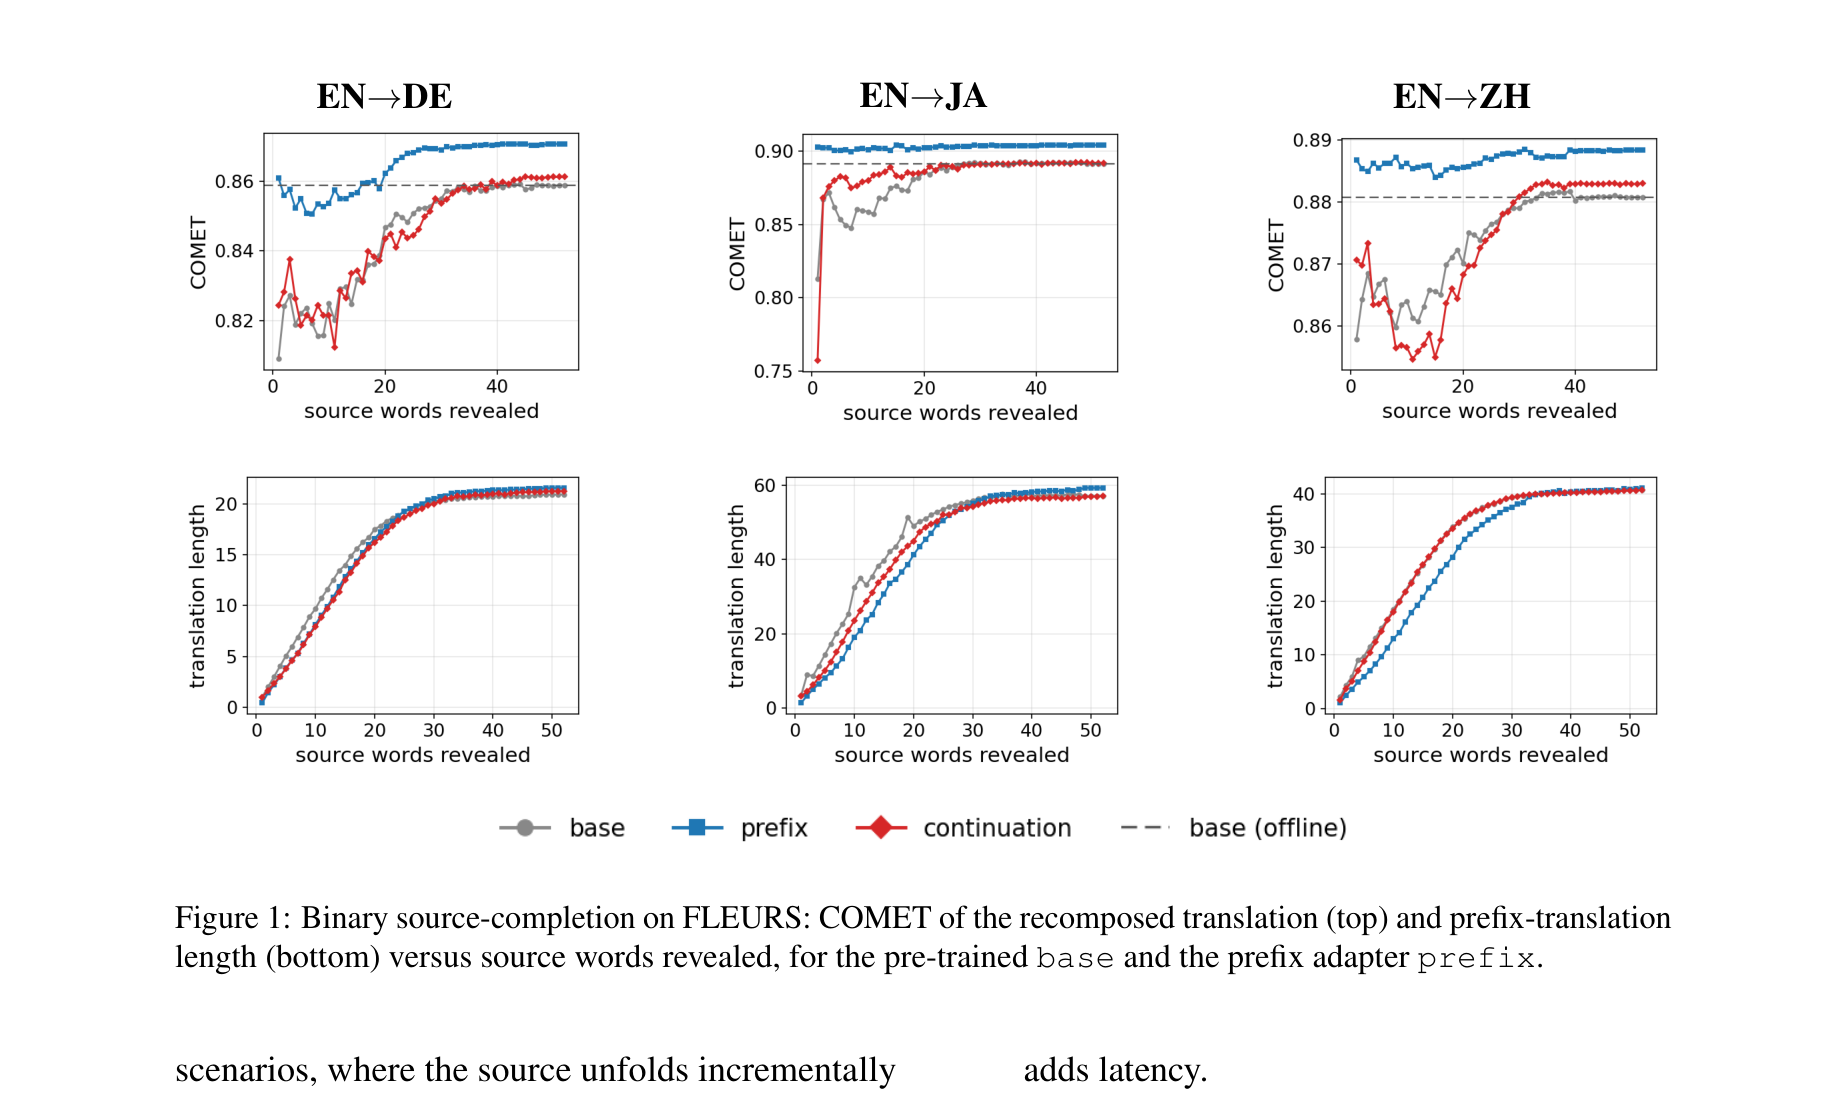
怎么读这张图:横轴是”源文已经揭示了多少个词”,越往左说明模型看到的源文越少、越难;上排纵轴是那一刻部分翻译的 COMET 质量,下排是译文长度;灰线是没微调的 base,蓝线是 prefix,红线是 continuation,虚线是”等整句再译”的离线水平。重点看左半边:源词很少时,灰线(base)和红线(continuation)的质量明显往下塌——这就是改口在拖后腿;而蓝线(prefix)从头到尾贴着甚至高于离线虚线,几乎不塌。下排还能看到 prefix 早期提交的长度略短——它更克制,宁可少说也不乱说。
这个”稳”能量化。下表在 FLEURS 上把各切分点的部分翻译质量汇总,Full 是整句译完的 COMET,Worst 是所有切分点里最差的那个 COMET:
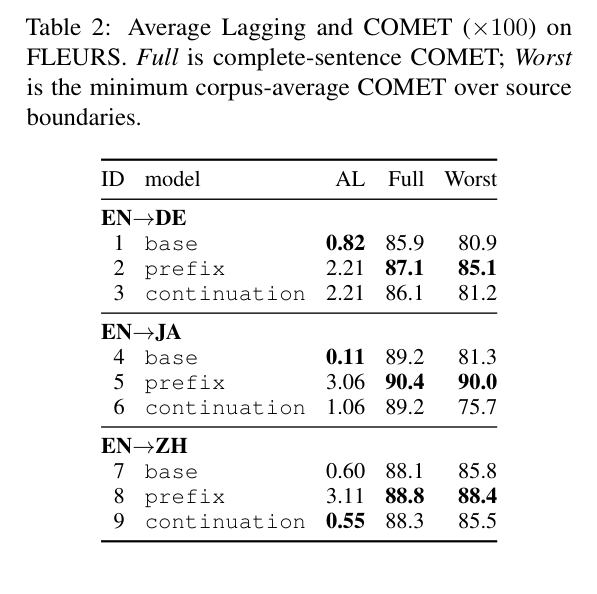
看 Worst 这一列:prefix 相比 base 大幅抬升——英译德 80.9 → 85.1,英译日 81.3 → 90.0,英译中 85.8 → 88.4。也就是说,prefix 模型哪怕在最尴尬的中途时刻,翻译质量也不会崩。这正是 stable prefix 训练想要的:不是平均更好,而是最坏情况托底——这对实时字幕体验至关重要。
再看整体的质量-延迟前沿(主结果)。
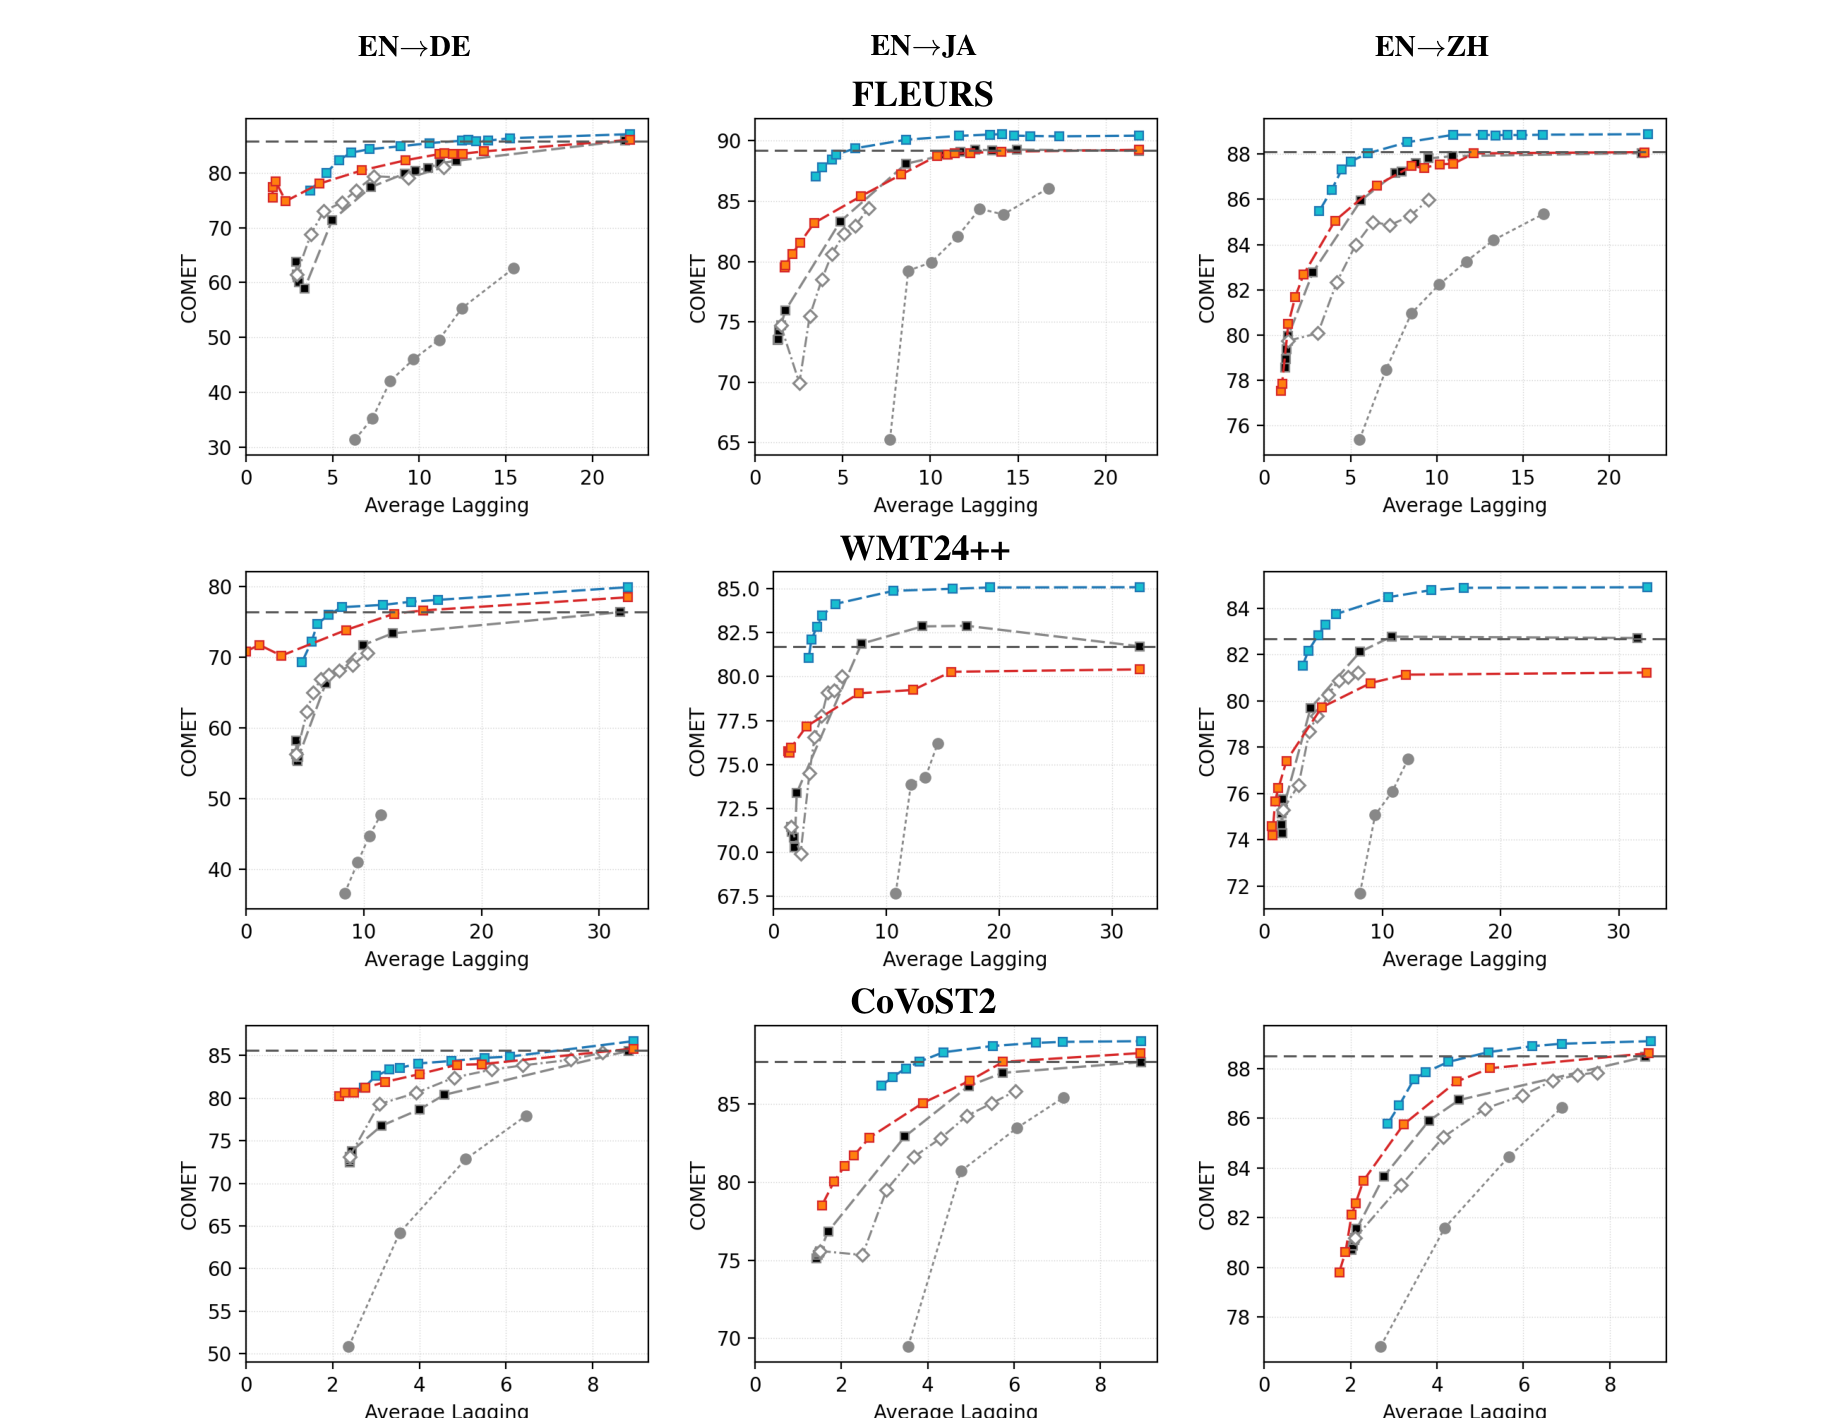
怎么读这张图:一共 3 行(FLEURS / WMT24++ / CoVoST2 三个测试集)× 3 列(德 / 日 / 中),每个小图横轴是延迟 AL(越左延迟越低),纵轴是 COMET 质量(越高越好),所以越靠左上角越好;虚线还是离线上限。灰色点线是 base 用 wait-k,是最差的基线;蓝线是 prefix 用置信度机制。几乎每张小图里,蓝线都稳稳压在其它曲线的左上方——用低得多的延迟就逼近了离线质量;而 base wait-k 要花大得多的延迟才追得上来。
量化对比(下表是 FLEURS 上”COMET-over-AL 曲线下面积 AUC”,越高越好):
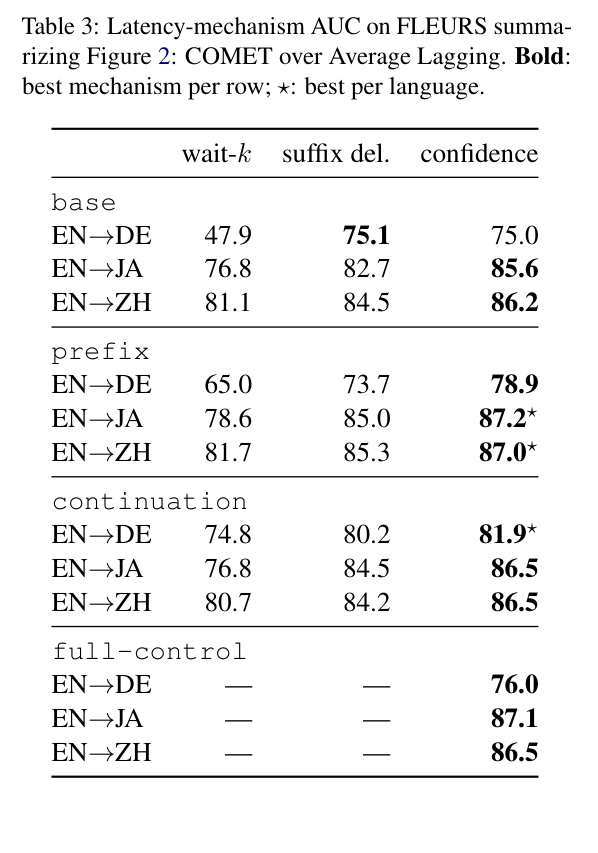
几个结论一目了然:
- 微调 » 不微调:以英译德为例,base 用 wait-k 只有 47.9,换成 prefix + 置信度直接干到 78.9。
- 三个旋钮里,置信度(confidence)机制普遍最好:它按模型自己的把握动态读写,比 wait-k 的”一刀切节奏”和砍尾巴都灵活。
- prefix 和 continuation 各有胜负:置信度机制下 prefix 在英译日(87.2)、英译中(87.0)拿到该语言最佳,continuation 则在英译德(81.9)反超。论文的解释是 prefix 每轮都强制解码完整的已提交译文当上下文,把整条曲线往上拉。
最后一个有意思的点:为什么置信度机制对 prefix 模型特别好使? 因为 stable prefix 训练顺带把模型的”提交置信度”校准了——prefix 模型说”我有把握”的时候,往往真的到了可以安全提交的位置(论文用 Expected Calibration Error 衡量,prefix 的校准误差明显更低)。置信度可信,用它当读写信号(那个阈值 τ)才靠谱。
局限也说清楚(论文挺实诚):这是级联方案,ASR 的错误会往下传;2000 万合成数据的成本不低;整套方法依赖一个离线老师译文来定义 stable prefix(本质是自蒸馏);而且只验证了英译德/日/中三个方向。
7. 迁移到 ASR 和其他实时任务
这篇虽然做的是翻译,但我读完第一反应是:这套”stable prefix + 置信度读写”的思路,几乎是为流式 ASR 和其它实时任务量身定做的。展开聊几点(这段掺了不少个人私货)。
先说 ASR 有一模一样的改口病。 流式 ASR(不管是 RNN-T、chunk-based,还是 Whisper 的流式改造,或者现在的 SpeechLLM——就是把音频编码器接到一个 LLM 前面、让 LLM 自回归解码文字的那类模型,Qwen3-ASR、Kimi-Audio 都属于这类)在出中间结果时,随着音频不断进来,前面已经显示的字经常被回改。用过手机实时字幕的都见过:一句话没说完,字幕在那儿反复跳。这跟本文攻击的 flicker 是同一个东西。
stable prefix 几乎可以原样搬到 ASR:
- “源前缀”换成”音频前缀“(前 t 秒 / 前若干帧的音频,天然就是分块的)。
- 先用一个强的离线 ASR 当老师,把整段音频的转写 f 跑出来;再对每个音频前缀跑流式 ASR 得到 p_i。
- 同样算 p_i 和 f 的最长公共前缀 + 运行最大值,得到稳定转写前缀(中文按字、英文按词,跟论文对齐)。
- 拿这些(音频前缀,稳定转写前缀)对去微调流式 ASR 或 SpeechLLM,让它学会”只提交敢提交的字,hold 住不稳的尾巴”。
置信度那个读写策略更是通用件。 Δ = P(最可能非结束符) − P(结束符),配一个阈值 τ——这套东西对任何自回归的实时生成都成立:流式 ASR 用它决定”这个字要不要现在就吐”、增量 TTS 用它决定”这段音频要不要现在就合成”,语音到语音、直播字幕、甚至”边想边答”的 streaming agent 都能套。而且 τ 是推理期旋钮,一份权重就能滑出整条延迟-质量曲线,工程上太香了。
还有个天然的组合拳:这篇本来就是级联同传的 MT 半边。如果把前面的 ASR 也用 stable-prefix 训练改造成不改口的,再接上这套不改口的 MT,整条 ASR→MT 流水线就都 flicker-free 了,两段还能各自用 τ 调延迟。这对做实时会议同传、直播翻译的场景很有想象空间。
但有几个坑得提前想清楚:
- 能不能改口,决定了收益大小。 纯展示型字幕其实是允许回改的(观众能接受字幕微调),这时 stable prefix 的收益主要在观感;但commit-once 场景(语音转语音、级联后接下游模块、已经播出去的音频)根本没法反悔,这才是 stable prefix 真正的主场——它把”最坏情况”托住了(回想 Table 2 的 Worst 列)。
- 音频是连续信号,不是离散词。 “前缀”要按时间/帧切,延迟指标也得从”滞后几个词”换成音频时间或计算感知延迟(computation-aware latency),不能照抄 AL。
- SpeechLLM 是 decoder 架构,forced-prefix + 置信度几乎能 1:1 搬;但传统 RNN-T / CTC 那套没有显式的 EOS 概率,Δ 的定义得改造(比如用 blank 概率或 token 后验的 margin 替代)。
- 老师质量是天花板。 稳定前缀是拿离线老师的转写当”真值”抽出来的,老师错了学生跟着错。ASR 里离线模型通常比流式强不少,这条一般成立,但领域词、专名上仍要当心。
一句话:这篇的贡献与其说是”一个更好的同传 MT”,不如说是给出了一套”把稳定性构造进训练数据 + 用模型自身置信度做读写决策”的通用配方,翻译只是它第一个落地的任务。
8. 小结
回到最开始那个矛盾:同传的难,难在”话没说完就得表态”。这篇论文没有去发明什么复杂的读写网络,而是绕到了数据这一侧——先用离线老师把”哪些部分迟早不会变”标出来(stable prefix),让模型从数据里就学会克制;再在推理时用 forced prefix 把”说过的不许改”变成硬约束,用一个置信度阈值把延迟做成可调旋钮。整套东西简单、可解释、还能拆开复用。
对做流式语音(ASR / TTS / 同传)的同学,我觉得最值得抄的就是那个 stable prefix 构造法:任何”边接收边输出、又不希望反复改口”的任务,都可以先问自己一句——我能不能用一个离线的强模型,把”稳定的那部分”从数据里先框出来?
扯句题外话:这套”用推理期的一个标量旋钮换延迟-质量”的思路,和我们平时做模型压缩 / 效率优化时”用一个可调超参在精度和开销之间取舍”的心态其实相通。这方面的系统积累,我和朋友整理进了《动手学 AutoML:从 NAS 到大语言模型优化实战》——书里更多聊的是 NAS、超参搜索和 LLM 剪枝 / 量化这类”训练与压缩侧”的自动化,和本文的”推理侧读写策略”角度不同、目标相近(都是在质量和成本之间找更好的前沿),感兴趣可以当相邻方向翻翻。
