Jev 拆解:不生成文本的 AI,究竟怎么直接做决策?
Jev 拆解:不生成文本的 AI,究竟怎么直接做决策?
主要资料:Jev 官方发布博客 · Jev 官方文档 · ConfTuner(NeurIPS 2025)。各实现的源码、模型卡与完整 URL 统一列在文末。
1. 一个只需要回答 A/B/C 的任务,为什么还要生成一段文字
一个客服 Agent 收到这样的请求:
信用卡被重复扣款了,希望今天退款,否则我就取消订阅。
系统接下来真正需要做的,其实是几个很具体的判断:该转给 billing 还是 account security?用户有没有明确要求退款?流失风险高不高?要不要在一小时内回复?
今天最常见的做法,是把工单、问题和候选答案一起塞给 LLM,让它返回 A/B/C 或一段 JSON。这个方案当然能用,但答案明明只有几个选项,模型还是要一个 token 一个 token 地生成;生成完还要解析 JSON、检查字段、处理越界选项,偶尔遇到 markdown code fence、解释性废话或者空字符串,还得重试。
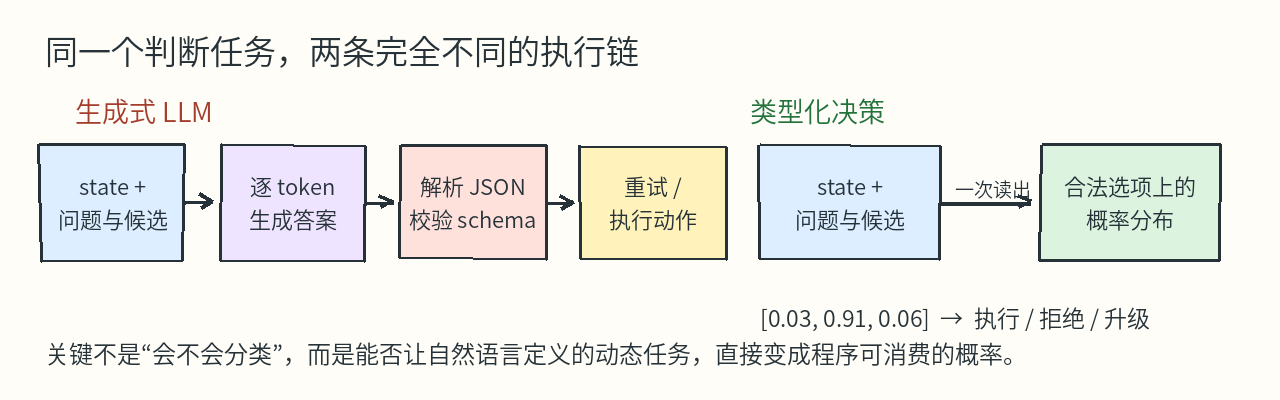
另一头是传统分类器。BERT 接一个 Linear(H, K) 分类头,一次 forward 就能返回 K 类概率,便宜又直接;问题是 K 个类别通常在训练时已经写死。业务一旦从“billing / technical / sales”换成另一套 taxonomy,往往就要改 head、准备数据、重新训练。
Jev 想填的是两者之间这块空白:
任务和候选由自然语言在请求时定义,输出却像专用分类器一样,直接是程序可以消费的概率。
这类模型现在常被叫作 typed decision model,也就是“类型化决策模型”。这不是某一个具体模型的名字,而是一类输出合同:模型不负责自由写作,只在调用者给出的有限答案空间里做 Choice、Score 或 Boolean 判断。Jev 是闭源产品,随后出现的 OpenJev、Nimble、this-that-model、Laya 则用了完全不同的方式去实现相似能力。甚至 NeurIPS 2025 的 ConfTuner,虽然仍然保留文本生成,也在解决同一个核心问题:怎么把模型的判断变成可信、可执行的概率。
2. Jev 把自然语言理解包装成了一个概率接口
TypeSafe 在 2026 年 9 月发布 Jev,把它称为第一个 “System One model”。这个名字借用了卡尼曼的系统一/系统二:系统二慢慢推理、组织语言,系统一快速做直觉判断。这个比喻是否严谨可以另说,产品定位倒是很清楚——Decisions, not strings。
一次 Jev 请求由一份 state 和一组 questions 组成。state 是所有判断共享的当前状态,可以是字符串、JSON 或数组;每个 question 则描述“要判断什么”和“合法答案有哪些”。例如:
state = {
    "message": "信用卡被重复扣款,希望今天退款,否则取消订阅",
    "plan": "Pro",
    "duplicate_charge": True,
}

questions = {
    "department": {
        "type": "choice",
        "instructions": "哪个团队应该处理这张工单?",
        "criteria": {
            "billing": "账单、扣款和退款",
            "security": "盗刷与账户安全",
            "technical": "产品故障",
        },
    },
    "churn_risk": {
        "type": "score",
        "instructions": "评估用户流失风险",
        "criteria": ["低", "中", "高"],
    },
    "refund_requested": {
        "type": "noul",
        "instructions": "用户是否明确要求退款?",
    },
}
这三个 question 都能读到同一份 state,但彼此独立,不能读取其他问题的答案。问题 ID(上面的 department)只负责让返回结果对上字段,模型实际判断依赖的是 instructions 和 criteria,所以不能只取一个聪明的字段名,却把指令写得含糊不清。
2.1 Choice、Score 和 Noul 是 Jev 唯一能“说”的三种话
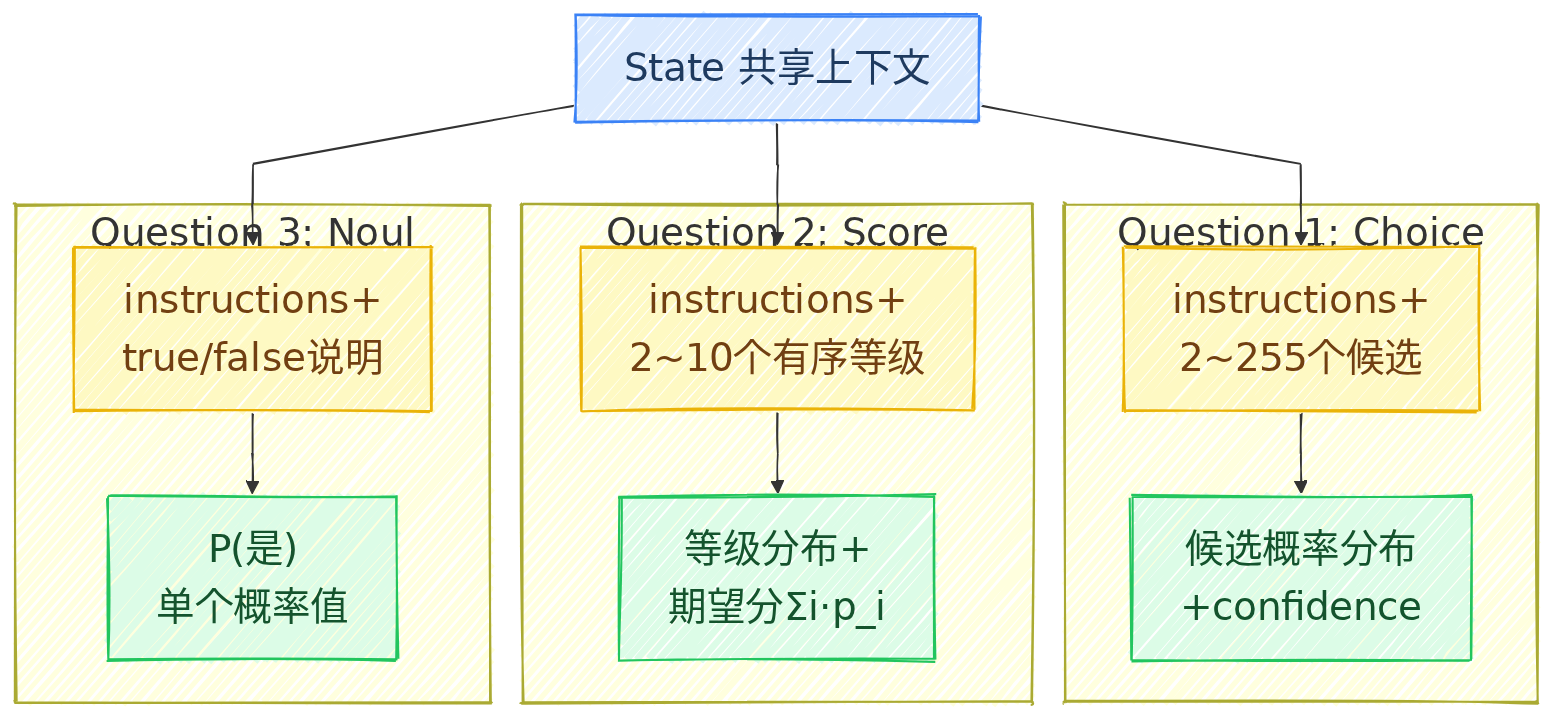
Choice 接受 2~255 个候选,返回每个候选的完整概率分布、top-1 选项和一个 confidence。候选来自本次请求,不是训练时写死的类别:今天可以判断客服队列,下一次也可以判断 Agent 该调用哪个 tool。
Score 接受 2~10 个有序等级,返回各等级的概率,再计算期望分:
\[\text{score}=\sum_{i=0}^{K-1} i\,p_i\]假设“低、中、高”三个等级的概率分别是 [0.1, 0.6, 0.3],期望分就是 $0\times0.1+1\times0.6+2\times0.3=1.2$。它不是粗暴地只返回“中”,而是保留了向“高”偏移的不确定性。
Noul 是 Jev 给 yes/no 判断起的名字,SDK 里也常写成 Boolean。它只需要返回一个 $P(\text{true})$,因为 $P(\text{false})=1-P(\text{true})$。
完整分布比单独返回 top-1 更有价值:
A: 0.91, B: 0.06, C: 0.03
A: 0.43, B: 0.41, C: 0.16
两次的答案都是 A,但后者几乎是掷硬币。前者可以自动执行,后者更适合追问用户、升级到更强模型或者转人工。Jev 真正卖的不是“会分类”,而是把自然语言理解变成 workflow 的控制信号。
2.2 255 个候选不够时,不是把 head 硬扩到几万个类别
官方文档给 Choice 设的上限是 255 个选项。这个数字究竟来自模型结构还是产品工程约束,官方没有解释,所以不能看到 255 就脑补成 Linear(H, 255),更不能猜它和一个字节有关。
对于上千甚至上万个候选,官方建议把 taxonomy 做成树:先判断大类,再判断子类,并用 beam search 在每一级保留概率最高的 K 条路径。beam search 可以理解成“不只押一条路”,它会留下几个最有希望的分支继续往下搜索,避免第一层一次误判就彻底出局。
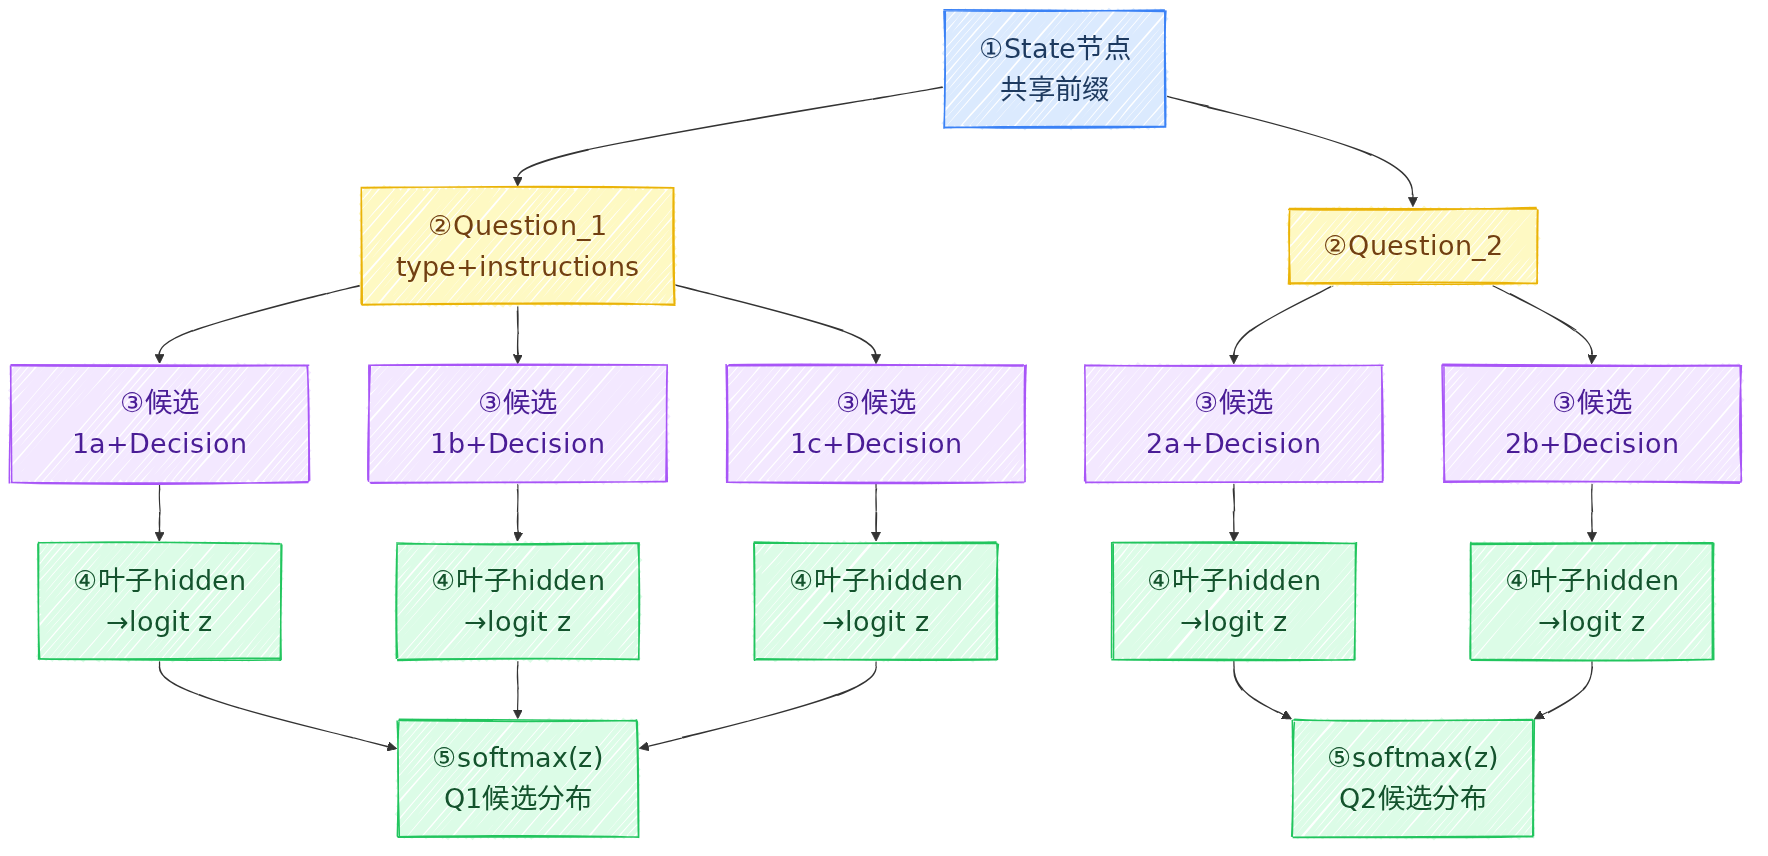
这条路线适合产品目录、工单 taxonomy 等天然有层级的任务,但它也意味着“大规模选择”不再是一次 forward:树越深,请求链越长,上一级的错误也会传给下一级。
2.3 “没有输出 token”不等于“没有计算”
Jev 当前公开的信息可以支持下面几个判断:
- 它不向用户生成自由文本,而是返回 Choice、Score、Noul 的数值结果;
- 多个独立 question 可以在一次请求中处理;
- state 与全部 questions 合计最多 64k token,state 加最长单个 question 不超过 32k;
- 官方定价是每百万输入 token 0.042 美元,输出免费,因为没有输出 token;
- 官方宣称在自己的 workflow 中比生成式模型快 20~200 倍、便宜 40~400 倍。
最后一组数字高度依赖模型、输入长度、网络、batch 和生成长度,适合说明方向,不能当成通用 benchmark。
更重要的是,官方没有公开 backbone、参数量、attention mask、decision head 和 forward 过程。因此下面这些说法都不能当成 Jev 事实:
- “Jev 就是让 LLM 只生成一个 A token”;
- “它一定复用了 state 的 KV Cache”;
- “它内部是 pointer head”;
- “255 就是固定输出 head 的宽度”。
不生成自由文本,省掉的是自回归 decoding loop、输出传输和 parser,不是把 prefill、question encoding 和候选打分全部省掉。后面会看到,不同开源项目都对外返回相似的 JSON,底下的计算图却完全不是一回事。
2.4 RLCD 想让概率对得上现实,但 recipe 还在黑盒里
TypeSafe 把 Jev 的训练方法叫作 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)。所谓 calibration,不是“模型每次都很自信”,而是它给出 0.8 的那批判断,长期看应该大约有 80% 真正答对。
这和 accuracy 是两个维度。一个模型可以 top-1 accuracy 很高,却总把 60% 的把握报成 99%;也可以 accuracy 一般,但很诚实地知道自己什么时候不会。业务要根据阈值自动退款、执行 shell command 或拦截用户时,后者往往同样重要。
遗憾的是,RLCD 目前公开的是目标,不是完整 recipe。reward 怎么算、是否真的使用 policy gradient、训练数据从哪里来、规模多大、backbone 更新哪些参数,都没有披露。Jev 可以作为闭源基线,但不能把后面任何一个开源实现的结构倒推成它的内部结构。
3. 从“会报置信度”到“完全不生成”,差别不只是换一个输出头
Jev 把目标定义得很清楚:输入一份 state 和若干问题,直接返回有限选项上的概率。但官方没有公开模型结构,于是社区实际上沿着几条不同的路在回答同一个问题:怎样把一个擅长语言理解的模型,变成便宜、稳定、可以直接接进程序分支的决策器?
下面这张图先给出全貌。阅读时从上往下看,改造逐渐深入:最上面仍然让 LLM 写答案;第二层不再生成,只读取现成模型对 A/B/C 的分数;第三层开始用决策数据训练;第四层继续解决多个问题重复计算 state 的问题;最下面则连生成式 backbone 都换掉。右侧不是效果排名,而是每条路线最鲜明的取舍。
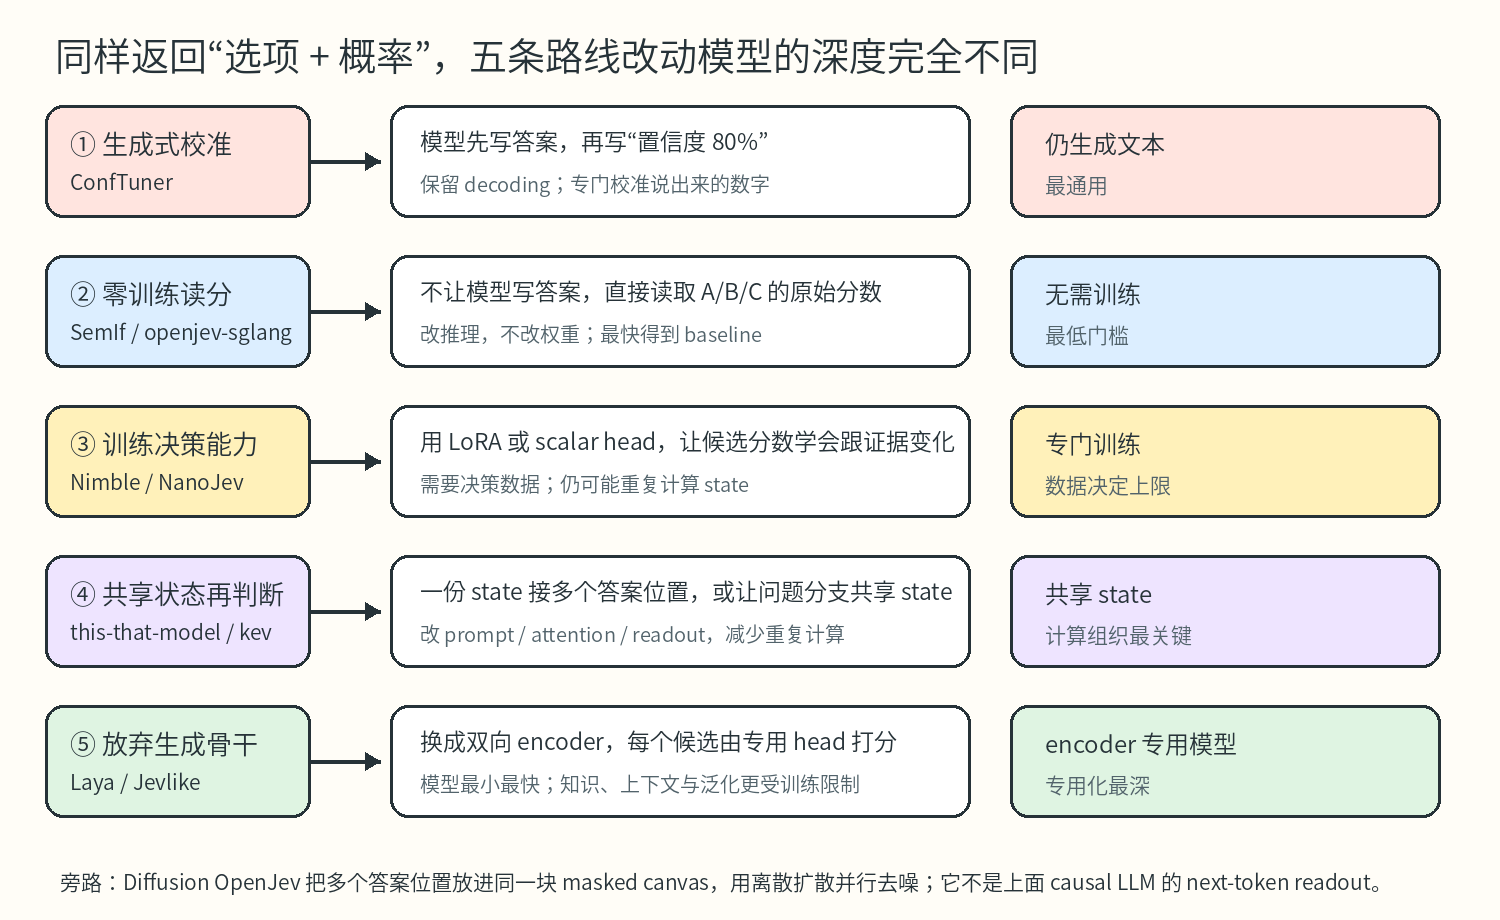
一句话概括各自特点:
- ConfTuner:不改生成范式,重点解决“模型说 80% 时,能不能真的对 80%”。
- SemIf / openjev-sglang:不训练新模型,直接读取现成 LLM 对合法选项的分数,是门槛最低的 baseline。
- Nimble / NanoJev:给现成 LLM 加 LoRA 或打分头,让候选分数真正学会跟随关键证据变化。
- this-that-model / kev:不只改怎么打分,还改一次 forward 里的信息流,尽量让多个问题共享 state。
- Laya / Jevlike:放弃自回归生成骨干,改用双向 encoder 和专用 decision head,模型更小,但能力边界也更依赖训练数据。
还有一条不能硬塞进这条梯子里的旁路:基于 DiffusionGemma 的 OpenJev 把多个答案空位放在同一块 masked canvas 上,用离散扩散同时去噪。它不是普通 causal LLM 的 next-token readout,后面单独讲。
后文会反复用到两个词。Readout 指“模型算完 hidden states 后,究竟从哪里把最终答案读出来”;answer slot 则是输入中专门留给某个问题的“答案位置”,模型不一定真的在这里生成 token,也可以只读取这个位置的 hidden state。先把这两个概念放稳,后面的结构差异就不会像模块名堆砌。
4. NeurIPS’25 ConfTuner:不省生成成本,先解决“80% 到底是不是真的 80%”
ConfTuner 论文不是 Jev-compatible server,也没有取消自回归生成。它代表这条路线的起点:模型照常生成答案,再用自然语言写出 Confidence: 80%。论文把这种说出来的置信度称为 verbalized confidence,也就是“语言化置信度”。
4.1 多问十次得到的一致率,不等于模型答对的概率
过去常见的办法,是让模型回答同一道题很多次:十次有九次都答 A,就把 confidence 记成 90%。问题是模型完全可能稳定地答错。另一些方法让 teacher model 给答案打分,也只是把 teacher 的偏差搬过来;多次采样还会同步放大数据构造和推理成本。
ConfTuner 的关键特点可以压成一句话:不用“模型自己是否前后一致”当标签,而是直接用答案真实的对错,校准它说出口的 confidence。
4.2 公式看起来绕,本质是让“答对报高、答错报低”可以反向传播
模型生成到 Confidence: 后,ConfTuner 先不急着取最终数字,而是读出 0~100 这 101 个数字 token 的 logits。logit 是 softmax 之前的原始分数;对这 101 个分数做 softmax,得到 $q_0,\ldots,q_{100}$,表示模型分别有多倾向于报告 0%、1%……100%。
下图从左到右分两步。上半部分先把模型原本想说的 99% 展开成 101 个数字上的分布;下半部分再根据答案其实是错的,把目标放到 0%,用损失把概率质量从 99 一侧推回 0 一侧。图中的重点不是“最后从 99 改成 5”这个个例,而是训练时使用了完整的 101 维分布,不是把最终输出的一个数字当普通字符串处理。
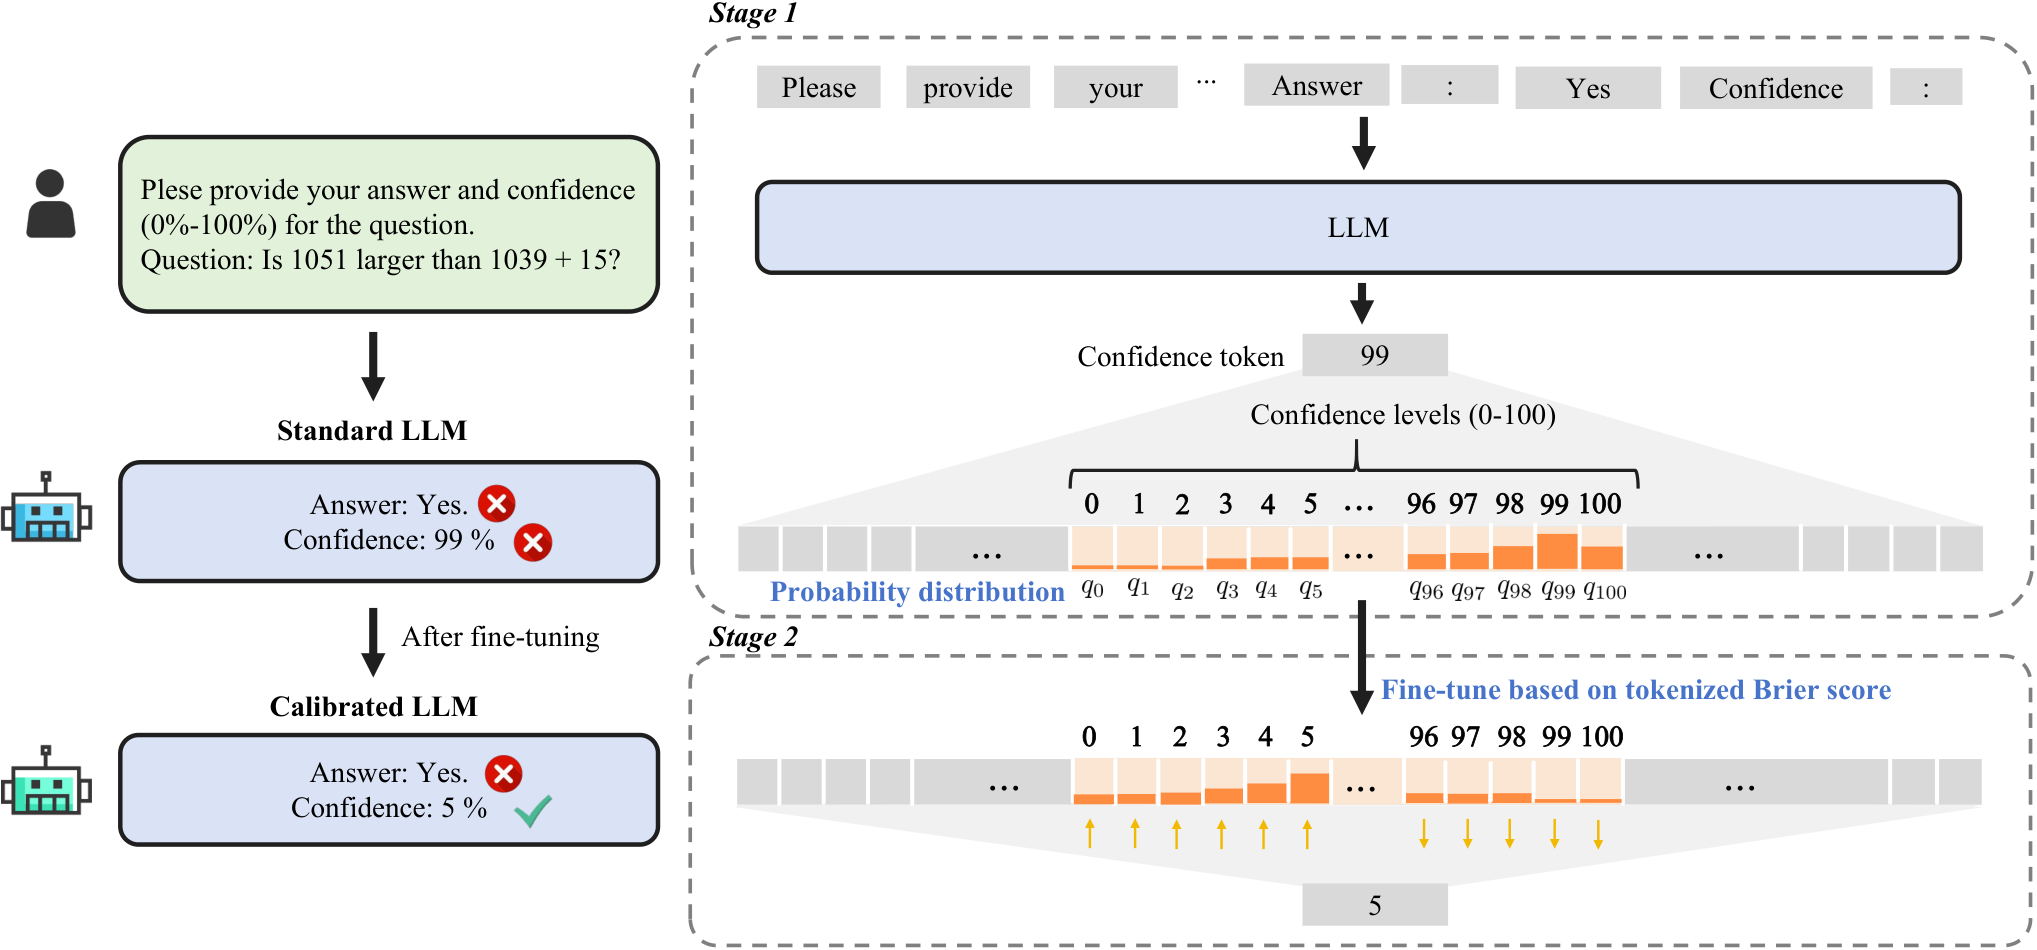
论文使用 tokenized Brier score:
\[\mathcal L=\sum_{i=0}^{100}\left(q_i-\mathbb 1[i=100y]\right)^2,\qquad y\in\{0,1\}.\]把公式翻译成人话:$y=1$ 表示答案正确,目标就在 100% 那一格;$y=0$ 表示答案错误,目标就在 0% 那一格。模型在 101 个格子上预测的概率与目标相差多少,逐格平方再求和。Brier score 越低越好,而且它是 proper scoring rule——长期来看,模型如实报告自己相信的正确概率,期望损失最低;永远报 99% 或者永远躲在 50%,都占不到便宜。
训练只用了 HotpotQA 的 2000 条样本和 LoRA。LoRA(Low-Rank Adaptation)是在部分线性层旁插入小型低秩矩阵,只训练这部分增量参数;论文设置是 rank 8、alpha 32,作用在 attention 的 Q/V projection 上。
下表最值得看的是最后两列:ConfTuner 每条输入只采样一次,因此 2000 条训练问题就对应 2000 条响应;SaySelf 每条采样 100 次,最终滚到 900 万条响应。训练时间也从 120 分钟降到 4 分钟。这里节省的不是 inference decoding,而是训练阶段不再为 proxy confidence 反复采样。
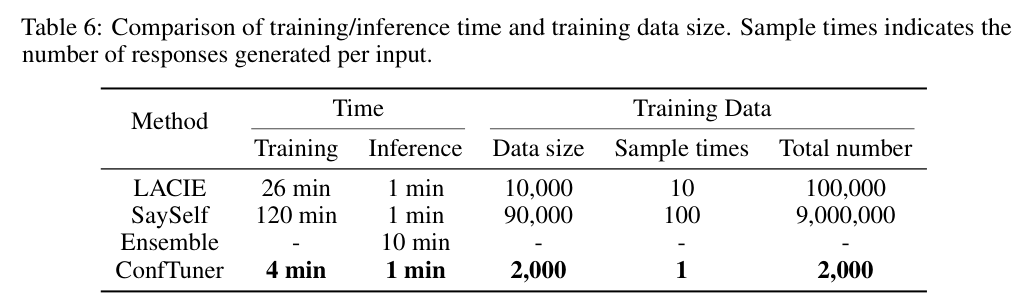
从表里横向看,LACIE、SaySelf 和 Ensemble 都要为同一道输入采样多次;ConfTuner 的 Sample times=1,所以总训练响应数没有被重复采样放大。这里的 4 分钟和 120 分钟对应论文环境,只用于比较这几种数据构造方式,不能外推成所有模型上的固定训练时间。
4.3 HTML 原图说明了两件事:同分布很强,跨分布仍然打折
论文用 ECE(Expected Calibration Error,期望校准误差)衡量置信度是否诚实。它把样本按 confidence 分桶,再比较每个桶的平均 confidence 和真实正确率,越低越好。
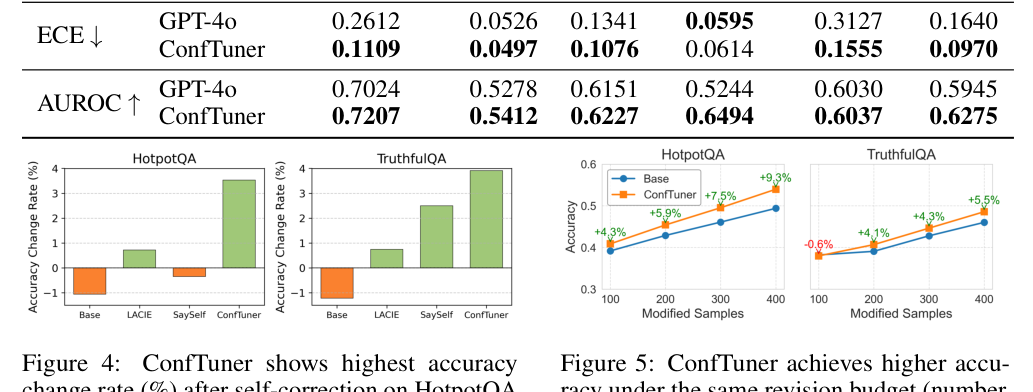
下面这张表直接从论文 HTML 页面渲染。每个 backbone 有五行方法;左侧 HotpotQA 是训练分布,右侧四个数据集没有参与这次训练。读表时先看每组最后一行 ConfTuner:LLaMA 在 HotpotQA 上从 0.4803 降到 0.0405,Ministral 从 0.6767 降到 0.1027;再看最右侧 OOD 平均值,仍有提升,但没有同分布上那么夸张。Qwen 在 GSM8K、StrategyQA 上甚至不是该列最优。
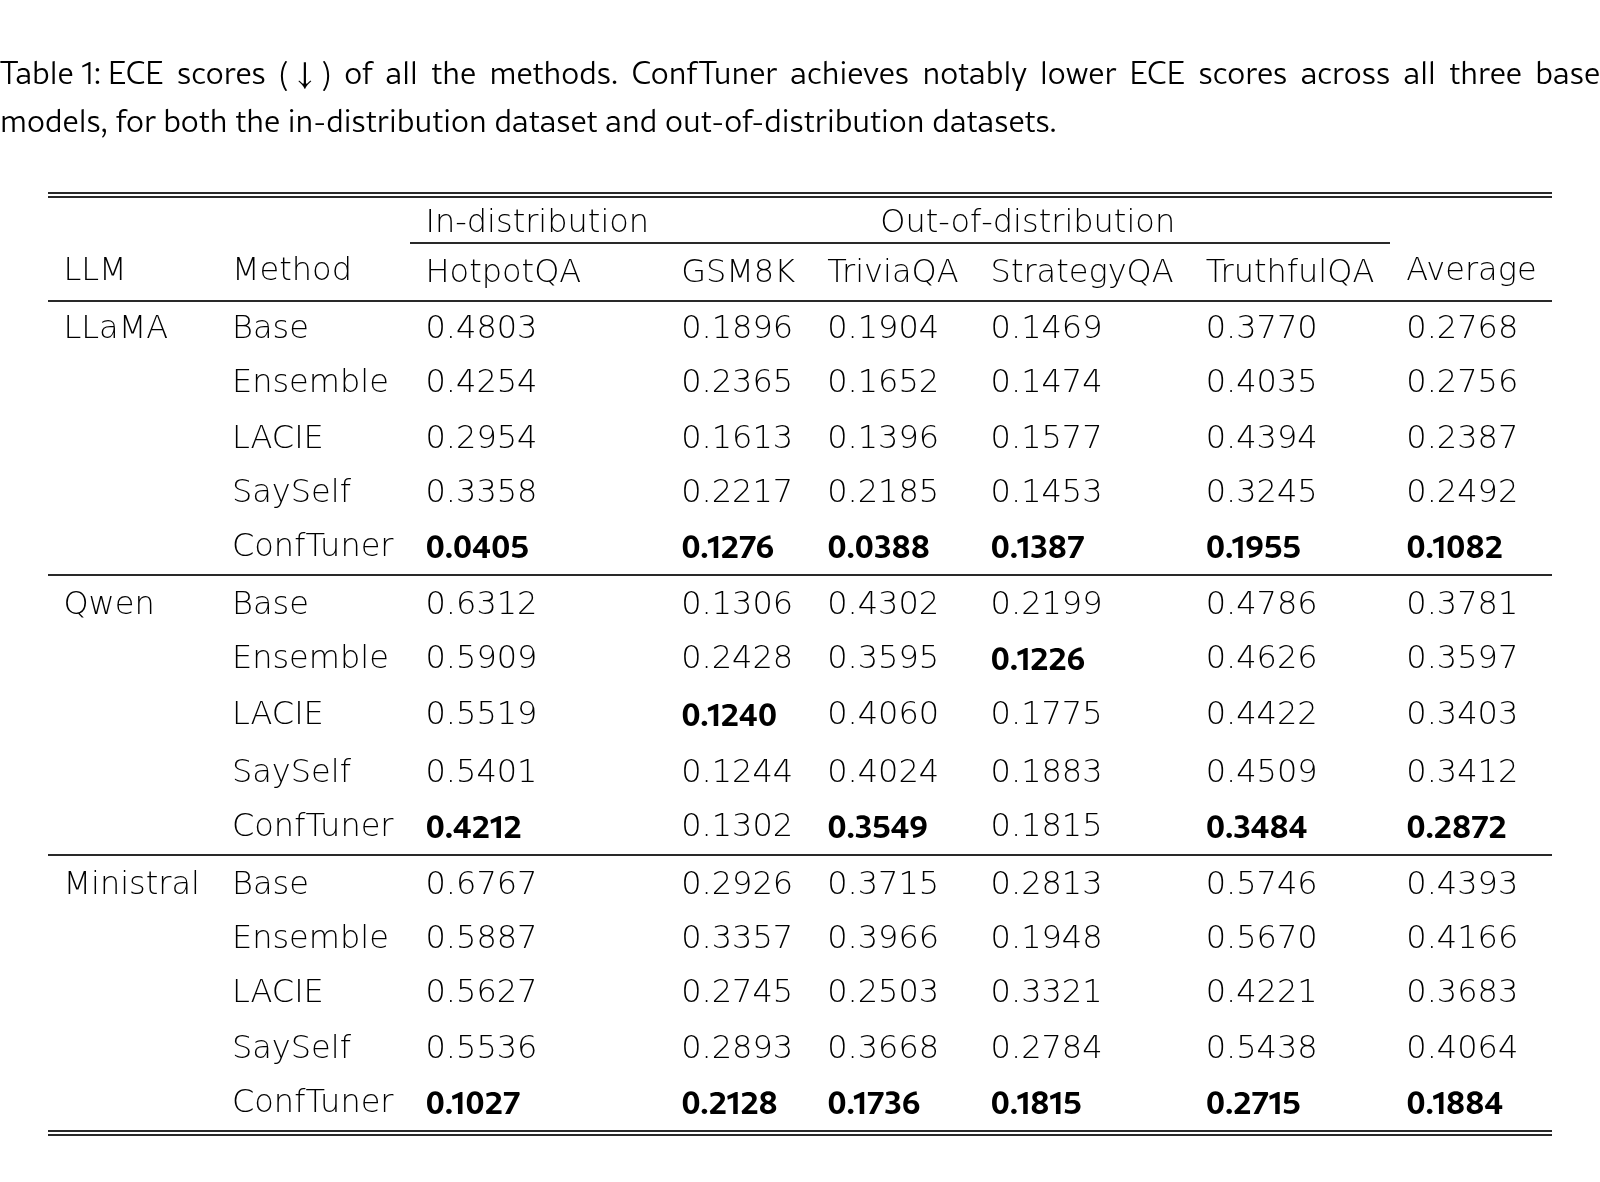
这张表还有个容易漏掉的细节:ConfTuner 并非每个 OOD 单项都拿第一,但三种 backbone 的 OOD 平均 ECE 都是本组最低。更准确的结论是“整体迁移后仍有收益”,而不是“在任何新任务上都最优”。
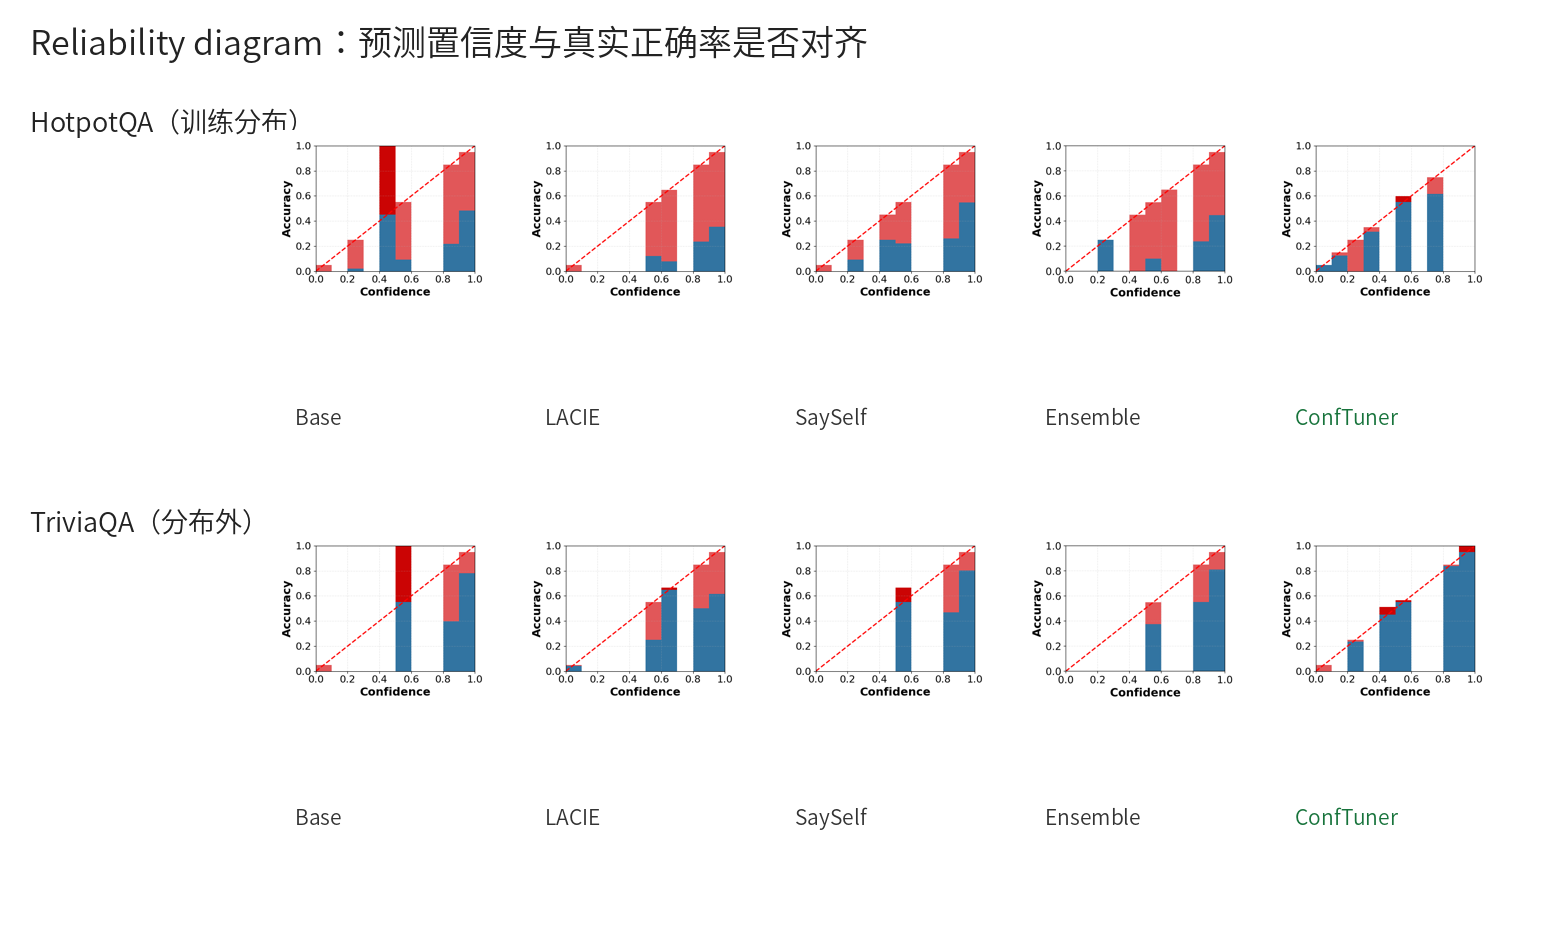
Reliability diagram 更直观:横轴是模型报告的 confidence,纵轴是该桶真实答对的比例;红色虚线代表理想状态,蓝柱与虚线之间的红色缺口越小越好。下图上排是 HotpotQA,下排是分布外的 TriviaQA,五列从 Base 到 ConfTuner。最右一列整体更贴近虚线,但 TriviaQA 仍有可见偏差——校准能力不是训练一次就能无条件迁移到所有任务。
论文还让模型看到自己的答案和 confidence,再决定要不要修改。下图左半边比较 self-correction 前后的正确率变化,右半边比较在相同修改预算下的准确率。ConfTuner 的意义不是让每道题都再想一次,而是让低 confidence 更像一个有用的升级信号。
ConfTuner 把“概率可信”这件事讲透了,但它没有解决 Jev 最显眼的系统开销:答案和 confidence 仍然要逐 token 生成。于是下一条路线干脆先不训练——既然最终只认 A/B/C,能不能直接读取模型对这几个选项的分数?
5. SemIf 与 openjev-sglang:零训练拿掉 decoding,先得到最便宜的 Jev-like baseline
这里必须先把几个容易混淆的网站拆开:
- openjev.sh 与 openjev.tech 当前是同一套访问平台。它们宣称用
$JEV交易费用补贴调用,底层提供的是 TypeSafe Jev 的公共入口,不是一个开源模型实现。 - openjev.com 是原名 OpenJev、后来改名为 SemIf 的浏览器实验;其代码仓库是 TheoLeeCJ/SemIf。
- openjev-sglang 是 Qwen + SGLang 的 Jev-compatible server。
- razorback16/openjev 是 DiffusionGemma structured read,计算方式不同,放到第 9 节。
SemIf 和 openjev-sglang 的共同点是:不先训练一个 decision model,而是把现成 instruction model 的 next-token logits 当作选项分数。
下图按从左到右的执行顺序读。prompt 先告诉模型 state、问题和候选;Transformer 做完 prefill,在最后位置产生 hidden state;原本的 LM head 会给整个词表打分;程序只留下 A、B、C 三个合法 label 的分数再 softmax。这里 A/B/C 只是候选的单 token 编号,比如 A 映射到 billing、B 映射到 security。模型不需要真的把字符 B 写出来。
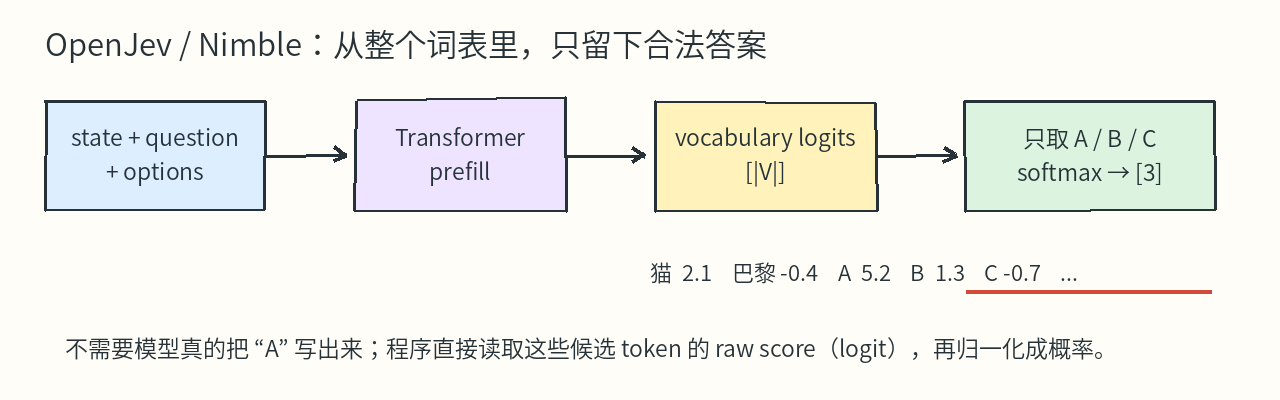
这种做法最大的优点是门槛低:没有新权重、没有训练数据,任何能返回 logits 的 LLM 都能先跑起来。SemIf 还测了 state 复用:在 37 个 state、每个 21 个判断的 workload 上,fresh scoring 是 2.33 decisions/s,serial prefix reuse 是 10.75,parallel suffixes 是 20.03。不过 BF16 的快速复用路径相对 fresh scoring 出现了 5~6/777 次 argmax 变化,说明“数学上相同的前缀复用”到了有限精度和不同 kernel 下,也要检查数值漂移。
它的短板同样直接:base model 从未被专门训练成“让 A/B/C logits 表达可靠的业务概率”。候选顺序、prompt 模板和 label token 的先验都可能影响结果。SemIf 对 Qwen3.5-4B 做的 per-workload temperature scaling,把 WANLI 上的 ECE 从 0.208 降到 0.069,也再次说明 raw softmax 不是开箱即用的 calibrated probability。
openjev-sglang 的重点更偏 serving:Qwen3.6-35B-A3B 提供能力,SGLang 的 radix cache 用前缀树复用相同 prompt prefix,再配合异步 batching 和 CUDA graph 降低 prefill overhead。它优化的是怎么更快地读现成模型,不是怎么用新数据教模型做 decision。
零训练 baseline 能验证“取消 decoding 到底省多少”,但不能保证选项分数会对关键证据敏感。下一步自然是保留这种窄 readout,同时让模型专门学一次。
6. Nimble 与 NanoJev:用决策数据训练 readout,让概率跟着关键证据变化
6.1 Nimble 的特点不是“读取一个 token”,而是用反事实样本训练这个 token
Bespoke Nimble 保留 Qwen3.5-9B 的语言能力,用 LoRA 把它训练成 decision scorer。所谓 answer code,只是给长候选取的单 token 代号:
A → 拒绝退款,因为超过 14 天窗口
B → 同意退款
C → 转人工复核
模型不生成右侧长文本,只读取 A/B/C 的 logits,再由程序映射回原始候选。answer code 本身不神秘,真正决定效果的是它前面的 hidden state 是否已经理解 state、policy 和候选之间的关系。
下图分四块:左上是一次 prefill 后读候选分数;右上是数据构造,只改一条关键事实并让 label 翻转;左下是 Qwen3.5-9B 上做 LoRA;右下是 held-out 结果。读图时最值得关注右上到左下这条因果链——模型不是模仿 Jev 概率,而是从成对的反事实样本中学习“哪条证据应该改变答案”。
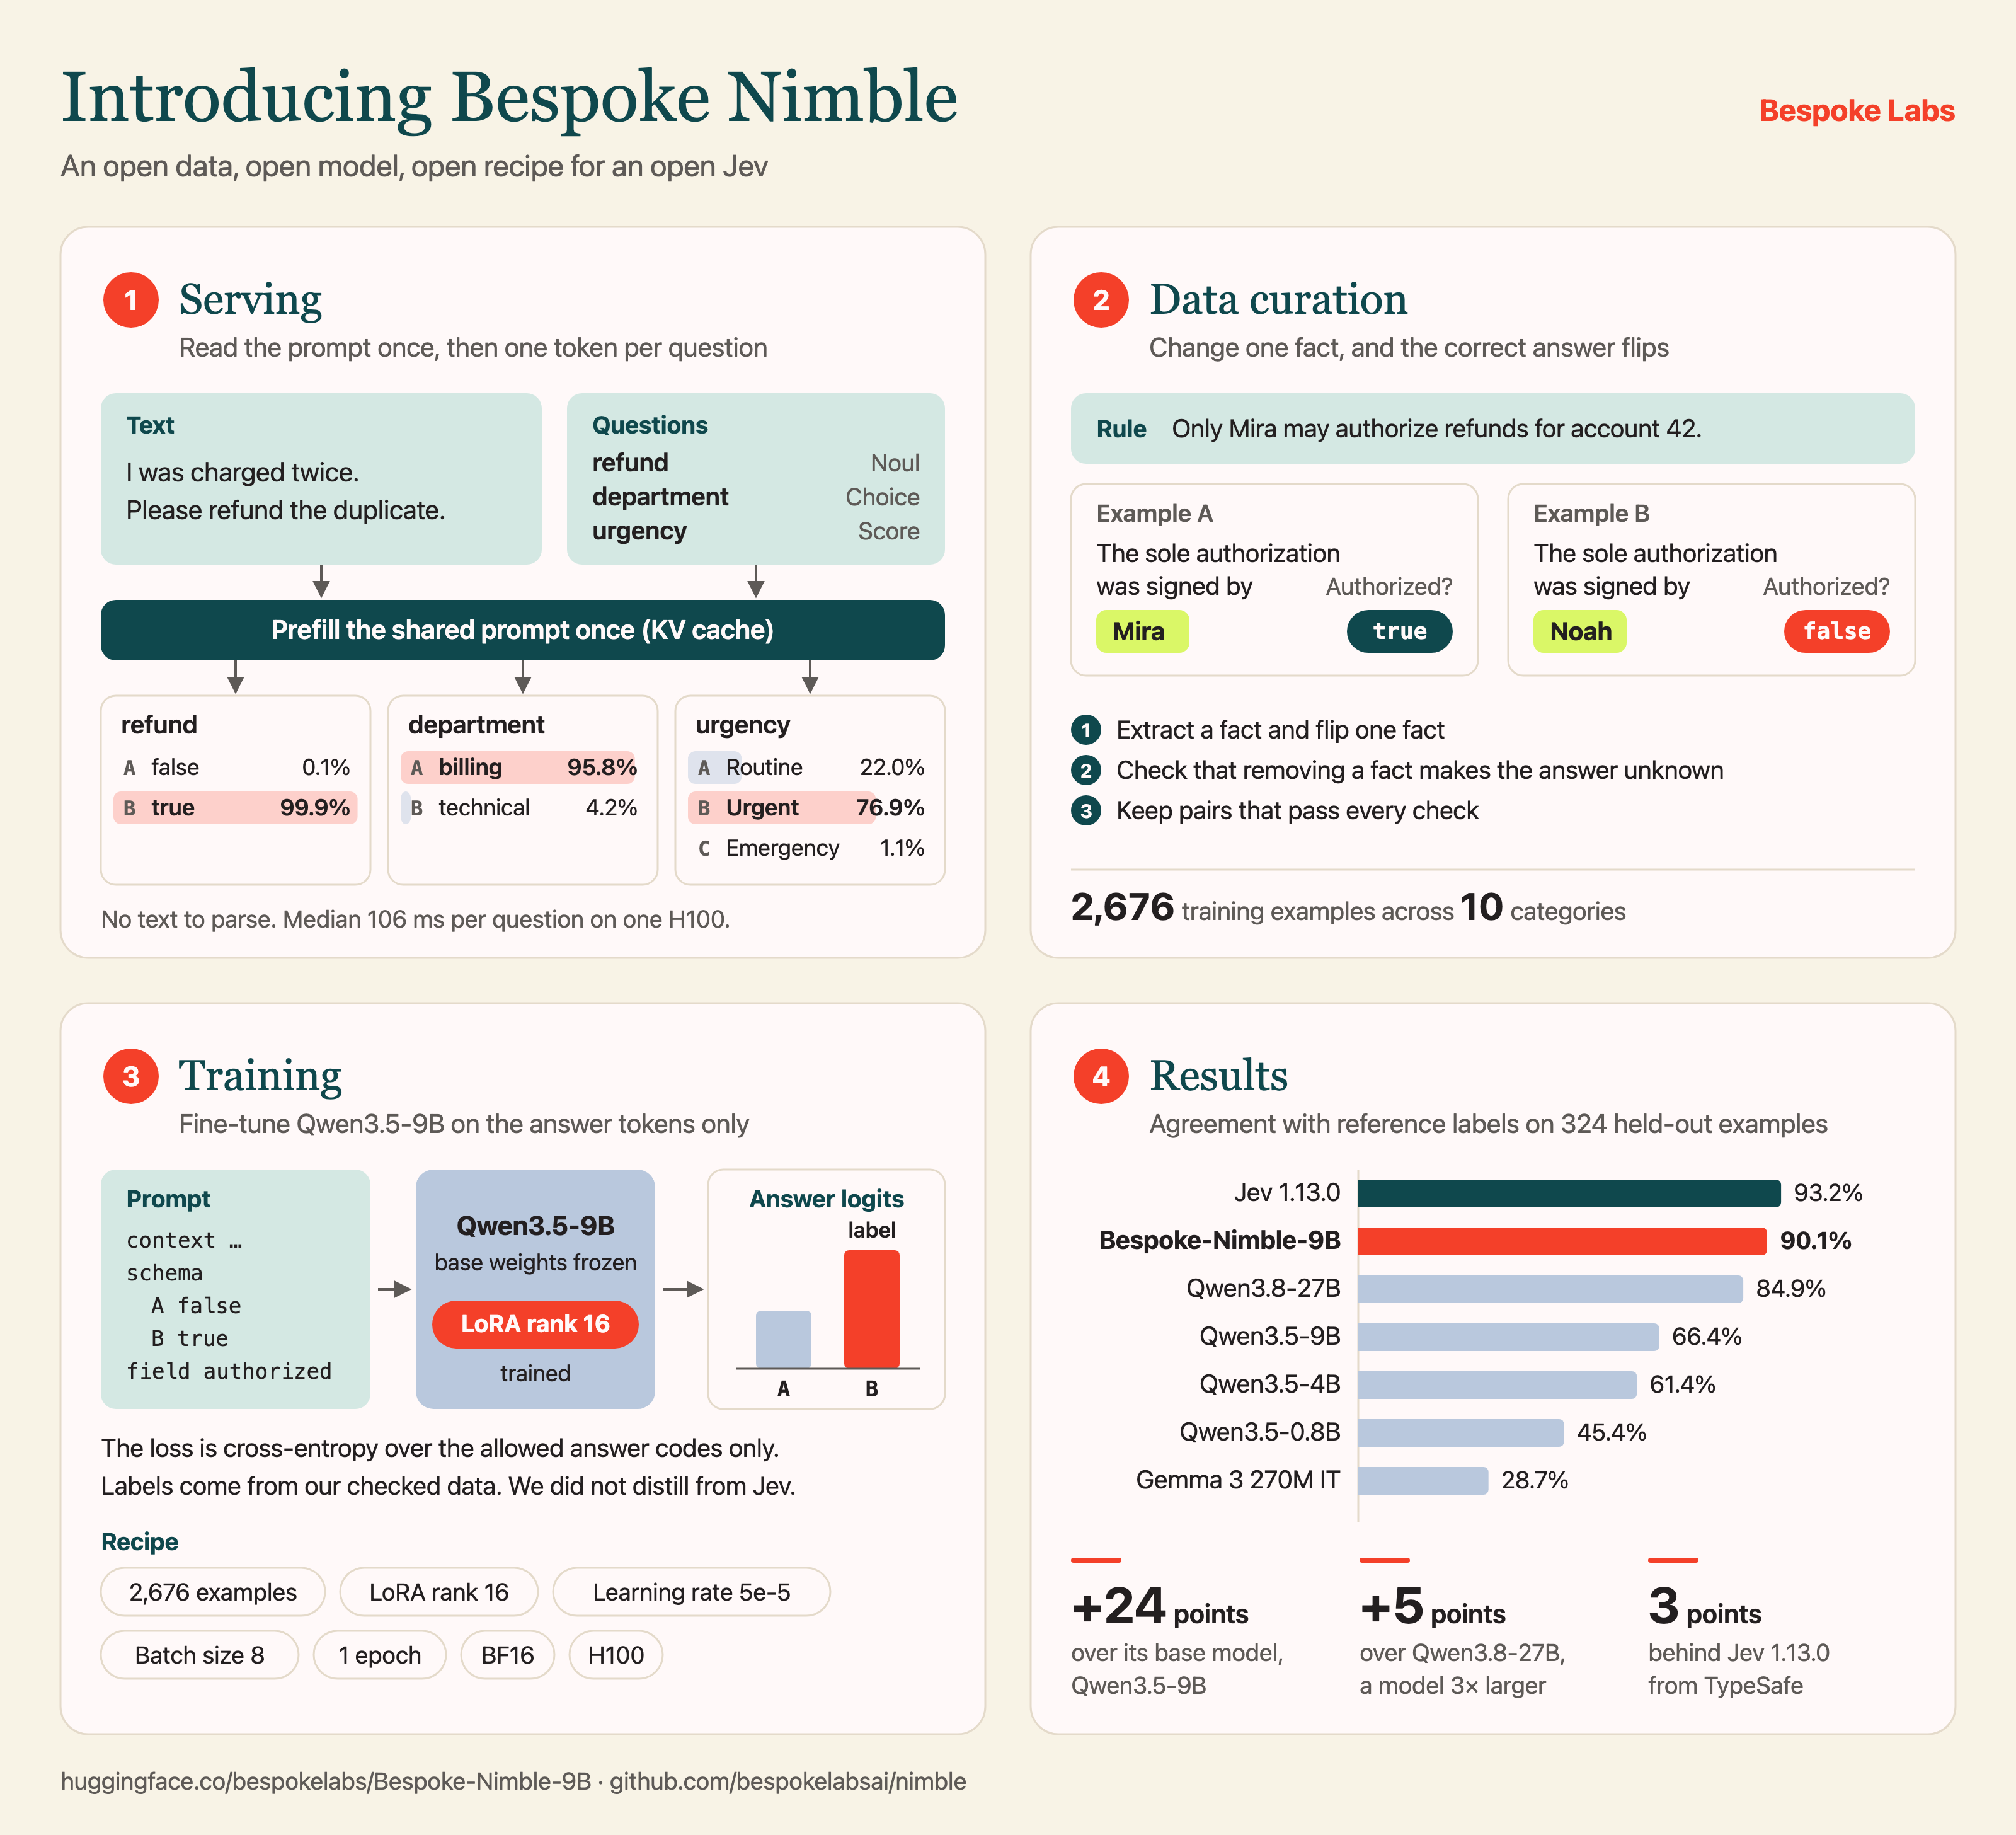
例如规则写着“只有 Mira 可以批准 account 42 的退款”。原始记录由 Mira 签署,答案是 true;反事实只把 Mira 改成 Noah,答案就变成 false。问题、规则和其余上下文保持不变。这种 contrastive data curation 能减少“看到 refund 就答 true”这类表面捷径。
训练集有 2676 条、覆盖 10 类任务,held-out 集 324 条;最终 recipe 是 LoRA rank 16、学习率 $5\times10^{-5}$、effective batch size 8、一个 epoch,在合法 answer-code logits 上优化 cross-entropy。标签由模型审核后再通过规则程序生成,没有人工逐条复核,也没有用 Jev 概率蒸馏。
下图比较同一批 324 条 held-out 样本上的 reference-label agreement。柱高只表示最终选项与 synthetic reference 是否一致:Nimble 为 90.12%,Jev 1.13.0 为 93.21%,未微调 Qwen3.5-9B 为 66.36%。它不衡量 probability calibration,所以不能从这张图推出 Nimble 的 0.9 和 Jev 的 0.9 同样可信。
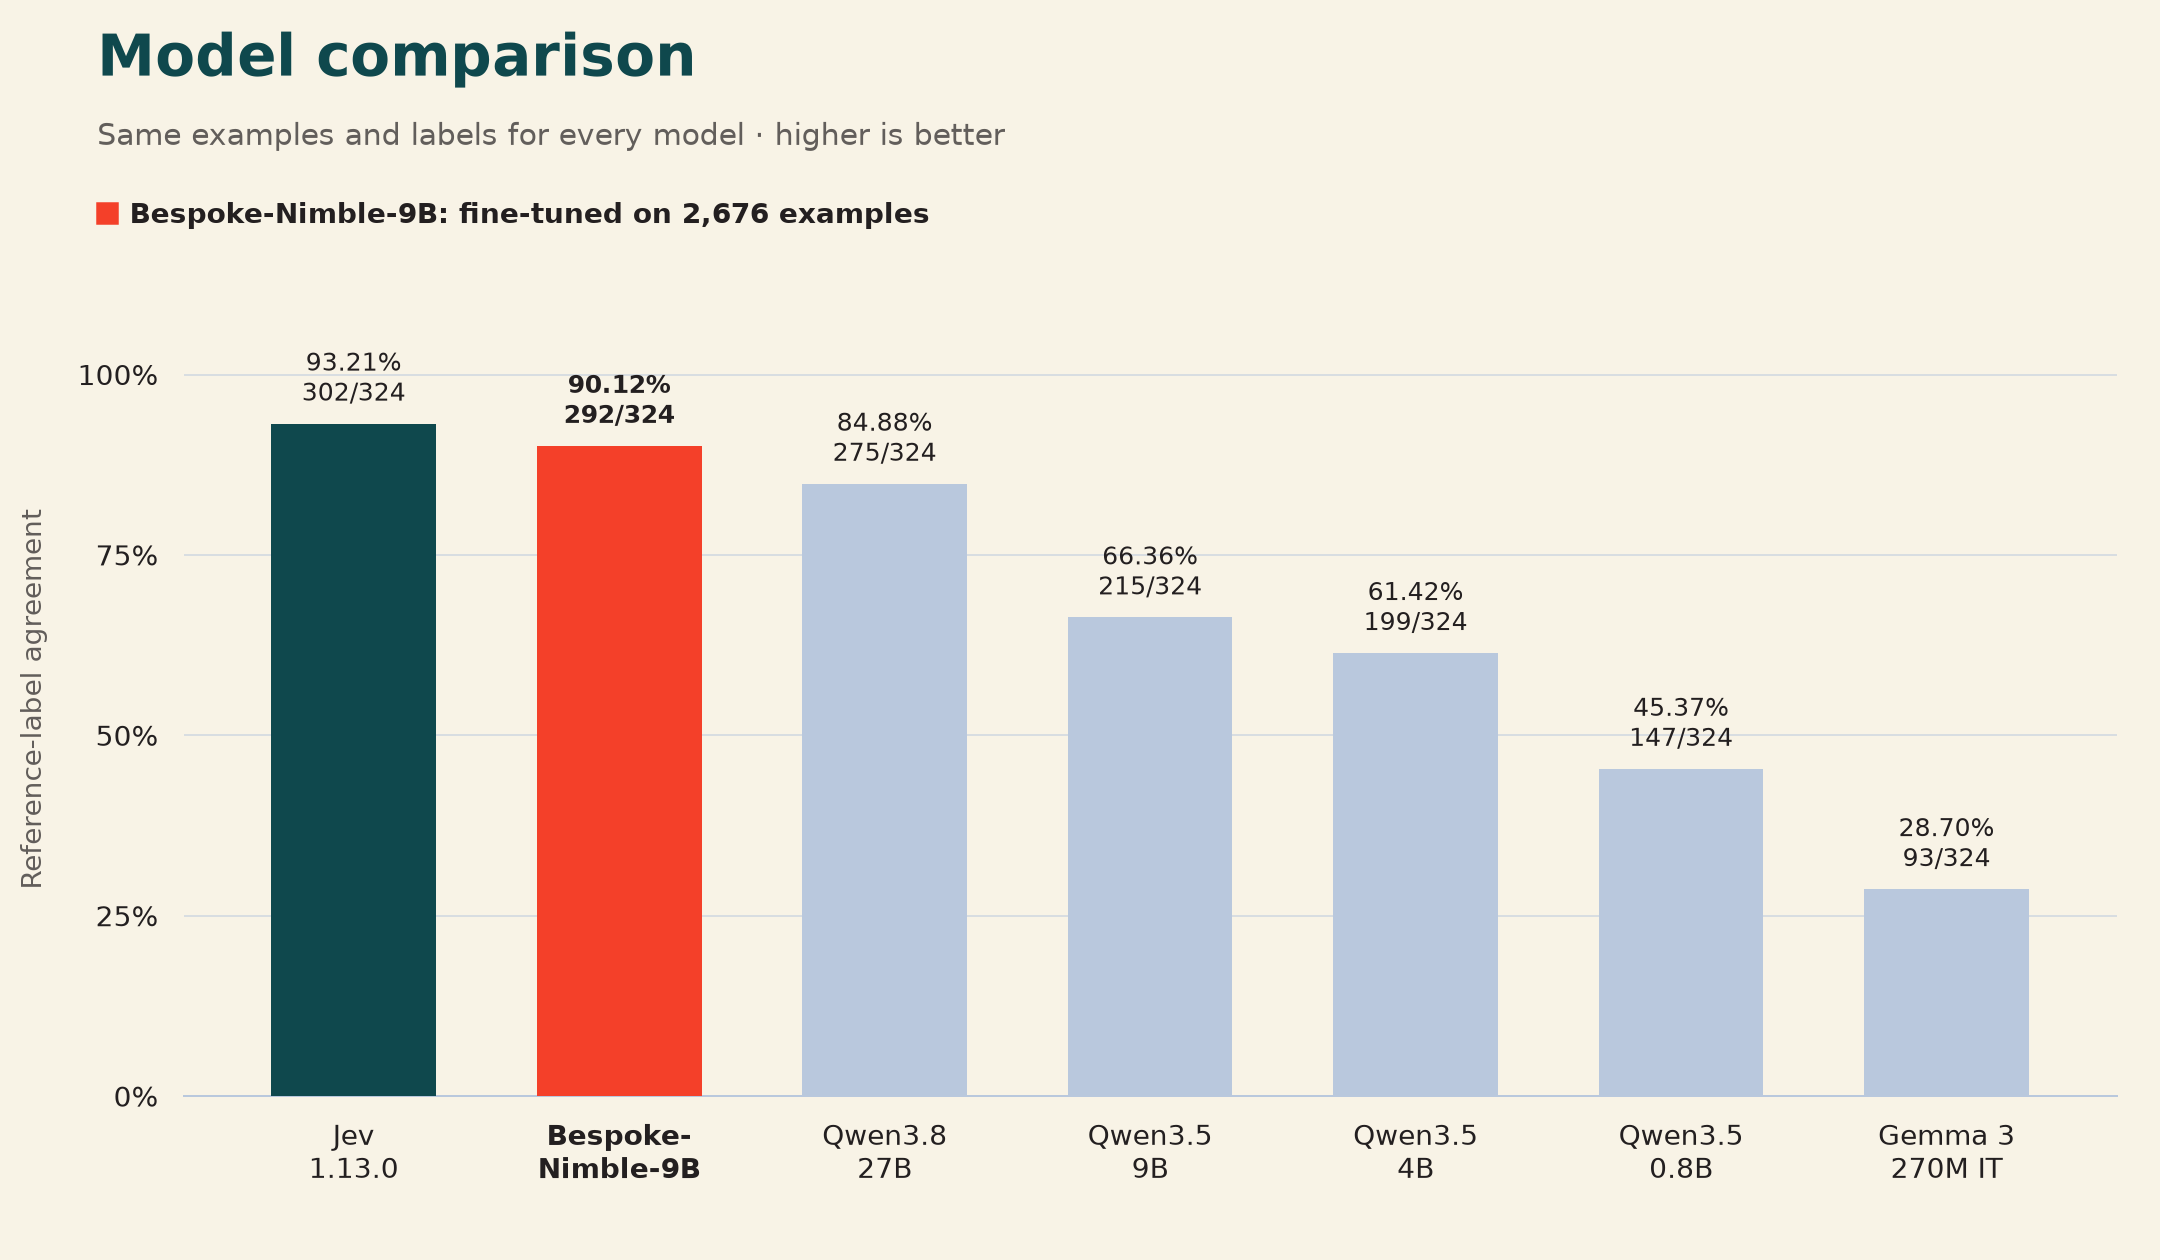
Nimble 自己也明确写了 temperature 固定为 1.0,尚未校准;CUDA scorer 当前还会为每个 field 重跑完整 prompt,MLX ParallelScorer 才复用 context。训练解决了决策能力,不等于顺手解决了概率校准和共享计算。
6.2 NanoJev 把“每候选一条路径”训练得更完整,但重复 state 的成本也更明显
NanoJev 用 Qwen3-0.6B、共享 scalar head 和 Choice set-attention,公开了模型、数据、训练与游戏评测。它会为每个候选构造一条 state + question + candidate 路径,由同一个 Linear(H,1) 打成 scalar logit,再对 K 个候选 softmax;Choice 后面的 set-attention 让候选之间可以相互比较。
好处是候选文本直接参与语义编码,训练链路也完整;代价是 20 个候选通常意味着 20 份 state 路径,只是被合并进 batch,而不是 state 真正只编码一次。这恰好引出下一层问题:决策学会了以后,怎样组织一次 forward,才能不为每个问题或候选反复算公共上下文?
7. this-that-model 与 kev:重点从“怎么打分”转向“state 怎样只算一次”
7.1 this-that-model 用 answer slot 复用 LM head
FLock-io/this-that-model 在每个问题后留一个 answer slot。这里的 slot 不是已经填入 A/B/C 的 token,而是 Answer: ( 末尾那个位置:backbone 跑完后,该位置自然有一个 hidden vector,程序直接拿它打分,不把答案写回输入。
下面的图按箭头读:两个问题先各自提供一个答案位置;一次 backbone forward 取出 $h_1,h_2$;再从原模型 LM head 里抽出 A/B/C 三个 label 对应的权重行;hidden vector 与每一行做点积,得到每题三个 logits,最后 softmax。图中的 $H$ 是 hidden size,$N$ 是问题数,$K$ 是本题候选数。
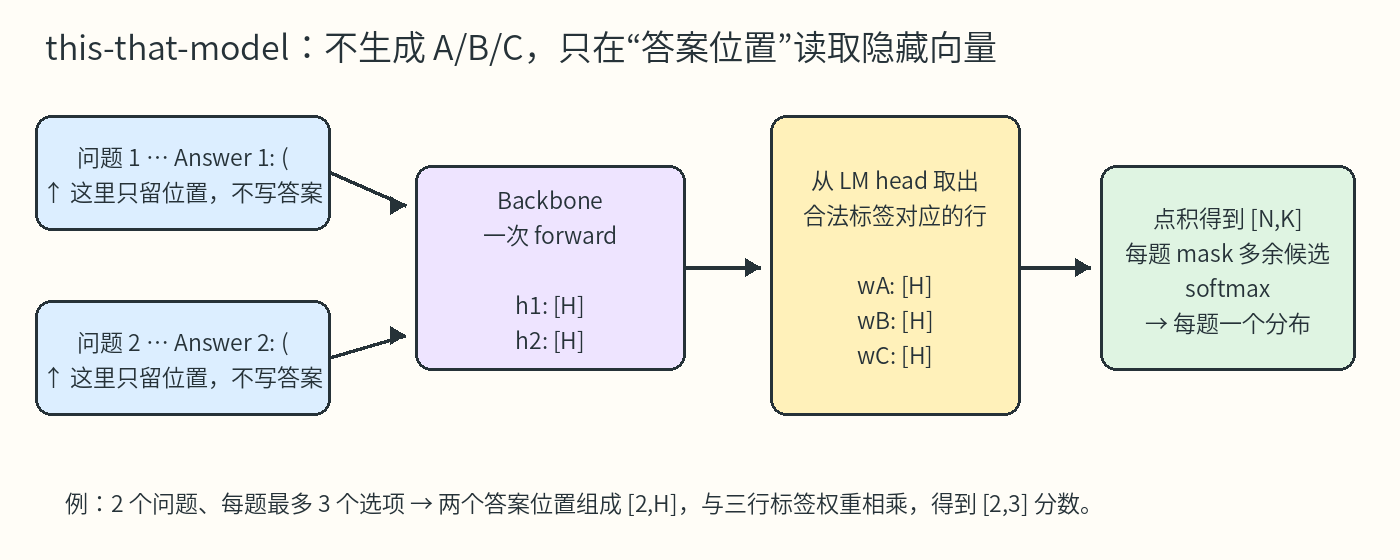
公式是:
\[p_k(j\mid x)=\operatorname{softmax}_j\left(\frac{\langle w_j,h_k\rangle}{\tau}\right).\]通俗地说,$h_k$ 是“模型读完第 k 个问题后,对答案的内部表示”,$w_j$ 是原 LM head 里“把这个表示解释成标签 j”的方向;点积越大,表示越支持该标签。$\tau$ 是 temperature,用来控制分布尖锐程度。只在合法的 K 行上 softmax 后,非法字符串根本不在答案空间里。
它的 state_first 把多个 question/slot 放在一条序列里,一次 backbone forward 读出多个结果;schema_first 则把固定问题模板放到前缀,处理许多不同 state 时可以复用 schema cache。不过 causal attention 下,后面的 slot 能看到前面问题文本,只是看不到前一个答案——所以“答案不相互条件依赖”不等于“问题分支完全隔离”。
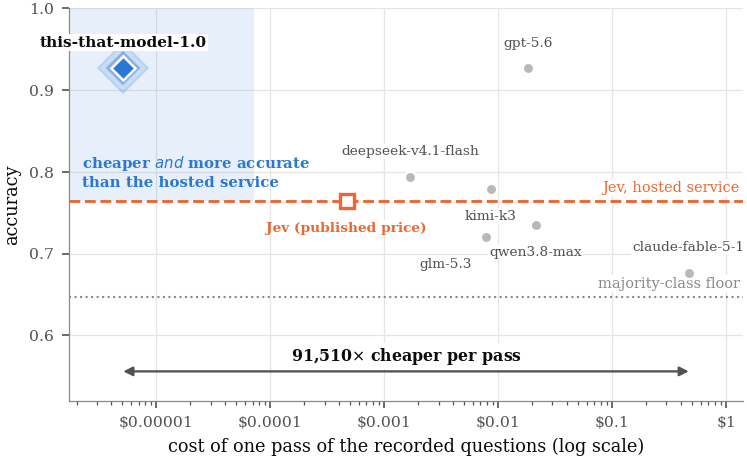
仓库在 68 个第三方记录问题上报告 accuracy 0.941、Brier 0.042,Jev 是 0.765/0.133;但 68 条太小,多个 frontier model 已经全对。下图横轴还把本地电费和商业 API 售价放在一起,作者自己提醒应读成约一个数量级,而不是视觉上的五个数量级。
更大的 spatial benchmark 共同子集有 2250 题,this-that-model 为 0.844、Jev 为 0.803、Laya 为 0.345。读这张表必须同时看实验条件:this-that-model 训练见过全部 15 种 question shape,其他 hosted model 是 zero-shot,所以它证明的是“稳定任务形状可以训练出便宜专用模型”,不是 1.88B 全面超过 frontier model。
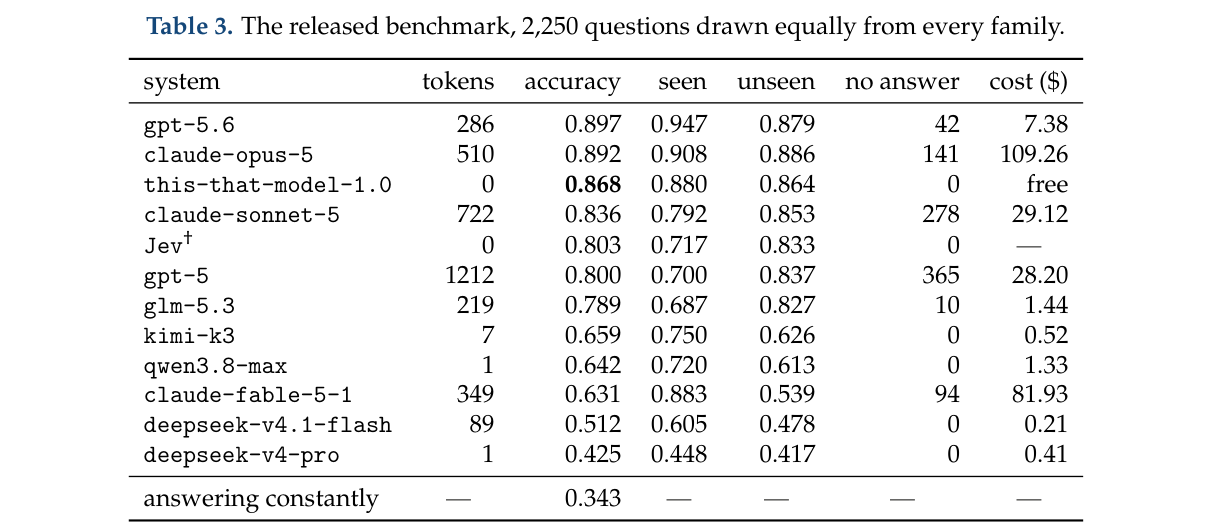
表里 tokens/question=0 只表示这些系统没有生成回答 token,不表示 forward 没有计算;seen/unseen 则按 this-that-model 自己的训练任务划分。把这两列连起来看,最有价值的信息不是谁排第三或第四,而是同一个 decision model 在训练覆盖与未覆盖任务上的差距。
7.2 kev 用 block-causal mask 把共享 state 和隔离问题同时写进 attention
kev 对“共享”处理得更严格:state prefix 只出现一次,后面接多个 question branch;block-causal attention mask 规定每个 branch 可以看 state 和自己,却看不到兄弟 branch。每个 option 的边界位置产生 key,<decide> 位置产生 query,再用 pointer head 做匹配。
Pointer head 可以理解成“不是固定输出 255 个类别,而是拿一个问题向量逐个查询本次请求里的 K 个候选向量”。因此候选数变化时,模型参数不变;同时 <decide> 位于整组 options 之后,可以先看完整候选集合再做 listwise 判断。
Kev 基于 Qwen3.5 提供 0.8B、4B、9B 权重,训练数据包含 Banking77、BoolQ、AG News、MNLI、SST-5、Yelp 等公开任务及合成 policy 数据,用 cross-entropy 训练 LoRA 和 pointer head,再在独立 calibration partition 上拟合 temperature。它比 this-that-model 多做了 branch isolation,代价是自定义 attention mask、训练和 serving 都更复杂。
这一路已经把 causal LLM 改造成很像专用 decision network 了。再往前一步,自然会问:既然不需要左到右生成,为什么还背着 causal decoder?
8. Laya 与 Jevlike:换成双向 encoder,速度更直接,泛化更依赖训练覆盖
8.1 Laya 用每个 [MASK] 位置代表一个候选
Laya 使用 421M 参数的 ModernBERT-large,多语言版使用 322M 的 mmBERT-base。ModernBERT 是 bidirectional encoder:每个 token 一次 forward 就能看左右上下文,不需要遵守“只能看前文”的 causal mask,更适合判别任务。
它把每个问题组织为:
[CLS] <type> instructions [SEP]
[MASK] option 0 [MASK] option 1 ... [SEP]
state [SEP]
每个 [MASK] 是该候选的 marker。encoder 输出 [B,L,H] 后,程序抽出 K 个 marker vectors,再经过共享 MLP:
LayerNorm(H) → Linear(H,H) → GELU → Linear(H,1)
每个候选得到一个 scalar logit,K 个 logits softmax 成分布。README 报告 T4 上单问题约 33ms、batch 后约 7.2ms/question;context limit 为 512 或 1024 token。
但 “many questions in one forward pass” 在当前源码中是把 N 条都含完整 state 的序列组成 batch,并不是 state hidden states 只算一次。Laya 还公开了 proper-scoring-rule reward,不过代码会把某些过度锐化的 checkpoint temperature 限制回 [0.5,5.0],并明确提示相关 confidence 应视为未校准。
8.2 Jevlike 让“候选主动查询上下文”,结构比固定分类头更适合动态 options
Jevlike 让每个 option 变成 query,对 context tokens 做 attention,得到该 option 自己的 context vector,再由共享 scorer 产生一个分数。它的特点可以压成一句话:不是先把整段输入压成一个向量再固定分类,而是让每个动态候选主动去上下文里找支持自己的证据。
默认版本从 byte embedding 训练小 encoder,也支持冻结 Hugging Face encoder;数据格式就是 context + 可变 options + label。它还把相同 option-attention head 用到 Doom 按键和棋盘操作,说明这种 readout 可以扩展到视觉 controller。不过从头训练的小模型能否跨领域,仍然完全取决于数据覆盖。
Encoder 路线省掉了生成能力和大词表 LM head,速度优势最直接;代价也同样直接:长上下文、世界知识、复杂规则和 OOD 泛化,不会因为模型被叫作 decision model 就凭空出现。
9. Diffusion OpenJev:答案位置同时去噪,不是普通 LLM 的 next-token logits
razorback16/openjev 使用 DiffusionGemma 26B-A4B NVFP4,与第 5 节的 SemIf/openjev-sglang 不是同一种 readout。
DiffusionGemma 是离散扩散语言模型:不是从左到右一次追加一个 token,而是在一块 token canvas 上反复把 masked/noisy 位置去噪。其基础结构来自 Gemma 4 26B A4B MoE,总参数 25.2B、每次激活约 3.8B,使用 encoder-decoder 与 bidirectional attention,并可按 256-token block 并行生成。MoE(Mixture of Experts)表示总参数分成多个专家,每个 token 只激活其中一部分,因此“25.2B 总参数”和“3.8B active”并不矛盾。
OpenJev 利用这个结构预先建好一块 canvas,state 和问题文本固定,只有每个问题的答案位置保留为 mask。下图从左往右读:第一块 canvas 有三个 [?];一次 diffusion read 同时计算三个位置;每个位置只保留自己的合法标签,如 yes/no、A/B/C、0/1/2;最后直接返回 typed answers。其他 token 被 pinned,不会在去噪过程中把 prompt 改坏。
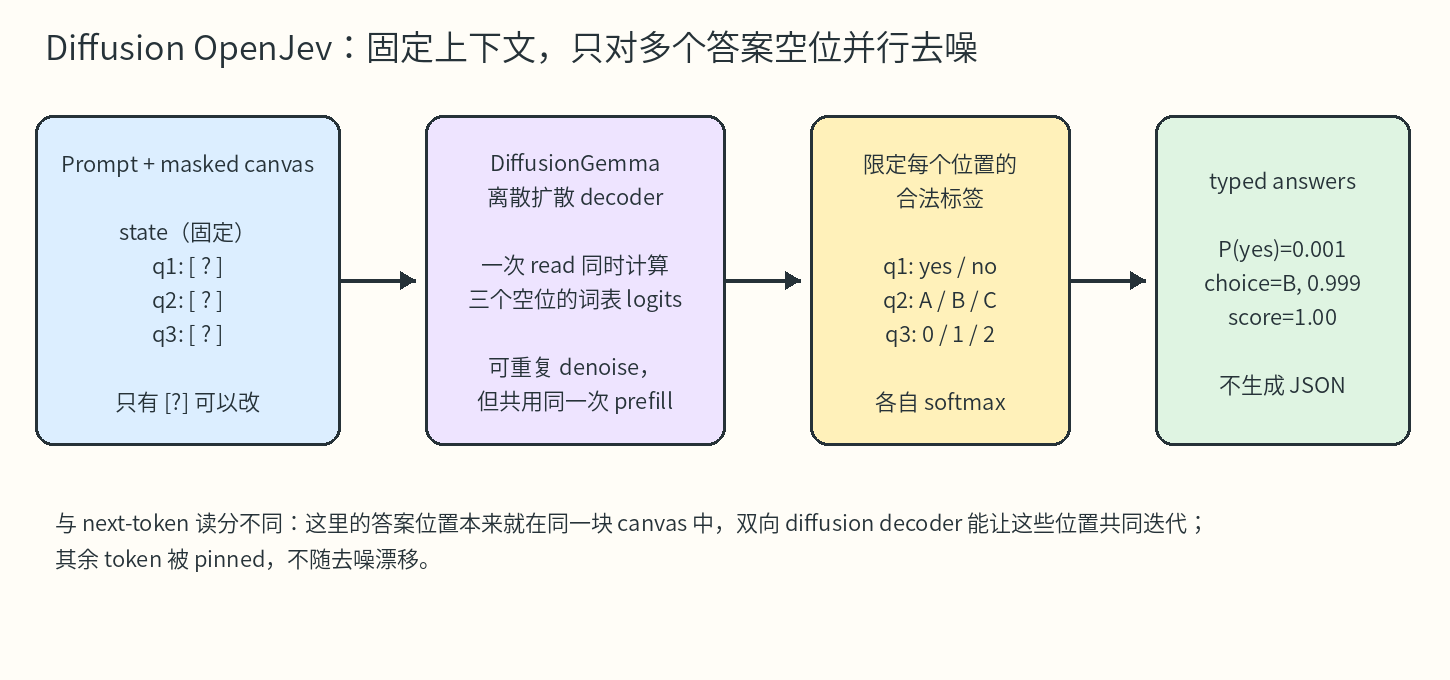
如果某个 slot 的 entropy 大于 0.1,默认实现会换新噪声最多重读四次并平均;也可以增加 1~8 个 denoise steps。多一步会增加 GPU 时间,但复用同一份 prompt prefill。其 vLLM 实现依赖 structured-read 扩展,MLX 版本则在进程内直接调用 diffusion decoder。
9.1 它没有 Jev 专用训练集,所谓泛化主要来自 DiffusionGemma 本身
这一点必须讲清楚:OpenJev 仓库没有再用一份 typed-decision dataset 微调 DiffusionGemma。它做的是推理结构改造,不是 decision post-training。NVIDIA 的 NVFP4 checkpoint 只是用 CNN/DailyMail 和 Nemotron Post-Training Dataset v2 做量化 calibration;底层 DiffusionGemma 的通用训练数据规模未披露,覆盖 web、code、math、图像等大规模语料。这些不是 OpenJev 为 Choice/Score/Noul 收集的训练数据。
因此它的泛化上限来自基础模型已经学到的语言、视觉和知识能力,无法通过 OpenJev 代码本身“保证”。仓库 README 也明确要求在自己的 workload 上评估答案质量。它的 entropy confidence 仍只衡量分布是否尖锐,不证明 0.9 真的是 90%。重复带噪 read 可以降低采样方差,也不能修复基础模型系统性理解错误。
LocalJev 名字相似,但又是另一条路:普通 oMLX API 暴露不了 structured read,于是它让 DiffusionGemma生成 JSON 概率,再校验和重试。它 wire-compatible,却重新引入了文本生成、自报概率和 parser,不能与这里的 masked-slot readout 混为一谈。
10. 总结:真正的分水岭是训练信号、共享计算和概率校准
| 路线 | 代表实现 | 一句话特点 | 是否专门训练 | state 是否天然共享 |
|---|---|---|---|---|
| 生成式置信度 | ConfTuner | 保留回答能力,专门校准说出口的数字 | LoRA + Brier | 不适用 |
| 零训练读 logits | SemIf、openjev-sglang | 不改权重,直接把 A/B/C 原始分数变成概率 | 否 | 依赖 prefix cache / runtime |
| 训练候选分数 | Nimble、NanoJev | 用反事实数据、LoRA 或 scalar head 学会看证据 | 是 | 实现不同,常有重复 state |
| 共享 state 的专用 readout | this-that-model、kev | 用 answer slot 或隔离分支一次读多个问题 | 是 | 是,但隔离语义不同 |
| Encoder + decision head | Laya、Jevlike | 完全放弃生成,直接为动态候选打分 | 是 | Laya 当前按问题复制 state |
| Diffusion masked canvas | Diffusion OpenJev | 多个答案空位在同一 canvas 上并行去噪 | 否 | 同一 read 内共享 |
这几条路线没有简单的“谁最高级”。零训练读分最容易部署,却最依赖 prompt;Nimble/NanoJev 用数据换能力,但数据覆盖决定上限;this-that/kev 把重点推进到计算组织;Laya/Jevlike 用更小模型换速度;Diffusion OpenJev 则利用基础模型原本就能并行填 mask 的结构。
真正共同的难点有三个:
- 训练信号:模型到底学过哪些 decision shape,换规则、换领域后是否还成立?
- 共享计算:所谓“一次请求”究竟是 state 只编码一次,还是 N 条序列被塞进同一个 batch?
- 概率校准:softmax、entropy confidence 和“长期真的对 90%”是三件不同的事。
至少要分别看 accuracy、NLL、Brier score 和 ECE。Accuracy 看 top-1 选对多少;NLL 对“真实答案只拿到很低概率”惩罚很重;Brier 看完整预测分布与真实结果的平方距离;ECE 看每个 confidence 区间的预测把握与实际正确率差多少。一个 99% 的错误答案可能 entropy confidence 很高,却会在后三个指标上暴露问题。
Jev 真正打开的不是一种唯一模型架构,而是一种模型分工:如果 workflow 节点最终只需要做决定,就没必要默认让 LLM 先写一段话。但程序准备根据 0.9 自动退款、执行命令或者拦截用户时,这个 0.9 是否真的意味着 90%,比省掉几个输出 token 更重要。
11. 参考资料(完整链接)
部分平台不会保留 Markdown 超链接,下面把正文用到的主要资料以完整 URL 再列一遍:
- Jev 官方发布博客:https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Jev 官方文档:https://docs.typesafe.ai/
- ConfTuner(NeurIPS 2025):https://arxiv.org/abs/2508.18847
- OpenJEV 公共访问平台:https://openjev.sh/(镜像:https://openjev.tech/)
- SemIf(原 OpenJev)网页:https://openjev.com/
- SemIf 源码:https://github.com/TheoLeeCJ/SemIf
- openjev-sglang:https://github.com/ekzhang/openjev-sglang
- Bespoke Nimble:https://github.com/bespokelabsai/nimble
- NanoJev:https://github.com/TianyuCodings/NanoJev
- this-that-model:https://github.com/FLock-io/this-that-model
- kev:https://github.com/jaredpalmer/kev
- Laya:https://github.com/NandhaKishorM/laya
- Jevlike:https://github.com/vinnylarouge/jevlike
- DiffusionGemma 版 OpenJev:https://github.com/razorback16/openjev
- DiffusionGemma NVFP4 模型卡:https://huggingface.co/nvidia/diffusiongemma-26B-A4B-it-NVFP4
- LocalJev:https://github.com/githubnext/localjev
- Jev 黑盒分析:https://archerhume.com/posts/jevs-architecture-unmasked
顺带扯一句题外话。这篇里的几条路线,本质上都在做“预训练模型的任务专用化”:有人改 loss,有人加 LoRA,有人换 decision head,也有人直接换掉生成式 backbone。《动手学 AutoML:从 NAS 到大语言模型优化实战》里没有专门讲 Jev,但第 8、9 章讨论了 LLM 压缩、模型融合以及 LLM 驱动的 AutoML,关注的是怎么系统地寻找这类改造方案。角度不同,目标很接近:不是所有任务都值得让完整大模型用同一种方式做到底。
