Jev 拆解 | 一个不生成 token 的模型,怎么做决策?
Jev 拆解 | 一个不生成 token 的模型,怎么做决策?
参考资料:TypeSafe 官方发布博客 · TypeSafe 官方文档 · Jev 黑盒分析 · SemIf · NanoJev · kev
1. 为什么一个“只会判断”的模型,反而有这么多地方能用
先看几个场景。
客服系统收到一句“信用卡被重复扣款了”,真正要做的不是写一篇分析,而是判断它该去账单、退款还是账户安全队列;搜索和推荐拿到几百个候选结果,也不是再生成一份网页,而是判断哪一个应该排在前面;Agent准备调用工具时,需要判断的是“这一步是否安全”“该调用哪个 API”“要不要先问用户确认”;放到游戏里,则变成判断下一步往东、西、南、北哪个方向走。
这些任务表面上差很多,底层其实是同一件事:
给定当前状态和一组候选,判断每个候选有多大可能是对的。
分类并不新,为什么这件事现在又变得重要了?因为 LLM 进入 Agent 和 workflow 之后,很多任务已经不是“帮我写一段话”,而是“下一步到底做什么”。这类判断会出现在一条 workflow 的每个节点上:先判断请求属于哪一类,再判断该调哪个工具,执行后还要判断结果是否可信。单次分类看起来不起眼,但一天跑几百万次以后,生成式 LLM 的解码延迟、输出成本和格式错误就都放大了。
传统做法通常是把候选写进 prompt,让 LLM 最后回答 A/B/C 或一段 JSON。问题是答案明明只有一个选项,模型仍然要一个 token 一个 token 地生成;生成后还要检查 JSON 是否合法、选项是否越界,而且 next-token 概率也不天然等于“这个判断有多可信”。
TypeSafe AI 今年 9 月发布的 Jev,就是冲着这个问题来的。它不生成文本,只接收一段 state(当前状态)和若干个 question(要做的判断),直接返回完整概率分布。例如:
state: 用户说“信用卡被重复扣款了”
question: 应该路由到哪个队列?

billing       0.91
refund        0.06
account       0.02
security      0.01
概率分布比单独返回一个 billing 更有用:0.91 时可以直接执行;如果前两项分别是 0.43 和 0.41,系统就知道这次判断并不稳,可以追问用户或转人工。Jev 真正卖的不是“会分类”,而是把自然语言理解变成一个能直接驱动下一步动作的概率接口。
官方展示的应用基本都沿着这条线展开:
- 智能家居:一次判断请求类型、房间、设备和动作,直接控制后续执行;
- Wikiracing / 检索重排:面对一个页面里的几百个链接,判断下一跳选哪个;
- 实时游戏 AI:根据当前局面判断移动方向或是否开枪;
- Agent trace 和安全事件判断:决定一步操作是否异常、是否应该拦截;
- 发票抽取、客服路由:把自由文本映射成有限字段或业务队列。
官方博文给出的数字是自家工作流里 20–200× 更快、40–400× 更便宜。这类数字当然要结合输入长度、网络位置和对比方法看,不能直接当通用 benchmark;但方向很好理解:如果任务最终只需要做决定,就没必要为“生成一段答案”付完整的解码成本。
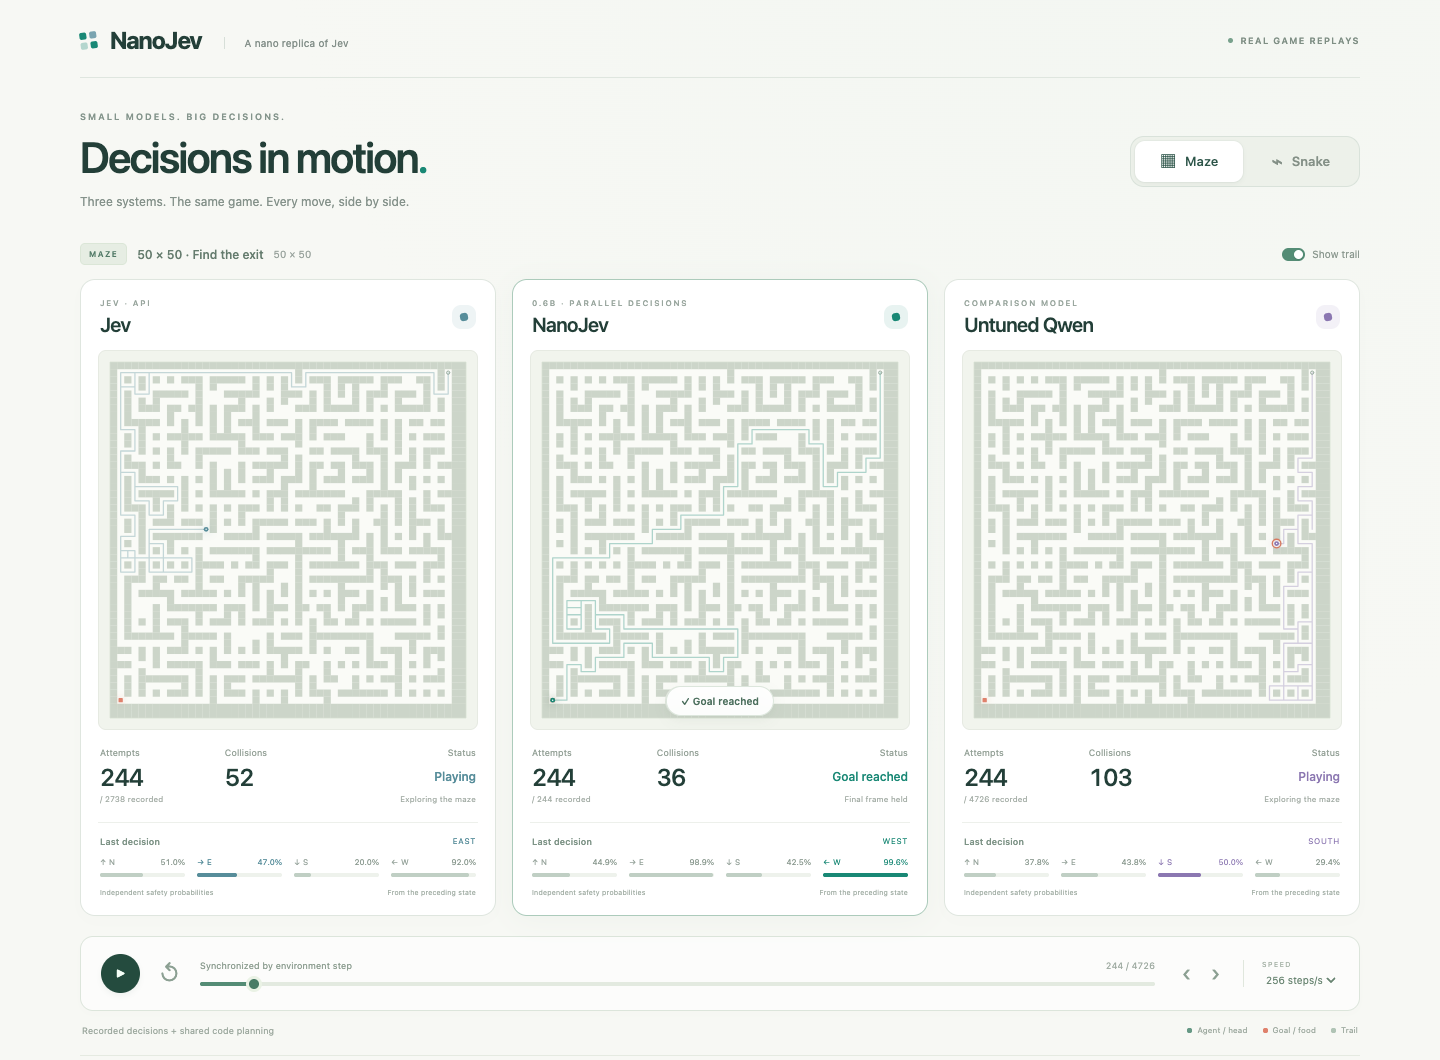
下图是 NanoJev 仓库里的对比演示:Jev、NanoJev 和未经微调的 Qwen3-0.6B 同时走迷宫。这里模型每一步做的事情都很简单——给几个可行方向分配概率——但这些连续的小判断最终决定了能不能走到出口。
理解了“分类其实是 workflow 的控制面”之后,再看它为什么要设计 Choice、Score 和 Boolean 三种接口,以及一个模型怎么应付每次都不同的候选集合,就顺了。
2. Jev 把判断拆成了三种接口
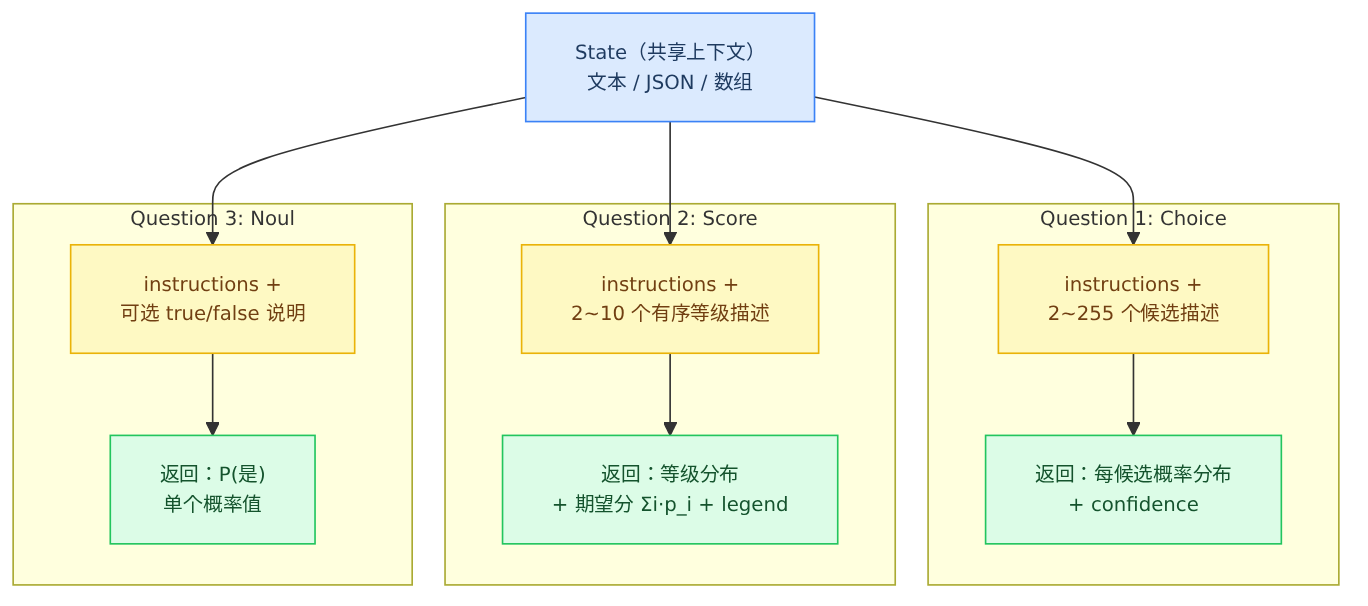
一次请求由两部分组成:state(字符串/JSON/数组,多个问题可共用)和 questions(每个问题有自己的 type、instructions、criteria)。问题之间互相独立,不能读取彼此答案,这是接口层面的硬约束。
三种类型(primitives):
| 类型 | 输入 criteria | 输出 |
|---|---|---|
| Choice | 2–255 个候选,每个是 候选名: 描述 | 每个候选的完整概率分布 + confidence |
| Score | 2–10 个有序等级描述 | 每级概率分布 + 期望分 Σ i·p_i + legend |
| Noul(SDK 里叫 Boolean) | 可选 true/false 说明 | 单个概率值 P(是),没有独立 confidence |
这套接口里有几个设计挺容易被忽略。
首先,Choice 的问题 ID 不会进入模型。比如你把一个问题命名成 route 或 urgency,这个名字只负责在返回结果里对上答案,模型真正看到的是 instructions 和候选描述。所以问题不能只写一句“请判断”,指望模型从 route 这个 key 猜出你想问什么。
其次,Score 不会把等级数字喂给模型,也不会让某一级看到相邻等级的描述。假设四档严重程度分别叫 0、1、2、3,模型判断“核心功能受阻”时,并不知道它前面是“次要功能受阻”、后面是“服务完全中断”。每一档先独立得到分数,最后才把概率按顺序加权成期望值。这样做是为了避免模型只靠“第 3 档听起来比第 2 档严重”这种位置线索来猜。
最后,Noul 没有单独的 confidence 字段,只返回 P(true)。Choice 和 Score 的 confidence 也不是模型额外预测出来的另一个数,而是根据最终概率分布算出来的。
上下文预算:state + 全部 questions 合计 64k token,state + 最长单个 question 32k token;定价 输入 $0.042/百万 token,输出免费(本来就不产生输出 token)。
confidence 公式(来自 MIT 协议的 LLM adapter,是 adapter 实现不是服务端证明,但可合理参考):
choice_confidence = (max(p) - 1/K) / (1 - 1/K)      # K 是候选数

m = argmax(p); d = Σ p_i * |i - m|; d_uniform = (1/K) * Σ |i - (K-1)/2|
score_confidence = max(0, 1 - d / d_uniform)
所以这里的 confidence 衡量的是“这组概率有多集中”,不是“这次答案有多大概率正确”。分布越接近 one-hot,confidence 越接近 1;越接近均匀分布,就越接近 0。这两个概念不能混在一起:一个模型完全可能非常自信地选错。
接口讲得很清楚,但模型内部怎么实现,官方基本没说。到目前为止,下面这些信息都没有公开:
- 网络具体结构、参数量(官方只说”不是小模型,也不是传统 LLM”,没给数字)
- RLCD 的 reward 设计、loss、采样算法、训练数据规模和来源
- 训练代码本身
官方倒是讲了 workflow eval 怎么做:ground truth 来自 GPT-6 Astra 和 Claude Fable 5.1 高推理模式的共识标注,Jev 在这套 eval 上的分数约为 67.8%,而且这些评测集不进入训练集。但这只能回答“怎么评”,回答不了“怎么训”。模型结构和训练流程这块,只能把黑盒实验与不同开源实现放在一起看,拼出几种可能的答案。
3. Jev 到底是什么模型?先把官方事实和社区复现分开
看到这里,一个最容易产生的误解是:Jev 是不是一个换了分类头的 LLM?
现在还不能这么下结论。 TypeSafe 没有公开权重、网络结构、参数量、基座模型和 RLCD 的具体训练算法。官方确认的只有下面几件事:
- Jev 是从 pretrained language model 继续 post-training 得到的 System One model;
- 它不生成回答文本,而是直接返回 Choice、Score、Noul 的数值结果;
- 同一份 state 只输入一次,多个 question 并行、彼此隔离地读取它;
- 训练目标叫 RLCD(Reinforcement Learning for Calibrated Decisions),目标是让高概率对应更高的真实命中率;
- 当前
jev-1.13.0只支持文本,整次请求 64k token,state 加最长单个 question 不超过 32k。
所以更准确的说法是:Jev 不是某个已经公开结构的模型名字,而是一款闭源的 decision model 产品。 它保留语言模型理解自然语言的能力,但把输出合同从“继续写 token”改成了“对有限答案空间给概率”。至于内部用的是 decoder、encoder、MoE,还是专门设计的 readout,官方都没有确认。
这也是为什么网上的“Jev 复现”要分两类看:一类只是做出了相同 API;另一类才真的尝试复现“共享 state、并行 question、直接读概率”这套计算方式。两者都不能证明自己还原了 Jev。
3.1 现在关注度较高的开源实现有哪些
截至 2026 年 9 月 20 日,GitHub 上关注度较高、而且确实提供本地模型或推理代码的项目主要有这些。Star 变化很快,表里的数字只对应这次检查时间。
| 项目 | Star | 它实际做了什么 | 适合拿来做什么 |
|---|---|---|---|
| SemIf | 2.2k | 直接读取 Qwen 等开源模型的选项 token logits,不训练新的 Jev 模型 | 最成熟的 zero-shot baseline,benchmark 和复现材料比较全 |
| NanoJev | 1.2k | Qwen3-0.6B 加 scalar head 和 Choice set-attention,带数据、训练、评测和 serving | 看完整训练 pipeline,以及动态候选怎么实现 |
| Jevlike | 1.0k | 每个 option 查询 context,再用共享打分器输出概率;还有 Doom/Chess 视觉例子 | 看最小模型和多模态 option scoring |
| Bespoke Nimble | 848 | Qwen3.5-9B + LoRA,读取单 token answer code;公开权重和对比式数据构造 | 看数据 recipe 和相对强的开源效果 |
| kev | 752 | state 只编码一次,question 用 block-causal mask 隔离,pointer head 对动态 options 打分 | 目前最值得参考的“架构型复现” |
| LocalJev | 553 | 把 typed questions 改写成 prompt,让 DiffusionGemma 生成 JSON 概率 | 只适合 API 兼容,不是 generation-free 复现 |
这些仓库基本都是 Jev 发布后几天内出现的,Star 涨得快不等于技术已经被充分验证。这里把 Star 当成“社区在关注什么”,不把它当成正确性排名。真正需要看的还是:有没有公开权重和数据,state 是否只计算一次,question 是否真的隔离,概率是不是直接 readout,以及 benchmark 能不能复现。
这里不能简单按 Star 选一个“最正确”的。SemIf 关注度最高,但它本质上是无需训练的 option-logit baseline;NanoJev 的训练链路最完整;kev 对“state 只算一次、question 相互隔离、动态 option readout”这几个 Jev 特征还原得更到位。
如果目的是跑一个开源 baseline,优先用 SemIf;如果要研究训练方法,NanoJev 和 Nimble 更合适;如果要理解 Jev 最可能怎样组织一次 forward,kev 是目前更好的参考。
3.2 NanoJev 是正确实现吗
从代码、测试和仓库保存的实验记录看,NanoJev 这套实现内部是自洽的,它确实能完成下面这条链路:
state + question + candidate
  → Qwen3-0.6B hidden state
  → LayerNorm + Linear(d, 1)
  → 每个 candidate 一个 logit
  → softmax 得到完整分布
它也真的支持动态候选、三种 primitive、训练、评测和服务,不是只套了一层接口的 demo。问题在于:“能实现 Jev 的输入输出”不等于“实现方式就是 Jev”。
NanoJev 会给每个候选复制一遍完整的 state + question,然后把所有候选路径塞进同一个 batch。比如 20 个候选,本质上还是 20 条完整序列,只是合并成一次 GPU forward。它没有做到 state 在模型内部只编码一次,所以候选越多、state 越长,重复计算越明显。
Choice 的候选最开始也是独立打分的。为了让候选之间互相影响,它后面又补了一个 set-attention head。这能解决一部分 listwise interaction,但属于 NanoJev 自己的设计,不是官方披露的 Jev 结构。
但这不等于它已经经过了独立、完整的第三方复现实验。对 NanoJev 更合适的评价是:
这是一个实现链路完整、可以运行的 Jev-inspired 方案,但没有证据说明它还原了 Jev,也不能仅凭仓库自己的结果证明所有质量与性能结论。
原文如果把 NanoJev 写成“目前唯一能看到 Jev 执行细节的参考”,现在已经不准确了。它仍然值得讲,但应该放在多个实现中对照,而不是把它的 scalar head 当成 Jev 本身。
3.3 更接近 Jev 行为的实现:state 只算一次,question 各走一条分支
2026 年 9 月 17 日,有人用约 10,000 次 API probe 做了一份黑盒分析:Jev’s Architecture Unmasked。这些实验不是官方披露,但观察到了几个很有意思的信号:
- state 很长时,增加 question 的成本远低于把 state 重复请求多次;
- question 调换顺序后彼此不会读到对方,符合“共享 state、隔离分支”;
- 添加一个新 option 后,旧 options 之间的相对赔率也可能改变,说明 Choice 不像简单的独立打分再 softmax;
- 200 个 option 的返回时间和 2 个 option 接近,API 里的
output_tokens更像计费/序列化数字,不能拿它当生成速度; - 32k 单分支限制和 64k 整体限制,很像一份 state 加多条 question branch 被打包在同一请求中。
基于这些现象,一个更像样的推断结构是:
                    ┌→ question 1 + options → decide → distribution 1
state → shared KV ──┼→ question 2 + options → decide → distribution 2
                    └→ question 3 + options → decide → distribution 3
state 只计算一次。每个 question 都能看见 state,却看不见其他 question。实现这种信息流可以用 block-causal attention mask:state 区域正常做 causal attention;question 只能读取 state 和自己分支里的 token;兄弟分支之间直接 mask 掉。
kev 就沿着这条思路实现。它把整个请求打包成:
<state> ...
<q> instructions <opt> A </opt> <opt> B </opt> ... <decide>
<q> instructions <opt> A </opt> <opt> B </opt> ... <decide>
每个 option 结束位置有一个 hidden state,<decide> 位置也有一个 hidden state。pointer head 用 <decide> 去查询所有 option:
q = Wq · h_decide
k_i = Wk · h_option_i
z_i = qᵀk_i / √d
p = softmax([z_1, z_2, ..., z_K])
这和 NanoJev 的最大区别是:<decide> 在所有 options 后面,因此它做判断时已经看过完整候选集合。 候选 A 的分数不再只取决于 A 自己,也可以受 B、C 和“以上都不对”影响,更符合 Choice 的 listwise 语义。
3.4 2 到 255 个选项,输出维度为什么能跟着变
pointer head 也解释了动态候选问题。它不是一个固定的 Linear(d, 255),而是对这次请求里的每个 option hidden state 都算一次相似度。
2 个 options   → [z1, z2]               → 2 个概率
5 个 options   → [z1, z2, z3, z4, z5]  → 5 个概率
255 个 options → [z1, ..., z255]         → 255 个概率
模型参数 Wq 和 Wk 没有变化,变化的只是 option hidden state 的数量。来 K 个 option,就得到 K 个 key,最后 softmax 的输入自然也是 K 维。
NanoJev 用“同一个 scalar head 给 K 条候选路径分别打分”,kev 用“一个 decide query 与 K 个 option key 做 pointer score”。两种方法都能动态输出 K 个概率,但后者能先看完整 option set,而且更容易共享 state 计算。
当然,官方也可能使用固定的 256-slot head:最多 255 个 options,再留一个特殊 slot。黑盒行为无法排除这种方案。现在能够确认的是动态输出和 listwise interaction,不能确认内部究竟是 pointer head、固定 slot,还是另一种 readout。
3.5 RLCD 到底训练了什么
官方对 RLCD 的描述只有目标,没有 recipe。它想让预测满足:模型给 0.8 的事件,在大量样本中应该约有 80% 真正发生。这叫 calibration,关注的是概率和真实频率是否一致,而不只是 top-1 选没选对。
但下面这些关键细节都没公开:
- reward 具体怎么算;
- 用的是 policy gradient、交叉熵、Brier loss,还是几种目标的组合;
- label 来自人工、规则、真实 outcome,还是 teacher model;
- backbone 哪些参数更新;
- 训练数据规模和领域组成。
开源实现走了不同路线。NanoJev 同时尝试 hard label、teacher distribution 和一套 RLCD-inspired proper reward;Nimble 用对比式数据构造,让一条关键事实变化时答案也随之翻转;kev 用公开分类/NLI/政策规则数据做交叉熵训练;SemIf 干脆不训练,只读取 base model 的 option logits。
这几条路线都能输出概率,但“softmax 出来一个数”不代表概率已经 calibrated。要验证它,必须在独立数据上看 Brier score、NLL 和 reliability curve,而不是只看 accuracy。Brier score 衡量预测概率和真实结果之间的平方误差,越低越好;NLL 看模型给真实答案分配了多少概率,同样越低越好。
从现有公开结果看,Jev 仍然领先。kev 在 764 条 out-of-domain 记录上的 accuracy 是 0.79–0.80,Jev 是 0.857;Bespoke Nimble 在 324 条 held-out 样本上达到 90.1% reference-label agreement,Jev 是 93.2%。这些数字来自各项目自己的实验,数据和协议不同,不能横向排成统一榜单,但至少说明:开源实现已经能接近这套接口,离证明“复现了 Jev”还有一段距离。
4. 如果把这套判断能力接到音频上,会发生什么
Jev 目前接收的 state 本质上还是文本或 JSON。那能不能把它扩展到多模态?拿 ASR 来说,这件事确实有价值,但不是所有环节都需要音频。
比如一段语音被识别成:
我们把 Kubernetes 部属到两张 A100 上。
只看文本,模型很容易根据上下文猜到“部属”应该改成“部署”。这种错误用现有 Jev 就能做:把 ASR 的多个候选放进 Choice,让它根据上下文重新排序。
但换一个例子就不行了:
A. 这批卡已经到齐了
B. 这批卡已经到期了
两句话在语言上都成立,真正的证据藏在音频里。text-only 模型再聪明,也只能猜哪句话更常见,无法判断说话人发的是“齐”还是“期”。当错误来自声学歧义,而不是语言不通顺时,多模态就不是锦上添花,而是缺失的证据。
4.1 不要一上来就改模型,先看纯文本判断能做到哪一步
第一步甚至不用训练 audio Jev。让 ASR 输出 N-best,也就是同一段音频下概率最高的若干条转写,再把这些候选、前后文、热词和 ASR score 塞进 state:
state:
  context: 技术周会,正在讨论服务器部署
  hotwords: [Kubernetes, A100]
  candidates:
    A: 我们把 Kubernetes 部署到两张 A100 上
    B: 我们把 Kubernetes 部属到两张 A100 上

question: 哪条转写最符合当前上下文?
这其实是一个 context-aware reranker:ASR 负责“听”,Jev 负责利用语言和业务上下文重排。专业术语、中英混说、人名和产品名这类错误,往往仅靠热词与上下文就能修掉一部分,而且不需要碰音频模型。
只有当 text-only reranker 已经到顶、剩下的 bad case 主要是“两个候选都说得通,但发音不同”时,再把音频接进来。否则一开始就做多模态,训练成本上去了,却说不清收益究竟来自音频,还是来自更强的文本模型。
4.2 真要接音频,可以复用 ASR 的 audio encoder
一个直接的实现,是把 NanoJev 的文本 backbone 换成 Qwen3-ASR 这类已经能处理音频的 backbone:
音频 ─→ audio encoder ─→ audio embedding ─┐
                                          ├→ backbone → scalar head → logit
候选转写 + 问题 + 上下文 ─────────────────┘
音频只编码一次,候选 A、B、C 分别接在同一份 audio embedding 后面。每条候选仍然经过同一个 Linear(d_model, 1) 得到一个 logit,最后对当次的 K 个 logit 做 softmax。这样前面讲的动态候选机制不需要改:有 4 条 ASR 候选就返回 4 个概率,有 10 条就返回 10 个。
真正需要优化的是重复计算。音频通常比文本长,如果 10 个候选都把音频从头编码一遍,成本很快就上去了。更合理的做法是共享 audio embedding,进一步共享公共前缀的 KV cache,只让不同的候选文本走各自的分支。前面提到的 tree attention,放到这里反而比纯文本场景更有价值,因为最贵的音频前缀只需要算一次。
训练也不需要从头做。先冻结 audio encoder,只训练 scalar head 和少量 backbone 参数,让模型学会“这段音频更支持哪条文字”;如果效果不够,再逐步解冻。训练数据可以直接从现有 ASR 数据构造:标准转写是正候选,beam search、不同 ASR 模型和同音词替换产生困难负候选。
4.3 在 ASR pipeline 里,它最适合做三类决定
第一类是 N-best 选择。 ASR 不再只吐一个结果,而是给出几条候选;audio-text Jev 同时看音频和上下文,选出最匹配的一条。这是最直接的准确率增益。
第二类是局部纠错。 两条转写通常只有一两个位置不同,没必要把整句话重新判断。先对齐候选,找到“部署/部属”这种分歧片段,再截取对应音频,只判断这个位置应该保留还是替换。判断范围越小,候选越明确,训练数据也越容易构造。
第三类是决定要不要继续花算力。 如果第一名概率是 0.96,可以直接接受;如果前两名是 0.41 和 0.39,说明模型自己也拿不准,此时再带热词重跑、换更大的 ASR,或者交给人工。它带来的提升不一定全来自“选得更准”,也来自知道什么时候不该瞎选。
音频 → 小 ASR 生成 N-best → audio-text judge
                              ├─ 高置信:直接输出
                              ├─ 有明确替代项:局部纠错
                              └─ 低置信:热词重跑 / 大模型 / 人工
所以多模态版本最值得先验证的,不是“给音频做一个万能分类器”,而是一个很具体的闭环:ASR 负责产生候选,audio-text judge 负责选候选和判断是否拒绝。
实验时先看两个上限。第一,正确转写有没有出现在 N-best 里;如果根本不在,judge 再强也救不回来。第二,text-only judge 已经能修掉多少;只有 audio-text 版本在同一批候选上继续提升,才能证明听音频确实有用。最终同时报告 1-best、N-best oracle、text-only rerank 和 audio-text rerank 的 CER/WER——中文按字、英文按词计算需要多少次增删改才能变成标准答案,都是越低越好。
这套思路也能往图像、视频上迁移,但没必要为了“多模态”三个字强行扩展。判断所需的证据如果已经完整存在于文本里,就继续用文本;只有答案取决于声音、画面或时序信息时,才值得把对应模态接进 decision model。
5. 小结:Jev 和现有分类方法到底差在哪
读到这里再回头看,Jev 解决的并不是“模型能不能分类”——BERT 时代就能做,今天拿任意 LLM 回答 A/B/C 也能做。它真正想解决的是另一件事:
能不能让一个理解自然语言指令、候选集合每次都可以变化的模型,像专用分类器一样直接输出概率,而不是先生成文字再解析。
放在一起看,差别就清楚了:
| 方法 | 候选从哪里来 | 候选数 | 怎么得到答案 | 主要问题 |
|---|---|---|---|---|
| 固定分类头 | 训练时写死 | 固定 | 一次输出 N 类概率 | 换类别就要改 head、重新训练 |
| LLM 生成 A/B/JSON | 请求时给 | 可变 | 自回归生成后解析 | 有解码成本和格式失败 |
| 受限解码 | 请求时给 | 可变 | mask 非法 token 后生成 | 长文本候选、多 token 候选处理麻烦 |
| Cross-encoder reranker | 请求时给 | 可变 | 每个候选独立打分 | K 个候选通常要做 K 次独立判断 |
| Jev 式决策 | 请求时给 | 最多 255 | 直接返回 typed probability readout;具体内部结构未公开 | 依赖专门训练,开源方案尚未追平官方结果 |
动态候选在开源实现里至少有两条路:NanoJev 用共享 scalar head 分别处理 K 条候选路径,kev 用一个 decide query 对 K 个 option hidden states 做 pointer readout。两者都不需要固定 255 维分类头。真实 Jev 也可能采用固定 slot 或另一种 readout,黑盒实验还不足以把结构唯一确定下来。
官方 Jev 和这些开源实现仍然要分开。TypeSafe 只公开了接口、上下文限制、价格和部分评测,网络结构、参数量、RLCD recipe 和训练数据都没有公开。NanoJev 的 scalar head、kev 的 pointer head、SemIf 的 option-token logits,都是实现同一类产品接口的不同路线,谁都不能据此宣称还原了真实 Jev。
性能上也不能把“没有自回归解码”理解成“候选和问题没有成本”。NanoJev 会重复计算每条候选的 state;kev 虽然共享 state,question branch 和 option readout 仍然要算;SemIf 的共享前缀路径也有数值漂移记录。省掉的是逐 token 生成的依赖链,不是把所有计算都省掉。
所以这类模型更准确的定位,不是一个神秘的新分类器,而是 workflow 的决策层:上游把当前状态和合法选项交给它,它返回一个可以直接用于执行、拒绝或升级处理的概率分布。智能家居、Agent 工具选择、检索重排和游戏控制看起来完全不同,最后都能归到这个接口上。这才是一个简单分类任务突然变得有价值的原因。
顺带扯一句题外话:这类”用 decision head 替代生成”的思路,是在判断这个任务压根不需要生成,而不是优化生成过程本身。这两年一个挺明显的趋势就是越来越多团队开始琢磨”这个子任务到底要不要走完整自回归”。我们把 LLM 架构自动化、模型压缩这些相关积累整理成了一本书,第 9 章正好讲 LLM 驱动的 AutoML 和 LLM Agent 结合的方向,跟这篇聊的”任务专用化改造”角度不同但目标相近。

欢迎评论区交流,如果发现文章里哪些细节和你了解的官方情况不一致,也欢迎指出来。