StepAudio 3 Gen 把通用音频生成压成纯离散 token 预测,TTS 人味评测赢遍商业模型"
StepAudio 3 Gen 把通用音频生成压成纯离散 token 预测,TTS 人味评测赢遍商业模型
原文:StepAudio 3 Gen Technical Report(arXiv 2609.12945,StepFun-Audio Team)
1. 前言:一段”三种声音混在一起”的音频,暴露了整条流水线的裂缝
设想一个很常见的需求:给 60 秒的短视频配一条音频,里面有两个人对话、有开门和脚步声、背景还要压一段不抢戏的钢琴。
今天你要做这件事,基本得拼三条流水线:对话走 TTS(text-to-speech,文字转语音),音效走 text-to-audio 模型,背景音乐走 text-to-music 模型。三条流水线各有各的输入表征(一条吃文本 + 说话人参考,一条吃 caption,一条吃风格描述)、各有各的生成方式(有的跑 diffusion,有的跑 flow matching)、各有各的时间控制接口(谁负责把这三个音轨对齐到时间轴上?最后往往是人手在 Audition 里拖)。
问题不在于”哪个模型不够好”。单看每一块,今天的专用模型都很能打。问题在于它们之间没有共同语言——所以你也拼不出一个”同一个模型、一句话进去、三种声音混着出来、时间关系都对”的东西。
这正是 StepAudio 3 Gen 想去的地方。它给出的答案很激进:
把通用音频全部表示成同一套离散 token,然后交给一个 LLM 自回归地预测——不做 diffusion,不做 flow matching,连 acoustic renderer 都不要。
这里的”通用音频”包括语音、歌声、音乐、音效,也包括它们混在一起的复杂场景;论文里还专门列了一类 vibe speech,指带环境氛围和背景声的语音——不是一条干巴巴的朗读,而是”咖啡馆里边喝东西边聊天气”那种有空间感的东西。
结果上,这份技术报告里最硬的数字是 TTS:在中文”像不像真人在说话”的 Arena 式主观评测(两两对打,让人盲选更像真人的那条)里拿到 Elo 1755.33,比第二名 Qwen-Audio-3.0-TTS-Plus(1544.3)高出 211 分,对五个商业 TTS 系统的直接对比胜率是 82.0%,单场胜率区间 73.0%–90.0%。Voice design(用自然语言描述音色和风格,让模型”捏”一个声音出来)同样是第一,Elo 1668.5,胜率 75.5%。
这篇文章按三层来拆:结构上它做了什么、数据上它怎么凑的、训练上它做了哪些事才换来这个结果。
2. 先搞清楚:为什么音频生成一直没长成一个”LLM 任务”
统一音频生成不是新目标,最近一两年不少工作在做。路线大致两条,各自都有说不出的苦。
先插一句名词:后面反复出现的 codec,指的是音频编解码器——一个专门把音频压缩成紧凑表示、又能从这个表示还原回音频的模型(encoder 负责压、decoder 负责还原)。手机里录音存成的压缩格式是传统 codec,这里说的是神经网络版的 neural codec,思路一样:先压再还原。
第一条路线是连续 latent + diffusion / flow matching。用一个大 VAE 或者 codec 的 encoder 把音频压成连续的 latent(一串连续的浮点向量),然后在 latent 上跑 diffusion 来生成。好处是声学细节渲染得漂亮,多家通用音频模型(speech、sound、music 一起做的那种)走的是这条路。坏处是它和 LLM 天然不兼容:LLM 的词表是离散的 softmax,它的训练目标是 next-token prediction,它的上下文是文本和音频随意交错的序列。你没法把一个连续 latent 塞进 softmax 里。
第二条是离散 unit + LM 式序列建模,也就是先把音频变成 token(”音频 tokenizer”这个说法就是指做这件事的模块,它同时也要负责把 token 变回波形),再像语言模型那样预测。这条路天生和 LLM 兼容,但要理解它,得先把”音频怎么变成 token”这件事说清楚——因为所有后续设计的坑,都是从这里长出来的。
2.1 先搞懂:一段音频怎么变成 16 个整数
这一节把”音频 → token”整个走一遍。很多细节论文默认你懂,这里补齐。
第一步:音频在电脑里本来是什么样。 一段 24 kHz 的音频,在硬盘里确实是一长串离散的数——每秒 24000 个采样点,每个点是一个振幅值。但这串数又长又不好用:1 秒就是 24000 个数,而且相邻采样点之间高度冗余,直接拿去做 token 毫无意义。所以第一步不是量化,而是先用一个编码器把它压成”特征向量”。
第二步:编码器把波形压成一帧一个向量。 这就是 3.1 节要讲的那两个编码器干的活。它们把 24000 个采样点/秒的波形,压成 12.5 帧/秒,每一帧输出一个特征向量——这个向量有固定的维度(记作 $D$,比如几百到一千维,是模型结构定死的)。注意这里的关键转变:采样点是”声音的振幅”,特征向量是”这一帧的抽象表示”(里面编码了音高、音色、这一帧在说什么音等信息)。到这一步,1 秒音频 = 12.5 个 $D$ 维向量,还都是连续的浮点数。
第三步:codebook 把每个向量换成整数。 现在才轮到量化。codebook(码本)是一张表,有 2048 行,每一行也是一个 $D$ 维向量——和上一步的特征向量维度一模一样,这是它们能比较的前提。这张表不是人手写的,是训练时学出来的:模型自己去调这 2048 行的数值,目标是”让任意一个特征向量都能在表里找到一个足够接近的行”。训练完,这 2048 行就固定下来了。
编码时,拿一帧的特征向量,逐行去和 codebook 的 2048 行比相似度(论文用的是余弦相似度——看两个向量方向有多接近,越接近越像),找出最像的那一行,把它的行号(0~2047 之间的一个整数)记下来。所以:
一个 $D$ 维浮点向量 → 一个 0~2047 的整数。 这就是量化,本质是”从 2048 个预设向量里挑一个最接近的来代替你”。
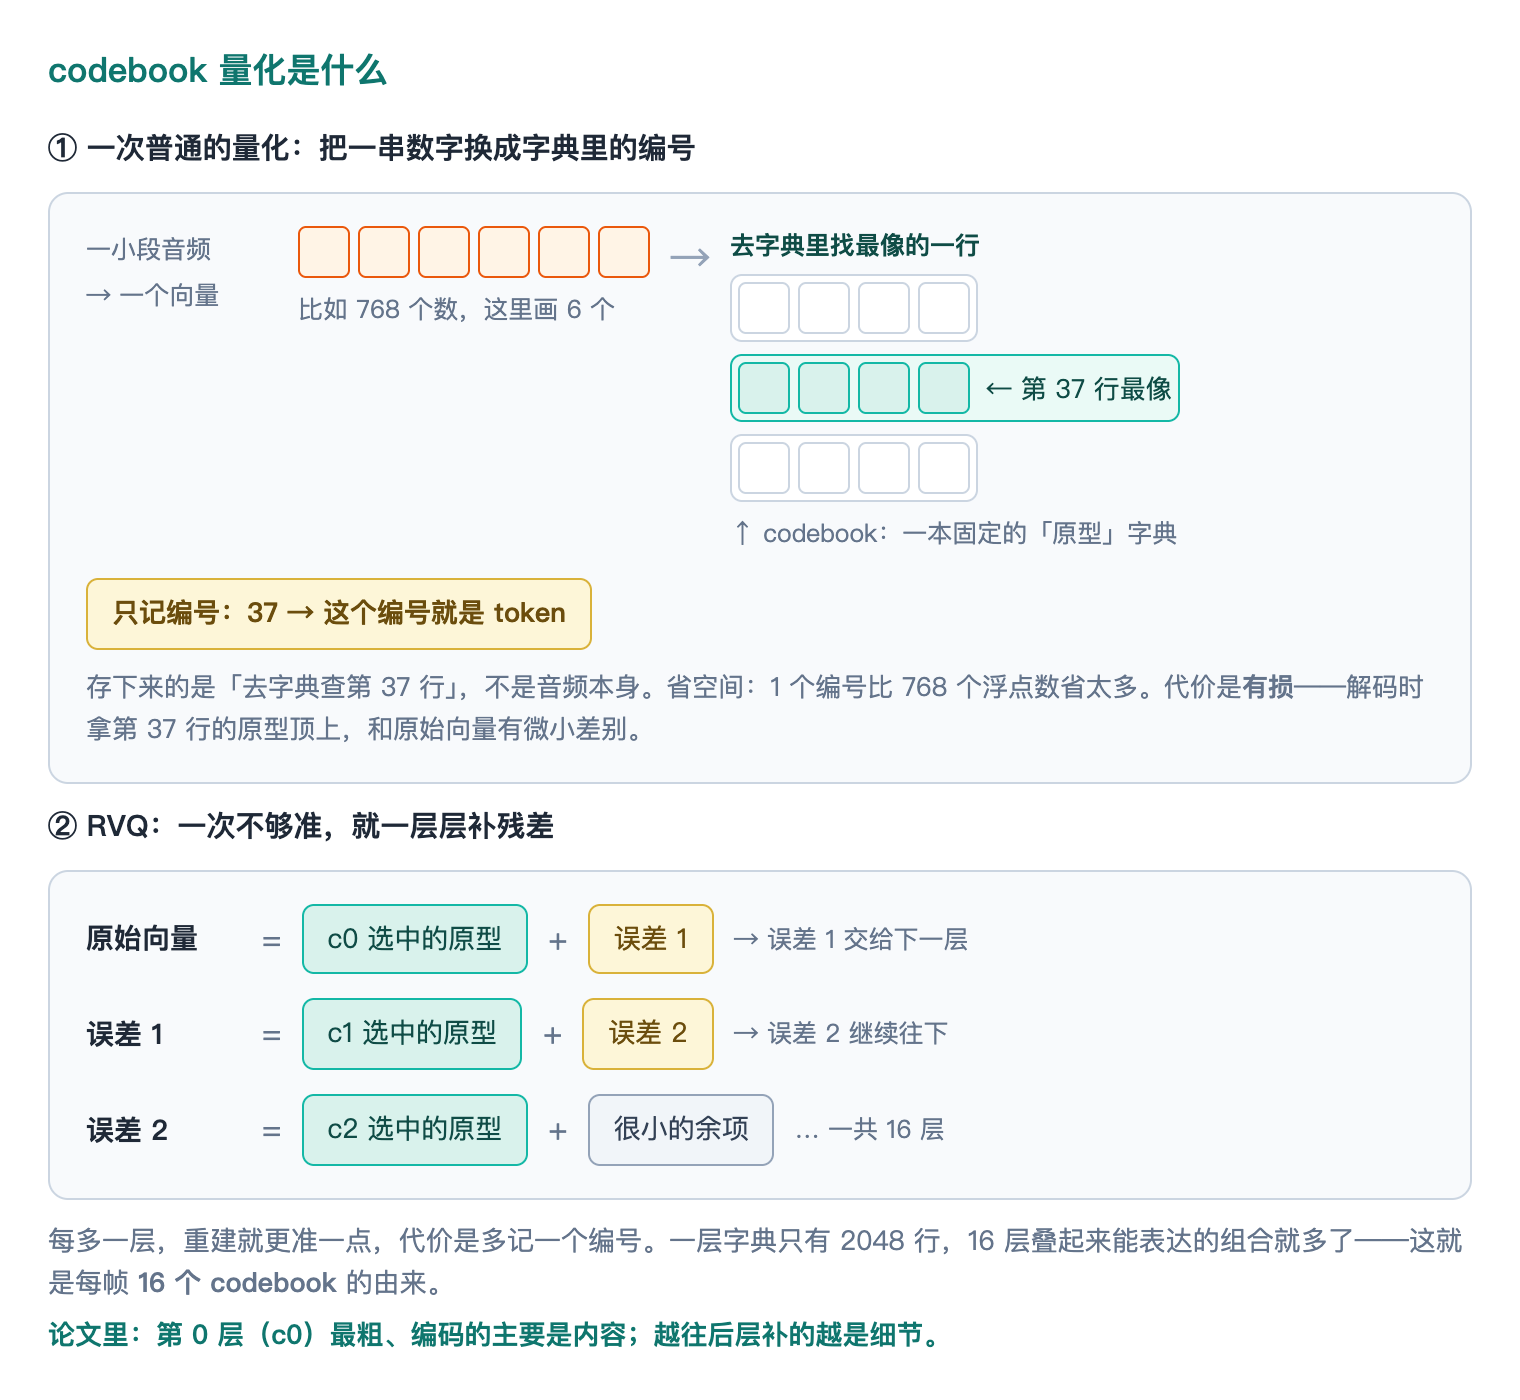
第四步:一层不够,用 16 层补。 一个 2048 行的表,最多只能表达 2048 种不同的向量,精度远远不够——用最接近的那一行去顶替,和原始向量总有差距(这个差距叫残差)。于是有了 RVQ(residual vector quantization,残差向量量化):第一层量化完,把”原始向量 − 第一行原型”这个残差再送进第二个 codebook 量化一次,第二层的残差再送进第三个……一共 16 层,每层都有自己独立的 2048 行表。每多一层,就多记一个整数、重建就更准一点。
于是最终答案是:一帧音频 → 16 个 0~2047 的整数(记作 $c_0$ 到 $c_{15}$)。第 0 层($c_0$)最粗、编码的是这一帧最主要的信息;越往后的层补的越是细节。一段 1 秒的音频,就变成 12.5 帧 × 16 = 200 个整数。
(这里对维度做了简化,好抓住主干。真实实现里 codebook 查找用的是 factorized 形式——先把特征向量投影到一个更低维的空间再和码本比,省计算;不影响上面的理解。)
2.2 由此而来的长度问题:16 个整数怎么排成序列
每帧 16 个整数,LLM 是”一个接一个读 token”的,所以得先决定:这些整数按什么顺序排成一条序列喂给它。下图和下文里,$t$ 表示第几帧(时间方向),$k$ 表示第几层码本(深度方向,$k_0$ 到 $k_{15}$)。 为了画得下,图里用 3 帧 × 4 层做示意。
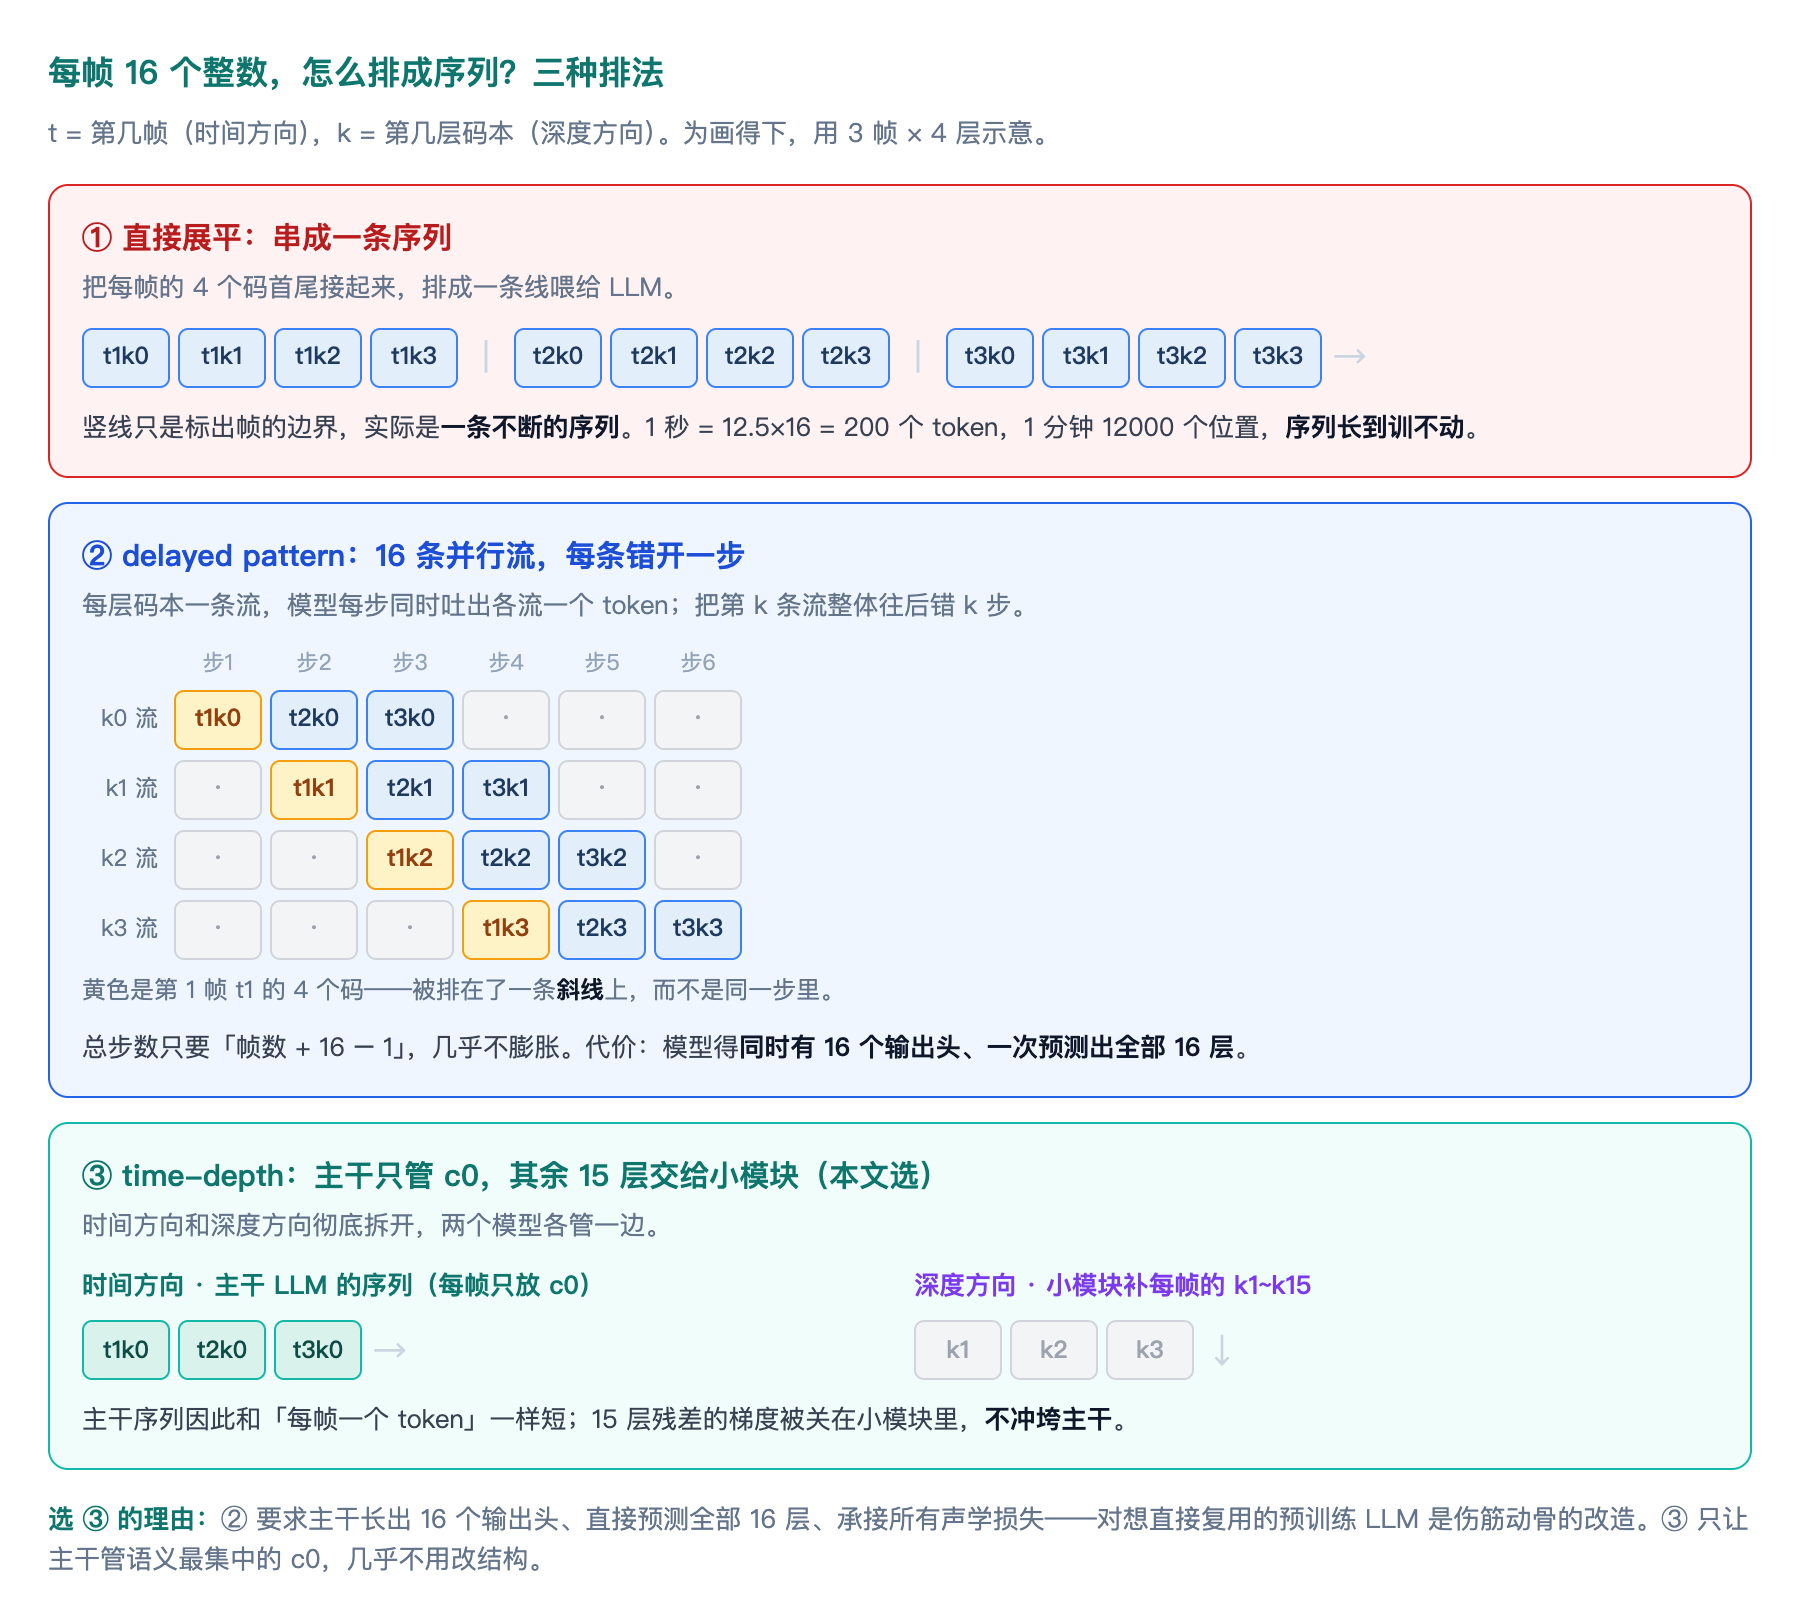
有三种排法:
-
① 直接展平:把所有整数首尾接成一条序列——第 1 帧的 $k_0 k_1 \ldots k_{15}$,接第 2 帧的 $k_0 k_1 \ldots k_{15}$,一直排下去。最直观,但长度爆炸:1 秒 = 200 个 token,1 分钟就是 12000 个位置,训不动。
-
② delayed pattern(延迟模式,MusicGen 用的):不再串成一条,而是开 16 条并行的流(每层码本一条),模型每个时间步同时吐出 16 个 token(每条流一个)。诀窍在于把第 $k$ 条流整体往后错 $k$ 步:第 0 层从第 1 步开始出,第 1 层从第 2 步才开始出……于是同一帧的 16 个码,不在同一步里,而是排在一条斜线上(见图中高亮的对角线)。这样总步数只有”帧数 + 16 − 1”,几乎不膨胀。代价是模型必须同时具备 16 个输出头、并一次预测出全部 16 层。
-
③ time-depth(时间-深度分离,本文选的):把两个方向彻底拆开。时间方向的主干序列里,每帧只放 $c_0$ 一个 token;剩下的 $c_1 \ldots c_{15}$ 不进主干,交给一个小模块沿深度方向(同一帧内部逐层)单独生成。主干因此短得和”每帧一个 token”一样。
论文选 ③,理由说得很直白:② 的延迟模式要求主干模型自己长出 16 个输出头、直接预测全部 16 层、并承接所有层的声学损失——这对一个想直接拿来复用的预训练文本 LLM 来说,是伤筋动骨的改造。而 ③ 只让主干管 $c_0$(语义最集中的那层),把 15 层残差和它们的梯度关进一个小模块里,主干几乎不用改。
这个”只让主干管 $c_0$”的选择,是理解全文的第一个支点。
3. 结构:一根时间轴管语义,一根深度轴管声学
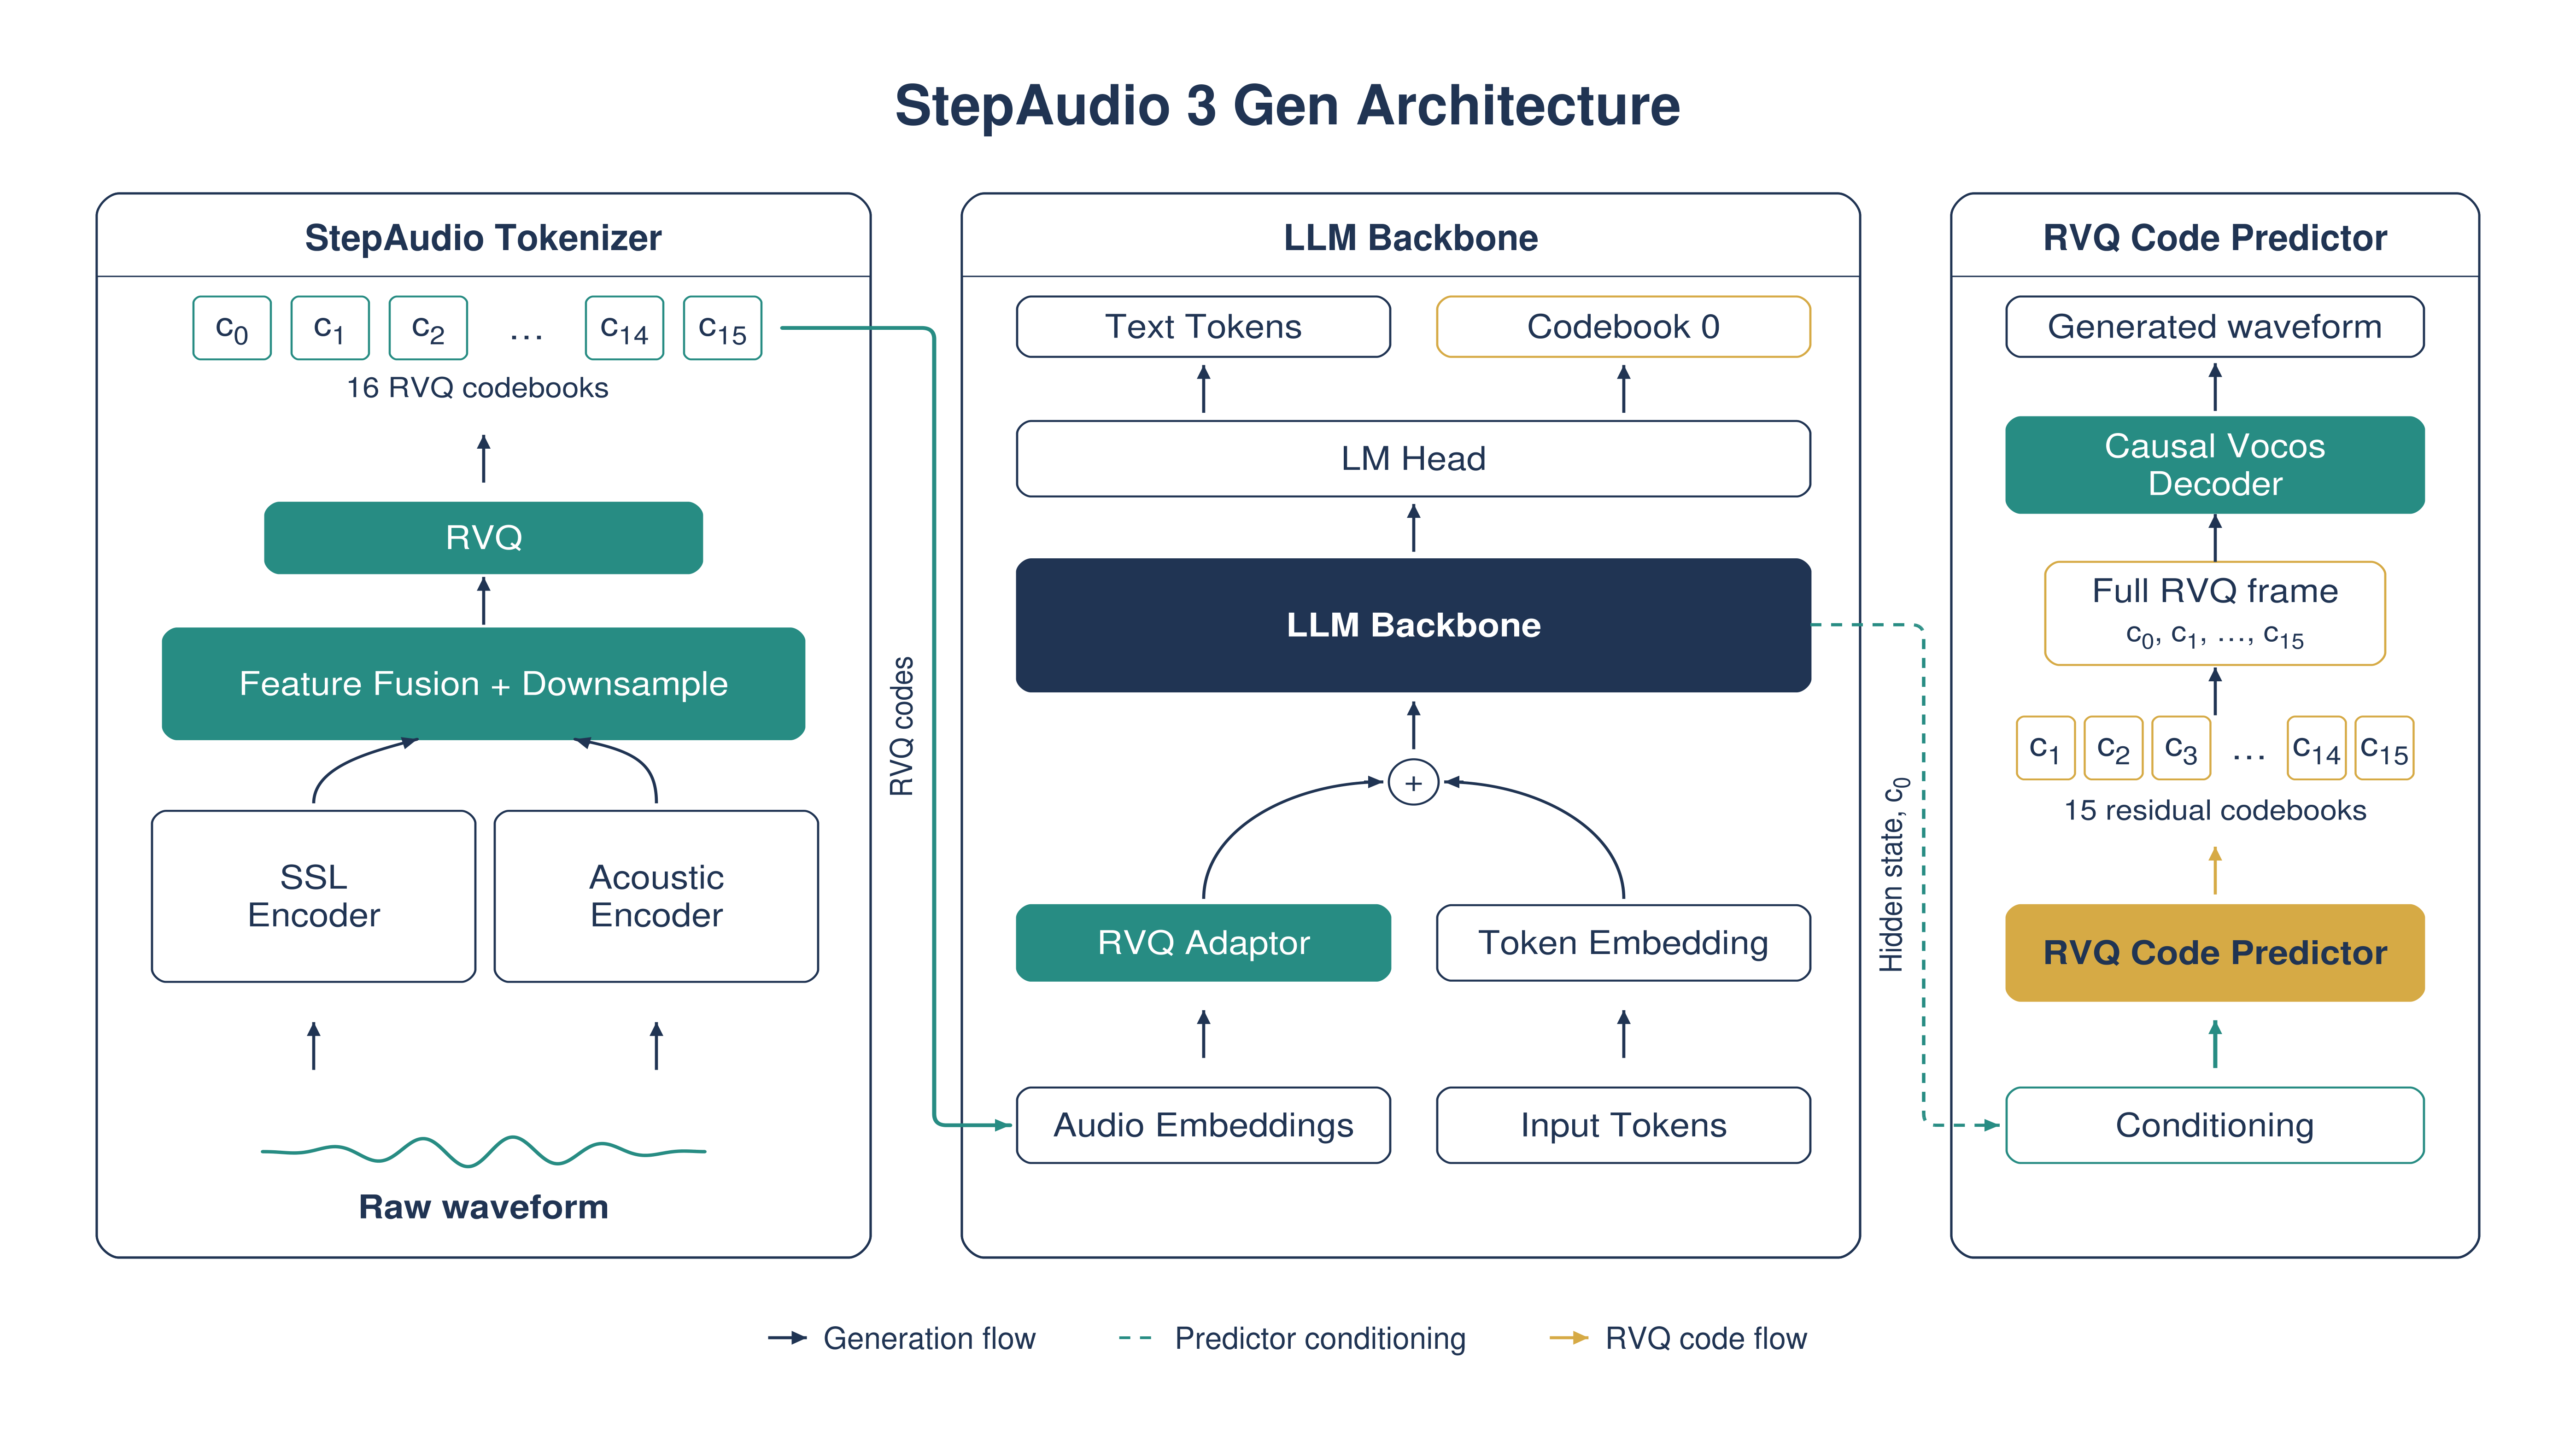
先看论文自己的架构图,建立整体印象:
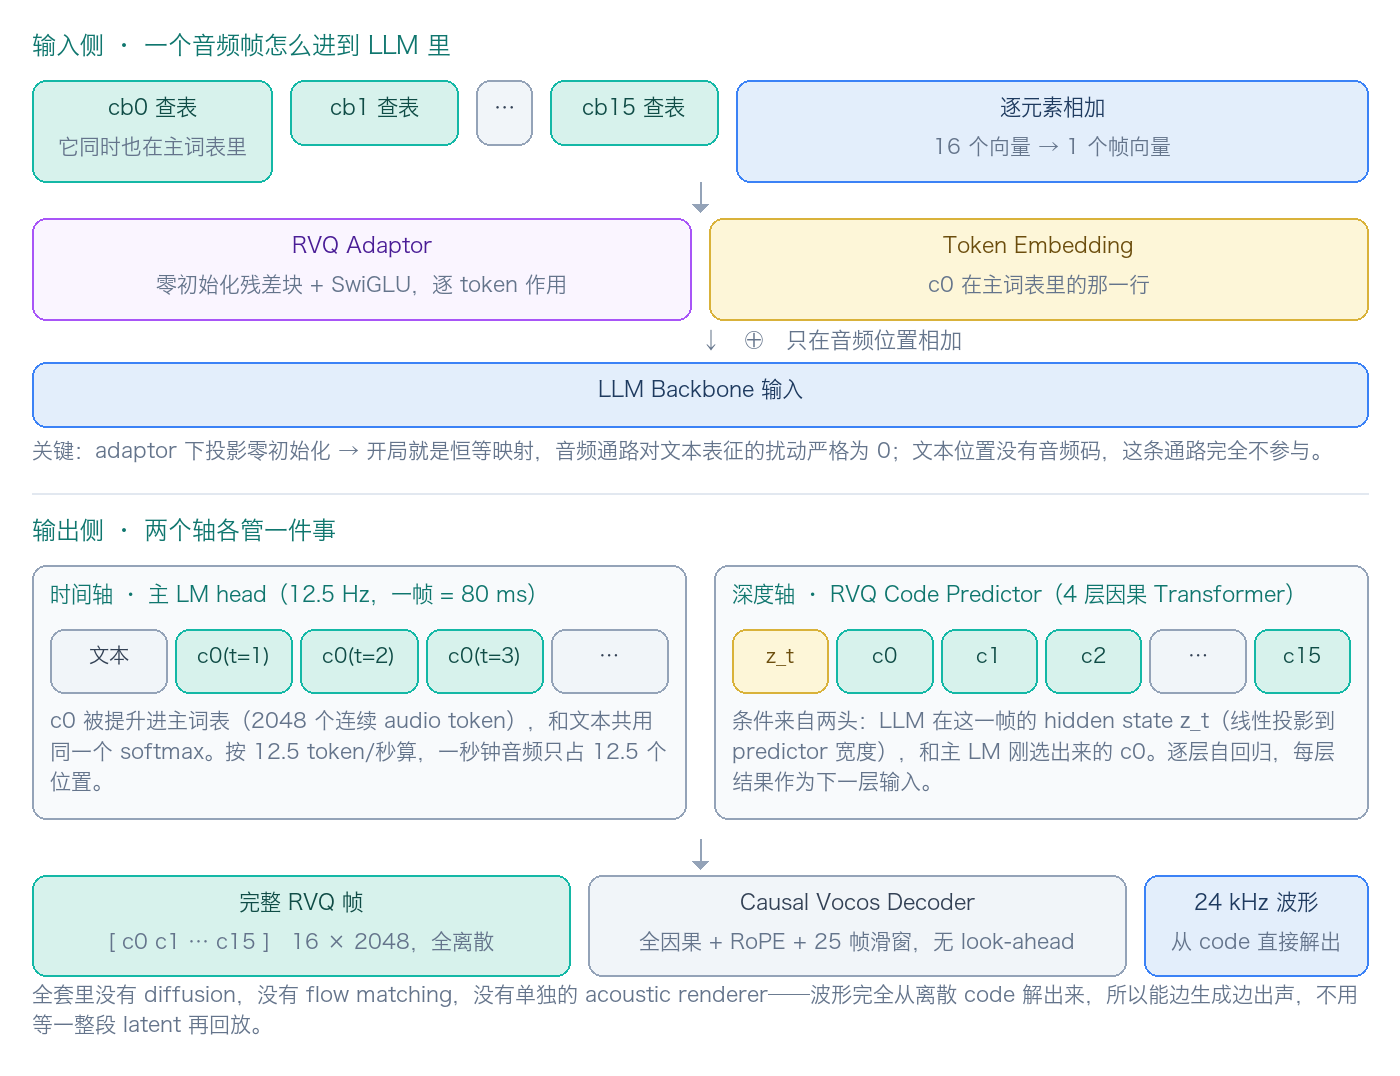
下面这张是按论文重新组织的输入/输出侧拆解。这张信息比较密,只抓两条主线就够了:上半部分是音频怎么进 LLM(紫色的 RVQ Adaptor),下半部分是 LLM 怎么把音频吐回来(绿色的时间轴 + 紫色的深度轴):
3.1 表征:12.5 Hz、16 个码本,语义和声学不分家
StepAudio Tokenizer 是整套东西的地基,规格是:12.5 Hz(每帧 80 毫秒,一秒钟音频 12.5 个时间步)、每帧 16 个 codebook,每个 2048 项、重建 24 kHz 波形。
但光看规格看不出门道。真正该先问的是:这套 token 是给谁用的? 答案是给 LLM 读写的——它既要当 LLM 的输入(音频理解),又要当 LLM 的输出(音频生成)。这个定位决定了表征必须同时满足两个互相拉扯的要求,而这一节剩下的每一个设计,都是在为同时满足这两件事服务。
要求一:LLM 得”读得懂”它,所以必须带语义。 LLM 的全部本领就是 next-token prediction:给定前面的 token,预测下一个。如果音频 token 的分布和语言没关系,LLM 就学不到”这句话说完,下一句该说什么”这种语言层面的规律,audio token 也没法跟 text token 放进同一个词表;往小了说,后训练里那堆理解类任务——ASR、语音翻译、音频描述——一个都做不了。所以语义信息必须在。
要求二:波形得还原得回去,所以必须带声学。 这套 token 还得负责出声。只靠语义做不到:同一个 c0 对应着无数种音色、无数种录音环境——”这人说’你好’“和”那人说’你好’“在语义上没差别,波形却完全不同。这是典型的一对多问题,光有语义层,还原时只能瞎挑一个,说话人信息全丢。
麻烦在于,单独任何一路都满足不了这两个要求:
- 只用语义特征(早期 semantic token + 外挂 vocoder 的做法):语义强,但丢音色,一对多还原不回去;
- 只用声学特征(SoundStream / EnCodec 这类纯重建导向的 codec):重建好,但 token 分布跟语言没关系,LLM 学不到东西。
StepAudio 的 tokenizer 沿用了一条叫 X-Codec 的现成路线(一系列专门解决”codec 缺语义”问题的音频 codec 工作,见文末参考),核心主张就是:语义和声学两个都要,并且在量化之前就把它们合在一起。具体用两路编码器:
- SSL 编码器(self-supervised learning,自监督学习)。指 HuBERT、wav2vec 2.0、WavLM 这一族模型:拿海量无标注音频,把一段帧遮掉、让模型去预测被遮位置对应的离散单元,监督信号从数据本身来,所以叫”自监督”。这类模型训完有个鲜明性格——对”说了什么”极其敏感,对”谁说的、在哪儿说的”相当不敏感。对识别任务是优点,对生成是缺点,因为它根本不记音色。
- 声学编码器。一个卷积编码器(配 SnakeBeta 激活,这个激活函数来自 BigVGAN),直接从原始波形、在 50 Hz 速率上提特征。它没有预训练、没有语义目标,是跟着 tokenizer 的重建损失和 GAN 损失端到端训出来的,学到的正是”要把波形还原出来还缺什么”——音色、基频、能量包络、混响。
至于 SSL 为什么是冻结的,论文没展开,但理由不难猜:一是省事,这个模型本来就是现成的;二是它还兼任语义蒸馏的 teacher(下面会讲),teacher 必须不动,否则蒸馏就失去了稳定的参考系。
两路沿通道维拼起来(不是二选一),再用一个 strided convolution 在时间上压到 12.5 Hz,交给同一个共享量化器。结果是每一层 codebook 里都同时有语义和声学信息,而不是前几层管语义、后几层管声音的硬分工。
但”信息都在”和”信息在前面”是两回事。3.2 节的 time-depth 分工要求主干只预测 c0,前提是 c0 足够”语义”——否则 LLM 拿一个混着音色噪声的 token 去做时间规划,是没意义的。为此训练时上了两个机关,把语义往前面几层挤:
- 量化器 dropout 取 0.5。指的是训练时随机跳过若干层残差量化,逼前面的层自己去扛更多信息。0.5 这个比例是刻意选的——论文提到再大一点,前几层确实更强,但满深度重建质量会掉;
- 语义蒸馏分支,用一个回归目标把冻结 SSL 编码器的特征从量化后的 latent 里还原出来。注意 SSL 编码器在这里是两重身份:既是被融合进输入的那一路,又是蒸馏的 teacher——这也是它必须冻结的另一个原因。
两个机关叠在一起,语义信息被集中到了最前面的 codebook 上。这不是一个可选的小优化,而是后面整套 time-depth 分工能成立的前提。
另外两个工程细节值得记一笔。第一,量化用的是 16×2048 的 RVQ,codebook 查找是 factorized + 余弦相似度的形式,不是常见的欧氏距离 L2 最近邻。第二,解码器是全因果的:Vocos 风格的 Transformer 骨架,配 RoPE 位置编码和 25 帧滑窗注意力,最后用一个 iSTFT head 出 24 kHz 波形——这么设计的目的很直接:全因果 + 无 look-ahead 意味着能边出 token 边出声,这是上实时在线服务的前提,也是很多走 diffusion 的通用音频模型绕不过去的坎。
3.2 生成:c0 交给 LLM,c1~c15 交给一个小 Transformer
有了统一表征,生成就被拆成了两根轴:
时间轴上,16 个 codebook 里的第 0 个(记作 c0)被提升进主语言模型的词表——2048 个连续的 audio token 直接接在文本词表后面。于是主 LM head 一个 softmax 就同时管了自然语言 token 和音频的顶层 token,两种模态可以自由交错。
深度轴上,剩下 15 层残差交给一个 4 层因果 Transformer,论文里叫 RVQ Code Predictor。它每一步收到两个条件:LLM 在这一帧的 hidden state $z_t$(线性投影到 predictor 的宽度),和主 LM 刚刚选出来的 c0。然后它自回归地吐出 c1、c2……直到 c15,每一层的输出再喂回去当下一步的输入。
写成分解式就是:
\[p(c_{t,0},\ldots,c_{t,15}\mid \mathbf{z}_{<t},\mathbf{c}_{<t}) = \underbrace{p(c_{t,0}\mid \mathbf{z}_{<t},\mathbf{c}_{<t})}_{\text{主 LM head}} \;\prod_{k=1}^{15}\;\underbrace{p(c_{t,k}\mid \mathbf{z}_{t},c_{t,0},\ldots,c_{t,k-1})}_{\text{RVQ Code Predictor}}\]论文特别强调这个分解是精确的而不是近似的,理由有点绕但值得品:因为一个音频帧的 16 个向量是先相加成一个帧向量再进 LLM 的,所以 $z_t$ 里已经通过 backbone 编码了历史帧的全部 16 层($\mathbf{c}_{<t}$),不存在”past 帧的残差没被 LLM 看到”的信息缺口。
它放弃的只是反方向:predictor 的输出不回灌给 backbone。而这恰恰是后面训练策略里那个 detach 操作的由来——因为两边既然不是必须联合优化,就可以分开、分阶段优化。
3.3 输入侧:RVQ Adaptor 这道”调压阀”
输出侧的设计已经够简洁了,输入侧还埋了一个更关键的模块。
一个音频帧不是一个向量,是 16 个向量。这 16 个 codebook 各自有一张 embedding 表,查出来的 16 个向量直接相加,得到这一帧的帧向量。然后这个帧向量过一道 RVQ Adaptor——一摞逐 token 作用的残差块(pre-norm + SwiGLU),输出只加在音频位置上,和 c0 那个 audio token 的 embedding 逐元素相加。
注意 c0 在这里被表示两次:一次在主词表里(作为那个 audio token),一次通过它自己的那张表混在帧向量里。
这道 adaptor 有两个细节决定了它到底管不管用:
- 位置门控:文本位置没有任何音频码,整条通路不参与,只加在音频位置;
- 下投影零初始化:这意味着训练刚开始时,adaptor 是一个恒等映射——音频通路对文本表征的扰动,在初始化那一瞬间严格是 0。
第二条是整套防干扰设计的源头。后面讲训练时会看到,正是靠它,第一阶段才敢只训 adaptor 而完全不做文本回放。
最后是损失函数:
\[\mathcal{L} = \mathcal{L}_{\mathrm{tok}} + \lambda\,\mathcal{L}_{\mathrm{sp}}, \qquad \mathcal{L}_{\mathrm{tok}} = -\sum \log p(c_{t,0}, x_t), \qquad \mathcal{L}_{\mathrm{sp}} = -\sum_t \sum_{k=1}^{15} \log p(c_{t,k}\mid\cdot)\]一个小到容易看漏、但后面会变成关键的设计:$\mathcal{L}_{\mathrm{sp}}$ 是对 15 层 codebook 求和(sum),而不是取平均。也就是说,声学损失的量级天然比 token 级损失大一个数量级。这个”债务”迟早要还——还的方式就是第 5 节里那个 $\lambda$。
4. 数据:预训练铺覆盖,后训练全靠自己造
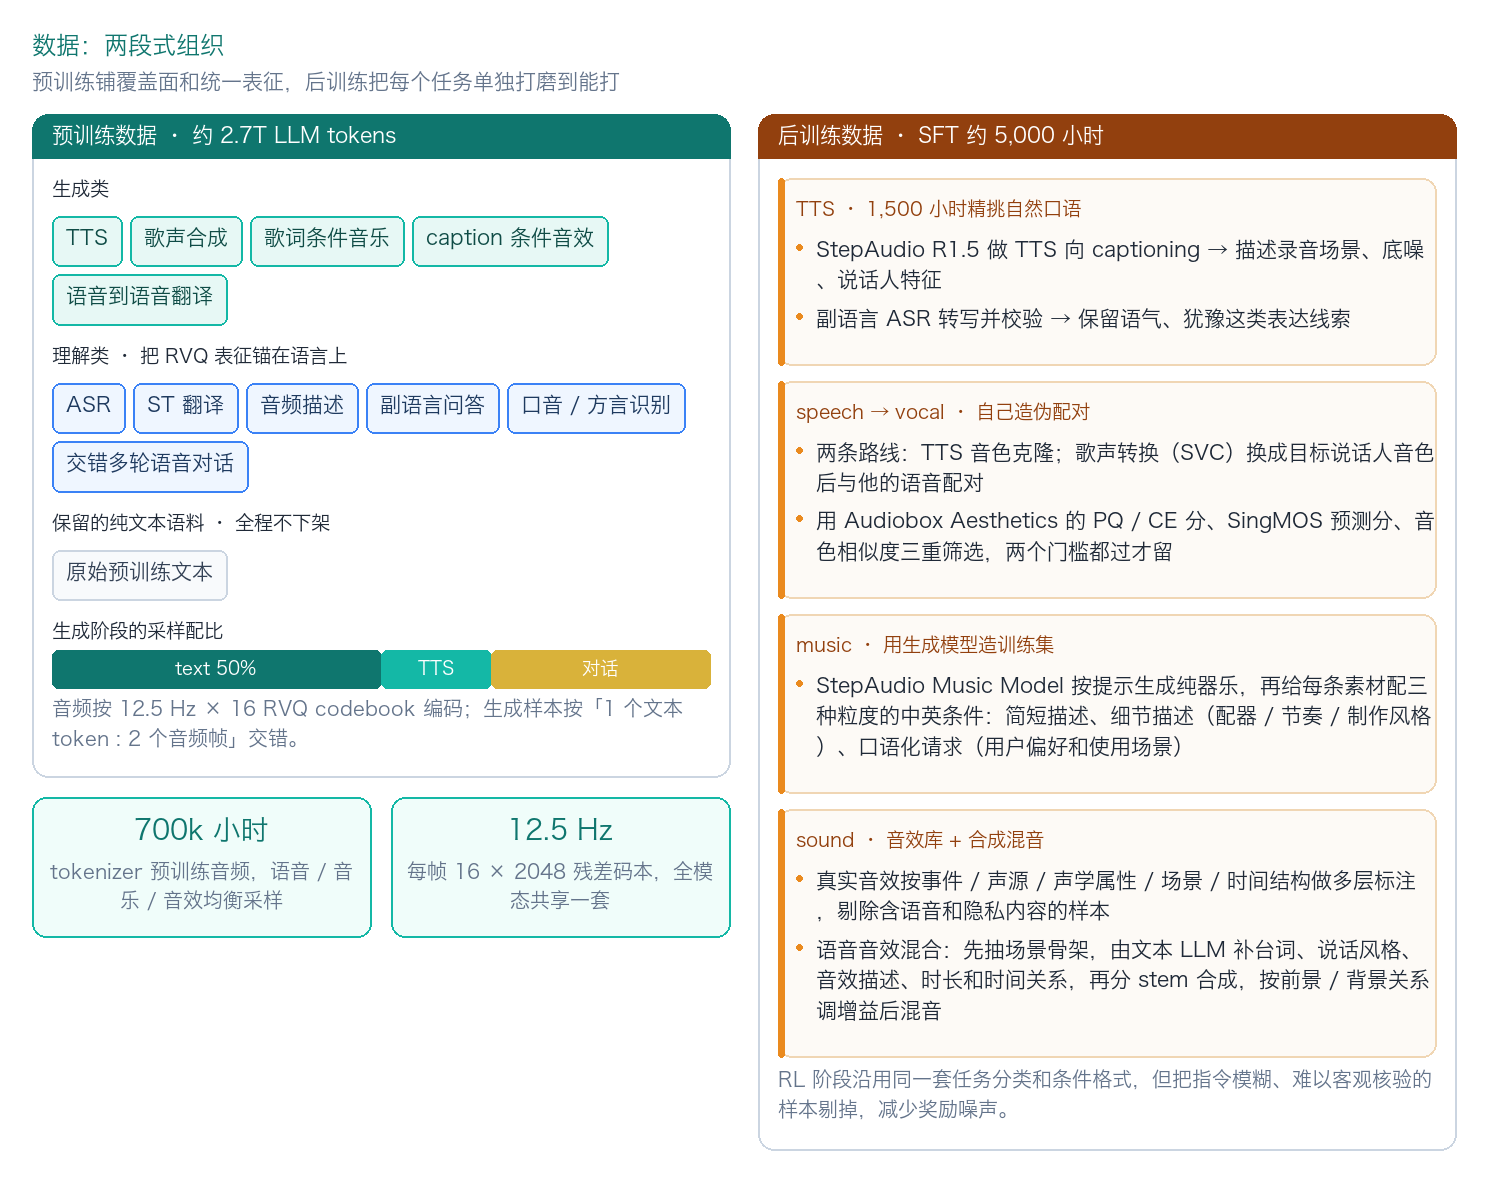
这张图左右两栏对应两段,先看两栏的标题,再看里面的粗体小标题,最后才是正文细节——如果只想抓住主线,看完左右两栏的标题就可以往下走。
整份报告的数据组织分成两段:预训练铺覆盖面(目标是建立一套统一的音频理解 + 生成能力),后训练按任务逐个打磨(目标是质量、自然度和可控性)。四个阶段加起来,LLM 侧一共吃了约 2.7T tokens。
4.1 预训练:一份”生成 + 理解 + 文本”的混合料
预训练的音频来源横跨语音、歌声、音乐和环境音,任务上分两类:
- 生成类:TTS、歌声合成、歌词条件音乐、caption 条件音效、语音到语音翻译;
- 理解类:ASR(自动语音识别)、语音到文本翻译、音频描述、副语言问答、口音 / 方言识别、交错的多轮语音对话。
理解类这一半很容易被忽略,但它其实是把 RVQ 表征锚在语言上的那根钉子。论文的原话是,这些 understanding 任务负责”暴露音色、情绪、口音这些可控属性”——模型要先能听懂”这是什么音色 / 什么情绪”,后面才谈得上按指令生成。
音频统一按 12.5 Hz × 16 codebook 编码,生成样本的排布方式是 1 个文本 token : 2 个音频帧交错。
采样配比有个很硬的比例,从第 2 阶段起生效:
- 从 Stage 2 开始,文本语料占每个 optimizer step 的一半;
- 生成阶段的配比固定为
text : TTS : 交错对话 = 3 : 1 : 2——文本份额恰好 50%,TTS 占每个 micro-batch 的 1/6,也就是音频生成流里的三分之一。
4.2 Tokenizer 自己的训练:700k 小时 + 两阶段
Tokenizer 不是白来的,它单独训了 约 70 万小时的语音 / 音乐 / 音效,用模态均衡的采样器保证不会偏向某一种。整个训练走 GAN 框架(多周期波形判别器 + 多分辨率频谱判别器),再配 feature matching、多尺度 mel 谱和 RVQ commitment 损失。
第二阶段的设计有个巧思:冻结编码器、量化器和语义分支,只练声学解码器和判别器。好处是重建质量涨了、但 token 空间一个字没动——所有已经在这些 token 上训过的模型依然兼容。说白了就是把”表示”和”渲染”彻底解耦,表示定稿之后,渲染可以慢慢调,不会连累下游。
4.3 后训练:约 5,000 小时,几乎每一块都是造出来的
预训练之后是 SFT(supervised fine-tuning,监督微调),语料约 5,000 小时,横跨音乐、音效、voice design、歌声和语音。这部分的构造细节比模型结构更能说明现在做通用音频模型的真实门槛——每一类数据背后都有一条用别的模型搭起来的流水线。挑几条看:
- TTS:为了”像人在说话”,单独精挑了 1,500 小时自然口语。筛选方式是用自家的 StepAudio R1.5 做面向 TTS 的音频 captioning,描述录音场景、底噪水平和说话人特征;再配一个专门优化过副语言现象的 ASR 做转写和校验,把语气、犹豫这类表达线索保住。
- speech → vocal(语音转歌声):语音-歌声成对数据极其稀缺,所以自己造伪配对。两条互补路线——TTS 音色克隆(拿一段歌声当条件,让 TTS 用它的音色说话),和歌声转换 SVC(把歌声换成目标说话人的音色,再和这个说话人的正常语音配对)。造完用三重指标筛:Audiobox Aesthetics 的 PQ / CE 两个分数(听感质量和内容愉悦度)、SingMOS 的歌声 MOS 预测(MOS 就是主观打分,1–5 分越高越好),加上合成音频与目标音频的音色相似度。音频质量和音色相似度两个门槛都得过才留。
- 音乐:干脆用自家的 StepAudio Music Model 按提示生成器乐素材,再给每条素材配三种粒度的中英条件——简短描述、细节描述(配器、节奏、制作风格)、口语化请求(用户偏好和使用场景)。三种粒度意味着同一段音乐在不同描述层级下都被监督到。
- 音效:真实音效库 + 合成混音两条腿。真实部分按”事件 / 声源 / 声学属性 / 场景 / 时间结构”做多层标注;混合场景则是先抽一个场景骨架(谁在说话、哪几段语音、哪些音效、什么环境声),让文本 LLM 去补台词、说话风格、音效描述、时长和时间关系,然后分 stem 合成(语音和音效各自独立生成),最后按声源显著度和距离调增益再混音——这一步是为了保住前景 / 背景的层次关系。
- Voice design:录制 + 合成两条来源,覆盖日常对话、角色对白、专业配音,以及各种录音环境,再把欠代表的”音色 × 说话风格 × 声学场景”组合用合成数据补上。
RL 阶段复用同一套任务分类和条件格式,只把指令模糊、难以客观核验的样本剔掉,减少奖励噪声。
5. 训练:四阶段课程,和它要挡的三件事
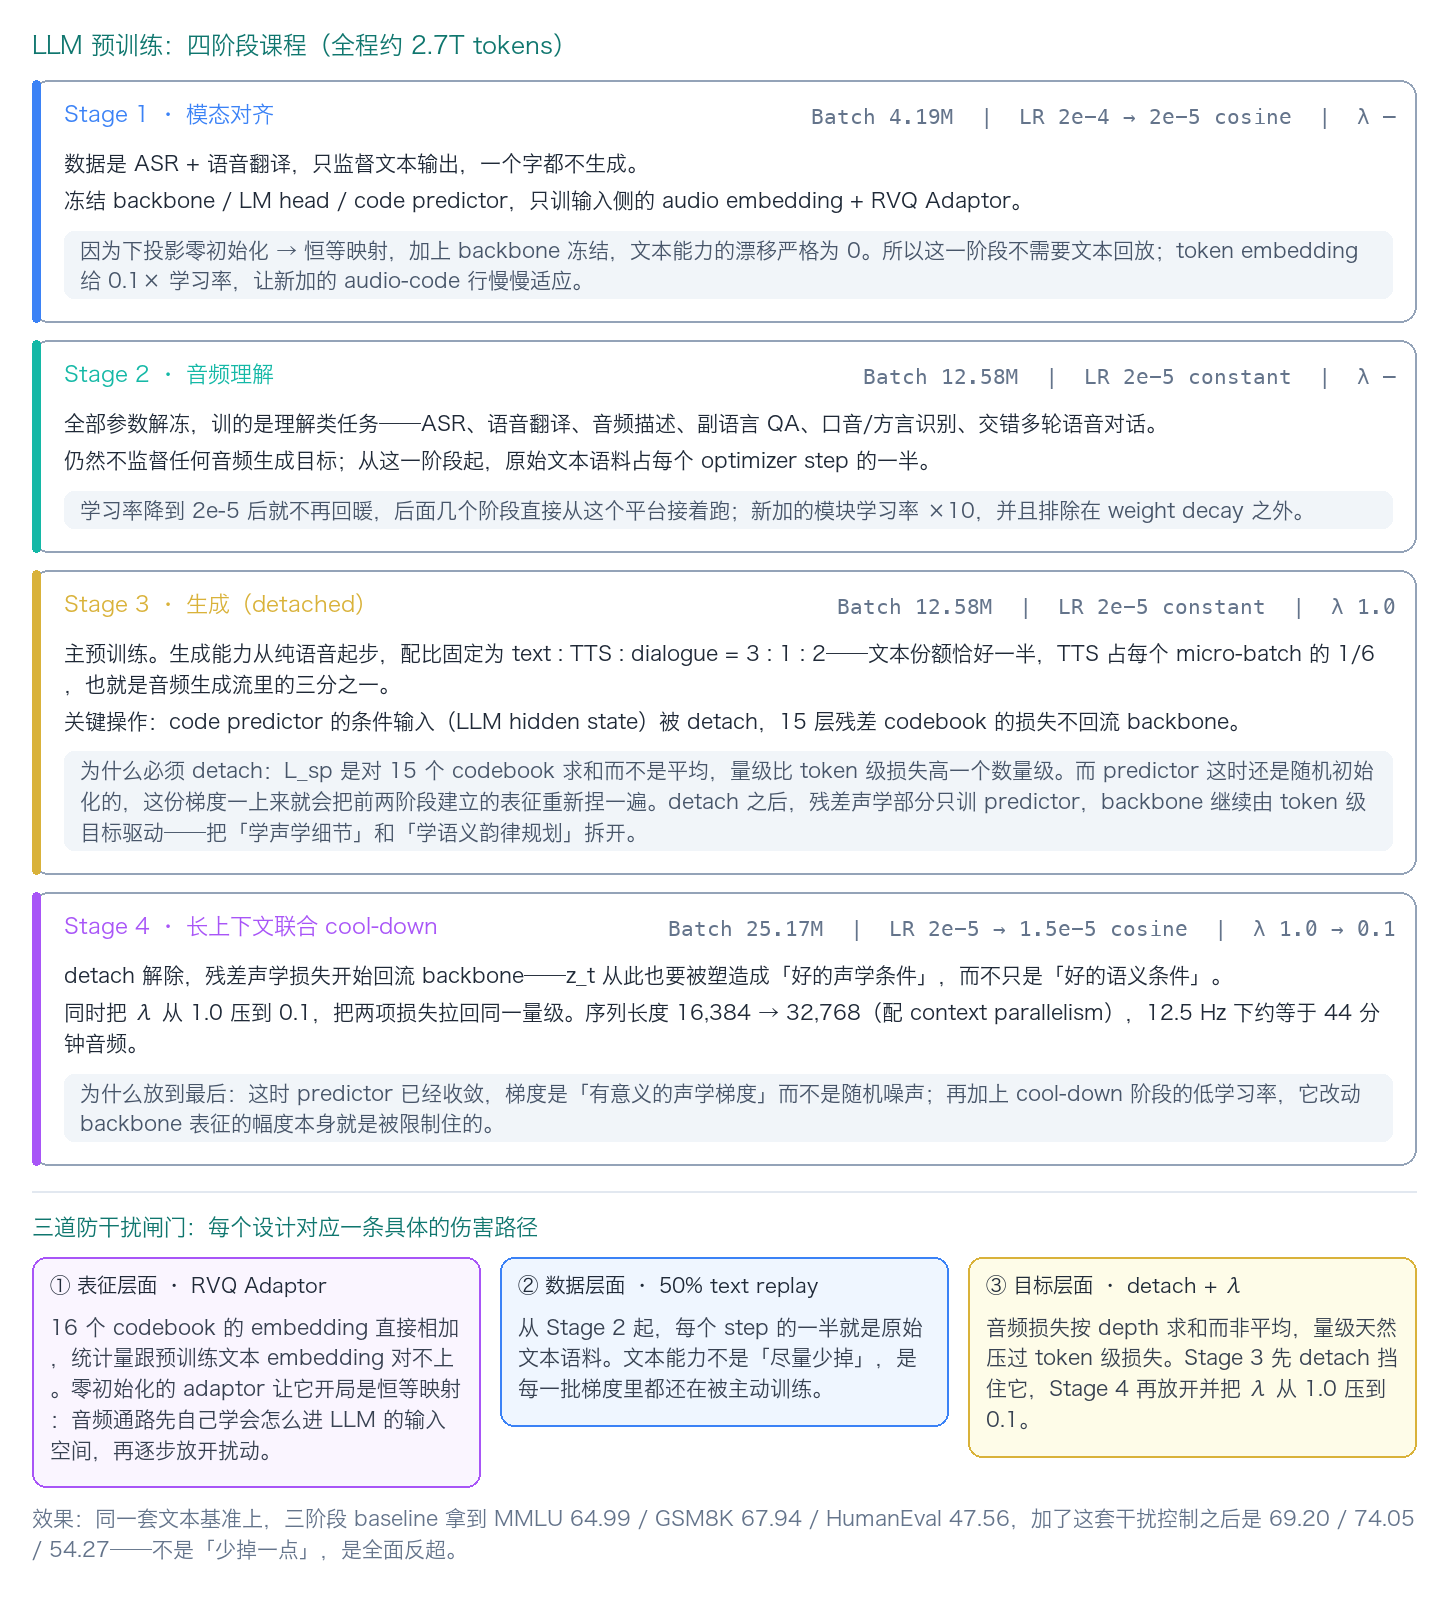
这张图分两层:上面四张卡片是四个阶段,看每张卡片左上角的 Stage 名字和右上角那行参数就够了;下面三张小卡片是四个阶段合起来要挡的三条伤害路径,对应 5.1 节。
这是整份报告里最”值钱”的部分,也是最能解释”为什么结果这么好”的部分。
5.1 先看清敌人:给文本 LLM 加音频,有两条伤害路径
论文把这件事说得非常直接:往一个文本 LLM 里加音频 token,不是中性的操作。
伤害路径有两条,方向完全不同:
- 表征层面:一堆新初始化的 RVQ embedding 加起来,它的统计量跟预训练文本 embedding 的统计量本来就对不上。LLM 被迫去适应一个分布外的新输入;
- 目标层面:每个时间步要预测 16 个 code,而残差那 15 层的损失因为是求和的,量级远大于 token 级交叉熵。如果一上来就联合优化,backbone 会优先去吸收这份巨大的声学梯度——在音频模块还没变有用之前,先把继承来的语言能力花掉了。
这两条路各自对应了具体的对策,而”四阶段课程”就是这些对策在时间上的排布。
5.2 四个阶段各自在干什么
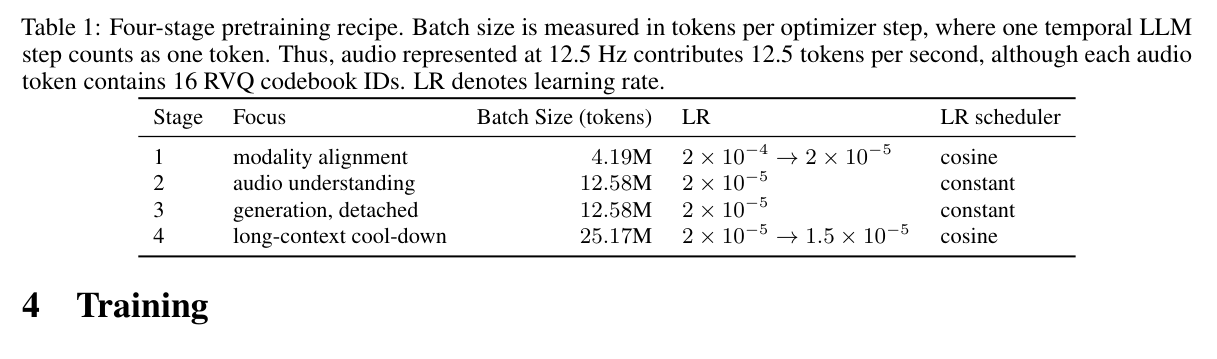
Stage 1 · 模态对齐。 数据是 ASR + 语音翻译,只监督文本输出,一个字音频都不生成。backbone、LM head、code predictor 全部零学习率,只训输入侧的 audio embedding 和 RVQ Adaptor。学习率 $2\times10^{-4} \to 2\times10^{-5}$ 走 cosine,batch 4.19M。
这一阶段有个很漂亮的论证:因为 adaptor 的下投影零初始化(恒等映射)+ backbone 冻结,文本能力的漂移严格等于 0,所以这一阶段根本不需要文本回放。另外 token embedding 给了 0.1× 的学习率——不是整块冻结,而是让新加的那 2048 行 audio-code 慢慢适应已有空间。
Stage 2 · 音频理解。 全部参数解冻,训理解类任务,仍然不监督任何音频生成目标。同时从这一阶段开始,原始文本语料占每个 step 的一半。学习率降到 $2\times10^{-5}$ 之后就走 constant——注意这个细节,后面几个阶段直接从这个平台接着跑,不再重新 warmup,也就不会再有”学习率从高往低冲一遍”带来的表征抖动。新加的模块学习率 ×10,并且排除在 weight decay 之外。
Stage 3 · 生成(detached)。 主预训练,生成能力从纯语音起步,配比 text : TTS : 对话 = 3 : 1 : 2。这一阶段的核心操作是:code predictor 的条件输入(backbone hidden state)被 detach,那 15 层残差的损失梯度不回流 backbone。
论文给的动机很实在:$\mathcal{L}_{\mathrm{sp}}$ 是对 15 个 codebook 求和而非平均,量级比 token 级损失高一个数量级;而 predictor 此刻还是随机初始化的。这两个条件凑在一起,那份梯度一上来就会把前两阶段辛苦建立的表征重新捏一遍。detach 之后,残差声学那部分只训 predictor,backbone 继续由 token 级目标驱动——把”学声学细节”和”学语义韵律规划”彻底拆开,这是保护文本能力的第二道保险。这一阶段 $\lambda = 1.0$。
Stage 4 · 长上下文联合 cool-down。 detach 解除,声学损失开始回流 backbone——于是 $z_t$ 除了要当好”语义条件”,还得被塑造成好的声学条件。同时 $\lambda$ 从 1.0 压到 0.1:既然 depth 损失现在能打到 backbone 了,就得把两项拉回同一量级,不能再让它高一个数量级。序列长度从 16,384 扩到 32,768(配 context parallelism),按 12.5 Hz 算,32,768 个时间步 ≈ 44 分钟音频,够覆盖长音频合成和多轮对话。batch 也翻倍到 25.17M。
为什么放到最后?论文两个理由都很实:一是这时 predictor 已经收敛,回流的是”有意义的声学梯度”而不再是随机噪声;二是 cool-down 阶段的低学习率本身就限制了它改动 backbone 表征的幅度。
把三道闸门并列看,会更清楚:
- 表征层面 · RVQ Adaptor——零初始化让它开局是恒等映射,音频通路先学会怎么进 LLM 的输入空间,再逐步放开扰动;
- 数据层面 · 50% text replay——文本能力不是”尽量少掉”,是每一批梯度里都还在被主动训练;
- 目标层面 · detach + λ——先挡住那份量级失衡的声学梯度,等 predictor 收敛、再放开并把 λ 从 1.0 压到 0.1。
5.3 后训练:SFT 全参微调 + GRPO
SFT 用的是全参数微调,把预训练末尾的联合配置直接继承下来(detach 保持关闭,$\lambda=0.1$ 的语音损失继续穿过 code predictor 打到 backbone)。序列长 16,384,batch 64,学习率从 $1.0\times10^{-5}$ 走 cosine 降到 $1.0\times10^{-6}$。audio embedding、adaptor、code predictor 这三个新模块保持 10× 学习率加成。
SFT 之后是 GRPO(Group Relative Policy Optimization)——这是 PPO 的一个变体,核心差别是不训 value model,而是对同一个指令采样一组输出,用组内相对好坏当优势值来更新策略。这里的几个设计值得单独看:
奖励是乘性的,不是加性的。 对每条生成的音频 $y_i$,先用一个音频理解模型写出 caption $c_i$,再让一个文本 LLM 比较 $c_i$ 和原始指令 $x$,给一个 0–100 的指令一致性分数。为了压评估方差,每个”指令-caption”对独立打 4 次分取均值 $\bar{s}_i$。对有目标文本的语音样本,再用 ASR 转出 $\hat{t}_i$,算错误率 $e_i$(中文按字算就是 CER,英文按词算就是 WER,都是”改多少个字才能变成标准答案”,越低越好):
\[R_i = \frac{\bar{s}_i}{100}\begin{cases}\exp(-\tau e_i), & e_i \leq 0.5,\\ 0, & e_i > 0.5,\end{cases} \qquad \tau = 3\]乘法的意义很直白:一段内容完全念错的音频,不能因为”风格很像指令描述的那样”就拿到高分。没有目标文本的任务(纯音效、纯音乐)就把 ASR 那一项设为 1。
动态采样滤掉”没信号”的组。 每条指令采 $G=16$ 个候选,优势 $\hat{A}_i=(R_i-\mu_R)/(\sigma_R+\eta)$。借鉴 DAPO 的做法,组内奖励标准差 $\sigma_R < \delta$($\delta=0.02$)的组直接丢掉——一组 16 个输出分数都差不多,说明这条指令对当前策略没区分度,留着重只会加噪声。
| 重要性比率是按 codebook 算的。 损失函数里对时间位置 $t$ 和 codebook 下标 $\ell \in {0,\ldots,15}$ 都算了 token 级的重要性比率 $\rho_{i,t,\ell}$,再除以 $16 | y_i | $ 做归一化,配一个很小的 KL 系数 $\beta$(主要靠 clip 约束更新),学习率 $10^{-6} \to 10^{-7}$。 |
这一步其实是个不太显眼但很实在的工程选择:GRPO 本来是给文本 token 设计的,这里把它直接铺到 16 层 codebook 上,让残差层也接受偏好信号的调教——而不是只训 c0、让 predictor 自生自灭。
6. 结果:每一块设计值多少分
报告里的实验组织得很干净,正好是三个问题:RVQ Adaptor 有没有用、干扰控制有没有用、最终生成质量如何。
6.1 RVQ Adaptor:不加它,音频根本没进到 LLM 的语义空间
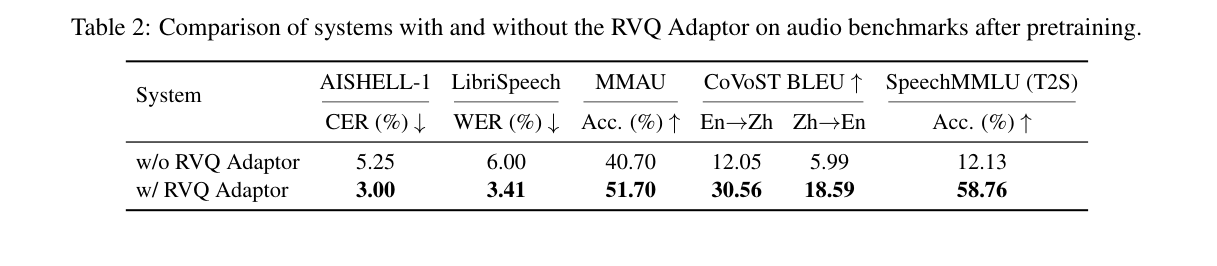
先回答一个容易犯嘀咕的问题:这个模型是拿来做音频生成的,为什么能报 ASR(语音转文字)成绩? 因为它并不是一个纯生成模型——2.1 节说过,它的 token 既能当输入也能当输出,而 5.2 节的 Stage 2 专门用 ASR、语音翻译、音频描述这些理解类任务训过它。也就是说,同一个模型既能”听懂”(把音频转成文字、做翻译),也能”开口”(生成音频)。这一节考的正是它”听”的能力。
几个指标先解释一下:CER / WER 是字/词错误率(识别结果要改多少字/词才能变成标准答案),越低越好;MMAU 是音频理解与推理基准,报准确率;CoVoST 是语音到文本翻译基准,报 BLEU(衡量生成译文和参考译文的 n-gram 重合度,越高越好);SpeechMMLU 是语音形式的知识问答,准确率越高越好。
对比结果:
- ASR:AISHELL-1 的 CER 从 5.25 → 3.00,LibriSpeech 的 WER 从 6.00 → 3.41;
- MMAU 准确率 40.70 → 51.70;
- CoVoST BLEU:En→Zh 12.05 → 30.56,Zh→En 5.99 → 18.59;
- SpeechMMLU (T2S) 准确率 12.13 → 58.76。
最后那一行是重点。SpeechMMLU 的 12.13% 是什么概念——基本等于在瞎猜。这说明不加 adaptor 的时候,多 codebook 音频表征根本没有落进 LLM 的语义空间,模型只是勉强在做模式匹配;加了之后才跳到 58.76%。这不是”涨了几个点”,是两个状态。
6.2 干扰控制:文本能力不是”少掉一点”,而是全面反超
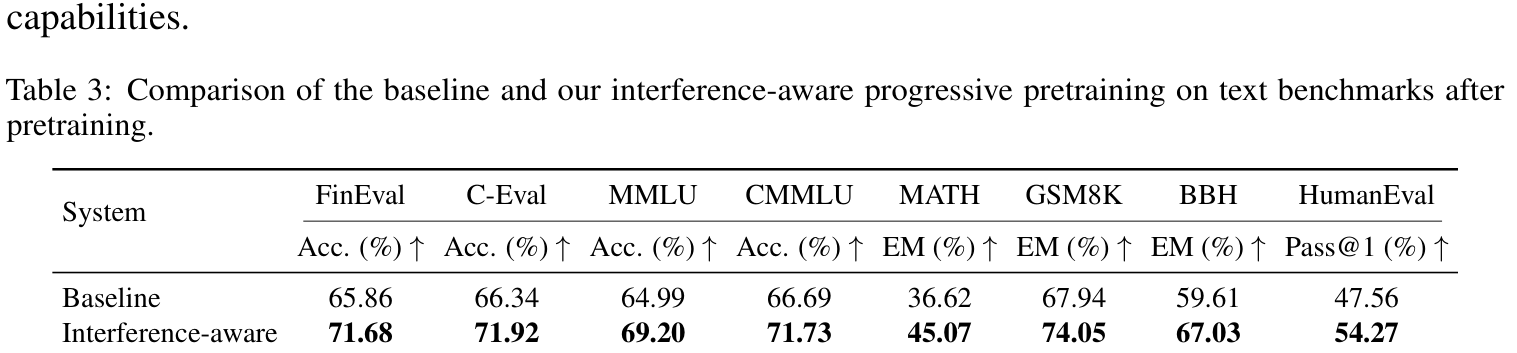
对照组是不用 RVQ Adaptor 的三阶段 baseline(ASR 训练 → 音频理解 + 生成训练 → cool-down),在 8 个文本基准上比:
- FinEval 65.86 → 71.68,C-Eval 66.34 → 71.92,MMLU 64.99 → 69.20,CMMLU 66.69 → 71.73
- MATH 36.62 → 45.07,GSM8K 67.94 → 74.05,BBH 59.61 → 67.03,HumanEval 47.56 → 54.27
八个基准全部反超,而且幅度不小。这比”文本能力只掉了 X%”有说服力得多——它说明这套课程不只是”少伤害文本能力”,而是在引入音频的同时顺带把文本能力也练上去了(毕竟 Stage 2 起一半的梯度就是纯文本)。
6.3 TTS:放弃 CER 和 SS,改问”像不像真人”
TTS 这块,报告的评测取向是全文最有意思的一处”反潮流”。
它明确说不用 CER 和 SS(speaker similarity,说话人相似度)这类客观指标,理由也站得住:一段语调平得像播报的音频,只要内容念对了,CER 照样很低;而 SS 反映的是说话人身份和音色,反映不了表达力。这两个指标恰恰测不出他们想要的”人味”。
所以他们搭了一个 Arena 式的成对主观评测:评者听两条音频,选”更像真人在自然说话”的那条,允许判平局。评测集是从真实人类语音里抽文本构造的中文 set,六个系统两两对比,一共 1,500 次比较,最后用 Elo 汇总(Elo 就是国际象棋那套评分,赢了涨分输了掉分,分数越高代表在这个池子里越被偏好)。
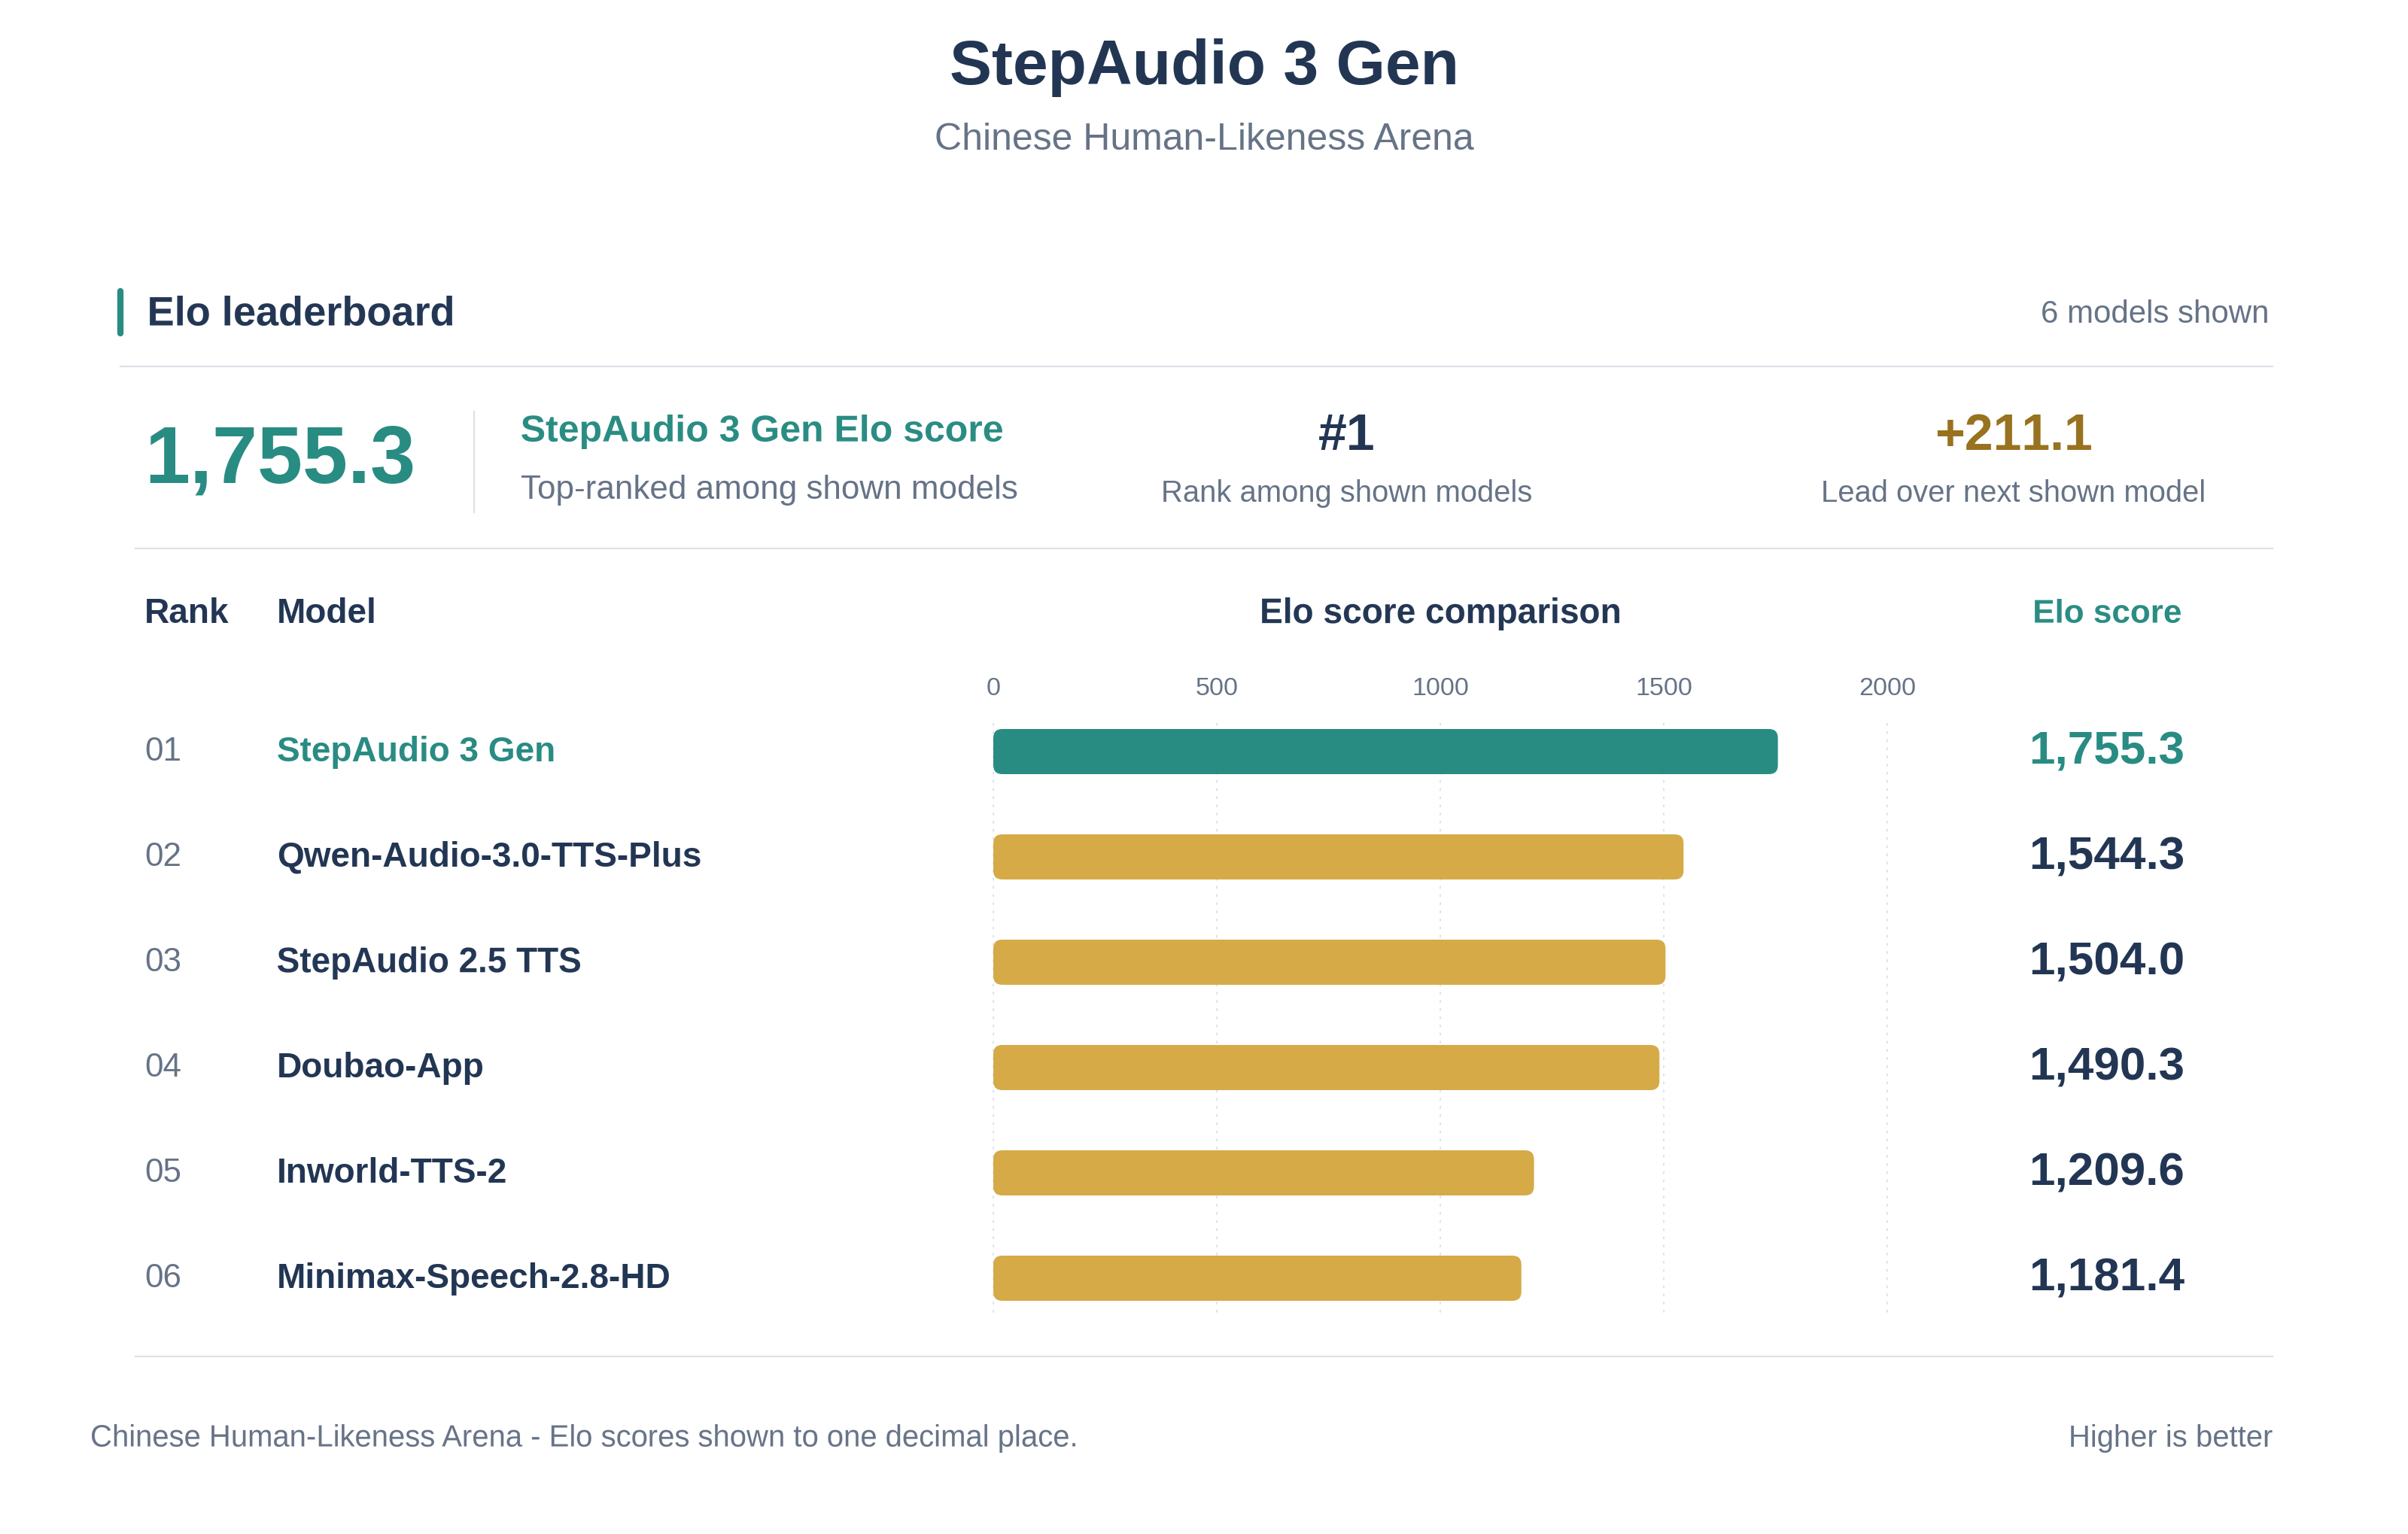
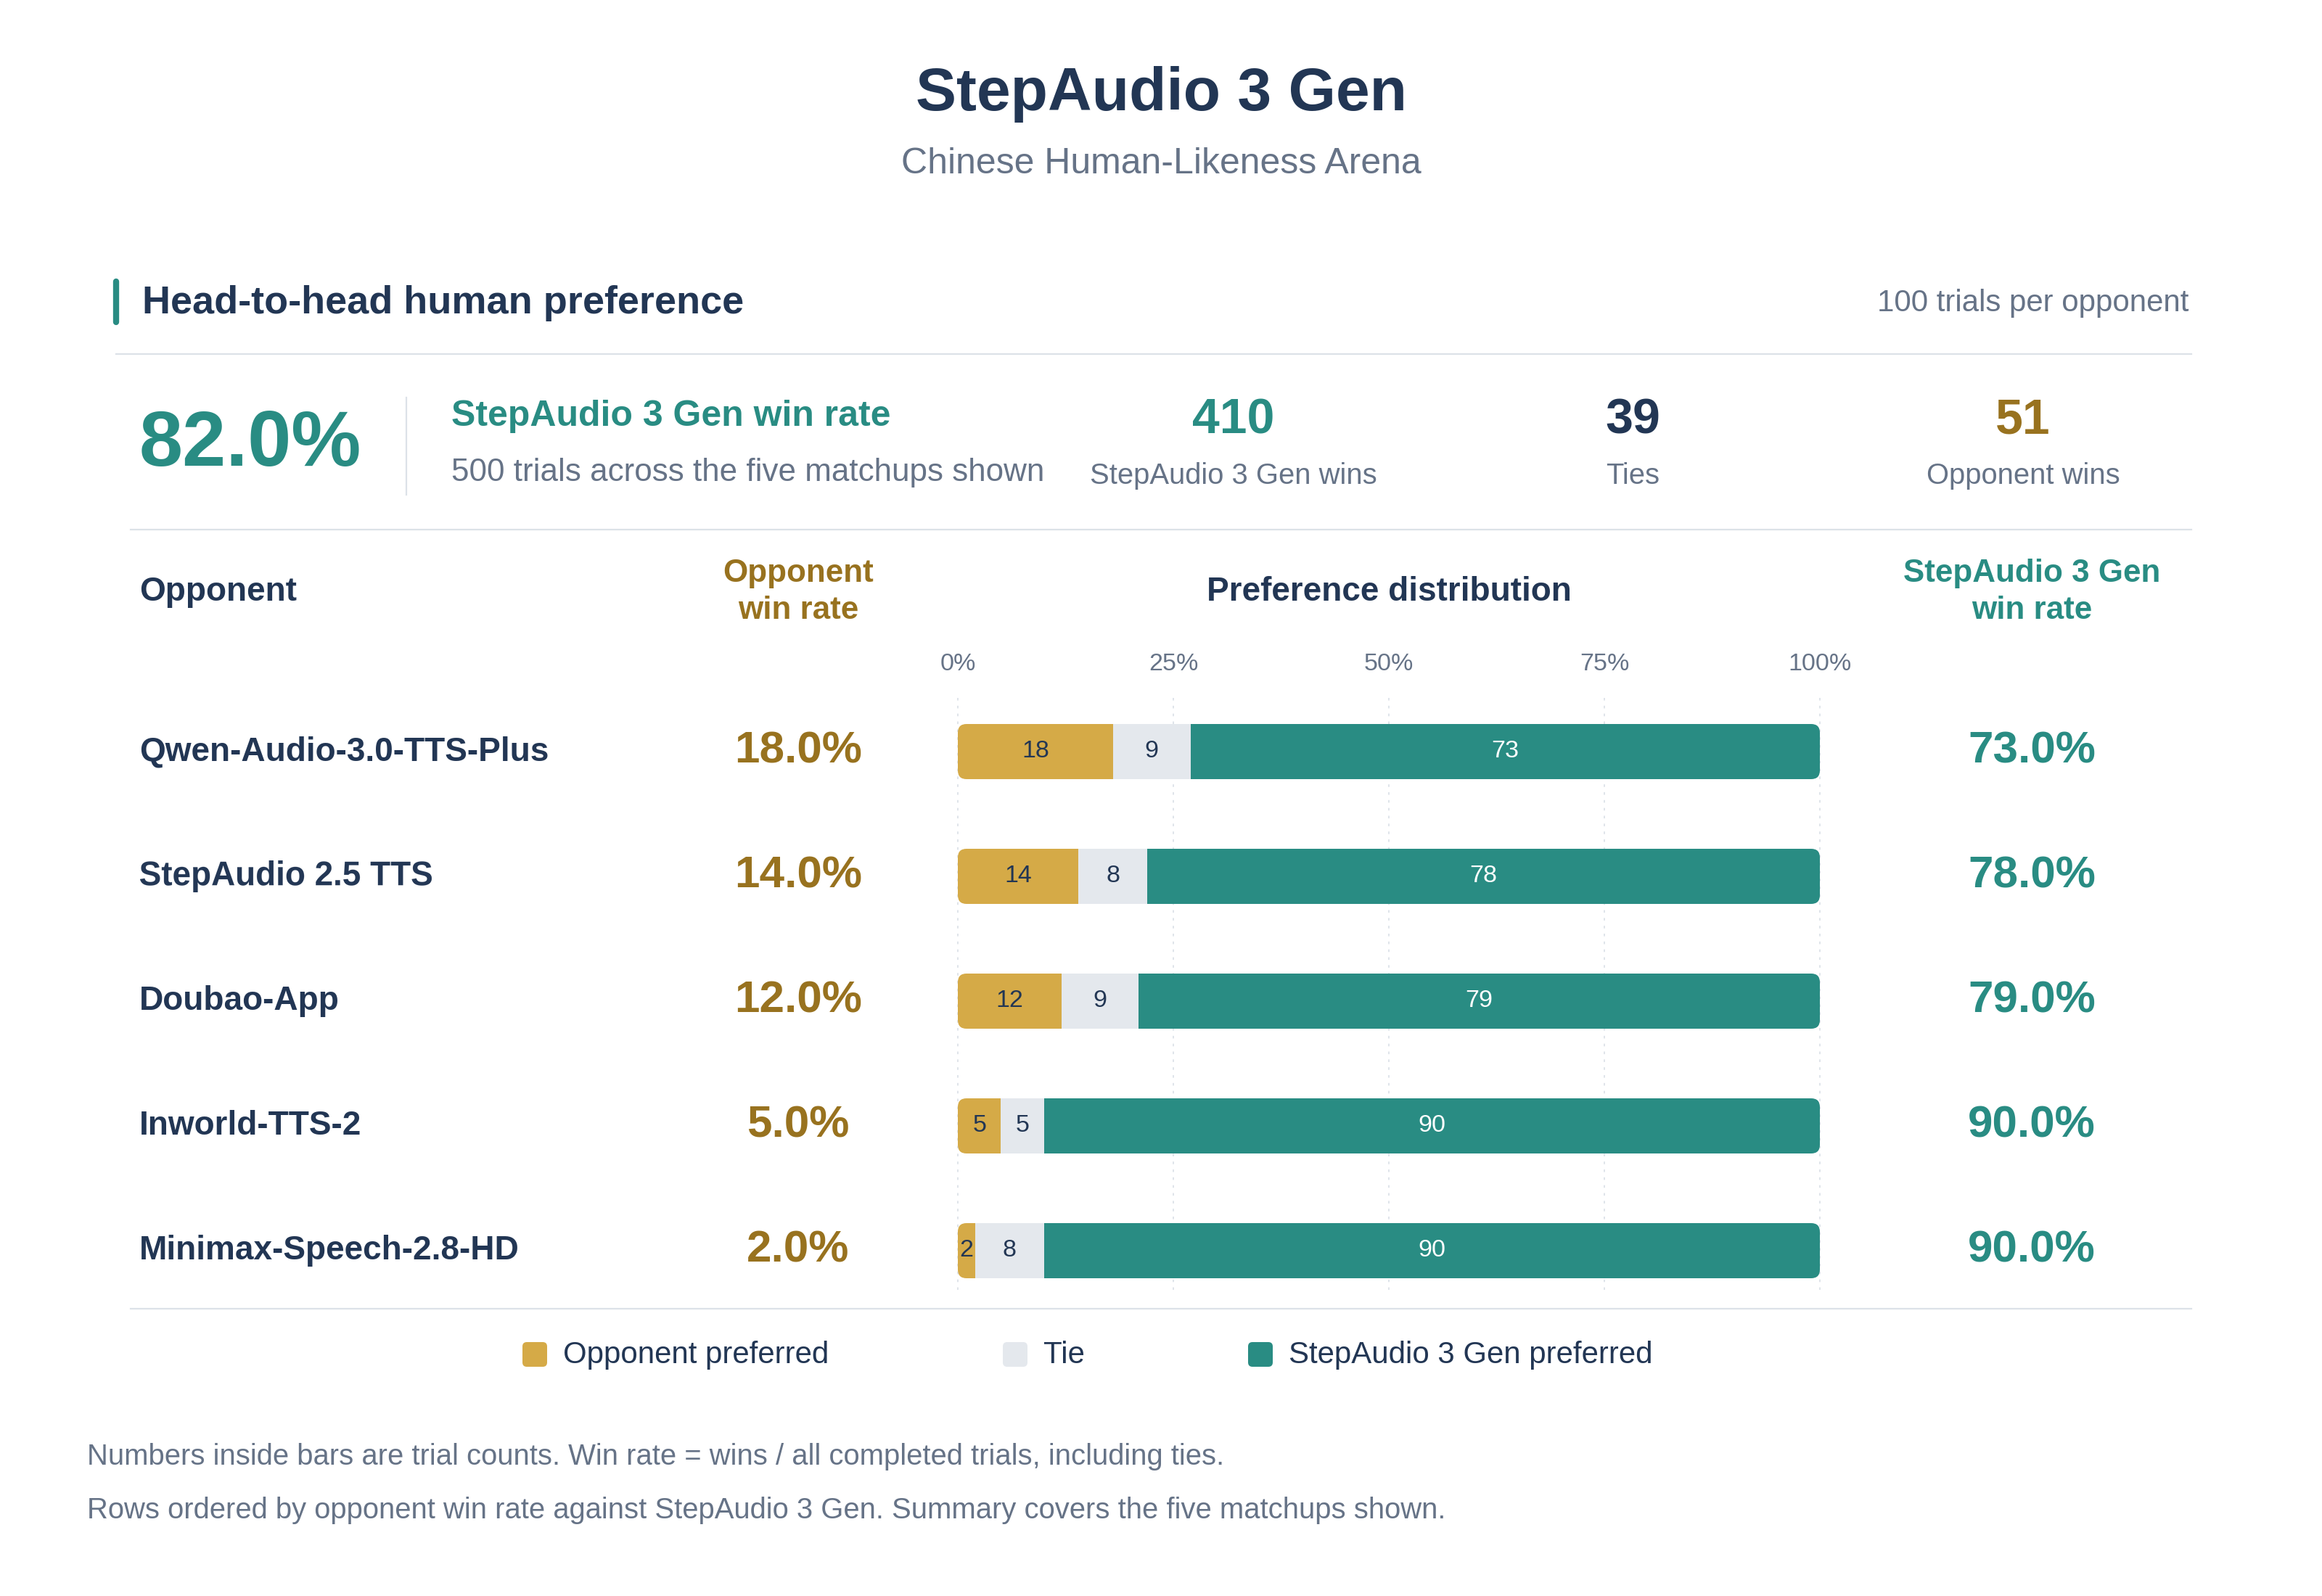
- StepAudio 3 Gen 1,755.3,比第二名 Qwen-Audio-3.0-TTS-Plus(1,544.3)高 211.1 分;
- 对五个商业系统的直接对比,总胜率 82.0%,单场从 73.0%(对 Qwen-Audio-3.0-TTS-Plus)到 90.0%(对 Inworld-TTS-2 和 Minimax-Speech-2.8-HD),每一场都是明显多数。
6.4 Voice design:指令遵循 + 盲测偏好双第一
Voice design 用了两个评测。
第一个是 InstructTTSEval 客观基准:2,000 条文本(中英各 1,000),每条在三种指令条件下各生成一遍——APS(声学参数指定,比如直接给音高语速)、DSD(描述性风格指令)、RP(角色扮演),一共 6,000 条音频,由 Gemini 3.1 Pro 判定风格一致性。
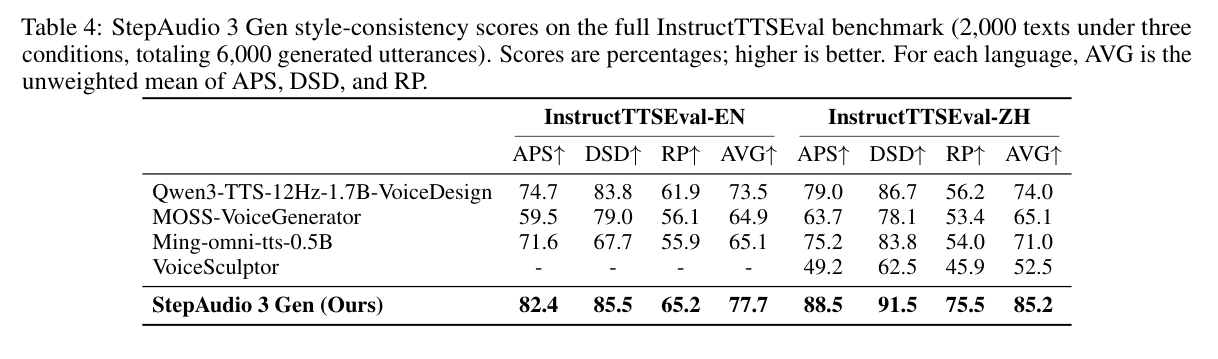
中文 AVG 85.2(APS 88.5 / DSD 91.5 / RP 75.5),英文 AVG 77.7(82.4 / 85.5 / 65.2),中英两边都排第一。三项里 RP 一致最低——角色扮演这类条件本身就最模糊,其它系统更低(Qwen3-TTS 的 RP 中文只有 56.2)。
第二个是盲测人类偏好,490 次中英对比,5 个模型:
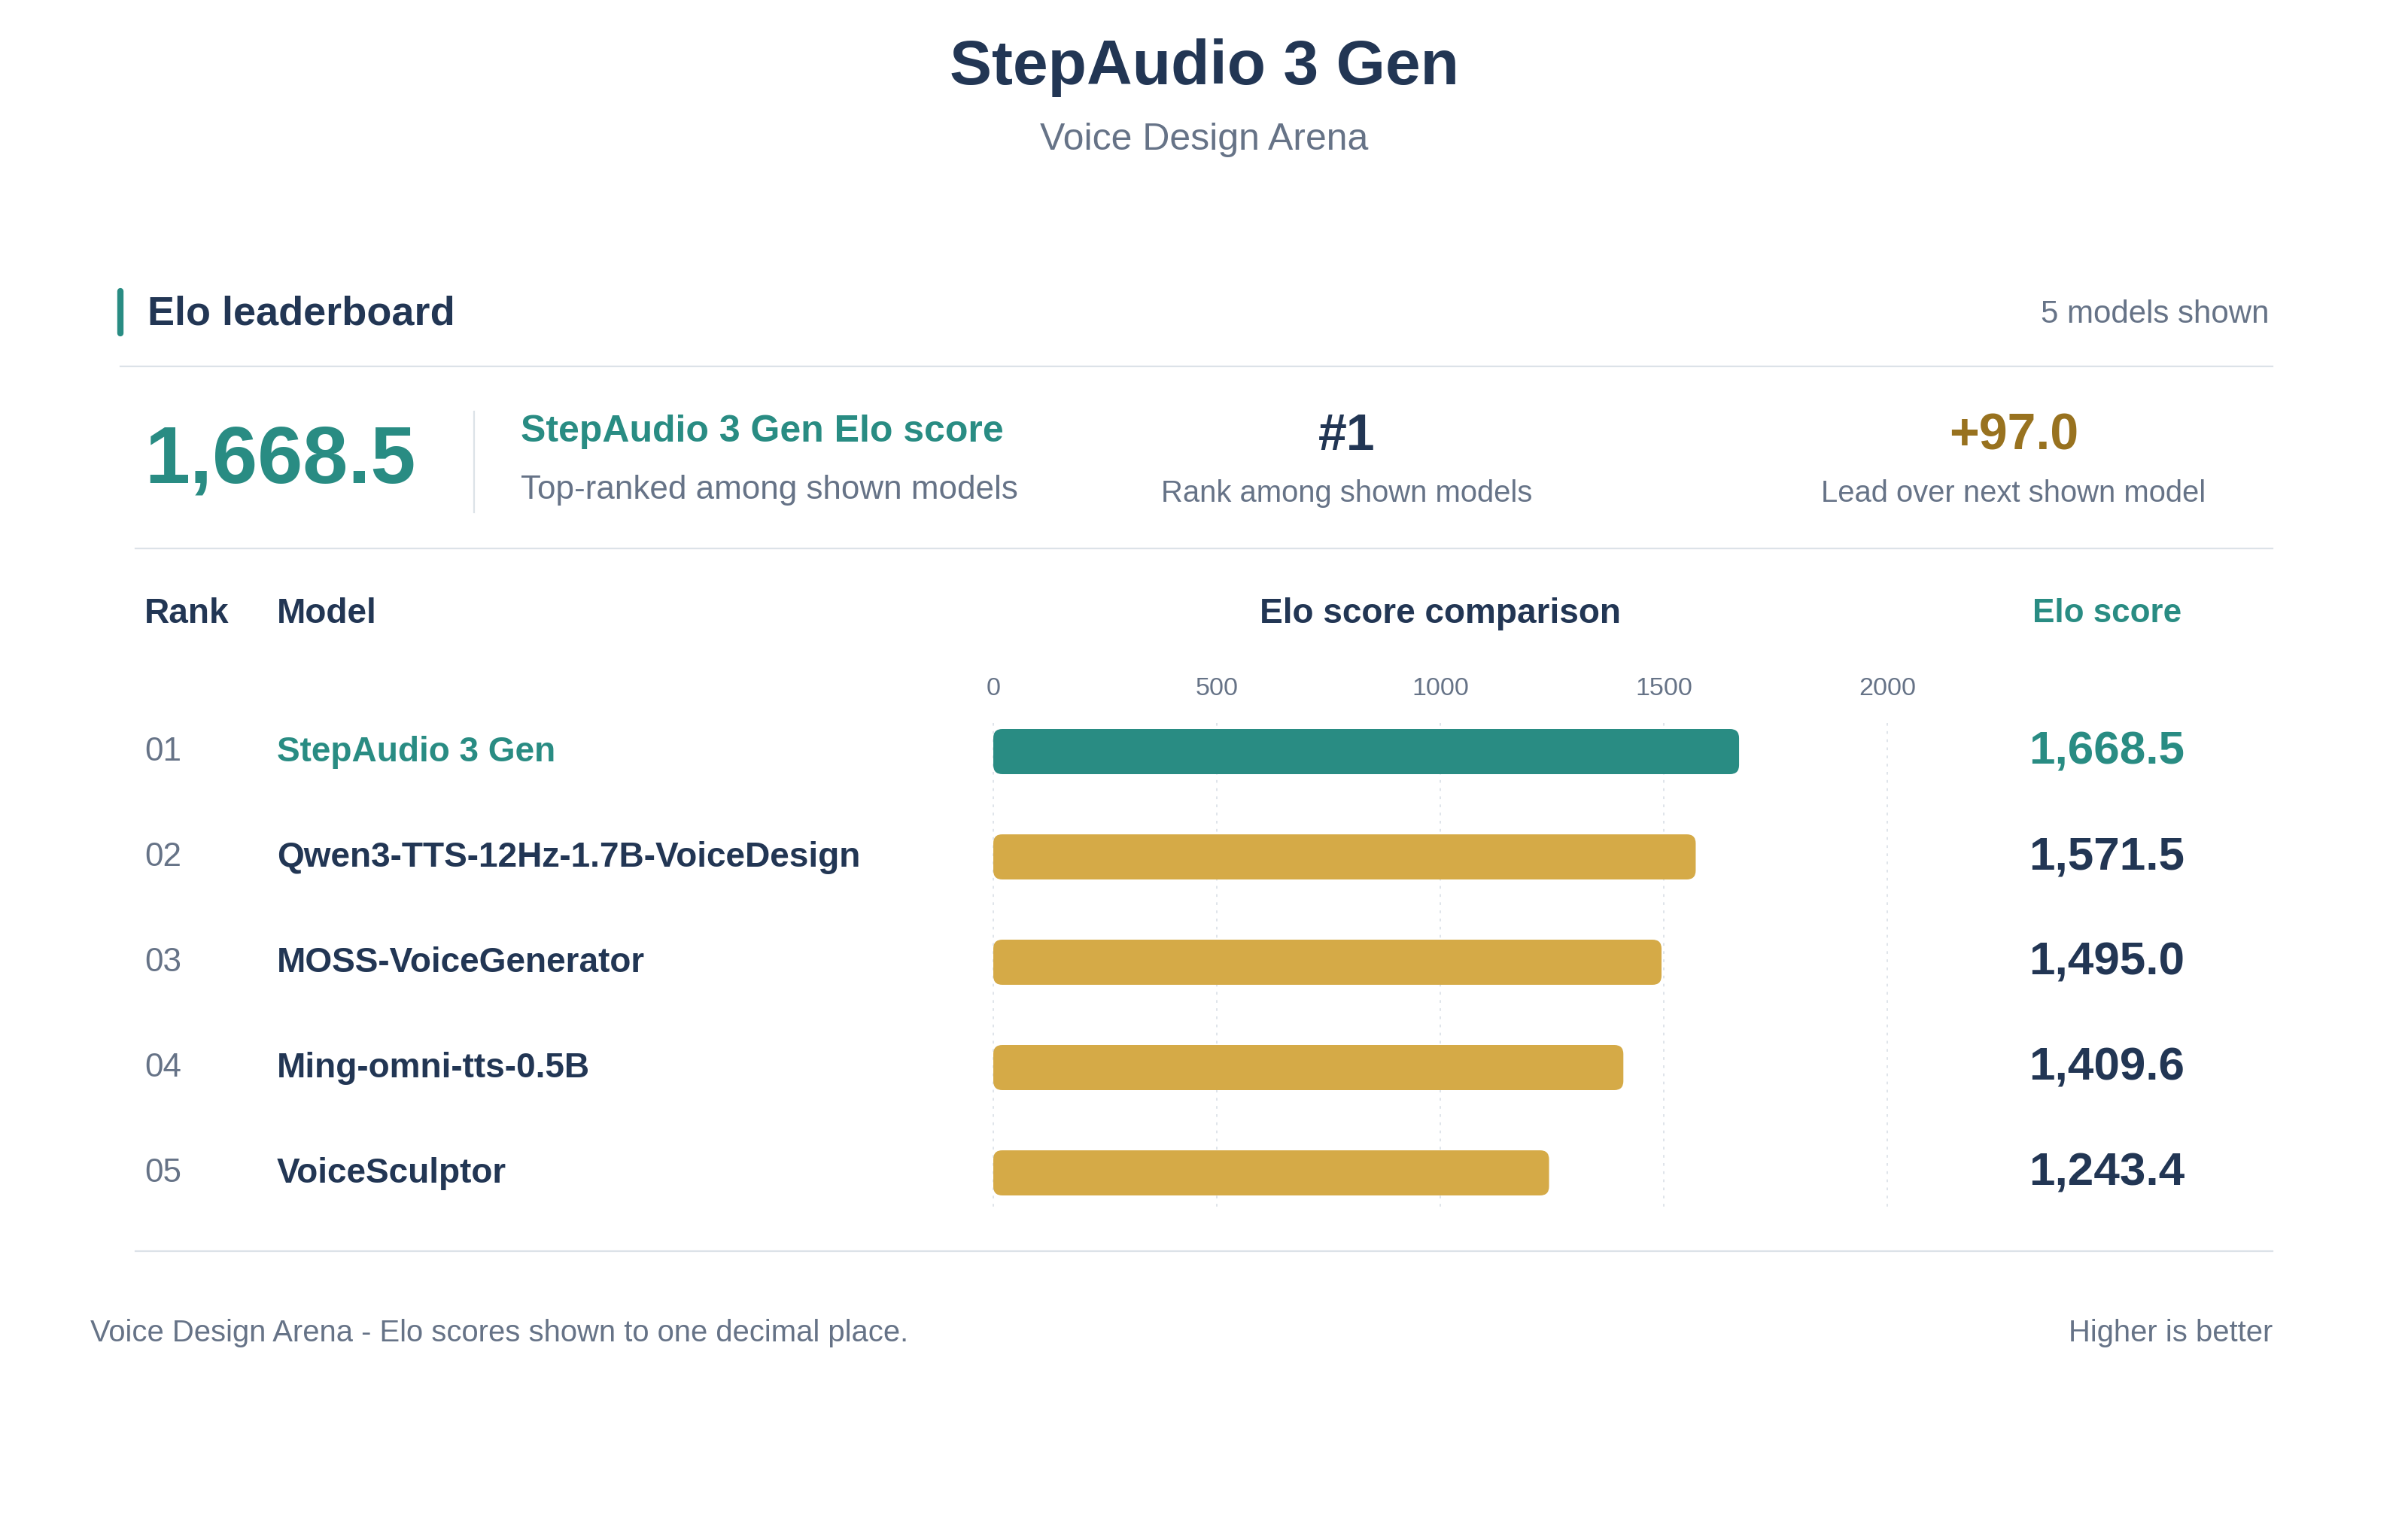
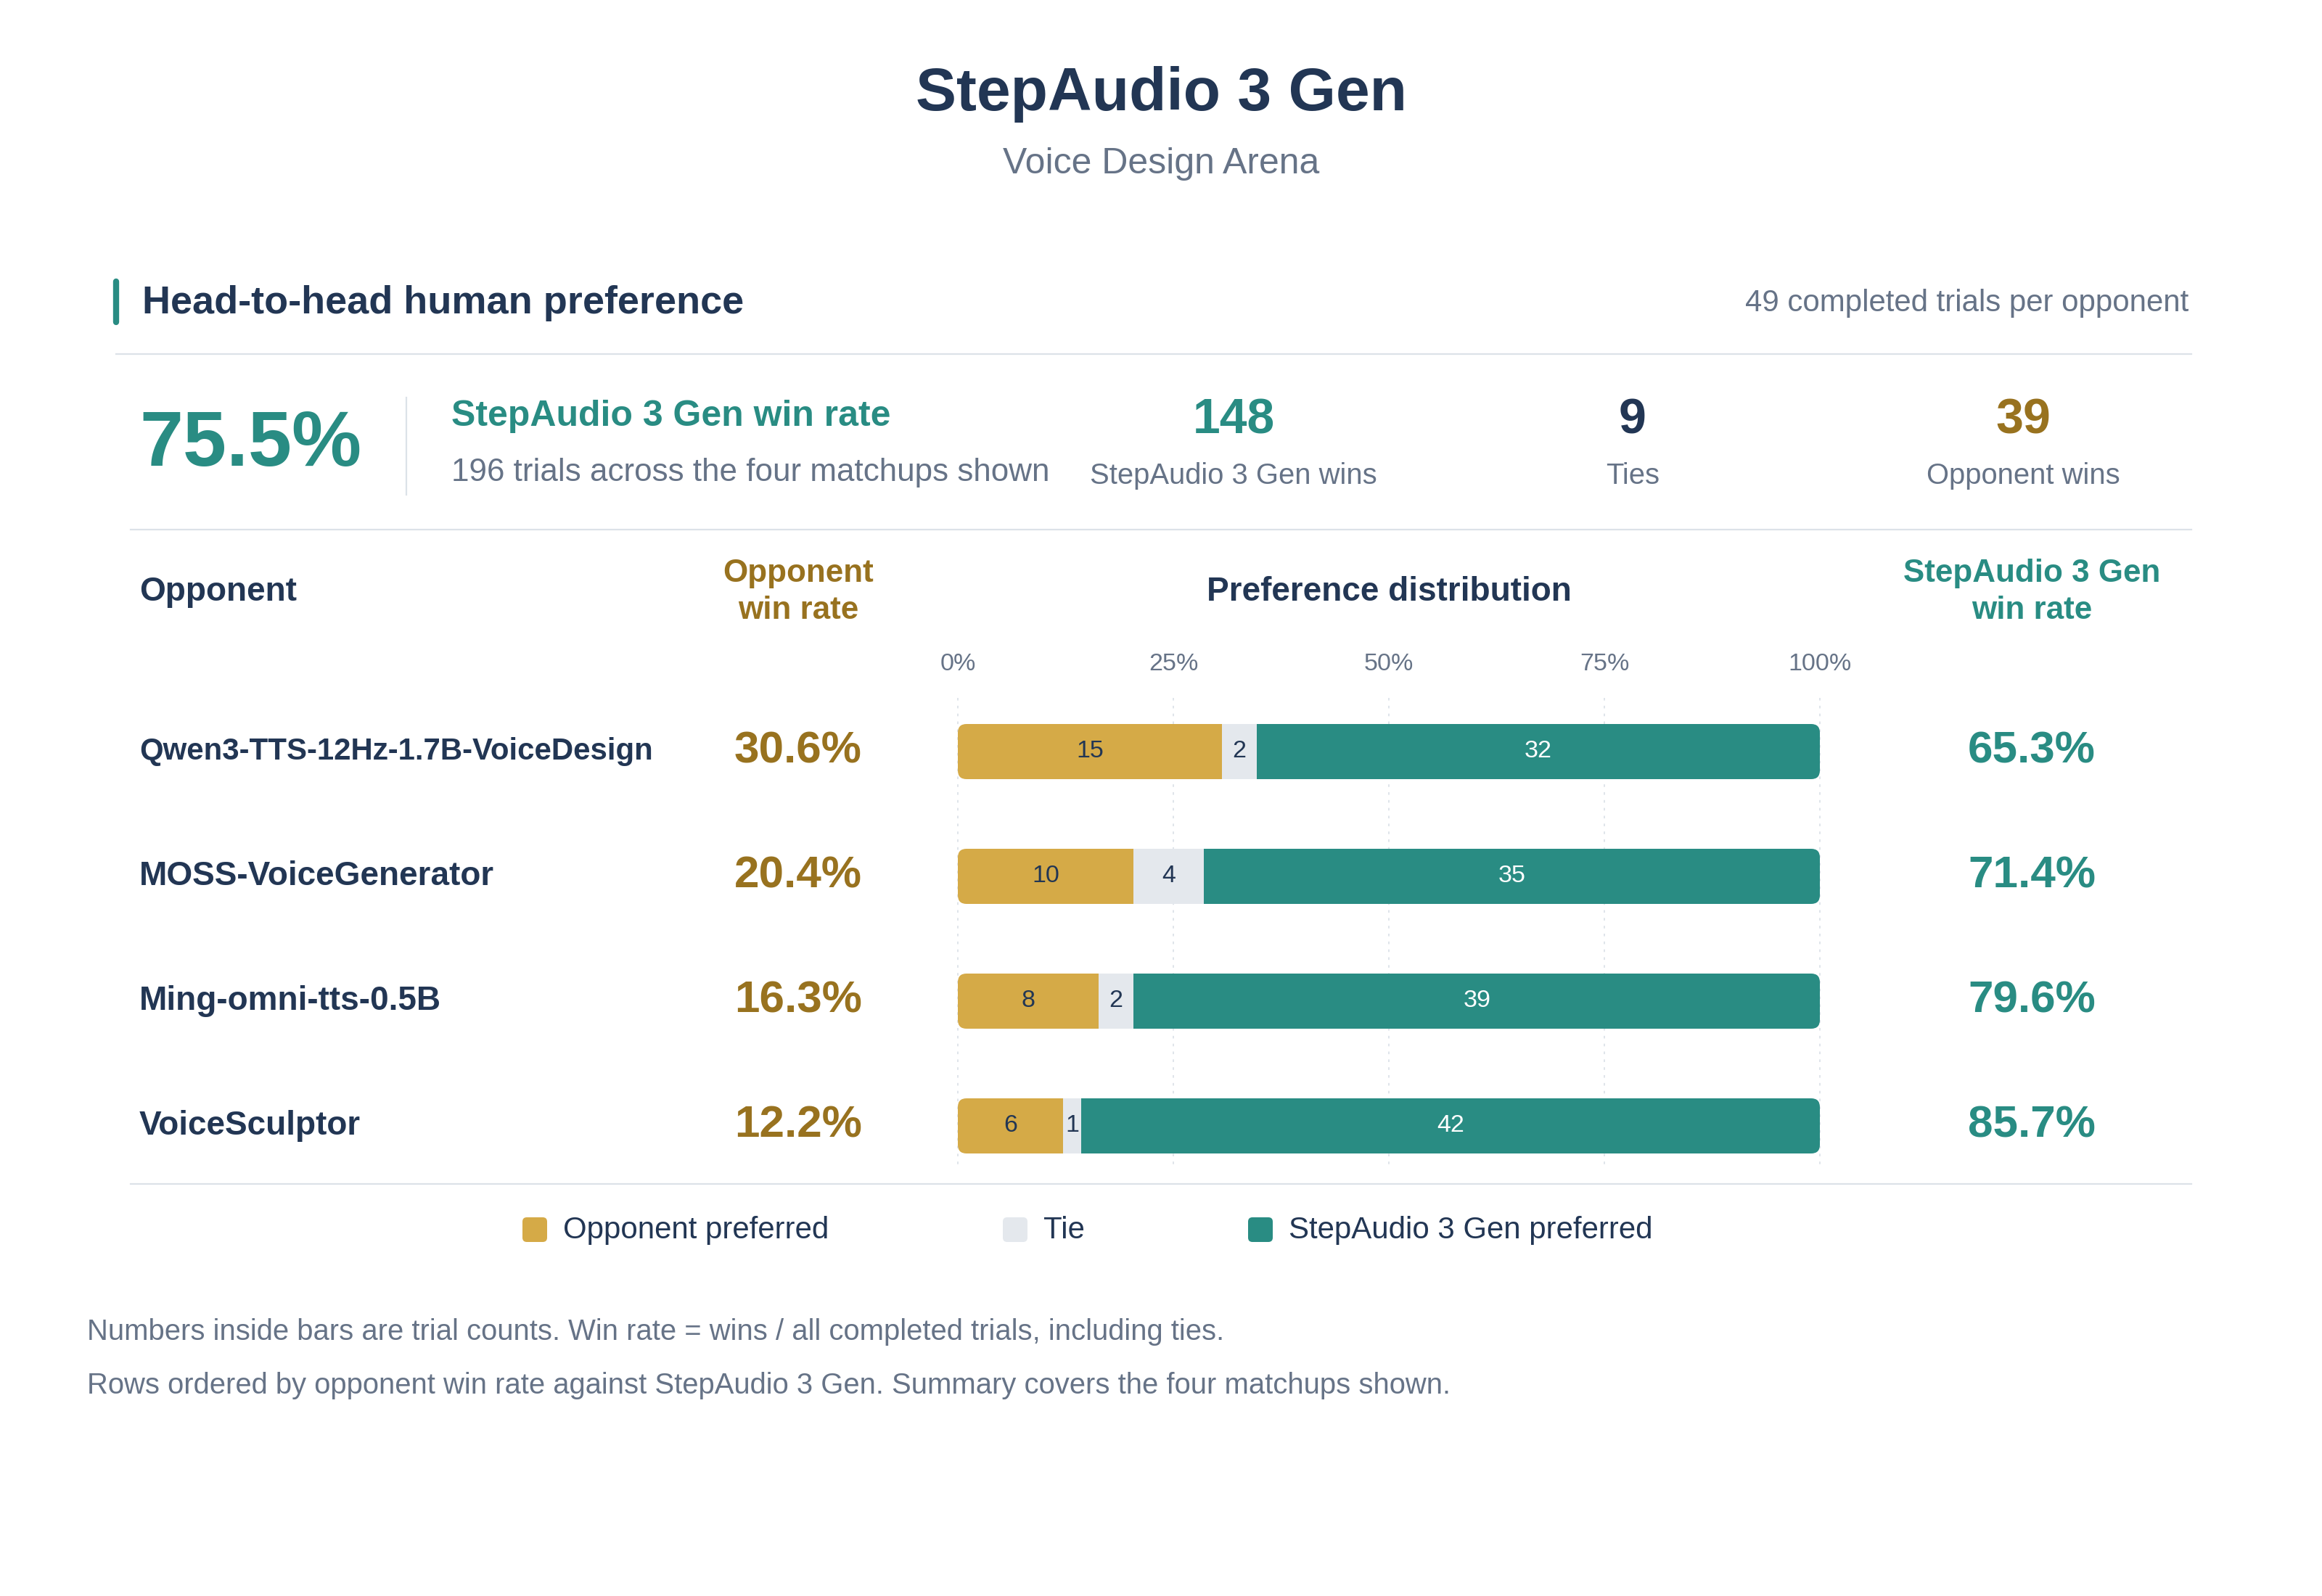
Elo 1,668.5 排第一,领先 Qwen3-TTS-12Hz-1.7B-VoiceDesign(1,571.5)97 分;总胜率 75.5%,单场 65.3%–85.7%。
7. 几点评述
第一,这篇真正的贡献是那套”隔离”思路,不是某个模块。
RVQ Adaptor 和 4 层 predictor 都不算新东西——time-depth 结构在音频 LLM 里已经用了好几年。真正少见的是把”加一个新模态会怎么伤害已有能力”这件事拆成两条具体路径、给每条配一个机制、再排成时间课程。零初始化 adaptor 管表征、50% text replay 管分布、detach + λ 管梯度量级——三个动作各自对应一个可诊断的问题,而不是笼统地”加个 LoRA 保一下”。
而且这套设计前后是自洽的:$\mathcal{L}_{\mathrm{sp}}$ 求和而非平均这件事,在 Stage 3 是必须 detach 的理由,在 Stage 4 是必须降 λ 的理由。全文的两处关键决策,都是从”损失量级天然失衡”这一个小小的事实推出来的。这种”从一个实现细节贯穿到底”的一致性,是读技术报告时最值得学的地方。
第二,TTS 评测从客观指标转向主观 Arena,这个方向是对的。
CER 和 SS 之所以流行,是因为它们便宜、可复现、能自动跑。但它们测的是”内容对不对”和”音色像不像”,而不是”听起来像不像人”。而通用音频模型发展到现在,剩下的差距恰恰主要在 CER 量不到的地方——韵律、节奏、呼吸、犹豫、什么时候该停顿。这篇选择用 Elo 和胜率来汇报,虽然主观、难复核,但至少测的是他们真正想优化的东西。它敢这么报,也是因为它赢得很明显(82% 胜率不是靠运气)。
第三,通用音频模型的门槛,已经从”模型架构”转移到了”数据构造流水线”。
把第 4 节的数据流水线再回顾一遍:TTS 数据要先用自家的 captioning 模型筛、再用自家的副语言 ASR 校验;speech→vocal 要用自家的 TTS 和 SVC 造伪配对,再用 Audiobox Aesthetics 和 SingMOS 三重筛;音乐数据直接用自家的音乐生成模型造;音效混合场景要靠文本 LLM 去补场景脚本。每一类数据的产出,都依赖另外几个已经训练好的模型。
这不是 StepFun 一家的特例,而是这个方向现在的普遍形态。它的含义是:一个团队想做通用音频生成,光有算力和架构不够,你还得先有一整套能互相当”数据生成器”的模型资产。这也直接解释了为什么这份报告里”数据”那一节的篇幅几乎和”训练”一样长。
第四,时间轴和深度轴的”权责划分”值得琢磨。
让 LLM 只管 c0,看起来是”降低了 LLM 的职责”,但换回来的是三件事:序列长度不膨胀、预训练的语言能力不被 15 层残差损失冲垮、以及 predictor 可以独立训练和独立 detach。在一个已经很重的 backbone 旁边加一个轻量、可隔离、可单独调度的模块,这个模式在别的模态扩展场景里大概率也能复用。
8. 局限
说几个报告里没解决、或者没说的:
- backbone 的规模完全没披露。 全文只给了 batch size、学习率、序列长度和 λ,没有一个字提参数量、层数、hidden 维度。作为一份技术报告,这个信息缺口比较大——你没法从这篇里学到”这套配方在不同规模的 LM 上是否同样有效”,而这恰恰是做多模态扩展时最关心的 scaling 问题。
- 数据构造的可复现性接近零。 前面说了,TTS captioning 用 StepAudio R1.5、副语言转写用自家 ASR、音乐数据用 StepAudio Music Model、音色筛选用 Audiobox 和 SingMOS。这套链条里除了 Audiobox 和 SingMOS,其余都是内部模型。外部团队能复现的只有”设计思路”,复现不了”数据”。
- 主观评测是自家的池子和流程。 Arena 式评测的评测集、评者构成、判定规则都会影响结果。1,500 次比较听起来不少,但对比的五个商业系统每家只用了一个音色——对 TTS 这种强依赖音色的任务,单音色对比的结论外推时要谨慎。
- 客观指标基本空缺。 只报主观 Elo 和胜率,一个 CER / SS / 相似度数字都没有。这在”强调人味”的框架下可以理解,但读者没法判断内容准确性上有没有代价——比如为了更自然的韵律,有没有牺牲字准。
- “通用”的覆盖面报得不均匀。 音乐只说了”能生成超过 60 秒、保持结构和风格一致”,没有和音乐专用模型做任何对比;音效、歌声、vibe speech 也都只有能力描述没有量化评测。相比之下 TTS 和 voice design 的评测完整得多。所以”general audio”这个说法目前更像是一个统一框架的存在性证明,而不是”在每个子领域都能打”的证明。
9. 总结
StepAudio 3 Gen 的核心思路可以压缩成一句话:用一套 12.5 Hz、16 层 codebook 的共享 RVQ 表征把语音、歌声、音乐、音效统一起来,然后让 LLM 管时间轴上的语义决策、让一个 4 层小 Transformer 管帧内的声学残差,整套生成过程完全在离散 token 空间里完成,不碰 diffusion。
它之所以能把结果做到这个水平,靠的不是某一个模块的新意,而是两件事的配合:
结构上,把”语义密集的 c0”和”声学密集的 c1–c15”分到两根轴、两个模块上,让 LLM 可以既参与音频生成、又不必承受全部声学损失;输入侧用零初始化的 RVQ Adaptor 把多 codebook 表征平滑地接进预训练 embedding 空间。
训练上,把”加新模态会伤害已有能力”拆成表征和目标两条路径,配三个机制(adaptor / 50% text replay / detach + λ),再排成四阶段课程。效果上,文本基准不是”少掉”,而是 MMLU +4.2、GSM8K +6.1、HumanEval +6.7 的全面反超。
要挑刺的话,信息透明度是这份报告最大的短板——模型规模不披露、数据链条不可复现、客观指标空缺。但就”离散自回归能不能撑起通用音频生成”这个问题而言,它给了一个相当有力的肯定答案:在 TTS 和 voice design 上,纯离散 token 的路线已经能在盲测里赢过一堆走连续 latent + diffusion 的商业系统。
参考资料
- StepAudio 3 Gen Technical Report(StepFun-Audio Team)— arXiv:2609.12945
- 试听样例 — stepaudiollm.github.io/step-audio-3-gen
- X-Codec: 语义 / 声学联合量化的音频 codec 系列工作(StepAudio Tokenizer 的路线参考)
- MusicGen(Copet et al., 2023)— delayed pattern 多流码本建模的代表
- DAPO: 动态采样思路的来源,本文用它滤掉低区分度的 GRPO 组
- Audiobox Aesthetics — PQ(Production Quality)/ CE(Content Enjoyment)打分模型
顺带扯一句题外话。这篇里有个初读时容易愣一下的小设计:RVQ 是”第一层粗量化、后面每层补上一层没还原出来的残差”,而书里讲 LLM 压缩时聊到的量化(把权重从 FP16 压到 INT8 / INT4),数学动作其实是同一族的——都是”用有限的离散候选去逼近一个连续量,然后逐层 / 逐通道补偿误差”。方向完全不同(一个是输入的表征、一个是权重的存储),但看 RVQ 的残差补偿那几行时,如果刚翻过量化那部分,会觉得挺熟。
另外第 5 节那套”先冻结对齐、再逐步放开、最后联合 cool-down”的课程,和书里 NAS 搜索策略那部分讲的 warm start、渐进式搜索空间放宽,也是同一种工程直觉在起作用:一次只放开一个自由度。我们把手头关于 AutoML / NAS 和大模型压缩的积累整理成了《动手学 AutoML:从 NAS 到大语言模型优化实战》,上面这两块对应的章节里都有,感兴趣可以翻翻。
