ICLR'26 | FastMix 把预训练数据配比搜索从 720 GPU 小时干到 1.3 小时
ICLR’26 | FastMix 把预训练数据配比搜索从 720 GPU 小时干到 1.3 小时
原文:FastMix: Fast Data Mixture Optimization via Gradient Descent(ICLR 2026,HKU × 腾讯混元 × 港中文) 代码:github.com/hrtan/fastmix
1. 前言:预训练剧本里,唯一靠拍脑袋写的那一行
训练一个大语言模型,配置表里大部分内容都是有章法的:模型架构抄主流、学习率照着 scaling law 推、batch size 看显存。只有一样东西基本靠经验——数据配比。
想象一下你手里有 17 个数据源(The Pile 就是 17 个无版权子集,代码、数学、书籍、百科、论坛什么都有),每个都可能有用,但也显然不能等权。于是你在配置里写下:
OpenWebText2: 0.30
Books3:       0.08
ArXiv:        0.12
PtB:          0.03
...
这些数字从哪来?绝大多数时候是「上一轮实验调出来的 + 看别人论文里抄的 + 感觉」。问题是:调一次配比 = 完整预训练一遍。当一次预训练要几万 GPU 小时的时候,试错成本高到离谱。而这个数字恰恰又是「决定模型最终水平」的关键变量之一——同样的算力,配比选好了,下游分数肉眼可见地涨。
所以这个问题很本质:
能不能用很小的代价,自动找到(接近)最优的数据配比?
这正是 FastMix 这篇 ICLR 2026 论文解决的问题。它把配比搜索的时间成本从 RegMix 的 720 GPU 小时压到 1.3 GPU 小时(约 550 倍),同时下游平均分还更高。这篇文章除了拆 FastMix 本身,我更想先带大家把「现在都有哪些做法」梳理一遍——因为不站在这个脉络上,你很难理解 FastMix 的巧妙之处。
2. 先把问题写清楚:一个双层优化
设数据源集合 $D_1, \dots, D_k$,配比 $\alpha$ 位于概率单纯形上(各分量非负且和为 1)。数据配比问题可以形式化为:
\[\min_{\alpha}\; \mathcal{L}_{\text{target}}\big(w^*(\alpha)\big) \quad \text{s.t.} \quad w^*(\alpha) = \arg\min_{w}\; \sum_{i=1}^{k} \alpha_i\, \mathcal{L}_{\text{train}}(D_i, w)\]内层:给定配比,把模型训到最优;外层:调整配比,让验证集或下游任务目标最小。这是个标准的双层优化(bilevel optimization)结构。
所有方法其实都在这张图上做文章,区别只在两点:
- 内层的「$w^*$」怎么逼近——训一个小代理模型?还是训练过程中在线估计?
- 外层的「$\min_\alpha$」怎么搜——网格?回归?贝叶斯?梯度?
而卡住「直接用梯度优化」的,正是 $\alpha$ 本身:它是采样概率,采样是离散算子,不可微。理解这一点是读懂全部工作的钥匙——FastMix 的全部魔法,就是从「让 $\alpha$ 可微」开始的。
3. 现有方法地图:两条主线、四代人
3.1 派系划分:静态 vs 动态
先给一张地图。数据配比方法大概分两派:
- 静态派(先搜索、后训练):正式训练前,先用小模型(代理模型)或拟合函数把配比定下来,再一次性按这个配比训练大模型。DoReMi、RegMix、CLIMB、配比定律(Data Mixing Laws)都属于这一派。
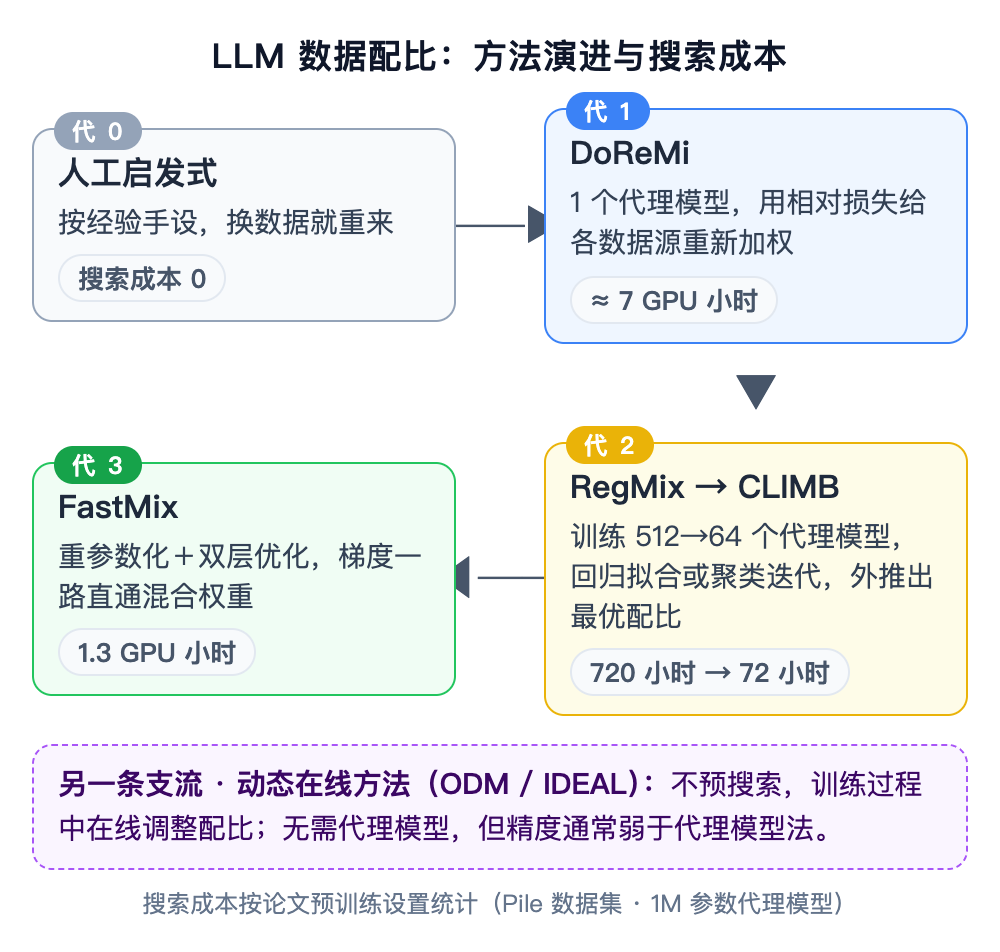
- 动态派(训练中调整):不预搜索,训练过程中根据当前模型状态在线更新配比,代表是 ODM 和 IDEAL。优点是不需要代理模型、自适应;缺点是容易不稳定,论文实验里动态派通常打不过静态派。
3.2 静态派的进化:从 0 个代理到 512 个代理,再回到 1 个代理
代 0:人工启发式(Human Heuristic)。 就是开头那行配置。零成本,但换数据集就重来,而且没人知道离最优有多远。
代 1:单代理模型 + 相对损失(DoReMi, 2024)。 思路:先拿一个「参考模型」,再看代理模型在各个数据源上的损失相对参考模型有多大——比值大说明这个域「还没学好、还有得学」,应该多采样。DoReMi 用这个比值重加权得到配比,再去训练大模型。它的哲学很朴素:用「相对损失」当「该域还有多少可学」的代理信号。在 FastMix 的预训练设置下搜索成本 7.4 GPU 小时。优点:只要 1 个代理模型,便宜;缺点:信号间接——「还没学好」不等于「学好了对下游有用」,容易把噪声大的域拉高。
代 2:多代理模型 + 回归外推(RegMix, 2024)。 RegMix 的做法更「暴力」:训练 512 个不同配比下的代理模型,得到 512 个「配比 → 最终损失」的数据点,拟合一个回归器,再在回归器上做优化,外推出最优配比。它把配比问题整个当成黑盒函数优化来做。缺点很明显:512 个代理模型 = 720.5 GPU 小时;而且「拟合曲面再采点」这个范式,拟合不准就全盘皆输。
代 2.5:聚类迭代缩搜(CLIMB, 2025)。 CLIMB 是对 RegMix 的工程化改进:不一次性均匀撒 512 个点,而是先粗搜 → 聚类 → 缩小搜索区域 → 迭代细化。代理模型数量降到 64 个,搜索成本降到 71.9 GPU 小时。成本降了一个数量级,但「要多训不少代理模型」的本质没变,聚类迭代本身也引入了自己的超参。
(这里还有一条并行的支线:配比定律(Data Mixing Laws)。DMLaw、Ge et al. 等人的工作尝试拟合「配比 → 损失」的解析函数,并利用小模型上拟合出的参数外推到大模型。它和 RegMix 共享「拟合」哲学,但目的更偏向「预测/外推」而非搜索。这条线为代理模型方法提供了理论基础:小模型上找到的最优配比,可以迁移到大模型——否则「用 1M 参数的代理模型替 70B 模型做决定」这件事本身就站不住脚。)
代 3:梯度直通(FastMix, ICLR 2026)。 到这里思路变了:不再「外面套一层搜索」,而是把配比本身变成可学习参数,让梯度一路从验证目标传到配比上。只需要 1 个代理模型,1.3 GPU 小时。这就是本文主角,下一节细说。
3.3 动态派:ODM 与 IDEAL
- ODM(Albalak et al., 2023):训练过程中在线调整数据混合比例,思路更接近课程学习。
- IDEAL(Ming et al., 2025):用影响函数(influence function)估计每个数据源对下游性能的贡献,动态重平衡训练数据。
影响函数本身是漂亮的想法——用二阶信息估计「把某个样本的权重微调 $\varepsilon$,验证损失会变多少」——但工程上贵且数值不稳定。记住这一点,后面 FastMix 的闭式梯度会和它有个有意思的对照。
3.4 一张表 + 一张图
| 方法 | 核心思路 | 代理模型数 | 搜索成本(预训练) | 主要短板 |
|---|---|---|---|---|
| 人工启发式 | 手工设定 | 0 | 0 | 不可迁移,无最优性保证 |
| DoReMi | 相对损失重加权 | 1 | 7.4h | 信号间接,易放大噪声域 |
| RegMix | 拟合「配比→损失」曲面再外推 | 512 | 720.5h | 代理模型太多,拟合误差 |
| CLIMB | 聚类迭代缩小搜索空间 | 64 | 71.9h | 代价仍大,超参多 |
| ODM / IDEAL | 训练中在线调整 | 0 | — | 不稳定,精度通常弱于静态派 |
| FastMix | 重参数化 + 双层优化,梯度直通 | 1 | 1.3h | $n_2=1$ 偏贪婪,对噪声敏感 |
(成本数字对应 FastMix 论文的预训练设置:Pile 数据集、1M 参数代理模型、最多 1B token 搜索预算。)
3.5 脉络总结
把上面串起来,能看到两条清晰的线:
第一条线:怎么用更小的代价「试」配比? 答案是代理模型——用 1M 参数的小模型替大模型试错。这条线的尽头是 RegMix/CLIMB 的「多代理 + 回归」:把配比搜索当黑盒,用采样换信息。
第二条线:怎么让配比「自己学习」? 这是更本质的追求:把 $\alpha$ 从「要被搜索的离散量」变成「可以被梯度优化的连续量」。FastMix 的贡献就是打通了这条线。
有趣的是,第二条线的成功恰恰缓解了第一条线的焦虑:当配比可以用 1 个代理模型 + 梯度直接优化时,「多训几个代理模型来拟合曲面」就变得没有必要了。
4. FastMix 的原理
4.1 核心一招:重参数化,把「采样概率」变成「损失权重」
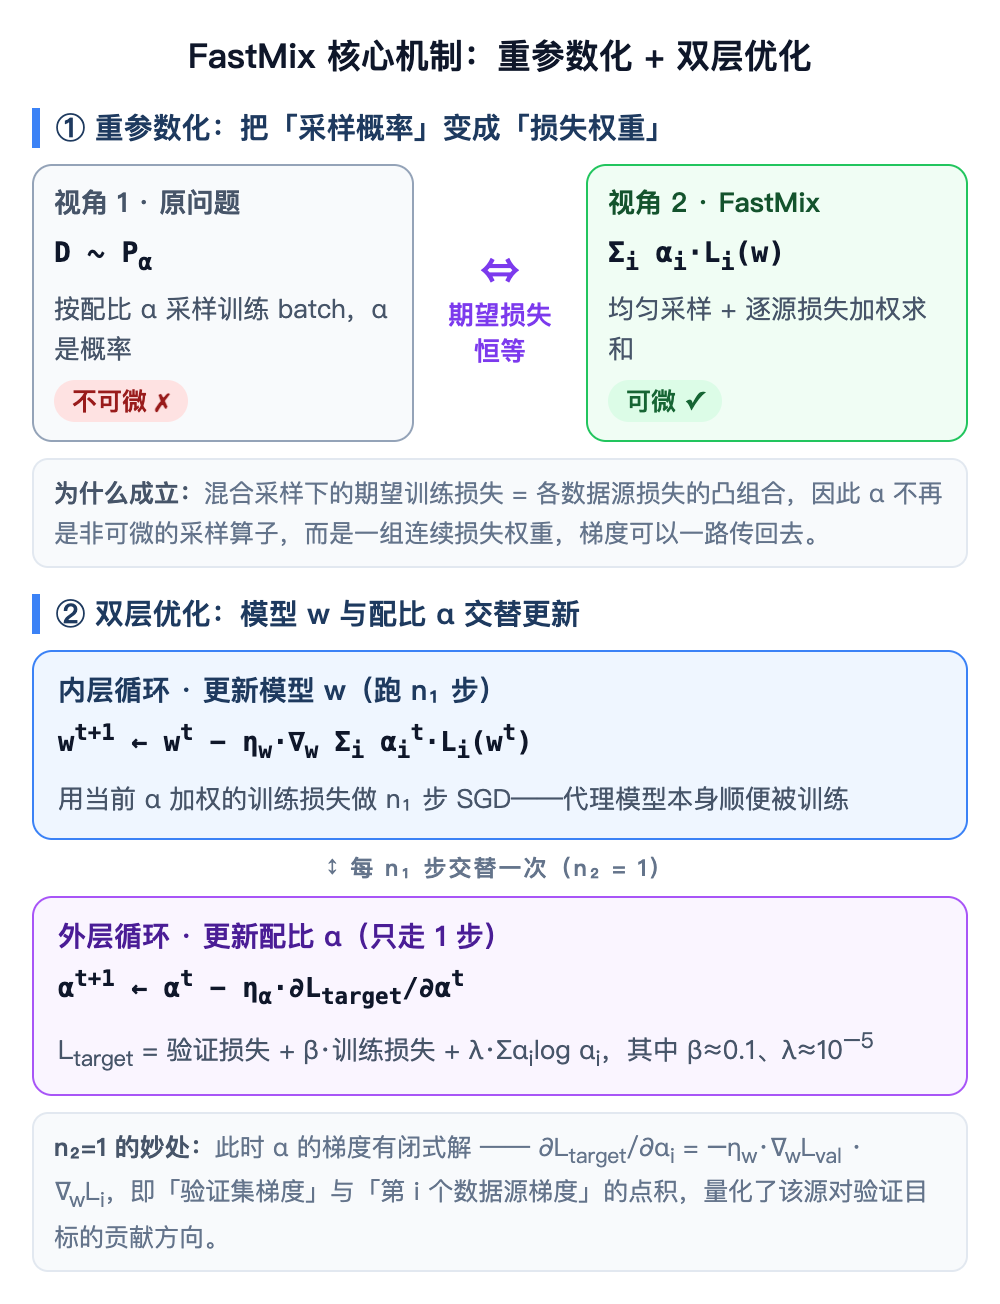
FastMix 全部工作的起点是一个看似平淡的数学观察:混合采样下,期望训练损失 = 各数据源损失的凸组合,即
\[\mathbb{E}\big[\mathcal{L}_{\text{train}}(D, w \mid \alpha)\big] = \sum_{i=1}^{k} \alpha_i\, \mathcal{L}_{\text{train}}(D_i, w)\]这个恒等式意味着什么?意味着我们不需要真的「按 $\alpha$ 采样」来训练——可以在每个 batch 里均匀采样各源数据,然后按 $\alpha$ 对损失加权。而一旦切换到这个视角,$\alpha$ 的语义也变了:它不再是采样概率,而是损失权重。损失加权是可微操作,于是 $\alpha$ 从「不可微的采样算子参数」变成了「完全可微的连续权重」,可以名正言顺地放进任何梯度优化器里。这就是全文最值钱的一步:重参数化(reparameterization)。
这个技巧在架构搜索领域特别眼熟——DARTS 就是把「选哪一个候选操作」的离散 argmax 松弛成 softmax 权重。FastMix 相当于在数据维度上做了一次同样的松弛:把「选哪个数据源」变成「给每个数据源一个连续权重」。
4.2 双层优化:模型 $w$ 与配比 $\alpha$ 交替更新
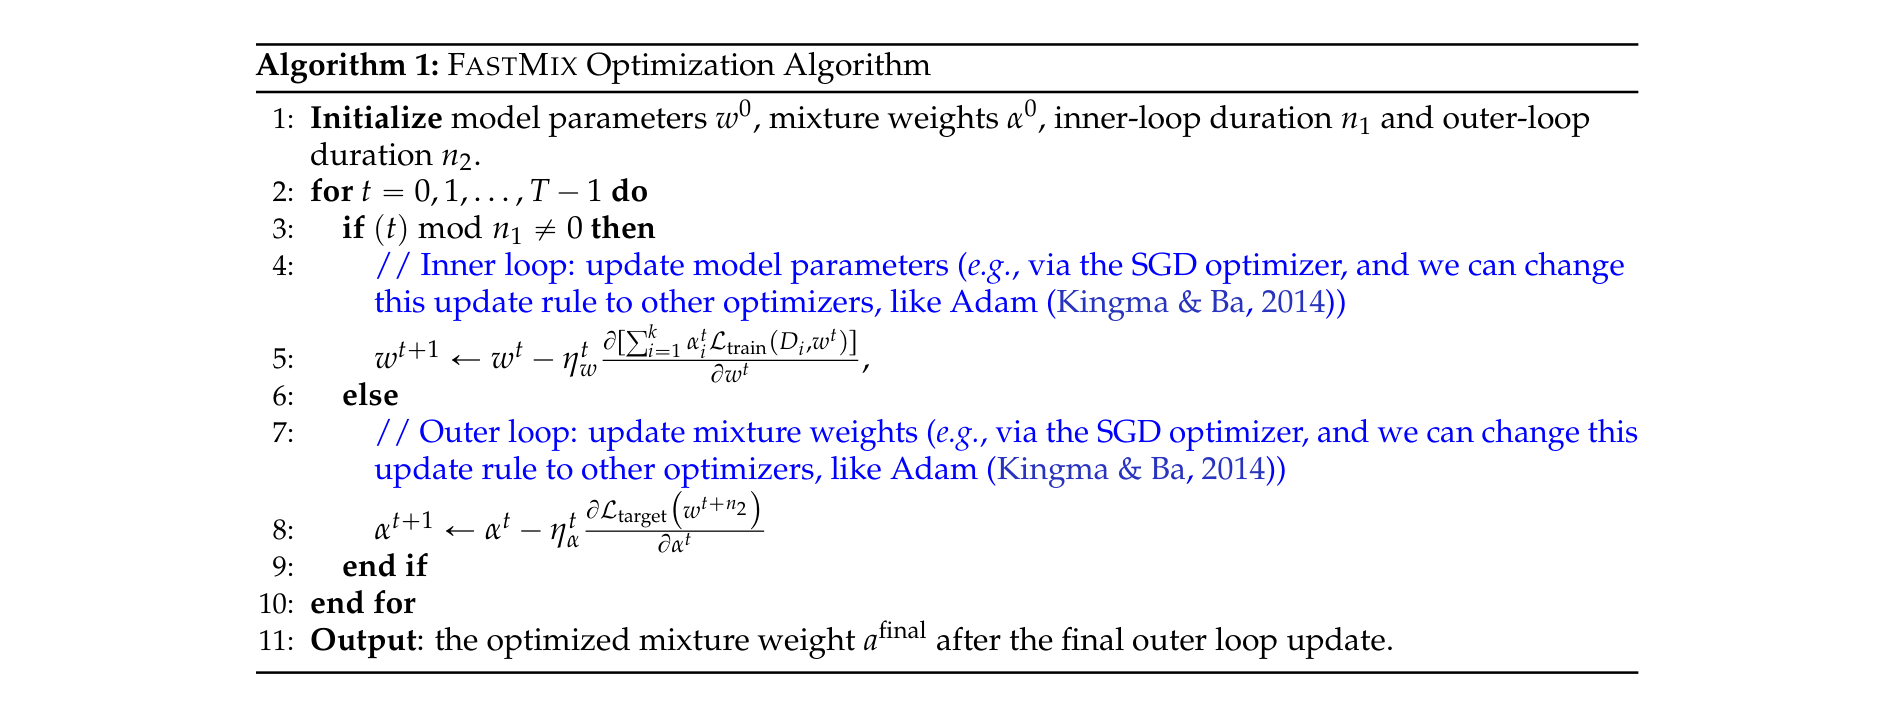
有了可微的 $\alpha$,FastMix 的优化就顺理成章了,完整流程见算法 1:
- 内层循环(跑 $n_1$ 步):固定当前 $\alpha$,用加权损失 $\sum_i \alpha_i\, \mathcal{L}_{\text{train}}(D_i, w)$ 更新模型参数 $w$(SGD)。注意:代理模型并不是单独预训练好的,而是和配比搜索同时训练——它本身就是搜索过程的一部分。
- 外层循环(只走 $n_2 = 1$ 步):固定 $w$,用验证集反馈更新 $\alpha$:
其中搜索目标 $\mathcal{L}_{\text{target}}$ 是三项之和:
\[\mathcal{L}_{\text{target}} = \mathcal{L}_{\text{val}}(w) + \beta\, \mathcal{L}_{\text{train}}(w) + \lambda \sum_{i} \alpha_i \log \alpha_i\]- 第一项是验证损失(或下游任务损失),是主要优化信号;
- 第二项是训练损失,作为辅助目标,减少对有限验证集的依赖(论文里 $\beta \approx 0.1$ 时效果最好);
- 第三项是熵正则化($\lambda \approx 10^{-5}$),防止配比坍缩到少数几个数据源上——只盯着一个源猛采很容易过拟合验证信号。
4.3 最漂亮的一步:$n_2=1$ 时的闭式梯度
如果外层只走一步($n_2 = 1$),$\alpha$ 的梯度有一个非常干净的闭式解:
\[\frac{\partial \mathcal{L}_{\text{target}}}{\partial \alpha_i} = -\eta_w \cdot \nabla_w \mathcal{L}_{\text{val}}(V, w^{t+1}) \cdot \nabla_w \mathcal{L}_{\text{train}}(D_i, w^t)\]翻译成人话:$\alpha_i$ 的更新方向正比于「验证集梯度」和「第 $i$ 个数据源训练梯度」的点积。这个点积有非常直观的几何含义:
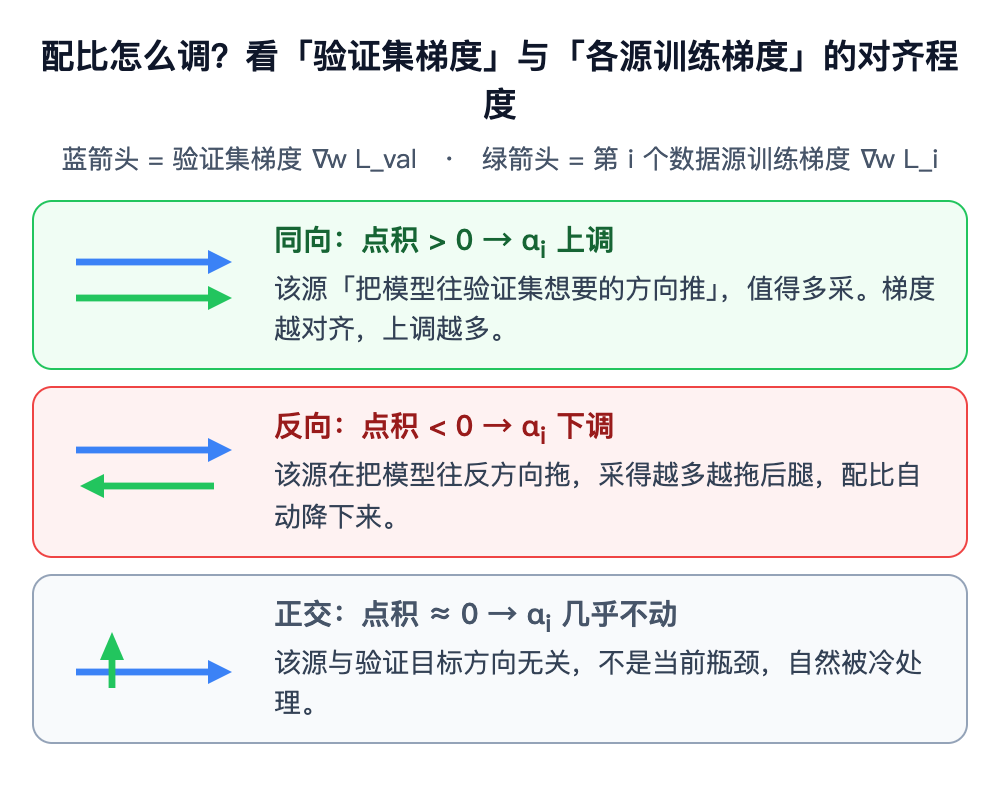
- 同向(点积 $> 0$):这个数据源把模型往验证目标想要的方向推 → 加大它的配比;
- 反向(点积 $< 0$):它在拖后腿 → 降低配比;
- 正交(点积 $\approx 0$):与当前目标无关 → 基本不动。
这个解释优雅得不像工程方法(笑)。而且它顺带解释了 FastMix 为什么「知道」每个源当下该不该被重视——它不是在全局意义上给每个源定一个静态权重,而是在训练过程的每一刻都能给出「此刻谁在帮倒忙」的信号。
4.4 为什么 $n_2$ 必须等于 1
论文里专门有一节「No Free Lunch」讨论工业实践中的坑,其中很关键的一条就是:长外循环($n_2 > 1$)不可行。为什么?$n_2 > 1$ 意味着 $\alpha$ 的更新要穿过 $n_2$ 步模型更新做反向传播——要么用 BPTT(显存灾难),要么用有限差分(慢且噪声大,尤其当目标还是非可微指标时)。作者实际试了 SPSA、有限差分等黑盒梯度估计器,在大规模工业数据上几乎不收敛。所以 FastMix 坚定地选择 $n_2 = 1$:宁可有点贪婪,也要梯度干净。
5. 实现思路:怎么把论文变成代码
官方实现在 github.com/hrtan/fastmix,读完代码有几个实现细节值得记一下:
-
配比就是一组可学习 logits。 混合权重对应一个
dataset_probs参数,softmax 之后得到采样分布。搜索过程中每隔若干步把当前 logits 存下来(FastMixtureOut/probs_module_step*.pt),所以配比随训练的演化轨迹是直接可观测的——这相当于免费送你一份「数据课程」曲线。 - 两种搜索目标(两个入口):
-
train_fastmix_val.py:目标 = 留出验证集上的语言建模损失(纯 LM 目标,适合预训练场景); -
train_fastmix_sft.py:目标 = 下游 SFT 数据。每条样本是{"question","answer"}对,实现里会 mask 掉 question 部分,只在 answer token 上算 loss 和梯度——论文的后训练实验就是它跑的。
注意「可微目标」在实现层面的体现:验证指标是离散的(比如准确率)时没法直接求导,所以论文建议用 SFT loss 当可微代理目标——这是「No Free Lunch」一节反复强调的实践要点。
-
-
效率靠工程。 代理模型本身不大(后训练实验里约 1B:Qwen2.5-1.5B-Instruct),但整个 pipeline 用了 flash-attention 的融合 cross-entropy / RMSNorm 核;数据侧走 RegMix 的管线(gpt-neox 分词 → 打包成二进制分片);验证集用更小的 chunk size($131136 = 2049 \times 64$)适配小数据量。
- 会踩的坑(论文 + 代码共同提示):
- 代理模型小于 0.5B 时不可靠:收敛不稳定、配比噪声大、对不同数据源有容量/架构偏差——作者把 RegMix 当 oracle 也观察到同样现象,说明这不是 FastMix 独有的问题,而是代理模型范式的通病;
- 序列长度不匹配:预训练序列长、SFT 序列短,梯度方向差异巨大,FastMix 会直接失败。解法是把多个 SFT 序列拼接起来,对齐到预训练长度;
- 正则化选型:学术界小数据集上熵正则防坍缩够用,但工业数据上,最稳的是「过采样不超过原始数据 3 倍」这种硬约束;
- 一个直接可复用的命令长这样(照 README 改路径即可):
python pretrain/train_fastmix_val.py \
  --train_data_dir /path/to/welldata \
  --val_data_dir /path/to/welldata \
  --data_yaml_file configs/pile.yaml \
  --out_name my_run --resume False \
  --learning_rate_dataset 0.01
6. 实验结果
6.1 预训练:48.2 分、9/14 项最佳、1.3 GPU 小时
设置:Pile 的 17 个无版权子集;代理模型约 1M 参数、最多训 1B token;搜索目标选 Pile-cc 子集上的损失;搜索完成后用得到的配比训练 1B 参数模型(25B token),在 14 个下游任务上评测。
| 方法 | 14 项平均分 | 搜索成本 |
|---|---|---|
| FastMix | 48.2(14 项中 9 项最佳) | 1.3 GPU 小时 |
| CLIMB | 47.5 | 71.9 GPU 小时 |
| RegMix | 47.2 | 720.5 GPU 小时 |
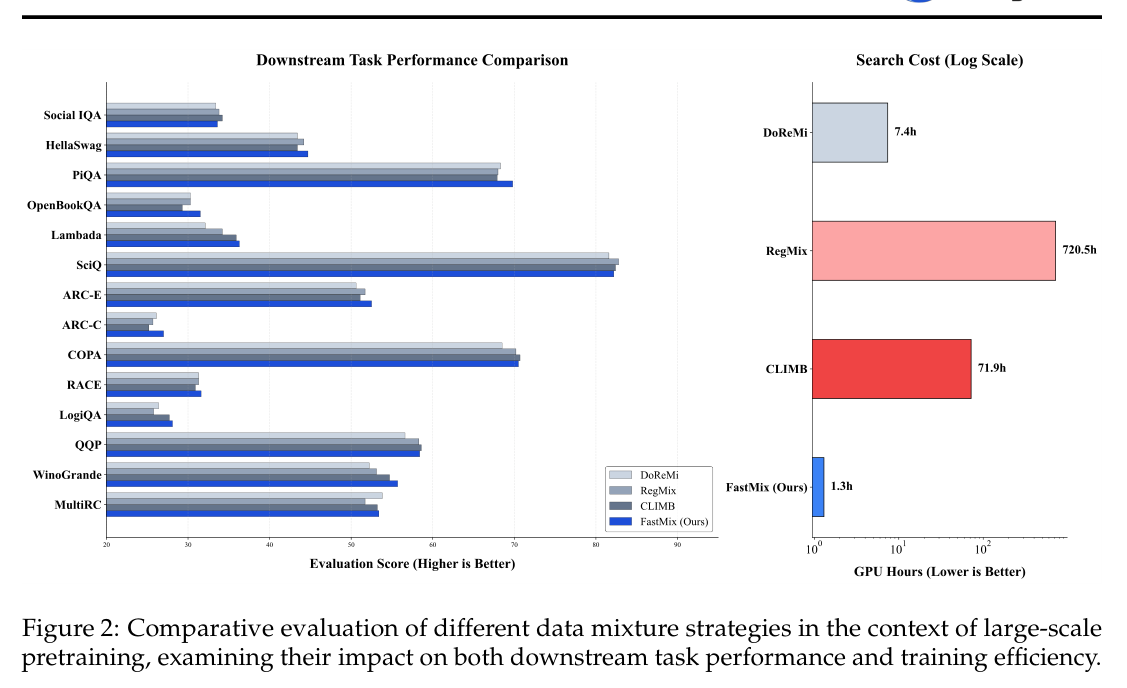
FastMix 比 CLIMB 快约 55 倍、比 RegMix 快约 550 倍,而且平均分最高、最佳任务数最多(9/14)——「更快」和「更好」同时成立,这在搜索类方法里挺少见。
6.2 后训练(SFT):+5.5 分、52 倍加速
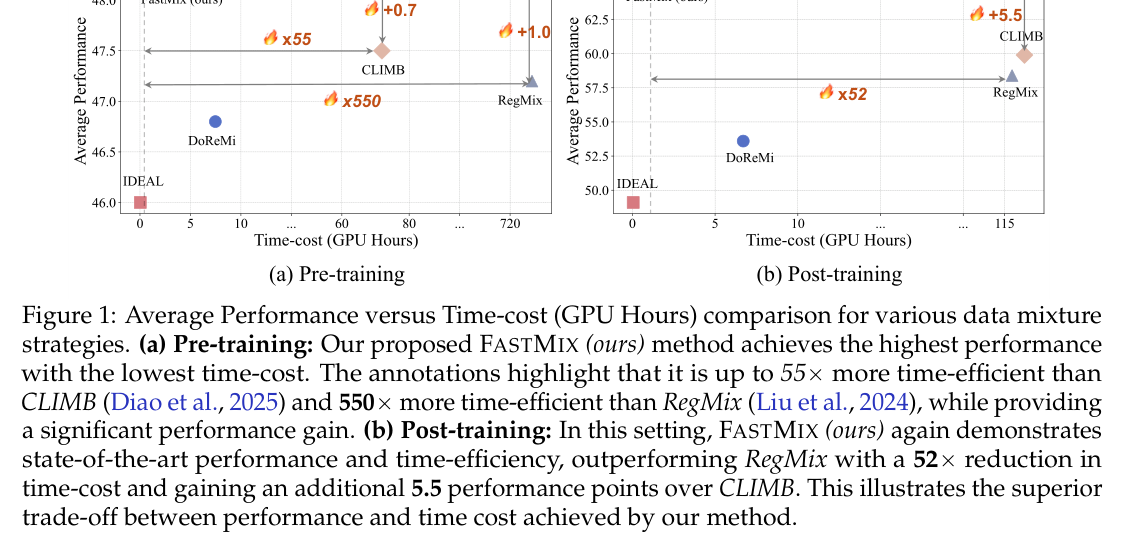
设置:Qwen2.5-Math-Instruct-7B 上做指令微调;8 个领域 SFT 数据(数学 OpenR1-Math-220k、代码 OpenThoughts-114K、对话 ShareGPT、STEM Platypus 等);优化目标 = GSM8K 与 gaokao2023en 的 1:1 加权评分;代理模型约 1B 参数(Qwen2.5-1.5B-Instruct)。为公平,RegMix/CLIMB 的代理模型数被压到 64 个。
| 方法 | 平均分 | 搜索成本 |
|---|---|---|
| FastMix | 65.4 | 2.2 GPU 小时 |
| CLIMB | 59.9 | 117.4 GPU 小时 |
| RegMix | — | 115.9 GPU 小时 |
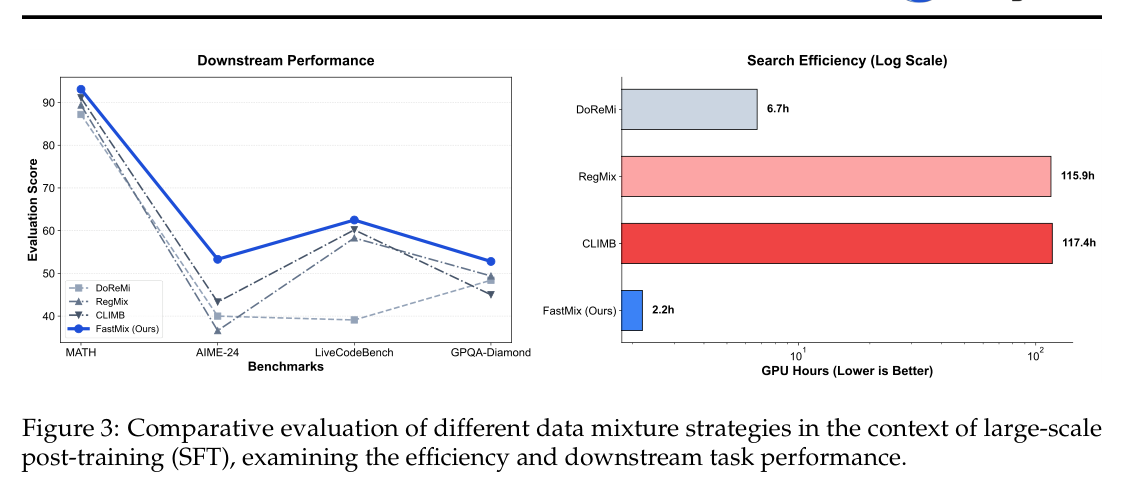
最值得注意的其实不是分数本身,而是泛化性:搜索信号只有数学(GSM8K + 高考题),但 FastMix 得到的配比在 LiveCodeBench(代码)和 GPQA-Diamond(STEM 问答)上也全面领先——说明它没有过拟合到优化信号上,找到的是一个「结构性更好」的配比,而不是「对数学卷子特攻」的配比。
7. Takeaways
最后说点私货。
-
重参数化是全文的灵魂。 从 AutoML 的视角看(我自己做 NAS 出身),FastMix 和 DARTS 走的是同一条路线:把离散的选择问题松弛成连续的权重问题,梯度就有了立足之地。差别在于 DARTS 松弛的是架构,FastMix 松弛的是数据采样——而数据配比恰恰是 LLM 时代最贵、最值得被「可微化」的变量之一。
-
黑盒与白盒的差距是数量级的。 RegMix 用 512 个模型去「采样」配比-性能曲面,每个模型只贡献一个标量损失;FastMix 的 1 个模型每步都在产出全梯度信息。512 个标量 vs 每一步一个向量——信息量完全不在一个量级。这解释了为什么「回归拟合」路线在配比这种高维、非凸、噪声大的问题上总是吃力不讨好。
-
梯度对齐是一种一阶的影响函数。 $\alpha$ 的更新方向是「验证梯度 · 各源梯度」,本质是一种数据归因:每个源对验证目标的贡献。IDEAL 用影响函数做同样的事,但需要二阶信息和 Hessian 近似,数值上很娇气;FastMix 用一阶梯度就拿到了大部分直觉,代价是短视($n_2 = 1$ 的贪婪)。这两种思路的取舍值得记一笔。
-
配比是时间的函数,不是常数。 论文观察到不同数据源的重要性随训练动态演化:有的源前期关键,有的源训练很久之后才主导。这给了课程学习(curriculum learning)一个很自然的视角——FastMix 产出的 $\alpha$ 轨迹序列,本身就是一份可复用的数据课程。如果后续工作把 $\alpha$ 显式参数化成时间函数(而不是逐轮外循环更新),可能会更有意思。
-
工程细节决定成败。 这一篇最实在的地方就是「No Free Lunch」那一节:SPSA/有限差分在工业数据上不收敛、小于 0.5B 的代理模型不可靠、序列长度不匹配直接失败、熵正则不如过采样硬约束……这些「论文正文不会告诉你」的教训,恰恰是复现和落地时最值钱的。
-
局限。 $n_2 = 1$ 的贪婪性让它对数据噪声敏感;当前流程还是「先搜后训」的一次性流程,离「边训边调」的在线范式还有距离;对验证集/搜索目标的选择依然敏感(选 Pile-cc 当目标 vs 选下游任务,结果会有差异)。
参考资料
- FastMix: Fast Data Mixture Optimization via Gradient Descent(ICLR 2026)— arXiv:2606.14971
- 官方实现 — github.com/hrtan/fastmix
- DoReMi: Optimizing Data Mixtures Speeds Up Language Model Pretraining(Xie et al., 2024)
- RegMix: Data Mixture as Language Model Pretraining Strategy(Liu et al., 2024)
- CLIMB: Clustering-based Iterative Data Mixture Bootstrapping for Language Model Pretraining(Diao et al., 2025)
顺带说一句:配比搜索本质上就是一次「超参搜索」,只是这个超参维度高、评估又贵。更有意思的是,FastMix 这套「内层训练模型、外层更新权重」的双层优化流程,和 DARTS 搜架构其实是同一个套路——DARTS 用 bi-level 优化搜索的是架构权重,FastMix 只是把搜索对象换成了数据集权重,换汤不换药。我们把手头关于 AutoML / NAS 的积累整理成了《动手学 AutoML:从 NAS 到大语言模型优化实战》,书里在搜索策略一章和「DARTS 可微分搜索」实战章节,把这个双层优化从数学推导讲到代码实现;理解了这一层,再回头看 FastMix 的闭式梯度,你会觉得它「原来如此」,而不是「不明觉厉」。感兴趣可以翻翻。
