DeepSeek V4.1 Flash | 后训练没有新算法,Agent 能力从哪来?
DeepSeek V4.1 Flash | 后训练没有新算法,Agent 能力从哪来?
“… our post-training introduces no algorithmic innovation. All substantive changes lie instead in the data pipeline.”
—— DeepSeek-V4.1-Flash 技术报告 《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》
https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
这句话放在一份以 KV Cache Compression 为标题的报告里,多少有点反直觉。报告前半花了大量篇幅重写模型处理长上下文的方式:哪些历史信息要算、要存、要在缓存失效后重建;到了后训练,作者却刻意不再改优化算法,把注意力放到数据、任务和环境是如何被造出来的。
模型一旦开始调用工具、处理代码仓库和网页、跑很多轮任务,先得付得起上下文不断增长的成本。模型会把已经读过的 token 留成一份可复用的注意力记忆,这份记忆通常叫 KV Cache:
- Agent 的上下文不断增长,未命中缓存时,重新读入整段历史的计算很贵;
- 命中缓存后,缓存本身仍要占 GPU 的高带宽显存(HBM)、主存或 SSD,还要在机器之间传输;
- 稀疏注意力已经显著降低了“看全上下文”的计算量,于是 KV 的存储和搬运反而越来越突出;
- 因此,V4.1 Flash 同时改了 prefill 的计算路径、全局 KV 的跨层复用,以及持久化缓存的恢复方式。
报告给出的模型规模是 552B backbone parameters,支持 1M context;但更应该关注的是每 token 激活参数:prefill 为 8B,decode 为 16B。这不是两套模型,也不是简单少用一半专家,而是“读入整段历史”和“生成一个新 token”走了不同深度的计算路径。这里的 “Flash” 并不意味着总参数最少,而是它试图把长上下文 Agent 的主要系统成本压下来。
成本能压下来,只是让更长的 rollout 变得可行。模型在 rollout 里究竟看见什么任务、进入什么环境、怎样知道一次尝试是真的完成而不是碰巧骗过评分器,决定了这些算力最后会变成什么能力。报告后半的重点正落在这里。
1. 先把问题说清楚:长程 Agent 到底贵在哪里
1.1 一轮 Agent 任务里,其实有三种不同的成本
对普通聊天来说,几十轮以内的上下文通常还不至于让 KV Cache 成为第一问题。但对代码 Agent、浏览器 Agent 或企业流程 Agent 来说,模型会反复经历“读历史—调用工具—把工具结果塞回上下文—继续读”的循环。
这时可以把成本拆成三部分:
- Prefill:模型第一次读入一段新上下文,并为它计算 KV Cache。工具返回很长、缓存失效、或者切换机器后要恢复任务时,这部分会重新出现。
- Decode:模型基于已有上下文逐 token 生成答案、命令或下一步工具调用。
- KV Cache 的存储与迁移:长任务不能只把缓存放在单张 GPU 的 HBM 里;缓存需要持久化到主机内存或 SSD,也可能跨节点搬运。此时容量和带宽都会变成吞吐限制。
这里的 KV Cache 可以粗略理解为:模型读过历史 token 后留下的一份“可直接复用的注意力记忆”。下次生成时不必从头重新计算每个历史 token 的 Key 和 Value,但代价是这份记忆会随上下文长度增长。
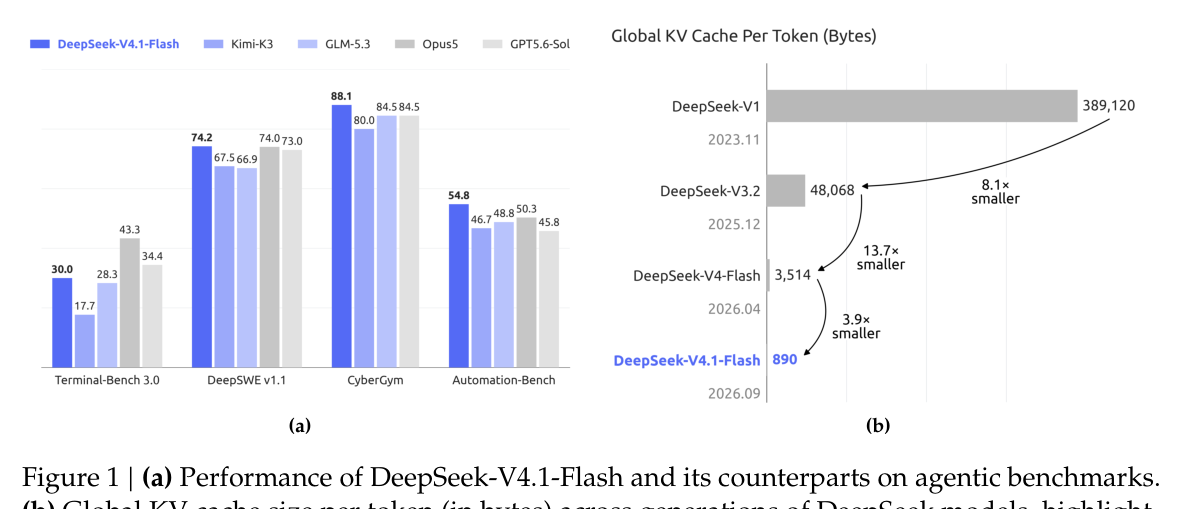
图 1。先看右图:报告把 V4.1 Flash 的全局 KV Cache 标成 890 bytes/token,约为 V4-Flash 的四分之一。左图则放了 Agent 基准表现。两张图并列的意思不是“缓存更小必然分数更高”,而是作者要说明:压缩缓存之后,模型并没有只换来成本下降,也维持了较强的 Agent 能力。
一个容易被忽略的点是:运行时 KV 和 持久化 KV 不是同一回事。
运行时 KV 常驻在 HBM 中,直接影响单机能同时服务多少长上下文请求;持久化 KV 则被放到主存或 SSD,供后续回合或迁移恢复使用。前者主要受显存容量限制,后者还会受到 I/O 和网络带宽影响。报告后面“约四分之一”和“约八分之一”这两个数字,分别对应这两层问题,不能混在一起看。
1.2 稀疏注意力解决了一半,剩下的一半变得更显眼
DeepSeek V4 的路线是把注意力分成两支:局部的 Sliding-Window Attention(SWA)只看最近窗口;全局分支用稀疏方式,从很长的历史里挑少量位置读取。
SWA 的缓存上限由窗口大小决定,窗口固定时不会随上下文无限增长。真正会随序列增长的,主要是全局分支的 KV。因此,当稀疏注意力已经让全局检索的算力下降后,长期保存这部分 KV 的空间和搬运开销就会更刺眼。
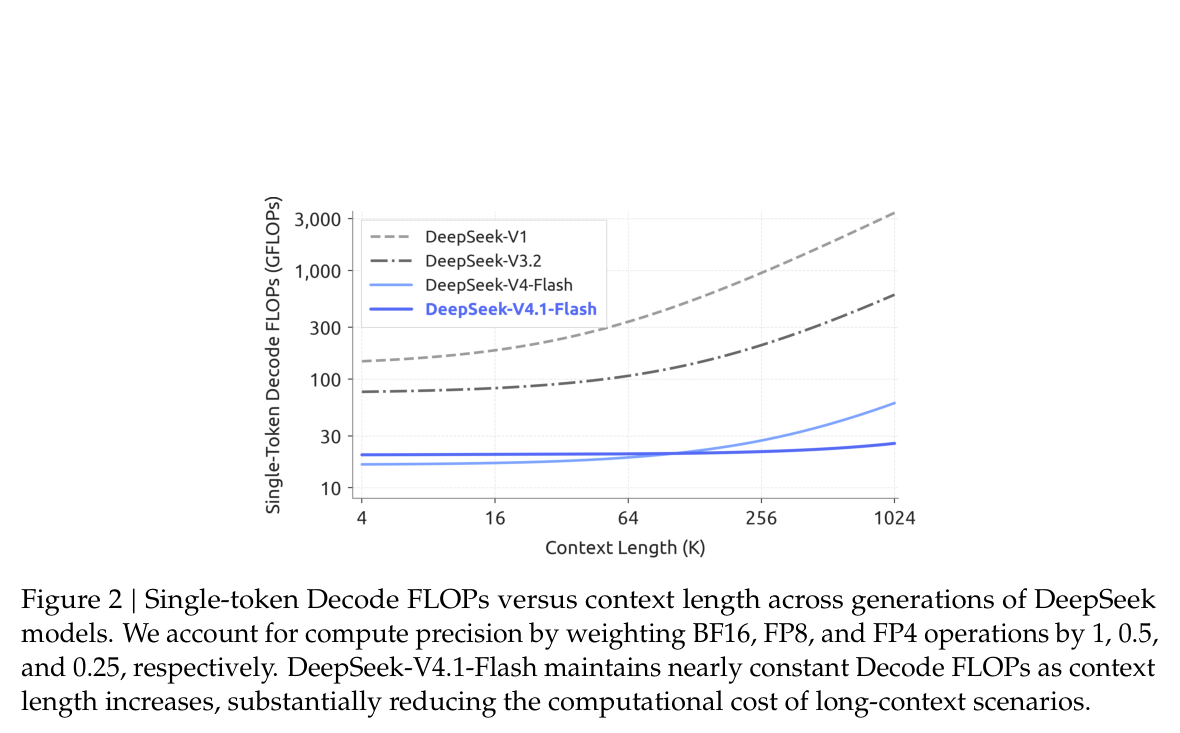
图 2。横轴是 context length,纵轴是生成一个 token 的加权 FLOPs。要看的不是某个点绝对值,而是曲线斜率:V4.1 Flash 从 4K 扩到 1M context 时,decode FLOPs 只小幅增长;V4-Flash 的曲线则更明显上扬。报告将不同精度的操作按 BF16=1、FP8=0.5、FP4=0.25 加权,因此这不是通用硬件上的真实延迟图,而是计算量口径下的架构比较。
到这里,问题才完整:既要少算新上下文,也要少存、少搬旧上下文。V4.1 Flash 的三个核心设计正好分别对应这三个动作。
2. 第一步:把“读完整段历史”和“生成下一个 token”拆开算
2.1 8B/16B 不是规格差异,而是两条计算路径
报告把这套设计命名为 Causal Encoder-Decoder(CED)。它将 40 层 Transformer 分成 20 层 causal encoder 和 20 层 decoder:前者负责把已经出现的历史 token 编成一份长期记忆,后者负责在生成时读取这份记忆并完成更深的变换。这里的 causal 仍表示只能看当前位置之前的 token,并不是把输入和输出完全分开的传统机器翻译式 encoder-decoder。
先说清 “activated parameters” 的口径。V4.1 使用的是混合专家模型(Mixture-of-Experts,MoE):总参数被分在很多专家网络中,每个 token 只会路由到其中少量专家。这里的 8B 或 16B,是一个 token 在对应阶段真正经过的参数规模。V4.1 Flash 的差异来自层数,而不是 prefill 阶段换成了另一种专家选择策略:
| 阶段 | 全部 $N$ 个 prompt token 都要经过的路径 | decoder 额外做什么 | 报告给出的每 token 激活参数 |
|---|---|---|---|
| Prefill | 前 20 层 causal encoder | 后 20 层的全局 KV由 encoder 输出直接投影;只有最后 $n_{\text{win}}$ 个 token 需要进入 decoder 重建局部 SWA 状态 | 8B |
| Decode | 新生成的 token 依次经过 20 层 encoder 和 20 层 decoder | 使用已建好的全局 KV 与局部 SWA KV,形成最终 logits | 16B |
因此,长 prompt 的主路径相当于只跑半个模型:20 层 encoder 对全部历史 token 做完整计算,得到中间表示;decoder 不必把每个历史 token 再完整过 20 层,只需从这个中间表示“写出”自己要用的全局记忆。设模型一共 $L$ 层,输入长度为 $N$,对于后 $L/2$ 层,全局 KV 不再从该层自己的隐藏状态生成,而是直接从第 $L/2$ 层的输出投影出来:
\[C_l = H_{L/2}W^{KV}_l,\qquad Z_l = H_{L/2}W^{Z}_l,\qquad l>\frac{L}{2}.\]这里 $H_{L/2}$ 是 encoder 最后一层对整段输入的表示;$C_l$ 是第 $l$ 个 decoder 层使用的压缩全局 KV 表示,$Z_l$ 是对应的压缩权重;$W_l^{KV}$ 与 $W_l^Z$ 则是该层各自的投影参数。关键在于:所有 decoder 层共享同一个来源 $H_{L/2}$,但每一层仍有自己的投影矩阵,因此它们拿到的并不是一份完全相同的 KV。
这件事之所以有机会成立,是因为 decoder 的全局注意力需要的是一份可按位置读取的长期记忆,并不一定要求每个历史 token 都先经过该 decoder 层,才能写出这份记忆。前 20 层已经把整段历史编码成 $H_{L/2}$;上半层再用自己的投影把它转换成各自适合检索的 KV。真正更依赖层级演化的局部模式没有被一刀切丢掉:SWA 仍按层保留,只是对历史前缀采用有限回放来恢复。换来的代价是,decoder 的全局记忆不再等价于“完整 40 层前向后该层本应得到的隐藏状态”,所以 CED 必须在训练和评测中验证这种替代是否可靠。

图 3。阅读顺序可以从下往上看。40 个 Transformer block 被分为 20 层 causal encoder 和 20 层 decoder;encoder 产生的表示向上投影为 decoder 的全局 KV。图中 decoder 仍保留局部 SWA 路径,因此“只算半个模型”只描述长 prompt 的主 prefill 路径:后半层没有为全部历史 token 重新做完整计算,但会为最后一个局部窗口补算 SWA 状态;真正 decode 新 token 时,40 层仍都要执行。
如果只看长 prompt 中“平均每个输入 token”经过的激活参数,直觉上可以写成:
\[P_{\text{prefill}}(N) \approx 8\text{B}+8\text{B}\cdot\frac{n_{\text{win}}}{N}, \qquad P_{\text{decode}}\approx 16\text{B}.\]第一项是所有 token 都要跑的 encoder;第二项是最后 $n_{\text{win}}$ 个 token 为了局部注意力额外过 decoder 的摊销成本。它不是报告的精确计费公式,而是解释为什么表里的主规格会写成 prefill 8B、decode 16B:当 $N\gg n_{\text{win}}$ 时,第二项几乎可以忽略;短 prompt 或频繁短回合时,这个额外项就不能忽略。
这也回答了“为什么 decode 不能也只用 8B”:缓存里的全局 KV 只解决了历史信息从哪里读,新 token 仍要经过 decoder 的层级变换、自己的局部注意力和 FFN,才能形成最终 logits。CED 省掉的是为历史 token 重复生成 decoder 全局 KV 的计算,并没有把 decoder 从生成路径里删除。
对于 $N\gg n_{\text{win}}$ 的长输入,报告给出的 prefill 复杂度近似从
\[O(NL)\]变成
\[O\left(N\frac{L}{2}+n_{\text{win}}\frac{L}{2}\right) \approx O\left(N\frac{L}{2}\right).\]其中 $n_{\text{win}}$ 是 SWA 的局部窗口大小。这个近似成立的前提很明确:输入足够长,窗口项相对于 $N$ 可以忽略。因此 CED 特别适合“工具结果很长、每轮新输入很多”的 Agent,而不是声称对任何短 prompt 都会获得同样接近一半的收益。
2.2 局部注意力仍需要状态:有界回放是在省存储,不是在凭空消失
CED 没有把所有计算都砍掉。为了保持局部建模能力,SWA 的 KV 仍然是逐层形成的。问题在于:如果要精确恢复 decoder 各层的 SWA 状态,理论上需要重放最近 $L\times n_{\text{win}}$ 个 token。
DeepSeek V4.1 Flash 采用了 SWA Bounded Replay:恢复时只重放最近 $n_{\text{win}}$ 个 token,而不是每层都沿着窗口继续展开。它用一小段重新 prefill 来近似重建需要的局部状态,于是不必把所有 SWA KV 持久化到 SSD。
这也是报告把持久化 KV 降到 V4-Flash 约八分之一的关键原因:一部分来自全局 KV 更小,另一部分来自不再长期保存 SWA KV。代价也不能略过——这是近似恢复。报告只在已评估设置中观察到很小的性能影响;在极端长程依赖、缓存断点附近或未覆盖的输入分布上,状态误差仍可能累积,这也是报告在局限性中明确提到的边界。
3. 第二步:别让每一层都重复建缓存、重复找历史
3.1 先理解全局稀疏注意力里重复了什么
长上下文的全局注意力通常不会对每个 query 和全部历史 token 做完整计算,而是先用一个轻量检索器从历史中选出 Top-K 个候选位置,再让主注意力读取这些候选 KV。
如果每一层都独立完成这件事,至少会有三类重复:
- 每层都保存一份全局 main KV;
- 每层都保存或计算用于检索的 indexer K;
- 每层都对长历史重新打分,得到自己的 Top-K 索引。
报告把压缩视为三个相乘的维度:减少单个 KV entry 的字节数、减少序列维度上的 entry 数、以及减少层维度上的重复。前两种做法已经比较常见;它把第三种跨层复用的设计称为 Compressed Sparse Attention 2(CSA2)。
3.2 Full、Reindex、Reuse:把“建库、检索、读取”拆开复用
CSA2 为每个注意力层静态指定三种模式。它们都保留当前层自己的 main Q 和局部 SWA KV;区别只在全局 KV、检索 key 与 Top-K 索引从哪里来。

图 4。按从上到下读即可。绿色是当前层新计算的量,黄色是从最近 Full 层复用的 main KV 与 indexer K,红色是从最近一次 Full 或 Reindex 复用的 Top-K 索引。关键是三种模式不是“有无注意力”的区别,而是对建库、重新排序、直接读取这三项工作做不同粒度的复用。
- Full Mode:当前层完整生成 main KV,投影 indexer K,用自己的 indexer Q 扫描并得到新的 Top-K。它相当于建立一份新的全局记忆基准。
- Reindex Mode:不再生成新的 main KV 和 indexer K,而是复用最近 Full 层的那一份;但它用自己的 indexer Q 重新打分,得到自己的 Top-K。这样“库”可以共用,层的检索偏好仍可不同。
- Reuse Mode:连 Top-K 也直接沿用最近一次产生索引的层;它只计算自己的 main Q、局部 SWA KV,并对同一批全局位置做注意力。这样最省索引计算,但也最依赖此前的选择没有漏掉关键信息。
这三种模式把一个很大的取舍拆得更细:完全逐层独立,效果上最自由但最贵;全层共享同一套 Top-K,最便宜但可能太死;CSA2 则在中间插入 Reindex,让一部分层能换检索结果,而不需要重新建全局 KV。
报告同时把全局 KV 用 FP4 存储。精度压缩和跨层复用是叠加的:前者让一份缓存更小,后者让需要存的“份数”更少。最终,报告给出的运行时全局 KV 体积是 890 bytes/token,约为 V4-Flash 的四分之一。
3.3 分层索引:只有第一层全量扫,后续层在候选池里找
即使已经有 Reindex,重新检索的层如果仍要对 1M 个位置逐个打分,成本还是会随 context 增长。于是报告又加了 Hierarchical Sparse Indexer。
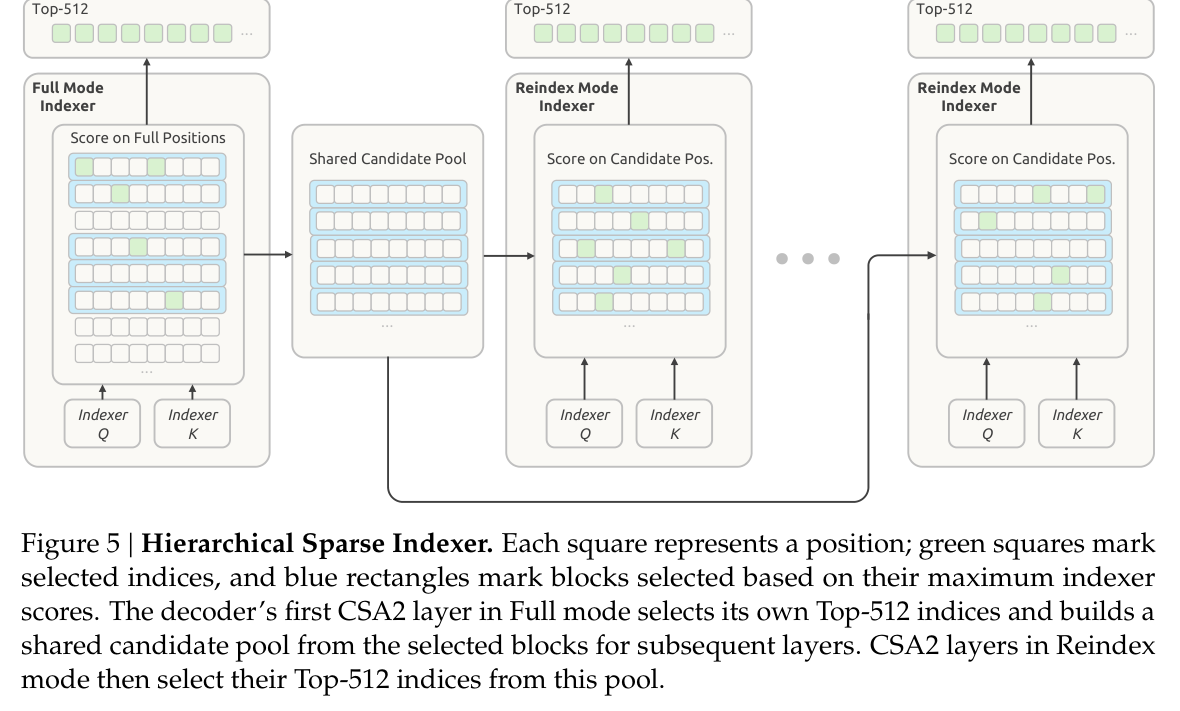
图 5。最上面的 Full Mode 先看完整历史:绿色方块是它选出的 Top-512,蓝色框表示这些高分位置所在的 block。中间和下面的 Reindex Mode 不再遍历全部位置,而只在蓝框覆盖的共享候选池中选自己的 Top-512。要注意:后续层共享的是“搜索范围”,不是强制共享最终 Top-K。
具体过程是:
- decoder 中第一个 Full Mode 层对所有可见的全局 KV 位置打分;
- 它一边选出自己要读的 Top-K,一边按 block 聚合分数:一个 block 的分数取内部位置的最大值;
- 选出高分 block,拼成比最终 Top-K 更大的候选池。报告举例:选 2,048 个 block、每个 block 8 个位置,会得到 16,384 个候选位置;
- 后续 Reindex 层只在这 16,384 个位置里用自己的 query 重新选 Top-K;Reuse 层则继续复用已有索引。
这一步为什么能让 decode 对上下文长度不敏感?因为第一层仍要全局扫描,但后续 indexer 的评分数量被候选池上限固定住了。随着 context 从 4K 变成 1M,后续层不会再按 256 倍的历史长度重复扩大检索工作。
代价也同样明确:如果第一层建候选池时漏掉了某段真正重要的历史,后续 Reindex 层就没有机会把它找回来。报告称训练和推理都使用同样的候选限制,目的是让后续层适应这个搜索空间;但这并不能替代对超长稀疏检索失败案例的压力测试。
4. 第三步:缓存小了之后,还要让模型与系统真的跑得动
4.1 把残差混合改成一次读取:Single-Pass mHC
CED 主要削减 prefill,CSA2 主要削减全局 KV 与索引;但 decode 阶段还有另一类常被 FLOPs 掩盖的成本:activation memory traffic,也就是中间激活在 HBM 与计算单元之间被反复读写的流量。batch 很小、逐 token 生成时,算术单元未必是第一瓶颈,等内存数据到位反而可能更慢。
mHC 是 V4 已有的 residual-stream mixing 设计。普通 Transformer 可以粗略看成维护一条 residual stream;mHC 同时维护 $n$ 条,并为每个 token 预测三组混合系数 $A_l,B_l,C_l$,决定本层输入从哪些 stream 混合而来、旧 stream 如何更新。原始形式可以写成:
\[X_{l+1}=B_lX_l+C_lF_l(A_lX_l),\qquad (A_l,B_l,C_l)=H(X_l).\]$X_l$ 是第 $l$ 层的 $n$ 条 residual stream,$F_l$ 是这一层的 Transformer block,$H$ 则根据当前 $X_l$ 预测混合系数。问题不是这个式子本身,而是执行顺序被卡死:先更新 $X_l$,才能算 $H(X_l)$;算完 $H(X_l)$,才能用新得到的 $A_l$ 做输入混合。旧实现因此至少要按“残差更新 → 系数预测 → 输入混合”分多次读同一份激活,kernel 很难合并。
Single-Pass mHC 把一个很小但关键的时间依赖向后挪一层:第 $l$ 层不再等 $A_l$,而使用前一层已经算好的 $A_{l-1}$:
\[X_{l+1}=B_lX_l+C_lF_l(A_{l-1}X_l).\]这样读到 $X_l$ 的同一时刻,就能同时完成残差更新、输入混合,并累积下一层 $A_l,B_l,C_l$ 的预测所需统计量。报告的 Mega-mHC kernel 正是利用这个顺序把三个阶段融合为一次 traversal;按作者的读写量计算,activation traffic 从原实现的 $(4n+4)d$ 降到 $(2n+2)d$,约减半。这里并不是“少了一次 Transformer 计算”,而是减少了中间向量在显存里来回搬运。
这个设计的取舍也很具体:当前 block 用到的混合系数比原来滞后一层。报告称实测性能损失可以忽略,但训练阶段仍沿用多 kernel 的实现;真正把 Single-Pass 用到极致的是部署阶段。这说明它更像为推理 kernel 解依赖的系统改写,而不是为了训练提出的新表达能力。
4.2 两条旁路:条件记忆 Engram 与草稿生成 DSpark
Engram 不是 KV Cache。KV Cache 保存的是当前这条上下文已经算出的注意力状态;Engram 是额外的条件记忆模块,试图把“见过的局部模式”从每个 token 都要经过的 MoE 主干中分出来。报告的实现会先压缩 token,再对 $2$、$3$、$4$-gram 通过多头哈希寻址,从 embedding table 取回若干候选记忆;随后由上下文相关的 gate 决定拿多少、怎样同主干表示融合。
为什么这会影响推理系统?报告将 196B Engram 参数分在两个模块中,放在第 1 和第 14 层;但这些表不是每个 token 都全量读取。哈希地址是确定的,因此系统可以在 host memory 中预取对应 embedding,并用后台 RDMA 与前面 Transformer block 的计算重叠。换句话说,它把一部分“记住 n-gram 局部规律”的工作变成稀疏查表和预取,目标是让主干参数更多服务于组合、推理和上下文建模。
这条路径也有边界:哈希寻址与外部表带来碰撞、预取命中和主机内存带宽等新依赖,报告没有给出单独的 Engram 消融来量化这些条件分别贡献多少。因此更稳妥的理解是,Engram 为参数规模和激活规模之间增加了一层可稀疏访问的记忆,而不是证明“外部记忆一定比主干权重更有效”。
DSpark 则解决输出端的自回归串行性。常规 speculative decoding 的思路是:小 draft model 先猜多个 token,大模型一次验证,猜对的部分就跳过逐 token 生成。V4.1 的 drafter 只有 3 个 Transformer block,局部 attention window 为 128;一次前向会并行给出未来 5 个 draft position 的基础 logits,再用轻量 Markov head 补充这些 draft token 之间的依赖。
真正有意思的是它没有固定“每次验证 5 个”。DSpark 还训练了 confidence head,预测每个候选位置在此前 token 被接受的条件下、自己会被接受的概率;把这些概率连乘可以得到不同 draft 前缀的存活概率。scheduler 再结合离线测得的引擎吞吐曲线,为每个请求动态选验证长度,目标是当前负载下的系统总 token throughput,而不只是让单个请求尽量激进地多猜。
训练顺序也说明了它是一个服务模块:backbone pre-training 结束后,先冻结 backbone 单独训练 DSpark;post-training 时两者一起更新,但 DSpark 的目标不向 backbone 反传梯度。这样 DSpark 能跟上 RL 后不断变化的策略,同时不让“更容易被验证”这件事改变主模型的能力目标。draft 猜错仍会带来验证浪费,因此收益依赖接受率、验证 kernel 和在线负载;这正是 scheduler 需要存在的原因。
4.3 再把缓存缩小:FP4 与三段式部署
前面说 CSA2 减少了要保存多少份全局 KV,FP4 Main KV Cache 则继续减少每一份占多少字节。FP4 可以先把它理解为四比特浮点存储:它不是为了让注意力矩阵乘更快,而是把写进缓存的 main KV 压得更小。报告把量化感知训练从 indexer 的 Q/K 扩展到 main KV:main KV 用 OCP MXFP4 格式的 E2M1 表示,每 16 个 channel 共用一个 E4M3 scale;真正做 attention 前再反量化。这样不要求硬件原生支持该 FP4 格式的矩阵乘,主要收益是存储布局更小。
这里有个不能混淆的细节:只有 main KV 被压到 FP4,SWA KV 仍保留 FP8。作者认为局部窗口状态对量化更敏感;相对 V4 的 FP8 main KV,FP4 大约再减半 main KV 的 HBM 与 SSD 占用。报告还给出数值范围的理由:训练中观察到的 main KV 幅值约为 10,而该格式在所用 scale 下的范围仍有余量。不过这依然是 QAT 和该模型分布下的结论,不能外推成“所有 KV 都可以直接用四比特”。
最后是部署切分。报告采用 Encoder–Prefill–Decode(EPD)disaggregation:视觉编码、读入 prompt、逐 token 生成可以由独立资源池扩缩容并重叠执行。持久化缓存只长期保留全局 KV,报告称至少保留 72 小时;SWA KV 转到每机约 10% host DRAM 的短 TTL 分布式池中,仅服务活跃会话。短期状态丢了就触发 Bounded Replay,而不是从 SSD 恢复完整 SWA。到这一层,CED、CSA2、FP4 和 replay 才真正接上同一条链:少算、少存、少搬,并把不可避免的 miss 降成一次有限范围的重算。
报告提到 CSA2 的 Reuse Mode 层在 prefill 使用 15 个 kernel、decode 使用 11 个 kernel;这是部署实现层面的指标,不该直接等同于任何硬件、任何 batch size 下的端到端延迟。
4.4 “Flash”不等于所有阶段都比前代少算
报告的 base model 总表很长,直接贴出来会让读者在一张小字截图里找重点。下面只摘出和本文判断直接相关的参数与文本/代码/长上下文项目;分数来自报告同一套内部评测,表头说明分差不超过 0.3 时视为同一水平。
| Base model | Backbone 参数 | 每 token 激活参数 | MMLU-Pro | BigCodeBench | HumanEval | LongBench-V2 |
|---|---|---|---|---|---|---|
| V4-Flash | 284B | 13B | 68.3 | 56.8 | 69.5 | 44.7 |
| V4-Pro | 1.6T | 49B | 73.5 | 59.2 | 76.8 | 51.5 |
| V4.1 Flash | 552B | prefill 8B / decode 16B | 74.1 | 60.6 | 79.4 | 45.2 |
V4.1 Flash 的 backbone 有 552B 参数,明显大于 V4-Flash Base 的 284B;decode 激活参数是 16B,也高于 V4-Flash 的 13B。它所换来的,是 prefill 时只激活 8B,以及更小的 KV footprint。表中最能说明取舍的是 LongBench-V2:V4.1 的 45.2 高于 V4-Flash 的 44.7,却仍低于 V4-Pro 的 51.5。结论不应被简化成“参数更少、能力更强”,而应是它针对长程服务重新分配了参数、计算与缓存预算。
报告称,该模型在 45T 多模态 tokens 上预训练,并从 64K sequence length 起就训练稀疏注意力,没有先用 dense attention warmup。作者报告 V4.1 Flash Base 在其 held-out evaluations 上相对 V4-Pro Base 有 5%–10% 改善,同时使用约三分之一总参数和四分之一激活参数。由于这些 held-out 集的构成没有完全公开,这个结论更适合被理解为作者的训练内证据,而不是跨模型的独立排名。
5. 训练数据不再只是 prompt
5.1 一道 Agent 任务,要先变成一个能运行、能判分的世界
报告所说的“没有新算法”只针对后训练。前面介绍的缓存和计算路径仍是实打实的架构与系统改动;但进入后训练后,整体配方沿用了已有做法:先用示范数据做监督微调(SFT),再用任务奖励做强化学习(RL),最后进行 on-policy distillation(OPD)。变化发生在模型面对的材料上。
拿代码 Agent 来说,一条“修复这个 bug”的指令远远不够。模型需要看到一个能启动的仓库、正确版本的依赖、任务开始时的工作区状态,以及不会把答案泄漏到上下文里的测试。做完之后,还需要一个验证器判断它究竟修好了问题,还是只改了恰好能让表面测试通过的地方。报告把一个训练任务写成 problem、environment 和 verification system 的组合,三者缺一个,RL 都很容易学偏。
因此,通用 Agent 的训练材料会从真实工作流的工具接口、失败反馈和多轮交互中重建 mock environment;代码 Agent 则从复杂会话和公开仓库中筛出任务,由不同 agent 负责容器搭建、求解尝试、质量检查和修复。任务被使用后留下的轨迹并不会立刻作废:新的失败方式会回到质检环节,暴露出难度不够、事实不对、验证点不严或可被钻空子的地方,再进入下一轮构造。
在这种定义下,数据管线包含的不是更多 prompt,而是更多可验证的任务、更多不同的交互环境,以及一套能持续过滤、去重和调节难度的机制。报告在第 25 页的判断也因此比“数据很重要”更强:在一个固定且并不特殊的优化流程下,合成数据和环境的规模、多样性与可验证性几乎解释了观察到的全部能力增益。这当然仍是作者对自身训练系统的归因,不是普适的因果定律;但它把 Agent 后训练的重心,从设计一个更花哨的 reward,推到了如何长期稳定地生产好任务上。
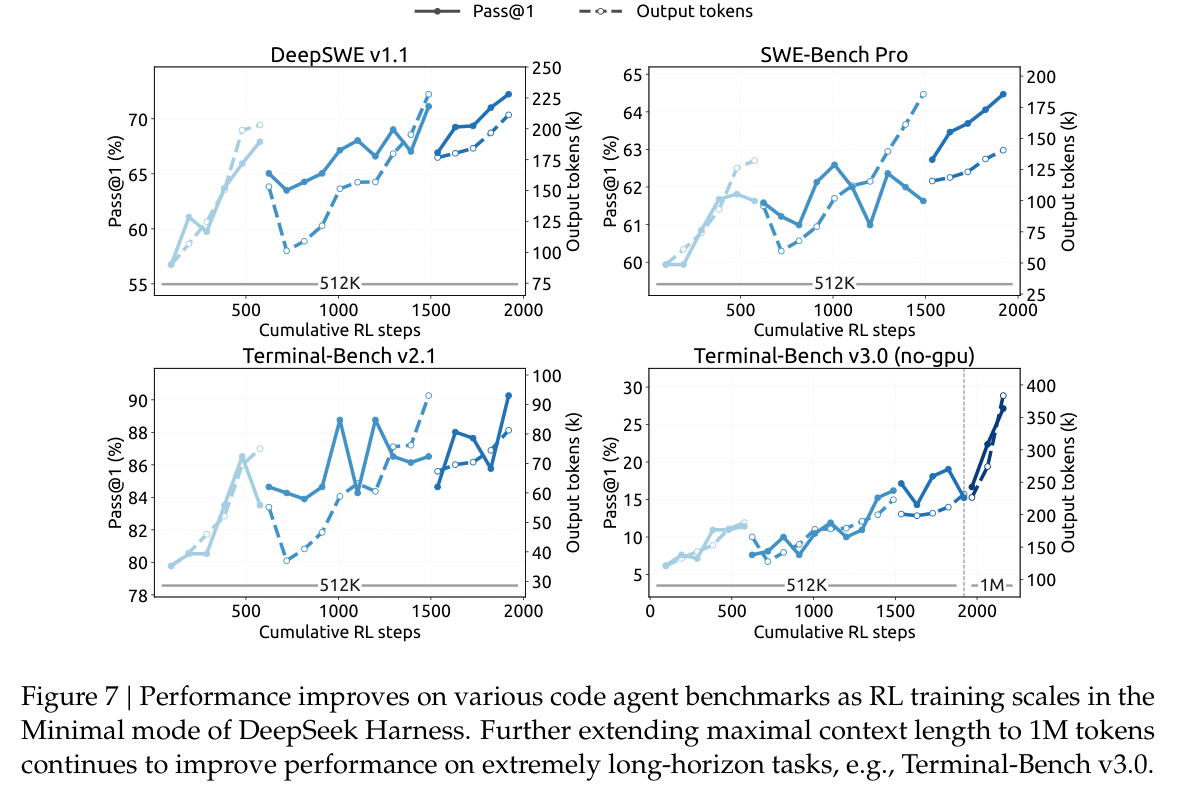
图 7。四个子图分别是 DeepSWE v1.1、SWE-Bench Pro、Terminal-Bench v2.1 和 v3.0。实线看 Pass@1,虚线看输出 token 数。图想说明两件事:更多 RL steps 仍带来提升;在最右侧 Terminal-Bench v3.0 上,最大 context 从 512K 增至 1M 也有额外收益。虚线同时提醒我们,这些提升伴随着更长轨迹,不能只看准确率。
5.2 换一套 Agent 外壳,能力还是否稳定
一个 Agent 的外壳通常被称为 scaffold:它规定系统提示词、工具 schema、上下文压缩方式和轮次控制。能力很容易被某个固定 scaffold 放大或限制;如果训练和评测只在一种框架里完成,模型可能学到的是某套交互惯例,而不是真正稳定的工具使用能力。
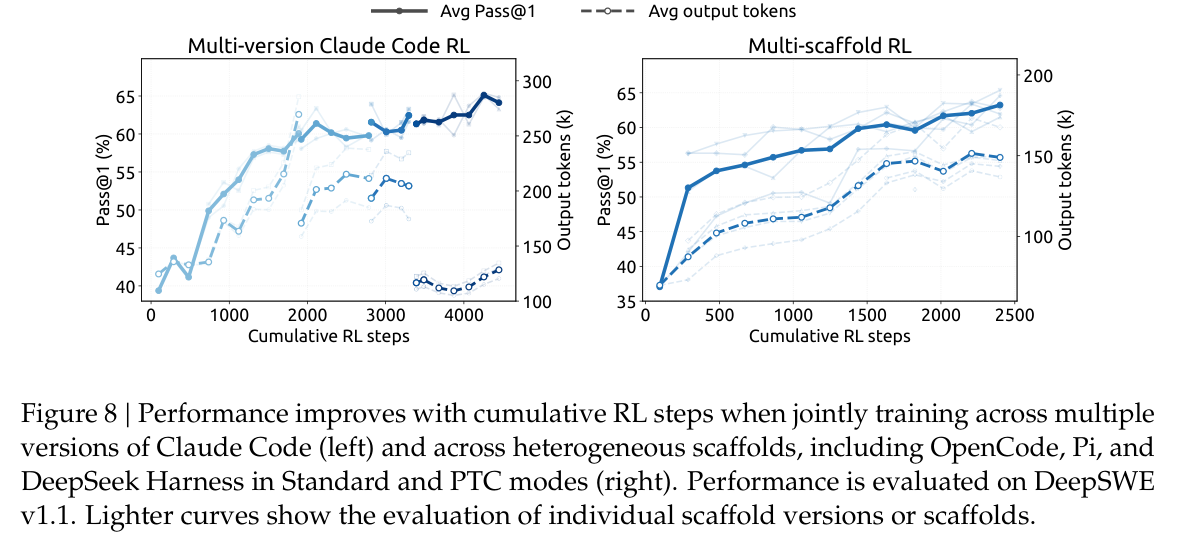
图 8。左图把多个 Claude Code 版本一起训练,右图混合 OpenCode、Pi 和不同 DeepSeek Harness 设置。深色线是联合训练后的总体表现,浅色线是单一 scaffold 或版本。作者据此主张:把交互协议做得更多样,RL 的收益仍可继续累积。这个图并不能单独证明因果关系,但至少说明报告没有只用单一 harness 来展示训练曲线。
这种训练方式也让“性能属于模型还是属于 harness”变成一个应当正面回答的问题。报告后面给了跨 scaffold 的评测,算是对这点做了必要补充。
6. 如何读结果:能力有提升,但不要把所有 benchmark 混成一个结论
6.1 相对 V4-Flash 的提升最明确;对顶级闭源模型仍是分任务看
报告的主结果表有 20 多项 benchmark。下面仍只摘出足以看出代际变化和能力边界的项目;其中 Pass@1 表示一次采样就完成任务的比例,DeepSWE 的 Resolved 表示被判定解决的问题比例,越高越好。所有数值仍是报告自己的 max-effort 设置,跨公司、跨 harness 的横向比较只能作为参考。
| 任务 | V4-Flash | V4.1 Flash | V4-Pro | GPT-5.6 Sol | Opus-5 |
|---|---|---|---|---|---|
| Codeforces(rating) | 3289 | 3471 | 3348 | — | — |
| Terminal-Bench 2.1(Pass@1) | 82.7 | 90.6 | 87.9 | 88.8 | 89.1 |
| DeepSWE v1.1(Resolved) | 54.4 | 74.2 | 62.7 | 73.0 | 74.0 |
| Terminal-Bench 3.0(Pass@1) | 7.6 | 30.0 | 11.8 | 34.4 | 43.3 |
| Terminal-Bench 4.0(Pass@1) | 7.0 | 31.2 | 12.4 | 39.9 | 51.8 |
| Automation-Bench(Pass@1) | 37.7 | 54.8 | 43.2 | 45.8 | 50.3 |
先纵向看 V4-Flash 与 V4.1 Flash 两列:DeepSWE v1.1 从 54.4 到 74.2,Terminal-Bench 2.1 从 82.7 到 90.6,Codeforces rating 从 3289 到 3471,这是最直接的代际改进。再横向看其他模型:V4.1 在 Terminal-Bench 2.1、DeepSWE、Automation-Bench 等任务很强,但 Terminal-Bench 3.0/4.0 仍落后于表内顶级闭源模型。不同 benchmark 的 harness、预算和评价设置并不完全相同,因此不宜把其中某一个最高分外推成笼统的“全面超越”。
几个具体结论可以相对稳妥地读:
- 对前代 V4-Flash,报告中的 Agent 任务增幅很大,尤其 DeepSWE v1.1 为 74.2 对 54.4,Terminal-Bench 2.1 为 90.6 对 82.7。
- 对 DeepSeek V4-Pro,V4.1 在 Codeforces(3471 对 3348)和部分 Agent 基准上更高,但并不在每个项目都占优。
- 对表内闭源模型,V4.1 在 Terminal-Bench 2.1、DeepSWE、AutomationBench 等单项上有竞争力;而在 Terminal-Bench 4.0 这类更偏科学与专家知识的任务上,仍显著落后于 Opus-5 和 GPT-5.6 Sol。
报告自己也承认这条边界:日常 coding 和白领工作流已可覆盖很多场景,但在需要专家级领域知识的科学型 Agent 任务上还有差距。这个说法比“能完成 95% 真实任务”更值得参考,因为后者缺少可复核的任务分布与统计口径。
6.2 reasoning effort 是一个可用的成本旋钮,而非免费提升
报告在 RL 时向 system prompt 加入 $b\in[1,100]$ 的 scalar effort。较高 $b$ 会降低长度惩罚,让模型有空间输出更长的推理与探索轨迹;不同 effort 下的样本在各自子组内计算相对优势,而不是直接把低 effort 和高 effort 的回答拿来比较。
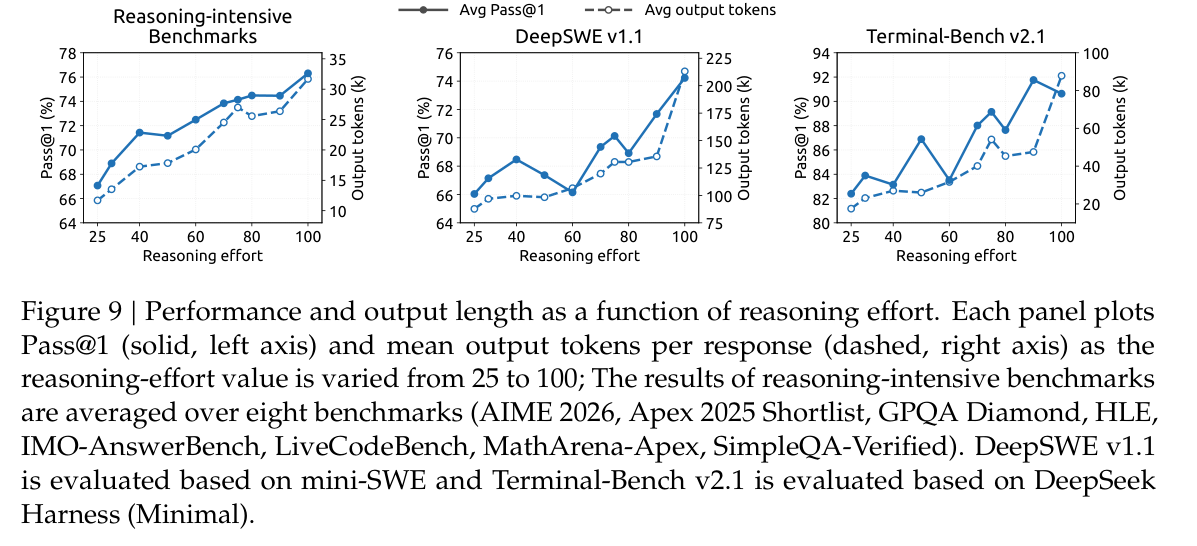
图 9。每个子图的实线对应 Pass@1,虚线对应平均输出 token 数;横轴从 effort 25 增至 100。三个任务上分数都上升,但 token 数也明显增长。报告给出的汇总是:八个推理基准的平均 Pass@1 从 67.1% 到 76.3%,DeepSWE 从 66.0% 到 74.2%,Terminal-Bench 2.1 从 82.4% 到 90.6%,代价约为 2.5 倍输出 tokens。
对实际使用者更有价值的信息在边际收益上:报告认为 effort 60–80 已拿到大部分最大 effort 的准确率,而到 100 时,Agent 轨迹会再长 1.6–1.8 倍,提升则变得有限。因此 API 中 low/high/max 映射为 $b=50/75/100$,应该被看成服务质量与 token 预算的操作点,而不是同一个模型的“免费档位”。

表 4。保持 checkpoint、解码参数和任务集不变,只替换 Claude Code、Codex、OpenCode、Pi、mini-SWE 与 DeepSeek Harness 等外围框架。DeepSWE 的区间为 65.5–74.2,Terminal-Bench 2.1 为 84.1–90.6。它说明模型并未只在某一种框架下工作;但 8 个配置之间仍有明显差距,也说明部署时 scaffold 不是可忽略的“外壳”。
6.3 多 Agent 曲线值得看,但目前仍是初步结果
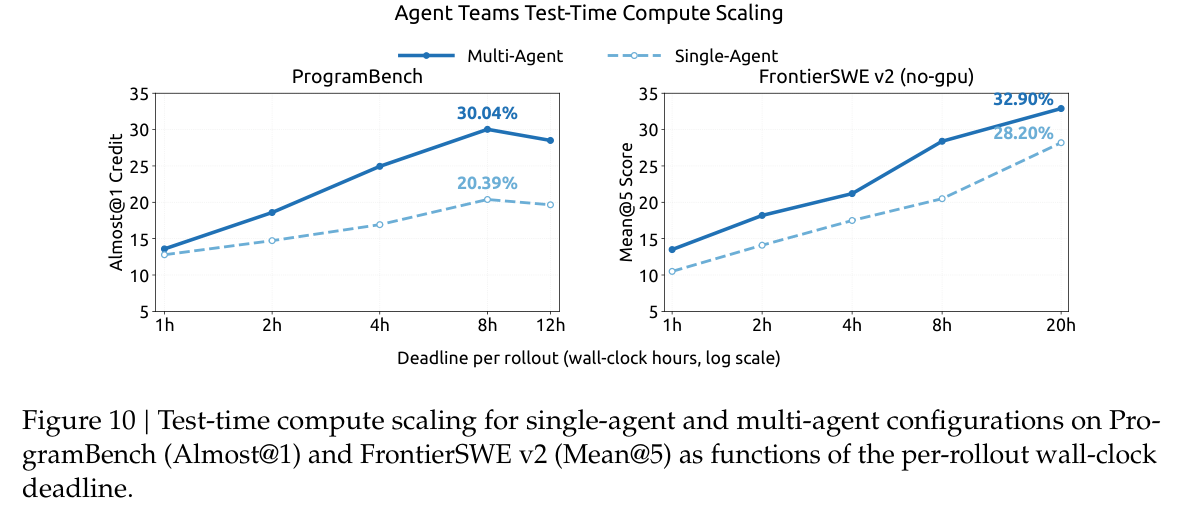
图 10。横轴是每次 rollout 的墙钟时间上限,纵轴分别是 ProgramBench 的 Almost@1 与 FrontierSWE v2 的 Mean@5。两项任务上,多 Agent 曲线都高于单 Agent:ProgramBench 在 8 小时处为 30.04% 对 20.39%,FrontierSWE v2 在 20 小时处为 32.90% 对 28.20%。但这是作者挑选的最强配置之间的 preliminary comparison,不应直接读作“多 Agent 必然更好”。
这部分实验真正传达的是:当任务预算从一次模型回复变成数小时的工具执行,多 Agent 的价值可能来自并行探索和分工,而不是单个模型突然更聪明。但相应地,协调、共享工作区、消息同步和截止时间都会成为算法的一部分。
7. 这份报告真正给出的启发,与仍未回答的问题
7.1 最值得带走的是一套成本建模方式
V4.1 Flash 最有价值的地方,不是某个单独模块,而是它把长上下文 Agent 的成本拆成了可分别优化的对象:
| 约束 | 对应设计 | 解决的不是 |
|---|---|---|
| 新上下文读入太贵 | CED + decoder SWA bounded replay | 单纯减少输出 token |
| 全局 KV 太大 | CSA2 跨层复用 + FP4 KV | 只降低注意力算力 |
| 长上下文检索反复扫描 | Hierarchical Sparse Indexer | 让所有层共享同一检索结果 |
| 缓存要跨回合保留 | 不持久化 SWA KV、恢复时有限重放 | 永久不再计算 |
| 模型在单一工具框架里过拟合 | 多环境、多 scaffold 的 RL | 不需要评测 harness |
这张表也解释了为何“更长 context”本身不是完整答案。上下文窗口做到了 1M,如果缓存必须按层完整保存、每层都重新索引、缓存恢复还要精确重放所有局部状态,服务系统依然会被显存、SSD 与网络拖住。
7.2 它的风险也恰好藏在最省钱的地方
报告的节省都有对应的假设:
- CED 假设 encoder 中间层的表示足以为 decoder 生成有效的全局 KV;
- Reuse Mode 假设相邻层可以共用一批被检索到的位置;
- Hierarchical Sparse Indexer 假设第一层构造的候选池不会漏掉后续层真正需要的信息;
- Bounded Replay 假设只重放一个局部窗口就能近似恢复所需的 SWA 状态;
- FP4 KV 假设极低精度存储不会在关键长程任务上造成不可接受的误差。
这些不是理论上无代价的压缩。报告已把 CSA2 的 selection error 和 Bounded Replay 的近似状态恢复列为尚需继续做压力测试的边界。更完整的后续验证,应该包括:对针尖式长程信息检索的对抗样本、跨缓存恢复点的一致性、不同 I/O 条件下的端到端吞吐,以及真实长任务的成本曲线,而不只是单 token FLOPs 或单一 benchmark。
结语
如果把这份报告只概括成“DeepSeek 又发布了一个更强的 Flash 模型”,会漏掉最重要的部分。它真正处理的是:当 Agent 工作流越来越长时,模型能力之外的 KV Cache 已经变成产品可用性的一部分。
CED 让输入阶段少跑一半左右的全局计算;CSA2 让全局缓存和检索决策在层间以不同粒度复用;Bounded Replay 则把持久化缓存从“完整保存状态”改成“保存更少、需要时小范围重算”。三者拼在一起,才得到报告中运行时全局 KV 约为前代四分之一、持久化 KV 约为前代八分之一的结论。
对做模型服务的人来说,这比一个漂亮的参数量或单项分数更接近实际问题:未来的竞争不只是模型能不能完成任务,也是谁能以可恢复、可迁移、可承受的缓存成本,让它把任务做得足够久。
如果你对 MoE、KV Cache、长上下文推理这些问题感兴趣,可以看看我的新书《大模型基础与前沿:从 Transformer 到 Agent》。书里尝试从 Transformer 的计算图出发,把注意力、推理、训练与 Agent 系统里的概念放在同一套框架下解释;和本文一样,更关心“一个设计究竟在解决哪一类约束”。
