arXiv'26 | VibeVoice-ASR-Streaming:LLM 如何实时转写谁说了什么
arXiv’26 | VibeVoice-ASR-Streaming:LLM 如何实时转写谁说了什么
原文:VibeVoice-ASR-Streaming Technical Report 代码:microsoft/VibeVoice(本文结合仓库
1541f59阅读,模型结构数字取自microsoft/VibeVoice-ASR-Streaming-7B在 HuggingFace 上公开的config.json)
1. 前言
会议字幕这几年已经被打磨得很成熟,单人说话“听到什么写什么”基本够用。真正麻烦的是紧跟在文字后面那半句:这句话是谁说的。只要房间里有两个人以上,Speaker 0 讲完一句,Speaker 1 接上,几分钟后 Speaker 0 又开口——系统必须一直用同一个编号认出他,而且不能等录音结束才回头补标签,因为下游的语音 agent 早就根据这句话做出反应了。这类任务有个专门的名字,叫 streaming speaker-attributed ASR:ASR 负责把语音变成文字,speaker attribution 负责把文字挂到会话里已经出现过的某个说话人身上。这里的“身份”不是真实姓名,而是按出场顺序分配的 Speaker 0、Speaker 1,之后这个人每次再开口都要沿用同一个编号。
最直观的做法是把音频切成 2 秒一段,各自独立跑一次识别。接口简单、吞吐好堆,但两类信息会同时丢掉:语言上下文断在切片边界上,跨块的指代、断句、半个词全靠猜;说话人历史也断了——第 0 段第一次冒出来的声音被叫 Speaker 0,第 15 段这个人回来了,独立请求没有任何依据继续叫他 Speaker 0。传统系统通常在 ASR 外面另挂一个 diarization(说话人分割聚类)模块去补这个缺口:抽 speaker embedding、维护一个 speaker cache、拿新片段去匹配。这确实能工作,但代价是转写和说话人归属变成两套独立状态,标签随时可能被后续证据重新聚类、回写——也就是说,你当下看到的输出,并不是真正意义上的“最终结果”,后面还有一套修正逻辑在悄悄运行。
VibeVoice-ASR-Streaming 想做的,是把“要不要保留会话历史”和“能不能不做事后修正”这两件事,用一个模型同时解决,而不是维持“ASR + 一个外部说话人组件”的老架构。它的做法可以先用一句话概括:把新音频块和模型已经生成的带说话人文本交错写进同一个 LLM 上下文,让说话人编号变成模型自己要维护的上下文状态,而不是外部聚类的产物。
这篇不打算停在“有这么个设计”的层面。下面每一节都会尽量落到具体数字和可以跑起来的代码上:两个语音 encoder 到底输出多少维、怎么和 LLM 的 3584 维 embedding 对上;一个 chunk 的窗口边界具体切在哪一秒;训练数据是怎么按词级时间切成逐块目标的;K/V 缓存是怎么一格一格长起来、又为什么没有回头改的余地。手上没有下载 7B 的权重,所以模型本身的文字预测能力没法在这篇文章里复现,但架构里所有”纯计算”的部分——窗口怎么滑、维度怎么变、缓存怎么长——都可以用真实的维度和真实的切分规则跑一遍给你看。
2. 核心机制:交错序列,把历史变成模型自己的状态
第 $k$ 个音频块记为 $X_k$,对应输出记为 $Y_k$,模型看到的是:
提示词, X0, Y0, X1, Y1, X2, Y2, ...
生成当前 $Y_k$ 时,条件写成:
\[p(Y_k \mid X_{<k}, \widetilde{X}_k, Y_{<k})\]其中 $X_{<k}$ 是此前已经听过的音频,$Y_{<k}$ 是此前已经写出的文字和 Speaker 编号,$\widetilde{X}_k$ 是当前负责的音频块再加上一小段 look-ahead(第 5 节展开)。这条式子表达的是一个具体分工:历史用于延续会话状态,look-ahead 用于降低当前边界的不确定性。 生成的 $Y_k$ 不是旁路结果,而是直接成为下一轮的上下文——具体是怎么“成为上下文”的,本质上就是一次 K/V 缓存的追加,第 6 节会用代码把这个追加过程画出来。
下面的架构图中,蓝色连续 latent 和文本 token 交替进入同一个自回归模型;不是“一个声学模型先出结果,再让语言模型另行润色”。
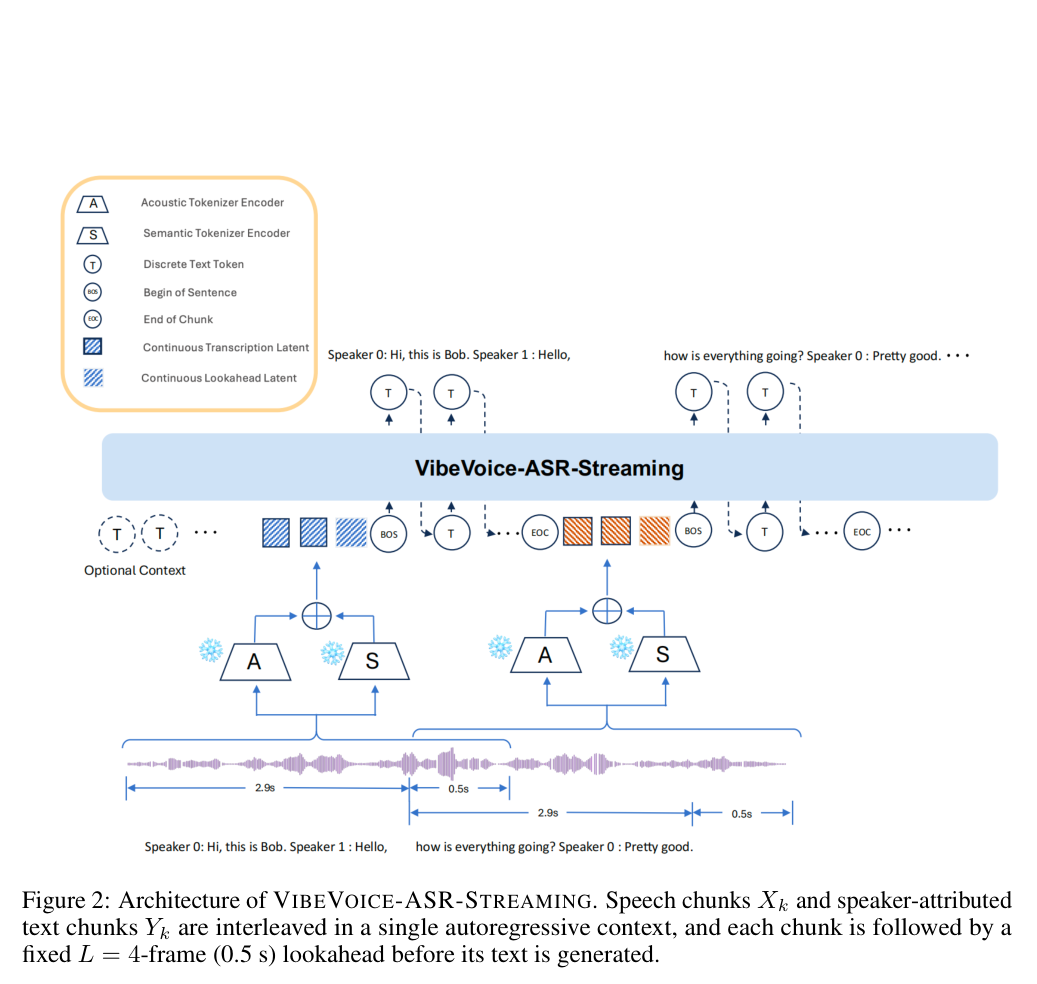
按图从下往上读会比较清楚。最底部是原始波形,第一段括号标出本轮新增的 2.9 秒,右侧斜线区域是额外读取的 0.5 秒前瞻。波形先分别经过两个 encoder(第 3 节会给出它们各自输出多少维、怎么进 LLM),两个小圆圈表示同一时刻的两路特征合并成一个 latent frame。中间的 BOS、连续蓝色 latent、EOC 组成当前音频输入,EOC(end of chunk)告诉 LLM:这一段声音已经结束,可以开始生成文字。最上方的文本 token 是模型自回归生成的 Speaker 0: ...、Speaker 1: ...;生成完一个块后,下一块音频接在同一条序列后面。图左侧的 optional context 是名字、术语、缩写等提示词,它在开头加入,之后和音频、文本历史一起保留。
保留历史这件事,论文强调是任务本身的要求,不是一个可选的优化:一个丢弃历史的系统,必须在别处把历史找回来——外部 embedding 库、speaker cache,或者一次离线聚类,这恰好是这个方案想去掉的独立阶段。代价也很直接:上下文随录音时长线性增长,因此发布的 checkpoint 目前只支持约 8 分钟的会话,第 11 节还会再谈这个限制。
3. 语音怎么变成模型能读的向量:真实维度,以及一个和论文描述不完全一致的细节
先回答一个容易被跳过的问题:图里那两路进入 latent frame 的分支,是模型,还是只是某种固定的分词规则?答案是——它们是两个独立训练好的神经网络,训练这件事根本不发生在这篇论文里。
这两个 encoder 叫 Acoustic tokenizer 和 Semantic tokenizer,来自另一篇论文,也就是 VibeVoice 语音合成技术报告([PYW+25])。在那篇报告里,它们都是“encoder + decoder”成对出现的:encoder 把波形压成连续 latent,decoder 再把 latent 还原成波形,服务于文本到语音合成。VibeVoice-ASR-Streaming 只取用其中的 encoder 半部分,而且在本文的全部训练过程中始终冻结、不参与梯度更新——真正被训练的只有 Qwen2.5 这个 LLM backbone。
真实的维度可以直接从 HuggingFace 上公开的 config.json 里读出来,不用猜:
| 模块 | 关键字段 | 数值(7B 配置) |
|---|---|---|
| Acoustic tokenizer | vae_dim | 64 |
| Semantic tokenizer | vae_dim | 128 |
| 两个 tokenizer 共用 | encoder_ratios | [8, 5, 5, 4, 2, 2],连乘 = 3200,对应 3200× 下采样 |
| 两个 tokenizer 共用 | encoder_depths | 3-3-3-3-3-3-8,7 个阶段,每阶段是若干层 depthwise convolution 组成的残差块,用 RMSNorm 归一化 |
| Qwen2.5 backbone(7B) | hidden_size / num_hidden_layers | 3584 / 28 层,28 个 attention head、4 个 KV head(GQA),intermediate_size 18944 |
| Qwen2.5 backbone(1.5B) | hidden_size / num_hidden_layers | 1536 / 28 层,12 个 attention head、2 个 KV head |
Acoustic tokenizer 输出 64 维、Semantic tokenizer 输出 128 维,这两个数字不相等,本身就说明它们不是同一种特征的两份拷贝:Acoustic 是 σ-VAE(变分自编码器,来自 [SBW+24])设计,输出一个连续隐变量分布,用来保留频谱、音色、韵律等声学细节;Semantic 输出的是确定性特征(不做 VAE 式随机采样),天然更贴近文字内容。两者的下采样率完全一致——encoder_ratios 连乘 8×5×5×4×2×2=3200,对应到 24 kHz 波形就是每 133.3 ms(3200/24000 秒)产生一帧,7.5 帧/秒。
真正有意思的是这两路 64 维和 128 维特征怎么变成 LLM 认识的向量。论文原文的说法是“两路表示沿特征维拼接,再投影进 Qwen2.5 的 embedding 空间”——听起来像是 concat(64, 128) → Linear(192, 3584) 这种一次性投影。但仓库里 SpeechConnector 的实现是这样的:
# vibevoice/modular/modeling_vibevoice_streaming.py
# class SpeechConnector
class SpeechConnector(nn.Module):
    def __init__(self, input_dim, output_dim):
        super().__init__()
        self.fc1 = nn.Linear(input_dim, output_dim)
        self.norm = LlamaRMSNorm(output_dim, eps=1e-6)
        self.fc2 = nn.Linear(output_dim, output_dim)

    def forward(self, features, **kwargs):
        x = self.fc1(features)
        x = self.norm(x)
        x = self.fc2(x)
        return x
# vibevoice/modular/modeling_vibevoice_asr.py
# class VibeVoiceASRModel(构造函数),约第 84 行
self.acoustic_connector = SpeechConnector(config.acoustic_vae_dim, lm_config.hidden_size)
self.semantic_connector = SpeechConnector(config.semantic_vae_dim, lm_config.hidden_size)
# vibevoice/modular/modeling_vibevoice_asr.py
# encode_speech(...) 末尾,约第 333 行
combined_features = acoustic_features[speech_masks] + semantic_features[speech_masks]
也就是说,Acoustic 的 64 维和 Semantic 的 128 维各自先经过一个“Linear → RMSNorm → Linear”的两层 connector,独立投影到 3584 维(7B 配置),投影完之后是逐元素相加,不是先拼接再投影。这两种做法不是等价的:先拼接再过一个线性层,等价于两路特征各自乘一个权重矩阵再相加,是一个线性组合;而这里每一路先各自过完整的两层 MLP(中间还夹了一次归一化)才相加,两路特征在被“融合”之前已经各自经过一次非线性变换。论文里“concatenate”是对整体设计意图的概括描述,实际实现是两个独立 connector 分别升维再相加——这个细节只有读代码才能看到。
用真实维度把这一步在本地跑一遍(不需要下载 7B 权重,两个 connector 用随机初始化代替,只是为了验证维度和计算顺序):
import torch, torch.nn as nn

ACOUSTIC_VAE_DIM, SEMANTIC_VAE_DIM, HIDDEN_SIZE = 64, 128, 3584

class SpeechConnector(nn.Module):
    def __init__(self, input_dim, output_dim):
        super().__init__()
        self.fc1 = nn.Linear(input_dim, output_dim)
        self.norm = nn.RMSNorm(output_dim, eps=1e-6)
        self.fc2 = nn.Linear(output_dim, output_dim)
    def forward(self, x):
        return self.fc2(self.norm(self.fc1(x)))

acoustic_connector = SpeechConnector(ACOUSTIC_VAE_DIM, HIDDEN_SIZE)
semantic_connector = SpeechConnector(SEMANTIC_VAE_DIM, HIDDEN_SIZE)

WINDOW_FRAMES = 26  # 22 帧 chunk + 4 帧 lookahead,第 5 节会解释这两个数字
acoustic_latent = torch.randn(1, WINDOW_FRAMES, ACOUSTIC_VAE_DIM)
semantic_latent = torch.randn(1, WINDOW_FRAMES, SEMANTIC_VAE_DIM)

acoustic_features = acoustic_connector(acoustic_latent)
semantic_features = semantic_connector(semantic_latent)
combined_features = acoustic_features + semantic_features   # 逐元素相加,不是 concat
print(combined_features.shape)   # torch.Size([1, 26, 3584])
实际打印出来是:
acoustic_latent : torch.Size([1, 26, 64])
semantic_latent : torch.Size([1, 26, 128])
acoustic_features (fc1->norm->fc2 之后): torch.Size([1, 26, 3584])
semantic_features (fc1->norm->fc2 之后): torch.Size([1, 26, 3584])
combined_features (逐元素相加,不是 concat): torch.Size([1, 26, 3584])
audio_embeds (BOS + 26 帧 latent + EOC): torch.Size([1, 28, 3584])
最后一行的 audio_embeds 是把这 26 帧再前后各拼一个边界 token 的 embedding:起始边界复用的是 Qwen2.5-VL 词表里原本给视觉用的 <|object_ref_start|>(id 151646),结束边界是 <|object_ref_end|>(id 151647)——图里的 BOS/EOC 具体就是这两个 token,只是被 VibeVoice 拿来标记“一段语音的开始/结束”而不是图像区域。这一整条 28 长的向量序列,就是一次 forward 真正喂给 Qwen2.5 的“音频输入”。
所以“15 帧”“22 帧”“4 帧”不是抽象的模型 token 数,而是明确的时间预算:每帧固定对应 133.3 ms 音频。仓库的 ChunkGeometry.from_pretrained() 会从 checkpoint 的 preprocessor_config.json 读取 chunk_frames 和 lookahead_frames(7B、22-frame 配置读到的正是 22 和 4),这不是配置洁癖——训练分布已经绑定了窗口长度和边界语义,拿 15-frame 模型按 22-frame 的节奏运行,即使 tensor shape 不报错,也已经改变了模型学到的输入输出契约。
4. 说话人怎么区分:先看训练目标怎么构建,再看模型怎么用它
这一节要拆两个问题:一个 chunk 里出现两个甚至更多说话人,文本是怎么组织的;模型又是凭什么把新出现的声音和几分钟前的某个编号对上。前一半是可以精确复现的机械规则,后一半是训练出来的能力,没有 7B 权重没法真的跑一遍“模型认出了谁”,但可以把它学习时看到的监督信号原原本本摆出来。
先看规则。 论文 3.2 节给的词级切分规则是:先用 Qwen3-ForcedAligner-0.6B(一个独立的强制对齐小模型,只在构造训练目标时用,推理时不需要)跑出每个词的结束时间,再判断——“一个词属于 chunk k,如果它的结束时间落在 chunk k 的边界之前,允许 0.1 秒容差”。这个规则可以直接用代码复现,不需要真实模型:
CHUNK_DUR, TOLERANCE = 2.9333, 0.1   # 22 帧 chunk,7B/22-frame 配置的真实时长

def assign_chunk(word_end_time, chunk_dur=CHUNK_DUR, tol=TOLERANCE):
    k = 0
    while word_end_time > (k + 1) * chunk_dur + tol:
        k += 1
    return k
拿一段自己编的两人对话(speaker, word, 词结束时间)喂给它,再把落在同一个 chunk、同一个说话人的连续词拼成一段、说话人切换就换一行 \n Speaker k:——这正是附录 A 里那份解码轨迹的构造方式:
words = [
    ("S0", "Okay,", 0.42), ("S0", "let's", 0.71), ("S0", "start", 1.05),
    ("S0", "with", 1.24), ("S0", "the", 1.38), ("S0", "deployment", 1.94), ("S0", "plan.", 2.31),
    ("S1", "Sure.", 3.62), ("S1", "I", 3.81), ("S1", "think", 4.05), ("S1", "we", 4.20),
    ("S1", "should", 4.48), ("S1", "first", 4.79), ("S1", "verify", 5.21), ("S1", "the", 5.38),
    ("S1", "latency", 5.86), ("S1", "on", 6.62), ("S1", "the", 6.75), ("S1", "meeting", 7.10), ("S1", "set.", 7.43),
    ("S0", "Agreed.", 8.05), ("S0", "We", 8.21), ("S0", "can", 8.39), ("S0", "run", 8.58),
    ("S0", "that", 8.79), ("S0", "today.", 9.24),
]
chunks = {}
for spk, w, end_t in words:
    chunks.setdefault(assign_chunk(end_t), []).append((spk, w))
跑出来的结果是:
chunk  0: " \n Speaker 0:Okay, let's start with the deployment plan."
chunk  1: " \n Speaker 1:Sure. I think we should first verify the latency"
chunk  2: " \n Speaker 1:on the meeting set. \n Speaker 0:Agreed. We can run that"
chunk  3: " \n Speaker 0:today."
chunk 2 正好落在 Speaker 1 说完“set.”、Speaker 0 又接上“Agreed.”的位置,于是一个 chunk 里出现了两段、换了一次标签——这就是“一个 chunk 里有多个说话人”在训练数据层面的样子:不是靠额外规则判断,纯粹是词的结束时间落到了哪个 2.9333 秒的区间里。如果某个 chunk 区间里恰好没有任何词落进去(比如长时间沉默),这条规则会自然产出一个空字符串,对应论文附录 A 里 chunk 4 : "" 那一行;训练时 <|text_chunk_end|> 在这种空 chunk 上照样被监督,模型因此学到的是“每个 chunk 都要给一个判断,哪怕是空的”,而不是“遇到没内容的块就跳过”。
再看模型怎么用它。 编号分配的规则很直接:按第一次出现的顺序编号(Speaker 0、Speaker 1……),后面同一个人再开口,继续用这个编号,不重新分配,也没有真实姓名。支撑这件事的完全是“历史文字仍留在上下文里”:LLM 在预测第 12 个 chunk 该写 Speaker 几时,能看到前面 11 个 chunk 里每一句话对应的音频和文字(第 2 节的交错序列),可以综合声学线索(音色、语调,来自 Acoustic tokenizer 的特征)、语言线索(措辞、话题连续性)和对话结构(轮次切换的位置)一起判断——本质上是一次 next-token 预测,而不是提取一个声纹向量去缓存里找最近邻。这个判断能力是训练出来的:模型在约 42 万小时(Stage 2)加约 1.3 万小时(Stage 3)的多说话人语音上,被反复要求在千变万化的声音、话题、轮次组合里做出这个判断,没有一个显式的“相似度阈值”或“聚类算法”可以写成伪代码,这也是为什么这一段没法像上面的切分规则一样简单复现——它是 28 层 Transformer 权重里的东西,不是一段可以抽出来单独运行的逻辑。
那两个人真的同时开口呢?论文没有回避,明确列为限制:输出终究是一条文本流,解码器必须把重叠语音串行化成前后相继的片段,不能并行输出两条流。Limitations 一节原话是“长时间重叠会让性能下降,因为解码器必须把重叠语音串行化进单一输出流”,并把 separation-aware 表示或 multi-stream 解码列为未来工作。训练数据里合成的短暂多人重叠(抢话、附和,第 7 节会提到怎么合成)能让模型学到一个说得过去的顺序,但长时间、多人持续同时说话,不是这篇论文已经解决的问题。
5. Look-ahead 和更新粒度:一次 forward 到底吃进多少音频,多久才提交一次
假设当前输出覆盖 0.0–2.93 秒。若模型只看到这段音频,2.93 秒处的“我觉得这个方案……”可能有三种后续:下一句是“可以”、是“不行”,或者说话人已经换了。没有边界右侧的证据,系统必须在最不确定的位置提前做决定。VibeVoice 的做法是:在生成当前块的文字前,再读取未来 $L=4$ 个 latent frame,对应约 0.5 秒:
\[T_{\text{lookahead}}=4\times\frac{3200}{24000}\approx0.5\text{ s}\]这半秒只用于决定上一块如何结束、以及边界附近的说话人归属,不会把未来半秒的文字提前输出。真实的窗口滑动关系用第 3 节确认过的 chunk_frames=22、lookahead_frames=4、frame_samples=3200、sample_rate=24000 这几个数字,直接可以算出来,不用猜:
FRAME_DUR = 3200 / 24000                 # 0.1333 s / 帧
CHUNK_DUR = 22 * FRAME_DUR               # 2.9333 s,本轮新增音频
LOOKAHEAD_DUR = 4 * FRAME_DUR            # 0.5333 s,前瞻
WINDOW_DUR = CHUNK_DUR + LOOKAHEAD_DUR    # 3.4667 s,单次 forward 真正吃进的音频

t = 0.0
for chunk_idx in range(4):
    window = (t, min(t + WINDOW_DUR, 10.0))
    commit = (t, min(t + CHUNK_DUR, 10.0))
    print(chunk_idx, "窗口", window, "提交", commit)
    t += CHUNK_DUR   # 注意:往前推进的是 CHUNK_DUR,不是 WINDOW_DUR
对一段 10 秒音频跑出来是:
chunk |  窗口起点  |  窗口终点  |     本轮真正提交的时间段
    0 |    0.000  |    3.467  | [0.000, 2.933)
    1 |    2.933  |    6.400  | [2.933, 5.867)
    2 |    5.867  |    9.333  | [5.867, 8.800)
    3 |    8.800  |   10.000  | [8.800, 10.000)
这张表把“窗口”和“时间推进”的区别摆得很清楚:chunk 0 的窗口一直读到 3.467 秒,但它只对 [0.000, 2.933) 这段负责;chunk 1 的窗口从 2.933 秒开始——正是 chunk 0 窗口的末尾——往后再读到 6.400 秒,其中 [2.933, 3.467) 这 0.533 秒的音频,chunk 0 已经拿它当过一次“前瞻”,chunk 1 会把它当作正式内容重新处理一遍。窗口有重叠,时间边界不重叠,模型因此能看到边界右侧的证据,又不会把同一段声音的文字交付两次。
前瞻不是越大越好,也不是免费的。固定 22-frame、7B 模型测试 $L=0,2,4$ 时,每增加 2 帧要多付出 0.267 秒期望延迟;五套评测的平均 WER/CER(不考虑说话人的词/字错误率,越低越好)从 27.18 降到 25.91、再到 24.66,cpWER/cpCER(在此基础上还考察话有没有挂到正确说话人名下,同样越低越好)从 35.88 降到 34.09、再到 31.55。
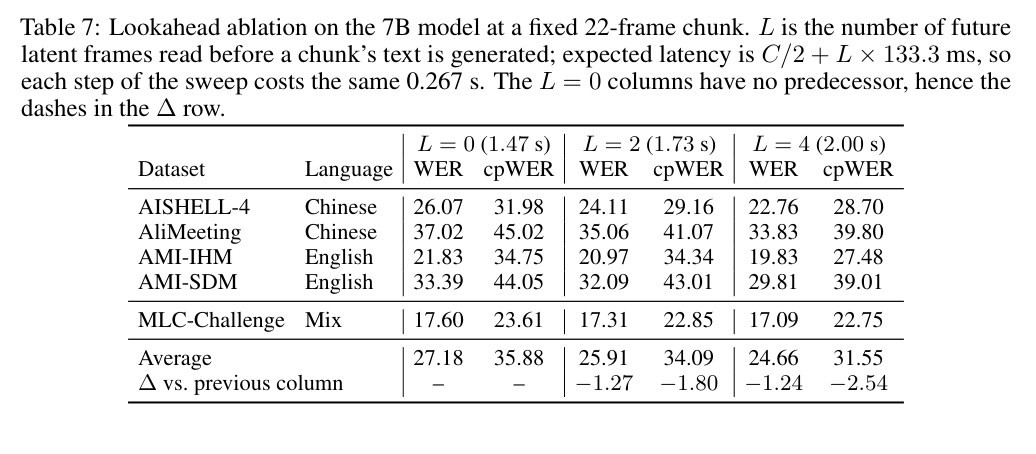
读这张表时先看表头:横向三组分别是 $L=0$、$L=2$、$L=4$,括号里的 1.47 s、1.73 s、2.00 s 是对应的期望延迟;每组里面左列是普通 WER,右列是带说话人归属的 cpWER。底部的 Δ vs. previous column 直接给出每增加两帧带来多少改善:第一步(0→2 帧)WER/CER 改善 1.27、cpWER/cpCER 改善 1.80;第二步(2→4 帧)分别是 1.24 和 2.54。最后两帧对 cp 指标的改善比对普通识别的改善更大,而且是持续上升而非收敛,这支持一个具体判断:边界右侧的信息对“谁在说”尤其重要,而且在 $L=4$ 处仍未见顶,这也是发布配置选择读 4 帧而不是更少的原因。
再说更新粒度:这个粒度不在模型内部——LLM 内部确实是逐 token 自回归生成的——而在下游每次能拿到一批新结果的边界在哪,这个边界就是上面表里“提交”那一列的宽度,2.9333 秒一格,不会更细。在一个 chunk 的窗口还没读完之前,模型不会开始生成这个 chunk 对应的文字,生成过程中也不会把这段文字拆成“先给一半、再补一半”的中间结果——解码到 <|text_chunk_end|> 才算这一块完成。首包(第一次看到任何输出)要等满整个窗口,也就是表里 chunk 0 的 3.467 秒,论文按帧数取整报告为 3.5 秒;后续每一轮的刷新间隔固定是 2.9333 秒,但论文报的 2.00 秒“期望算法延迟”不是刷新间隔,而是一个词从被说出到它的说话人标签稳定下来、平均要经过的时间——一个词可能落在 chunk 中间任意位置,平均要等半个 chunk($C/2$)才能被这一块的生成覆盖到,再加上 0.5 秒前瞻,所以是 $C/2+T_{\text{lookahead}}$,不是 $C$ 本身。
这个刷新粒度是训练和推理都固定死的 chunk contract,不是可以在推理时随意调小的旁路参数:15-frame 和 22-frame 是两个独立训练出来的 checkpoint,各自的 preprocessor_config.json 记着不同的 chunk_frames,粒度变了,模型学到的边界语义也变了。服务端的解码速度也不是瓶颈:7B 模型 15-frame 配置下,单块 decode 只需 146–208 ms,远小于 2000 ms 的 chunk 时长,real-time factor(处理耗时除以音频时长,低于 1 才能跟上实时输入)在 0.073–0.104 之间。真正决定“多久能看到新结果”的是 chunk + look-ahead 这个协议本身,不是算力。
6. 一次提交、不再修改:K/V 缓存怎么长,以及和 Google STT 的 D0/Dfin 对比
论文里出现过“revise”这个词,但主语不是 VibeVoice-ASR-Streaming,而是作为对比基线的 Google Cloud Speech-to-Text,这一点值得单独说清楚,因为容易被读成“这篇论文的模型会先给一个粗糙结果,再自己回头纠错”——实际情况正好相反,而且“不纠错”不是一句设计口号,是可以在 K/V 缓存的增长方式上直接看到的机械事实。
先看这个机械事实。仓库里 streaming_generate 的每一轮都在做同一件事:把这一轮的 audio_embeds 追加到 past_key_values 后面,逐 token 生成直到 <|text_chunk_end|>,再把这个结束符也追加进去——全程只有追加,没有任何一步会回头修改前面已经写入缓存的位置。用一个 2 层的玩具 transformer(参数随机初始化,没有下载 7B 权重,所以解码出来的 token 没有语言意义,这里只演示缓存怎么增长)可以把这件事跑出来看:
import torch, torch.nn as nn, math

HIDDEN, N_HEADS, VOCAB = 64, 4, 200

class TinyCausalBlock(nn.Module):
    def __init__(self):
        super().__init__()
        self.head_dim = HIDDEN // N_HEADS
        self.qkv = nn.Linear(HIDDEN, HIDDEN * 3)
        self.out = nn.Linear(HIDDEN, HIDDEN)
        self.norm = nn.RMSNorm(HIDDEN)

    def forward(self, x, past_kv=None):
        B, T, _ = x.shape
        qkv = self.qkv(self.norm(x)).view(B, T, 3, N_HEADS, self.head_dim)
        q, k, v = qkv[:, :, 0], qkv[:, :, 1], qkv[:, :, 2]
        if past_kv is not None:
            k = torch.cat([past_kv[0], k], dim=1)
            v = torch.cat([past_kv[1], v], dim=1)
        attn = (q.transpose(1, 2) @ k.transpose(1, 2).transpose(-1, -2)) / math.sqrt(self.head_dim)
        o = (attn.softmax(-1) @ v.transpose(1, 2)).transpose(1, 2).reshape(B, T, HIDDEN)
        return x + self.out(o), (k, v)

class TinyStreamingLM(nn.Module):
    def __init__(self, n_layers=2):
        super().__init__()
        self.embed = nn.Embedding(VOCAB, HIDDEN)
        self.blocks = nn.ModuleList([TinyCausalBlock() for _ in range(n_layers)])
        self.lm_head = nn.Linear(HIDDEN, VOCAB)

    def forward(self, inputs_embeds, past_key_values=None):
        x, new_pkv = inputs_embeds, []
        for i, block in enumerate(self.blocks):
            x, kv = block(x, past_key_values[i] if past_key_values else None)
            new_pkv.append(kv)
        return self.lm_head(x), new_pkv

model = TinyStreamingLM()
TEXT_CHUNK_END_ID, AUDIO_EMBEDS_PER_CHUNK = 199, 28   # 28 = 第 3 节算出的 BOS+26帧+EOC

_, past_kv = model(model.embed(torch.randint(0, VOCAB, (1, 12))))   # 玩具 prompt
cache_len = 12
for chunk_idx in range(4):
    logits, past_kv = model(torch.randn(1, AUDIO_EMBEDS_PER_CHUNK, HIDDEN), past_kv)
    cache_len += AUDIO_EMBEDS_PER_CHUNK
    frozen = cache_len   # 追加 audio_embeds 之后,这些位置的 K/V 立刻冻结
    n_new = 0
    next_logits = logits[:, -1:, :]
    for _ in range(6):
        next_id = int(torch.argmax(next_logits[0, -1]))
        if next_id == TEXT_CHUNK_END_ID:
            break
        next_logits, past_kv = model(model.embed(torch.tensor([[next_id]])), past_kv)
        cache_len += 1
        n_new += 1
    _, past_kv = model(model.embed(torch.tensor([[TEXT_CHUNK_END_ID]])), past_kv)
    cache_len += 1
    print(f"chunk {chunk_idx}: cache 长度 -> {cache_len},"
          f"其中前 {frozen - AUDIO_EMBEDS_PER_CHUNK} 个位置在这一轮里完全没被重新计算")
跑出来是:
prompt 之后:past_key_values 长度 = 12
chunk 0: 喂入 audio_embeds 后 cache 长度 = 40  (新增 28)
        生成 6 个文本 token + 1 个 <|text_chunk_end|>,cache 长度变为 47
        —— 前面 12 个位置的 K/V 完全没有被重新计算,chunk 0 一旦写完就冻结了
chunk 1: 喂入 audio_embeds 后 cache 长度 = 75  (新增 28)
        生成 6 个文本 token + 1 个 <|text_chunk_end|>,cache 长度变为 82
        —— 前面 47 个位置的 K/V 完全没有被重新计算,chunk 1 一旦写完就冻结了
chunk 2: 喂入 audio_embeds 后 cache 长度 = 110  (新增 28)
        生成 6 个文本 token + 1 个 <|text_chunk_end|>,cache 长度变为 117
        —— 前面 82 个位置的 K/V 完全没有被重新计算,chunk 2 一旦写完就冻结了
chunk 3: 喂入 audio_embeds 后 cache 长度 = 145  (新增 28)
        生成 6 个文本 token + 1 个 <|text_chunk_end|>,cache 长度变为 152
        —— 前面 117 个位置的 K/V 完全没有被重新计算,chunk 3 一旦写完就冻结了
这就是“一次提交、不再修改”的字面意思:Speaker k: 这个标签一旦作为某个 token 的 embedding 被写进 past_key_values,它对应的 K/V 向量在后续所有轮次里只会被新 token 拿来做 attention 的“被查询对象”,永远不会被重新计算或覆盖。想要修改一个已经提交的标签,唯一的办法是把那部分缓存整个扔掉、从那个位置重新跑一遍前向——而这正是 VibeVoice-ASR-Streaming 的推理循环里没有写的一条分支。
对比一下 Google Cloud Speech-to-Text 的做法,就能看出“不写这条分支”省掉的是什么。Google STT 在实时转写时会先给一个说话人标签,记作 D0(首次输出时的标签);等整段录音处理完,再基于全局信息重新聚类、修正标签,记作 Dfin(最终修订标签)——这本质上就是上面那个“把缓存扔掉重算”的操作,只是发生在一个显式的、独立的后处理阶段。论文测出来这个“回头改”的代价相当大:文字大约 1.5 秒就基本稳定,但说话人标签的中位数还要再改 16.5 到 31.3 秒才收敛;42.6%–67.9% 的词,标签在首次输出后至少被改过一次;哪怕给 30 秒的“修正预算”,也只有 66.4%(AMI-IHM)、66.8%(AMI-SDM)、78.4%(MLC 英语部分)的标签能追上 Dfin 的最终结果。论文汇总表里给出的整体平均延迟是:Azure Conversation Transcriber 8.21 秒,Google STT 的 D0 为 9.12 秒、Dfin 为 51.06 秒,VibeVoice 为 2.00 秒——这 51 秒不是录音本身变长,而是标签修正过程本身消耗的时间。修正带来的准确率差距也很直接:用 D0 算英语 cpWER 是 60.57,等到 Dfin 收敛之后,同样的文字配上修正过的标签,cpWER 降到 28.40——差距接近一半。
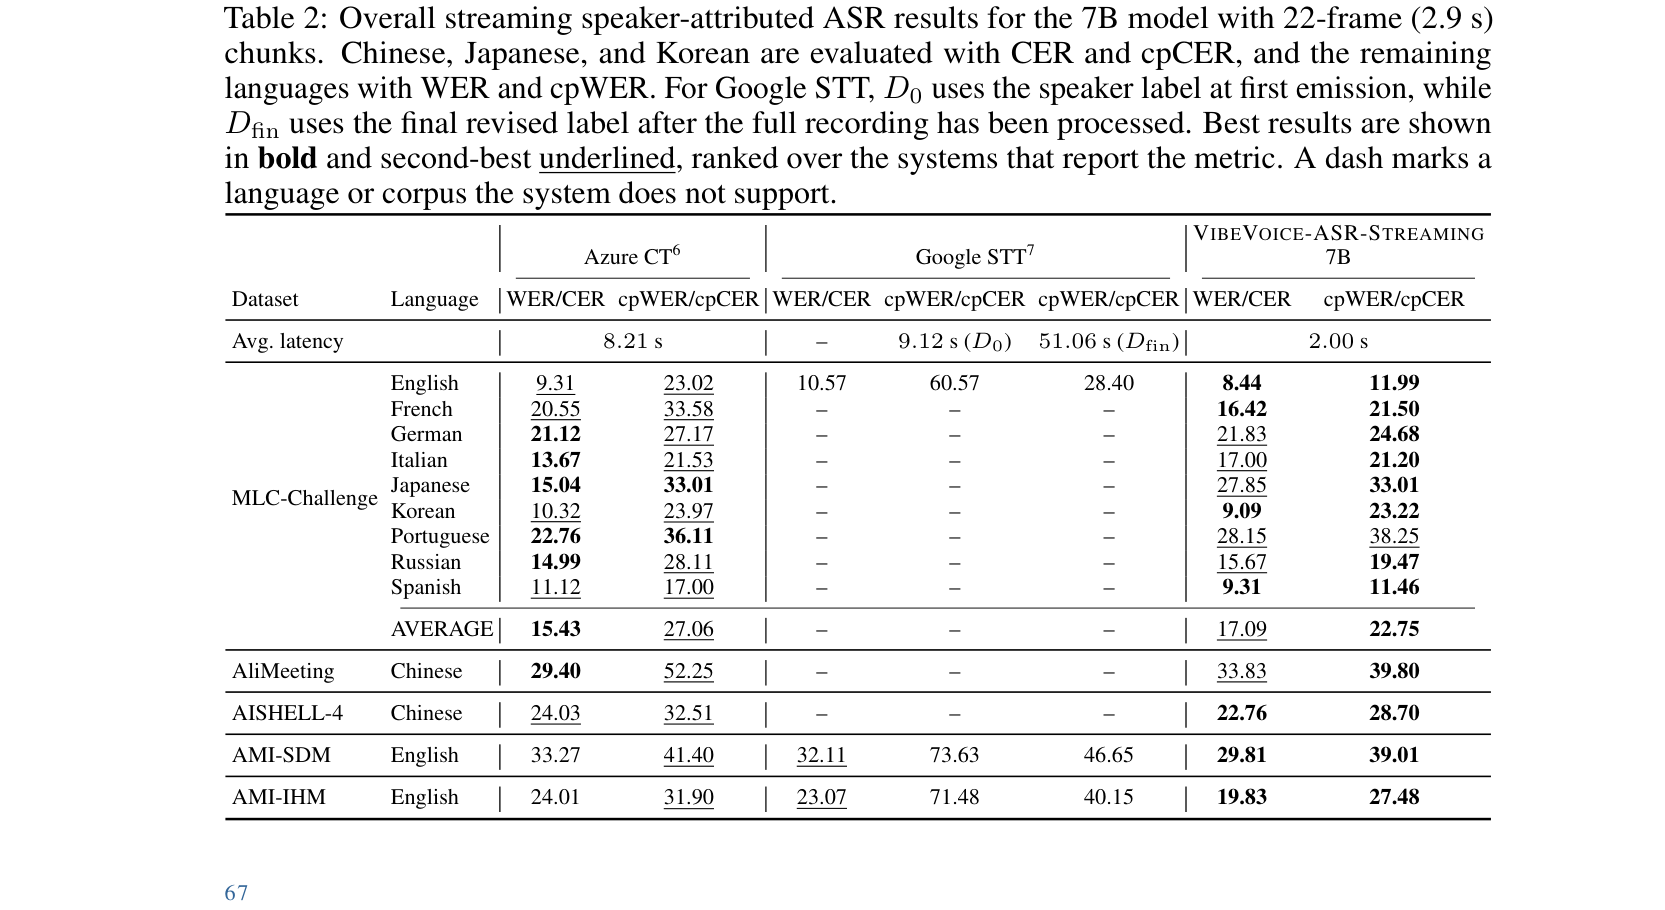
这张表需要先看三组系统列:Azure CT 只有一组 WER/CER 和 cpWER/cpCER;Google STT 中间是 D0 对应的 WER/cpWER,右侧多给出 Dfin 对应的 cpWER;VibeVoice 在最右侧同时报告普通识别和说话人归属。最上面的 Avg. latency 一行就是刚才那几个数字。VibeVoice 在能对比的设置上(比如 AMI-IHM cpWER 27.48、AMI-SDM cpWER 39.01)仍优于或接近 Google STT 的 Dfin,同时把整体延迟从 9–51 秒压到 2 秒左右——不是“因为不纠错所以更快但更不准”,而是在能对比的设置里数字反而更好,这正是论文强调 13 项设置里 12 项 best-or-tied-best 的来源之一。
这也解释了论文另一组实验:把 speaker label 放在片段文字前面(Head,发布配置)和放在末尾(Tail)对比。如果标签完全依赖“攒够声音再决定”的声纹聚类逻辑,等整段说完再输出似乎应该更有利;但结果是五套数据平均 cpWER/cpCER 几乎一样,31.55 对 31.56,Tail 的普通 WER/CER 反而高 0.98 个点。
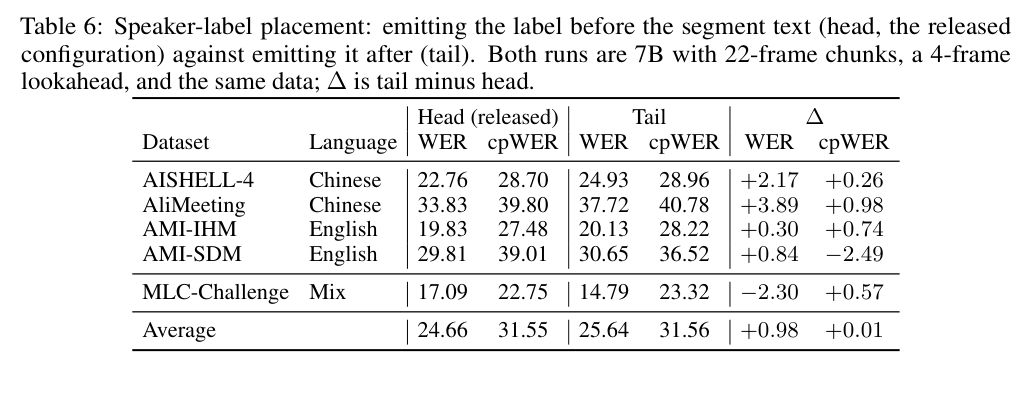
表头的 Head 表示先输出 Speaker k: 再输出这段话,Tail 表示先输出文字、等片段结束后再补标签;最右侧的 $\Delta$ 是 Tail 减 Head,正数代表尾置更差。逐行看方向并不完全一致(AMI-SDM 的 cpWER 尾置反而低 2.49),最终五集平均几乎抵消。这和上面 K/V 缓存的事实是同一回事:模型的说话人判断从一开始就同时依赖声学证据和文字/对话上下文,不是一个先攒够声音再决定的纯声纹聚类过程,所以没有必要等,也没有“等了会更准”的空间。
7. 训练怎么让模型学会这套协议
如果只在推理时切音频,模型并不会自动学会“每个块输出到这里就停”,也不会自动学会“看到新块也要保持标签一致”。因此作者不只是改变推理脚本,而是分三阶段组织训练样本:
- Stage 1(非流式训练):模型先在离线 speaker-attributed 设定下训练——完整录音在生成前整段可见。这一步建立基本的多说话人识别和归属能力,不带任何流式约束,对应的正是先前发布的 VibeVoice-ASR([PYC+26]):论文里 Table 4 拿来对比的 non-streaming VibeVoice-ASR checkpoint,就是这一阶段(同规模)的产物,后续两阶段都从它初始化,不需要从零训练。
- Stage 2(streaming pre-training):从 Stage 1 checkpoint 初始化,把样本组织成 $X_0,Y_0,X_1,Y_1,\dots$,每个音频块带固定前瞻;架构、可训练模块和训练目标都和 Stage 1 相同,只是输入组织方式变了——也就是第 4 节那段切分代码产出的格式。使用约 42 万小时中英文语音(取自 Stage 1 语料的子集),让这种交错格式成为模型的默认工作模式。
- Stage 3(streaming fine-tuning):用约 1.3 万小时精选、合成和公开数据,收敛转写规范、Speaker 编号一致性和热词遵循等用户可见行为。
训练目标中的关键 token 是 <|text_chunk_end|>(真实 id 是 151665,来自released tokenizer 的 added_tokens.json)。每个 $Y_k$ 最后都监督它,包括第 4 节提到的静音、目标文本为空的 chunk。生成到这个 token,模型就向音频流发出“本块完成”的信号,系统才追加下一块音频;输出长度没有预先给定,何时停止本身是模型要学习的预测。
第 4 节的合成数据部分(50,884 段录音、共 4,519.6 小时增强多说话人语音)额外加入专业术语、口语读法与书面规范的差异、多人 overlap 和 room impulse response(模拟房间混响与麦克风响应),确保“重叠语音怎么排序”这件事也有真实的监督来源,第 4 节说的短暂重叠处理能力正是从这里来的。
8. 源码里的一个 turn:真正的 7B 模型上跑的是同一套逻辑
上一节的玩具模型演示的是缓存怎么增长;仓库里 streaming_generate 跑在真正的 Qwen2.5 backbone 上,逻辑和玩具版一一对应,只是 past_key_values 里装的是第 3 节算出来的 3584 维真实向量:
# vibevoice/modular/modeling_vibevoice_asr.py
# class VibeVoiceASRForConditionalGeneration
# def streaming_generate(...),约第 529 行
for chunk_idx, feat_chunk in enumerate(feature_chunks):
    audio_embeds = torch.cat([sp_start_embed, feat_chunk, sp_end_embed], dim=1)
    outputs = self(inputs_embeds=audio_embeds,
                   past_key_values=past_key_values, use_cache=True,
                   return_dict=True)
    past_key_values = outputs.past_key_values
    next_logits = outputs.logits[:, -1:, :]

    chunk_tokens = []
    for _ in range(max_new_tokens_per_chunk):
        next_token_id = torch.argmax(next_logits[:, -1, :], dim=-1).item()
        if next_token_id == text_chunk_end_id or next_token_id == eos_id:
            break
        chunk_tokens.append(next_token_id)
        next_embed = embed_tokens(torch.tensor([[next_token_id]], device=device))
        outputs = self(inputs_embeds=next_embed,
                       past_key_values=past_key_values, use_cache=True,
                       return_dict=True)
        past_key_values = outputs.past_key_values
        next_logits = outputs.logits

    tce_embed = embed_tokens(torch.tensor([[text_chunk_end_id]], device=device))
    outputs = self(inputs_embeds=tce_embed,
                   past_key_values=past_key_values, use_cache=True,
                   return_dict=True)
    past_key_values = outputs.past_key_values
    yield chunk_idx, total_chunks, tokenizer.decode(chunk_tokens, skip_special_tokens=True)
feat_chunk 就是第 3 节 encode_speech 算出来的 combined_features,形状是 [batch, window_frames, 3584];sp_start_embed、sp_end_embed 是 <|object_ref_start|>(151646)和 <|object_ref_end|>(151647)这两个复用自 Qwen2.5-VL 词表的边界 token 各自查表得到的 embedding。past_key_values 里已有提示词和此前所有轮次;输出是 generator 每轮 yield 的一段 chunk 文本,不是整篇最终稿。最后那次 tce_embed 对应的 forward 看起来像多余的 bookkeeping,实际上很关键:<|text_chunk_end|> 必须进入下一轮上下文,否则序列会和训练格式错位,第 6 节的玩具版里同样保留了这一步。
9. vLLM 服务怎样避免“保留历史”变成重复计算
参考实现手里有显式 K/V 缓存;vLLM 的服务接口则通常是一轮一个 request,没有直接暴露“把我的 K/V 缓存拿回来继续 append”的 API。仓库因此采用 automatic prefix caching:每轮重建到目前为止的 token prompt,依靠完全相同的前缀命中缓存。
# vllm_plugin/asr_streaming_server.py
# class StreamingSession
# async def push(self, window),约第 275 行
self._windows.append(window)
tokens = self._tokens + [self.audio_token_id]
k = len(self._windows) - 1

# 已处理窗口不重复传波形;uuid 必须保持不变。
uuids = [f"{self.session_id}-{i}" for i in range(k + 1)]
audio = [None] * k + [window]
out = await self.engine.generate(tokens, audio, uuids,
                                 self.sampling_params, req_id)

gen = list(out.outputs[0].token_ids)
while gen and gen[-1] == self.text_chunk_end_id:
    gen.pop()

# stop token 不回显,但要手动补到下一轮 prompt。
self._tokens = tokens + gen + [self.text_chunk_end_id]
return _strip_specials(out.outputs[0].text)
这个函数的输入 window 是当前新到的一段 PCM 音频,返回值是当前 chunk 的可显示文本;self._tokens 和 self._windows 则留给下一轮。实现里有三个容易被忽略的约束:
-
audio = [None] * k + [window]让旧窗口不必随每轮请求重复上传;UUID 仍要字节级稳定,vLLM 才能把它们识别成相同的多模态前缀。 - 文本历史仍然完整保留。省掉的是重新计算,不是语义信息;第 4 节说的 Speaker 编号一致性依然依赖这份历史。
- 如果多模态处理缓存被驱逐,代码会降级为重发所有窗口。这比静默丢掉历史可靠,但意味着部署时要给
mm_processor_cache_gb留足空间。
WebSocket 入口和这个状态模型是一致的:缓冲区达到 window_samples 后送出窗口,然后执行 buf = buf[chunk_samples:],只消费新增 chunk,保留 look-ahead 重叠。尾部不足一个完整窗口时补零,避免最后一次编码出现训练时没见过的“短窗口但没有前瞻”。
10. 实验结果说明了什么:收益存在,但流式化确实有代价
论文在英语上用 WER、中文/日文/韩文上用 CER,都是“把预测文本改成参考文本需要多少编辑”的错误率,越低越好。7B、22-frame 配置在四个会议集和 MLC-Challenge 的五集平均普通识别误差为 24.66;论文对比的 Gemini 3.5 Transcribe Live 为 25.23。speaker-attributed 评测中,VibeVoice 在 13 个可比较设置里有 12 个达到最好或并列最好,第 6 节已经详细拆解了它和 Google STT D0/Dfin 的对照,这里不重复。
比 D0/Dfin 更直接的一组代价,是同源模型“流式化前后”的差距:streaming 和非 streaming 的同源 checkpoint 对比显示,流式化后普通 WER/CER 增加 0.75–3.53 个点,cpWER/cpCER 增加 5.13–6.67 个点。后者下降更多,和前面“有限未来上下文对说话人归属更敏感”的推断一致。
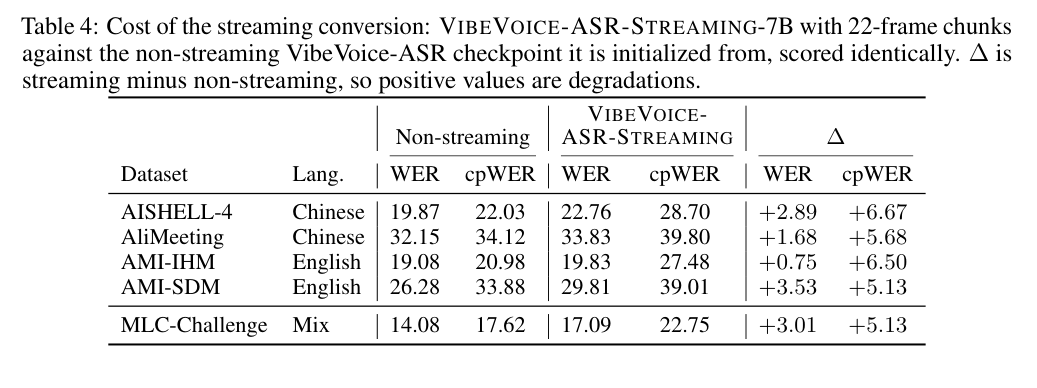
这张表是同一个 7B 模型的配对比较:左边是初始化来源的 non-streaming checkpoint(即第 7 节 Stage 1 的产物),中间是加入 22-frame streaming 约束后的结果,最右侧 $\Delta$ 是“流式减离线”,所有正数都是流式化带来的误差增加。逐行看,普通 WER/CER 增加 0.75–3.53 个点,而 cpWER/cpCER 增加 5.13–6.67 个点;后者在每个数据集都更大,说明额外损失主要不只是词识别变差,还来自说话人归属在有限上下文下更难。
模型规模和 chunk 长度也主要影响说话人归属:22-frame 比 15-frame 在 7B 五集平均改善 1.46 个 WER/CER 点、4.06 个 cpWER/cpCER 点;1.5B 升到 7B 时,22-frame 的 cp 指标改善 12.76 点,而普通指标改善 4.69 点。这个现象更像是更长窗口和更大模型(对应第 3 节表里 hidden_size 从 1536 涨到 3584)提供了更丰富的 speaker evidence,而不是单纯提升了词汇建模能力。
服务成本方面,论文只报告了一个明确配置:7B、15-frame、batch size 1、A100 80GB PCIe、bfloat16 和 vLLM。在 30–480 秒音频上,每个 2 秒 chunk 的 decode 为 146–208 ms,RTF 为 0.073–0.104,和第 5 节的结论一致:粒度由协议决定,不由算力决定。
11. 适用范围和我的判断
这篇工作最清楚的贡献,不是宣称 streaming ASR 已经没有问题,而是把一个难以拆开的状态问题拆成了几个可验证、甚至可以在没有真实权重的情况下用代码复现出计算过程的机制:两个独立冻结的语音 encoder,各自升维到 3584 后逐元素相加,而不是先拼接再投影;训练目标按词级时间以 0.1 秒容差切进固定长度的 chunk;K/V 缓存只追加不回改,把“不做事后修正”变成推理循环里压根没写的一条分支;vLLM 用前缀缓存把这套“只追加”的语义落实成可接受的服务成本。
相应的限制也很明确:训练语言受 Qwen3-ForcedAligner-0.6B 的词级对齐覆盖限制,目前是十种语言;长时间多人重叠会因为单一文本流的串行化而下降(第 4 节已详细讨论);发布 checkpoint 支持的录音长度约为 8 分钟,主要受未压缩上下文的计算成本限制;首包延迟仍是完整 chunk 加前瞻(3.5 s / 2.5 s),而不是报告里 2.00 s / 1.53 s 的稳态数字(第 5 节)。
因此比较稳妥的结论是:VibeVoice-ASR-Streaming 给出了一条把“实时转写”和“会话内说话人一致性”放进同一个 LLM 状态里的可运行路径,实验也显示它在本文设置下有竞争力;但它不是把 diarization 的所有困难凭空消除了,而是把这些困难转成了上下文长度、前瞻预算、训练对齐和服务缓存的工程取舍。
顺带一提,ASR streaming 和《动手学 AutoML:从 NAS 到大语言模型优化实战》并不是同一个方向;但两者都说明,模型效果不能脱离输入格式、上下文长度和部署资源单独讨论。书里把 LLM 架构自动化、压缩和后训练剪枝整理成了可复现的实现路径,感兴趣可以看下。
