2026 | Voice Memory:ASR 纠错不训权重只训一个 memory.md,学到的是'克制'
2026 | Voice Memory:ASR 纠错不训权重只训一个 memory.md,学到的是”克制”
1. 前言
你有没有遇到过这种情况:语音识别(ASR,Automatic Speech Recognition,把语音转成文字的模型)的结果已经挺准了,但你还是想”再抢救一下”——把识别结果丢给大模型 LLM 纠错,结果反而越改越差?
这个问题比表面看起来复杂得多。纠错模型最大的毛病不是不够聪明,而是太勤快:它总想改点什么。NVIDIA 这篇 Voice Memory 给出的答案很反直觉——最好的纠错是大部分时候什么都不做,而且实现方式更反直觉:不改任何权重,只在推理时读一个几百字节的文本文件。
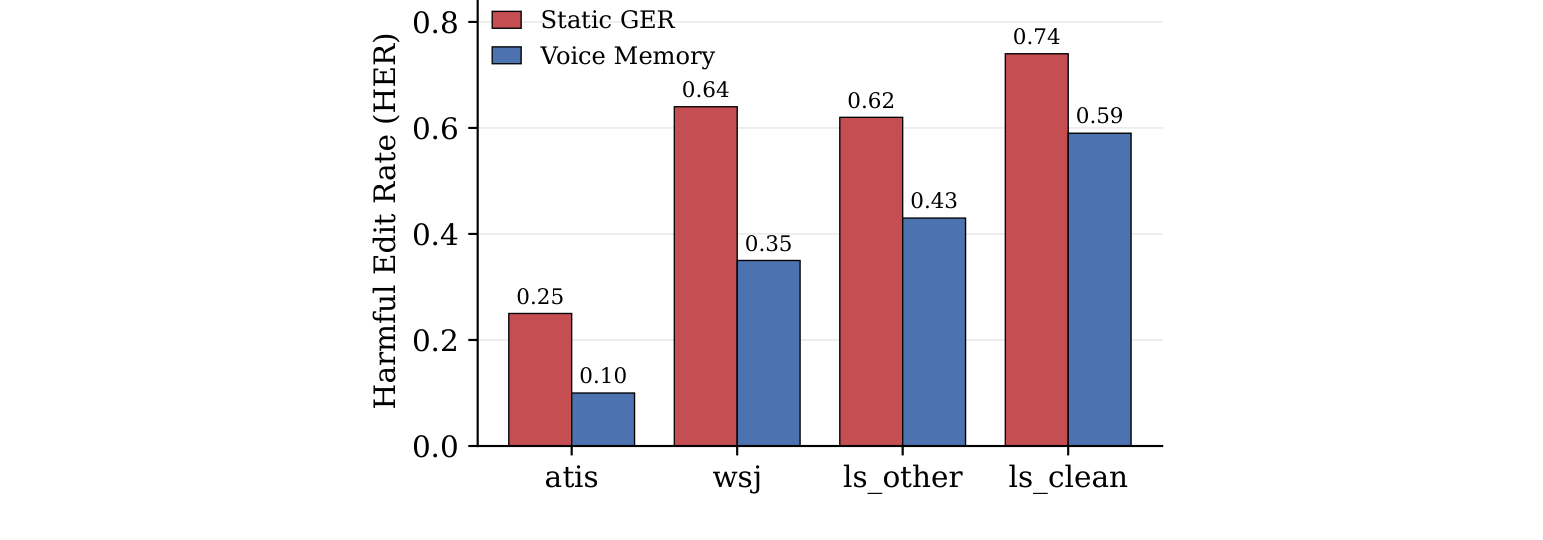
先交代下背景。把 ASR 的输出交给 LLM 做二次纠错,这条路线在业界叫生成式纠错(GER,Generative Error Correction,让 LLM 把识别出的文字重写一遍以消除错误)。论文里有个数字特别扎眼:在金融新闻这种数据上,无约束的 GER 每做 100 次编辑,最多有 64 次是把本来对的 token 改坏了。Voice Memory 把这个数字压到了 35%。在 10 个公开 benchmark 上,加权 WER 从 8.36% 降到 7.52%,没有任何一个数据集比不改还差——不过这个提升的幅度和分布,后面第 5、8 节会拆开看,别指望它是全面碾压。
这套方法有个名字很贴切:Voice Memory——把纠错技能写进一个叫 memory.md 的文本文件里。
先别急着往下看,把这篇工作的定位说清楚,免得期待错位:它的新意不在原理,而在组合和工程化。拆开看,几个部件没一个是新的——LLM 读 n-best 做生成式纠错(GER)是 2023 年就有的老路线;用验证集反馈自动改进文本提示是 GEPA、Trace2Skill 这类轨迹优化同款玩法;”LLM 别乱改”也是做 GER 的人早就知道的常识。Voice Memory 做的是把它们组装成一个带显式决策的闭环:纠错技能外置成一个可审计、可自动学习的 memory.md,纠错器每句只做一件事——决定动手改还是 abstain(放弃)。这个组装带来一个实打实的实证发现:无约束的纠错会过度纠错(最多 64% 的编辑改坏正确 token),而学会”克制”后有害编辑率降到 35%。后面所有实验都在验证这个发现,以及它的适用范围和边界。如果读完只想带走一个数字,记住 64%→35%——它说明纠错系统的头号敌人不是”不够聪明”,而是”不知道什么时候不该动”。
2. 背景:ASR 纠错的两种老路,为什么都不够好
先建立概念。ASR 模型解码时通常会输出多个候选结果,按得分从高到低排成一列,得分最高的叫 1-best(第一名),整列叫 n-best(前 n 个候选)。纠错模型的输入就是这个 n-best 列表,输出一条更准的文字。评测指标是 WER(Word Error Rate,词错误率:要改动多少个词才能把识别结果变成标准答案,替换、删除、插入都算,越低越好)。
想给 ASR 注入领域知识,历史上主要有两条路:
第一条路:上下文偏置(contextual biasing)。提前准备一个领域热词表(比如航空公司常见的地名、航班号),在解码时”喂”给声学模型,让它更倾向于识别这些词。这条路的问题是:需要专门的 bias 词表、要重新适配模型甚至重新训练,而且词表外的知识一概无效。
第二条路:LLM 生成式纠错(GER)。不碰声学模型,把纠错当成一个纯文本任务:LLM 读 n-best,重写一条更合理的文字。这条路灵活得多,但它有个致命问题——LLM 不知道什么时候该住手。它会把 “dollars” 改成 “$”、把正确的词”润色”成另一个正确的词、把缩写展开、把语序”优化”一下。改完一测 WER,反而涨了。
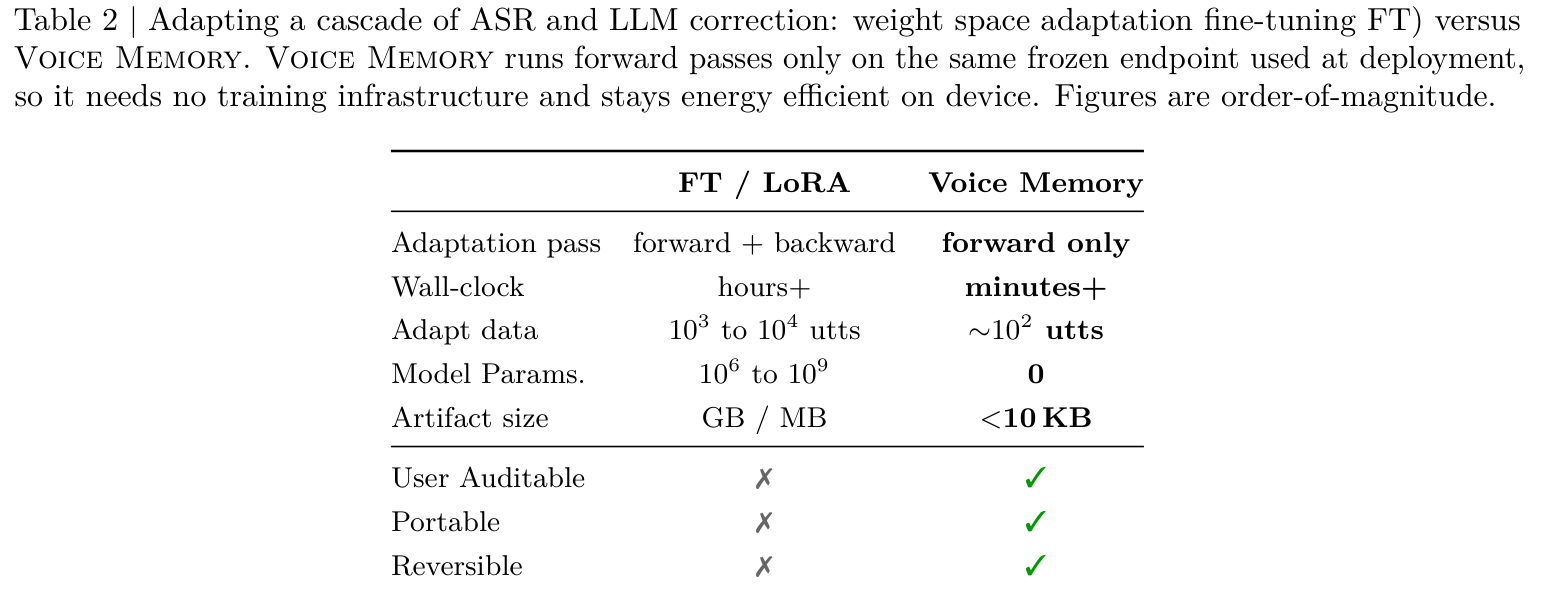
论文用表 2 把两条路的代价摊开对比:微调(fine-tune,在预训练模型基础上用领域数据继续训练)和 LoRA(Low-Rank Adaptation,一种只训练少量低秩参数的轻量微调方法)要 forward + backward 反传梯度,耗时以小时计、需要 10³~10⁴ 条数据、产物是 GB/MB 级的权重文件;而 Voice Memory 全程只有前向推理,分钟级搞定,~10² 条数据就够,产物不到 10KB,还能被人读、被审计、随时撤销。
3. 核心思想:listener-thinker 架构
Voice Memory 把纠错拆成了两个角色,论文称之为 listener-thinker(监听者-思考者)架构:
- listener(监听者):推理时同步工作的那条路径。一个完全冻结的纠错模型读入语音识别出的 n-best,外加一份当前生效的
memory.md,然后做出决策——这一条 utterance(一句话)是动手改,还是 abstain(放弃,直接保留 1-best)。注意是”决策”,不是”重写”,这是全文最关键的设计。 - thinker(思考者):推理之外异步工作的那条路径。一个优化器离线地对
memory.md做有界编辑(一次最多改几个条目),只有在改完后的验证分数严格变好时才接受这次编辑。
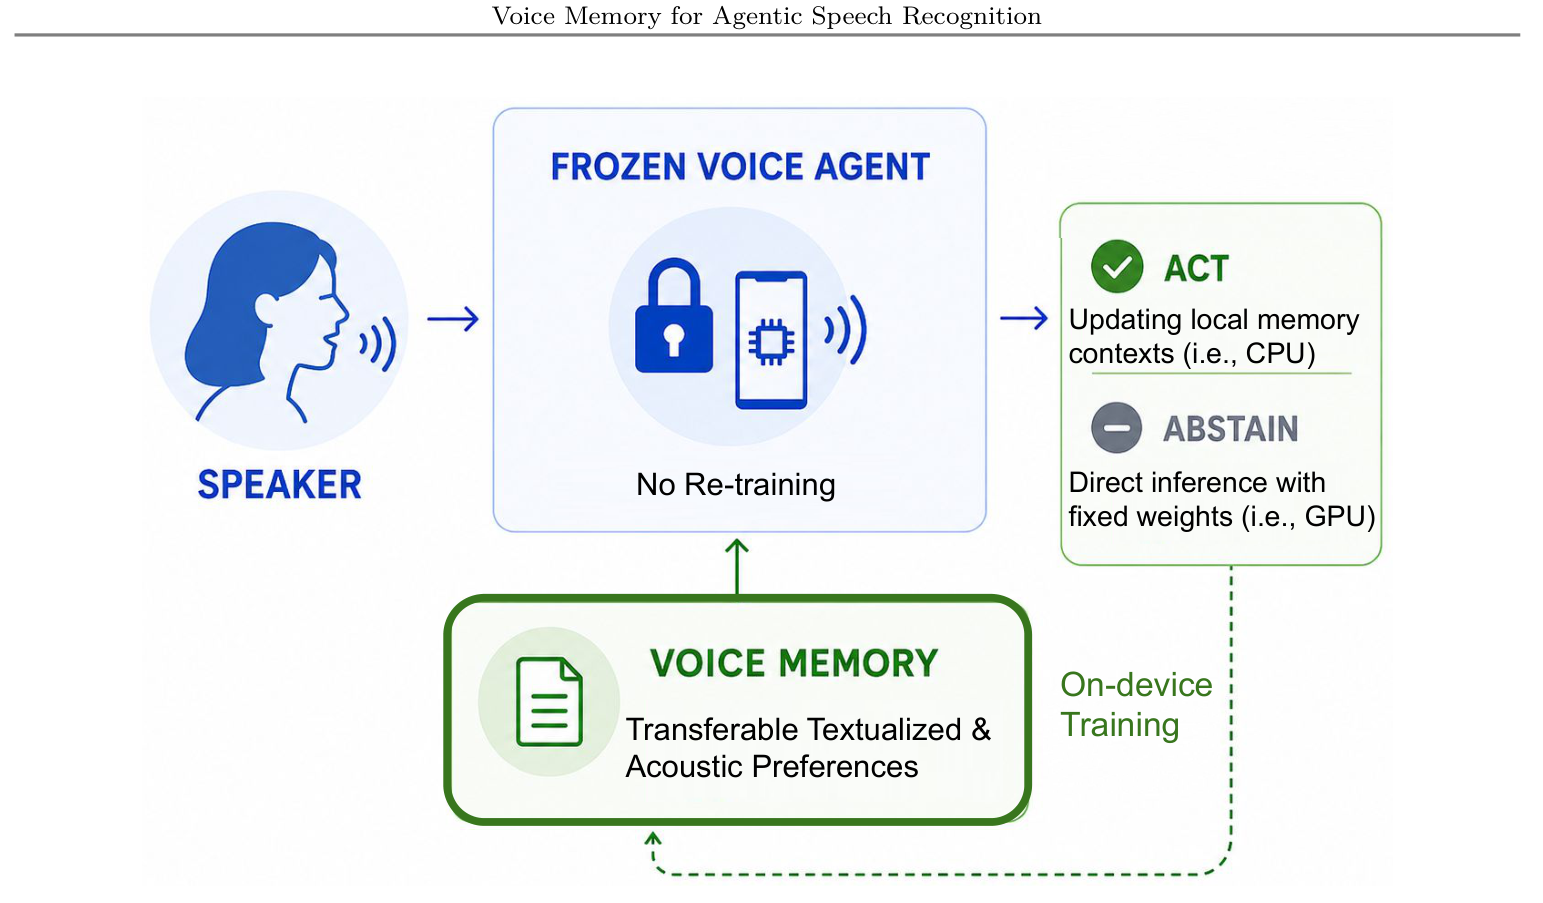
两个角色唯一的耦合点是那个文本文件。权重一个字不动,所以这套系统天然可审计、可移植、可回滚——这些都是权重里的知识给不了的。下图把整个结构画得很清楚:推理时(GPU 侧)冻结的纠错器读 memory 做决策,离线时(CPU 侧)优化器只改那个文本状态,二者通过文件解耦。
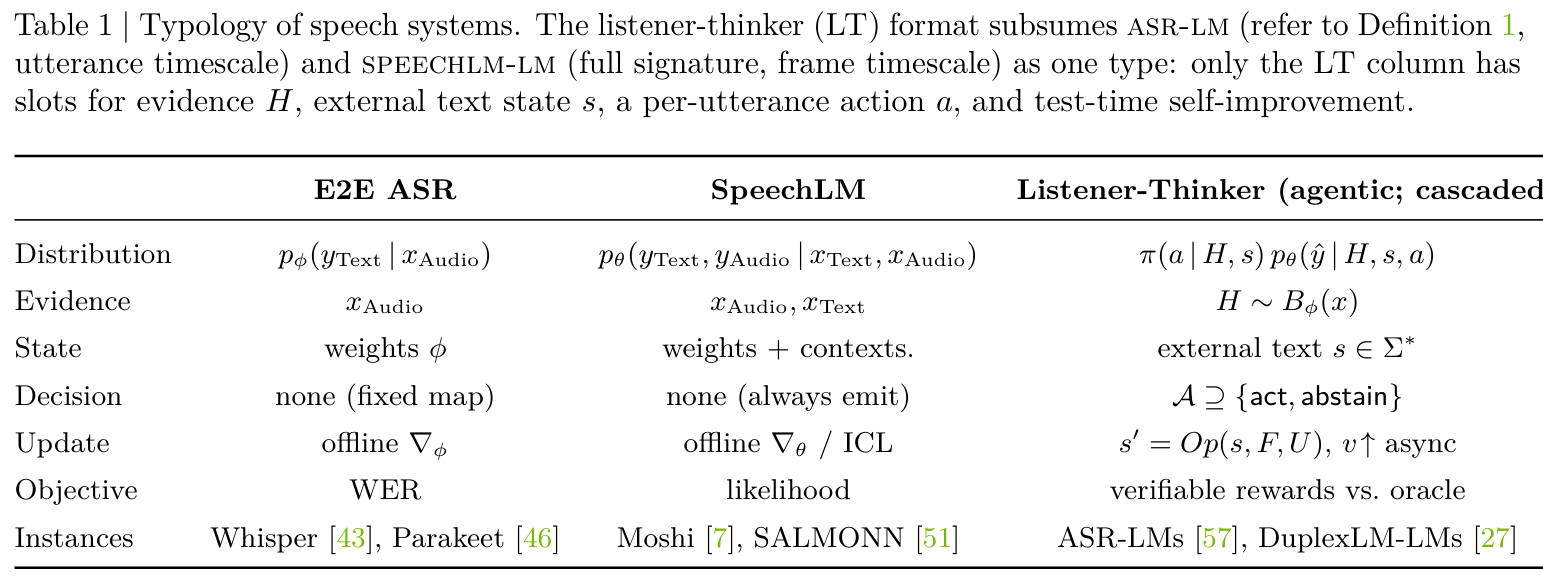
论文还把这种格式放在整个语音系统的谱系里看(下表),只有 listener-thinker 这一列同时拥有”证据、外部文本状态、逐句动作决策、测试时自我改进”四个槽位。
这里要诚实交代一个适用范围问题:这套框架强依赖 n-best,论文的整个评估都建立在 Whisper 的候选列表之上。HyPoradise 这个 benchmark 本身就是 Whisper large-v2 的 5-best 数据(模型卡里白纸黑字写着:”ρ depends on the n-best list (Whisper large-v2 5-best throughout)”),所以深度研究(MiniMax 当纠错端)和广度研究(Qwen3-30B-A3B 当纠错端)里,listener 一直是传统声学模型,纠错端换的是 LLM。对 Qwen3-ASR 这类 LLM-based ASR,情况就尴尬了:它们通常是端到端单输出(argmax 取 token),不产出候选列表——没有 n-best 就没有 oracle(上帝视角上界),ρ 这套”恢复了多少 headroom”的分析直接无法定义。act/abstain 的主干机制理论上还能套(决定改不改唯一的 1-best),但收益会大幅缩水,memory 能补的大概只剩领域专有名词。论文对这条路径没有任何实验,所以严格说:它解决的是”传统 ASR + LLM 纠错”级联的适配问题,不是 LLM-based ASR 的问题。
4. memory.md 里到底写了什么,以及它是怎么被优化出来的
整个系统学到的”技能”,最后都沉淀在一个人类可读的 Markdown 文件里。论文给的例子长这样:
keep the verbatim ASR token; do not normalize.
place 'dollars' after the amount, not '$' before it.
第一条意思是”保留 ASR 的原始 token,别做规范化”——这就是典型的克制型规则:它在教模型不要手痒。第二条是领域约定(金额的表达习惯)。部署下来的 wsj 领域记忆只有 776 字节。
这个文件不是人写的,是优化器自己从训练集里”长”出来的。整个流程见算法 1:
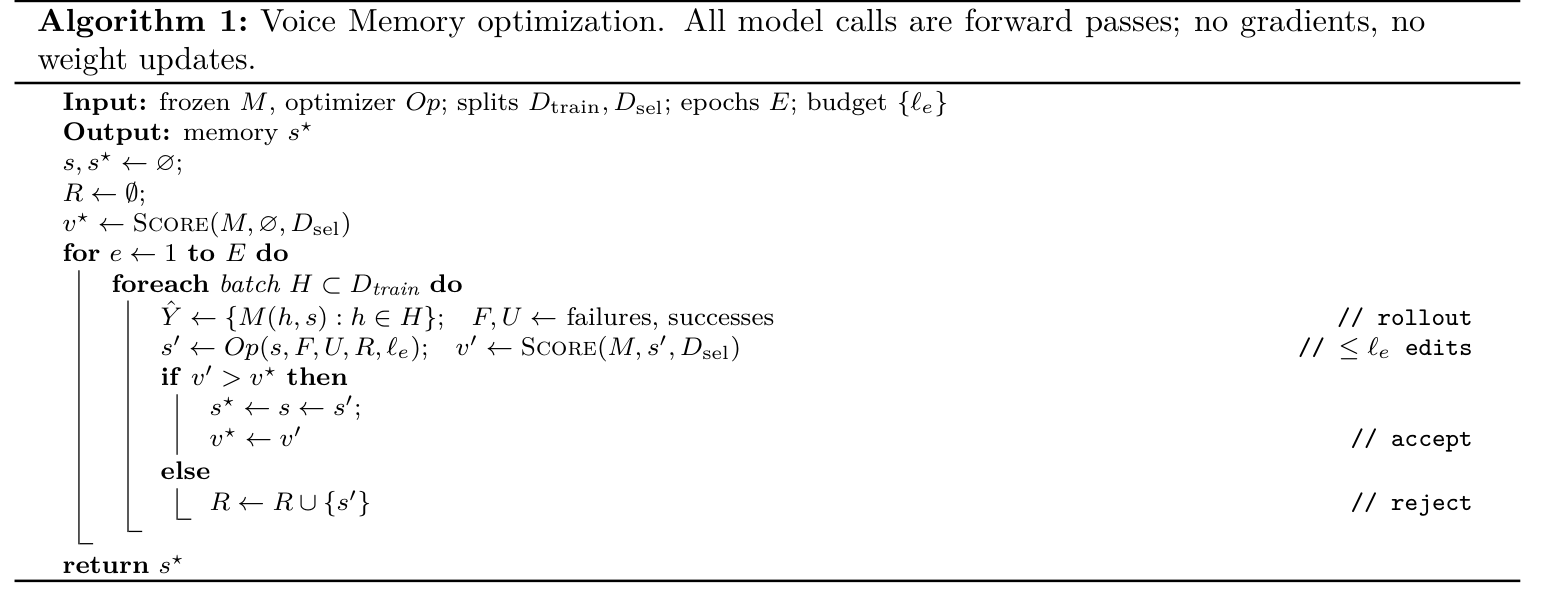
大致逻辑是:
- 拿当前
memory.md,让冻结的纠错模型对训练集做 rollout(跑一遍推理得到输出),把失败的样本和成功的样本分开; - 优化器基于失败样本提出一组候选编辑(增、删、改条目,有预算上限);
- 在独立的验证集上打分,只有分数严格高于当前最优才接受这次编辑,否则回滚;
- 迭代若干轮(默认 4 epochs),返回最终文件。
关于这个文件的生命周期,有几个值得展开的点:它会不会越攒越大?会不会过拟合?是不是每个场景都要写一条规则?论文都有交代,只是散在各处,这里集中说。
规模是受控的。 优化过程是”有界编辑”——每次迭代最多增删改几个条目,而不是无限制地累积规则;部署产物也印证了这一点:wsj 记忆只有 776 字节,最大的自动生成版也才 9.0 KB,而且论文还观察到”质量胜过覆盖”——5.4 KB 的 Claude 生成记忆效果比 9.0 KB 的自动记忆更好。
过拟合有防线,但没被彻底解决。 门控是主要防线:每次编辑都要在独立验证集(论文叫选择集)上严格变好才接受,比直接优化训练集稳得多;语义门控又比 WER 门控对随机种子稳定 4 倍。但诚实地讲:跨模型和翻译实验只有 40~100 条 utterance 的小样本,而且论文自己在 wsj(数据量大的领域)观察到自形成记忆会过度纠错(6.2 vs 无记忆 6.1)——这就是过拟合的实锤,论文没有回避。”记忆规模与过拟合的关系”没有被系统研究,是空白。
不是每个场景写一条规则。 memory 是 per-domain 的:每个领域一份文件,里面是通用克制规则(keep verbatim、do not normalize)加少量领域规则,而不是把每个错误都记一条;跨域迁移实验(一份记忆换到别的领域)显示学到的规则更接近”通用的克制策略”而非领域特化修补。代价是每个新领域确实要单独优化一份 memory,这个成本要算进去。
全程只有前向推理,没有任何梯度。打分用什么指标很关键,论文后面专门分析过(第 7 节),先按下不表。
看到这里可能有人会觉得:这不就是”给 LLM 换了个更好的 prompt”吗?说实话,这个质疑一半是对的。作者自己发布的 notebook 里,用一个 30 行的规则引擎就复现了完整效果:正则解析 memory 里的替换规则("x" -> "y")和偏好词表,按命中数给候选打分选一条,没有命中就 abstain——LLM 在这里只是规则的”通用执行器”,规则本身是机械可执行的。这恰好说明:memory 本质上就是一组显式规则,说它”像 skill”不是贬低,而是准确描述。
那剩下的那一半新意在哪?两处:一是这套规则不是人写的,是优化器在独立验证集上门控”搜索”出来的——搜索空间是文本规则,搜索策略是迭代编辑加”严格变好才接受”的收益判断,这跟 NAS 搜网络结构是同一个味道;二是它配了 ρ、HER 两把尺子(下面马上讲),让”纠错有没有用、有没有改坏”第一次可以量化——没有这两把尺子,这套搜索无从谈起。诚实地说,连”验证集门控优化提示词”这个玩法本身也不是它首创的(GEPA、Trace2Skill 都在做),它的增量是把这套搬进了 ASR 纠错,并实证了”克制”是收益来源。
为了量化”纠错到底帮了多少”,论文定义了两个指标,都值得记住:
- ρ(可恢复信息比,Recoverable Information Ratio):纠错后缩小的错误差距占”1-best 到 oracle”差距的比例。oracle(上帝视角)指的是每句都从 n-best 里挑出 WER 最低那条的极限。ρ=1 说明完全吃满了 n-best 能提供的收益;ρ<0 说明越纠越差(损伤区);ρ>1 说明它产出了 n-best 里根本不存在的 token,比 oracle 还强。
- HER(有害编辑率,Harmful Edit Rate):所有编辑里,把本来正确的 token 改坏的那部分占比。这个指标专门用来抓”过度纠错”。
5. 核心发现:这个循环学到的技能是”克制”
论文最重要的结论藏在实验里:无约束的 GER 之所以有害,是因为它把纠正当成了改写;而 Voice Memory 学到的恰恰是”哪些 token 不要碰”。
先看深度研究:用 MiniMax-M3428B(428B 参数、激活 23B 的模型)当冻结纠错器,在 HyPoradise(一个开源的 ASR 纠错 benchmark 套件,覆盖 9 个领域)全测试集上跑,结果如表 3:
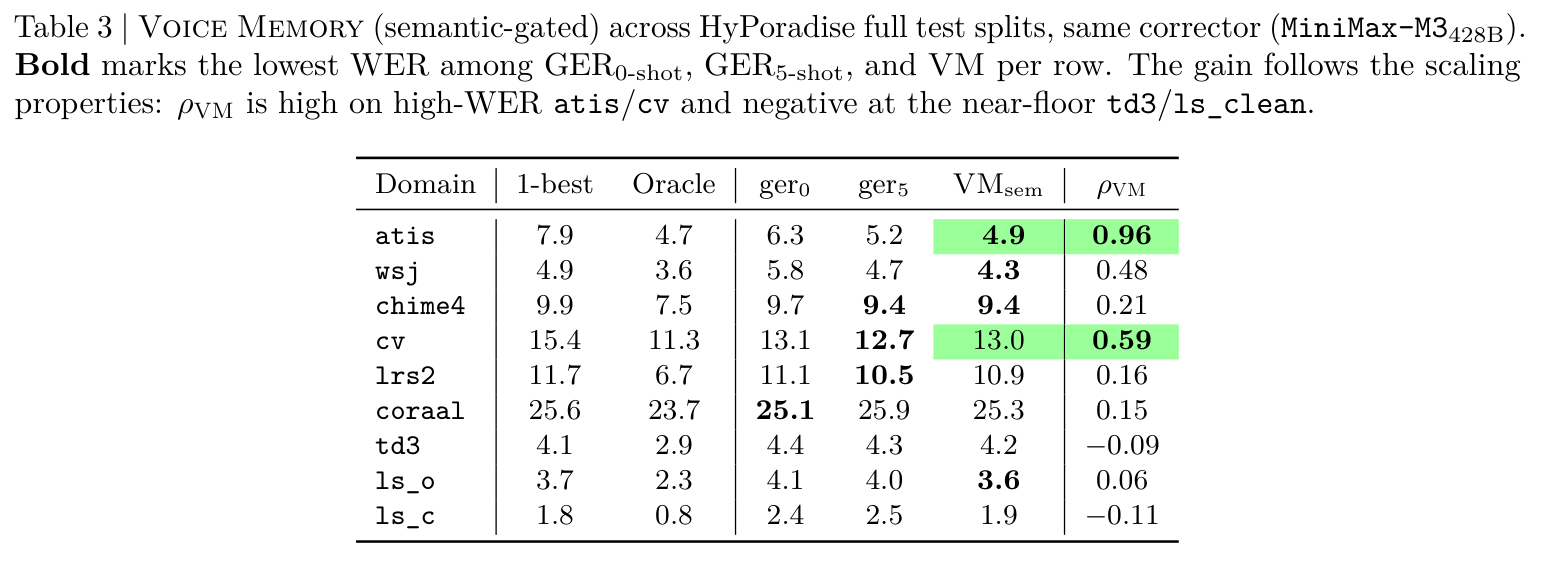
几个数字值得细看:
- 高错误率领域收益最大:atis(航班信息查询)1-best 是 7.9,oracle 是 4.7,Voice Memory 干到 4.9,ρ=0.96——几乎吃满了 n-best 的全部潜力。
- 错误率越低收益越少,甚至为负:ls_clean(干净的朗读语音)1-best 已经 1.8,再纠反而到 1.9(ρ=-0.11)。这印证了 ρ 和 1-best WER 的相关系数高达 +0.90——收益集中在有头寸(headroom)可恢复的地方,到了错误率地板就没什么可纠的了。
- 零样本 GER 在三成领域把 WER 抬高了:ls_clean 1.8→2.4、ls_other 3.7→4.1、td3 4.1→4.4,典型的过度纠错。
有害编辑率的变化更能说明问题(下图):四个领域上静态 GER(static GER,即不做记忆、直接让 LLM 硬纠)的 HER 高达 0.25~0.74,Voice Memory 把它们全部降下来,wsj 从 0.64 压到 0.35。
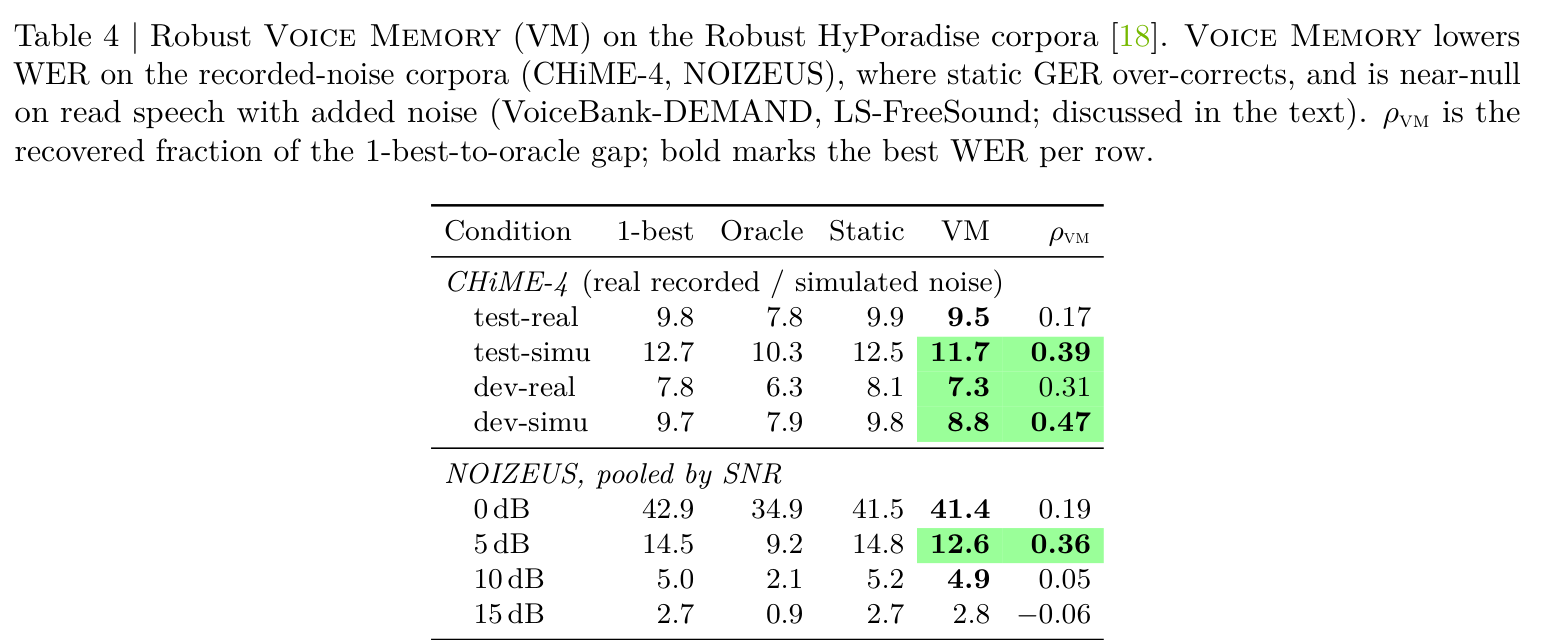
在噪声环境下结论一样成立(表 4):CHiME-4 这类真实录音噪声语料上,静态 GER 反而把 WER 抬高(9.8→9.9),Voice Memory 则降到 9.5;NOIZEUS 0dB 极端噪声下 42.9→41.4。而在”干净的朗读语音 + 人为加噪”这种本来就没多少可恢复空间的场景,Voice Memory 学会的是老老实实 abstain。
6. 换个模型、换个任务,记忆照样好用
文本形式的最大红利是可移植。论文做了两个方向的验证:
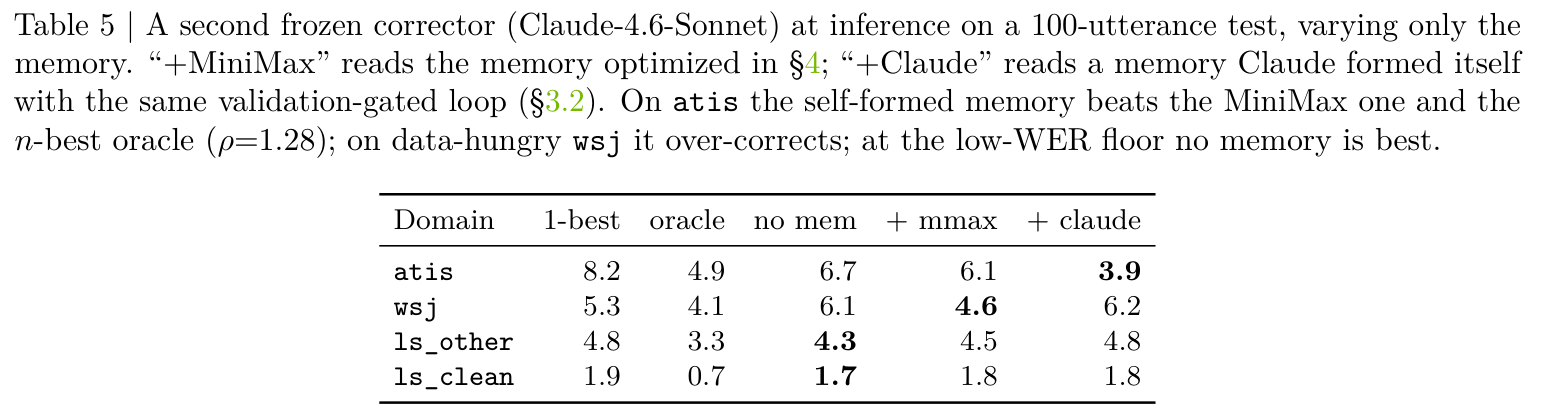
换模型:把 MiniMax 优化出的记忆直接给 Anthropic Claude-4.6-Sonnet(一个完全不同的模型家族)读。在 atis 上,Claude 无记忆时 WER 6.7,读 MiniMax 写的记忆降到 6.1——一个模型学到的技能,另一个模型直接继承。更妙的是让 Claude 用自己的 loop 重新优化一份记忆,在 atis 上达到 3.9,ρ=1.28,超过了 n-best oracle(因为它恢复了 n-best 里不存在的 token)。注意这是 100 条 utterance 的小样本实验,数字当定性证据看,别当定量结论。边界也很诚实:在数据量大的 wsj 上自形成记忆会过度纠错(6.2 vs 无记忆 6.1),在错误率地板处(ls_clean)不读记忆最好。
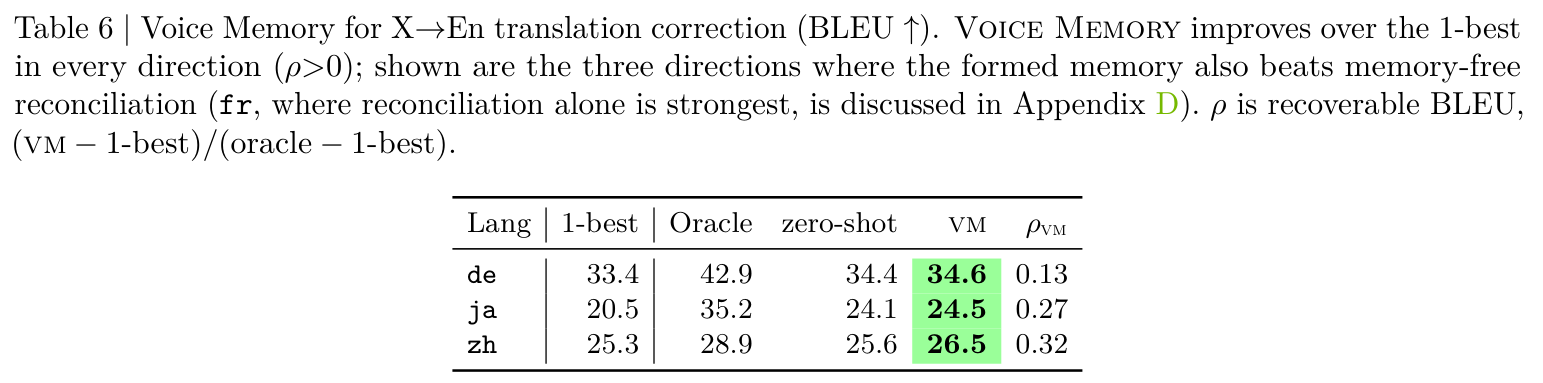
换任务:把同一个 loop 搬到语音翻译纠错上(X→En,即把非英语语音先识别再翻译成英语,让 LLM 从 n-best 翻译里调出一条更好的,用 BLEU 打分——BLEU 衡量机器翻译和参考译文的重合度,越高越好)。四个语向上 BLEU 全部提升,恢复了 oracle 头寸的 13%~32%。40 条 utterance 的小实验,但机制完全一致:优化器甚至拒绝了”抄一条参考译文就能刷分”的投机编辑——它学到的还是克制。
7. 分析:为什么”优化语义”比”优化 WER”更好
论文第 7 节是我个人觉得最有意思的部分,它回答了一个方法论问题:优化器打分时该盯着哪个指标?
答案是不要盯着 WER。表 7 的消融实验直接对比两种 gate(验证闸门,决定是否接受一次编辑的信号):WER gate(按 WER 打分)和 semantic gate(按纠错结果与参考句的语义相似度打分,用端侧句向量模型算余弦相似度)。结果是 semantic gate 在两个领域两个随机种子下 WER 都更低,而且在 ls_clean 上对随机种子稳定 4 倍(结果波动范围 0.03 vs 0.17)。
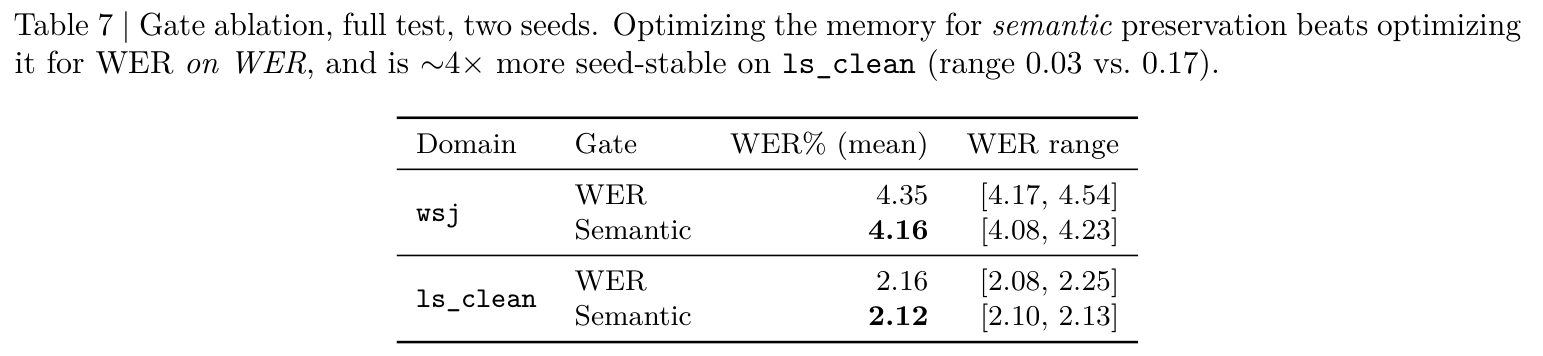
原因值得细品:WER 是按”表面字符”打分的,它奖励任何消除表面不匹配的编辑——包括同音字、拼写变体这类”改了也没意义甚至更糟”的改动。而语义打分只认”意思对不对”,天然对这类表面追逐免疫。用论文的话说:优化你上报的指标(WER),不如优化你真正在乎的东西(语义),WER 只是语义的带噪近似。
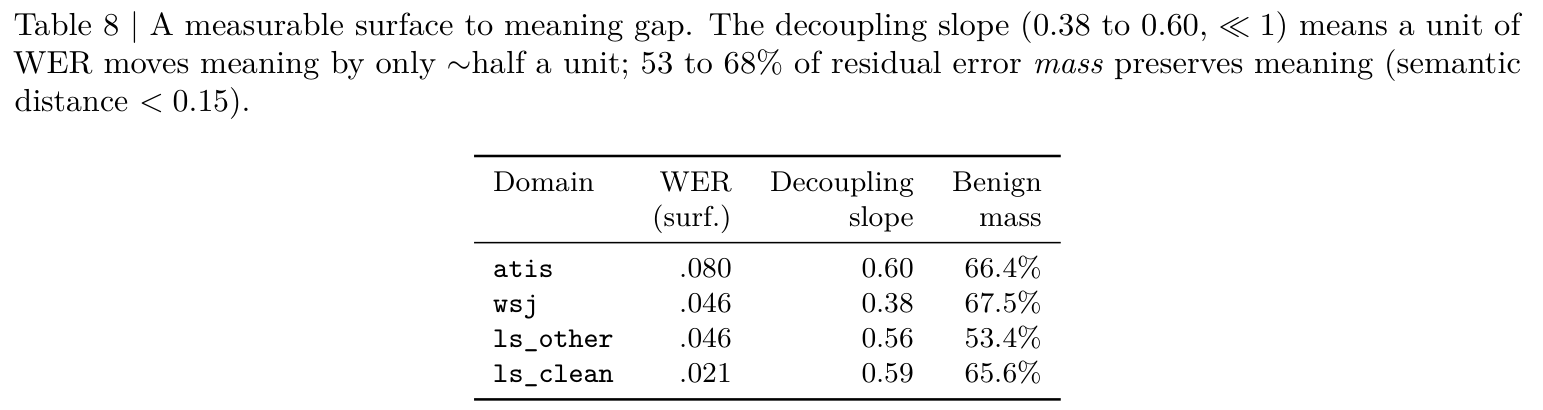
表 8 把这个”表面到语义的鸿沟”量化了:解耦斜率(decoupling slope)只有 0.38~0.60,意味着 WER 变动一个单位,语义只动大约半个单位;而且残余错误里有 53%~68% 是”良性的”(语义距离小于 0.15,即意思完全没变)。也就是说,剩下的 WER 里有大半根本不该去纠——这给”克制”提供了最硬核的论据。
8. 广度验证:开源模型 + 全部 10 个数据集
深度研究用的是闭源 MiniMax,论文还用全开源组合验证了广度:Whisper-v2-Large 当声学模型 + Qwen3-30B-A3B 当纠错器(一个稀疏 MoE 模型,MoE 是混合专家架构,前向时只激活约 30B 里的 3B 参数),覆盖 16,108 条测试样本、10 个数据集。
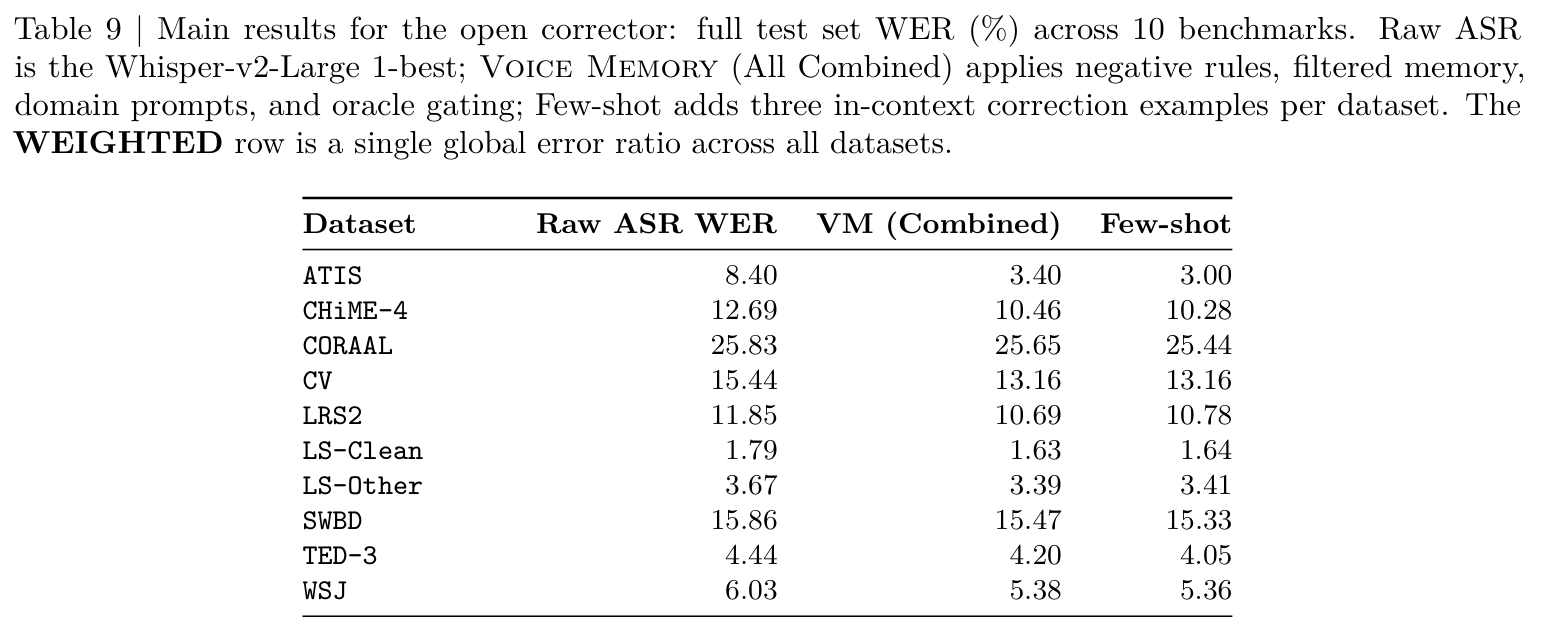
结果和深度研究完全一致:加权 WER 8.36% → 7.52%(再加三个 in-context 示例则到 7.47%),没有任何数据集跌破 1-best 基线。收益最大的还是 ATIS:8.40% → 3.40%,因为它缺失的领域词汇(航班、地名)恰恰是 memory 能补上的;而本就很难的对话语音(CORAAL、SWBD)几乎不动——那是声学歧义,语言先验救不了。
消融实验还揭示了一个反直觉的功臣:负向规则(negative rules,教模型”不要做什么”的规则)是承重墙。单独只保留负向规则,加权 WER 就从 7.66 降到 7.52,比任何其他组件贡献都大。它们的职责就是阻止纠错器去改写本来正确的 token——压缩写的展开、压 paraphrase、压数字转单词。整个 agent 发现的最优策略,本质就是”知道什么时候别动”。
9. 我的 take
先说结论:这不是一篇原理上有突破的论文,但也不是水文。它的贡献要分清楚哪些是实的、哪些只是包装。
实的地方有两个。 一是实证发现”克制”是纠错收益的主要来源:64% 有害编辑率这个数字本身就说明”重写式纠错”的路线有问题,压到 35% 靠的不是更聪明的重写技巧,而是学会了 abstain;第 7 节的语义门控(优化语义比优化 WER 更好)也是可迁移的方法论结论。二是工程上的”技能外置”:把纠错技能写成几百字节的可读文件,让冻结模型加一份外部状态就能改进,可审计、可移植、可回滚——对”部署侧零成本提效”这个命题,它给了个朴素但能用的答案。
包装过度的也有两处。 一是”agentic”这个词:act/abstain 这个决策建模本身是合理的,但把它说成”智能体”有点往脸上贴金,本质就是”加了一个是否改写的门控”。二是”对模型本身有什么贡献”——它对模型(权重)没有任何改动,这不是缺陷,但也别拔高成”模型层贡献”,它做的就是提示词优化那一套,只是产物从连续向量换成了可读文本。
最硬的两个边界,论文自己其实交代了,但容易被读者忽略:
- 强依赖 n-best:ρ、oracle headroom 全部建立在候选列表存在的前提上(Whisper large-v2 5-best throughout)。对 Qwen3-ASR 这类单输出 LLM-based ASR,评估体系直接失效,act/abstain 机制勉强能套但收益缩水,论文未验证——它解决的是”传统 ASR + LLM 纠错”级联的适配,不是 LLM-based ASR 的问题。
- 收益幅度有限:加权 WER 8.36%→7.52%,绝对收益不到一个百分点;深度研究(表 3)里 Voice Memory 相对零样本 GER 在 9 个领域里 8 个更好(唯一更差的是 coraal 25.3 vs 25.1),但相比 1-best,在错误率地板处是负收益(td3 4.1→4.2、ls_c 1.8→1.9,ρ<0,靠 abstain 兜底不更差)。收益高度集中在 ATIS 这类”领域词汇密集”的任务上(7.9→4.9,一次砍 3 个点),其余大多是 0.1~1 个点的改善。
一句话总结:它值得一读,是因为”纠错要学会克制”这个实证发现和语义门控的方法论;它不值得被神化,是因为机制上它就是”LLM 纠错 + 验证集门控的提示词优化”,而评估体系被 n-best 这个前提牢牢绑住。
顺带一提,这篇文章讲的”推理时自适应、不动权重”其实和我在 LLM 压缩、推理效率方向上的研究是同一个底层命题:模型训练完之后,还能怎么零成本地变强。我们把这些年的积累整理成了《动手学 AutoML:从 NAS 到大语言模型优化实战》,书里第 8、11 章讲了 LLM 压缩(剪枝、量化)这类”训练后提效”的手段,跟本文角度不同但目标相近——都是不动训练流程、在部署侧榨出剩余价值。有兴趣的读者可以翻翻。
